摘要:在 VibeVideoBench 的代码驱动视频任务中,GPT-6 Astra 已与 Claude Opus 5.5 处于同一水平,综合质量略高、成本更低;Opus 5.5 交付更稳定;OpenAI 下一代通用模型尚未发布,其视频能力需要发布后实测。
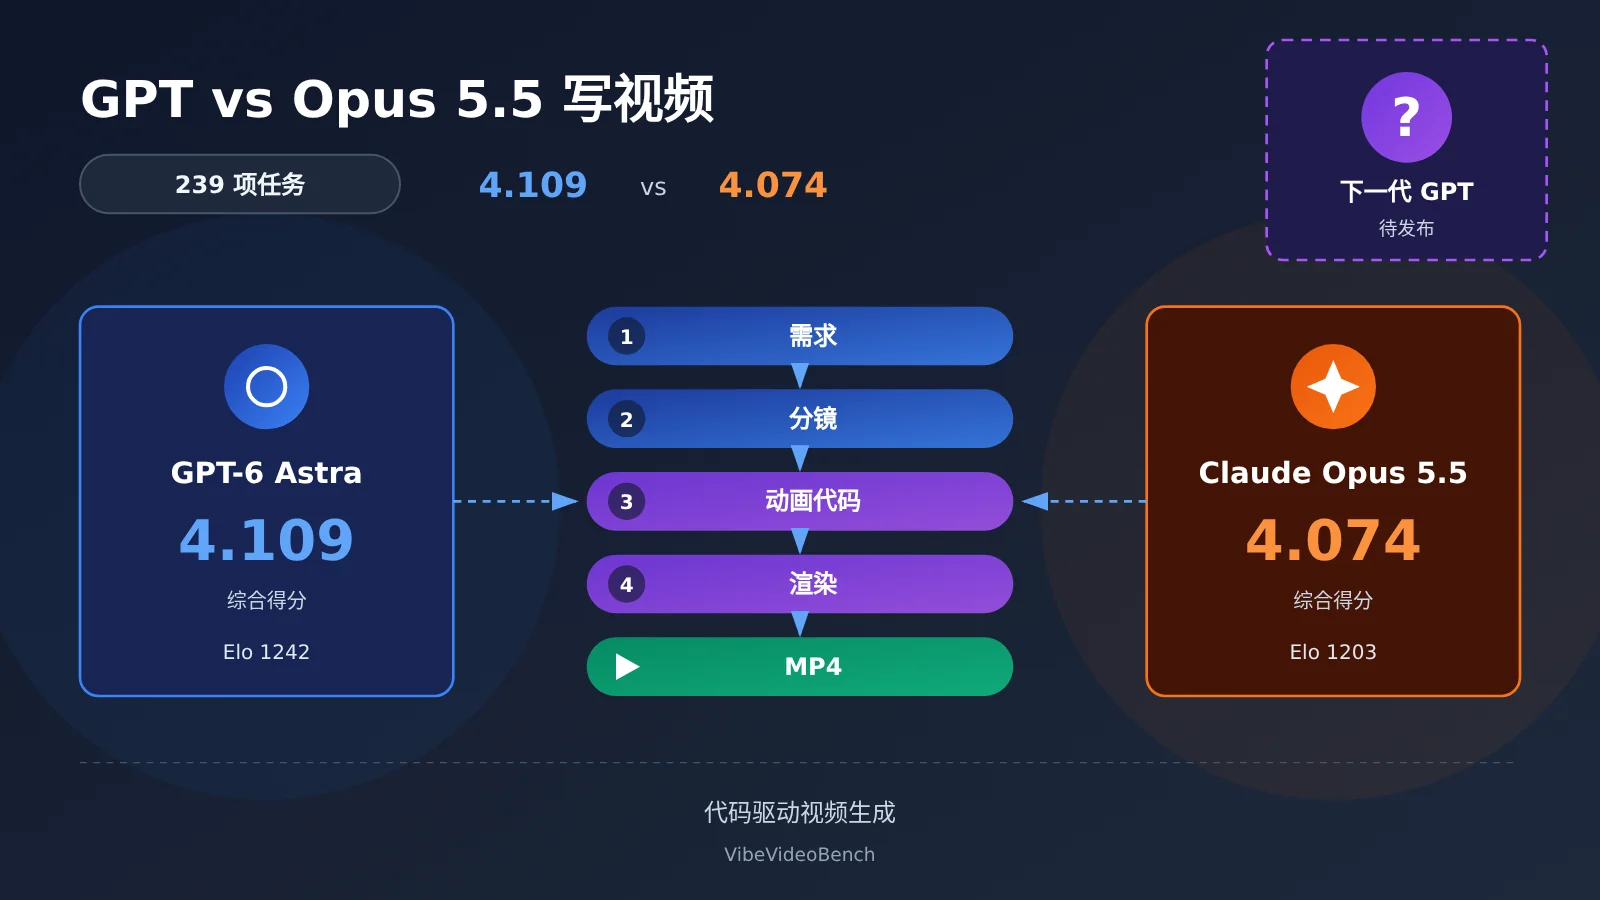
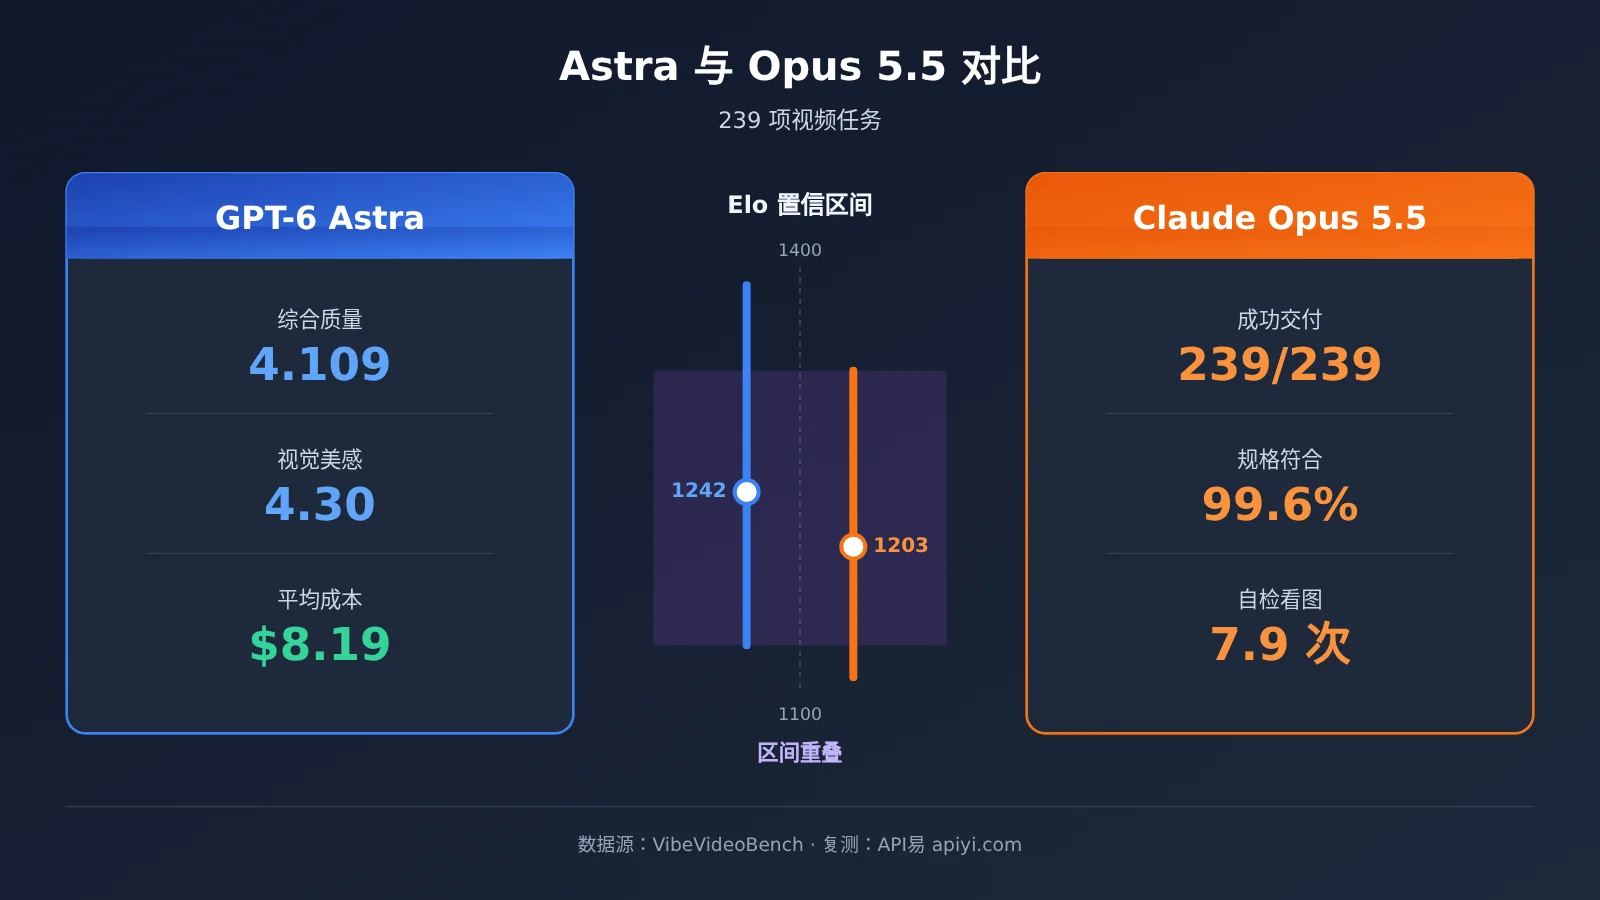
结论先行:截至 2026 年 11 月 15 日,在“Agent 编写代码、调用渲染工具、交付完整 MP4”这条路线上,GPT-6 Astra 与 Claude Opus 5.5 是 VibeVideoBench 中最接近的两个系统。Astra 综合质量得分 4.109,Opus 5.5 为 4.074;人工盲测 Elo 分别为 1242 和 1203,统计上无法区分。Opus 5.5 交付全部 239 项任务,严格任务成功率 76.3%,高于 Astra 的 74.5%;Astra 平均每项任务 API 成本 8.19 美元,约为 Opus 5.5 的一半。OpenAI 已公开两项内部模型显著强于 Astra 的证据,但下一代通用 GPT 的名称、发布时间和视频专项成绩均未公布。所以对标题问题的回答是:现款 GPT 已经赶上,下一代能否拉开差距取决于发布后的实测。
内容预告:下文先界定评测范围,再拆解 VibeVideoBench 的总体成绩、分类成绩、人工偏好和成本数据,说明两者各自的优势来自哪里;随后梳理 OpenAI 内部模型的公开信号与下一代模型的发布状态,分析视频 Agent 真正的瓶颈;最后给出一套在新模型发布后可直接复用的对比测试方法,帮助你判断它是否值得替换现有方案。
To Know:阅读本文前需要了解的术语
| 术语 | 解释 |
|---|---|
| Code-driven Video Generation | 代码驱动视频生成:AI 编写动画和渲染程序,最终输出 MP4 |
| Native Video Generation | 原生视频生成:模型直接根据文字、图片生成视频画面,代表产品有 Sora、Veo |
| VibeVideoBench | 专门测试 AI Agent 自主制作完整视频的评测基准,2026 年 10 月 26 日发布 |
| Harness | 模型运行环境,提供代码执行、文件访问、工具调用等能力,如 Codex CLI、Claude Code |
| L1 / L2 / L3 | 评测的三层:程序交付检查、任务要求逐条检查、多模态评审的视频质量评分 |
| 严格任务成功率 | 视频成功交付且满足全部约束的任务比例,比单纯“交付率”更严格 |
| Bradley–Terry Elo | 根据人工两两比较结果计算模型相对偏好的评分方法 |
| Multi-agent Orchestration | 多智能体编排:让多个 Agent 分工协作,再整合结果 |
| Render Pipeline | 视频渲染流水线:画面生成、音频处理、编码合成到最终输出 |
| Remotion / FFmpeg | 前者用 React 代码写视频动画,后者负责音视频编码与合成 |
| ffprobe | FFmpeg 附带的检查工具,用来读取视频的分辨率、帧率、时长、音轨等信息 |
| Cache Hit | 缓存命中率:重复上下文从缓存读取的比例,直接影响长任务的 API 成本 |
| BenchCAD 2.0 | 测试 AI 三维零件重建、机械装配设计和 PCB 连接识别能力的工程评测 |
1 先给结论:GPT 已经进入 Opus 5.5 的视频创作竞争区间
1.1 本文比较的是哪一种“写视频”
AI 视频创作目前有两条路线。原生视频生成由模型直接输出连续画面,擅长人物、物理运动和镜头语言;代码驱动视频生成则让模型担任导演兼程序员:理解需求、写脚本和分镜、用 Remotion、Three.js、Cairo 或 Blender 编写动画、用 TTS 生成旁白、再用 FFmpeg 合成并检查成片。
本文讨论的是第二条路线,也就是通过 Codex CLI、Claude Code 这类 Agent 交付完整 MP4 和可编辑工程的能力。这条路线适合数据可视化、产品介绍、知识科普、动态信息图和品牌宣传片,也是 GPT 与 Claude 目前有独立基准可比的领域。
OpenAI 自己的原生视频产品线已经发生变化:Sora 产品于 2026 年 4 月 26 日停止服务,Sora 2 模型及 Videos API 于 9 月 24 日关停,官方弃用公告注明没有一对一替代 API。11 月 4 日发布的 GPT-Image-2.6 支持 2—16 帧的 GIF 动画输出,适合表情包、循环动作和分镜预览,与完整 MP4 制作属于不同工作流。因此,GPT 系列“写视频”的能力,当下主要体现在代码驱动路线上。
1.2 一句话回答标题问题
GPT-6 Astra 在 VibeVideoBench 中与 Opus 5.5 极为接近,综合评分略高,交付稳定性略低。OpenAI 下一代模型具备继续提升的技术信号,但公开的视频专项成绩仍以 Astra 为基准。
2 239 项真实视频任务:GPT-6 Astra 与 Opus 5.5 谁更强?
2.1 VibeVideoBench 如何测 GPT 与 Opus 5.5 的视频能力
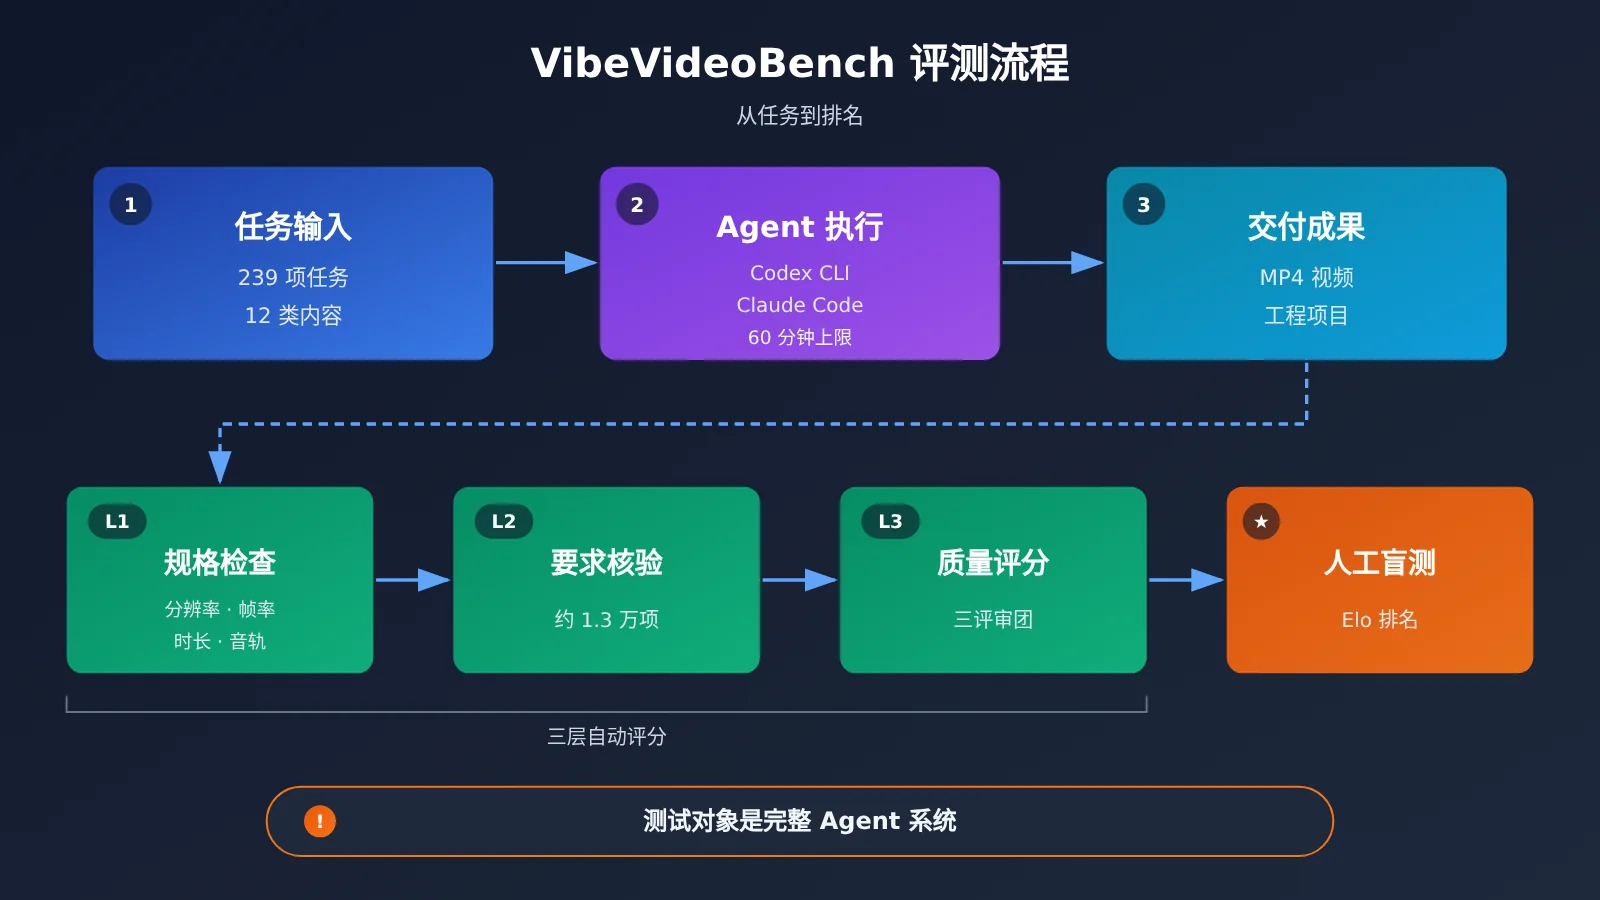
VibeVideoBench 构建了 239 项真实视频制作任务,覆盖 12 类内容,共测试 9 个 Agent 系统、2,151 次运行。每项任务要求 AI 在沙箱中自主完成,交付可播放 MP4、可重新生成视频的工程项目以及制作说明。每项任务限时 60 分钟,所有系统使用各自原生开发环境、最高可用推理强度,中途不追加人工指令。
GPT-6 Astra 运行在 Codex CLI 中,Claude Opus 5.5 运行在 Claude Code 中。其余参测系统包括 Claude Sonnet 5.5、Gemini 4 Argon、DeepSeek V4.1 Flash、Kimi K3、GLM-5.3 Flash、GPT-5.6 Sol 和 Gemini 3.8 Flash。评分分三层:L1 检查 MP4 是否交付及分辨率、帧率、时长、音轨等规格;L2 逐条验证约 1.3 万项任务要求;L3 由三个多模态评审系统评估画质、美感、内容逻辑、运动节奏和音频同步。
2.2 GPT-6 Astra 与 Opus 5.5 总体成绩对比
| 指标 | GPT-6 Astra | Claude Opus 5.5 | 领先 |
|---|---|---|---|
| 成功交付视频 | 238/239 | 239/239 | Opus |
| 视频交付率 | 99.6% | 100% | Opus |
| 规格符合率 | 93.7% | 99.6% | Opus |
| 任务要求通过率 | 97.1% | 97.3% | Opus |
| 视频质量 | 4.08 | 3.99 | Astra |
| 视觉美感 | 4.30 | 4.19 | Astra |
| 内容逻辑 | 4.20 | 4.18 | Astra |
| 运动与节奏 | 3.95 | 3.95 | 平 |
| 音频质量与同步 | 4.10 | 4.07 | Astra |
| 综合质量得分 | 4.109 | 4.074 | Astra |
| 严格任务成功率 | 74.5% | 76.3% | Opus |
| 人类偏好 Elo | 1242 | 1203 | 统计上无法区分 |
数据来自三评审团平均结果,评分范围 1—5 分。两个系统均领先其他参测系统。
这张表呈现出清晰的分工:Astra 在“做出来的视频好不好看”上略占优势,综合质量领先 0.035 分,视觉美感领先 0.11 分;Opus 5.5 在“能不能按规格交出来”上更可靠,规格符合率高出 5.9 个百分点,严格任务成功率高出 1.8 个百分点。0.035 分的差距很小,结合 Elo 置信区间来看,两者处于同一档位。
2.3 不同视频类型中 GPT 与 Opus 5.5 的优势分布
| 视频类别 | Astra | Opus 5.5 | 领先者 |
|---|---|---|---|
| 品牌与营销 | 4.18 | 4.18 | 平局 |
| 产品与功能展示 | 4.20 | 4.24 | Opus |
| 音乐与声音驱动 | 3.83 | 3.92 | Opus |
| 论文解读 | 4.03 | 4.07 | Opus |
| 概念与流程解释 | 4.19 | 4.15 | Astra |
| 数据与事实故事 | 4.14 | 4.01 | Astra |
| 视觉艺术 | 3.94 | 3.91 | Astra |
| 游戏与体育 | 4.15 | 4.12 | Astra |
| 活动与个人表达 | 4.03 | 3.93 | Astra |
| 故事与视觉喜剧 | 4.00 | 3.88 | Astra |
| 建造与制作流程 | 3.97 | 3.94 | Astra |
| 课堂教学 | 4.47 | 4.45 | Astra |
数据来自论文 Appendix E.4,计入未交付视频的零分。
Astra 在 12 类中领先 8 类,差距最大的是数据与事实故事(0.13)和故事与视觉喜剧(0.12);Opus 5.5 在产品展示、音乐驱动和论文解读中领先,音乐驱动的差距为 0.09。音乐类任务对音画对齐要求高,产品展示对规格和细节要求高,这与 Opus 在规格符合率上的优势方向一致。大部分类别的差距在 0.05 分以内,模型选择已出现任务类型差异,但单类差距仍需结合重复测试判断。
2.4 Opus 5.5 为什么仍然有竞争力
人工盲测采用 Bradley–Terry 模型计算 Elo。Astra 为 1242(95% 置信区间 1134–1387),Opus 为 1203(1111–1327),两者排名置信区间都是 1–3,论文给出的比较概率 P=0.69,结论是统计上无法区分。需要注意,人工测试只评价已经交付的视频,无法衡量按时交付能力,而交付恰好是 Opus 的强项。
自检行为解释了这一点。Opus 每次运行平均查看渲染图片 7.9 次、使用 ffprobe 3.9 次;Astra 分别为 3.4 次和 2.1 次。Opus 更频繁地检查自己的输出、发现问题再修复,换来了 100% 的交付率和 99.6% 的规格符合率。Anthropic 将 Opus 5.5 定位为长时间运行的 Agentic Coding 模型,社区也有用户自述用它约 30 分钟完成 iOS 应用宣传片、自动制作 1080×1920 竖屏新闻短视频并附带 SRT 字幕,这些属于个人案例,可作为工作流完整性的旁证。
2.5 视频任务成本:GPT-6 Astra 单价更高,单任务更便宜
| 指标 | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|
| 标准输入价(美元/百万 Token) | 10 | 4 |
| 标准输出价(美元/百万 Token) | 50 | 20 |
| 平均任务成本 | $8.19 | $15.38 |
| 中位任务成本 | $7.88 | $10.19 |
| P90 任务成本 | $11.88 | $31.22 |
| 平均输出 Token | 61K | 130.7K |
| 每项任务 API 调用 | 46 | 51 |
| Cache Hit | 97% | 65% |
Astra 的标准单价是 Opus 5.5 的 2.5 倍,但平均任务成本低约 46.7%。原因有两个:Astra 输出 Token 少约 53.3%;Astra 缓存命中率达到 97%,而 Opus 约 76% 的任务成本来自 Cache Write。P90 成本差距更明显,Opus 在复杂任务上的成本波动更大。论文也指出,单纯增加 Token 消耗并没有带来对应的质量提升。
这组成本是按公开 API 价格折算的等价成本,不含完整商业视频的人工和素材费用。Opus 5.5 官方 Batch API 提供输入输出五折,离线批量制作时成本结构会变化。
💰 成本优化:视频 Agent 的单任务成本受缓存命中和输出长度影响很大,只看单价容易误判。建议在 API易 apiyi.com 上用同一任务分别跑两家模型,按“每条成片的实际消耗”来核算,而不是按标价比较。
3 OpenAI 下一代 GPT 的能力提升信号
3.1 Navier–Stokes 研究:内部模型显著强于 GPT-6 Astra
2026 年 9 月 8 日,OpenAI 发布 Navier–Stokes 千禧年大奖问题研究成果。官方文章写明,所用内部模型能力显著强于 GPT-6 Astra,采用大规模强化学习训练,公告发布时训练仍在继续。
这项研究的执行规模是多智能体能力的直接展示:约 10,000 个 Agent 同时参与,研究耗时约 88 小时,产生 270 万条消息、约 1,300 亿输出 Token;Agent 分组研究不同版本的问题,小组之间交换信息,由 Codex 整合中间成果,系统持续把资源集中到更有希望的路线上。最后的 Lean 形式化验证额外用时 17 小时,使用的是 GPT-6 Astra。
对视频创作而言,这里最相关的是长时程任务调度和多 Agent 协作,而非数学能力本身。一条复杂视频同样需要并行处理脚本、动画、音频,再整合、检查、返工。
3.2 BenchCAD 2.0:工程能力从 0.594 提升到 0.875
2026 年 11 月 3 日,OpenAI 在《Accelerating engineering for the physical world》中公布:一个较新的内部模型在 BenchCAD 2.0 获得 0.875 的平均成绩,GPT-6 Astra 在最高推理强度下为 0.594,相对提升约 47.3%。测试内容包括三维零件重建、机械装配设计和 PCB 连接识别。
这两项证据应分开看待。OpenAI 没有说明 BenchCAD 测试模型与 Navier–Stokes 研究模型是否为同一个,名称和发布时间也均未公布。BenchCAD 是 OpenAI 自己公布的工程测试,属于空间理解与复杂工程知识的进步信号,与视频生成任务没有直接对应关系。
3.3 下一代 GPT 何时发布:截至 11 月 15 日的公开状态
| 日期 | 公开进展 |
|---|---|
| 11 月 2 日 | 据 The National 报道,Altman 在 ADIPEC 表示数学研究使用了一个即将发布的 GPT 模型,约 10,000 个 Agent 协作约四天;报道注明该表述未经独立验证 |
| 11 月 3 日 | OpenAI 公布内部模型 BenchCAD 2.0 数据 |
| 11 月 4 日 | The Information 援引知情人士报道,OpenAI 可能最快 11 月 6 日推出新一代 Astra、Sol 和网络安全模型 |
| 11 月 5 日 | OpenAI API Changelog 确认发布 GPT-6 Cyber,未发布新一代通用 Astra 或 Sol |
| 11 月 15 日 | 官方模型目录的通用旗舰仍为 GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Luna |
网络上流传的 GPT-6.2 Astra、GPT-6.2 Sol 等名称目前没有获得 OpenAI 官方确认。同样要注意,VibeVideoBench 测的是 GPT-6 Astra 和 GPT-5.6 Sol,Astra 的成绩不能直接套用到 GPT-6.1 Sol 或 Terra 上。
4 下一代 GPT 要在视频创作上超越 Opus 5.5,还需要什么
4.1 视频 Agent 的真正瓶颈:时间管理与交付
VibeVideoBench 全部 2,151 次运行中,有 224 次没有交付可播放视频。其中 169 次属于时间管理问题:最终渲染启动太晚、运行过慢或根本没有启动,约占全部失败的 75%。测试环境是 8 核 CPU、32GB 内存、无 GPU 的统一 Docker 容器,渲染本身就要占用可观时间。
这说明模型推理能力提升之后,还要落实到执行节奏上。一个模型把动画写得再精致,如果在第 55 分钟才启动渲染,结果仍是零分。Astra 与 Opus 5.5 在质量上已经难分高下,下一代 GPT 拉开差距的空间主要在交付侧。
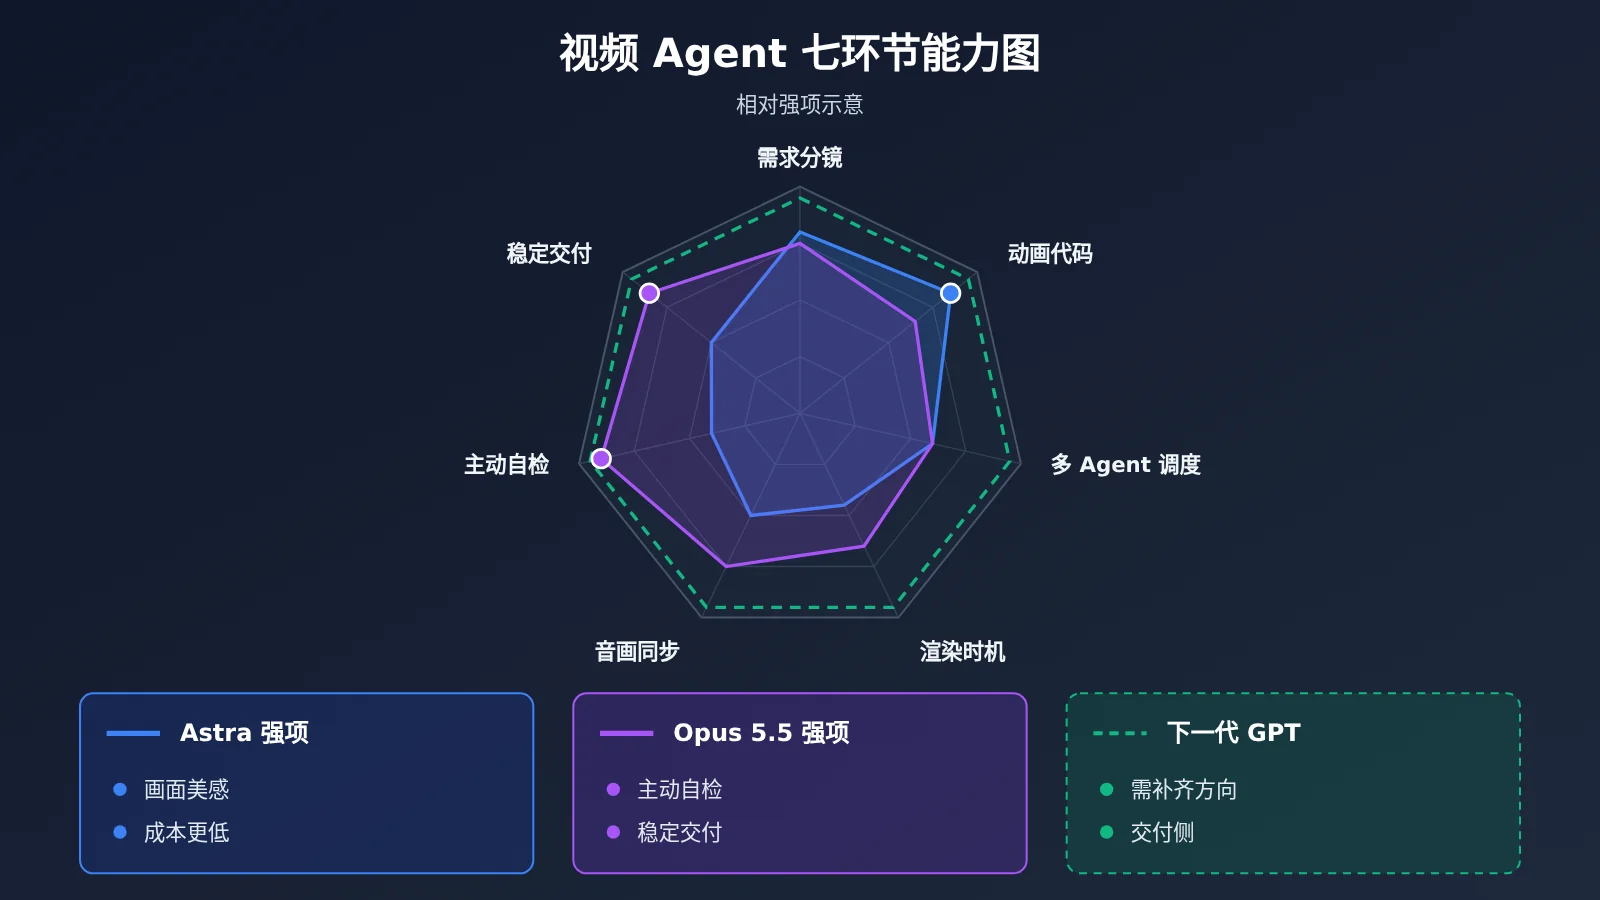
4.2 下一代 GPT 在视频工作流中的七个提升点
结合两者当前的强弱项,下一代模型若要明显超过 Opus 5.5,需要在以下环节同时进步:
- 需求与分镜理解:准确把握主题、受众、风格,把需求拆成镜头顺序和时间轴。
- 复杂动画代码:Remotion、Three.js、Python 动画一次写对,减少返工渲染。
- 多 Agent 调度:把脚本、动画、音频并行化,内部模型在数学研究中展示的编排能力需要迁移到这类工程任务。
- 渲染时机:预留足够渲染时间,避免占失败总数约四分之三的时间管理问题。
- 音画同步:旁白、音效与画面节奏对齐,这是 Opus 在音乐驱动类任务领先的方向。
- 主动自检:Opus 平均看图 7.9 次,Astra 为 3.4 次,自检频率与规格符合率直接相关。
- 稳定交付:完整 MP4 加可编辑工程,规格一次达标。
5 下一代 GPT 发布后,如何验证它是否真的超过 Opus 5.5
5.1 七步对比测试方法
公开榜单只运行一次、限时 60 分钟、以英文任务为主(239 项中 209 项为英文),中文业务场景需要自己复测。以下方法可在新模型发布当天直接复用:
| 步骤 | 做法 | 关注指标 |
|---|---|---|
| 1 固定任务集 | 选 10—20 条真实业务视频需求,覆盖脚本、动画、数据可视化、产品展示 | 任务覆盖度 |
| 2 固定环境 | 统一工具链(Remotion/FFmpeg 版本)、机器配置和时限;Harness 差异单独记录 | 可比性 |
| 3 分环节测试 | 先用 API 单测分镜和动画代码,再在 Agent 环境跑全流程 | 环节得分 |
| 4 记录消耗 | 每次运行的耗时、输入输出 Token、缓存命中 | 单位视频成本 |
| 5 交付检查 | 用 ffprobe 核对分辨率、帧率、时长、音轨 | 交付率、规格符合率 |
| 6 盲测与重复 | 隐去模型名做两两比较,每任务至少跑 3 次 | 偏好胜率、方差 |
| 7 综合打分 | 质量、成功率、修改成本、单位视频成本加权 | 最终选型结论 |
第 3 步把“模型能力”和“Agent 环境能力”分开。VibeVideoBench 测的是完整 Agent 系统,Codex CLI 与 Claude Code 本身也有差异;用同一个 OpenAI 兼容接口直接调用两家模型生成分镜和动画代码,可以先剥离 Harness 的影响,看清模型本身的差距。
5.2 用统一接口做环节级对比的代码示例
下面的极简示例通过同一个 base_url 调用两个模型,生成同一条视频需求的分镜脚本。模型名称请以平台模型列表为准。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 统一接口,一个 Key 调用 GPT 与 Claude
)

prompt = "为一款记账 App 设计 30 秒竖屏宣传片:给出 6 个镜头的分镜、旁白和每个镜头的时长。"
for model in ["gpt-6-astra", "claude-opus-5-5"]:
    r = client.chat.completions.create(model=model, messages=[{"role": "user", "content": prompt}])
    print(model, r.usage.total_tokens, "\n", r.choices[0].message.content[:300])
查看完整的多轮对比测试脚本(记录耗时与 Token)
import time
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 通过 API易 统一调用,便于切换和对比
)

MODELS = ["gpt-6-astra", "claude-opus-5-5"]  # 以平台模型列表为准;新模型发布后直接追加
RUNS = 3  # 每个任务重复运行次数

TASKS = {
    "storyboard": "为一款记账 App 设计 30 秒竖屏宣传片,输出 6 个镜头的分镜、旁白和时长(JSON)。",
    "remotion": "用 Remotion 写一个 10 秒的柱状图增长动画组件,数据为 [12, 30, 45, 80],带标题与数值标签。",
    "data_story": "把“某城市 2020-2025 年新能源车渗透率从 5% 升至 48%”写成 45 秒数据故事视频的脚本和镜头说明。",
}

SYSTEM = "你是视频导演兼前端动画工程师,输出可直接用于代码驱动视频制作的内容。"


def run_once(model: str, prompt: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": SYSTEM},
            {"role": "user", "content": prompt},
        ],
        max_tokens=4000,
    )
    return {
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "output": resp.choices[0].message.content,
    }


results = []
for task_name, prompt in TASKS.items():
    for model in MODELS:
        for i in range(RUNS):
            try:
                rec = run_once(model, prompt)
            except Exception as e:
                rec = {"error": str(e)}
            rec.update({"task": task_name, "model": model, "run": i + 1})
            results.append(rec)
            print(task_name, model, i + 1, rec.get("seconds"), rec.get("completion_tokens"))

# 保存结果,隐去模型名后交给评审做盲测
with open("video_bench_results.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
🚀 快速上手:环节级对比需要同时调用 GPT 与 Claude。通过 API易 apiyi.com 用一个 API Key、OpenAI 兼容接口即可切换两家模型,新用户有免费测试额度,下一代 GPT 上线后把模型名加进
MODELS列表就能复跑同一套任务。
5.3 全流程测试的注意事项
环节测试通过后,再在 Codex CLI 和 Claude Code 中跑完整视频任务,记录交付率和 ffprobe 检查结果。人工盲测只评已交付视频,交付率必须单独统计,否则会重复 VibeVideoBench 人工测试的盲区。每个任务至少重复 3 次,取均值和方差,避免把单次运行的结果当成稳定性能。
6 决策建议:GPT 与 Opus 5.5 的视频场景怎么选
6.1 按场景选择 GPT-6 Astra 或 Opus 5.5
依据 VibeVideoBench 的分类成绩和交付数据,现阶段可以这样分配:
- 优先 GPT-6 Astra:数据与事实故事、概念与流程解释、故事类和游戏类视频;批量生产、对单位成本敏感的场景,平均任务成本 8.19 美元,P90 成本也更可控。
- 优先 Claude Opus 5.5:产品与功能展示、音乐驱动视频、论文解读;对规格和交付有硬性要求的商业交付,如固定分辨率、时长、必须带音轨的投放素材。
- 品牌营销:两者得分同为 4.18,按成本和团队已有工具链决定。
6.2 等待下一代 GPT 还是现在上线
现款两个模型已经能稳定产出可用视频,业务无需等待下一代模型。更实际的做法是用第 5 节的方法建立自己的任务集和基线成绩,新模型发布当天复跑,用数据决定是否切换。
💡 选择建议:两者差距集中在交付稳定性和成本结构上,最终选择取决于你的视频类型和交付要求。建议通过 API易 apiyi.com 用同一批真实任务分别测试,统一接口便于并排比较和后续切换到新模型。
7 最后结论:下一代 GPT 的竞争目标已经不只是追平 Opus 5.5
7.1 GPT 与 Opus 5.5 视频能力核心要点
- 现状:GPT-6 Astra 与 Claude Opus 5.5 在 VibeVideoBench 代码驱动视频任务中同处第一梯队,综合质量 4.109 对 4.074。
- Astra 的优势:视觉美感、多数内容类别得分,以及约低 46.7% 的平均任务成本。
- Opus 5.5 的优势:239/239 全部交付、99.6% 规格符合率、更频繁的自检。
- 人工偏好:1242 对 1203,置信区间重叠,统计上无法区分。
- 下一代信号:内部模型在 BenchCAD 2.0 达到 0.875(Astra 0.594),并展示了万级 Agent 协作能力;名称、发布时间和视频成绩均未公布。
- 真正瓶颈:约 75% 的交付失败源于时间管理,竞争焦点正从生成质量转向执行与交付。
- 验证方式:固定任务、固定环境、多轮盲测、按单位视频成本核算,可在 API易 apiyi.com 上用统一接口完成环节级复测。
7.2 竞争终点是完整生产效率
回到标题:GPT 已经赶上 Opus 5.5,现款 Astra 在质量和成本上略占优势,Opus 5.5 在交付可靠性上保持领先。OpenAI 内部模型展示出更强的通用能力和多 Agent 执行潜力,下一代通用 GPT 有机会进一步提高视频制作能力,具体幅度要等发布后的独立评测和你自己的业务测试来回答。
接下来的竞争会落在完整生产效率上:从理解创意到输出一条可靠、精确、可修改的视频,谁能以更低成本完成更多任务。建议现在就用 API易 apiyi.com 建好自己的视频任务基线,新模型一上线即可直接对比。
参考资料
- VibeVideoBench 官方评测网站:视频 Agent 排行榜与质量分数
- 链接:
vibevideobench.github.io -
说明: 总体榜单与评测设计概览
-
VibeVideoBench 论文:方法论、分类成绩、成本、人工偏好与失败原因
- 链接:
arxiv.org/abs/2610.35864 -
说明: 本文表格数据的主要来源,分类成绩见 Appendix E.4
-
Anthropic Claude Opus 5.5 发布公告:模型定位与官方案例
- 链接:
anthropic.com/claude-opus-5-5 -
说明: Opus 5.5 能力与成本变化的官方描述
-
OpenAI:On the Navier–Stokes Millennium Prize Problem:内部模型与多 Agent 研究
- 链接:
openai.com/index/navier-stokes-solution -
说明: 10,000 并发 Agent、88 小时研究等数据
-
OpenAI:Accelerating engineering for the physical world:BenchCAD 2.0 内部模型成绩
- 链接:
openai.com/index/accelerating-engineering-for-the-physical-world -
说明: 内部模型 0.875 与 GPT-6 Astra 0.594 的对比
-
OpenAI API Changelog 与模型目录:发布进展核实
- 链接:
developers.openai.com/api/docs/changelog、developers.openai.com/api/docs/models -
说明: GPT-6 Cyber 发布记录与当前公开旗舰模型
-
OpenAI API Deprecations:Sora 2 与 Videos API 关停信息
- 链接:
developers.openai.com/api/docs/deprecations - 说明: 原生视频生成路线的现状
作者:API易 技术团队
技术交流:欢迎在 API易 apiyi.com 首页联系我们交流视频 Agent 测试经验,更多接入资料可访问 docs.apiyi.com 文档中心