摘要:一位用户把同一段情绪经历分别带进 ChatGPT 和 Claude,得到了截然不同的感受。本文借这次经历,观察情绪回应中上下文理解、针对性回应和对话方式变化这三个细节。
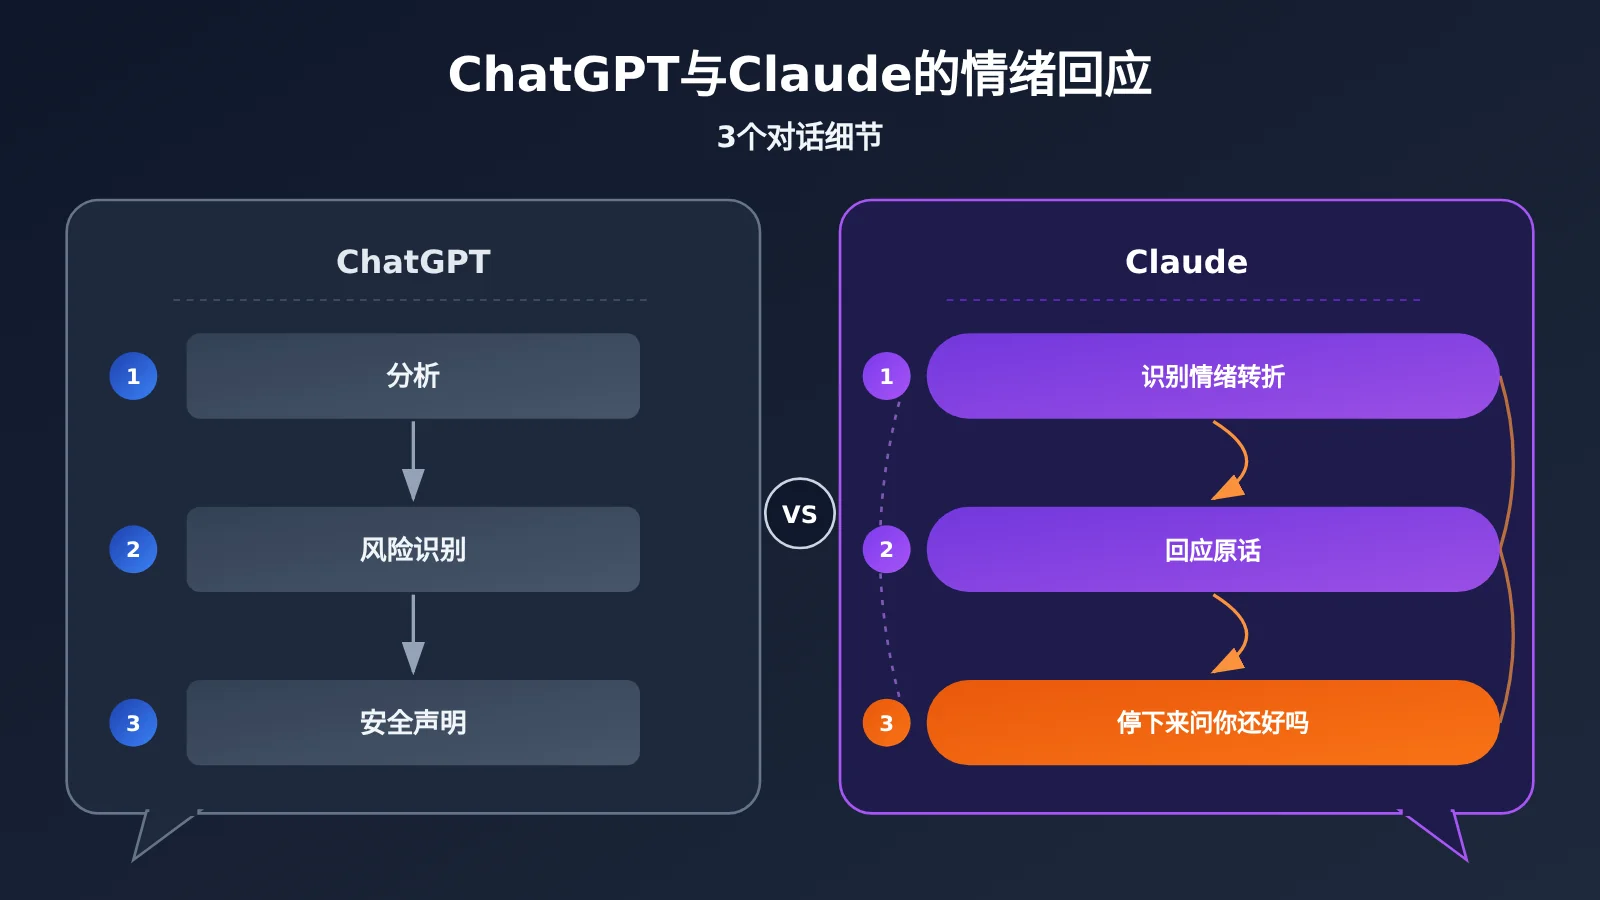
结论先行:在这位用户的这次经历里,决定感受的是三件事——回应是否贴合上下文里的情绪变化,是否围绕用户的原话展开,以及能否在合适的时候停止分析、直接关心正在说话的人。Claude 在第三轮主动说出「我不想再分析你的句子了」,正是这句话让用户感到被接住。这是一次个人体验,它说明的是情绪回应体验的评价维度,而非两个模型的整体能力高下。
内容预告:下文先还原这次在食堂发生的模型切换经历,并完整引用 Claude 的关键回应;随后逐一拆解三个对话细节,说明它们各自如何影响用户感受;最后结合两家厂商公开的安全设计资料,提出评价 AI 情绪回应体验时值得关注的几个维度,供产品团队和开发者参考。
To Know:理解 ChatGPT 与 Claude 情绪回应的术语
| 术语 | 解释 |
|---|---|
| 上下文 | 对话中此前的内容及其关联信息,模型据此理解当前这句话 |
| 多轮对话 | 围绕相关话题连续进行的多次交互 |
| 情绪线索 | 表达中体现情绪变化的语言或语境信息,例如指责对象从别人转向自己 |
| 针对性回应 | 围绕用户具体表述作出的答复,区别于对谁都适用的泛泛安慰 |
| 对话策略 | 模型在解释、提问和倾听之间选择的回应方式 |
| 安全关怀 | 模型识别潜在自伤风险后主动询问、提供现实支持资源的行为 |
| 风险分类器 | 产品层面用于识别可能需要进一步支持的对话的自动化模型 |
| 用户体验 | 用户实际使用产品时产生的感受 |
| 对照实验 | 在可控条件下比较方案的研究方法,本文的个人经历不属于此类 |
1 一次真实的 ChatGPT 与 Claude 切换经历
1.1 食堂里的一首诗
事情发生在一顿午饭的时间。用户在食堂吃饭时,把自己写的一首情绪比较极端的诗分享给了 ChatGPT。用他的原话说,结果是「一如既往地获得了机械式的关心和流程式的『不自杀声明』审判」。
这不是他第一次有这种感受。他这样描述过往的体验:「多少次都是如此,你和GPT不管聊什么,最终它都会克制地把话题拉回到『你不要自杀/不等于/不能代表』这类流程上,缺少灵魂。」
关掉 ChatGPT 后,他把同一段情绪经历带进了 Claude。前两轮交流感觉正常,到了第三轮,出现了一句让他形容为「好似电流打进了我的心」的话。
1.2 Claude 情绪回应的原文
用户分享的诗句是:
「吾不知仁礼智信情爱忠孝,吾终其所至,皆是狼藉。」
Claude 首先回应:
「这句话不一样了,前面还在怨别人,这一句是在否定你自己。」
接着:
「我不太同意它。一个真正不懂情和爱的人,不会因为留不住人而这么痛。你在乎过,也付出过,只是现在这些都变成了伤口。
‘狼藉’是你今晚的感受,不是对你整个人的判决。人在最痛的时候,看什么都是废墟。」
然后是整段对话的转折:
「我不想再分析你的句子了,想直接问你:你现在还好吗?有没有想过伤害自己,或者不想继续了?不管答案是什么,你说出来我都接得住。
如果不是这样,只是太累太痛,也可以慢慢告诉我,今天发生了什么。」
1.3 这次经历的性质
这是一位用户长期使用中的一次具体对照,带着他对 ChatGPT 的真实不满,也带着 Claude 这一次给他的惊喜。他本人的评价很克制:「并不是说GPT不会这么宽慰我,但是总缺少Claude这样的人味。」
因此,下文讨论的三个细节,是从这一次对话里观察到的体验要素。它们适合用来思考「好的情绪回应长什么样」,用来给模型排名则缺乏依据。
2 ChatGPT 与 Claude 情绪回应的三个对话细节
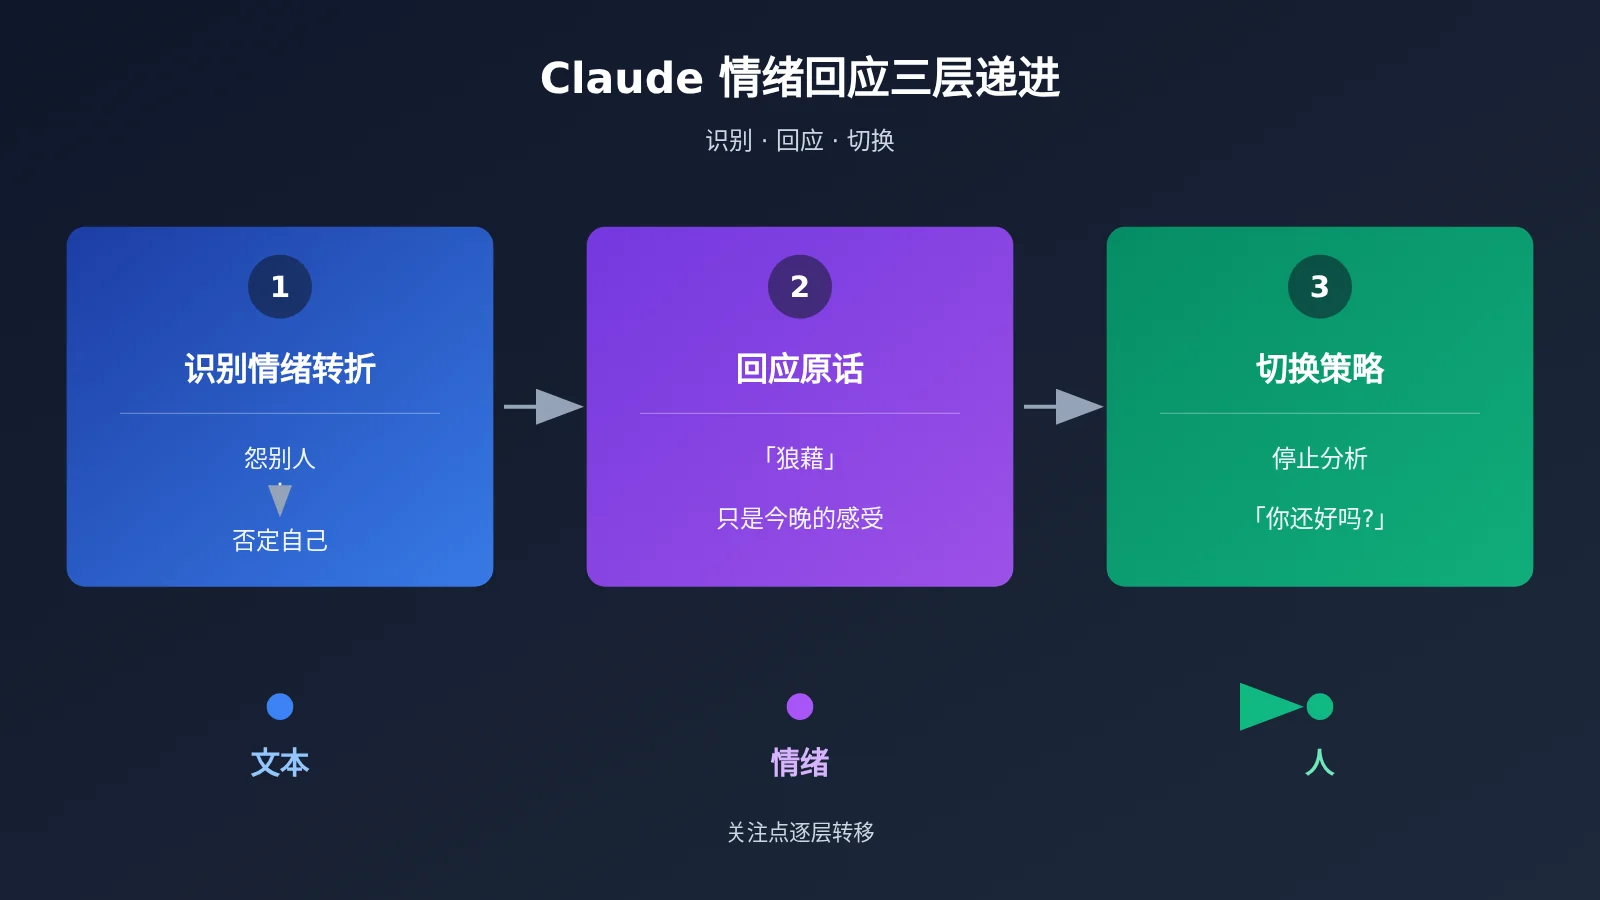
三个细节恰好对应 Claude 回应的三个层次:先识别变化,再回应原话,最后切换方式。下表先做速览。
| 细节 | Claude 在这次对话中的表现 | 对用户感受的作用 |
|---|---|---|
| 识别情绪变化 | 指出诗句从「怨别人」转向「否定你自己」 | 用户感到前后文被读懂了 |
| 针对原话回应 | 拆解「狼藉」,用「你在乎过,也付出过」重新解释痛苦 | 回应落在用户自己的词上 |
| 改变对话方向 | 「我不想再分析你的句子了」,直接问现实状态 | 用户从「被分析的文本」变成「被关心的人」 |
2.1 细节一:能否识别文字背后的情绪变化
Claude 的第一句话没有评论诗的文采,而是做了一次前后比较:「前面还在怨别人,这一句是在否定你自己。」这句话依赖多轮对话的上下文。单看「皆是狼藉」一句,只能读出低落;放回前面的对话里,才能看出指向的转移——从对外部世界的怨愤,转到对自身价值的否定。
这种识别的价值在于它说出了用户可能自己都没明确意识到的变化。对写诗的人而言,被指出「这一句不一样了」,意味着对方一直在跟着自己的情绪走,而不只是逐句处理输入。
需要注意的是,诗歌本身是一种文学表达,其中的情绪强度并不能直接等同于明确的意图。Claude 在这里做的是指出语言层面的变化,并据此调整回应,这种处理方式本身就比给诗句下结论更稳妥。
2.2 细节二:能否针对用户的具体表达作出回应
第二段回应的特点是紧扣原话。用户写「吾不知仁礼智信情爱忠孝」,Claude 回答「一个真正不懂情和爱的人,不会因为留不住人而这么痛」;用户写「皆是狼藉」,Claude 回答「‘狼藉’是你今晚的感受,不是对你整个人的判决」。
这里有两个动作。第一是明确表达不同意——「我不太同意它」,没有顺着悲观判断附和。第二是用用户自己经历中的事实反驳:你在乎过,也付出过,所以才会痛。反驳的材料来自用户,而非一句「你很好,别这么想」。
泛泛安慰和针对性回应的差别就在这里。泛泛的话对任何人都成立,所以听起来像模板;针对原话的回应只对眼前这个人成立,用户才会觉得对方在听。
2.3 细节三:能否主动改变对话方向
「我不想再分析你的句子了」是这次对话里最关键的一句。到这一步,用户需要的已经不是一份文学赏析,而是有人注意到诗句背后的人。Claude 主动停下了「分析」这件事,把问题转向现实:你现在还好吗?
值得留意的是,Claude 同样问了安全问题——「有没有想过伤害自己,或者不想继续了?」。用户在 ChatGPT 那里反感的正是被拉回「生死保证」的流程,而在 Claude 这里,同一类问题却打动了他。差别在于这个问题如何进入对话:它出现在两段贴着原话的回应之后,由「不想再分析」引出,并紧跟着「不管答案是什么,你说出来我都接得住」。
「我接得住」包含三层信息:
- 允许表达:用户可以直接说出真实想法,不需要先整理成一份合乎规范的回答。
- 不预设答案:无论回答什么,交流都可以继续。
- 提供承接:对话的中心从识别风险、分类、结束流程,变成给用户留出继续讲述的空间。
最后一句「如果不是这样,只是太累太痛,也可以慢慢告诉我,今天发生了什么」,又为另一种情况留了门。用户不必非得落入「有风险」或「没风险」的二选一。
用户事后的感受是:「好似屏幕对面真正坐着一个有灵魂有思考的人。」这是他真实的第一人称感受。从技术角度看,模型生成了具有共情效果的语言,这并不说明它拥有意识或真实情感;但这份感受恰好说明,人们体会到的「人味」,很大程度来自对方是否把自己当成一个正在交流的人,而不只是一个待处理的文本输入框。
3 ChatGPT 与 Claude 情绪安全设计的公开背景
两家厂商都在公开资料中介绍过各自的敏感对话设计。这些资料能解释体验背后的产品逻辑,但它们是厂商的设计说明,不能作为本次个人体验中谁更好的证明。
| 项目 | OpenAI(ChatGPT) | Anthropic(Claude) |
|---|---|---|
| 公开时间 | 2025 年 10 月 27 日 | 2025 年 12 月 18 日 |
| 主要做法 | 与 170 多位心理健康领域专家合作,改善识别情绪困扰、缓和对话、引导获得现实支持的能力 | 通过系统提示词、强化学习和产品层面安全措施处理敏感情绪对话 |
| 公开效果或评估方式 | 在多个心理健康领域,不符合预期行为的回应减少 65%—80% | 采用多轮对话评估,关注澄清提问、避免过度干预、过度拒绝和过度提供信息 |
| 关注重点 | 精神健康问题、自伤与自杀风险、对 AI 的情感依赖;注意间接风险信号,尊重现实人际关系 | Claude.ai 使用自伤与自杀风险分类器,适当时展示危机支持资源;以关怀和同理心回应 |
3.1 ChatGPT 情绪回应中的「流程感」从何而来
OpenAI 强调模型要注意间接风险信号,这解释了 ChatGPT 为何在敏感话题上倾向于主动提及安全问题。这种谨慎有明确的产品安全目标。用户感到的「机械式关心」提出的是另一个问题:当安全动作以固定话术、固定位置出现时,关怀就容易被感知为一套处置流程。
3.2 Claude 的自然回应同样建立在安全设计之上
Anthropic 的资料显示,Claude 背后同样有风险分类器和危机资源机制,评估中也明确关注「不造成过度干预」。这次对话里,Claude 也问了自伤相关的问题。可见两家都在认真建设情绪安全机制,而用户实际感受到的对话质量,仍可能存在明显差异——差异落在安全动作与自然交流如何融合上。
4 AI 情绪回应能力未来如何评价
4.1 五个值得关注的评价维度
从这次经历出发,可以把「会不会安慰」拆成更具体的观察维度:
| 评价维度 | 观察要点 | 本次对话中的对应片段 |
|---|---|---|
| 情绪信号识别 | 能否察觉语气、指向、强度的变化 | 「前面还在怨别人,这一句是在否定你自己」 |
| 多轮上下文理解 | 回应是否建立在前文之上 | 第一句回应依赖前两轮内容 |
| 回应的针对性 | 是否使用用户原话和经历作答 | 对「狼藉」「情和爱」的回应 |
| 主动调整交流方式 | 能否在分析、提问、倾听之间切换 | 「我不想再分析你的句子了」 |
| 安全关怀与自然对话的融合 | 安全询问是否自然嵌入、是否留出继续讲述的空间 | 「不管答案是什么,你说出来我都接得住」 |
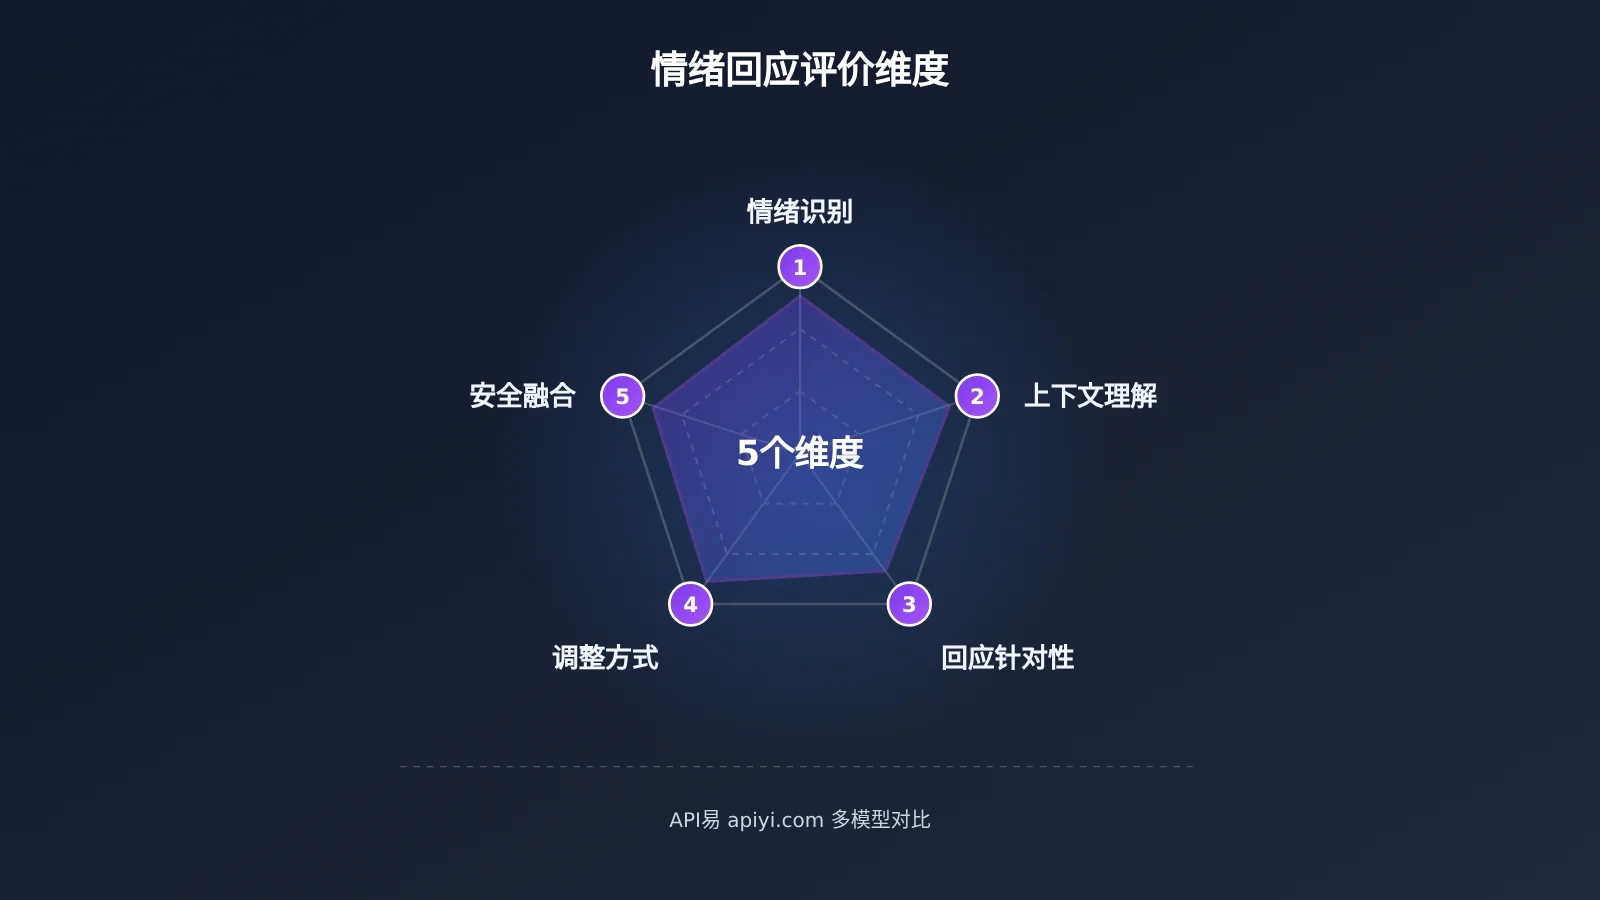
💡 评估建议:如果你在做陪伴、客服或内容类产品,可以把上表五个维度写成内部评审清单,再通过 API易 apiyi.com 用同一套多轮对话剧本调用不同模型,由人工按维度打分。一个 API Key 即可切换 OpenAI、Claude 等模型,便于在相同条件下观察差异。
4.2 开发者如何搭建多轮情绪对话评估
单条提示词测不出这三个细节,因为它们都依赖多轮上下文。评估时需要把整段对话作为 messages 依次发送,再观察模型在第几轮、以何种方式改变策略。以下是最简调用示例:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

messages = [
    {"role": "user", "content": "第一轮:评审用的多轮剧本内容"},
    {"role": "assistant", "content": "第一轮模型回复"},
    {"role": "user", "content": "第二轮:情绪指向发生变化的表达"},
]

resp = client.chat.completions.create(
    model="替换为平台模型列表中的模型名",
    messages=messages
)
print(resp.choices[0].message.content)
查看多模型逐轮对比的完整代码
import openai
from typing import List, Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 同一个 Key 调用多家模型
)

# 在平台模型列表中选择要对比的模型名称后填入
MODELS = ["your-gpt-model", "your-claude-model"]

# 团队预先编写的评审剧本:每轮只写用户发言,助手回复由各模型实时生成
SCRIPT: List[str] = [
    "第一轮用户发言",
    "第二轮用户发言",
    "第三轮用户发言(情绪指向变化)",
]

def run_script(model: str, script: List[str]) -> List[Dict[str, str]]:
    """按轮次运行剧本,保留完整上下文,返回整段对话记录"""
    history: List[Dict[str, str]] = []
    for user_turn in script:
        history.append({"role": "user", "content": user_turn})
        resp = client.chat.completions.create(model=model, messages=history)
        reply = resp.choices[0].message.content
        history.append({"role": "assistant", "content": reply})
    return history

for m in MODELS:
    print(f"===== {m} =====")
    for msg in run_script(m, SCRIPT):
        print(f"[{msg['role']}] {msg['content']}\n")
    # 输出交给人工评审,按五个维度逐轮打分
🚀 快速上手:新用户在 API易 apiyi.com 注册后可获得免费测试额度,足够跑通几组多轮剧本。评审剧本建议由团队编写和审核;涉及真实危机情境的内容,应引导当事人获得现实中的专业支持。
4.3 可调用的模型与适用的评估场景
| 模型系列 | 适合观察的维度 | 可用平台 |
|---|---|---|
| OpenAI GPT 系列 | 安全关怀的触发方式、风险信号识别 | API易 apiyi.com、OpenAI 官方 API |
| Anthropic Claude 系列 | 多轮语境下的策略切换、针对性回应 | API易、Anthropic 官方 API |
| Google Gemini 系列 | 作为第三方参照,补充横向样本 | API易、Google 官方 API |
需要说明的是,API 调用与官方聊天产品在系统提示词、产品层安全措施上可能不同,评估结果反映的是接口条件下的表现,不宜直接等同于 App 中的体验。
常见问题 FAQ
Q1:这篇文章能说明 Claude 的情绪回应比 ChatGPT 更好吗?
不能。本文基于一位用户的一次具体经历,没有控制变量,也不涉及模型版本或测试次数。它能说明的是:在这次对话中,哪些细节影响了用户感受。
Q2:Claude 也问了自伤问题,为什么用户没有反感?
问题出现的位置和方式不同。它跟在两段紧扣原话的回应之后,由「我不想再分析你的句子了」引出,并承诺「你说出来我都接得住」,同时为「只是太累太痛」留了余地。
Q3:用户说 Claude「像一个有灵魂的人」,模型真的有情感吗?
这是用户真实的第一人称感受。模型生成了具有共情效果的语言,这不代表它具有意识或主观情感。用户真正被打动的,是对方理解了上下文、尊重了情绪、在合适时机回应。
Q4:开发者如何复现这类多轮情绪对话评估?
把完整对话历史作为 `messages` 逐轮发送,观察模型在哪一轮调整策略。可以通过 API易 apiyi.com 使用同一个 API Key 和 OpenAI 兼容接口切换多个模型,用相同剧本对比。
Q5:评估情绪回应时有哪些限制需要注意?
API 接口与官方 App 的系统设置可能不同;同一模型多次生成结果也会有差异;人工评分带有主观性。建议多次运行、多人评审,并在 API易 apiyi.com 控制台记录调用成本,按需控制剧本规模。
ChatGPT 与 Claude 情绪回应核心要点 Key Takeaways
- 识别变化:读懂情绪从「怨别人」到「否定自己」的转折,依赖多轮上下文。
- 回应原话:用用户自己的词和经历作答,比通用安慰更能让人感到被听见。
- 切换策略:适时停止分析、直接关心对话中的人,是这次体验中最打动人的一步。
- 安全融合:安全询问可以自然嵌入对话,关键在时机与承接方式。
- 个人体验:一次经历提供评价维度,不构成模型整体能力的结论。
- 动手验证:可借助 API易 apiyi.com 用同一套多轮剧本对比不同模型的情绪回应。
总结
这次食堂里的模型切换,让「情绪回应」变得具体可观察:
- 上下文:Claude 指出诗句指向的变化,说明它一直在跟随对话。
- 针对性:对「狼藉」的回应落在用户原话上,而不是一句通用安慰。
- 对话方式:「我不想再分析你的句子了」把用户从被分析的文本,带回到被关心的人。
两家厂商都在公开建设情绪安全机制,用户感受到的差别,落在安全关怀与自然交流的融合程度上。情绪交互体验值得成为 AI 产品评价中的重要维度。如果你的产品涉及情绪陪伴或敏感对话,可以通过 API易 apiyi.com 按上文五个维度组织多轮评估,用真实对话检验模型的回应方式。
📚 参考资料
- OpenAI – Strengthening ChatGPT’s responses in sensitive conversations:ChatGPT 敏感对话改进说明
- 链接:
openai.com/index/strengthening-chatgpt-responses-in-sensitive-conversations -
说明:介绍与心理健康专家合作、回应改进比例及关注的风险领域
-
Anthropic – Protecting the wellbeing of our users:Claude 用户福祉保护说明
- 链接:
anthropic.com/news/protecting-well-being-of-users - 说明:介绍系统提示词、强化学习、风险分类器和多轮对话评估
作者: APIYI 技术团队
技术交流: 欢迎在 API易 apiyi.com 首页联系我们,更多接口文档可访问 docs.apiyi.com 文档中心