最近有客戶在羣裏問了一個很典型的問題:「我們這種 images2,可以生成電商套圖吧?」答案是可以,但不是一次調用就吐出一整套圖。gpt-image-2 的接口是「一個提示詞對應一次生成」,想要主圖、賣點圖、場景圖、詳情頁這樣內容各不相同的一套圖,需要在調用方式上做一點設計。
本文把 gpt-image-2 電商套圖拆成兩條路線:一條是用一張圖承載多維度信息,適合詳情頁長圖;另一條是先用文本模型拆解需求、生成每張圖的提示詞,再併發調用 gpt-image-2,適合真正意義上的多圖套圖。讀完你會拿到完整的流程設計、可運行的代碼,以及保持整套圖風格統一的幾個關鍵技巧。
gpt-image-2 電商套圖的核心限制:一次調用只對應一個提示詞
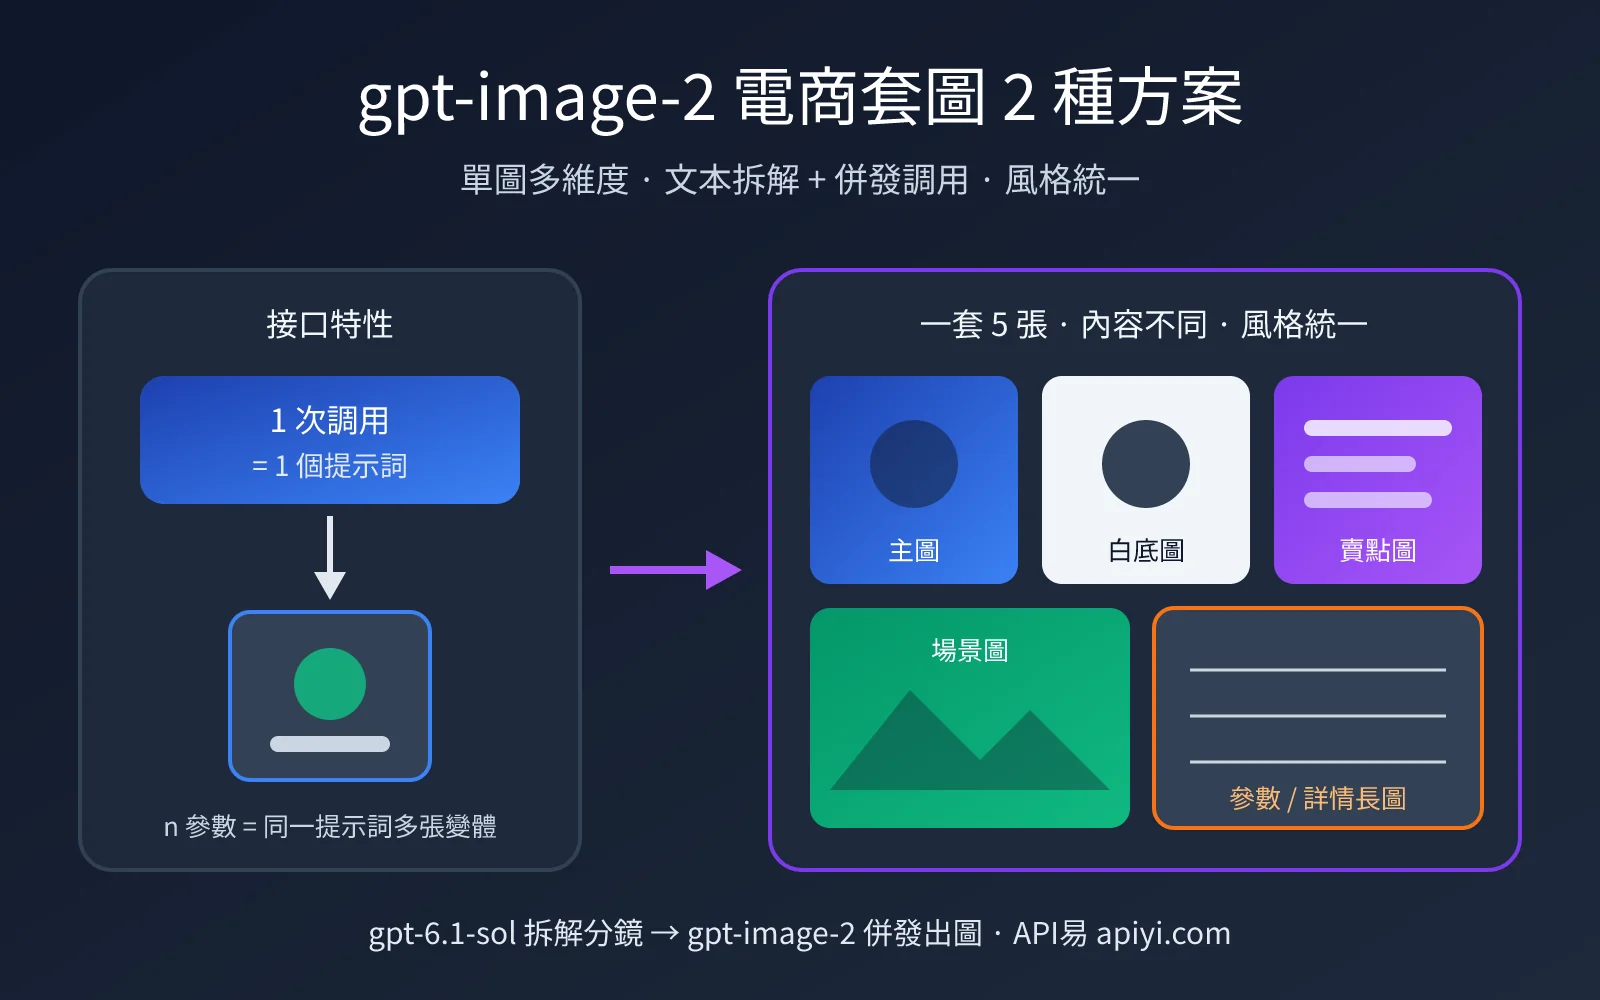
先把接口行爲說清楚,後面的方案設計都建立在這個前提上。gpt-image-2 的 /v1/images/generations 和 /v1/images/edits 每次請求只接受一個 prompt。官方 gpt-image-2 和 2.5 系列都支持 n 參數,API易 也完整支持,但 n 的含義是「同一個提示詞生成 n 張變體」,而不是「n 個提示詞各出 1 張」。
所以 n=5 拿到的是同一畫面的 5 個版本,適合「多出幾張挑一張最好的」,不適合做套圖。電商套圖的本質是多張內容不同、風格統一的圖片:主圖要突出產品,賣點圖要配文案,場景圖要有使用環境,參數圖要有尺寸標註。每張圖的提示詞都不一樣,自然需要多次調用。
gpt-image-2 電商套圖的 3 個真正難點
想清楚限制之後,會發現套圖的難點其實不在「出多張」,而在下面三件事:
- 主體一致:5 張圖裏的產品必須是同一個產品,顏色、Logo、結構不能每張都變樣。
- 風格一致:色調、光線、背景質感、字體風格要像出自同一個設計師之手。
- 信息分工:每張圖承擔不同的營銷任務,不能 5 張都在講同一個賣點。
這三件事決定了套圖不能靠「把一句話丟給模型」解決,需要在調用之前先做規劃。下面這張表是常見電商平臺套圖的標準構成,可以作爲規劃的起點。
| 套圖位置 | 主要用途 | 推薦比例 | 信息密度 | 是否需要文字 |
|---|---|---|---|---|
| 主圖(首圖) | 搜索結果點擊率 | 1:1 | 低,突出產品 | 可選,少量 |
| 白底圖 | 平臺規範、廣告投放 | 1:1 | 極低 | 不需要 |
| 賣點圖 | 傳達 2-3 個核心賣點 | 1:1 或 3:4 | 中 | 需要 |
| 場景圖 | 營造使用氛圍 | 1:1 或 4:5 | 中 | 可選 |
| 尺寸/參數圖 | 降低諮詢和退貨 | 1:1 | 高 | 需要 |
| 詳情頁長圖 | 完整講解產品 | 9:16 或更長 | 很高 | 需要 |
🎯 規劃建議:動手寫代碼前,先按上表確定你的平臺需要幾張圖、每張圖承擔什麼任務。我們建議在 API易 apiyi.com 上用 gpt-image-2 先手動跑 2-3 張單圖,確認產品還原度和文字渲染效果符合預期,再進入批量套圖流程。
方案一:gpt-image-2 單圖承載多維度信息(詳情頁長圖)
第一條路線是「一張圖講完一套話」。gpt-image-2 的中文文字渲染和版面理解能力很強,在一張豎版大圖裏分區排布主視覺、賣點、參數表是完全可行的。對於詳情頁長圖、賣點合集圖、信息圖這類需求,一次調用就能出一張信息量很大的成品。
這條路線最大的好處是天然沒有一致性問題。所有內容都在同一張圖裏由模型一次生成,色調和風格自然統一,也不需要額外的編排代碼。缺點是單圖篇幅有限,內容太多時文字會變小、變擠,而且沒法拆成獨立的主圖去投放。
gpt-image-2 詳情長圖的分區提示詞寫法
單圖多維度的關鍵在於分區描述。不要寫一大段混在一起的描述,而是按從上到下的版面順序,告訴模型每個區域放什麼。下面是一個保溫杯詳情長圖的提示詞結構示例:
豎版 9:16 電商詳情頁長圖,整體風格:簡約北歐風,米白色背景,柔和自然光。
【頂部區域】產品主視覺:一隻啞光墨綠色保溫杯斜 45 度放置,標題文字“24 小時長效保溫”。
【中部區域】三欄賣點,每欄一個線性圖標加短文案:“316 不鏽鋼內膽”“一鍵彈蓋單手開”“500ml 大容量”。
【底部區域】參數表格:容量 500ml、重量 320g、高度 22cm、材質 316 不鏽鋼。
所有文字使用清晰的無襯線中文字體,不要出現多餘文字。
尺寸方面,長圖建議用 9:16 豎版,比如 2K 檔的 1152x2048。如果需要更高清的最終素材,可以用 4K 檔的 2160x3840。
單圖方案只需 1 次調用,成本最低,風格天然統一;代價是信息容量有限,超過 5 個區塊文字就容易擁擠,也無法拆出來單獨作爲搜索主圖投放。它最適合家電、數碼配件、日用品這類參數型標品的詳情頁和賣點合集。
💡 實踐提示:分區超過 5 個時,文字渲染錯誤率會明顯上升。建議把長圖拆成 2-3 張「半屏圖」分別生成,再在詳情頁裏縱向拼接。這些半屏圖本身就是一組小套圖,也就自然過渡到了方案二。
方案二:文本模型拆解 + gpt-image-2 多次調用生成電商套圖
如果你要的是真正的多圖套圖(主圖、賣點圖、場景圖各自獨立),就需要一條小型流水線。思路是把「理解需求、規劃分鏡」交給文本模型,把「出圖」交給 gpt-image-2,兩者用結構化的 JSON 銜接。
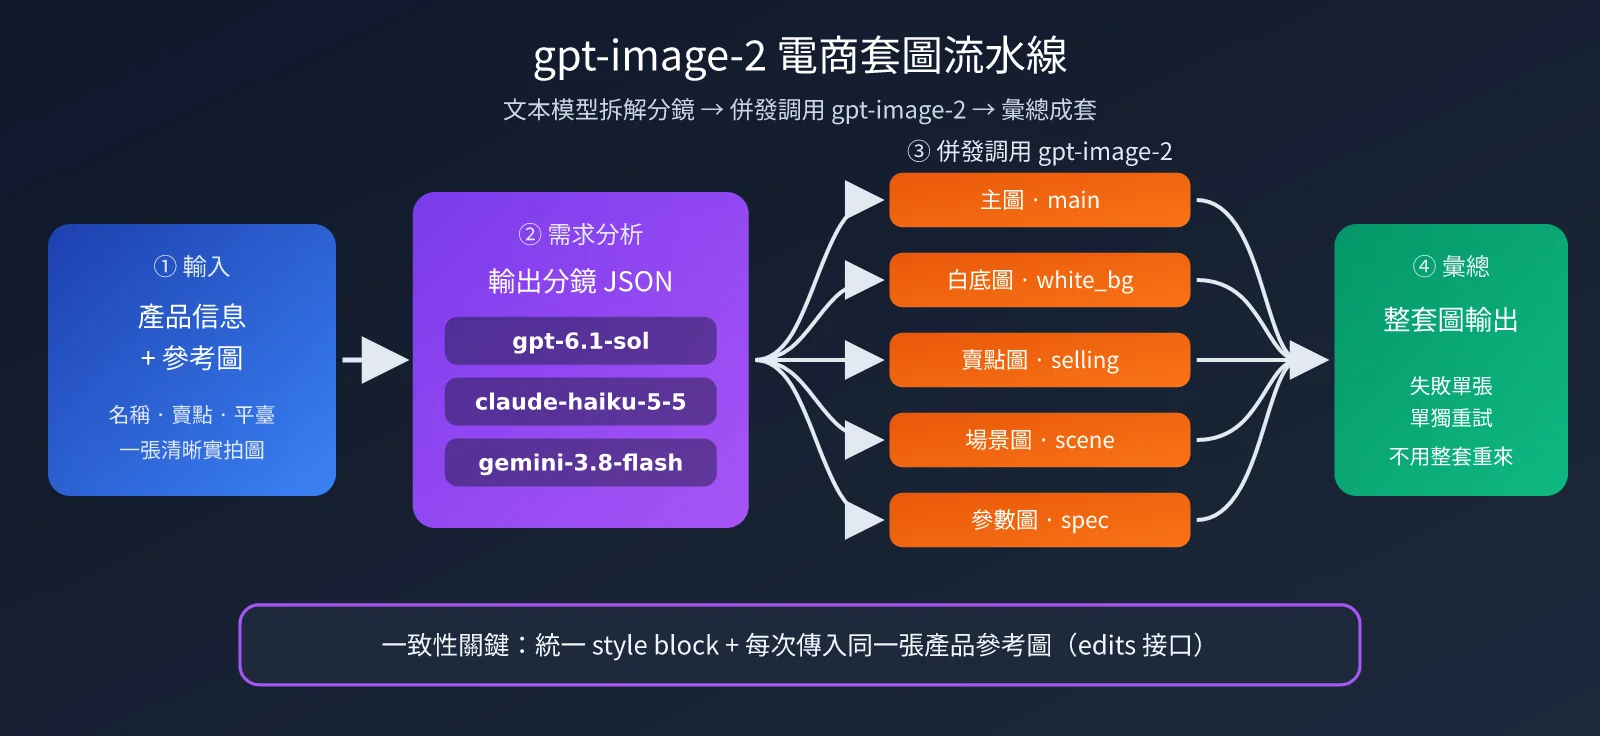
完整流程分 4 步:
- 輸入:商家提供產品名稱、賣點、目標平臺,以及至少一張清晰的產品實拍圖。
- 需求分析:文本模型根據輸入,輸出一個 JSON 數組,每個元素是一張圖的分鏡,包括用途、提示詞、尺寸、文案。
- 併發出圖:程序遍歷分鏡數組,每條分鏡調用一次 gpt-image-2,帶上同一張產品參考圖。
- 彙總校驗:收集所有結果,失敗的單張單獨重試,最後按順序輸出整套圖。
文本模型怎麼選:gpt-image-2 套圖的「大腦」
需求分析這一步對文本模型的要求是:能理解電商營銷邏輯、能穩定輸出 JSON、能寫出畫面感強的提示詞。目前 API易 上的幾款最新模型都能勝任:
| 模型 | 定位 | 適合場景 | 選擇理由 |
|---|---|---|---|
| gpt-6.1-sol | 旗艦推薦 | 高客單價商品、複雜賣點提煉 | 營銷文案和分鏡規劃質量最好 |
| claude-haiku-5-5 | 低價高速 | 批量 SKU、標準化品類 | 指令遵循穩定,JSON 輸出規整 |
| gemini-3.8-flash | 低價高速 | 大批量、多語言跨境商品 | 速度快、成本低,多語言文案自然 |
需求分析每套圖只調用一次,token 消耗很少,成本主要還是在出圖上。我們建議先用 gpt-6.1-sol 把提示詞模板調到滿意,批量跑量時再切換到 claude-haiku-5-5 或 gemini-3.8-flash 降本。三款模型在 API易 apiyi.com 上都走 OpenAI 兼容接口,切換時只需改 model 參數。
gpt-image-2 電商套圖的分鏡 JSON 設計
讓文本模型輸出固定結構的 JSON,是整條流水線穩定運行的關鍵。下面是推薦的字段設計:
| 字段 | 類型 | 說明 | 示例 |
|---|---|---|---|
scene |
string | 套圖位置標識 | main / white_bg / selling |
purpose |
string | 這張圖的營銷任務 | 突出產品外觀,提升點擊率 |
prompt |
string | 給 gpt-image-2 的完整提示詞 | 啞光墨綠保溫杯置於木質桌面… |
size |
string | 輸出尺寸 | 2048x2048 |
text_overlay |
string | 圖中需要渲染的文字 | 24 小時長效保溫 |
gpt-image-2 套圖極簡代碼
下面是最小可運行版本:先讓文本模型生成分鏡,再逐條調用 gpt-image-2 的 edits 接口(帶產品參考圖)。
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "爲墨綠色 316 保溫杯規劃 5 張淘寶套圖,輸出 {\"shots\": [...]},"
               "每項含 scene/purpose/prompt/size/text_overlay,統一風格:北歐簡約、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
這段代碼是串行執行的,5 張圖要依次等待,下一節會改成併發版本。
如何保持 gpt-image-2 電商套圖風格一致
多次調用最容易出的問題,就是 5 張圖看起來像 5 個不同店鋪的。下面幾個技巧組合使用,可以把一致性提升到可商用的水平:
- 統一 style block:把色調、光線、背景、鏡頭語言寫成一段固定文字,拼接在每條分鏡提示詞的末尾。不要讓文本模型每次自由發揮風格描述。
- 固定產品參考圖:每次調用都通過 edits 接口傳入同一張產品實拍圖,並在提示詞裏明確「保持參考圖中產品的顏色、Logo 和結構不變」。這是保證主體一致最有效的手段。
- 固定參數:同一套圖使用相同的
quality檔位,尺寸只在必要時變化(比如長圖用豎版)。 - 用 n 參數做擇優:對主圖這種最關鍵的位置,可以設置
n=2或n=3生成幾個變體,人工挑一張最好的。這正是 n 參數的正確用法。
🎯 一致性建議:style block 是整套圖的「品牌規範」,建議爲每個店鋪沉澱一份固定模板。通過 API易 apiyi.com 調用 gpt-image-2 時,可以把 style block 存在配置文件裏,所有 SKU 共用,換季時統一更新即可。
gpt-image-2 電商套圖併發調用:提速與放量策略
串行生成一套 5 張圖,等待時間是每張圖耗時的總和,圖片越多越慢。由於每張分鏡之間互不依賴,完全可以併發調用,讓整套圖的耗時接近「最慢那一張」的耗時。
API易 對 gpt-image-2 的調用沒有設置併發上限,500 RPM 以下可以直接使用,不需要額外申請。對絕大多數商家來說,即使同時跑幾十個 SKU 的套圖,也遠到不了這個量級。
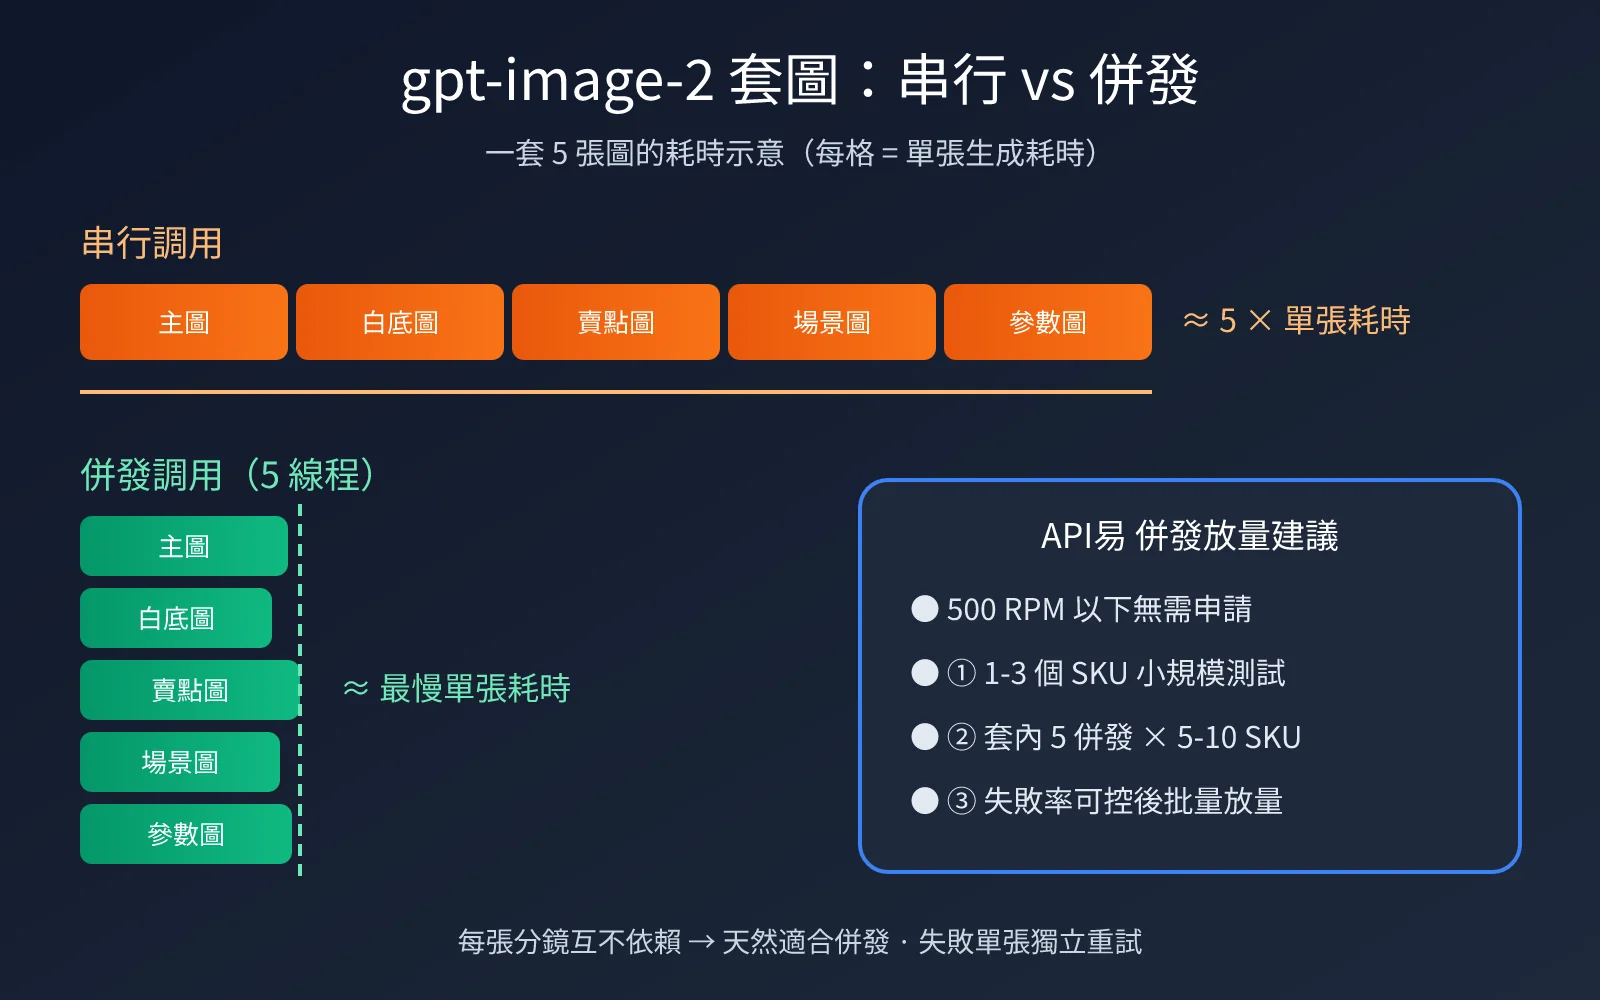
gpt-image-2 套圖併發代碼
把上面的串行循環換成線程池,就能實現併發出圖,同時加入失敗重試,避免一張失敗導致整套重來:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
查看完整版代碼(含 style block、多 SKU 批量、失敗補生成、結果落盤)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整體風格:北歐簡約,米白色背景,柔和自然光,低飽和配色,"
    "保持參考圖中產品的顏色、Logo 和結構完全不變,文字使用清晰無襯線中文字體。"
)

PLAN_PROMPT = """你是資深電商視覺策劃。根據以下商品信息規劃一套 {count} 張的{platform}套圖。
商品信息:{product}
輸出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每張圖承擔不同營銷任務;prompt 只描述畫面內容,不要描述整體風格;
需要文字時把文字原文寫進 prompt 並用引號標出。"""


def plan_shots(product: str, platform: str = "淘寶", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """用文本模型拆解分鏡,批量時可換 claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """單張出圖,失敗指數退避重試"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] 第 {attempt + 1} 次失敗:{e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # 失敗單張補生成一輪
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 成功 {sum(1 for v in results.values() if v)}/{len(shots)} 張")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨綠色 316 不鏽鋼保溫杯,500ml,24 小時保溫,一鍵彈蓋",
        ref_image="cup.png",
    )
併發放量的 3 個階段
雖然沒有併發上限,我們仍然建議按階段放量,先驗證效果再擴大規模,避免一次性跑出幾百張不合格的圖:
- 小規模測試:選 1-3 個 SKU,串行或低併發跑通,人工檢查產品還原度、文字正確率和風格統一度。
- 中等併發:效果穩定後,開到每套圖 5 併發、同時 5-10 個 SKU,觀察失敗率和平均耗時。
- 批量放量:確認失敗率可控後,按業務量繼續提高併發,500 RPM 以內都可以直接跑。
| 調用方式 | 一套 5 張耗時 | 穩定性 | 適用階段 |
|---|---|---|---|
| 串行調用 | 約 5 倍單張耗時 | 最穩,便於調試 | 提示詞調試期 |
| 套內併發(5 線程) | 約等於最慢單張 | 穩定 | 日常上新 |
| 多 SKU + 套內併發 | 與單套接近 | 需配合重試 | 大促批量上新 |
🚀 放量建議:對於大促前集中上新的場景,我們推薦通過 API易 apiyi.com 採用「多 SKU + 套內併發」模式。平臺 500 RPM 以下無需任何申請,配合失敗單張補生成機制,幾十個 SKU 的整套圖可以在很短時間內全部完成。
gpt-image-2 電商套圖方案怎麼選
兩種方案並不互斥,實際業務中經常組合使用。下面按常見平臺和場景給出推薦:
| 平臺/場景 | 推薦方案 | 建議張數 | 說明 |
|---|---|---|---|
| 淘寶/天貓主圖 | 方案二 | 5 張 | 主圖、白底、賣點、場景、參數各一張 |
| 淘寶/拼多多詳情頁 | 方案一 + 方案二 | 3-6 張半屏圖 | 分段生成後縱向拼接 |
| 亞馬遜 Listing | 方案二 | 7 張 | 首圖白底嚴格合規,其餘做賣點和場景 |
| 獨立站商品頁 | 方案二 | 4-6 張 | 場景圖權重更高,突出品牌調性 |
| 小紅書種草 | 方案二 | 3-6 張 | 3:4 豎版,生活化場景爲主 |
| 活動海報/賣點合集 | 方案一 | 1 張 | 單圖信息集中,傳播效率高 |
選擇的核心原則很簡單:需要獨立投放、獨立展示的圖,用方案二;只在一個頁面裏連續閱讀的內容,用方案一。如果拿不準,就先用方案二出主圖和場景圖,再用方案一出一張賣點合集長圖,覆蓋面最廣。
💡 組合建議:兩種方案用的是同一個 gpt-image-2 模型、同一套 API Key。建議把兩套流程封裝成一個服務,按商品類型自動選擇方案,商家只需要上傳一張產品圖和幾行賣點文字即可。
常見問題
gpt-image-2 的 n 參數能直接生成電商套圖嗎?
不能。官方 gpt-image-2 和 2.5 系列都支持 n 參數,API易 也支持,但它是同一個提示詞生成 n 張變體。套圖的每張圖內容不同,需要不同的提示詞,所以要多次調用。n 更適合用在主圖這種關鍵位置做擇優。
生成的多張圖裏產品長得不一樣怎麼辦?
這是套圖最常見的問題。最有效的做法是每次調用都用 edits 接口傳入同一張產品實拍圖,並在提示詞裏寫明「保持參考圖中產品的顏色、Logo 和結構不變」。同時把風格描述固定成 style block,不要讓文本模型自由發揮。參考圖建議用背景乾淨、光線均勻的實拍圖,還原效果最好。
圖中的中文文字渲染錯誤怎麼處理?
gpt-image-2 的中文渲染能力已經很強,但文字越多出錯概率越高。建議每張圖的文字控制在 2-3 個短句以內,在提示詞中用引號標出文字原文。如果某張圖文字出錯,只重新生成這一張即可,不用整套重來。
文本拆解用哪個模型最划算?
調試提示詞模板時用 gpt-6.1-sol,規劃質量最好;模板穩定後批量跑量,可以切換到 claude-haiku-5-5 或 gemini-3.8-flash,成本更低、速度更快。這一步每套圖只調用一次,花費遠低於出圖本身。三款模型在 API易 apiyi.com 上用同一個 API Key 即可調用。
併發調用需要申請額度嗎?
不需要。API易 對 gpt-image-2 沒有設置併發上限,500 RPM 以下直接使用即可。建議先用 1-3 個 SKU 做小規模測試,確認效果後再逐步提高併發放量。
總結
gpt-image-2 生成電商套圖,關鍵在於理解它「一次調用對應一個提示詞」的接口特性。n 參數解決的是擇優問題,套圖需要的是多個不同提示詞的多次調用。在這個前提下,詳情頁、賣點合集這類連續閱讀的內容,可以用單圖多維度方案一次生成;主圖、場景圖這類需要獨立展示的套圖,用文本模型拆解 + 併發調用的流水線批量完成。
兩條路線的共同核心是一致性控制:固定的 style block 加上同一張產品參考圖,是讓多張圖看起來出自同一個設計團隊的關鍵。併發方面,500 RPM 以下可以直接放量,按「小規模測試 → 中等併發 → 批量放量」三步走最穩妥。
我們建議通過 API易 apiyi.com 一站式完成整條流水線:gpt-6.1-sol、claude-haiku-5-5、gemini-3.8-flash 負責需求拆解,gpt-image-2 負責出圖,一個 API Key 打通全部環節,可以快速搭建自己的電商套圖生成服務。
作者: APIYI Team | 專注 AI 大模型 API 技術分享,更多模型接入教程歡迎訪問 API易 apiyi.com