Gemini 4 Argon 有了新進展:繼 9 月 30 日官宣、先向 Fairwind 計劃網絡防禦方開放之後,Gemini 4 Argon 已經可以在 Vertex AI 中拉取到模型,Google Cloud 側的放量正式開始。對大多數開發者來說,接下來最現實的問題就是:Gemini 4 Argon 的價格到底怎麼算,接入後每個月要花多少錢?
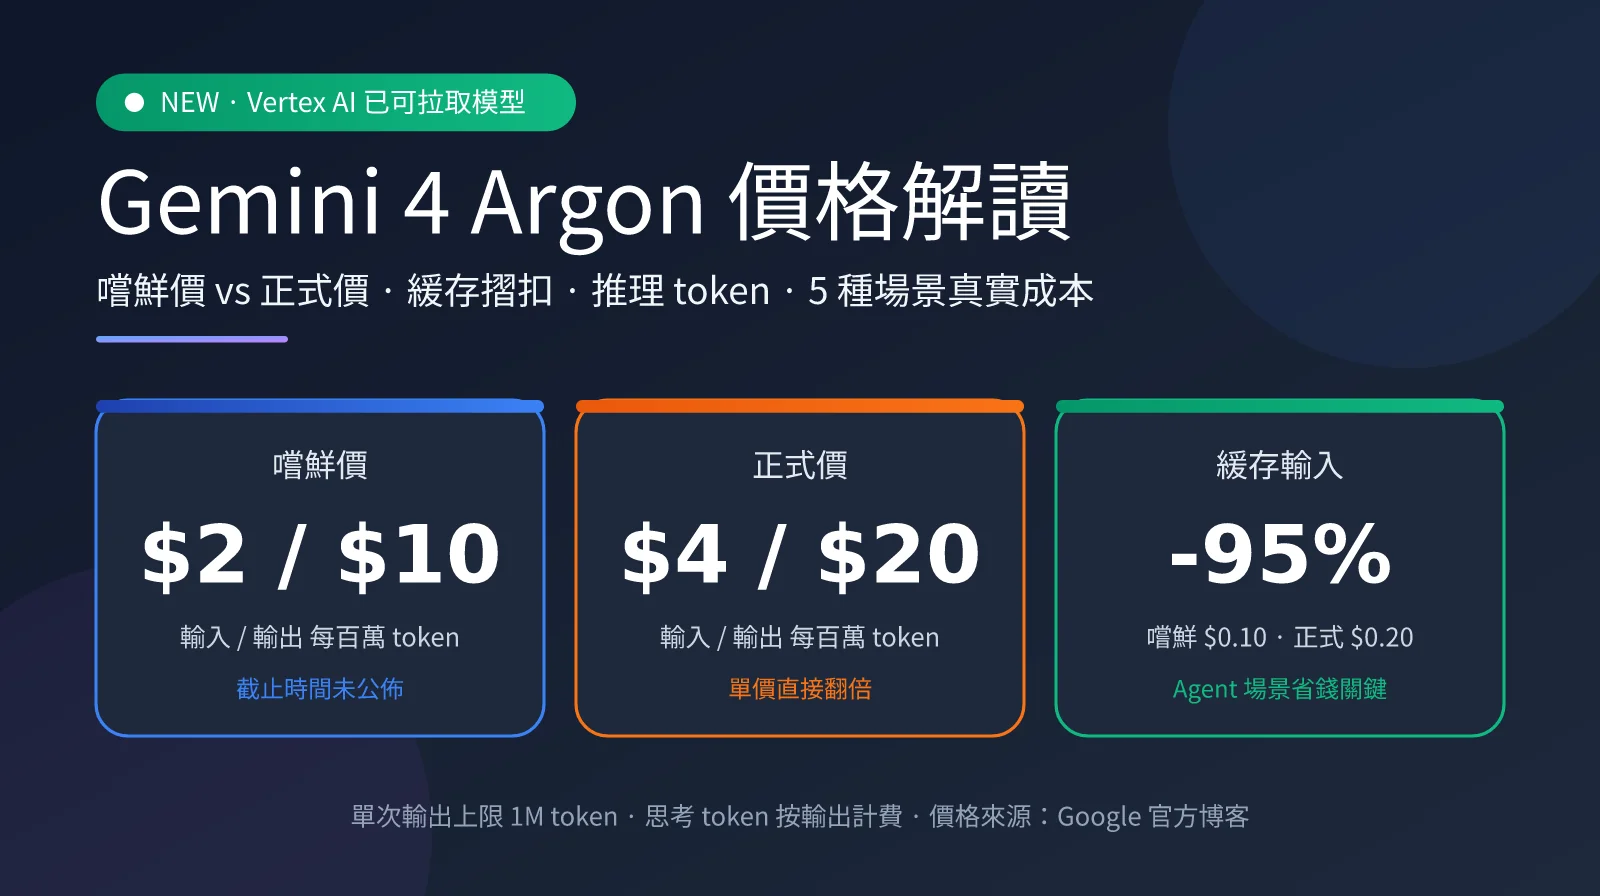
表面上看,Argon 的定價很簡單:嚐鮮價輸入 $2、輸出 $10 每百萬 token,正式價翻倍到 $4/$20,緩存輸入打 95% 折。但這張價目表背後還藏着幾個變量:推理 token 怎麼計費、1M 輸出上限會不會讓單次請求成本失控、Argon 的 token 消耗量比競品高出多少。本文結合 Google 官方博文與多家英文媒體、第三方評測機構的公開數據,逐項拆解 Gemini 4 Argon 價格,並給出 5 種典型場景的成本測算。
核心價值:讀完本文,你能算清 Gemini 4 Argon 在自己業務中的真實單任務成本,知道嚐鮮期結束後賬單會怎麼變,以及如何用緩存和輸出上限把成本壓下來。
Gemini 4 Argon 價格一覽
先把 Google 官方公佈的價格信息整理成一張表。需要特別注意的是,Google 只公佈了嚐鮮價和正式價兩檔,沒有說明嚐鮮期持續多久,也沒有公佈批量(Batch)、Flex、長上下文分檔和緩存存儲費等細項。
| 計費項 | 嚐鮮價(每百萬 token) | 正式價(每百萬 token) | 說明 |
|---|---|---|---|
| 輸入 | $2.00 | $4.00 | 嚐鮮期時長未公佈 |
| 輸出 | $10.00 | $20.00 | 推理 token 計費方式官方未單獨說明 |
| 緩存輸入 | $0.10 | $0.20 | 輸入價打 95% 折,正式價檔位按同一折扣推算 |
| 單次輸出上限 | 1M token | 1M token | 此前 Gemini 模型爲 64K |
| Batch / Flex | 未公佈 | 未公佈 | 現有 Gemini 型號通常有批量折扣 |
| 長上下文分檔 | 未公佈 | 未公佈 | 輸入上下文窗口官方亦未公佈 |
Gemini 4 Argon 價格的三個關鍵細節
第一個細節是推理 token。Google 沒有單獨說明 Argon 的思考 token 怎麼計費,但當前 Gemini 系列的慣例是思考 token 按輸出價格計費。做預算時最穩妥的做法是假設 Argon 沿用這一規則,也就是所有思考過程都按 $10(嚐鮮)或 $20(正式)每百萬 token 計入賬單。
第二個細節是緩存摺扣。95% 的緩存摺扣意味着嚐鮮期緩存輸入只要 $0.10 每百萬 token。對於 Agent 類工作流,每一輪對話都要重複發送系統提示詞、工具定義和代碼庫上下文,緩存命中率往往能做到 70% 以上,這個折扣對總賬單的影響可能比 $2 的標價還大。
第三個細節是嚐鮮期的不確定性。嚐鮮期結束後所有單價直接翻倍,而 Google 沒有給出截止時間。這意味着你基於嚐鮮價做的 ROI 測算,最好同時準備一份正式價版本,避免某天賬單突然翻倍。
🎯 預算建議:Gemini 4 Argon 的價格變量較多,建議先用小流量跑出真實的 token 消耗分佈,再決定是否大規模切換。通過 API易 apiyi.com 平臺可以在統一接口下同時調用 Gemini、GPT、Claude 等多個系列模型,方便用同一批任務對比真實成本。
Gemini 4 Argon Vertex AI 上線最新動態
Argon 的開放節奏一直是開發者最關心的問題。按照 Google 博文的規劃,Argon 先面向 Fairwind 計劃的可信網絡防禦方和 Google 內部,然後是付費 API 客戶和 Google AI Ultra 訂閱用戶,最後纔是更廣泛的開發者、企業和消費者。下表梳理了從官宣到 Vertex AI 可拉取的時間線。
| 時間 | 事件 | 信息來源 |
|---|---|---|
| 9 月 3 日 | Fairwind 計劃啓動,首發模型爲 Gemini 3.8 Flash Cyber | Google 官方博客 |
| 9 月 30 日 | Gemini 4 Argon 官宣,向 Fairwind 成員推送 | Google 官方博客 |
| 9 月 30 日 | DataCamp 檢查:Vertex AI、Gemini CLI 等均未上架 | DataCamp |
| 10 月 7-8 日 | 社區在 Vertex AI 發現 gemini-4-argon-cyber-permissive 條目 |
社區與科技媒體 |
| 10 月中旬 | Vertex AI 中已可拉取 Gemini 4 Argon 模型 | 最新動態 |
社區最早發現的 gemini-4-argon-cyber-permissive 這個 ID 很有意思。“cyber-permissive”暗示這是面向網絡防禦方、放寬網絡安全護欄的版本,這和 Google 博文中“對可信防禦方不加網絡安全護欄”的描述一致。面向普通付費客戶的版本大概率會使用不同的 ID,並保留完整的安全防護。因此在接入時,請以你自己的 Google Cloud 控制檯 Model Garden 中實際顯示的模型 ID 爲準,不要直接照搬網上流傳的名稱。
Gemini 4 Argon 在 Vertex AI 的價格與平臺變化
有社區消息稱,Vertex AI 中展示的 Argon 全球價格爲輸入 $4、輸出 $20 每百萬 token,也就是 Google 博文中的正式價檔位。這一點值得重視:如果企業通過 Vertex AI 接入時直接按正式價計費,那麼基於 $2/$10 嚐鮮價做的測算都需要乘以 2。嚐鮮價究竟適用於哪些渠道,Google 目前沒有明確說明,接入前請以控制檯賬單頁的實際單價爲準。
另一個容易被忽視的變化是平臺本身。Google 在 2026 年 4 月的 Cloud Next 大會上把 Vertex AI 的服務整合進了 Gemini Enterprise Agent Platform,舊版 Vertex AI 文檔已經標註不再更新。現有端點繼續可用,但 Argon 這類新模型的文檔和新功能會優先出現在 Agent Platform 一側。此外,Gemini 2.5 Pro、2.5 Flash 和 2.5 Flash-Lite 將於 10 月 16 日退役,還在使用這些型號的團隊正好可以借這次機會統一完成遷移。
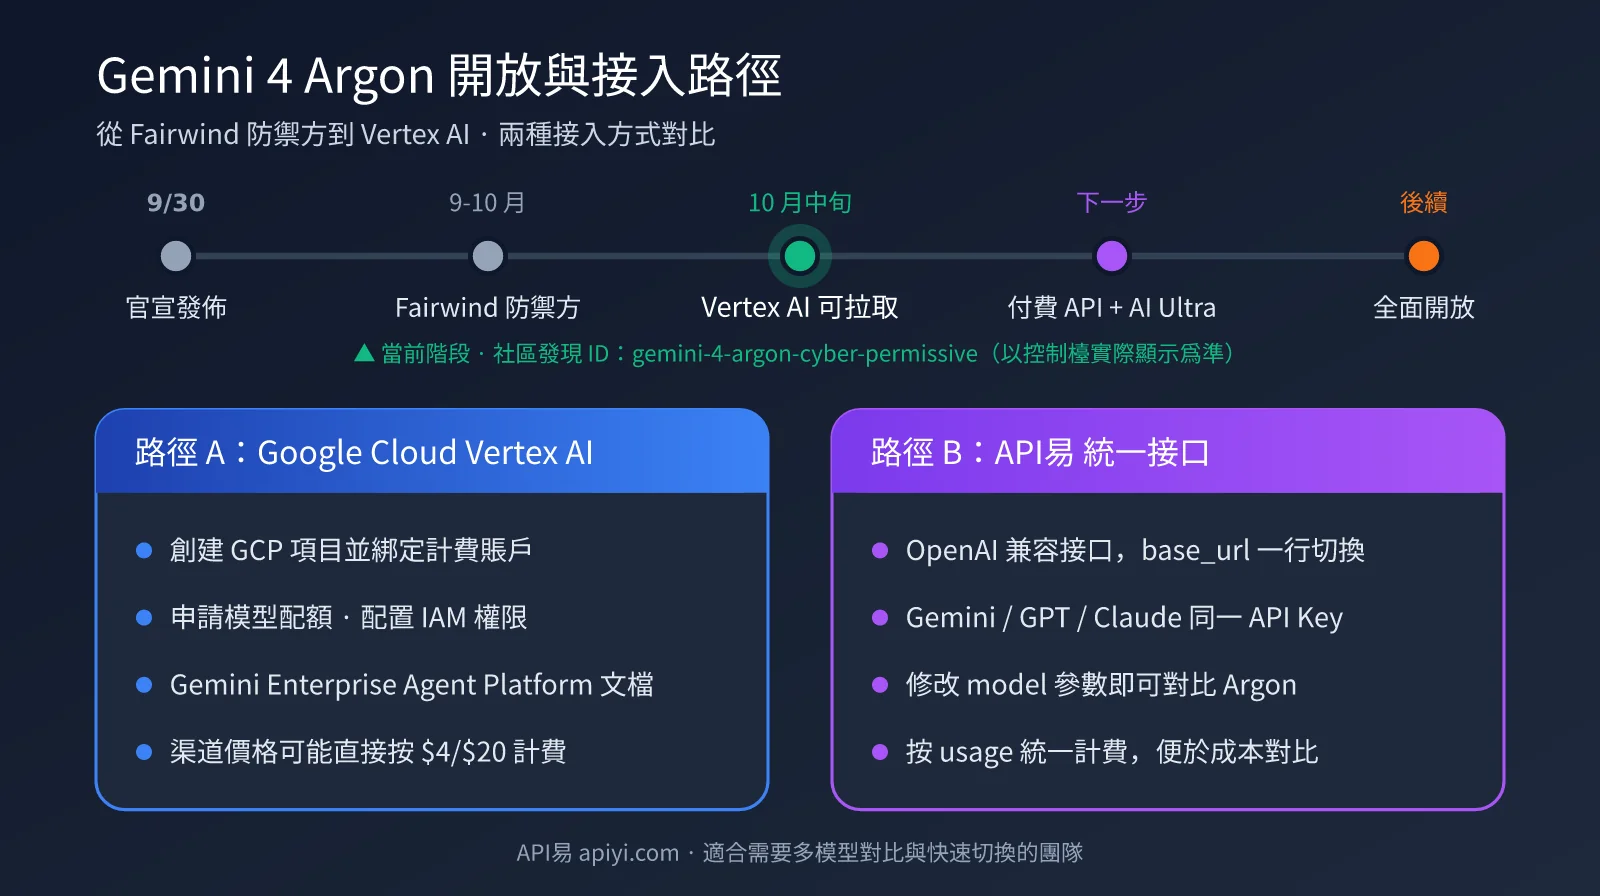
🚀 接入建議:直接走 Vertex AI 需要 GCP 項目、計費賬戶、配額申請和 IAM 配置,對中小團隊門檻不低。我們建議通過 API易 apiyi.com 平臺的 OpenAI 兼容接口統一接入 Gemini 系列模型,只需修改 model 參數就能在 Argon 和其他模型之間切換。
Gemini 4 Argon 價格對比:同門與競品
只看單價很難判斷 Argon 貴不貴,需要放到同門的 Gemini 3.8 Flash 和競品旗艦模型中一起比較。下表爲各模型的標價,其中競品價格來自第三方整理,以各廠商官方頁面爲準。
| 模型 | 輸入 / 百萬 token | 輸出 / 百萬 token | 單次輸出上限 | 定位 |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | 日常主力,高性價比 |
| Gemini 4 Argon(嚐鮮) | $2.00 | $10.00 | 1M | 長鏈路推理旗艦 |
| Gemini 4 Argon(正式) | $4.00 | $20.00 | 1M | 長鏈路推理旗艦 |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | 競品旗艦 |
| GPT-6 Astra | $10.00 | $50.00 | 128K | 競品旗艦 |
從單價看,Argon 嚐鮮價約爲 Gemini 3.8 Flash 的 2.7 倍,正式價與 Claude Opus 5.5 持平,只有 GPT-6 Astra 的 40%。但單價只是一半,另一半是完成同樣任務要消耗多少 token,這正是 Argon 定價最需要警惕的地方。
Gemini 4 Argon 單任務成本:token 消耗纔是關鍵
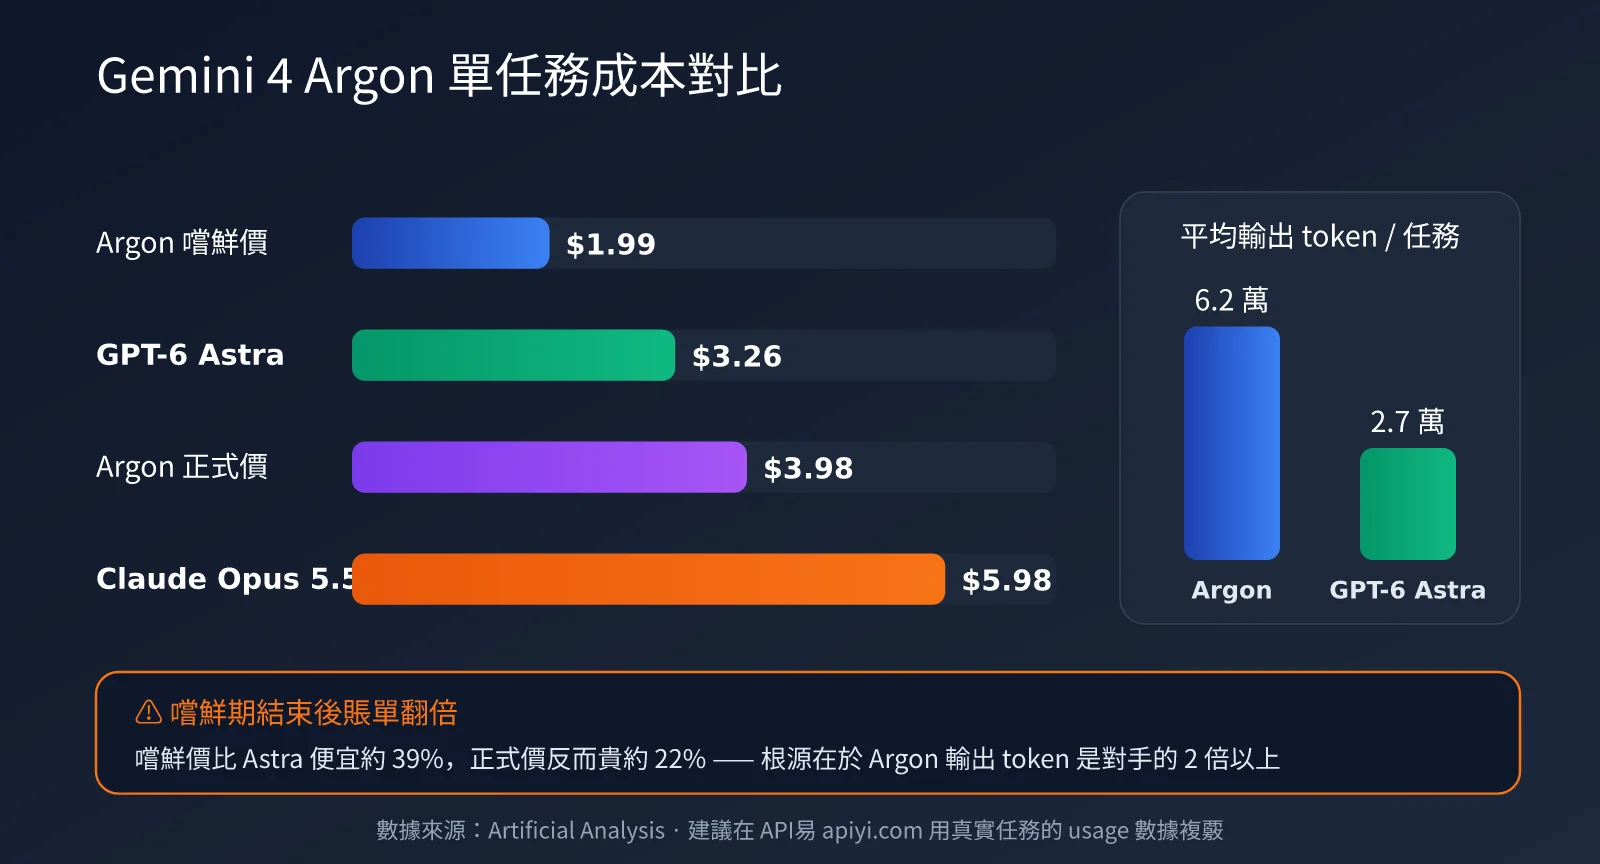
第三方評測機構給出的單任務成本,比單價更能說明問題。Artificial Analysis 的數據顯示,Argon 在智能指數測試中平均每個任務生成約 6.2 萬個輸出 token,而得分相同的 GPT-6 Astra 只用了約 2.7 萬個,Argon 的“話量”是對手的兩倍多。
| 評測口徑 | Gemini 4 Argon | 對比模型 | 結論 |
|---|---|---|---|
| AA 單任務成本(嚐鮮價) | $1.99 | GPT-6 Astra $3.26 | 嚐鮮期比 Astra 便宜約 39% |
| AA 單任務成本(正式價) | $3.98 | GPT-6 Astra $3.26 | 正式價反而比 Astra 貴約 22% |
| AA 單任務成本 | $1.99 | Claude Opus 5.5 $5.98 | 約爲 Opus 5.5 的三分之一 |
| Vals 單次測試成本 | $15.68 | Opus 5.5 $32.14 / Sonnet 5.5 $21.34 | 該工作負載下成本最低 |
| 平均輸出 token / 任務 | 約 6.2 萬 | GPT-6 Astra 約 2.7 萬 | Argon 推理過程明顯更長 |
這張表揭示了 Gemini 4 Argon 價格最關鍵的一點:嚐鮮期 Argon 的性價比很高,但嚐鮮期結束後,在部分工作負載上它可能比單價更高的 GPT-6 Astra 還貴。原因就在於輸出 token 消耗量。不過 Vals 的測試又顯示 Argon 在另一類工作負載上成本最低,說明結論高度依賴具體任務,必須用自己的數據來測算。
💡 選型提示:單價低不等於賬單低。建議在 API易 apiyi.com 平臺用同一批真實任務分別調用 Argon 和其他旗艦模型,記錄每次請求的 usage 字段,用實際 token 消耗而不是標價來決定路由策略。
Gemini 4 Argon 真實成本測算:5 種典型場景
下面用 Google 公佈的單價,按嚐鮮價和正式價分別測算 5 種典型場景的單次請求成本。思考 token 統一計入輸出。
| 場景 | 輸入 token | 輸出 token | 嚐鮮價成本 | 正式價成本 |
|---|---|---|---|---|
| 日常問答 | 2 萬 | 5000 | $0.09 | $0.18 |
| 長文檔分析 | 20 萬 | 5 萬 | $0.90 | $1.80 |
| Agent 編程(80% 緩存命中) | 60 萬 | 6.2 萬 | $0.91 | $1.82 |
| 大型代碼遷移 | 30 萬 | 40 萬 | $4.60 | $9.20 |
| 滿額 1M 輸出 | 忽略不計 | 100 萬 | $10.00 | $20.00 |
以 Agent 編程場景爲例:60 萬輸入中 48 萬命中緩存,按 $0.10 計費僅 $0.048;其餘 12 萬按 $2 計費爲 $0.24;6.2 萬輸出按 $10 計費爲 $0.62,合計約 $0.91。可以看到,在緩存充分的情況下,輸出 token 佔了總成本的近七成,控制輸出長度比壓低輸入更重要。
大型代碼遷移和滿額 1M 輸出這兩個場景最需要警惕。1M 輸出上限是 Argon 的核心賣點,但一次滿額輸出在正式價下就是 $20。如果客戶端超時設置不合理導致請求失敗後自動重試,成本會直接翻倍。對於每天要跑上百次長任務的團隊,這類隱性成本很容易讓月度賬單失控。
Gemini 4 Argon 隱性成本清單
結合以上測算,接入 Argon 時需要重點防範以下幾類隱性成本:
- 推理 token 膨脹:Argon 平均輸出 token 是 GPT-6 Astra 的兩倍以上,按輸出價計費的思考過程會顯著推高單任務成本。
- 超長輸出與重試:1M 輸出上限下,客戶端、負載均衡的超時設置不當會導致長請求失敗重試,成本成倍增加。
- 緩存未命中:提示詞結構不合理會讓緩存命中率很低,白白損失 95% 的折扣。
- 嚐鮮期結束:所有單價翻倍,且沒有明確截止日期。
- 渠道價格差異:Vertex AI 展示價格可能直接是正式價,與嚐鮮價測算存在 2 倍差距。
Gemini 4 Argon 省錢接入實踐
針對上面的隱性成本,最有效的三個手段是:給每個請求設置明確的輸出上限、把穩定內容放在提示詞前部以提高緩存命中率、按任務難度做模型路由。下面的示例採用 OpenAI 兼容接口,模型 ID 通過環境變量配置。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

# 模型 ID 以平臺或 Vertex AI 控制檯實際顯示爲準
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 顯式設置輸出上限,避免默認放開到 1M
    messages=[{"role": "user", "content": "分析這段代碼的併發安全問題"}],
)
u = resp.usage
print(f"輸入 {u.prompt_tokens} / 輸出 {u.completion_tokens} token")
查看完整代碼:按難度路由 + 成本記錄
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型與單價全部配置化,嚐鮮期結束後只需改環境變量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 穩定前綴放在最前面,提升緩存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """簡單示例:長任務、遷移、審計類任務走 Argon,其餘走 Flash"""
    keywords = ("遷移", "重構", "審計", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 長輸出任務放寬超時,避免失敗重試導致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未計緩存摺扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目錄下的 C 模塊遷移爲 Rust,並保持接口一致"))
這段代碼體現了三個省錢原則。一是 max_tokens 顯式設置,不要依賴模型默認的超大輸出上限;二是 系統提示詞作爲穩定前綴放在最前面,讓多輪請求儘量命中緩存;三是 按難度路由,把簡單任務留給單價只有 Argon 約三分之一的 Gemini 3.8 Flash,只把長鏈路、高難度任務交給 Argon。
建議:可以先在 API易 apiyi.com 獲取測試額度,用上面的路由腳本跑一週真實流量,再根據 usage 日誌調整路由閾值和輸出上限。
常見問題
Q1:Gemini 4 Argon 現在的價格是 $2/$10 還是 $4/$20?
Google 官方公佈的嚐鮮價是 $2/$10,正式價是 $4/$20,但沒有說明嚐鮮期持續多久,也沒有說明不同渠道是否統一執行嚐鮮價。有社區消息稱 Vertex AI 展示的是 $4/$20 正式價。建議以你實際接入渠道的賬單單價爲準,並同時按兩檔價格做預算。
Q2:Vertex AI 上的 gemini-4-argon-cyber-permissive 能直接用嗎?
這個 ID 從名稱看是面向網絡防禦方、放寬網絡安全護欄的版本,對應 Fairwind 計劃的訪問權限,普通項目通常沒有調用權限。普通付費客戶應以自己控制檯 Model Garden 中顯示的模型 ID 爲準。如果不想處理 GCP 項目、配額和權限配置,也可以通過 API易 apiyi.com 等聚合平臺統一調用 Gemini 系列模型。
Q3:Argon 的思考 token 要額外收費嗎?
Google 尚未單獨說明,但現有 Gemini 模型的思考 token 按輸出價計費,建議按同一規則預算。由於 Argon 平均輸出 token 偏多,思考 token 往往是成本的主要來源,可以通過限制 max_tokens 和調整推理強度來控制。
Q4:什麼場景值得爲 Gemini 4 Argon 付費?
大規模代碼遷移、長文檔專業分析、法律金融類 Agent 和安全審計等長鏈路任務,最能體現 Argon 的能力優勢,值得付費。日常問答、簡單代碼補全和高併發輕量任務,用 Gemini 3.8 Flash 等低價模型通常更划算。最穩妥的做法是在 API易 apiyi.com 平臺上用真實任務做 A/B 對比,再決定路由比例。
總結
Gemini 4 Argon 的價格可以概括爲“標價友好、變量很多”。嚐鮮價 $2/$10 在旗艦模型中很有競爭力,95% 的緩存摺扣對 Agent 場景尤其友好;但推理 token 消耗偏高、嚐鮮期結束後單價翻倍、Vertex AI 渠道可能直接執行正式價,這三點都會讓真實賬單與標價預期出現明顯偏差。
隨着 Gemini 4 Argon 已經可以在 Vertex AI 中拉取,接下來的關鍵不是搶先全量切換,而是先用真實流量測出 token 消耗分佈,再通過輸出上限、緩存前綴和難度路由把成本控制住。建議把 Argon 定位爲“難題專用”的旗艦模型,與 Flash 級模型搭配使用。
我們建議通過 API易 apiyi.com 平臺統一接入 Gemini 系列模型,在同一接口下完成 Argon 與其他模型的成本和效果對比,用數據而不是標價來決定模型策略。
參考資料:
- Google 官方博客 Gemini 4 Argon 發佈文章: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Google Fairwind Program 介紹頁: deepmind.google/fairwind-program
- DataCamp Gemini 4 Argon 基準與定價整理: datacamp.com/blog/gemini-4-argon
- Artificial Analysis 模型成本與智能指數: artificialanalysis.ai
- Vals AI 模型評測與成本數據: vals.ai
作者:APIYI Team | 持續追蹤大模型價格與接入動態,更多 AI 模型接入資訊請訪問 API易 apiyi.com