作者注:gpt-image-2.6-all 的 2K/4K 是超分檔,響應可能不回顯 size,實際像素也會偶發偏差。本文講清原因,並給出保存圖片後讀取真實寬高再排版的做法。
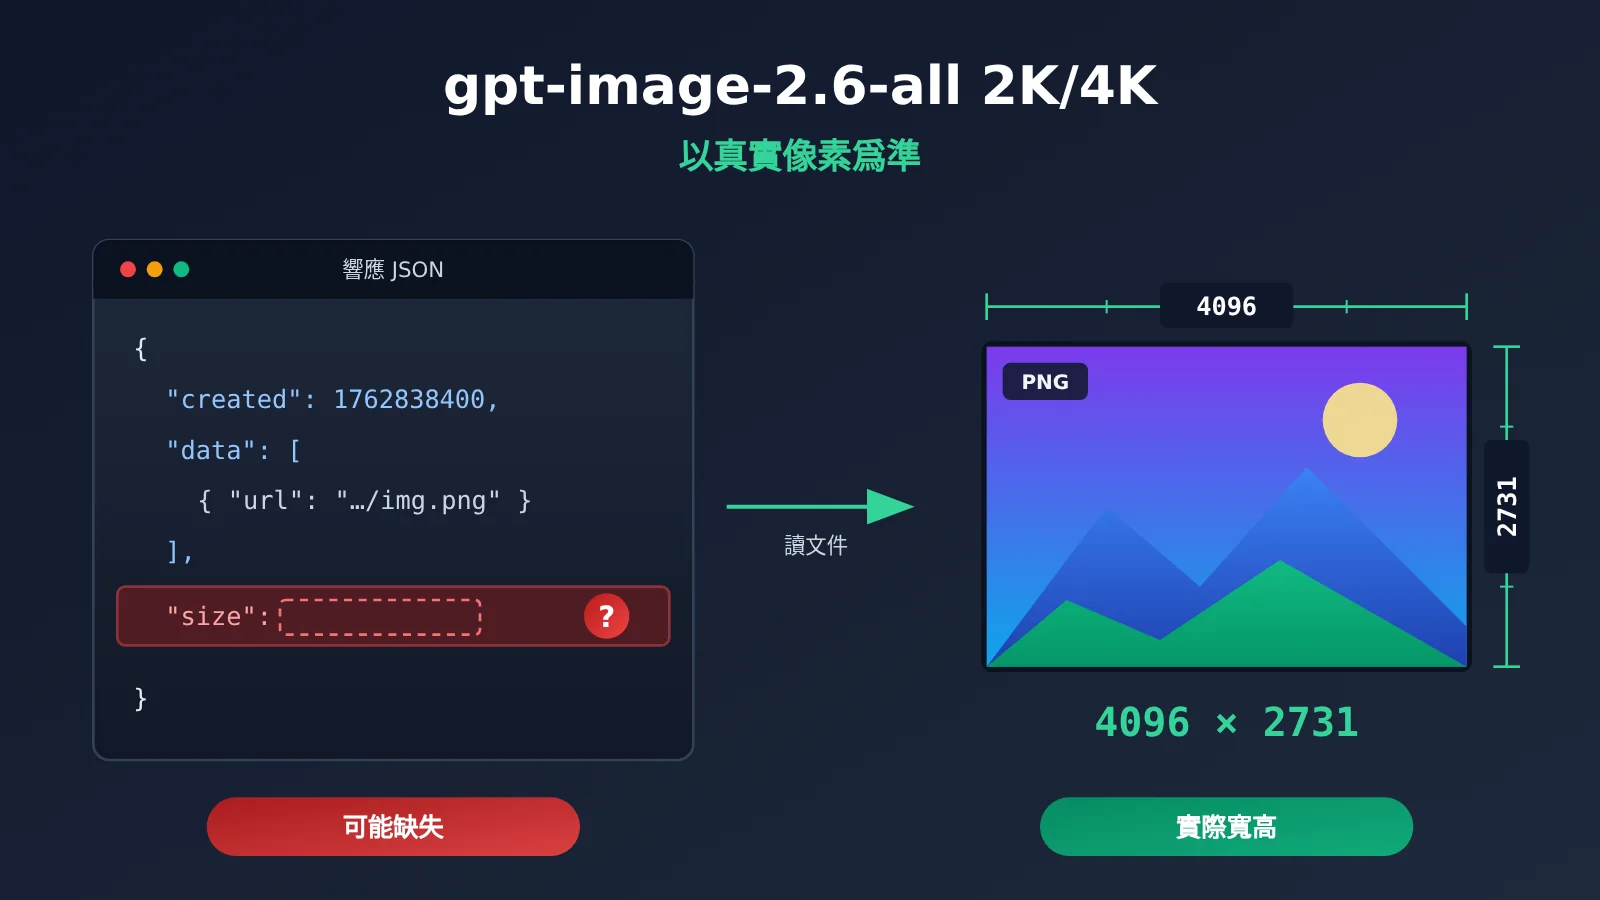
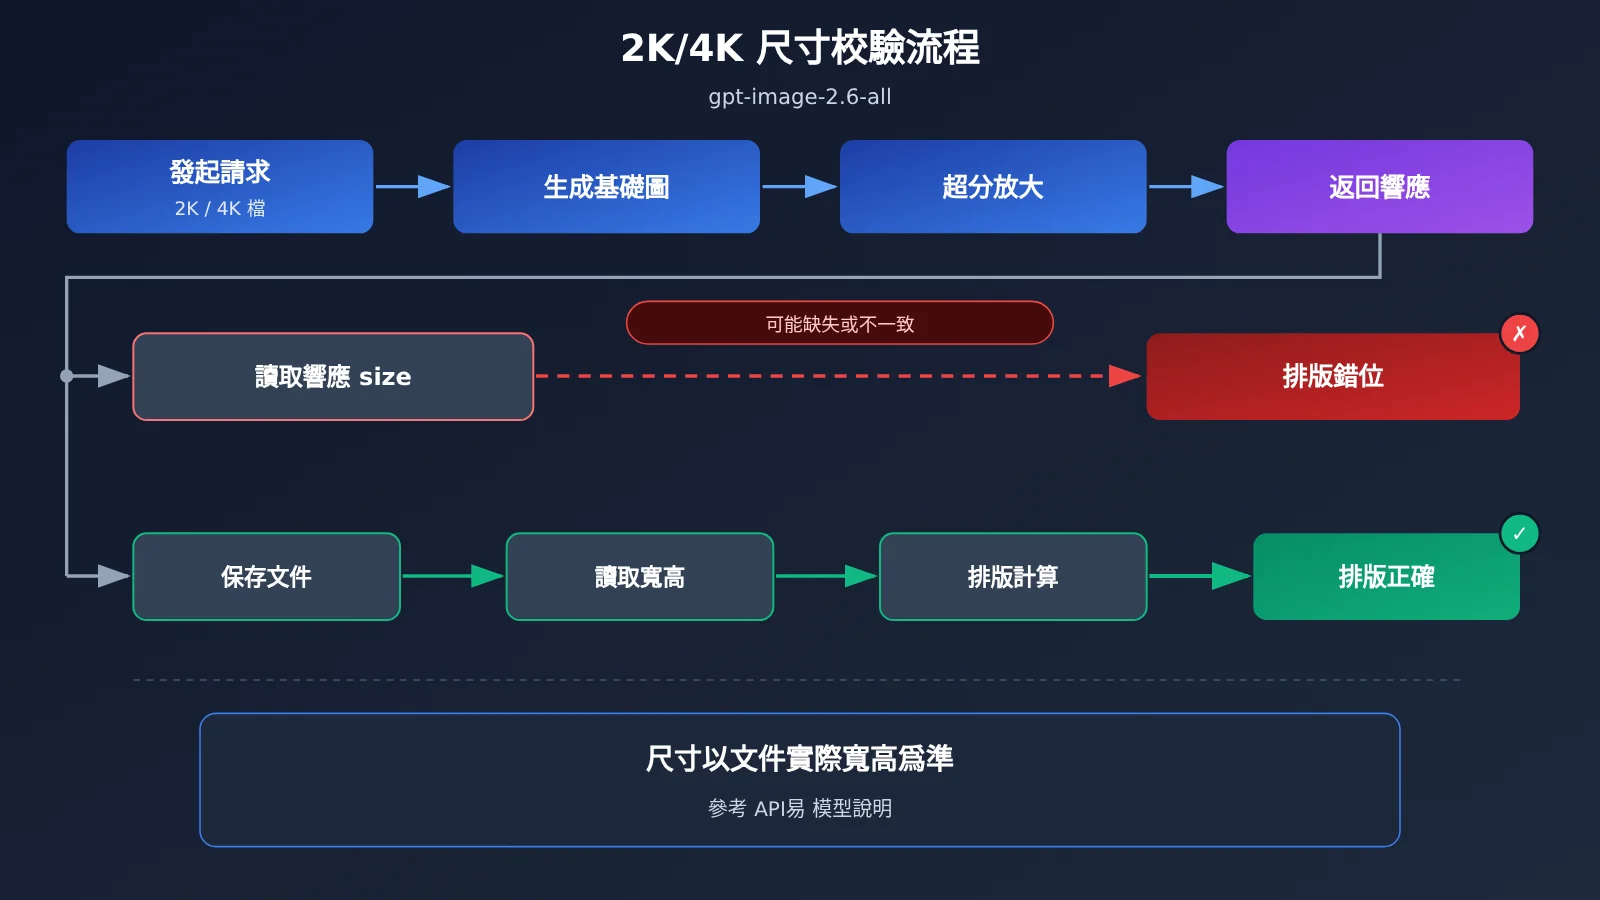
很多人把圖片生成接口接進海報模板、電商主圖或視頻封面流水線時,會直接讀取響應裏的 size 字段,用它計算畫布和版式。對 gpt-image-2.6-all 的 2K/4K 檔來說,這樣做有風險。API易 apiyi.com 在 2026-11-11 發佈的模型說明中寫明:2K/4K 屬於超分檔,響應可能不回顯 size,個別場景下實際像素也會和預期不同。尺寸以圖片文件的實際寬高爲準,這是文檔給出的結論。
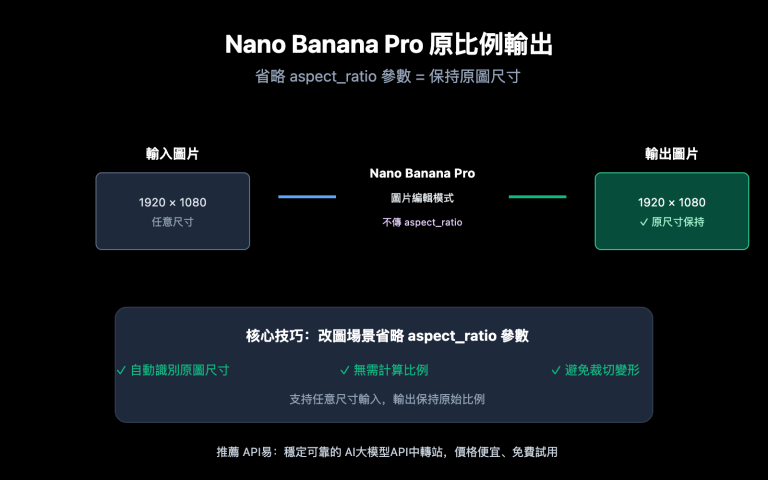
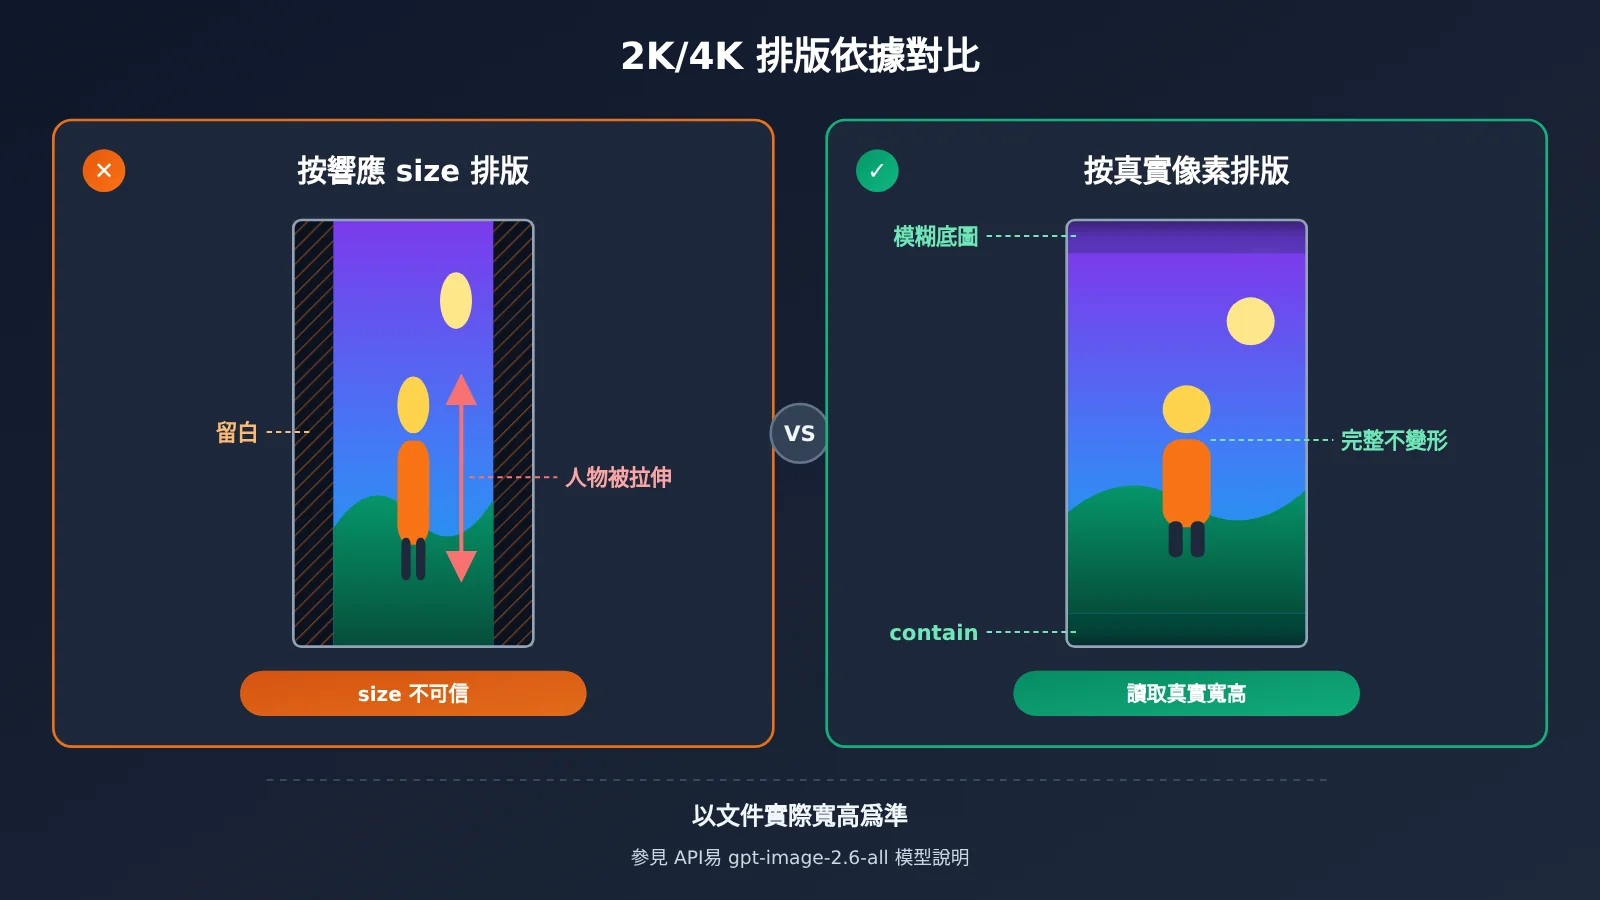
這個問題會直接影響排版結果。 一張 1365x2048 的圖如果被當作 9:16 放進豎版模板,畫面會出現留白或拉伸,主體也可能被裁掉。
核心價值:讀完本文,你會知道 2K/4K 檔爲什麼不能依賴響應字段,也能學會在保存圖片後讀取真實像素,再交給排版邏輯處理。
gpt-image-2.6-all 2K/4K 尺寸核心要點
下表彙總了文檔中和尺寸相關的信息,後面的代碼和排版方案都以這些信息爲依據。
| 要點 | 說明 | 對排版的影響 |
|---|---|---|
| 2K/4K 是超分檔 | 最終文件經過超分處理,像素由超分環節決定 | 不能按請求參數推算最終尺寸 |
| size 可能不回顯 | 2K/4K 檔的響應裏可能拿不到 size 字段 | 代碼依賴該字段時會讀到空值或報錯 |
| 像素偶發偏差 | 9:16 偶發 1365x2048,4K 偶發 4096x2731 |
寬高比可能和請求的比例不同 |
| quality=low 有差異 | 2K 檔可能輸出 2048x1153 |
出現奇數邊長,部分視頻編碼流程會報錯 |
| 以實際寬高爲準 | 文檔明確以圖片文件的真實寬高爲準 | 保存圖片後再讀像素,是唯一可靠的數據來源 |
爲什麼 gpt-image-2.6-all 2K/4K 的 size 字段不可靠
可以把超分檔理解爲兩步:先生成一張基礎圖,再放大到 2K 或 4K。最終文件的像素由超分環節決定,響應結構裏的 size 字段不一定和它同步。文檔對 2K/4K 的描述是“可能不回顯 size”。這意味着同一段代碼,有時能讀到這個字段,有時讀不到。
真正麻煩的情況是字段存在,但和文件不一致。代碼不會報錯,數值看起來也正常,錯誤要到排版結果出來後纔會被發現。所以更穩妥的做法是不把 size 當作尺寸來源,它最多用於日誌對照。排版要用的寬高,一律從保存下來的圖片文件裏讀取。
gpt-image-2.6-all 2K/4K 已知像素偏差解讀
文檔列出了幾種偶發的像素情況。下表把這些像素換算成寬高比,方便判斷它們對排版有什麼影響。
| 場景 | 可能出現的實際像素 | 換算寬高比 | 排版風險 |
|---|---|---|---|
| 9:16 比例 | 1365x2048 |
約 0.667,接近 2:3 | 按 9:16 模板放置會左右留白或被裁切 |
| 4K 檔 | 4096x2731 |
約 1.5,接近 3:2 | 短邊和預期不符,固定畫布會錯位 |
| 2K 檔 + quality=low | 2048x1153 |
約 1.776,接近 16:9 | 高度爲奇數,需要偶數邊長的編碼流程會失敗 |
從這幾個例子可以看出,長邊通常落在 2048 或 4096,短邊則不固定。第一種情況的比例偏差很明顯,9:16 約爲 0.5625,而 1365x2048 約爲 0.667。如果代碼按請求的 9:16 計算畫布,留白會非常顯眼。第三種情況的比例幾乎沒變,但 1153 是奇數。常見的視頻編碼像素格式要求寬高爲偶數,直接拿這張圖做視頻封面或首幀,轉碼時可能報錯。
這些情況都是“偶發”的,測試時跑幾張圖可能都沒問題,上線後纔會碰到。所以校驗邏輯應該放在每一次生成之後,不能只在測試階段抽查。
gpt-image-2.6-all 2K/4K 快速上手:讀取真實像素
核心思路只有一句話:先拿到圖片的二進制內容並保存,再用圖像庫讀取寬高。下面的示例使用 OpenAI 兼容的 Python SDK 和 Pillow。2K/4K 檔位、比例等請求參數的具體寫法請以 API易 文檔爲準,示例中只保留佔位。
極簡示例:對比響應 size 與真實像素
這段代碼生成一張圖,然後同時打印響應字段和真實像素,方便直觀看到兩者的差異。
import base64, io, requests
from openai import OpenAI
from PIL import Image

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

resp = client.images.generate(
    model="gpt-image-2.6-all",
    prompt="一張豎版城市夜景海報",
    # 2K/4K 檔位參數按 API易 文檔填寫
)
item = resp.data[0]
raw = base64.b64decode(item.b64_json) if item.b64_json else requests.get(item.url, timeout=120).content

img = Image.open(io.BytesIO(raw))
print("真實像素:", img.size)                       # (寬, 高)
print("響應 size:", getattr(resp, "size", None))   # 2K/4K 下可能爲 None
代碼中用 getattr 讀取 size,是爲了在字段缺失時不拋異常。同時兼容了返回 URL 和返回 base64 兩種形式,後續邏輯只依賴圖片的二進制內容。如果你的接入方式在文檔中走的是其他接口,只需要換掉“拿到圖片內容”這一步,讀取像素的部分完全不用改。
完整實現:保存後校驗並生成排版參數
生產環境建議把下面幾件事放進同一個函數:保存文件、讀取真實寬高、和響應字段對照、檢查比例漂移和奇數邊長,再按真實尺寸計算縮放結果。
import base64
import io
from pathlib import Path
from uuid import uuid4

import requests
from openai import OpenAI
from PIL import Image

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

# 2K/4K 檔位、比例等參數以 API易 文檔爲準,這裏僅爲佔位
TIER_PARAMS = {}


def fetch_image_bytes(item) -> bytes:
    if getattr(item, "b64_json", None):
        return base64.b64decode(item.b64_json)
    return requests.get(item.url, timeout=120).content


def parse_declared_size(resp):
    size = getattr(resp, "size", None)
    if not size or "x" not in str(size).lower():
        return None
    w, h = str(size).lower().split("x")
    return int(w), int(h)


def generate_and_measure(prompt, expected_ratio=None, out_dir="outputs"):
    resp = client.images.generate(
        model="gpt-image-2.6-all",
        prompt=prompt,
        **TIER_PARAMS,
    )
    raw = fetch_image_bytes(resp.data[0])
    img = Image.open(io.BytesIO(raw))
    width, height = img.size  # 唯一可信的尺寸來源

    Path(out_dir).mkdir(exist_ok=True)
    ext = (img.format or "png").lower()
    path = Path(out_dir) / f"{uuid4().hex[:8]}_{width}x{height}.{ext}"
    path.write_bytes(raw)

    declared = parse_declared_size(resp)
    report = {
        "path": str(path),
        "width": width,
        "height": height,
        "declared": declared,
        "declared_match": (declared == (width, height)) if declared else None,
        "odd_dimension": width % 2 == 1 or height % 2 == 1,
    }
    if expected_ratio:
        real_ratio = width / height
        report["ratio_drift"] = round(abs(real_ratio - expected_ratio) / expected_ratio, 4)
    return report


def fit_into_box(width, height, box_w, box_h, mode="contain"):
    if mode == "contain":
        scale = min(box_w / width, box_h / height)
    else:
        scale = max(box_w / width, box_h / height)
    return round(width * scale), round(height * scale)


if __name__ == "__main__":
    r = generate_and_measure("豎版城市夜景海報", expected_ratio=9 / 16)
    print(r)
    if r.get("ratio_drift", 0) > 0.01:
        print("比例漂移超過 1%,建議改用 contain 或重新生成")
    print(fit_into_box(r["width"], r["height"], 1080, 1920))
這段實現有三處設計值得說明:
- 文件名帶上真實寬高:下游服務無需再次解碼,看文件名就能拿到尺寸。
- declared_match 只用於日誌:它可以幫你統計字段缺失或不一致的頻率,但不參與排版計算。
- odd_dimension 提前攔截:類似
2048x1153的圖片在進入視頻編碼前,可以先裁掉或補齊 1 像素。
🚀 快速上手建議:可以先在 API易 apiyi.com 用一個 Key 分別跑 2K 和 4K 兩檔,把上面的 report 打印出來,觀察字段缺失和比例漂移的實際頻率,再決定線上的容錯閾值。平臺使用 OpenAI 兼容接口,示例代碼改好 base_url 就能運行。
gpt-image-2.6-all 2K/4K 排版適配方案
拿到真實像素只是第一步,下一步是讓排版邏輯完全基於這些數據運行。先對比三種尺寸信息來源,明確哪一種可以用來做決策。
| 信息來源 | 可靠性 | 2K/4K 下的表現 | 推薦用途 |
|---|---|---|---|
| 請求時選的檔位和比例 | 低 | 超分後的實際像素可能偏離 | 表達預期,作爲比例漂移的參照 |
| 響應中的 size 字段 | 低 | 可能不回顯,也可能與文件不一致 | 僅寫入日誌,用於統計 |
| 圖片文件的真實寬高 | 高 | 文檔明確以此爲準 | 排版、裁切、編碼的唯一依據 |
在不同環節讀取 gpt-image-2.6-all 2K/4K 真實寬高
圖片可能在後端生成,在前端展示,最後再交給視頻工具處理。每個環節都有對應的方式讀取真實像素,沒必要把尺寸信息一路透傳下去。
| 環節 | 讀取方式 | 注意事項 |
|---|---|---|
| Python 後端 | Pillow 的 Image.open(...).size |
只讀文件頭就能拿到寬高,開銷很小 |
| 瀏覽器前端 | img.naturalWidth / img.naturalHeight |
在 onload 之後讀取,不要讀 CSS 渲染尺寸 |
| 命令行或轉碼 | ffprobe 或 ImageMagick 的 identify |
進入編碼前順帶檢查是否爲偶數邊長 |
| 對象存儲 | 上傳時把寬高寫入元數據或文件名 | 後續服務直接讀取,不必再次解碼 |
前端是最容易踩坑的環節。很多組件會給圖片設置固定寬高,這時讀到的是渲染尺寸,而不是圖片本身的像素。判斷原圖是否接近 9:16,應該使用 naturalWidth 和 naturalHeight。
gpt-image-2.6-all 2K/4K 比例漂移的處理策略
比例漂移無法完全消除,能做的是提前決定好遇到漂移時怎麼處理。下面三種策略按風險從低到高排列。
| 策略 | 做法 | 適合場景 | 代價 |
|---|---|---|---|
| contain 適配 | 按真實寬高等比縮放,完整放進畫布 | 海報、詳情頁這類主體不能被裁的場景 | 可能出現留白,需要背景色或模糊底圖填充 |
| cover 裁切 | 等比放大鋪滿畫布,裁掉超出部分 | 封面、Banner 這類邊緣信息不重要的場景 | 主體靠邊時有被裁掉的風險 |
| 漂移重試 | 比例漂移超過閾值就重新生成 | 對比例要求嚴格的模板 | 多一次調用的費用和等待時間 |
對於奇數邊長,建議在進入編碼流程前統一處理:裁掉 1 像素,或者補 1 像素純色邊。2048x1153 裁成 2048x1152 後正好是標準的 16:9,視覺上幾乎看不出差別。
gpt-image-2.6-all 2K/4K 常見問題 FAQ
Q1: gpt-image-2.6-all 的 2K/4K 檔是什麼?
根據 API易 2026-11-11 發佈的模型說明,2K/4K 是超分檔,最終圖片經過超分處理後輸出。這也是它的尺寸行爲和普通檔位不同的原因:響應可能不回顯 size,實際像素也會偶發偏差。
Q2: 2K/4K 檔的響應 size 和文件真實尺寸,應該信哪個?
信文件。文檔明確寫了以圖片實際寬高爲準。響應裏的 size 在 2K/4K 檔下可能缺失,即使存在也只適合寫進日誌,不要拿它計算畫布、裁切區域或編碼參數。
Q3: 已知會出現哪些和預期不一致的尺寸?
文檔列出的情況包括:9:16 偶發 `1365×2048`,4K 偶發 `4096×2731`,quality=low 在 2K 檔可能輸出 `2048×1153`。這些都是偶發情況,所以校驗應該在每次生成後執行,不能只在測試時抽查。
Q4: 只在測試階段校驗幾張圖,上線後不校驗可以嗎?
不建議這樣做。偶發問題在小樣本測試中很可能一次都不出現。讀取寬高的開銷很小,Pillow 只需要解析文件頭。直接把校驗寫進生成函數,比事後排查錯位的版面省事得多。
Q5: 如何通過 API 快速調用 gpt-image-2.6-all 並驗證尺寸?
步驟如下:
1. 在 API易 apiyi.com 註冊賬號,獲取 API Key 和新用戶測試額度
2. 把示例代碼的 base_url 設置爲 `https://api.apiyi.com/v1`,檔位參數按文檔填寫
3. 運行完整實現代碼,查看 report 中的 declared_match、ratio_drift 和 odd_dimension
Q6: 2K 檔出現奇數高度會有什麼影響?
做靜態圖展示通常沒有影響。但如果要把圖片作爲視頻首幀、封面或轉碼素材,很多編碼流程要求寬高爲偶數。遇到 `2048×1153` 這類尺寸,建議裁掉或補齊 1 像素後再交給編碼器。
Q7: gpt-image-2.6-all 怎麼計費?
文檔標註爲按次計費,每次 $0.025。如果採用“比例漂移超閾值就重試”的策略,需要把重試次數算進成本。可以先在 API易 apiyi.com 用測試額度統計漂移頻率,再決定閾值設多嚴。
gpt-image-2.6-all 2K/4K 核心要點 Key Takeaways
- 2K/4K 是超分檔:最終像素由超分環節決定,不能按請求參數推算。
- size 字段不可依賴:2K/4K 響應可能不回顯 size,最多用於日誌對照。
- 偏差偶發且難以復現:
1365x2048、4096x2731、2048x1153都可能在線上出現。 - 先保存,再讀像素:用 Pillow 或 naturalWidth 讀取文件的真實寬高,再做排版。
- 提前處理奇數邊長:進入視頻編碼前,先裁掉或補齊 1 像素。
- 用測試額度定閾值:在 API易 apiyi.com 小批量統計漂移頻率,再確定重試策略。
總結
gpt-image-2.6-all 2K/4K 尺寸處理的要點:
- 不要相信響應裏的 size:超分檔可能不回顯,字段存在時也可能和文件不一致。
- 以圖片真實寬高爲準:保存圖片後讀取像素,這是文檔明確規定的判斷依據。
- 排版邏輯容忍漂移:用 contain、cover 或重試策略應對比例偏差,並提前處理奇數邊長。
把“讀取真實像素”寫進生成函數,就能在源頭避免版面錯位,後續流程也不必再關心響應字段是否可靠。推薦通過 API易 apiyi.com 用一個 API Key 跑通上面的校驗流程,確認 2K/4K 檔在你的模板中表現穩定後再上線。
📚 參考資料
- API易 gpt-image-2.6-all 上線說明:2K/4K 超分檔、size 回顯與實際像素說明
- 鏈接:
docs.apiyi.com/live/2026-11/gpt-image-2-6-all-launch -
說明:包含超分檔定義、偶發像素情況、以實際寬高爲準的說明和按次價格
-
Pillow 官方文檔:Python 圖像讀取庫
- 鏈接:
pillow.readthedocs.io -
說明:
Image.open與size屬性的用法,適合在後端讀取真實像素 -
MDN HTMLImageElement 文檔:瀏覽器端圖片屬性說明
- 鏈接:
developer.mozilla.org/docs/Web/API/HTMLImageElement - 說明:naturalWidth 與 naturalHeight 的含義,以及它們和渲染尺寸的區別
作者:API易 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心