作者注:AI 智能體讓代碼行數增長了 30%,交付的工單卻只增長了 12%。本文用研究數據定位瓶頸,並給出團隊可以直接照做的提效步驟。
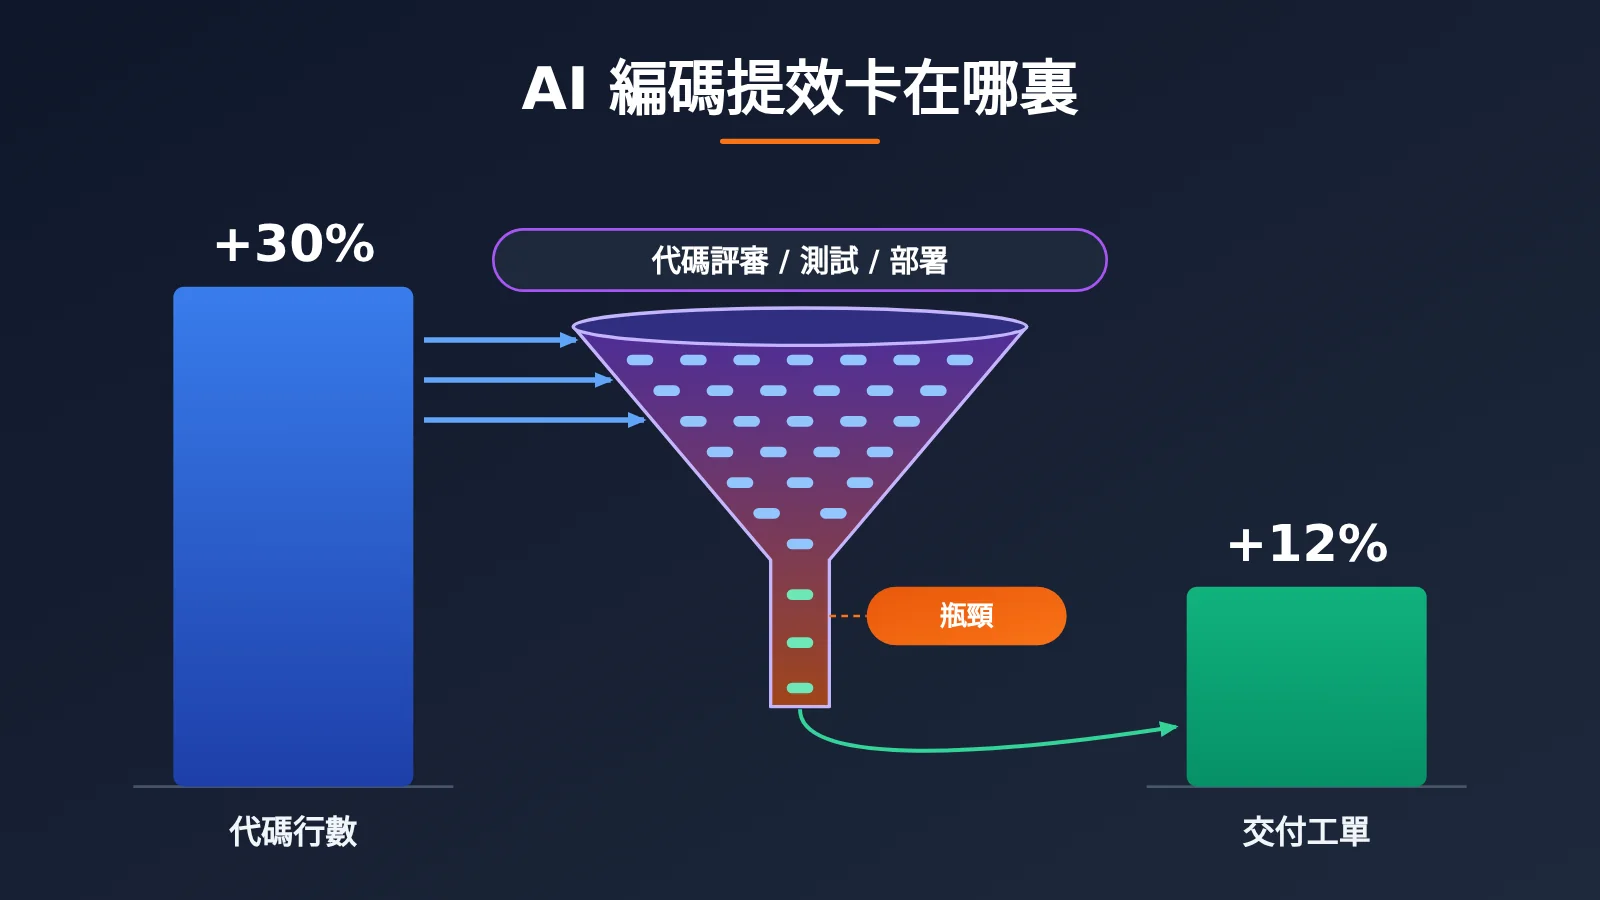
不少團隊引入 AI 智能體後發現,提交記錄變多了,合併請求變多了,可需求交付並沒有快多少。哈佛大學近期一項藉助 Jellyfish 平臺、覆蓋 718 家企業的研究給出了量化結論:代碼量漲 30%,交付只漲 12%,差距主要被代碼評審等下游環節喫掉了。
這不是又一篇唱衰 AI 編程的文章。研究的結論很明確:AI 智能體確實帶來了產出增長,問題在於整條交付流水線沒有跟着擴容。本文會先拆解數據,再給出一套從度量到流程改造的 5 步方法。
核心價值:讀完本文,你能判斷自己團隊的 AI 編碼提效卡在哪個環節,並知道先改什麼、怎麼衡量改進是否有效。
AI 編碼提效瓶頸的核心要點
這項研究的數據時段從 2021 年 1 月到 2026 年 3 月,覆蓋 700 餘家企業、70 萬名員工,合計約 3 億個工作事件。數據來源包括人力資源信息、代碼版本控制系統、工單系統、日程工具,以及 GitHub Copilot、Cursor、Claude Code 等生成式 AI 工具的使用記錄,樣本量在同類研究中相當罕見。
| 要點 | 研究發現 | 對團隊的意義 |
|---|---|---|
| 產出增長 | AI 智能體帶來代碼行數 +30%、提交 +20%、合併請求 +23% | 編碼環節確實變快了 |
| 交付增長 | 每人每月解決的工單隻增長 12% | 產出沒有同比例轉化爲交付 |
| 時間分配 | 工程師只有 30%–40% 的時間在寫代碼 | 只優化編碼,天花板很低 |
| 評審壓力 | 評審時長 +49%,評論數 +53%,需返工的合併請求佔比翻倍 | 瓶頸轉移到了評審環節 |
| AI 評審 | 引入 AI 輔助評審後,參與評審人員佔比仍增加 14% | 單純加 AI 評審工具不能解決問題 |
AI 助手與 AI 智能體的提效差異詳解
研究區分了兩類工具。編程助手(以補全和對話爲主)帶來的提升很小:代碼行數 +12%,提交 +9%,合併請求 +5%,其中只有提交記錄的增長具有統計顯著性。更關鍵的是,編程助手沒有帶來工單解決數量的提升,也就是說,對交付幾乎沒有可測量的影響。
AI 智能體(能自主完成多步任務)則在三項產出指標上都有顯著增長,並帶來了 12% 的工單增長。這說明“讓 AI 承擔完整任務”比“讓 AI 幫忙補幾行”更有價值,但同時也意味着下游收到的代碼量和審查負擔同步放大。研究還特別指出,評審工作量的上漲不能用單個合併請求體量變大來解釋,問題出在代碼本身需要更多討論和修改。
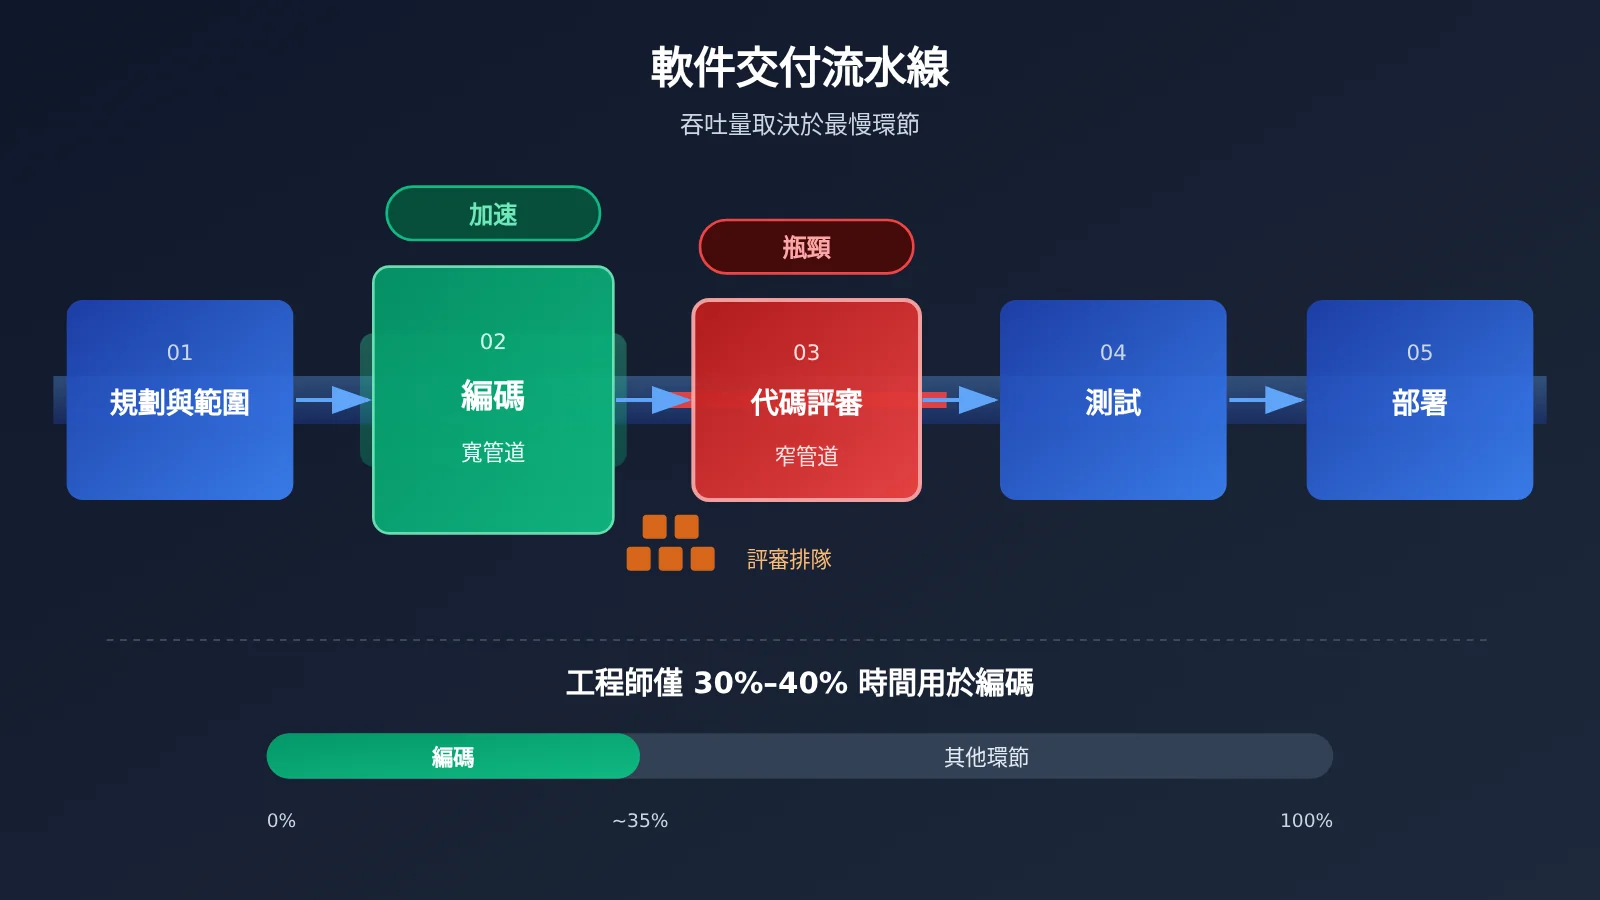
AI 編碼提效瓶頸在哪裏:用約束理論來理解
交付流水線的吞吐量取決於最慢的那個環節。當編碼只佔工程師 30%–40% 的時間時,即便把編碼速度翻倍,整體週期最多也只能縮短三分之一左右,而現實中被加速的編碼還會給評審和測試塞進更多待處理的工作。
研究裏的幾個數字可以拼出完整的因果鏈:智能體寫得更多,合併請求變多;每個合併請求的評論數增加 53%,說明評審者需要花更多精力理解和質疑 AI 寫的代碼;需要修改的合併請求佔比翻倍,說明首次提交的質量在下降。這些成本都落在了人工評審者身上,而評審者恰恰也是團隊中經驗最豐富、時間最緊張的人。
| 環節 | AI 帶來的變化 | 典型症狀 | 優先級 |
|---|---|---|---|
| 規劃與範圍 | 需求描述不清時,AI 會“自信地”寫錯方向 | 返工、合併請求被整體推翻 | 高 |
| 編碼 | 速度明顯提升 | 代碼量暴漲,單人產出看起來很好 | 已優化 |
| 代碼評審 | 待審數量與複雜度同時上升 | 評審排隊、評論來回拉扯 | 最高 |
| 測試 | 覆蓋率跟不上新增代碼量 | 迴歸問題增多 | 高 |
| 部署與運維 | 工程師對代碼理解變淺 | 故障排查變慢 | 中長期 |
社區討論也印證了這一點。有開發者評論“每一行代碼都是潛在風險”,還有人指出智能體是一個不太可靠的合作者,可能爲了完成任務做出離譜操作。另有觀點認爲,故障平均恢復時長(MTTR)會成爲評估 AI 影響的重要指標,因爲工程師對自己交付的代碼理解越淺,排查就越困難。
AI 編碼提效快速上手:5 步破局方法
下面的方法按投入從小到大排列,團隊可以按順序推進。每一步都儘量給出可度量的指標,避免“感覺變快了”這種無法驗證的判斷。
第 1 步:建立 AI 編碼提效的交付基線
先別急着換工具,先把度量體系搭起來。研究之所以能發現落差,是因爲同時看了產出指標和交付指標。很多團隊只看代碼行數和提交數,就會誤以爲提效很成功。
建議同時追蹤兩組指標:產出側看提交數、合併請求數;交付側看每人每月關閉的工單、需求從開始到上線的週期。再加上評審側的三個指標:合併請求平均評審時長、單個合併請求評論數、需返工比例。這些數據通常可以從 Git 平臺和 Jira 等工單系統中直接導出。
| 指標類別 | 具體指標 | 數據來源 | 觀察重點 |
|---|---|---|---|
| 產出 | 提交數、合併請求數 | Git 平臺 | 只作參考,不作考覈 |
| 交付 | 每人每月關閉工單數、需求週期 | 工單系統 | 核心目標指標 |
| 評審 | 評審時長、評論數、返工率 | Git 平臺 | 瓶頸預警 |
| 質量 | 線上故障數、MTTR | 監控與事故記錄 | 長期健康度 |
第 2 步:把需求規劃前置給 AI 編碼智能體
智能體在需求含糊時最容易“自信地跑偏”。與其在評審階段推翻一整個合併請求,不如在動手前花十分鐘寫清楚任務說明:要改哪些模塊、不能動哪些接口、驗收標準是什麼、需要補哪些測試。
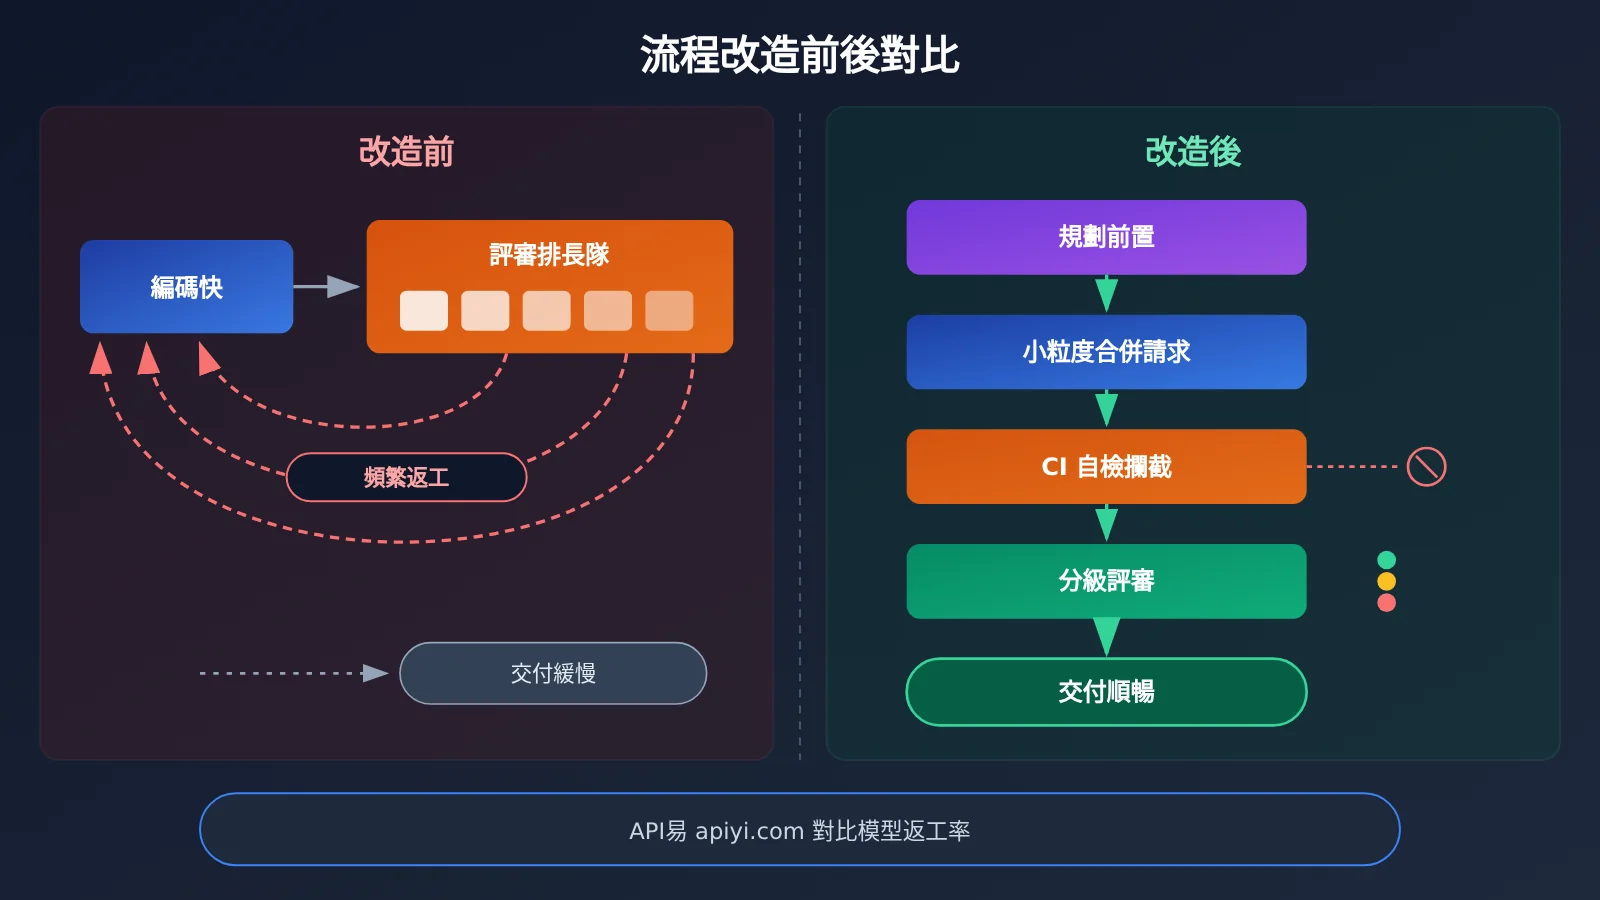
一個實用的做法是讓智能體先輸出實施計劃,由工程師確認後再進入編碼。計劃階段的修改成本遠低於代碼階段,也能讓評審者提前知道改動範圍。這一步看似增加了前期時間,但能直接降低“需返工合併請求佔比翻倍”這類問題。
第 3 步:控制 AI 生成代碼的合併請求粒度
評審者的注意力是有限資源。即使研究顯示評審負擔上升不完全是因爲單個合併請求變大,控制粒度仍然是降低認知負擔最直接的手段。建議爲智能體任務設定明確邊界,一個合併請求只解決一個問題,重構與功能改動分開提交。
同時要求智能體在合併請求描述中寫明改動動機、影響範圍和自測結果。評審者讀描述就能判斷風險,而不是從幾百行差異中倒推意圖,評論來回拉扯的次數會明顯減少。
🎯 技術建議:不同模型在任務拆分和計劃質量上差異明顯。API易 apiyi.com 提供 Claude、GPT 等本文涉及的主流模型 API 調用,同時兼容 OpenAI 與 Anthropic 兩種接口格式,團隊可以在同一個智能體工作流裏切換模型,對比哪個模型生成的合併請求返工率更低。接入方式見 API易 文檔 docs.apiyi.com。
第 4 步:把測試與自檢交給智能體,而不是交給評審者
研究發現引入 AI 輔助評審後,參與評審的人員佔比仍增加了 14%。這說明在評審環節補一個 AI 並不夠,更有效的做法是把質量關口往前移:讓智能體在提交前就完成單元測試補充、本地運行測試、靜態檢查和格式化。
可以把“測試通過、檢查通過”設爲提交合並請求的硬性前置條件,由 CI 自動攔截。評審者因此可以專注於設計合理性、邊界條件和業務邏輯,而不是指出空指針和命名問題。AI 評審工具適合作爲第一道過濾,但最終判斷仍應由理解業務的人完成。
第 5 步:分級評審與 AI 編碼風險分層
並非所有 AI 生成的代碼都需要同等強度的評審。可以按風險把改動分級:文檔、測試、樣板代碼走輕量評審;業務邏輯走常規評審;涉及鑑權、支付、數據遷移、併發的改動必須由資深工程師深度評審,並要求作者能講清楚每一處改動。
| 風險等級 | 改動類型 | 評審方式 | 建議評審人數 |
|---|---|---|---|
| 低 | 文檔、測試用例、樣板代碼 | AI 初審 + 快速人工確認 | 1 人 |
| 中 | 常規業務邏輯 | 人工完整評審 | 1–2 人 |
| 高 | 鑑權、支付、數據遷移、併發 | 資深工程師深度評審 + 作者講解 | 2 人及以上 |
最後,要把 MTTR 納入長期跟蹤。如果工程師對代碼理解越來越淺,問題會在線上故障中暴露出來。定期要求作者講解自己合併的 AI 代碼,是防止“沒人真正懂這段代碼”的低成本手段。
🚀 快速開始:如果你正在搭建團隊內部的編碼智能體,可以先在 API易 apiyi.com 申請測試額度,用同一套任務說明分別調用不同模型,記錄生成合並請求的評審時長和返工率,再決定主力模型。
AI 編碼智能體的模型選型參考
模型選型本身不能解決流程瓶頸,但會影響首次提交質量,進而影響評審負擔。下表從工作流角色出發給出方向性建議,具體效果請以團隊實測爲準。
| 工作流角色 | 能力側重 | 選型思路 | 可用平臺 |
|---|---|---|---|
| 實施計劃生成 | 長上下文理解、任務拆分 | 選推理能力較強的旗艦模型 | API易 apiyi.com、官方 API |
| 代碼編寫與重構 | 代碼質量、遵循約束 | 選編程評測表現好的模型 | API易 apiyi.com、官方 API |
| 測試補充與自檢 | 穩定、調用量大 | 選性價比較高的模型 | API易 apiyi.com、官方 API |
| AI 初審 | 發現常見缺陷 | 與編寫模型錯開,避免同源盲區 | API易 apiyi.com、官方 API |
💰 成本說明:智能體工作流調用量大,計費口徑(輸入、輸出、緩存命中單價)直接決定成本。本文不列具體價格,所有模型的價格與計費方式請以 API易 價格頁 docs.apiyi.com/models 的實時數據爲準。
常見問題 FAQ
Q1:AI 編碼“代碼量漲 30%、交付只漲 12%”是什麼意思?
這是哈佛大學藉助 Jellyfish 數據的研究結論:使用 AI 智能體後,代碼行數增長 30%,但每名工程師每月解決的工單隻增長 12%。差距主要來自代碼評審、測試等下游環節成爲新瓶頸。
Q2:AI 編程助手和 AI 智能體的提效差別有多大?
編程助手的產出增長較小,只有提交記錄增長 9% 具有統計顯著性,且沒有提升工單解決數量。AI 智能體則讓代碼行數、提交和合並請求分別增長 30%、20%、23%,並帶來 12% 的工單增長。
Q3:這項 AI 編碼提效研究的數據可信嗎?
數據時段爲 2021 年 1 月到 2026 年 3 月,覆蓋 700 餘家企業、70 萬名員工、約 3 億個工作事件。工時分配推算還通過面向 100 名工程師的調研進行了驗證,樣本規模和交叉驗證都比較紮實。
Q4:引入 AI 代碼評審工具能解決評審瓶頸嗎?
單靠它不夠。研究顯示引入 AI 輔助評審後,參與評審的人員佔比仍增加了 14%。更有效的做法是把測試與自檢前移到提交前,再配合分級評審,讓人工評審聚焦高風險改動。
Q5:如何低成本驗證不同模型對評審負擔的影響?
建議用同一批真實任務對比多個模型:
1. 在 API易 apiyi.com 註冊並獲取測試額度
2. 按 API易 文檔 docs.apiyi.com 的說明,以 OpenAI 或 Anthropic 兼容格式接入現有智能體
3. 記錄每個模型生成合並請求的評審時長、評論數和返工率
這樣能用數據而不是印象來選模型。
Q6:團隊用 AI 編碼智能體的成本怎麼估算?
先統計單個任務平均消耗的輸入與輸出 Token,再乘以模型單價和月任務量。智能體任務往往上下文很長,緩存命中會顯著影響成本。具體單價和緩存計費口徑請以 API易 價格頁 docs.apiyi.com/models 爲準。
Q7:AI 編碼提效有哪些長期風險?
主要風險是工程師對代碼的理解變淺。社區觀點認爲,代碼庫持續擴張而理解不足時,故障可能更頻繁、排查更困難。建議長期跟蹤故障平均恢復時長,並要求作者能講清自己合併的 AI 代碼。
AI 編碼提效核心要點 Key Takeaways
- 產出不等於交付:AI 智能體讓代碼量漲 30%,交付工單隻漲 12%
- 編碼只佔三到四成時間:只優化寫代碼,整體提效天花板很低
- 評審是頭號瓶頸:評審時長 +49%,評論 +53%,返工比例翻倍
- AI 評審不是銀彈:引入後參與評審人員佔比仍上升 14%
- 質量關口前移:規劃前置、小粒度提交、提交前自檢最有效
- 長期盯住 MTTR:防止團隊對 AI 代碼“寫得多、懂得少”
- 用數據選模型:可通過 API易 apiyi.com 統一接口對比各模型返工率
總結
AI 編碼提效卡在哪裏,研究已經給出了答案:
- 瓶頸已經轉移:編碼變快後,代碼評審、測試和規劃成爲新的限速環節
- 度量要成對看:產出指標必須與交付、評審、質量指標一起追蹤
- 改流程比換工具更重要:規劃前置、控制粒度、自檢前移、分級評審,按順序推進
真正的提效不是讓 AI 寫更多代碼,而是讓更少的代碼以更高的首次質量通過評審。建議先用一個迭代週期跑出基線數據,再逐步落地上面的 5 步方法。
如果需要在智能體工作流裏對比不同模型的表現,推薦通過 API易 apiyi.com 快速驗證,平臺兼容 OpenAI 與 Anthropic 接口格式,價格以 docs.apiyi.com/models 爲準。
📚 參考資料
- InfoQ 中文:AI 生成代碼受下游環節瓶頸制約:研究報道中文版
- 鏈接:
infoq.cn/article/c3vTLNrRwfCzw8SAmz90 -
說明:包含研究方法、核心數據與社區討論
-
InfoQ 英文原文:Jellyfish AI Productivity:研究報道英文版
- 鏈接:
infoq.com/news/2026/10/jellyfish-ai-productivity -
說明:適合需要查閱英文原始表述的讀者
-
API易 文檔中心:模型接入與接口說明
- 鏈接:
docs.apiyi.com -
說明:OpenAI 與 Anthropic 兼容格式的接入方式
-
API易 模型價格頁:各模型計費口徑
- 鏈接:
docs.apiyi.com/models - 說明:輸入、輸出、緩存單價均以此頁實時數據爲準
作者:APIYI 技術團隊
技術交流:歡迎在 API易 apiyi.com 首頁聯繫我們,更多接入資料可訪問 docs.apiyi.com 文檔中心