作者注:OpenAI 於 2026 年 11 月 2 日披露了內部 Git 後端 Pando。本文圍繞“10 周進入生產”這一事實,拆解人機分工、測試體系和遷移過程,並整理普通團隊可以借鑑的 Agent 工程方法。
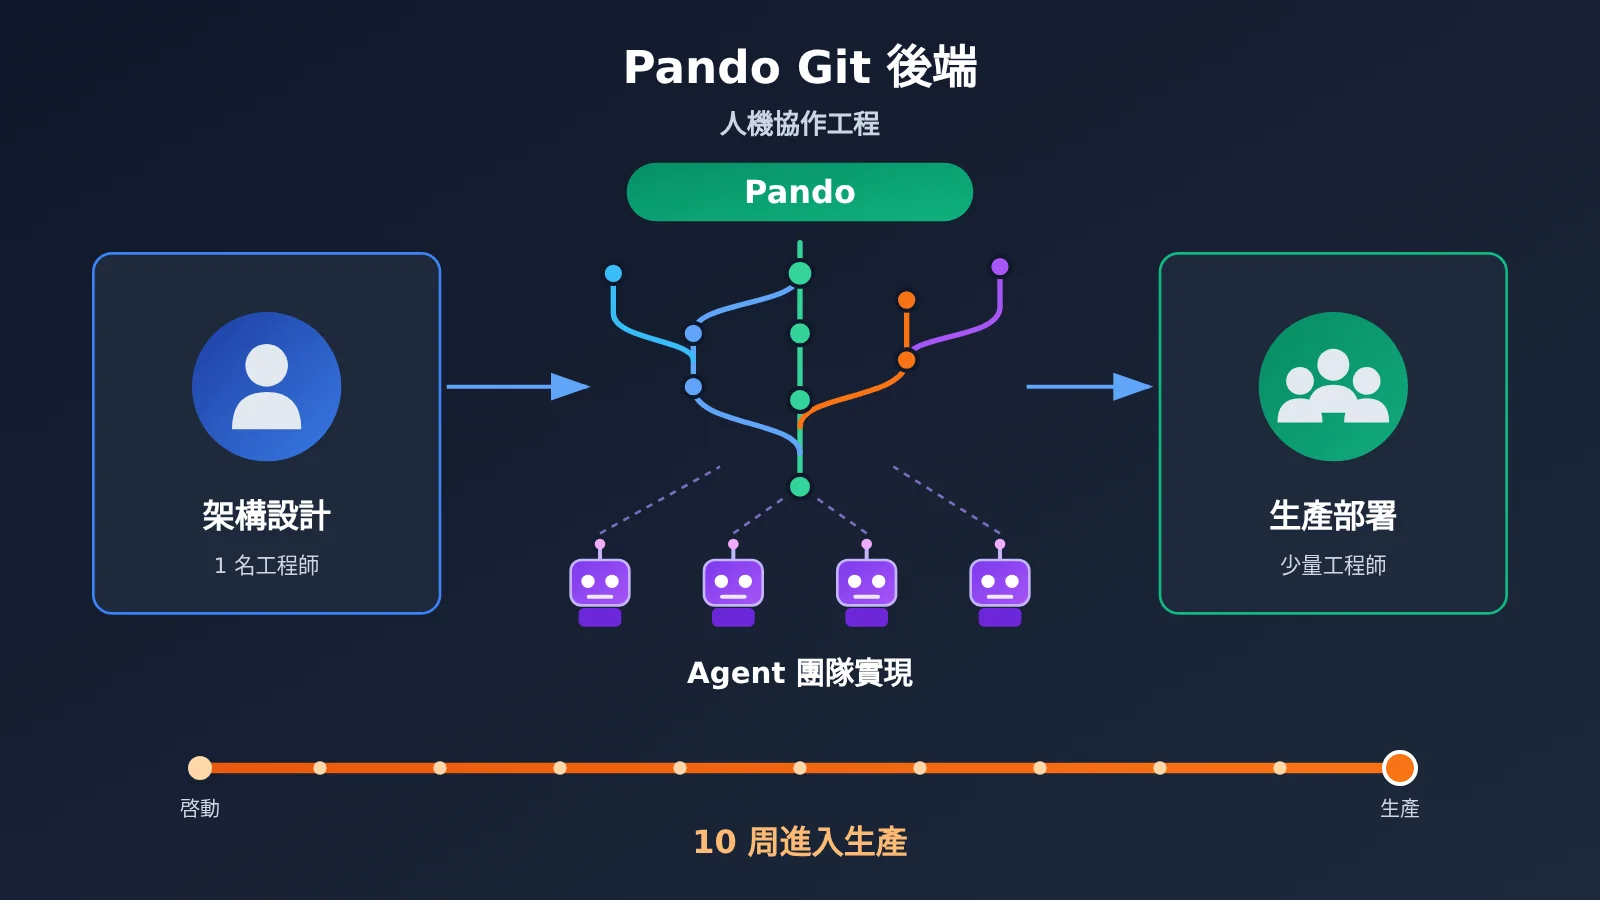
2026 年 11 月 2 日,OpenAI 發佈技術文章《Scaling Git at OpenAI》,公開了支撐其單體代碼庫全部開發活動的新 Git 後端 Pando:從啓動到承載生產流量約 10 周,核心架構由一名工程師設計,實現由多個 Agent 團隊承擔,部署由少量工程師完成。這組事實很容易被講成“一個人指揮 AI 造出基礎設施”的故事,但官方披露的細節說明,真正起作用的是一整套工程約束與驗證體系。
這不是一篇 AI 編程神話的轉述。本文依據 OpenAI 官方披露,區分已經公開的事實與尚未公開的信息,例如人員規模、Token 成本、任務記錄和代碼人工修改比例都沒有公佈。
核心價值:讀完本文,你將瞭解 Pando 爲什麼要建、Codex Agent 團隊具體承擔了什麼、哪些驗證手段讓 Agent 能參與基礎設施開發,以及這套方法在你自己的項目中應該如何落地。
Pando 核心信息速覽:Codex Agent 團隊交付了什麼
先用一張表把官方已經確認的信息彙總清楚。需要注意的是,Pando 是 Git 兼容的服務端後端,既不是新的版本控制協議,也不是 GitHub 的直接替代品。
| 信息項 | 詳情 |
|---|---|
| 發佈時間 | 2026 年 11 月 2 日,官方文章《Scaling Git at OpenAI》 |
| 作者 | Aaron Friel、Taylor Blau、Ted Nyman(OpenAI 技術人員) |
| 項目週期 | 從啓動到生產投入約 10 周,2026 年 4 月開始承載生產流量 |
| 實現語言 | 服務端主要使用 Rust,從頭構建,主動避免繼承舊系統依賴 |
| 人機分工 | 一名工程師設計核心架構,多個 Agent 團隊實現,少量工程師部署 |
| 生產結果 | Push 延遲中位數下降近 80%,每日交付接近 1 PB Git 數據 |
| 開放狀態 | 截至 2026-11-03,未發佈公開服務端、API 或定價 |
爲什麼 OpenAI 需要用 Codex Agent 重建 Git 後端
Pando 的起點是代碼提交規模的爆發。官方圖表以 2024 年第一季度合併到主分支的 Commit 數量爲基準,統計後續季度的增長率,下表摘取部分節點。
| 季度 | 相對 2024 Q1 的 Commit 增長 | 說明 |
|---|---|---|
| 2024 Q4 | +98% | 接近翻倍 |
| 2025 Q4 | +264% | 舊系統開始難以跟上需求 |
| 2026 Q1 | +432% | Pando 項目推進階段 |
| 2026 Q3 | +1,378% | 約爲基期 14.78 倍 |
| 2026 Q4 | +2,442% | 官方預測值,不是已完成季度實績 |
這裏有一個必須守住的邊界:Commit 數量不等於代碼行數、PR 數量或開發生產率。不能據此說“代碼量漲了 25 倍”或“Codex 讓工程師效率提高 25 倍”。OpenAI 自己的解釋是,Codex 讓工程師可以同時推進更多任務,進而帶來更多並行分支、Push、合併、CI 作業以及 Fetch 和 Clone 請求。
到 2025 年第四季度前後,舊系統出現了 Push 和 Fetch 變慢、合併失敗等問題,可靠性有時低於 90%。官方沒有公開該可靠性指標的統計口徑和時間序列,所以也不能把它理解爲“超過 10% 的提交都失敗了”。
Pando 技術架構的 4 個關鍵設計
Pando 沒有拋棄 Git,重新設計的是後端的存儲、引用更新和數據交付方式。理解這些設計,有助於看清“人類做了哪些不可替代的取捨”。
- 分支獨立更新:放棄爲整個倉庫維護單一時間點的一致快照,每個分支獨立維護版本,只有修改同一 Ref 的請求才需要協調,採用因果一致性模型。代價是一次多分支讀取中,不同分支可能來自不同時間點。
- 保存並複用 Packfile:每次 Push 收到的 Packfile 作爲不可變數據寫入 Blob Store,Fetch 時根據客戶端的 have/want 選取現成 Packfile,藉助 Git 的 packfile-uri 機制下發下載地址,避免爲每個客戶端重複打包壓縮。
- 區域緩存 Express:在多個區域部署集羣和本地緩存,用一致性哈希分配請求,Packfile 緩存命中率超過 99%。這是 Git 數據緩存,與大模型 API 的 Prompt Caching 不是一回事。
- 後臺分層 Compaction:類似 LSM Tree,將小 Packfile 逐層合併爲覆蓋連續版本區間的大集合,當前單體倉庫使用到 L4 級別。
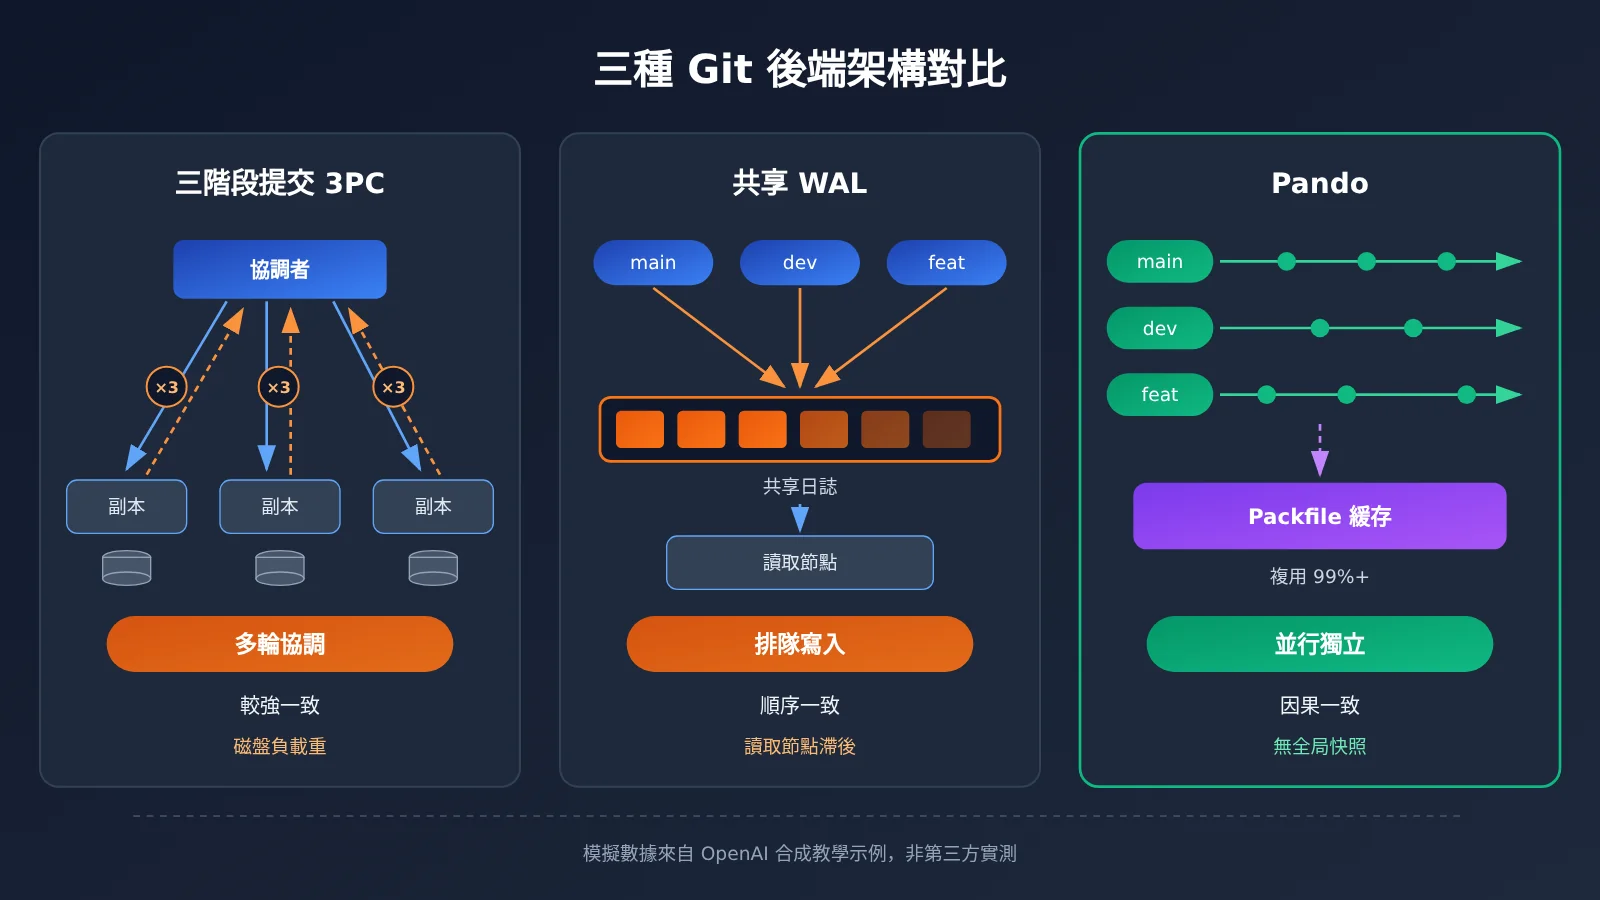
官方同時對比了三類架構,並做了一個 1,000 個客戶端、合計 10,000 次 Push 的模擬。這是 OpenAI 構建的合成教學模擬,不是第三方獨立基準測試。
| 架構方案 | 寫入方式 | 一致性 | 主要瓶頸 |
|---|---|---|---|
| 三階段提交 3PC | 多個完整副本協調寫入 | 較強 | 多輪協調和磁盤負載拖慢併發寫入 |
| 共享 WAL | 所有更新競爭同一日誌 | 順序一致 | 寫入快於應用時讀取節點滯後 |
| Pando | 各 Ref 獨立原子事務 | 因果一致性 | 放棄全倉庫同時刻快照 |
官方公開的生產數據還包括:單小時 Packfile 交付峯值超過 57 TB,其中超過 99% 字節來自本地磁盤緩存;標準雲虛擬機上 Clone 和 Fetch 可跑滿 10 Gbps 鏈路;Push 的元數據讀寫爲 O(1),Fetch 規劃的元數據讀取爲 O(log Δ)。這些複雜度描述的是元數據操作,不是端到端網絡耗時。
Codex Agent 團隊如何分工完成 Pando
“一名工程師設計核心”不等於項目只有一個人,“Agent 團隊實現”也不等於每一行代碼都由 AI 編寫。根據官方披露的工作範圍,可以把分工整理如下,但 OpenAI 並未公開每個 Agent 的具體任務清單。
| 角色 | 承擔的工作 | 爲什麼由這個角色做 |
|---|---|---|
| 架構工程師(人類) | 判斷舊系統瓶頸、堅持兼容 Git 協議、選擇分支獨立更新和 Packfile 複用、放棄全倉庫強一致 | 這些是不可逆的技術取捨,決定了系統邊界 |
| Codex 等 Agent 團隊 | Rust 後端實現、Push/Fetch 協議兼容、併發寫入、性能優化、邊界問題修復 | 實現量大、可被測試反覆驗證,適合並行迭代 |
| 驗證型 Agent | 長時間運行會話找邊緣問題,具備 Daybreak 能力的模型做全天候對抗測試 | 持續性強,人類難以保持同等頻率 |
| 部署工程師(人類) | 漸進切流、新舊系統同步、遷移數百項集成 | 生產風險和組織協調需要人類負責 |
這張表反映的核心是:人類制定架構、約束和驗收目標,Agent 承擔大量實現與迭代,工程師對生產遷移和系統可靠性負責。官方沒有提供人工開發的對照組,所以無法計算 Codex 把這個項目加速了多少倍。
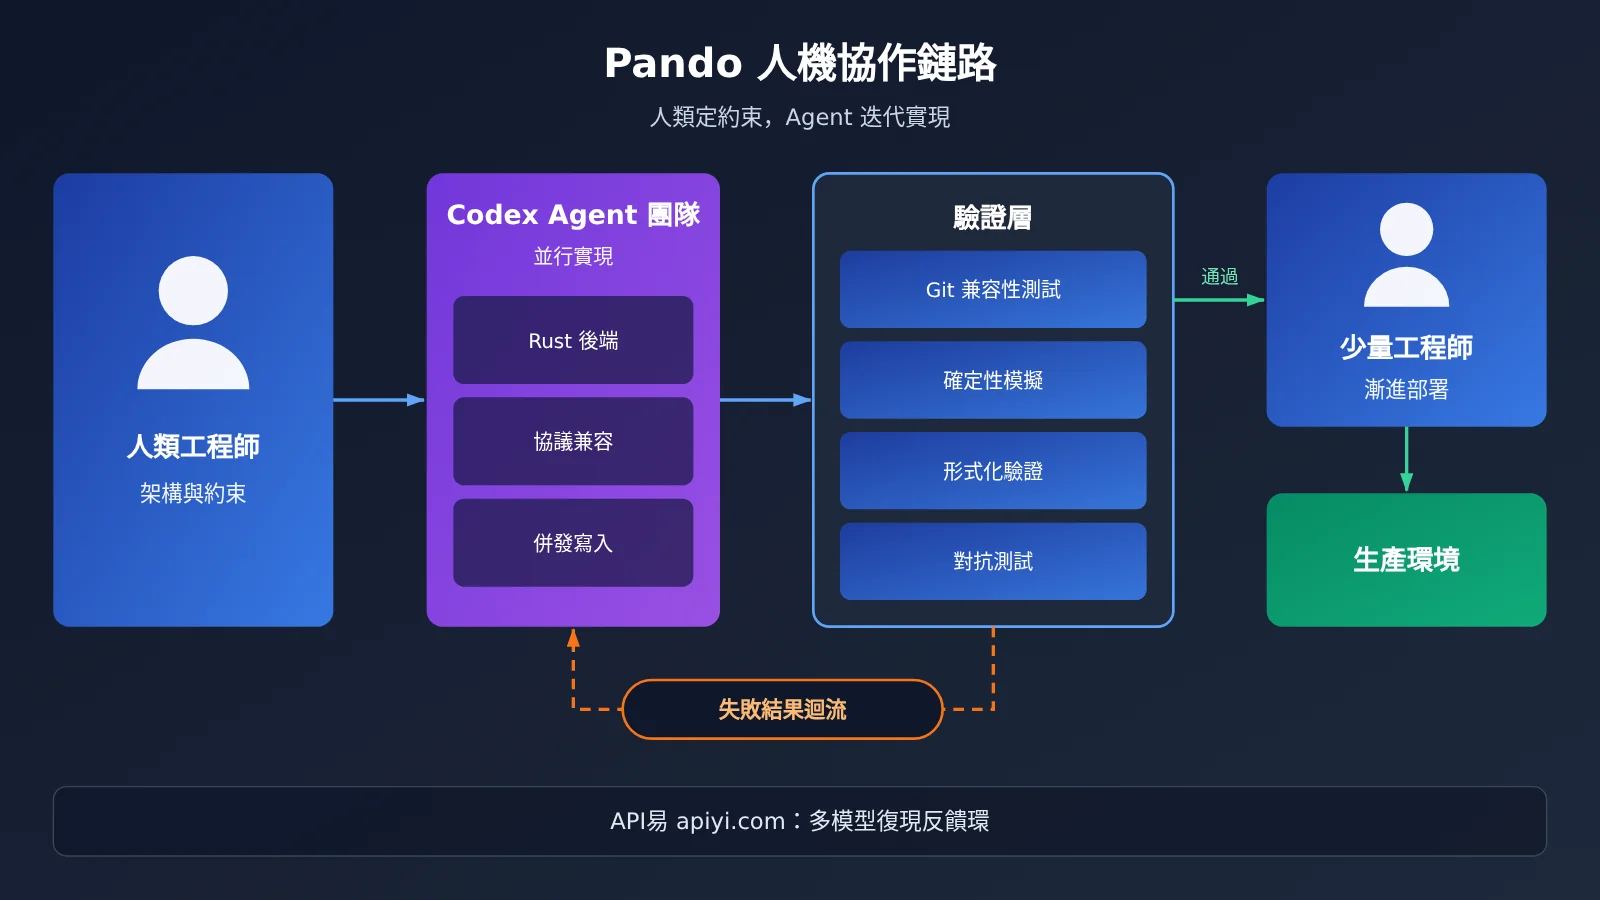
Pando 測試體系:Codex Agent 爲什麼能參與基礎設施開發
Pando 是基礎設施軟件,一旦出錯,影響的是分支是否指向正確提交、Push 是否丟失對象、Fetch 是否拿到完整歷史。普通網頁寫錯了可以刷新,Git 後端寫錯了可能讓整個公司的開發停擺。所以 OpenAI 給 Agent 配備的不是更長的提示詞,而是可執行的驗證系統。
Git 兼容性測試:判斷的是行爲而非編譯
OpenAI 建立了 Git Conformance Test Suite,讓 Agent 修改服務端實現後,可以自行檢查行爲是否符合標準 Git 預期。驗證對象涉及 Ref 更新、Push、Fetch、Packfile 傳輸和協議兼容。關鍵在於標準是“與 Git 行爲一致”,而不僅是“代碼能編譯、單測能過”。官方沒有公開測試用例數量。
確定性併發模擬:讓競態可重複
分佈式系統最難的錯誤往往出在多個操作交錯發生時。OpenAI 使用 Deterministic Simulation Harnesses,以可重複的方式模擬系統狀態和併發事件,幫助發現競態條件、Git 協商問題、Packfile 規劃錯誤和迴歸問題。舉例來說,兩個 Agent 同時修改同一分支時,不能讓兩個衝突更新都被判定爲成功;更新分支指針前,新提交對象必須已經可讀。這些是對測試目標的解釋,不是官方逐項公開的用例。
Lean 與 TLA+ 形式化驗證:注意時間線
官方披露使用 GPT-6 Astra 協助 Agent 編寫 Lean 和 TLA+ 形式化描述,形成所謂的“Theory of Pando”,用於檢查不變量、發現和修復錯誤,並證明特定性質。這裏有兩個限制:其一,被驗證的是指定性質,不代表整個系統的所有代碼路徑都完成了數學證明;其二,官方表述是新模型陸續出現後持續被用於提升性能和可靠性,因此不能把這些實踐全部歸入最初 10 周。
長時間 Agent 會話與對抗性安全測試
OpenAI 還提到,多個連續 Agent 會話運行了數百小時尋找並修復邊緣問題,具備 Daybreak 能力的模型持續對 Git 和 Pando 做對抗性測試。官方沒有公開 Agent 數量、單會話時長、Token 消耗、修復 Bug 數量和人工監督頻率,所以不能推導出“Agent 無人值守連續寫代碼幾百小時”。值得關注的是思路轉變:Agent 被用於持續驗證,而不只是首次生成代碼。
OpenAI 公開的 Git Fork 也能側面印證這種持續改進。例如 2026 年 8 月的 index-pack 並行哈希、10 月的限流重試和已完成 Pack 複用等補丁,但這些提交都晚於 2026 年 4 月首次投產,同樣不能算作 10 周內的交付物。
Pando 漸進式遷移:Codex Agent 寫完代碼不等於生產可用
10 周是從啓動到投入生產,不是完整成熟化的全部耗時。Pando 的上線方式是一次典型的“不停機漸進遷移”,官方披露的過程大致如下:
- 將 Pando 放在舊系統前面,作爲讀寫穿透代理,新舊後端保持同步。
- 在真實請求中合併相同請求、緩存 Git 數據,部分流量遷入後反而緩解了舊系統負擔。
- 通過內部 Git CLI 包裝器分批遷移開發客戶端。
- 遷移數百個依賴舊 API、Webhook 和倉庫下載方式的集成,以及 Review、Change Request 工作流。
- 提供用於遷移的 Codex Skills,開發者可以直接讓 Codex 協助準備本地倉庫和遷移環境。
- 將改進版 Git 客戶端部署到工程師設備和 ChatGPT 桌面應用中。
官方稱整個遷移沒有中斷工程開發,但沒有公開回滾率、故障分佈和失敗案例。對技術負責人來說,這一段比“10 周”更值得研究:兼容舊工作流、遷移集成、分批切流,這些工作的複雜度往往不亞於寫出新系統本身。
Pando 影響分析:對 Agent 開發者和技術團隊意味着什麼
對 Agent 開發者的影響
- 驗證能力決定 Agent 上限:Pando 能讓 Agent 參與核心實現,前提是存在兼容性測試、確定性模擬和形式化描述,Agent 能拿到可靠反饋。
- Agent 的角色在擴展:從寫代碼延伸到持續找邊緣問題、對抗測試和協助用戶遷移。
對技術負責人的影響
- AI Coding 會放大下游負載:提交量增長會傳導到 CI、代碼審查和代碼託管。OpenAI 在 2026 年 7 月另文披露,內部每週 PR 數量較此前第四季度增長超過一倍,代碼審查成爲新瓶頸之一。
- 不必盲目自建 Pando:大型 Monorepo 的規模問題並非 AI 時代纔有,絕大多數團隊並不需要重建 Git 後端。
與 Harness Engineering 案例的對照
2026 年 2 月,OpenAI 披露了另一個獨立項目:從空倉庫開始,產品代碼由 Codex 編寫,約五個月產生百萬行量級代碼、約 1,500 個 PR,初期由三名工程師驅動。它和 Pando 不是同一團隊和流程,數據不能混寫,但兩者指向同一趨勢:工程師越來越多承擔系統設計、測試環境和 Agent 工作流設計。該項目的經驗包括拆分小任務、爲每個分支提供獨立運行環境、向 Agent 開放日誌和指標、用 AGENTS.md 提供指引而不是把整個知識庫塞進提示詞。
Hacker News 上也有不同聲音:質疑者認爲 Commit 增長不等於質量提升,支持者認爲寫代碼成本下降讓更多小項目變得可行。這些是社區觀點,不是統計結論。
如何借鑑 Codex Agent 團隊的方法:測試驅動反饋環
Pando 最可遷移的不是規模,而是“讓 Agent 拿到可執行反饋”的結構。下面是一個最小化的測試驅動循環,模型生成補丁,測試結果迴流給模型繼續修改。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # API易 OpenAI 兼容接口
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # 替換爲你要測試的編程模型
    messages=[{"role": "user", "content": "根據以下失敗測試修複函數:..."}]
)
print(resp.choices[0].message.content)
查看完整的測試反饋環實現
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是嚴格遵守約束的工程 Agent。"
    "只修改指定文件,不得改動測試;輸出完整的新文件內容。"
)

def run_tests() -> tuple[bool, str]:
    """運行可執行驗證,相當於 Pando 中的兼容性測試"""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 輪:測試全部通過,等待人工審覈")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求與約束:\n{spec}\n\n當前代碼:\n{source}\n\n測試輸出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("達到輪次上限,轉交人類工程師處理")
    return False

agent_loop("src/ref_store.py", "同一分支的併發更新必須只有一個成功")
🚀 快速開始:搭建這類反饋環時,可以先通過 API易 apiyi.com 獲取免費測試額度,用同一個 API Key 切換不同編程模型,對比它們在你的測試集上的修復成功率。
把 Pando 的做法抽象成普通團隊可執行的框架,可以參考下表。這是基於官方披露整理的建議,並非 OpenAI 公開的 Pando 專用工作流。
| 階段 | 關鍵動作 | 對應 Pando 實踐 | 可用工具 |
|---|---|---|---|
| 定目標與邊界 | 明確必須兼容的協議和不可妥協的指標 | 堅持 Git 協議兼容 | 設計文檔、AGENTS.md |
| 建驗證環境 | 兼容性測試、併發模擬、迴歸檢測 | Conformance 測試與確定性模擬 | pytest、屬性測試、TLA+ |
| Agent 分工執行 | 小任務、獨立分支、自動跑測試 | 多個 Agent 團隊實現 | 多模型調用,如 API易 apiyi.com |
| 人類審覈 | 審關鍵取捨、跨模塊依賴、安全影響 | 架構由人類工程師把控 | Code Review 規則 |
| 漸進投產 | 小流量起步、保持舊系統兼容 | 讀寫穿透代理、分批遷移 | 灰度發佈、監控指標 |
常見問題 FAQ
Q1:什麼是 Pando?
Pando 是 OpenAI 內部的 Git 兼容服務端後端,支撐其單體代碼庫的全部開發活動。它保留標準 Git 協議和客戶端,重新設計了引用更新、Packfile 存儲複用和緩存交付,目標是支撐大量 Agent 與工程師併發提交和讀取。
Q2:Pando 是不是一個人用 Codex 做出來的?
不是。官方表述是一名工程師設計核心架構、多個 Agent 團隊實現、少量工程師部署。官方沒有公開參與人數、代碼人工修改比例和 Agent 配置,也沒有說所有代碼都由 Codex 生成或沒有人工審覈。
Q3:Pando 什麼時候上線,能對外使用嗎?
Pando 於 2026 年 4 月開始承載生產流量,技術文章於 2026 年 11 月 2 日發佈。截至 2026 年 11 月 3 日,沒有公開的服務端、API、定價或開放日期。公開的只有 OpenAI 的 Git 客戶端 Fork 和部分上游補丁,這不等於 Pando 服務端開源。
Q4:10 周內完成了全部驗證工作嗎?
不能這樣理解。官方稱新模型陸續出現後持續用於改進 Pando,GPT-6 Astra 輔助的 Lean/TLA+ 形式化工作、數百小時的 Agent 會話和對抗測試,都無法確認全部發生在最初 10 周內,公開的 Git 補丁也大多晚於首次投產。
Q5:如何用 API 搭建類似的 Agent 測試反饋環?
建議從小模塊開始:
1. 在 API易 apiyi.com 註冊並獲取 API Key 和免費測試額度
2. 先寫好可執行的測試或兼容性檢查,再讓模型改代碼
3. 使用本文代碼,將 base_url 設爲 `https://api.apiyi.com/v1`,循環“生成—測試—迴流日誌”
由於是 OpenAI 兼容接口,切換不同模型只需修改 model 參數,便於比較修復效果。
Q6:普通團隊直接照搬 Pando 的方法有哪些限制?
主要有三點:一是成本未知,官方沒有公佈 Token 和基礎設施費用;二是 Pando 依賴高質量的驗證體系,沒有測試的項目讓 Agent 大量寫代碼風險更高;三是 10 周的結果不能外推到所有同規模項目。建議先在非核心模塊用 API易 apiyi.com 小額度試驗,確認反饋環有效後再擴大範圍。
Pando 與 Codex Agent 核心要點 Key Takeaways
- Pando 是什麼:OpenAI 內部 Git 兼容後端,約 10 周進入生產,未對外開放
- 爲什麼要建:Codex 推高併發提交,舊系統出現變慢、合併失敗等問題
- 人機分工:人類定架構與約束,Agent 做實現迭代,工程師負責部署
- 成功關鍵:兼容性測試、確定性模擬、形式化驗證提供可靠反饋
- 時間線邊界:後續新模型和驗證方法不能全部歸入最初 10 周
- 上線方式:讀寫穿透代理加分批切流,遷移不中斷日常開發
- 上手方式:先建測試,再通過 API易 apiyi.com 多模型驗證反饋環
總結
Pando 案例的核心要點:
- 規模倒逼基礎設施:AI Coding 帶來的提交增長會傳導到 Git、CI 和代碼審查,Pando 是這一壓力下的工程回應。
- Agent 的產出依賴驗證:Codex Agent 團隊之所以能參與基礎設施實現,是因爲有可執行的兼容性測試、併發模擬和形式化描述。
- 人類決策仍然關鍵:架構取捨、一致性邊界和生產遷移都由人類工程師負責。
對大多數團隊來說,可遷移的不是“10 周”這個數字,而是清晰約束、可執行測試、任務分工、持續反饋和人類關鍵決策這五個環節。不必追求全自動開發,先讓 Agent 在一個有完整測試的小模塊裏跑通反饋環,再逐步擴大範圍。
推薦通過 API易 apiyi.com 快速驗證效果,平臺提供 OpenAI 兼容接口和新用戶免費額度,方便在同一套反饋環中對比不同編程模型。
📚 參考資料
- OpenAI 官方技術文章 Scaling Git at OpenAI:Pando 架構、遷移與性能數據的主要來源
- 鏈接:
openai.com/index/scaling-git-at-openai -
說明: 2026-11-02 發佈,本文事實的核心依據
-
OpenAI Harness Engineering:另一個 Codex 主導開發的內部項目
- 鏈接:
openai.com/index/harness-engineering -
說明: 用於理解 Agent 工程方法論,與 Pando 數據不可混用
-
Custom Code Review Rules for Codex:AI Coding 帶來的代碼審查瓶頸
- 鏈接:
developers.openai.com/blog/custom-code-review-rules-for-codex -
說明: 披露內部每週 PR 數量增長與 AGENTS.md 審查規則
-
OpenAI 公開 Git Fork:客戶端改進代碼倉庫
- 鏈接:
github.com/openai/git -
說明: 包含 packfile-uri 等改進,不是 Pando 服務端源碼
-
OpenAI Git 補丁追蹤:上游貢獻記錄
- 鏈接:
oai-git.openai.chatgpt.site - 說明: 可覈實投產後的持續工程改進
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多 Agent 開發資料可訪問 docs.apiyi.com 文檔中心