作者注:把 Gemini 4 Neon 的公開分數按編程、知識工作、科學三塊拆開,逐項標註來源,幫你判斷哪類活適合交給它。
2026-11-18,Google 發佈了 Gemini 4 Neon,Sundar Pichai 在發佈帖裏把它的定位概括爲複雜軟件工程、知識工作和科學流程上“更快做完”。同一天,DeepMind 放出了模型卡,Artificial Analysis 也發佈了第三方測量文章和模型頁,公開數據一下子多了好幾套。
問題在於這幾套數字的口徑不同。Google 博客是官方自報;模型卡的對照表雖然列了 Claude Opus 5.5 和 GPT-6.2 Sol,但評估說明寫明非 Gemini 的結果默認來自各家自報;只有 Artificial Analysis 是第三方測量。本文以 2026-11-19 爲數據覈對日,逐項保留來源標籤,兩套對不上的數字都並排寫出,不做平均。
核心價值:讀完本文,你會拿到一張按任務類型看的表,知道 Gemini 4 Neon 在編程、讀材料、科學三塊裏哪幾項官方說第一,哪幾項模型卡里對手更高,哪幾項第三方只領先 1 分。
Gemini 4 Neon 核心要點:先看入口,再拆三塊
綜合分是大多數人最先看到的數字。Artificial Analysis 文章顯示,Gemini 4 Neon 在 xhigh 思考檔的智力分爲 61,綜合第 3,前面是 GPT-6.2 Astra(max)和 Claude Fable 5.2(max)。Google 博客(官方自報)給出的也是 61 和第 3,並補了一句“落後於更大、更慢的模型”。模型卡的 AA Index v5.0.1 一欄同樣是 61,對照的 Opus 5.5 爲 59,Sol 爲 57。
這個 61 在三處來源裏一致,但它只是一個入口。綜合分會把編程、讀材料、科學揉在一起,而你要交出去的活通常只屬於其中一塊。下表先把三類來源的性質說清楚,後面各節再逐塊拆。
| 來源 | 性質 | 本文用它看什麼 |
|---|---|---|
| Google 博客 | 官方自報 | 哪幾項 Google 自稱第一、各項分數 |
| DeepMind 模型卡 | 官方彙總,非 Gemini 結果多爲各家自報 | Neon 與 Opus 5.5、Sol 三列逐項對照 |
| Artificial Analysis 文章 | 第三方測量 | Coding Agent Index、GDP.pdf、MKA 等 |
| Artificial Analysis 模型頁 | 第三方測量,按思考檔分列 | 四檔思考的智力分差異 |
Gemini 4 Neon 在家族裏的位置
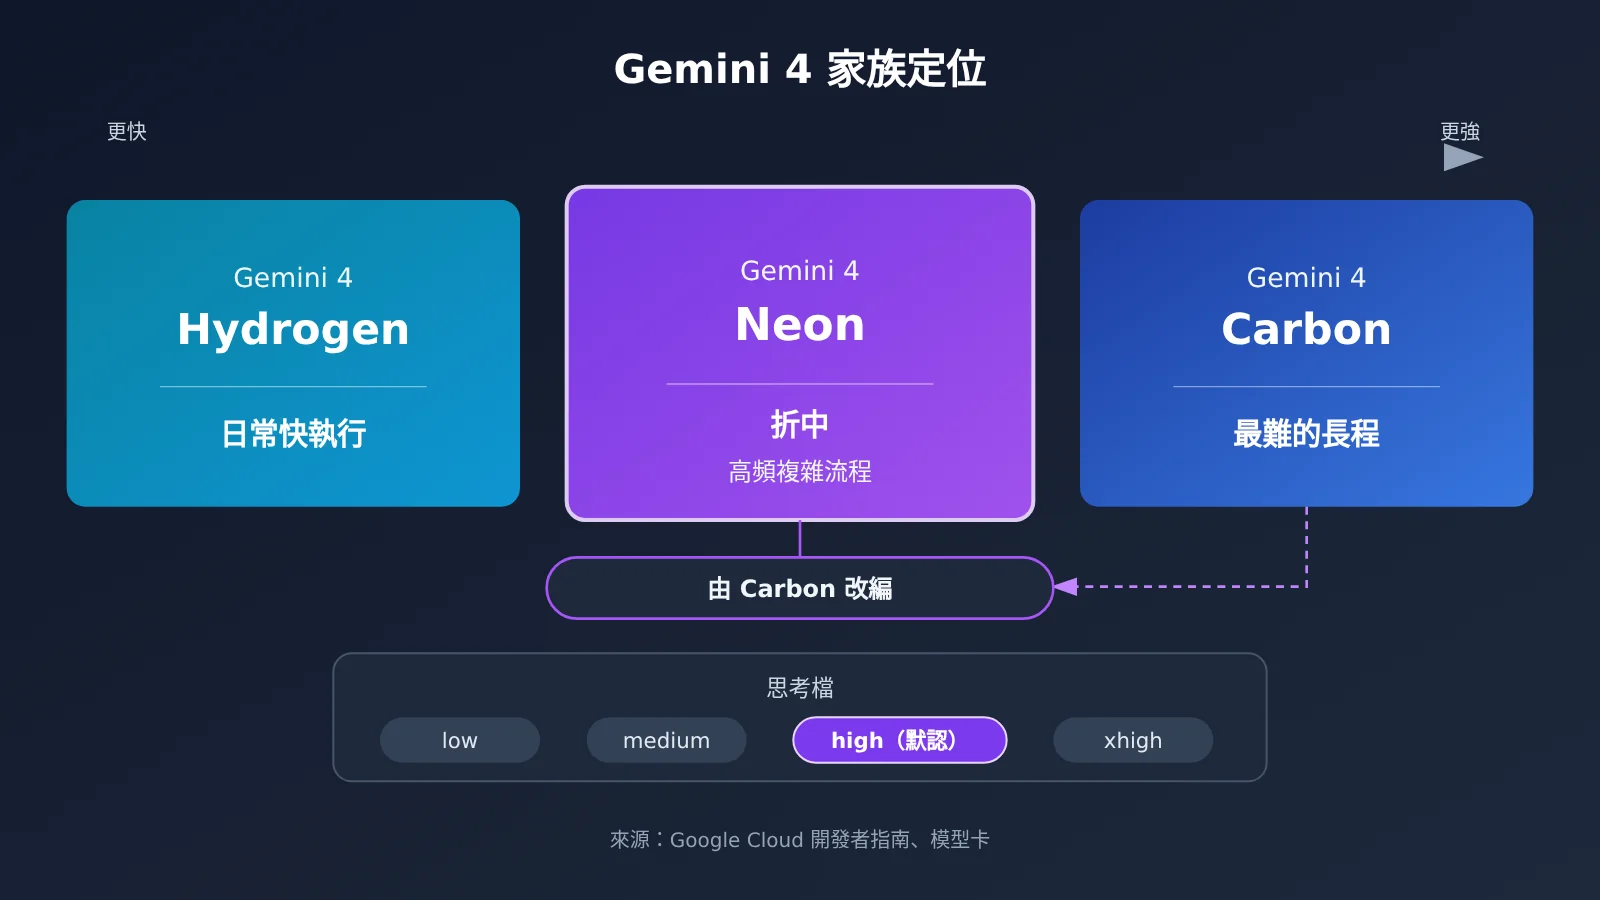
模型卡寫明 Gemini 4 Neon 由 Gemini 4 Carbon 改編,知識截止 2026 年 3 月,輸入支持文本、圖像、音頻、視頻,統一窗口最多 100 萬 token。Google Cloud 開發者指南把它放在 Hydrogen(日常快循環)和 Carbon(複雜長程)中間,官方博客也稱它面向高頻的複雜流程。
理解這個定位有助於讀後面的分數。Neon 的對照對象在不同來源裏不一樣:模型卡只有 Opus 5.5 和 Sol 兩列,沒有 Fable 5.2、Astra 和 Carbon;Artificial Analysis 則主要拿它和 Carbon、Fable、Opus 比。分項對照時,本文不會借用別的格子去填空。
Gemini 4 Neon 編程能力:兩處領先,兩處被 Opus 略超
編程是 Google 博客着墨最多的一塊。官方自報稱 Gemini 4 Neon 在 Artificial Analysis Coding Agent Index 上爲 58.6,總第 1。Artificial Analysis 文章給出的數字是 59,測量條件爲 Antigravity CLI 上的 Neon xhigh。58.6 和 59 來自兩個來源,本文兩個都保留。
第三方那邊的領先幅度需要單獨看。Artificial Analysis 文章裏,Claude Code 上的 Fable xhigh 和 Opus 5.5 max 都是 58,Carbon high 是 55。也就是說,Neon 對這兩個 Claude 模型的領先是 1 分。
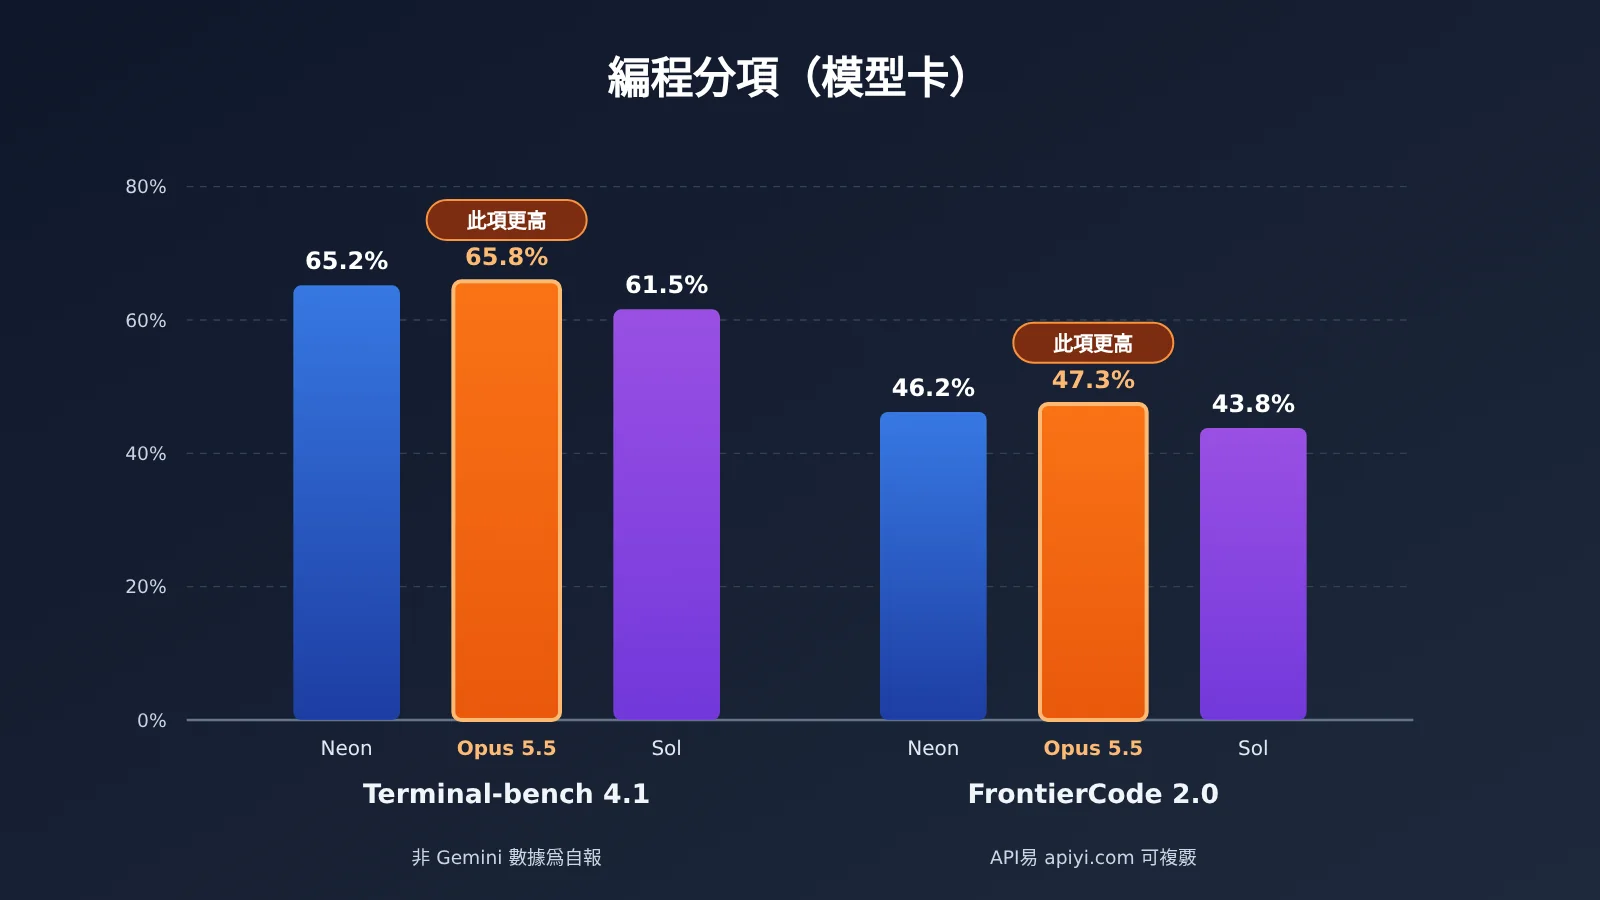
模型卡的分項則更細,其中有兩項是 Opus 5.5 更高。
| 編程項目(模型卡) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | 無 |
| Terminal-bench 4.1(作弊調整後) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep 廠商 harness | 39.0% | 10.1% | 8.3% |
| SWE-sweep mini-SWE harness | 12.8% | 3.6% | 11.6% |
Gemini 4 Neon 編程分數怎麼讀
Terminal-bench 4.1 上 Opus 5.5 是 65.8%,Neon 是 65.2%;FrontierCode 2.0 上 Opus 5.5 是 47.3%,Neon 是 46.2%。兩項差距都在一個百分點上下,但方向是 Opus 略高。官方博客裏 FrontierCode 2.0 的 46.2% 標註爲默認 high 檔。
SWE-sweep 的兩個數字最容易被誤讀。12.8% 是 mini-SWE harness 下的結果,39.0% 是在 Google Antigravity(廠商 harness)裏的結果。官方博客把兩者的差距描述爲 harness 帶來的解鎖,它反映的是工具鏈的作用,不能讀成模型本身相差三倍。還要注意,在 mini-SWE harness 下 Sol 是 11.6%,和 Neon 的 12.8% 相當接近。
Gemini 4 Neon 知識工作:多數領先,Chartography 是 Sol 更高
知識工作這一塊,官方博客列了不少“第 1”。Legal Research Bench 和 Tax Agent Bench 均稱第 1,但博客沒有給這兩項的百分數;Surge 上的金融、會計、表格建模、複雜約束任務也稱多數第 1,同樣沒給逐項分數。這些只能記作官方自報的排名,本文不補數字。
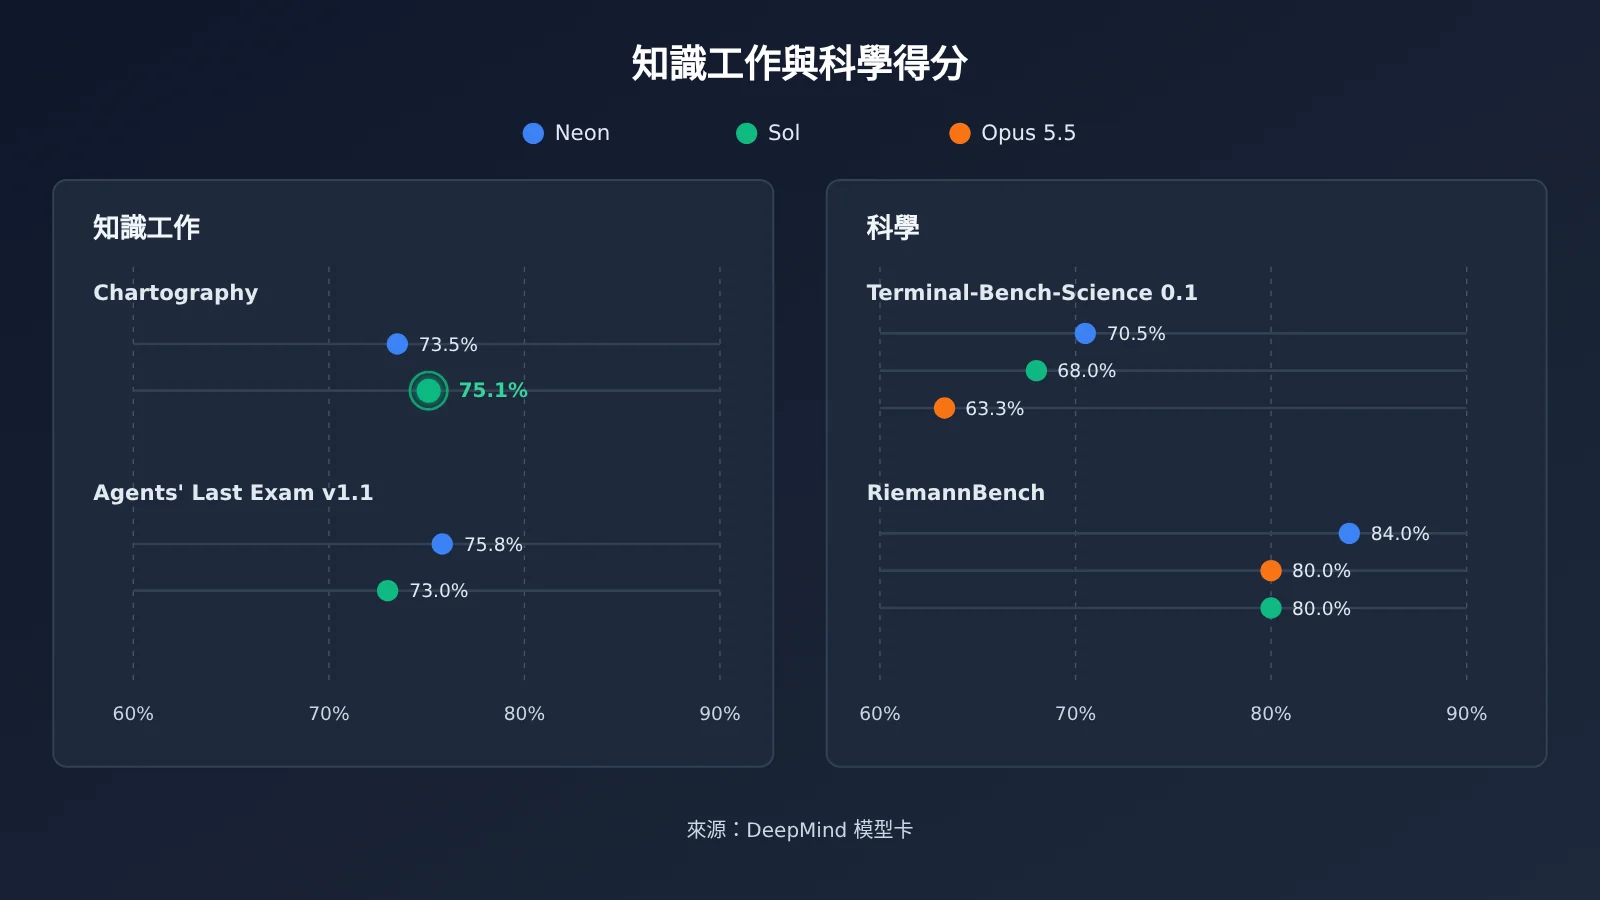
有分數的項目可以對照模型卡。Zapier AutomationBench 在官方博客裏是第 1、56.3%,Andon Labs Vending-Bench 2 第 1、16843 美元。Chartography 是本塊唯一一項 Sol 更高的分項:Sol 75.1%,Neon 73.5%。
第三方測量給了更多細節。Artificial Analysis 文章顯示,GDP.pdf 上 Neon high 爲 33.4%,Neon xhigh 反而是 28.0%,Carbon high 爲 28.4%,說明思考檔調高不一定換來更高分。AA-Briefcase 上 Neon xhigh 總分 1700 Elo,呈現質量 1771 Elo,高於 Claude Sonnet 5.5 max 的 1726。MKA 一項,Artificial Analysis 文章寫 Neon 56%,接近 Fable max 的 57%,比 Carbon 高 2 分;模型卡寫 56.5%,兩個數各自保留。
Gemini 4 Neon 科學能力:三項官方稱 best in class
科學是三塊裏官方措辭最強的一塊。Google 博客稱 Terminal-Bench Science 70.5%、RiemannBench 84.0%、HLE-Diamond 71.3% 三項 best in class,這是官方自報。模型卡的對照表與之一致,三項 Neon 都高於 Opus 5.5 和 Sol,但對照列同樣是各家自報彙總。
| 知識與科學項目(模型卡) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks(256k–1M,BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
GraphWalks 在 256k 到 1M 長上下文區間的 95.2%,與 Opus 5.5 的 66.8% 拉開較大,適合讀超長材料的場景重點關注。Terminal-Bench-Science 上 Sol 爲 68.0%,與 Neon 的 70.5% 相差 2.5 個百分點,是科學三項裏差距最小的一項。
Gemini 4 Neon 按任務看:一張總表
把三塊合起來,按“官方說第一”“模型卡對手更高”“第三方只領先 1 分”三種情況整理,就得到下面這張按任務看的表。它不回答誰全面最強,只告訴你每類任務的分數站在哪條證據上。
| 任務類型 | 官方自報第一 | 模型卡對手更高 | 第三方差距 1 分 |
|---|---|---|---|
| 編程 | Coding Agent Index 58.6 總第 1 | Terminal-bench 4.1、FrontierCode 2.0:Opus 5.5 更高 | Coding Agent Index 59 對 Fable xhigh、Opus 5.5 max 的 58 |
| 知識工作 | Legal Research Bench、Tax Agent Bench、AutomationBench、Vending-Bench 2 | Chartography:Sol 更高 | MKA 56% 對 Fable max 57%(Neon 低 1 分) |
| 科學 | Terminal-Bench Science、RiemannBench、HLE-Diamond | 無 | 無單列第三方科學分 |
| 綜合入口 | Vals Index 第 2(70.9%) | 無 | AA 智力分 61,比 Carbon high 高 1 分 |
Gemini 4 Neon 優缺點分析
優勢
- 科學三項一致領先:官方自報與模型卡均顯示 Terminal-Bench Science、RiemannBench、HLE-Diamond 高於兩個對照模型。
- 長上下文讀取強:模型卡 GraphWalks 在 256k–1M 區間 BFS F1 爲 95.2%,對應 100 萬 token 統一窗口。
- 工具鏈放大明顯:SWE-sweep 在廠商 harness 下 39.0%,說明配合 Antigravity 這類 agent 環境時收益較大。
- 多模態輸入齊全:模型卡寫明支持文本、圖像、音頻、視頻輸入;Artificial Analysis 模型頁顯示 Opus 5.5 輸入只有文本和圖像。
侷限
- 編程並非逐項第一:Terminal-bench 4.1 和 FrontierCode 2.0 上 Opus 5.5 略高,純終端或前沿代碼任務建議兩者都測。
- 圖表理解有對手更高:Chartography 上 Sol 更高,圖表密集的報表任務可把 Sol 納入對比。
- 高檔位不保證更高分:Artificial Analysis 文章中 GDP.pdf 的 xhigh 低於 high,思考檔需要按任務調。
- 參數約束較嚴:開發者指南寫明傳
thinking_budget或MINIMAL會返回HTTP 400,顯式上下文緩存不支持,只走 4096 token 以上共享前綴的隱式緩存。
價格和速度本文只留一句:單任務成本與 Carbon 的比較存在 Google 自報低 32%、Artificial Analysis 文章約少 17% 等不同口徑,留給計價專篇展開;各思考檔的耗時與輸出速度留給速度專篇。
Gemini 4 Neon 快速上手:先定任務,再定思考檔
上手順序建議分三步:先按上面的總表選定任務類型,再選定思考檔,最後去 API易 總表覈對已上架的 Gemini 4 家族型號是否夠用。
- 選任務類型:科學推理、長材料閱讀優先看 Neon 的強項;終端編程、圖表理解則把 Opus 5.5 或 Sol 一起列入候選。
- 選思考檔:開發者指南寫明 Neon 只有
low、medium、high、xhigh四檔,默認high。Artificial Analysis 模型頁顯示四檔智力分分別爲 44、55、60、61,high到xhigh只差 1 分,GDP.pdf 上high反而更高,所以多數任務從默認檔開始即可。 - 覈對可用型號:編排類任務可參考開發者指南的做法,把主控交給強模型、把快速子任務交給
gemini-4-hydrogen;最難的長程任務看gemini-4-carbon。
調用地址方面,OpenAI 兼容接口把 base_url 設爲 https://api.apiyi.com/v1,Gemini 原生接口使用 https://api.apiyi.com 並選擇 v1beta 版本。鑰匙從環境變量讀取,例如 APIYI_API_KEY,不要把明文鑰匙寫進代碼。調用時 model 填 gemini-4-carbon 或 gemini-4-hydrogen 即可,兩者在 API易 總表裏的端點都是 chat 與 gemini。
下表是 2026-11-16 更新的 API易 總表(docs.apiyi.com/models.md)與 2026-11-19 查詢的定價接口(api.apiyi.com/api/pricing,共 285 個模型)中可用來對照的型號,單位爲美元每百萬 token。
| 模型 ID | 輸入 | 緩存讀 | 輸出 | 可用平臺 |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | API易 總表、定價接口 |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | API易 總表、定價接口 |
claude-opus-5-5 |
4 | 0.2 | 20 | API易 總表、定價接口 |
gpt-6.2-sol |
2(超 272000 token 輸入爲 3) | 0.1 | 10(定價接口高檔約 11.25) | API易 總表、定價接口 |
gemini-4-carbon 的 2/10 是 API易當前貨架價,對應 Google 到 2026-11-30 的介紹價。Gemini 4 Neon 在 Google AI Studio 定價頁的標價爲輸入 3.00、輸出 15.00 美元每百萬 token,無免費檔;它在 API易總表和定價接口裏都還沒有出現。暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。
🚀 上手建議:在 Neon 上架前,可以先通過 API易 apiyi.com 用同一把 Key 分別調用
gemini-4-carbon、claude-opus-5-5和gpt-6.2-sol,把你自己的編程或報表任務各跑一遍,先確定哪類任務需要 Neon 級別的能力。
常見問題 FAQ
Q1:Gemini 4 Neon 是什麼定位的模型?
Google 於 2026-11-18 發佈的 Gemini 4 家族中間檔,由 Carbon 改編,開發者指南將其放在 Hydrogen 與 Carbon 之間,官方博客稱其面向高頻的複雜流程。模型 ID 爲 `gemini-4-neon`。
Q2:Gemini 4 Neon 綜合分 61 排第幾?
Artificial Analysis 文章顯示 xhigh 檔 61 分、綜合第 3,前面是 GPT-6.2 Astra(max)和 Claude Fable 5.2(max)。Google 博客與模型卡的 61 與之一致,但綜合分只適合當入口,分項要按任務看。
Q3:Coding Agent Index 到底是 58.6 還是 59?
兩個都對,來源不同。58.6 是 Google 博客(官方自報)的數字,59 是 Artificial Analysis 文章在 Antigravity CLI 上測 Neon xhigh 的數字。兩者不應合成或平均。
Q4:SWE-sweep 的 12.8% 和 39.0% 差這麼多,說明什麼?
它們是兩個 harness 的結果:12.8% 來自 mini-SWE harness,39.0% 來自 Google Antigravity。官方博客把差距歸爲 harness 的解鎖作用,選型時應關注你實際使用的 agent 環境。
Q5:哪些項目裏對手比 Gemini 4 Neon 更高?
模型卡中 Terminal-bench 4.1 與 FrontierCode 2.0 是 Claude Opus 5.5 略高,Chartography 是 GPT-6.2 Sol 略高。Artificial Analysis 文章中 MKA 是 Fable max 的 57% 高於 Neon 的 56%。
Q6:現在能通過 API 調用 Gemini 4 Neon 嗎?
Google 側已在 AI Studio 的 Gemini API 等渠道推出。API易 apiyi.com 的總表與定價接口目前沒有 `gemini-4-neon`,暫未上架,我們會盡快上架這個模型;型號與價格以平臺型號列表爲準。
Q7:上架前可以先用什麼型號替代測試?
可在 API易 apiyi.com 用 OpenAI 兼容地址 `https://api.apiyi.com/v1` 調用 `gemini-4-carbon` 或 `gemini-4-hydrogen`,同一把 Key 還能切到 `claude-opus-5-5`、`gpt-6.2-sol` 做橫向對照,新用戶有免費測試額度。
Q8:Gemini 4 Neon 有哪些調用限制?
開發者指南寫明:思考檔只有 `low` 到 `xhigh` 四檔,傳 `thinking_budget` 或 `MINIMAL` 返回 `HTTP 400`;不支持顯式上下文緩存;統一上限 1048576 token 含輸入和輸出,單段默認最多輸出 65536。
Gemini 4 Neon 核心要點 Key Takeaways
- 綜合分只是入口:AA 智力分 61、第 3 在三處來源一致,選型仍要按任務拆。
- 編程有兩項被超:模型卡中 Terminal-bench 4.1、FrontierCode 2.0 是 Opus 5.5 略高。
- 編程第三方領先 1 分:Coding Agent Index 59 對 Fable xhigh、Opus 5.5 max 的 58。
- 知識工作多數領先:Chartography 是 Sol 更高,GraphWalks 長上下文優勢最明顯。
- 科學三項官方稱 best in class:模型卡對照中同樣領先,但對手數據爲各家自報。
- 思考檔從 high 起步:high 與 xhigh 智力分只差 1,GDP.pdf 上 high 更高。
- 上手先測已上架型號:Neon 上架前,可在 API易 apiyi.com 用 Carbon、Hydrogen 先跑任務。
總結
Gemini 4 Neon 有多強,按三塊分開看會清楚得多:
- 編程:官方自報 Coding Agent Index 第一,第三方只領先 1 分,模型卡里 Opus 5.5 有兩項略高。
- 知識工作:AutomationBench、長上下文 GraphWalks 等多數領先,Chartography 是 Sol 更高。
- 科學:三項官方稱 best in class,模型卡對照一致領先,是三塊裏證據最整齊的一塊。
建議先把你的任務歸到其中一類,再對照本文的總表決定是否需要 Neon。上架前可以通過 API易 apiyi.com 用統一接口調用 Gemini 4 Carbon、Hydrogen 以及 Opus、Sol 做對照,等 gemini-4-neon 上線後直接替換模型 ID 複測。
📚 參考資料
-
Google 博客 – Introducing Gemini 4 Neon:官方發佈文與自報分數
- 鏈接:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - 說明: 官方自報的排名、編程與科學分數
- 鏈接:
-
DeepMind 模型卡 – Gemini 4 Neon:三列對照表與模型規格
- 鏈接:
deepmind.google/models/model-cards/gemini-4-neon/ - 說明: Neon、Opus 5.5、Sol 的逐項分數,非 Gemini 結果默認來自各家自報
- 鏈接:
-
Google Cloud 開發者指南 – Gemini 4 Neon:參數與調用約束
- 鏈接:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - 說明: 思考檔、token 上限、緩存與錯誤碼
- 鏈接:
-
Artificial Analysis 文章 – Gemini 4 Neon intelligence gain:第三方測量
- 鏈接:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - 說明: Coding Agent Index 59、GDP.pdf、MKA 等
- 鏈接:
-
Artificial Analysis 模型頁 – Gemini 4 Neon:按思考檔分列的指數
- 鏈接:
artificialanalysis.ai/models/gemini-4-neon - 說明: 四檔智力分對照
- 鏈接:
-
API易 模型總表:已上架型號與價格
- 鏈接:
docs.apiyi.com/models.md - 說明: 型號與價格以平臺型號列表爲準
- 鏈接:
作者:APIYI 技術團隊
技術交流:歡迎在 API易 網站首頁聯繫我們,更多資料可訪問 docs.apiyi.com 文檔中心