作者注:同样标着“千万 Token”的两个套餐,实际能完成的任务量可能相差数倍。本文提供一套可落地的换算方法,帮你判断该选订阅还是按量付费。
比较 Token 套餐额度时,很多开发者的第一反应是看“每月多少 Token、每月多少钱”,然后直接算单价。这种算法看似合理,却忽略了缓存、输出、模型倍率和时间窗口的差异。本文将介绍 “单任务等效成本”换算法,帮你把不同套餐放到同一把尺子上比较。
这不是一篇“订阅更划算”或“按量更灵活”的泛泛之谈,而是一套用你自己的用量数据得出结论的方法。文中不引用未经核实的价格,涉及 API易 的模型单价和计费口径,请以价格页 https://docs.apiyi.com/models 的实际数据为准。
核心价值:读完本文,你将学会读取 Token 用量字段、拆分计费口径、计算盈亏平衡点,并做出适合自己的选择。
Token 套餐额度核心要点
Token 只是计量单位,并不是统一的价值单位。输入、输出和缓存读取的 Token 单价往往不同,部分套餐还会按模型设置倍率,因此名义额度相同,不代表实际价值相同。
| 要点 | 说明 | 对选择的影响 |
|---|---|---|
| 计数口径 | 是否把缓存读取、缓存写入和推理 Token 计入额度 | 决定同一任务消耗多少额度 |
| 模型权重 | 不同模型可能按不同倍率扣减额度 | 决定高端模型实际能用多久 |
| 时间窗口 | 可能存在小时级、周级或月度限额 | 决定额度能否在高峰期用上 |
| 额度形态 | 可能以 Token、请求数、积分或消息数计量 | 决定能否与其他方案直接比较 |
| 任务结构 | 上下文长度、对话轮次、缓存命中率各不相同 | 决定最终的单任务成本 |
为什么 Token 套餐额度的数字会失真
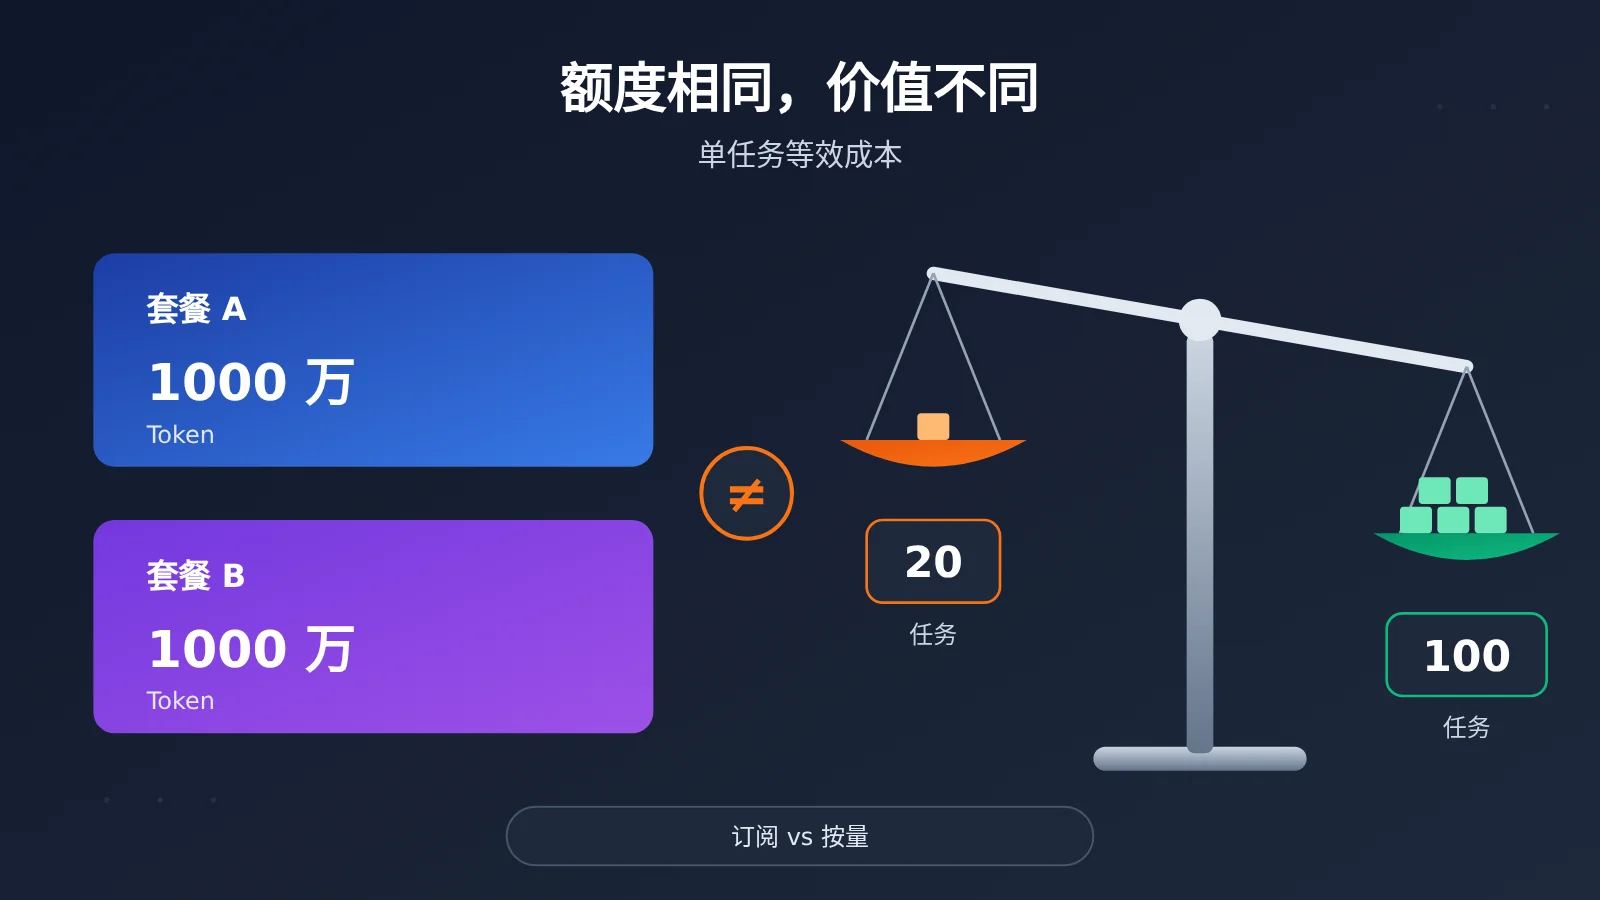
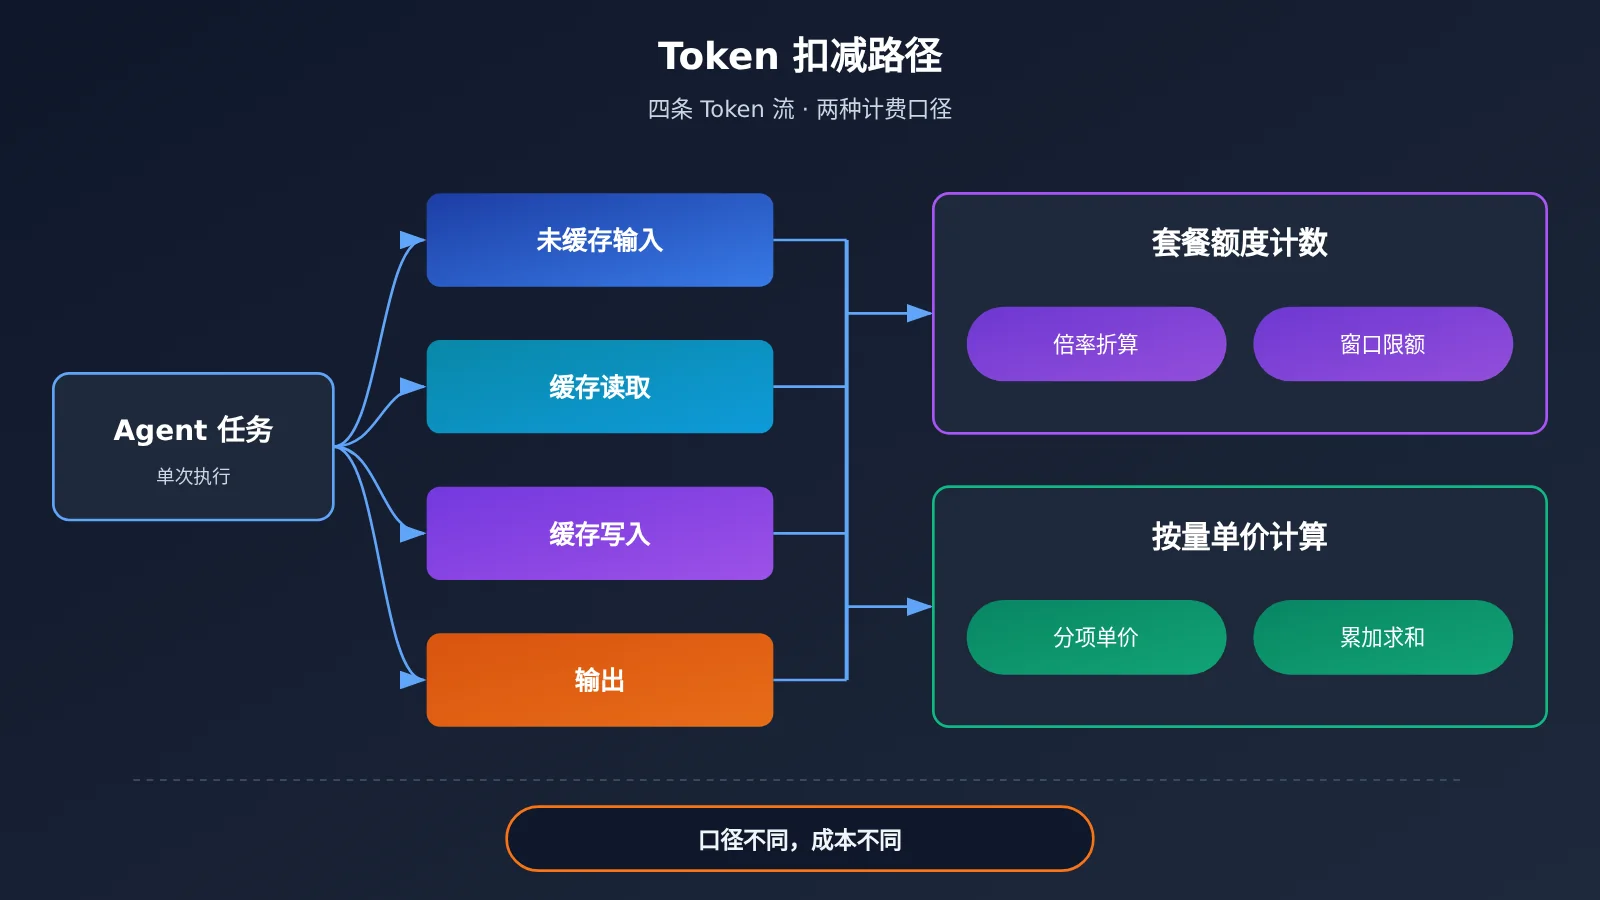
同一个编程 Agent 任务,可能因为反复发送上下文而产生大量缓存读取 Token。假设一个任务共产生 50 万 Token,其中缓存读取 40 万、未缓存输入 6 万、输出 4 万,以下数据均为说明方法的示例,不代表任何真实套餐。
如果套餐 A 把全部 Token 都计入额度,1000 万额度大约能跑 20 个这样的任务。如果套餐 B 不计缓存读取,同样的任务只消耗 10 万额度,1000 万额度大约能跑 100 个。两者名义额度一样,实际可完成的任务量却相差 5 倍。
Token 套餐额度的常见计费口径
下表列出了对比时最容易遗漏的口径。不同厂商的定义并不完全一致,购买前应逐项查阅官方说明,不要根据名称自行推断。
| 计费项 | 含义 | 常见陷阱 | 核对方式 |
|---|---|---|---|
| 未缓存输入 | 首次发送、未命中缓存的提示内容 | 长上下文会被多次计量 | 查看用量明细 |
| 缓存读取 | 命中提示缓存的输入内容 | 可能占总量的大头,计入规则差异大 | 查看套餐规则和价格页 |
| 缓存写入 | 将内容写入缓存时产生的用量 | 单价可能与普通输入不同 | 查看模型价格说明 |
| 输出 | 模型生成的内容 | 单价通常高于输入,长输出影响明显 | 查看模型价格说明 |
| 推理 Token | 推理模型思考过程产生的用量 | 用户看不到正文,但可能按输出计费 | 查看响应中的用量字段 |
API易 的按量计费数据,请统一以价格页 https://docs.apiyi.com/models 的实际标注为准。不同模型的单价和缓存规则可能不同,建议按实际使用的模型逐一核对。
Token 套餐额度快速上手:5 步算清订阅与按量付费
下面的方法不需要编写复杂工具,一张电子表格就能完成。关键是使用真实任务的数据,而不是凭感觉估算月用量。
第 1 步:采集真实任务的 Token 用量
挑选 3 到 5 类最常见的任务,例如修复一个 Bug、生成一份周报、处理一批客服工单。每类任务至少记录 5 到 10 次,以降低偶然波动的影响。复杂任务和简单任务的消耗可能差距很大,不建议只用一次结果代表全部情况。
如果你已经通过 API 调用模型,可以从响应的 usage 对象中读取用量。两种常见接口格式的字段含义并不相同,汇总时要特别留意:
| 用量项 | OpenAI 格式字段 | Anthropic 格式字段 | 汇总注意事项 |
|---|---|---|---|
| 输入 | prompt_tokens |
input_tokens |
前者通常已包含缓存命中部分,后者通常不包含缓存读写部分 |
| 缓存读取 | prompt_tokens_details.cached_tokens |
cache_read_input_tokens |
OpenAI 格式应从输入中扣除后再计算未缓存部分 |
| 缓存写入 | 视模型和接口返回情况而定 | cache_creation_input_tokens |
单独记录,并按对应单价计算 |
| 输出 | completion_tokens |
output_tokens |
关注长输出任务的占比 |
| 推理 | completion_tokens_details.reasoning_tokens |
视模型和接口返回情况而定 | 避免与输出重复相加 |
第 2 步:计算按量付费的单任务等效成本
把采集到的用量取平均值,再查询目标模型的单价。计算公式如下:
单任务按量成本 = 未缓存输入 × 输入单价 + 缓存读取 × 缓存读取单价 + 缓存写入 × 缓存写入单价 + 输出 × 输出单价
公式中的所有单价都应取自价格页,不要沿用旧截图或第三方转载的数字。如果价格按每百万 Token 标注,计算前记得统一单位。使用 API易 时,请以 https://docs.apiyi.com/models 展示的模型价格和计费口径为准。
第 3 步:把订阅额度换算成可完成任务数
订阅方案的关键指标不是总 Token,而是“在限额内能完成多少个任务”。先确认套餐的扣减规则,再用下面的公式估算:
月度可完成任务数 = 月度有效额度 ÷(单任务计费 Token × 模型倍率)
如果套餐以请求数或积分计量,就把分母换成单任务的平均请求数或积分消耗。规则没有公开时,可以在试用期内跑几个标准任务,观察额度变化并进行反推。这样得到的只是估算值,应在表格中明确标注。
第 4 步:用时间窗口修正 Token 套餐额度
月度总量够用,不代表高峰期也够用。如果套餐有小时级或周级窗口,还需要用峰值用量进行校验:
实际可用任务数 = min(月度可完成任务数,各时间窗口累计可完成任务数)
举例来说,开发者可能在冲刺周集中产生大部分用量,而周限额会提前触顶。此时额外的等待时间也是成本,尤其是在任务不能中断的情况下,因此这一步不能省略。
第 5 步:计算订阅与按量付费的盈亏平衡点
最后比较两个数字。第一个是盈亏平衡任务量,第二个是你每月真正需要完成的任务量:
盈亏平衡任务量 = 订阅月费 ÷ 单任务按量成本
判断规则可以简化为三条:
- 月任务量明显高于平衡点,且实际可用任务数能覆盖需求:优先考虑订阅。
- 月任务量低于平衡点,或者用量波动很大:优先考虑按量付费。
- 月任务量接近平衡点:选择更灵活的方案,并在下一个计费周期复算。
快速上手建议:想采集真实用量,可以通过 API易 apiyi.com 用同一批提示词测试不同模型,再把
usage数据填入表格。这样可以减少逐一适配接口的工作量,也方便统一比较。
通过 API易 采集 Token 用量的接入方式
API易 提供本文讨论的主流模型 API 调用,兼容 OpenAI 与 Anthropic 接口格式。现有项目通常只需调整接入配置,就能开始采集用量,具体模型是否可用请以价格页为准。
- 在 API易 apiyi.com 注册账号,并在控制台创建 API Key。
- OpenAI 兼容格式可将
base_url设置为https://api.apiyi.com/v1;Anthropic 格式的接入地址和请求头请按文档说明配置。 - 将
model设置为价格页列出的模型名称,发送标准任务并记录响应中的usage。 - 按模型在
https://docs.apiyi.com/models核对单价,再代入第 2 步的公式。
完整接入说明见 API易 文档:https://docs.apiyi.com。
Token 套餐额度方案对比:订阅、按量与混合
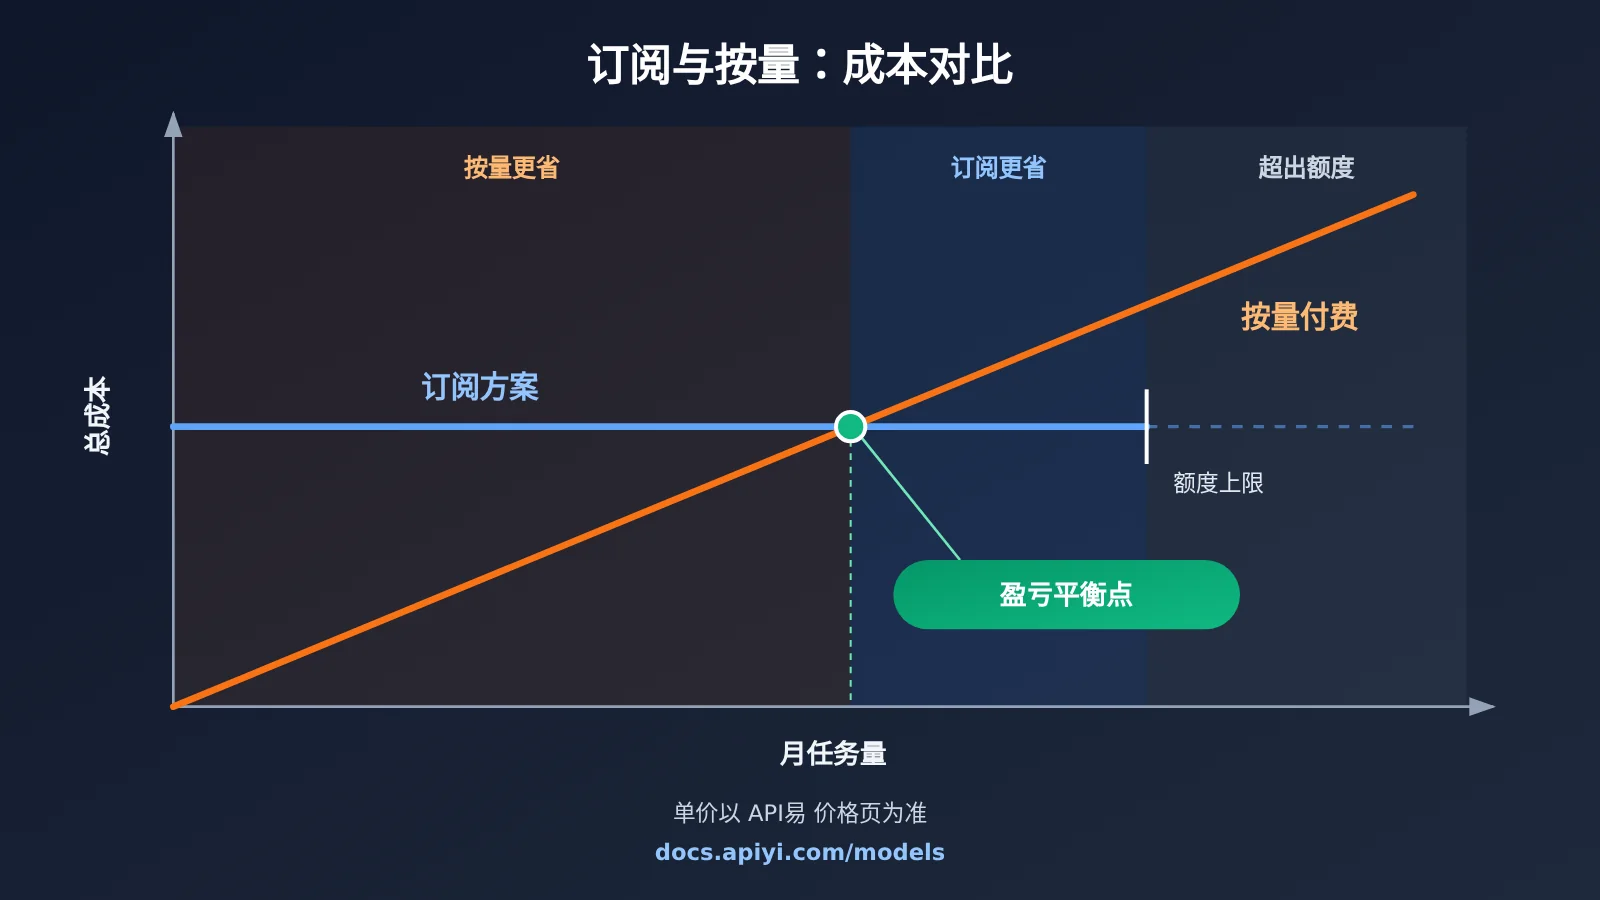
上图的交点因人而异,它取决于你的任务结构和所选模型。下表从决策维度对三种方案进行比较,不涉及具体价格。
| 对比维度 | 订阅方案 | 按量付费 | 混合方案 |
|---|---|---|---|
| 成本特征 | 月费相对固定 | 随用量变化 | 固定支出加弹性支出 |
| 主要风险 | 额度闲置或提前触顶 | 用量突增导致账单上升 | 两套账单增加管理成本 |
| 更适合 | 高频且稳定的日常开发 | 低频、波动或程序化调用 | 日常用量稳定但有峰值 |
| 模型切换 | 受套餐支持范围限制 | 通常更灵活 | 主力固定,其他按需调用 |
| 价格依据 | 以官方套餐页面为准 | 使用 API易 时以 https://docs.apiyi.com/models 为准 |
分别按对应页面核算 |
不同场景如何选择订阅或按量付费
高频个人开发者:如果你每天主要在固定工具中工作,用量也比较稳定,可以优先测算订阅方案。但要重点确认高峰窗口是否够用,以及缓存读取是否计入额度。
产品和后端服务:面向用户的线上功能通常更适合按量付费,因为调用量难以预测,也需要清晰的成本归因。同时要留意订阅服务的条款,部分订阅不一定允许用于生产服务或转售。
小团队:先分别统计每位成员的实际用量,不要默认所有人都需要同等级订阅。高频成员可以使用订阅,低频成员和自动化脚本使用按量付费,整体安排通常更容易匹配实际需求。
模型评估阶段:这个阶段还没有形成稳定的用量模式,按量付费更便于小规模验证。可以通过 API易 用统一接口调用多个模型,测试完成后再决定长期方案。
常见问题 FAQ
Q1:什么是 Token 套餐额度?
Token 套餐额度是服务商在一定周期内提供的用量上限。它可能直接按 Token 计算,也可能折算成积分、请求数或消息数。比较时要先确认扣减规则,不能只看名义数字。
Q2:Token 套餐额度和按量计费有什么区别?
套餐通常是预先支付固定费用,在限额内使用;按量计费则根据实际用量和模型单价结算。前者便于控制预算,但可能闲置或触顶;后者更灵活,但需要做好用量监控。
Q3:Token 套餐额度的规则多久需要复核一次?
建议每个续费周期复核一次,在模型升级、任务结构变化或套餐调整时立即复算。模型价格、倍率和限额都可能调整,旧结论不一定继续成立。价格信息应以官方页面的当前内容为准。
Q4:缓存命中率高时,一定更适合订阅吗?
不一定。缓存读取单价通常与普通输入不同,按量成本可能明显下降;但如果套餐把缓存读取也计入额度,额度反而消耗得很快。应把两种方案分别代入公式计算。
Q5:如何通过 API 快速验证 Token 成本?
可以准备 3 到 5 类标准任务,通过 API易 apiyi.com 调用候选模型,并记录 `usage` 字段。平台兼容 OpenAI 与 Anthropic 接口格式,便于复用现有代码。接入方法见 `https://docs.apiyi.com`。
Q6:在哪里查询 API易 的模型价格?
请访问 `https://docs.apiyi.com/models`。模型的输入、输出、缓存价格和计费口径,都以该页面的实际数据为准。建议计算前核对模型名称和价格单位,不要使用转载内容中的数字。
Q7:这套 Token 套餐额度换算方法有什么局限?
它依赖样本的代表性,样本太少时误差会比较大。部分套餐的倍率和限额没有完全公开,只能通过测试反推。此外,公式没有直接量化模型质量和返工成本,如果某模型需要反复重试,应把重试消耗一并计入。
Q8:可以同时使用订阅和按量付费吗?
可以,这也是用量有明显峰值时常见的做法。日常稳定任务由订阅承担,自动化脚本和超出限额的任务走 API 按量计费。实施时要分别统计两部分开支,并确认使用方式符合相应服务条款。
Token 套餐额度核心要点 Key Takeaways
- 名义额度不等于实际价值:同样的 Token 数量,可能对应差距很大的任务量。
- 先统一计费口径:逐项核对缓存读写、输出、推理 Token 和模型倍率。
- 用任务作为比较单位:比较可完成任务数,比比较每百万 Token 单价更可靠。
- 时间窗口必须纳入计算:月度总量够用,高峰期仍可能提前触顶。
- 用平衡点辅助决策:用订阅月费除以单任务按量成本,再与真实需求对比。
- 用真实数据验证:可通过 API易 统一调用模型,并按其价格页核算成本。
总结
Token 套餐额度不能直接比较,是因为相同的数字背后可能是不同的计费口径、模型权重和使用限制。要在订阅和按量付费之间做选择,可以按下面的顺序操作:
- 采集用量:记录真实任务的输入、缓存、输出和推理 Token。
- 计算成本:根据当前价格页算出单任务按量成本。
- 换算额度:把订阅额度转换成考虑倍率和时间窗口后的可完成任务数。
- 比较需求:用盈亏平衡任务量对照每月实际需求,选择订阅、按量或混合方案。
建议先用一周的真实任务完成第一次测算,并在每个续费周期更新数据。需要跨模型验证时,可以通过 API易 apiyi.com 使用统一接口进行测试,价格请以 https://docs.apiyi.com/models 为准。
📚 参考资料
- API易 模型与价格页:查询模型价格和计费口径
- 链接:
docs.apiyi.com/models -
说明:本文涉及 API易 价格和计费口径的内容,均以该页面的实际数据为准
-
API易 文档中心:接口接入说明
- 链接:
docs.apiyi.com -
说明:包含接入配置和使用说明,适合在测试前查阅
-
OpenAI 官方文档:API 与用量字段说明
- 链接:
platform.openai.com/docs -
说明:可用于核对 OpenAI 格式响应中的
usage字段含义 -
Anthropic 官方文档:Messages API 与提示缓存说明
- 链接:
docs.anthropic.com - 说明:可用于核对 Anthropic 格式的缓存读写用量字段
作者:API易 技术团队
技术交流:欢迎在 API易 apiyi.com 网站首页联系我们,更多资料可访问 docs.apiyi.com 文档中心