Примечание автора: отвечаю на вопрос о счетах за API. Базовые тарифы на модели за последние месяцы упали очень заметно, но кодинг-агенты по-прежнему влетают в копеечку. Все цены выверены по официальным прайс-листам, актуальным на 26.10.2026, а также по странице тарифов моделей APIYI. Цифра в 96% — это личная оценка стороннего автора, а не наши собственные замеры.
С 26 июня по 29 сентября 2026 года (примерно за четыре месяца) OpenAI и Anthropic по очереди переписывали ценники. Макс Вульф (Max Woolf) 25 октября 2026 года подробно расписал эту хронологию на minimaxir.com/2026/10/cheap-llms, заявив в заголовке о падении цен вплоть до 80%. В статье он отмечает: в сценариях с кодинг-агентами чтение из кэша съедает от 96% до 99% всех расходов на токены. Логика простая: на каждом шаге вся предыдущая история диалога повторно вычитывается из кэша, при этом cache hit rate составляет около 90%–100% в зависимости от инференс-провайдера. В оригинале подробных логов запросов для проверки не приводилось, так что будем считать это экспертной оценкой со стороны — полагайтесь в первую очередь на собственные метрики потребления.
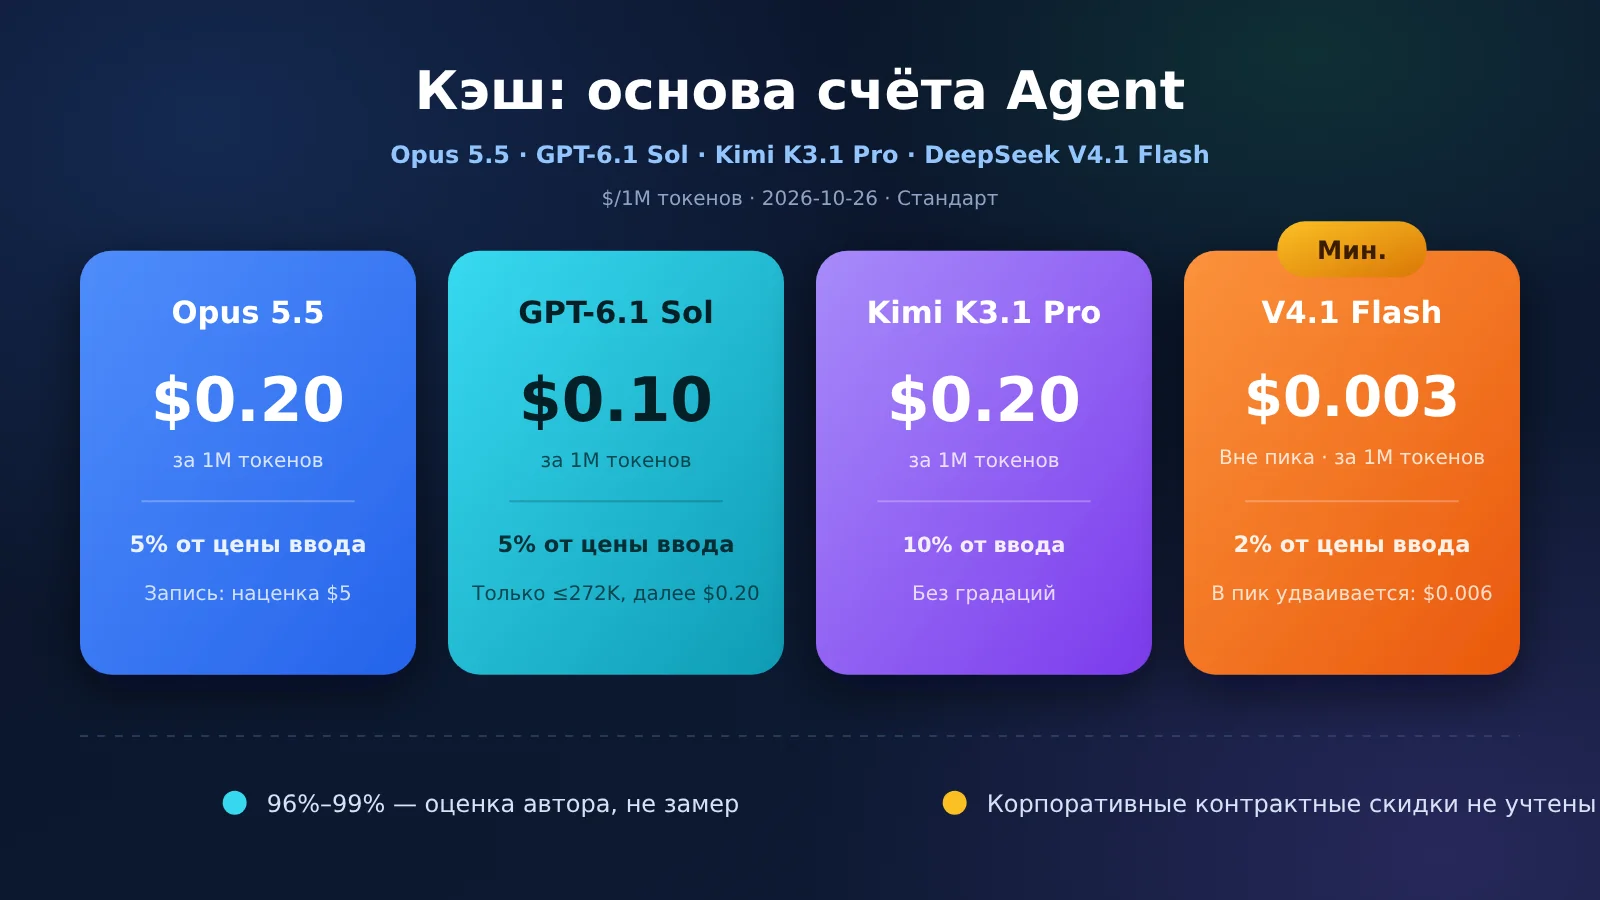
Если смотреть на актуальные официальные прайс-листы, стоимость чтения из кэша сейчас выглядит так: Claude Opus 5.5 — $0.20, GPT-6.1 Sol при входном контексте до 272K — $0.10, Kimi K3.1 Pro — $0.20, а у DeepSeek V4.1 Flash — $0.003 в непиковые часы и $0.006 в пиковые. Все цены указаны в долларах США за 1 миллион токенов.
Здесь нет размытого компромисса «у каждого свои плюсы». Если у вас стабильный префикс и объем входных данных обычно укладывается в 272K токенов в цикле кодогенерации, среди тройки проприетарных моделей первым делом смотрите на стоимость чтения кэша у GPT-6.1 Sol. Если нужно срезать ценник еще на порядок — переходите на DeepSeek в непиковые часы. У Opus 5.5 и Kimi стоимость кэшированного чтения одинаковая, а разница кроется в цене обычного (некэшированного) ввода, вывода и наценке за запись в кэш.
Главная мысль: после прочтения вы сможете выбирать модель, отталкиваясь от коэффициента попадания в кэш (hit rate), а не от базовой цены входных токенов, а также поймете, почему громкие статьи о корпоративных скидках никак не сходятся с реальными счетами небольших команд.
💡 Практический совет: все четыре модели можно протестировать через APIYI apiyi.com по одному API-ключу, просто меняя имя модели в запросе. Для новых аккаунтов предусмотрен бесплатный тестовый баланс. Советуем сначала зафиксировать системный префикс, а затем оценить объем чтения из кэша в статистике использования — не делайте поспешных выводов по одной короткой сессии.
В чём разница цен на чтение из кэша у четырёх провайдеров?
Сначала посмотрим на саму стоимость чтения из кэша, а затем — на её долю от цены обычного ввода при промахе кэша (cache miss). Именно это соотношение показывает, насколько дешевле обходится токен в длинных диалогах. У Opus 5.5 и GPT-6.1 Sol на коротком контексте чтение из кэша составляет всего 5% от цены обычного ввода, у Kimi K3.1 Pro — 10%, а у DeepSeek V4.1 Flash — всего 2%. В абсолютных же цифрах разрыв ещё заметнее: в непиковые часы Flash стоит $0.003 — это в 33 раза дешевле, чем Sol на коротком контексте ($0.10), и в 67 раз дешевле тарифа в $0.20.
| Модель | Чтение из кэша | % от обычного ввода | Обычный ввод (промах) | Вывод |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol, ввод ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol, ввод >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash (непиковое время) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash (пиковое время) | $0.006 | 2% | $0.30 | $1.20 |
Все цены указаны в долларах США за 1 миллион токенов по стандартному тарифу (без учёта Batch, Fast и региональных наценок).
— Цены на Opus 5.5 взяты из официального прайса Anthropic: чтение закэшированных данных тарифицируется с коэффициентом 0.05 от стоимости ввода.
— GPT-6.1 Sol приведен по стандартным расценкам OpenAI: под «коротким контекстом» понимается ввод объёмом до 272K токенов. При превышении этого порога стоимость чтения из кэша, ввода и вывода переходит на следующий тарифный уровень (при этом вывод стоит $15, а не $20).
— Данные по Kimi взяты из открытых тарифов Moonshot, градаций по длине контекста у них нет.
— DeepSeek приведен по официальной странице тарифов (имя модели deepseek-flash, версия DeepSeek-V4.1-Flash-1017). Пиковые часы приходятся на промежутки с понедельника по пятницу с 01:00 до 04:00 и с 06:00 до 10:00 по UTC (за исключением государственных праздников Китая; по пекинскому времени это 09:00–12:00 и 14:00–18:00). Окно между ними (12:00–14:00) считается непиковым. В выходные и праздничные дни Китая круглые сутки действует непиковый тариф.
В каталоге на странице тарифов APIYI (docs.apiyi.com/models) по состоянию на 25.10.2026:
— для claude-opus-5-5 действуют цены $4 / $20 / $0.20 (ввод / вывод / чтение из кэша);
— для gpt-6.1-sol — $2 / $10 / $0.10 (с примечанием, что при объёме свыше 272 000 токенов ввод пересчитывается по $4);
— для kimi-k3.1-pro — $2 / $10 / $0.20.
DeepSeek разделён на две позиции: deepseek-v4.1-flash и deepseek-flash стоят $0.30 / $1.20 / $0.006 (соответствует официальному пиковому тарифу), а deepseek-v4-1-flash-260910 — $0.15 / $0.60 / $0.003 (непиковый тариф). Если в официальном API переключение пик/непик происходит автоматически по времени поступления запроса, то здесь эти тарифы вынесены в отдельные строки каталога. Перед запуском вызова модели обязательно сверяйтесь с точным идентификатором в консоли управления.
Чтение из кэша — это лишь половина затрат. Стоимость записи определяет, придётся ли переплачивать каждый раз, когда истечёт срок жизни закэшированного префикса. Обратите внимание: короткие и длинные интервалы в следующей таблице нельзя сравнивать «лоб в лоб» по минутам: у OpenAI короткий интервал составляет целых 30 минут, а у Anthropic и Kimi — всего 5 минут.
| Модель | Короткий TTL (запись) | Длинный TTL (запись) | Как префикс попадает в кэш |
|---|---|---|---|
| Opus 5.5 | 5 минут, $5 (в 1,25 раза дороже ввода) | 1 час, $8 (в 2 раза дороже ввода) | В запросе нужно передавать cache_control |
| GPT-6.1 Sol, ≤272K | 30 минут, $2.50 (в 1,25 раза дороже ввода) | 12 часов, $5 (в 2,5 раза дороже ввода) | Запись вынесена отдельной строкой в прайсе; префикс должен быть неизменным |
| Kimi K3.1 Pro | 5 минут, $2 (равно цене ввода) | 1 час, $4 (расчетно: в 2 раза дороже) | По умолчанию автоматически на 5 минут; для более долгого интервала нужно явно указать 1 час |
| V4.1 Flash | Отдельной платы за запись нет | Нет | Первый запрос считается как промах кэша, дальше — по тарифу чтения из кэша |
На главной странице Kimi для записи в кэш указана цена $2 — это соответствует дефолтному тарифу на 5 минут. Значение $4 для 1 часа взято из конфигурации в документации Kimi на платформе APIYI, где прямо отмечено, что списание по этому тарифу кэша еще не проверялось на практике в текущем цикле тестов. В официальной документации к предыдущему поколению Kimi K3 запись на 1 час стоила вдвое дороже 5-минутной, так что для K3.1 Pro по той же логике выходит $4. Если данные в консоли отличаются, всегда ориентируйтесь на консоль. У скоростной версии kimi-k3.1-pro-highspeed стоимость ввода и вывода удваивается, но чтение из кэша остается прежним — $0.20. Если у вас высокий процент попаданий по префиксу, разница по затратам между этими двумя версиями будет практически незаметна.
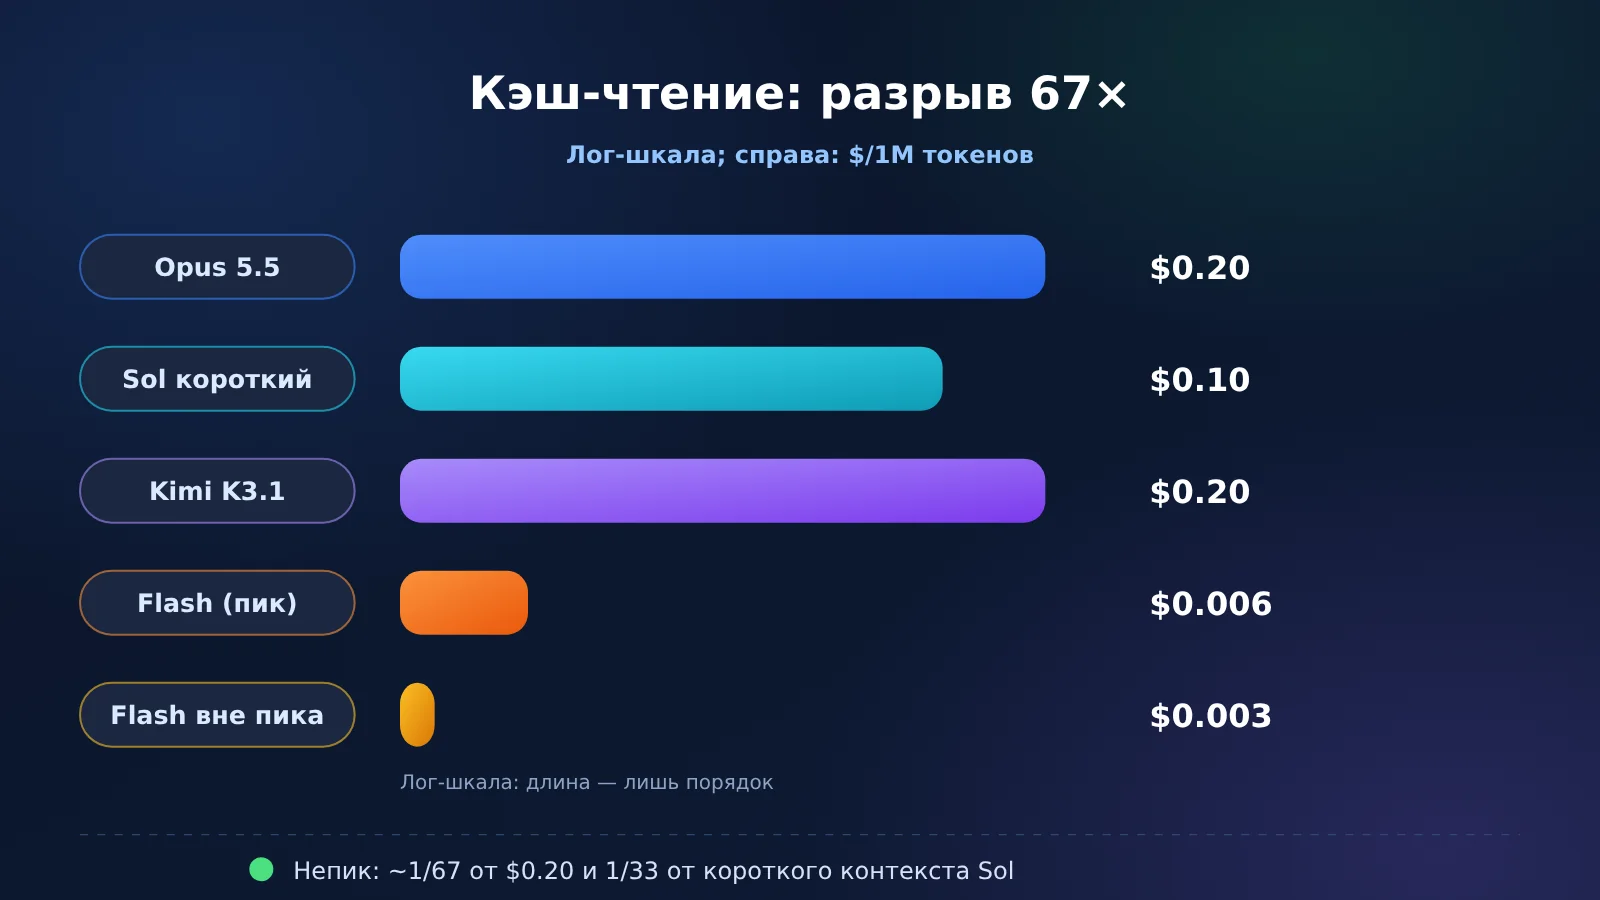
Длина столбцов на графике нужна лишь для наглядного сравнения порядков величин. Реальная оплата по-прежнему рассчитывается как базовая цена, помноженная на число токенов. Если вы используете один и тот же ключ для разных моделей, ориентируйтесь на колонку стоимости чтения из кэша в консоли APIYI — использовать эту диаграмму для точных расчетов бюджета не стоит.
Почему в расходах на кодинг-агентов чтение из кэша выносят отдельной строкой?
На каждом шаге агент заново отправляет системный промпт, описания инструментов и всю предыдущую историю переписки. Ту часть префикса, которая осталась неизменной, можно прочитать из кэша по льготному тарифу. Но стоит префиксу измениться, как всё, начиная с места правки, считается промахом кэша (cache miss), а некоторые провайдеры вдобавок берут отдельную плату за повторную запись. Поэтому падение базовой цены на входные токены на 20% вовсе не гарантирует, что итоговый счет за сессию кодинга снизится на те же 20%. Если чтение из кэша составляет основную массу токенов, ориентироваться нужно именно на тариф этой строки.
Когда Макс Вульф (Max Woolf) говорит о 96%–99%, он имеет в виду «суммарные затраты токенов». В английском языке слово expenditure может обозначать как финансовые расходы, так и расход самих токенов. В исходном тексте база расчета попросту не раскрыта. Зато в другом независимом бенчмарке методология описана прозрачно: в обновлении WorkloadBench от 16.10.2026 указано, что в длительных задачах кодинга от 89% до 96% токенов промпта читаются из кэша. Медиана для GPT-6.1 Sol и Claude Opus 5.5 составила 95% (с разбросом 91%–98% и 94%–99% соответственно). Источник данных — workloadbench.brenhq.com/cache. Однако это процент исключительно от токенов промпта: здесь не учитываются токены вывода, и уж тем более речь не идет о доле в долларах. Нельзя объединять эти цифры в громкое утверждение «96% счета приходится на кэш».
В денежном выражении доля кэша обычно заметно скромнее, поскольку токены вывода стоят в десятки, а то и в сотни раз дороже чтения кэша. Давайте посмотрим на структуру затрат на конкретном примере (это модельный расчет, а не реальные логи автора). Допустим, у нас диалог на 40 итераций: в каждой итерации 120 000 токенов берутся из кэша, 1 500 новых токенов идут как промах, а модель генерирует 800 токенов вывода. В самом начале сессии один раз записываются в кэш 40 000 токенов. Эти 40 000 больше не учитываются как промах. У DeepSeek нет отдельного тарифа на запись, поэтому эти 40 000 считаются обычным промахом. Общий объем входного контекста на итерацию составляет около 120 тыс. токенов, что попадает в базовый тариф короткого контекста Sol.
Суммарно набегает 4 932 000 токенов, из которых чтение из кэша занимает 4 800 000 (около 97%). Этот пример наглядно иллюстрирует: по количеству токенов сценарий «длинный префикс, много итераций и короткие ответы» действительно попадает в озвученный диапазон.
| Модель | Чтение из кэша | Промах кэша | Вывод | Запись или первый промах | Итого | Доля кэша в деньгах |
|---|---|---|---|---|---|---|
| Opus 5.5, запись на 5 мин | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | около 47% |
| GPT-6.1 Sol, ≤272K, запись на 30 мин | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | около 47% |
| Kimi K3.1 Pro, запись на 5 мин | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | около 65% |
| V4.1 Flash, непиковые часы | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | около 30% |
| V4.1 Flash, пиковые часы | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | около 30% |
Тарифы Opus по четырём позициям для короткого контекста ровно вдвое выше, чем у Sol, поэтому их доли абсолютно одинаковы, а в сумме выходит ровно половина. У Kimi чтение из кэша стоит 10% от базового инпута, а не 5%. При той же структуре токенов на чтение из кэша приходится около 65% расходов, а итоговая сумма составляет $1.48, то есть аккурат посередине. У Flash в часы низкой нагрузки (off-peak) выходит около $0.049, в пиковые часы — вдвое больше. Поскольку чтение из кэша здесь обходится всего в 2% от цены промаха (cache miss), в этом сценарии основная доля расходов смещается на аутпут — около 40%, тогда как чтение из кэша забирает примерно 30%. Среди трёх флагманских моделей чтение из кэша всё ещё остаётся самой крупной статьёй расходов в этом расчёте. Flash же экономит за счёт совершенно другого порядка цен во всём счёте, а не просто перераспределения тех же 96% структуры затрат.
Но если префикс меняется на каждом шаге диалога, таблица выше теряет всякий смысл. Таймстемпы, случайно перетасованный список инструментов (tools), имя пользователя, вставленное посреди системного промпта, — всё это моментально сбивает попадание в кэш. В таком случае сравнивать придётся уже стоимость промаха и записи в кэш. У Opus запись на 5 минут стоит в 1.25 раза дороже обычного инпута; у Sol запись на 30 минут — тоже в 1.25 раза, а на 12 часов — уже в 2.5 раза. У Kimi запись на 5 минут равна обычной цене инпута — никакой наценки за короткий TTL нет. У DeepSeek первое обращение тарифицируется по стандартной цене промаха кэша.
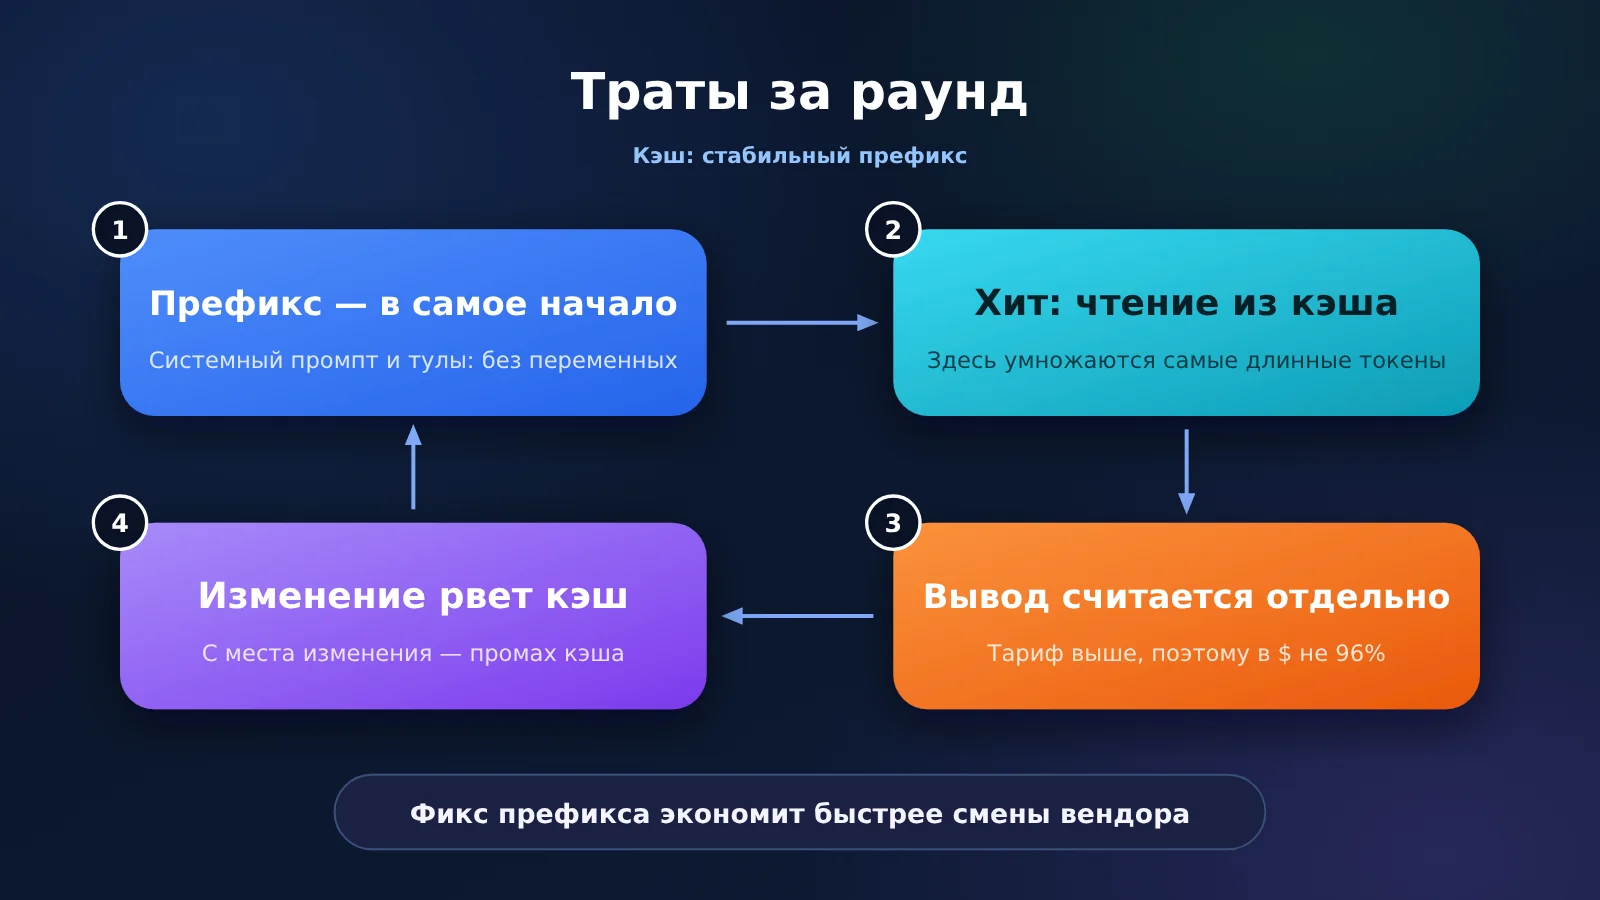
Навести порядок в префиксах часто помогает сэкономить куда быстрее и эффективнее, чем смена провайдера. Зафиксируйте строгий порядок вызова инструментов, выносите любой динамический контент в самый конец сообщений и следите, чтобы паузы внутри одной сессии не превышали короткий TTL кэша. И только когда это настроено, имеет смысл выбирать модель по стоимости чтения из кэша.
Что показывает хронология снижения цен за эти четыре месяца?
Фраза «подешевело на целых 80%» относится лишь к двум конкретным моментам, и не стоит думать, будто цены на все модели разом упали в пять раз. Первый случай зафиксировал Макс Вульф (Max Woolf): 30 июля 2026 года OpenAI снизила цены на GPT-5.6 Luna с $1 / $6 / $0.10 до $0.20 / $1.20 / $0.02 — и для входных токенов, и для чтения из кэша дисконт составил около 80%. Второй случай касается чтения из кэша в линейке Sol: с $0.50 у GPT-5.6 Sol (26 июня 2026 г.) до $0.10 у GPT-6.1 Sol (29 сентября 2026 г.), что тоже дает падение на 80%. Но здесь и сама модель сменилась с версии 5.6 на 6.1 — это не просто скидка 80% на один и тот же SKU.
| Дата | Событие (по его данным) | Вход / Выход / Чтение кэша |
|---|---|---|
| 2026-06-26 | OpenAI выпускает GPT-5.6 Sol и Luna | Sol: $5 / $30 / $0.50 |
| 2026-06-30 | Anthropic выпускает Sonnet 5, заявляя стартовую цену как временную | $2 / $10 / $0.20 |
| 2026-07-24 | Anthropic выпускает Opus 5 | $5 / $25 / $0.50 |
| 2026-07-30 | Снижение цен на GPT-5.6 Luna | $0.20 / $1.20 / $0.02 |
| 2026-08-21 | Временное снижение цен на GPT-5.6 Sol примерно на 20% сроком на три месяца | $4 / $20 / $0.40 |
| 2026-09-01 | Fable 5.1: чтение кэша дешевле, чем у Fable 5 в июне | $10 / $50 / $0.25 |
| 2026-09-22 | В один день выходят GPT-6 Sol и Opus 5.5 | Sol: $2 / $10 / $0.20; Opus 5.5: $4 / $20 / $0.20 |
| 2026-09-29 | GPT-6.1 Sol: чтение кэша подешевело еще в два раза | $2 / $10 / $0.10 |
В таблице выше сведены данные Макса Вульфа, цены везде указаны в формате «вход / выход / чтение кэша». Мы перепроверили актуальные цифры из двух последних строк: тариф $4 / $20 / $0.20 для Opus 5.5 совпадает с официальным прайс-листом Anthropic, а $2 / $10 / $0.10 для GPT-6.1 Sol сходится со стандартным тиром OpenAI для короткого контекста. Более ранние записи по архивам релизов мы детально не сверяли, так что при ссылках лучше опираться на его первоисточник.
По поводу Opus 5.5 Вульф также отмечает, что суммарные расходы снизились на 40–60%. По официальному прайсу подтверждаются три базовые ставки: по сравнению с Opus 5 цены на вход и выход упали на 20% (с $5 до $4 и с $25 до $20 соответственно), а чтение кэша подешевело на 60% (с $0.50 до $0.20). Коридор 40–60% — это его личная расчетная оценка с учетом типовой структуры запросов, а не единая скидка от вендора. Сами Anthropic объясняют это тем, что на инференс Opus 5.5 уходит меньше вычислительных ресурсов, чем у Opus 5, что и нашло отражение в стоимости. Впрочем, это лишь официальное заявление разработчика.
Он также отметил, что на собственном API DeepSeek модель DeepSeek V4.1 Flash стоит около $0.15 / $0.60 / $0.003. Эти цифры совпадают с официальными ценами в часы низкой нагрузки (off-peak), а в пиковые часы они удваиваются. Для Kimi K3.1 Pro автор указал $2 / $10 / $0.20, что полностью соответствует карточке тарифов на официальном сайте. Что касается баллов от Artificial Analysis (55 у Kimi, 58 у Opus 5.5 и 45 у Flash) — это сторонние бенчмарки, а не наши практические тесты написания кода, поэтому при выборе модели не стоит опираться исключительно на эту тройку оценок.
Как небольшой команде выбрать модель без корпоративных скидок?
Помимо публичных цен существует еще один пласт — скрытые скидки, доступные только крупным клиентам. Издание AI Weekly 24 октября 2026 года со ссылкой на The Information сообщило: OpenAI предложила скидку более 30%, чтобы закрыть контракт на сумму свыше $100 млн в год, в результате чего Replit перенесла большую часть своих расходов на ИИ с Anthropic на OpenAI. По данным издания, Anthropic не стала продлевать ранее предоставленную для Replit скидку. Официальных подтверждений от этих трех компаний в материале не приводилось. Сам CEO Replit Амджад Масад (Amjad Masad) на конференции TechCrunch Disrupt заявил, что решение принималось с учетом стоимости, партнерских отношений и производительности. В той же статье отмечается, что модели Claude по-прежнему доступны разработчикам, но OpenAI теперь назначена дефолтной для агентных сценариев (Agent). Также упоминается компания Rippling, которая перевела генерацию кода с Anthropic на OpenAI, сославшись на оптимизацию расходов. Все это лишь публикации в медиа, а не открытые совместные прайс-листы.
Небольшим командам такие контракты не светят. Без обязательств тратить по 100 миллионов долларов в год заветные 30% скидки из новостей не получить. Но даже если чисто механически применить эти 30% к чтению из кэша (cache read) у Opus — цена снизится с $0.20 до $0.14, что всё равно выше публичной цены в $0.10 за короткий контекст у GPT-6.1 Sol. В отчете не уточняется, на что именно распространялась скидка — на кэшированные токены, обычный ввод (cache miss) или итоговый счет. Однако это сравнение наглядно показывает порядок цифр: базовых открытых цен на чтение из кэша вполне достаточно, чтобы небольшая команда могла сделать первичный выбор.
| Характеристики сессии / задачи | К кому присмотреться сначала | Почему |
|---|---|---|
| Стабильный префикс, ввод обычно до 272K токенов, нужна проприетарная модель для кодинга | GPT-6.1 Sol | Чтение из кэша — $0.10, самая низкая цена из тройки |
| Разовый ввод превышает 272K токенов | Не рассчитывайте на $0.10 | У Sol чтение из кэша подскакивает до $0.20, а генерация (вывод) — до $15 |
| Бюджет на чтение из кэша как у Opus, но хочется дешевле обычный ввод и вывод | Kimi K3.1 Pro | Чтение из кэша те же $0.20, при этом ввод и вывод — $2 / $10 без градаций по объему |
| Высокий процент попадания в кэш, задачи можно запускать вне пиковых часов | DeepSeek V4.1 Flash (в часы низкой нагрузки) | Чтение из кэша всего $0.003 — итоговый счет отличается на порядок |
| Запуски строго в будни с 9:00 до 12:00 и с 14:00 до 18:00 по Пекину | Пересчитывайте Flash по пиковым тарифам | Чтение из кэша уже $0.006, остальные тарифы также удваиваются |
| Префикс меняется на каждом шаге | Сначала оптимизируйте структуру промпта | Колонку со стоимостью кэша можно даже не смотреть |
В этой таблице модели специально не ранжируются по качеству работы. Например, Макс Вульф (Max Woolf) считает, что Opus 5.5 превосходит более дорогую Fable 5.1 — но это сугубо субъективная оценка на основе его личных задач. Разработчики DeepSeek прямо заявляют, что за эндпоинтом deepseek-flash теперь стоит модель DeepSeek-V4.1-Flash-1017; прежний идентификатор deepseek-v4-flash продолжает работать и тарифицируется как Flash, а deepseek-v4-pro по-прежнему продается отдельно. Официального ранжирования по способностям между Flash и Pro вендор не дает. Здесь работает простое правило: если цена ошибки выше разницы в стоимости токенов — берите более мощную и дорогую модель. Если последствия ошибки незначительны и стоят дешевле переплаты — смело гоняйте пайплайн на Flash.
💰 Оптимизация расходов: В прайс-листе всегда указаны базовые тарифы. В панели управления APIYI apiyi.com цены отображаются со скидкой в зависимости от вашей группы, а бонусы за пополнение баланса рассчитываются отдельно — все условия открыто описаны на странице с тарифами. Это прозрачные публичные правила, а не закрытые годовые контракты, выбитые через отдел продаж. Фактические списания всегда сверяйте по данным в личном кабинете.
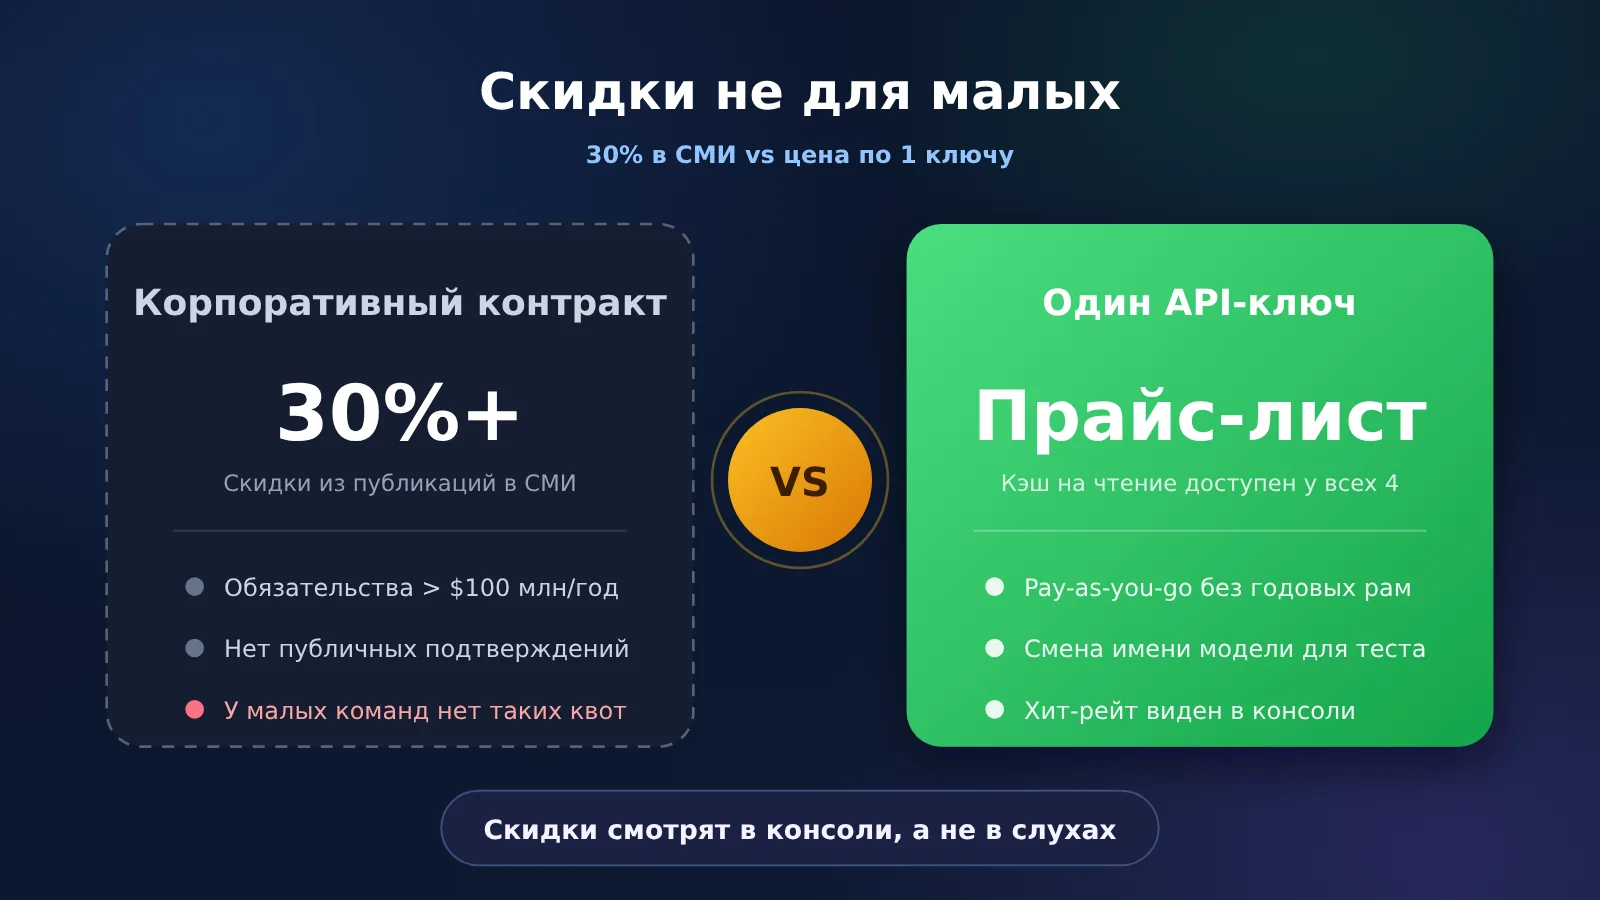
30% скидки и контракты на 100 млн долларов в левой части взяты из новостей — на такие цены при обычном заказе рассчитывать не стоит. А вот правая часть — это реальный и рабочий путь для небольшой команды.
Как проверить чтение из кэша у четырех провайдеров с помощью одного ключа?
В документации по тарифам рекомендуется: для моделей GPT-5 и новее лучше использовать эндпоинт /v1/responses — так проще попадать в кэш в многораундовых диалогах. При этом Chat Completions по-прежнему доступен. В примере ниже мы берем Chat Completions просто для того, чтобы для gpt-6.1-sol, kimi-k3.1-pro и deepseek-flash можно было менять только имя модели.
Для Opus 5.5 кэширование по этому пути по умолчанию не работает. У Anthropic кэш сейчас активируется добавлением cache_control на верхнем уровне запроса либо установкой контрольных точек на блоках контента. Платформа APIYI поддерживает для claude-opus-5-5 как эндпоинт chat, так и messages. Чтобы получить расчет по тарифу с кэшированием, отправляйте запрос через messages с параметром cache_control. Если вызывать модель через обычный Chat Completions, не стоит рассчитывать, что указанная в каталоге цена в $0.20 применится автоматически.
- Ставим базовые пакеты: если SDK еще не установлен, выполните
pip install openai. В начале файла пропишитеimport osиfrom openai import OpenAI. Сам API-ключ сохраните в переменную окруженияAPIYI_API_KEY— ни в коем случае не коммитьте его в репозиторий. - Инициализируем клиент: буквально одна строчка:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). Базовый URL настраивается только здесь. - Фиксируем префикс: в
STABLE_PREFIXпередаем системный промпт и описание инструментов — слово в слово, без изменений от вызова к вызову. Вuser_turnпередаем динамический контент текущего раунда, и он всегда идет последним сообщением. - Отправляем запрос:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}]). Чтобы протестировать двух других провайдеров, достаточно просто заменитьmodelнаkimi-k3.1-proилиdeepseek-flash. - Смотрим расход токенов: сначала получаем детализацию через
details = resp.usage.prompt_tokens_details, затем достаем кэш:cached = getattr(details, "cached_tokens", 0) or 0, и выводим результат:print(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens). Эти три числа по порядку означают: токены промпта, токены из кэша и токены ответа.
Прогоните несколько раундов подряд: разделив число токенов из кэша на общее число токенов промпта, вы получите свой реальный процент попадания в кэш. Умножьте объем кэшированных токенов на тариф конкретного провайдера за чтение из кэша — это и будет фактическая сумма в долларах.
В документации Kimi указано, что их кэш-тариф является конфигурационным, а финальный расчет ведется по данным в консоли. Если для DeepSeek вам нужен ночной тариф со скидкой, выбирайте точное имя модели из каталога — deepseek-v4-1-flash-260910. Не рассчитывайте, что стандартный deepseek-flash сам переключит цену по часам.
Храните API-ключ в переменной окружения APIYI_API_KEY и берегите его от попадания в репозиторий. Бесплатный тестовый баланс отлично подходит для того, чтобы прогнать один и тот же префикс на четырех моделях за пару раундов и сопоставить структуру расходов. Если контекста не хватает, увеличивайте нагрузку постепенно, а не скармливайте сразу гигантскую кодовую базу всем четырем сервисам.
Частые вопросы о стоимости чтения из кэша
Q1: Означают ли эти 96%, что чтение из кэша составляет 96% от общей суммы счета?
Нет, в статье такого вывода нет. Макс Вульф (Max Woolf) писал, что чтение из кэша занимает 96–99% от общего расхода токенов — это сторонняя оценка, точный знаменатель в расчетах не раскрывался. По замерам WorkloadBench показатель составляет 89–96% от токенов промпта, без учета вывода. Если исходить из наших модельных расчетов, на кэш приходится около 97% токенов, а вот в денежном выражении это примерно 47% для Opus и Sol, около 65% для Kimi и около 30% для Flash.
Q2: Почему чтение из кэша у Sol иногда стоит $0.10, а иногда $0.20?
Все зависит от длины входного контекста в одном запросе. Если объем не превышает 272K токенов, стандартный тариф OpenAI за чтение из кэша составляет $0.10. Если порог превышен, ставка поднимается до $0.20, при этом стоимость промаха кэша (новых входных токенов) вырастает до $4, а токенов вывода — до $15. В каталоге APIYI указаны цены для короткого контекста ($2 / $10 / $0.10) с примечанием, что при превышении 272 000 токенов входной тариф составит $4. Цены на вывод и кэш для длинного контекста соответствуют стандартным тарифам OpenAI, а если в консоли предусмотрено разделение по уровням — ориентируйтесь на данные в консоли.
Q3: Почему у DeepSeek две разные цены на чтение из кэша?
Официальный провайдер использует пиковые и внепиковые тарифы: вне пика цена ровно в два раза ниже. Внепиковое чтение из кэша стоит $0.003, а в пиковые часы — $0.006. Пиковые часы — это рабочие дни с 09:00 до 12:00 и с 14:00 до 18:00 по пекинскому времени (пересчитано из официального окна UTC, за исключением праздничных дней в Китае). По выходным и праздникам круглосуточно действует внепиковый тариф. В каталоге APIYI эти тарифы вынесены в две отдельные строчки для удобства.
Q4: Может ли небольшая команда получить 30%-ную скидку для корпоративных клиентов?
В новостях упоминались скидки, привязанные к годовым контрактам свыше $100 млн, да и сами провайдеры официально это не подтверждали. У небольших команд просто нет таких объемов обязательств. Для базового выбора вполне достаточно сравнить публичные тарифы на чтение из кэша. Что касается групповых скидок и акций на пополнение баланса — актуальную информацию всегда смотрите в консоли APIYI, не путая ее с теми самыми корпоративными контрактами.
Q5: Как подключить все четыре сервиса через один API-ключ?
Создайте один API-ключ на платформе APIYI apiyi.com и используйте базовый URL `https://api.apiyi.com/v1`. Модели `gpt-6.1-sol`, `kimi-k3.1-pro` и `deepseek-flash` работают через стандартный Chat Completions — достаточно просто менять название модели. Для `claude-opus-5-5`, если требуется учет кэша, используйте эндпоинт `messages` с параметром `cache_control`. А для GPT-5 и более новых моделей, чтобы получить более высокий процент попадания в кэш в многошаговых диалогах, на странице тарифов рекомендуется переключиться на `/v1/responses`.
Q6: Если чтение из кэша такое дешевое, стоит ли сделать Flash моделью по умолчанию?
Только если цена ошибки ниже разницы в стоимости. В часы низкой нагрузки ориентировочный счет получается примерно на порядок ниже — где-то в 20 раз меньше, чем у Sol ($0.0486 против $1.02), а в пиковые часы — примерно в 10 раз. Но если Flash потребуется сделать несколько дополнительных итераций для решения той же задачи, лишние раунды быстро съедят всю экономию. Лучше сначала протестировать количество итераций на одном и том же префиксе, используя бесплатные лимиты, и только потом выбирать модель по умолчанию.
Q7: Может ли запись в кэш стоить дороже чтения?
Да, если префикс постоянно протухает, а попаданий в кэш совсем мало. У Opus и Sol короткий интервал записи стоит в 1.25 раза дороже обычного ввода, а 12-часовой тариф у Sol — уже в 2.5 раза дороже. У Kimi 5-минутная запись тарифицируется по стандартной цене ввода. Только после двух-трех успешных попаданий чтение из кэша становится основной статьей расходов. Для задач с плавающими интервалами вызовов сначала подберите правильный TTL, а уже потом сравнивайте стоимость чтения.
Главные выводы по стоимости чтения из кэша
- 96% — это сторонние оценки: Макс Вульф (Max Woolf) не публиковал сырые логи. Долю расходов в долларах придется пересчитывать самостоятельно, умножая объемы на тарифы.
- Сначала смотрим на цену чтения из кэша, затем — на скачок тарифа: если у Sol контекст переваливает за 272K, чтение из кэша дорожает с $0.10 до $0.20.
- Чтение из кэша у Opus и Kimi стоит одинаково — $0.20: однако у Kimi дешевле промахи кэша и генерация, а при быстрой записи нет дополнительной наценки.
- Преимущество Flash — в разнице на порядки: $0.003 в часы спада и $0.006 в пике, так что расходы на чтение из кэша перестают быть доминирующей статьей в чеке.
- Корпоративная скидка 30% не актуальна для небольших команд: это условия годовых контрактов, о которых писали в СМИ. Для первого этапа и базового выбора вполне достаточно публичных цен.
- Один ключ для подключения ко всем четырем провайдерам: просто меняйте названия моделей через APIYI apiyi.com, а фактический процент попаданий в кэш отслеживайте по статистике использования в панели управления.
Итоги
За последние четыре месяца официальные цены упали местами до 80%. В основном это коснулось базового прайса на Luna, а также чтения из кэша в линейке Sol — здесь ценник снизился с $0,50 до $0,10. При разработке ИИ-агентов для кодинга стоимость чтения кэша по-прежнему имеет смысл считать отдельно.
Если смотреть на официальные расценки на 26.10.2026, то на коротком контексте чтение кэша у GPT-6.1 Sol обходится в $0,10, у Opus 5.5 и Kimi K3.1 Pro — в $0,20, а у DeepSeek V4.1 Flash — всего $0,003 в часы затишья и $0,006 в пиковые часы. Показатели экономии в 96%–99% приводятся лишь со ссылкой на твит Макса Вульфа (Max Woolf). В показательных расчетах объем сэкономленных токенов действительно может приближаться к этим значениям, но в пересчете на реальные доллары выгода обычно оказывается чуть скромнее.
Описанные в медиа корпоративные скидки требуют годовых коммитментов, и небольшим проектам до них просто не дотянуться. Гораздо практичнее подключить всех четырех провайдеров через единый API-ключ и посчитать реальные расходы, умножив свой процент попадания в кэш на публичные тарифы, чем ждать контракт со скидкой в 30%. Проще всего прогнать один и тот же стабильный префикс промпта через APIYI apiyi.com и уже на реальных цифрах решить, какую модель сделать основной.
Автор: техническая команда APIYI
Обратная связь: задать вопросы можно через форму на главной странице сайта APIYI. Актуальная стоимость вызова моделей всегда доступна на странице тарифов в документации docs.apiyi.com.
Источники и справочные материалы
- Макс Вульф (Max Woolf): хронология снижения цен и оценка падения на 96%–99%
- Ссылка:
minimaxir.com/2026/10/cheap-llms -
Примечание: от 25.10.2026. Цифры 96%–99% — это личная оценка автора, а не результаты замеров в данной статье.
-
Цены на модели Anthropic
- Ссылка:
platform.claude.com/docs/en/about-claude/pricing -
Примечание: расценки на входные и выходные токены Opus 5.5, чтение из кэша и два тарифа на запись в кэш.
-
Цены на модели OpenAI
- Ссылка:
developers.openai.com/api/docs/pricing -
Примечание: стоимость короткого и длинного контекста для GPT-6.1 Sol, чтение и запись кэша. 272K токенов — официальная граница между коротким и длинным контекстом.
-
Цены на модели DeepSeek
- Ссылка:
api-docs.deepseek.com/quick_start/pricing -
Примечание: тарифы
deepseek-flashпри попадании в кэш (в пиковые и непиковые часы), промахе кэша и выводе токенов. -
Kimi API
- Ссылка:
platform.kimi.ai -
Примечание: стоимость Kimi K3.1 Pro за входные и выходные токены, попадание в кэш и стандартную запись в кэш.
-
AI Weekly о контракте Replit
- Ссылка:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
Примечание: скидка более 30% и годовой бюджет свыше 100 млн долларов взяты из материала The Information; публично эти условия ни одна из трех сторон не подтверждала.
-
Доля кэшированных токенов по данным WorkloadBench
- Ссылка:
workloadbench.brenhq.com/cache - Примечание: от 16.10.2026. Доля токенов промпта, взятых из кэша (в процентах от общего числа токенов, а не расходов в долларах).