Недавно клиент задал в чате очень типичный вопрос: «У нас вот images2 — сможем генерировать комплекты изображений для маркетплейсов?» Ответ — да, но не одним вызовом, который сразу выдаёт весь набор. У интерфейса gpt-image-2 принцип «один промпт — одна генерация». Чтобы получить набор, где главное фото, карточка с преимуществами, сцена использования и страница деталей отличаются по содержанию, нужно немного продумать способ вызова.
В этой статье мы разбираем gpt-image-2 для e-commerce комплектов по двум сценариям: первый — когда одно изображение несёт многомерную информацию, подходит для длинной страницы деталей; второй — когда сначала текстовая модель разбирает задачу и генерирует промпты для каждой картинки, а затем параллельно вызывается gpt-image-2, подходит для настоящего набора из нескольких изображений. После прочтения у вас будет полный дизайн процесса, работающий код и несколько ключевых приёмов, чтобы сохранить единый стиль всего набора.
Ключевое ограничение gpt-image-2 для комплектов: один вызов — один промпт
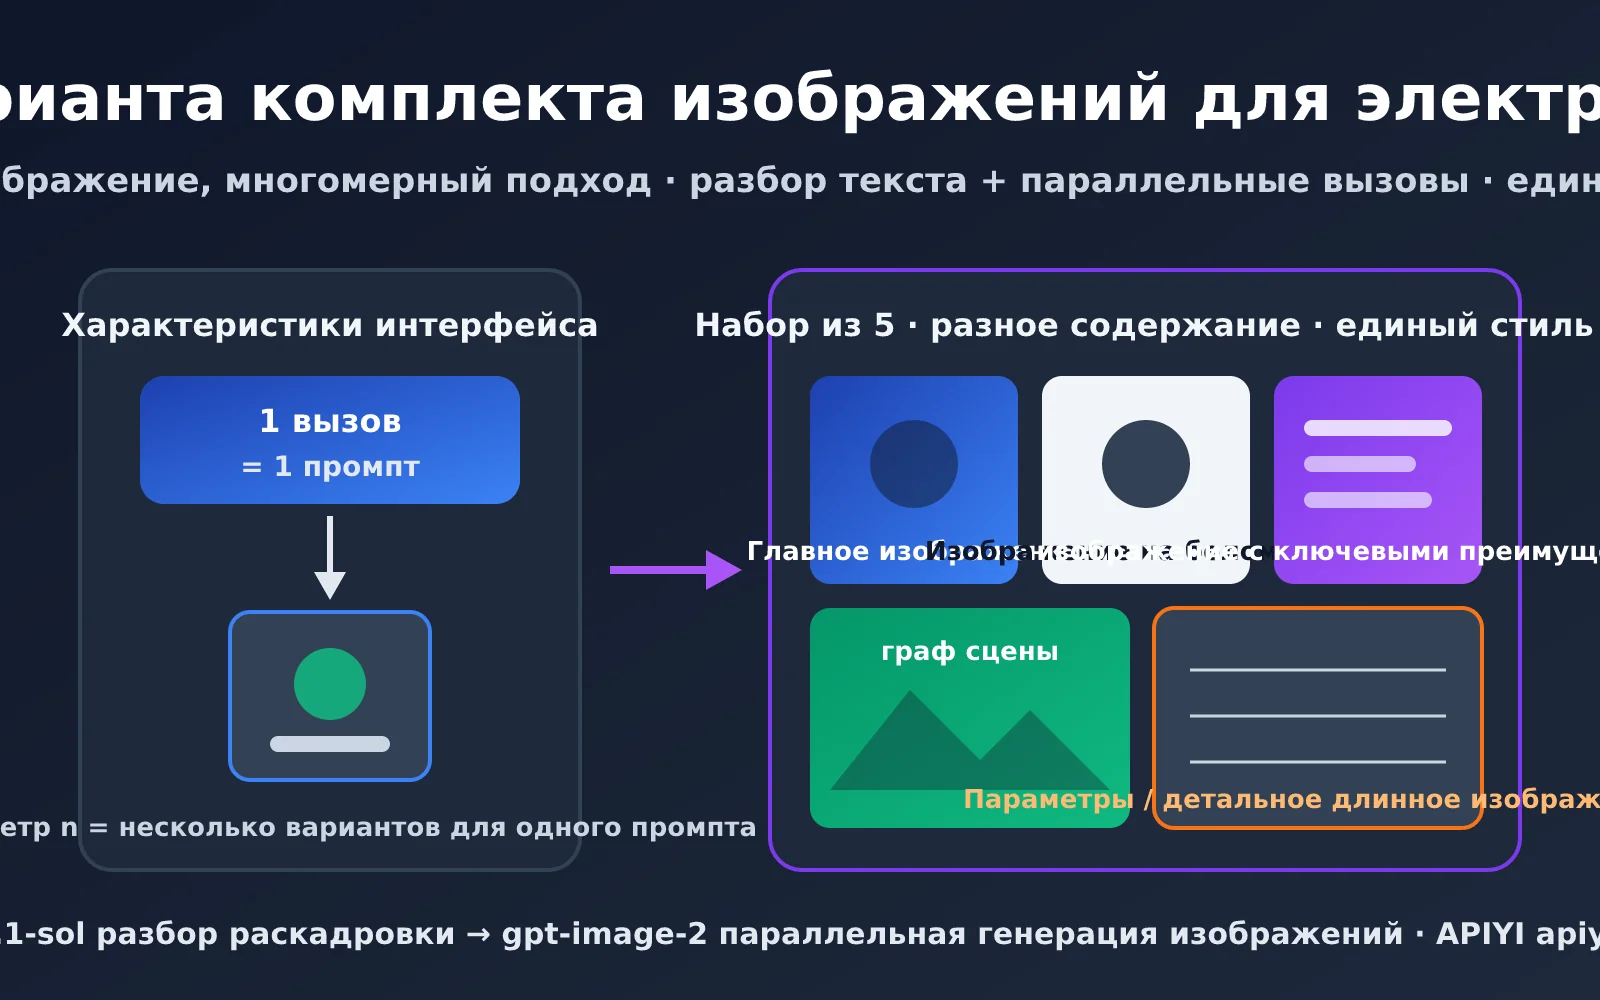
Сначала проясним поведение интерфейса — вся дальнейшая архитектура строится именно на этой предпосылке. Эндпоинты gpt-image-2 /v1/images/generations и /v1/images/edits принимают один prompt за запрос. Официальные модели gpt-image-2 и 2.5 поддерживают параметр n, и APIYI его полностью поддерживает, но смысл n — «сгенерировать n вариантов по одному и тому же промпту», а не «n промптов, по одной картинке каждый».
То есть при n=5 вы получите 5 версий одной и той же картинки — это подходит для «сгенерировать побольше и выбрать лучшую», но не для комплекта. Суть набора для маркетплейса — несколько изображений с разным содержанием, но единым стилем: главное фото акцентирует продукт, карточка преимуществ — с текстом, сцена — с обстановкой использования, параметрическая — с размерами. У каждой картинки свой промпт, поэтому, естественно, нужны несколько вызовов.
3 настоящие сложности gpt-image-2 для комплектов
Когда ограничения ясны, становится видно, что сложность не в «сгенерировать много картинок», а в трёх вещах:
- Единый объект: продукт на 5 картинках должен быть одним и тем же — цвет, логотип, конструкция не должны меняться от изображения к изображению.
- Единый стиль: палитра, освещение, фактура фона и стиль шрифта должны выглядеть так, будто их делал один дизайнер.
- Разделение информации: каждая картинка выполняет свою маркетинговую задачу — нельзя, чтобы все 5 рассказывали об одном и том же преимуществе.
Эти три вещи означают, что набор нельзя получить, просто «бросив фразу модели» — нужно планирование до вызова. Таблица ниже — стандартный состав комплекта для типичного маркетплейса, можно взять за отправную точку.
| Позиция в наборе | Назначение | Рекомендуемое соотношение | Плотность информации | Нужен ли текст |
|---|---|---|---|---|
| Главное фото (первое) | Кликабельность в поиске | 1:1 | Низкая, акцент на продукте | Опционально, немного |
| Фото на белом фоне | Требования платформы, реклама | 1:1 | Очень низкая | Не нужен |
| Карточка преимуществ | Передать 2–3 ключевых преимущества | 1:1 или 3:4 | Средняя | Нужен |
| Сцена использования | Создать атмосферу применения | 1:1 или 4:5 | Средняя | Опционально |
| Размеры/параметры | Снизить число вопросов и возвратов | 1:1 | Высокая | Нужен |
| Длинная страница деталей | Полноценно объяснить продукт | 9:16 или длиннее | Очень высокая | Нужен |
🎯 Совет по планированию: прежде чем писать код, определите по таблице выше, сколько картинок нужно вашей платформе и какую задачу решает каждая. Мы рекомендуем на APIYI apiyi.com сначала вручную прогнать 2–3 одиночных изображения через gpt-image-2, убедиться, что точность воспроизведения продукта и рендеринг текста соответствуют ожиданиям, и только потом переходить к пакетному процессу.
Вариант 1: gpt-image-2 — одна картинка несёт всю информацию (длинное изображение для страницы товара)
Первый путь — «всё сказано одной картинкой». gpt-image-2 отлично справляется с рендерингом китайского текста и пониманием компоновки, так что в одном вертикальном изображении вполне можно разложить по зонам главный визуал, преимущества и таблицу характеристик. Для длинных изображений на странице товара, подборок преимуществ и инфографики достаточно одного вызова, чтобы получить готовый результат с большим объёмом информации.
Главный плюс этого пути — проблемы согласованности просто нет. Всё содержимое генерируется моделью за один раз внутри одной картинки, цвета и стиль естественным образом совпадают, никакой дополнительный код для компоновки не нужен. Минус — площадь одного изображения ограничена: чем больше контента, тем мельче и плотнее становится текст, к тому же такую картинку нельзя разбить на отдельные главные изображения для размещения.
Как писать промпт с зонированием для длинного изображения товара в gpt-image-2
Ключ к «много информации в одной картинке» — описание по зонам. Не пишите один большой смешанный абзац, а идите по порядку сверху вниз и говорите модели, что находится в каждой области. Вот пример структуры промпта для длинного изображения страницы товара — термокружки:
Вертикальное изображение 9:16 для страницы товара на маркетплейсе, общий стиль: минималистичный скандинавский, кремово-белый фон, мягкий естественный свет.
【Верхняя зона】Главный визуал продукта: матовая тёмно-зелёная термокружка под углом 45 градусов, заголовок «Держит тепло 24 часа».
【Средняя зона】Три колонки с преимуществами, в каждой линейная иконка и короткий текст: «Внутренняя колба из стали 316», «Крышка открывается одной кнопкой одной рукой», «Объём 500 мл».
【Нижняя зона】Таблица характеристик: объём 500 мл, вес 320 г, высота 22 см, материал — сталь 316.
Весь текст — чётким шрифтом без засечек с поддержкой китайского, никакого лишнего текста.
По размеру для длинного изображения советую вертикальный формат 9:16 — например, 1152x2048 в 2K. Если нужен финальный материал в более высоком разрешении, берите 4K — 2160x3840.
Одна картинка — один вызов, минимальная стоимость, стиль естественно единый. Плата за это — ограниченная ёмкость: больше 5 блоков, и текст начинает сбиваться в кучу, а вырезать отдельную картинку как главную для поиска не получится. Лучше всего это работает для страниц товара и подборок преимуществ в категориях вроде бытовой техники, цифровых аксессуаров и товаров повседневного спроса — там, где важны характеристики.
💡 Практический совет: когда зон больше пяти, доля ошибок в рендеринге текста заметно растёт. Разбейте длинное изображение на 2–3 «половинных экрана», сгенерируйте их по отдельности и склейте вертикально уже на странице товара. Эти полуэкраны сами по себе образуют небольшой набор изображений — так мы естественно переходим к варианту 2.
Вариант 2: текчтовая модель разбирает задачу, gpt-image-2 генерирует набор изображений для маркетплейса за несколько вызовов
Если вам нужен настоящий набор независимых изображений (главное, с преимуществами, сцена — каждое само по себе), понадобится небольшой конвейер. Логика такая: «понять задачу и распланировать кадры» отдаём текстовой модели, «нарисовать» — gpt-image-2, а связываем их структурированным JSON.
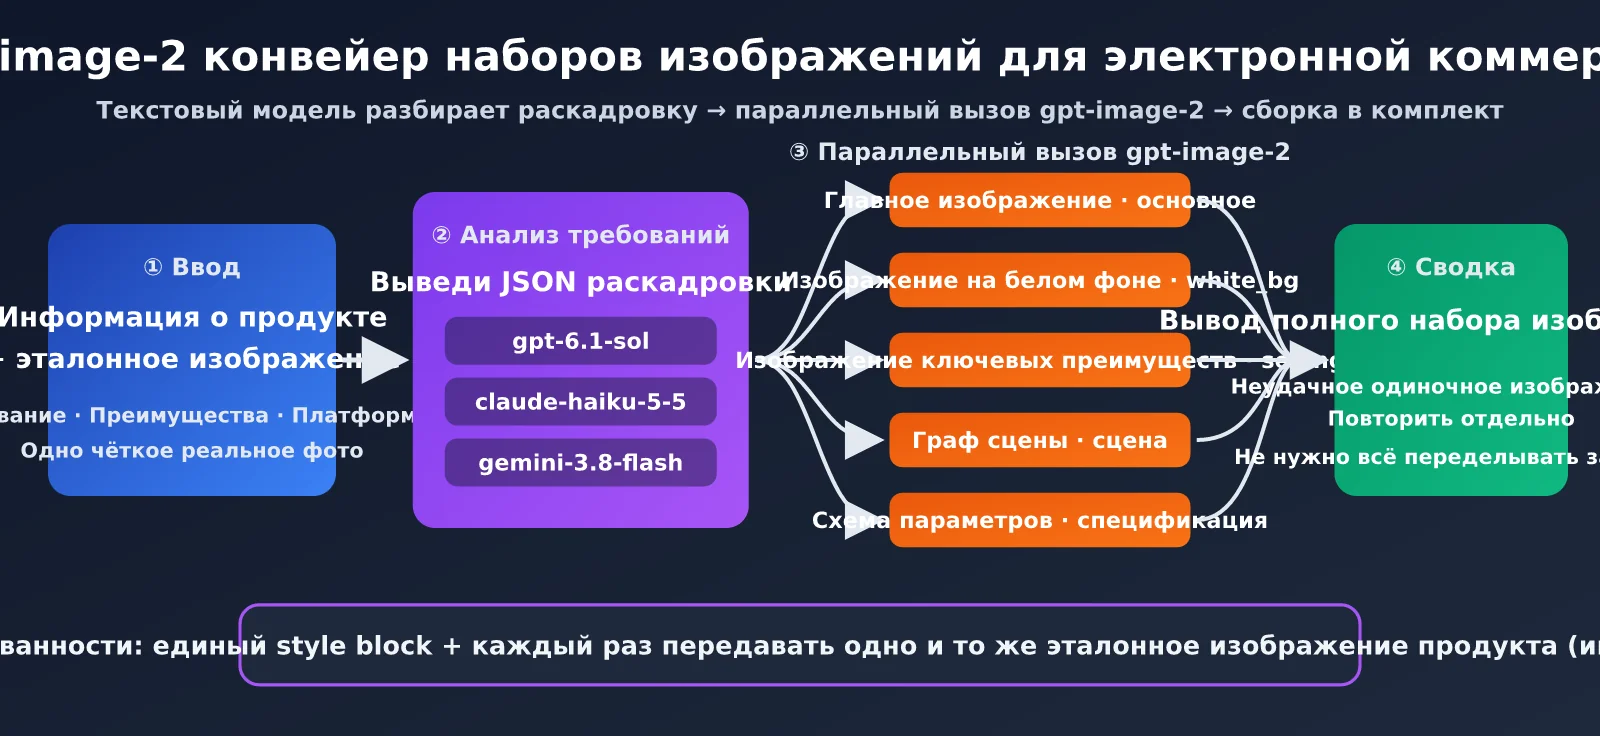
Весь процесс — 4 шага:
- Вход: продавец даёт название продукта, преимущества, целевую площадку и хотя бы одно чёткое фото продукта.
- Анализ задачи: текстовая модель выдаёт JSON-массив, где каждый элемент — это кадр изображения: назначение, промпт, размер, текст.
- Параллельная генерация: программа проходит по массиву кадров, на каждый делает вызов gpt-image-2 с одним и тем же эталонным изображением продукта.
- Сбор и проверка: собираем все результаты, неудачные картинки повторяем по одной, в конце выводим весь набор по порядку.
Как выбрать текстовую модель: «мозг» набора изображений для gpt-image-2
К шагу анализа требований у текстовой модели три запроса: понимать логику маркетинга на маркетплейсах, стабильно выдавать JSON и писать промпты с яркими образами. Сейчас на APIYI с этим справляются несколько свежих моделей:
| Модель | Позиционирование | Подходящие сценарии | Почему выбрать |
|---|---|---|---|
| gpt-6.1-sol | Флагман, рекомендуем | Дорогие товары, сложное выделение преимуществ | Лучшее качество маркетинговых текстов и планирования кадров |
| claude-haiku-5-5 | Дёшево и быстро | Массовые SKU, стандартные категории | Стабильно следует инструкциям, аккуратный вывод JSON |
| gemini-3.8-flash | Дёшево и быстро | Большие объёмы, мультиязычные товары для кросс-бордера | Быстро, дёшево, естественные мультиязычные тексты |
Анализ задачи вызывается один раз на набор изображений, токенов уходит мало — основные расходы всё равно на генерации. Советуем сначала довести шаблон промпта на gpt-6.1-sol, а при массовой обработке переключиться на claude-haiku-5-5 или gemini-3.8-flash, чтобы снизить затраты. Все три модели на APIYI apiyi.com работают через OpenAI-совместимый интерфейс, для переключения достаточно поменять параметр model.
Дизайн JSON с кадрами для набора изображений в gpt-image-2
Заставить текстовую модель выдавать JSON фиксированной структуры — залог стабильной работы всего конвейера. Вот рекомендуемые поля:
| Поле | Тип | Описание | Пример |
|---|---|---|---|
scene |
string | Идентификатор места в наборе | main / white_bg / selling |
purpose |
string | Маркетинговая задача этой картинки | Показать внешний вид, повысить кликабельность |
prompt |
string | Полный промпт для gpt-image-2 | Матовая тёмно-зелёная термокружка на деревянном столе… |
size |
string | Размер на выходе | 2048x2048 |
text_overlay |
string | Текст, который нужно отрисовать на картинке | Держит тепло 24 часа |
Минимальный код набора изображений в gpt-image-2
Ниже самая компактная рабочая версия: сначала просим текстовую модель составить раскадровку, потом по очереди вызываем edits-эндпоинт gpt-image-2 (с эталонным изображением продукта).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

# Планируем набор изображений: текстовая модель выдаёт JSON с кадрами
plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "Спланируй 5 изображений для карточки товара на Taobao: "
               "матовая тёмно-зелёная термокружка со стальной колбой 316. Выведи {\"shots\": [...]}, "
               "в каждом элементе scene/purpose/prompt/size/text_overlay, единый стиль: "
               "скандинавский минимализм, кремово-белый фон, мягкий естественный свет"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

# Генерируем по одному изображению на каждый кадр, передавая одно и то же эталонное фото
for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
Этот код выполняется последовательно: пять картинок ждут друг друга по очереди. В следующем разделе переделаем его в параллельную версию.
Как сохранить единый стиль набора изображений в gpt-image-2
Самая частая проблема при множественных вызовах — пять картинок выглядят как из пяти разных магазинов. Несколько приёмов в комбинации поднимают согласованность до коммерческого уровня:
- Единый style block: опишите цветовую гамму, свет, фон и язык кадра одним фиксированным абзацем и приклеивайте его в конец каждого промпта кадра. Не давайте текстовой модели каждый раз сочинять описание стиля заново.
- Фиксированное эталонное изображение продукта: при каждом вызове передавайте через edits-эндпоинт одно и то же реальное фото продукта и явно указывайте в промпте: «сохранить цвет, логотип и конструкцию продукта с эталонного изображения без изменений». Это самый действенный способ удержать единство主体а.
- Фиксированные параметры: для одного набора используйте одинаковый уровень
quality, размер меняйте только при необходимости (например, вертикальный для длинного изображения). - Выбор лучшего через параметр n: для самой важной позиции вроде главного изображения можно поставить
n=2илиn=3, сгенерировать несколько вариантов и выбрать лучший вручную. Как раз правильное применение параметра n.
🎯 Совет по согласованности: style block — это «брендбук» всего набора. Заведите для каждого магазина отдельный固定 шаблон. При вызове gpt-image-2 через APIYI apiyi.com можно хранить style block в конфиге, использовать его для всех SKU и обновлять централизованно при смене сезона.
Параллельные вызовы gpt-image-2 для комплектов изображений в e-commerce: как ускорить и масштабировать
Если генерировать комплект из 5 изображений последовательно, время ожидания будет равно сумме времени генерации каждой картинки — чем больше изображений, тем дольше. Поскольку кадры не зависят друг от друга, их можно смело запускать параллельно: тогда время на весь комплект будет близко к времени самой медленной картинки.
APIYI не устанавливает лимит на параллельные вызовы gpt-image-2: до 500 RPM можно работать сразу, без дополнительных заявок. Для большинства продавцов даже одновременная генерация комплектов для десятков SKU не приближается к этому порогу.
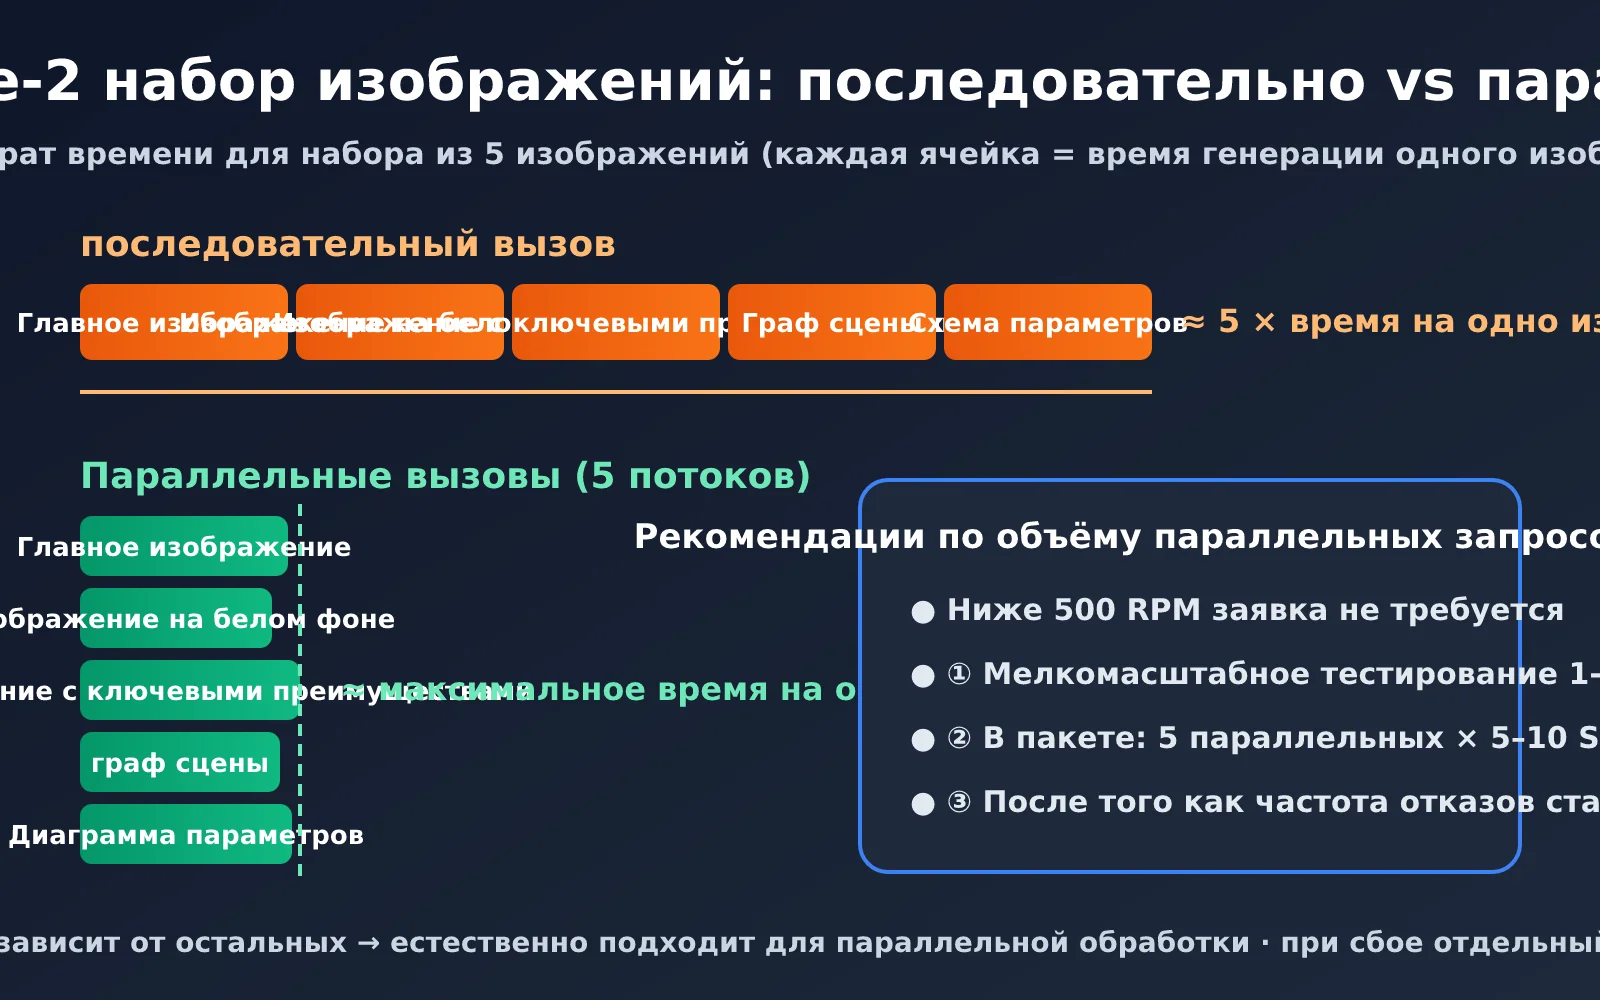
Код для параллельной генерации комплекта gpt-image-2
Замените последовательный цикл из примера выше на пул потоков — и получите параллельную генерацию. Заодно добавьте повторные попытки при ошибках, чтобы из-за одной неудачной картинки не приходилось перезапускать весь комплект:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
Посмотреть полный код (со style block, пакетной обработкой нескольких SKU, догенерацией после сбоев и сохранением результатов на диск)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "。整体风格:北欧简约,米白色背景,柔和自然光,低饱和配色,"
    "保持参考图中产品的颜色、Logo 和结构完全不变,文字使用清晰无衬线中文字体。"
)

PLAN_PROMPT = """你是资深电商视觉策划。根据以下商品信息规划一套 {count} 张的{platform}套图。
商品信息:{product}
输出 JSON:{{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
要求:每张图承担不同营销任务;prompt 只描述画面内容,不要描述整体风格;
需要文字时把文字原文写进 prompt 并用引号标出。"""


def plan_shots(product: str, platform: str = "淘宝", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """用文本模型拆解分镜,批量时可换 claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """单张出图,失败指数退避重试"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] 第 {attempt + 1} 次失败:{e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # 失败单张补生成一轮
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: 成功 {sum(1 for v in results.values() if v)}/{len(shots)} 张")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="墨绿色 316 不锈钢保温杯,500ml,24 小时保温,一键弹盖",
        ref_image="cup.png",
    )
Три этапа масштабирования параллельных вызовов
Хотя жёсткого лимита на параллельные вызовы нет, мы всё равно советуем увеличивать нагрузку поэтапно: сначала проверьте качество, потом масштабируйте. Так вы не получите сразу несколько сотен неудачных изображений.
- Небольшой тест: возьмите 1–3 SKU, прогоните последовательно или с низкой параллельностью и вручную проверьте, насколько точно воспроизводится товар, правильно ли отображается текст и выдержан ли единый стиль.
- Средняя параллельность: когда результат стабилен, запускайте по 5 параллельных генераций на комплект и одновременно 5–10 SKU, следя за долей ошибок и средним временем.
- Массовое масштабирование: убедившись, что доля ошибок под контролем, повышайте параллельность под свой объём работы — в пределах 500 RPM можно работать без ограничений.
| Способ вызова | Время на комплект из 5 изображений | Стабильность | Когда использовать |
|---|---|---|---|
| Последовательный вызов | Примерно 5× времени одной картинки | Самый стабильный, удобно отлаживать | Этап отладки промптов |
| Параллельно внутри комплекта (5 потоков) | Примерно равно времени самой медленной картинки | Стабильно | Обычное обновление ассортимента |
| Несколько SKU + параллельность внутри комплекта | Близко к одному комплекту | Нужны повторные попытки | Массовое обновление перед распродажей |
🚀 Совет по масштабированию: если нужно массово обновить ассортимент перед большой распродажей, рекомендуем через APIYI apiyi.com использовать схему «несколько SKU + параллельность внутри комплекта». На платформе до 500 RPM не требуется никаких заявок; вместе с механизмом догенерации неудачных картинок комплекты для десятков SKU можно полностью подготовить за очень короткое время.
gpt-image-2 电商套图方案怎么选
两种方案并不互斥,实际业务中经常组合使用。下面按常见平台和场景给出推荐:
| 平台/场景 | 推荐方案 | 建议张数 | 说明 |
|---|---|---|---|
| 淘宝/天猫主图 | 方案二 | 5 张 | 主图、白底、卖点、场景、参数各一张 |
| 淘宝/拼多多详情页 | 方案一 + 方案二 | 3-6 张半屏图 | 分段生成后纵向拼接 |
| 亚马逊 Listing | 方案二 | 7 张 | 首图白底严格合规,其余做卖点和场景 |
| 独立站商品页 | 方案二 | 4-6 张 | 场景图权重更高,突出品牌调性 |
| 小红书种草 | 方案二 | 3-6 张 | 3:4 竖版,生活化场景为主 |
| 活动海报/卖点合集 | 方案一 | 1 张 | 单图信息集中,传播效率高 |
选择的核心原则很简单:需要独立投放、独立展示的图,用方案二;只在一个页面里连续阅读的内容,用方案一。如果拿不准,就先用方案二出主图和场景图,再用方案一出一张卖点合集长图,覆盖面最广。
💡 组合建议:两种方案用的是同一个 gpt-image-2 模型、同一套 API Key。建议把两套流程封装成一个服务,按商品类型自动选择方案,商家只需要上传一张产品图和几行卖点文字即可。
常见问题
gpt-image-2 的 n 参数能直接生成电商套图吗?
不能。官方 gpt-image-2 和 2.5 系列都支持 n 参数,APIYI 也支持,但它是同一个提示词生成 n 张变体。套图的每张图内容不同,需要不同的提示词,所以要多次调用。n 更适合用在主图这种关键位置做择优。
生成的多张图里产品长得不一样怎么办?
这是套图最常见的问题。最有效的做法是每次调用都用 edits 接口传入同一张产品实拍图,并在提示词里写明「保持参考图中产品的颜色、Logo 和结构不变」。同时把风格描述固定成 style block,不要让文本模型自由发挥。参考图建议用背景干净、光线均匀的实拍图,还原效果最好。
图中的中文文字渲染错误怎么处理?
gpt-image-2 的中文渲染能力已经很强,但文字越多出错概率越高。建议每张图的文字控制在 2-3 个短句以内,在提示词中用引号标出文字原文。如果某张图文字出错,只重新生成这一张即可,不用整套重来。
文本拆解用哪个模型最划算?
调试提示词模板时用 gpt-6.1-sol,规划质量最好;模板稳定后批量跑量,可以切换到 claude-haiku-5-5 或 gemini-3.8-flash,成本更低、速度更快。这一步每套图只调用一次,花费远低于出图本身。三款模型在 APIYI apiyi.com 上用同一个 API Key 即可调用。
并发调用需要申请额度吗?
不需要。APIYI 对 gpt-image-2 没有设置并发上限,500 RPM 以下直接使用即可。建议先用 1-3 个 SKU 做小规模测试,确认效果后再逐步提高并发放量。
Итог
При генерации наборов изображений для e-commerce с помощью gpt-image-2 ключевое — понять особенность его API: «один вызов соответствует одному промпту». Параметр n решает задачу выбора лучшего варианта, а набору изображений нужны множественные вызовы с разными промптами. При таком раскладе контент для последовательного чтения — страницы товара, подборки преимуществ — можно сгенерировать за один проход по схеме «одно изображение, много аспектов»; а наборы вроде главных изображений и сцен-фонов, которые нужно показывать по отдельности, — пакетно, через конвейер «декомпозиция текстовой моделью + параллельные вызовы».
Общая основа обоих подходов — контроль согласованности: фиксированный style block плюс одно и то же эталонное изображение продукта — вот что заставляет несколько картинок выглядеть так, будто их сделала одна команда дизайнеров.
По параллелизму: ниже 500 RPM можно смело запускать на полную мощность, а самый надёжный путь — три шага: «малый тест → средняя нагрузка → пакетный запуск».
Мы рекомендуем собрать весь конвейер в одном месте через APIYI apiyi.com: gpt-6.1-sol, claude-haiku-5-5 и gemini-3.8-flash отвечают за декомпозицию требований, gpt-image-2 — за генерацию изображений, а один API-ключ связывает все этапы — так можно быстро построить собственный сервис генерации e-commerce наборов изображений.
Автор: APIYI Team | Делимся техническими материалами об API больших языковых моделей. Больше руководств по подключению моделей — на APIYI apiyi.com