Примечание автора: от критериев приёмки и изоляции данных до независимой проверки — как за 5 шагов выстроить внешнюю валидацию для глубоких задач с ИИ и не дать модели самой себе поставить «зачёт» за невыполненную работу.
Модель отвечает «задача выполнена, результаты точные», но воспроизвести их не получается — с этой проблемой сталкиваются многие, кто берётся за нетривиальные задачи с ИИ. В этой статье — методика проектирования внешней валидации, которую можно запускать независимо: она помогает превратить «модель говорит, что сделала» в «есть доказательства, что сделано».
Felix Rieseberg, разработчик Claude, в практическом руководстве, опубликованном в октябре 2026 года, прямо советует: не позволяйте модели оценивать саму себя и опирайтесь на внешнюю валидацию. По его мнению, идеальный вариант — инструменты, которые модель может запускать сама и сразу получать обратную связь. 4 ноября 2026 года InfoQ опубликовал китайский перевод этой статьи.
Это не очередное напоминание «проверьте лишний раз». В оригинале задано направление, а здесь я разбираю его на конкретные шаги, которые можно внедрить: как выбирать средства проверки, какие режимы отказа встречаются чаще всего и как устроить проверку силами нескольких моделей.
В чём польза: дочитав до конца, вы сможете написать для своих глубоких задач с ИИ контракт валидации — чтобы модель двигалась к результату по проверяемой обратной связи, а не завершала работу самооценкой.
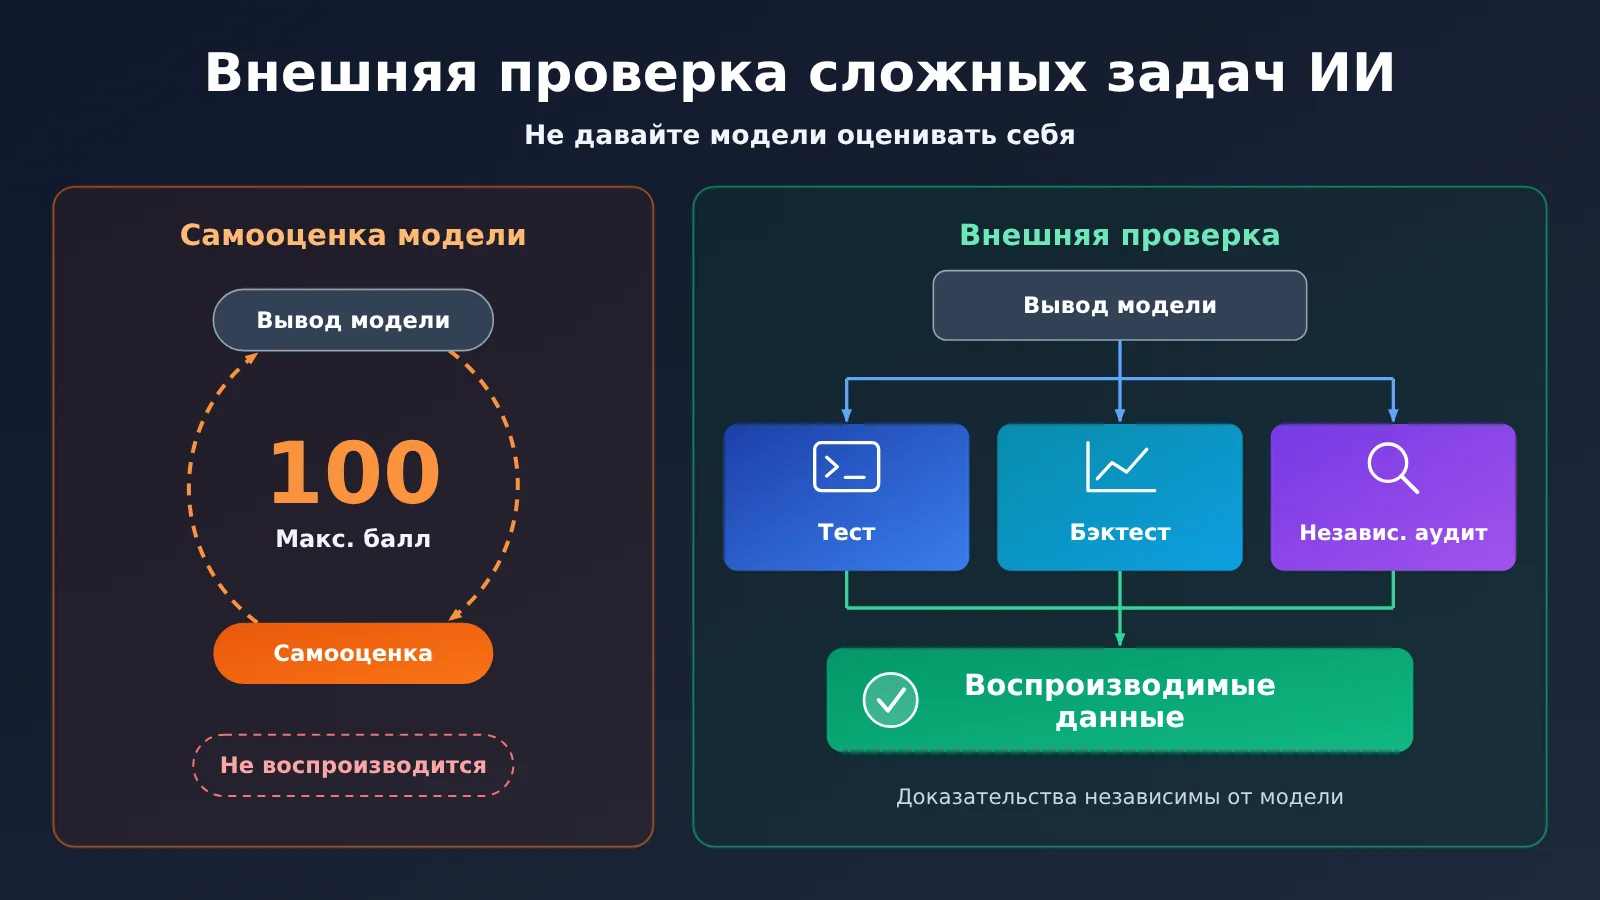
Ключевые принципы внешней проверки глубоких задач ИИ
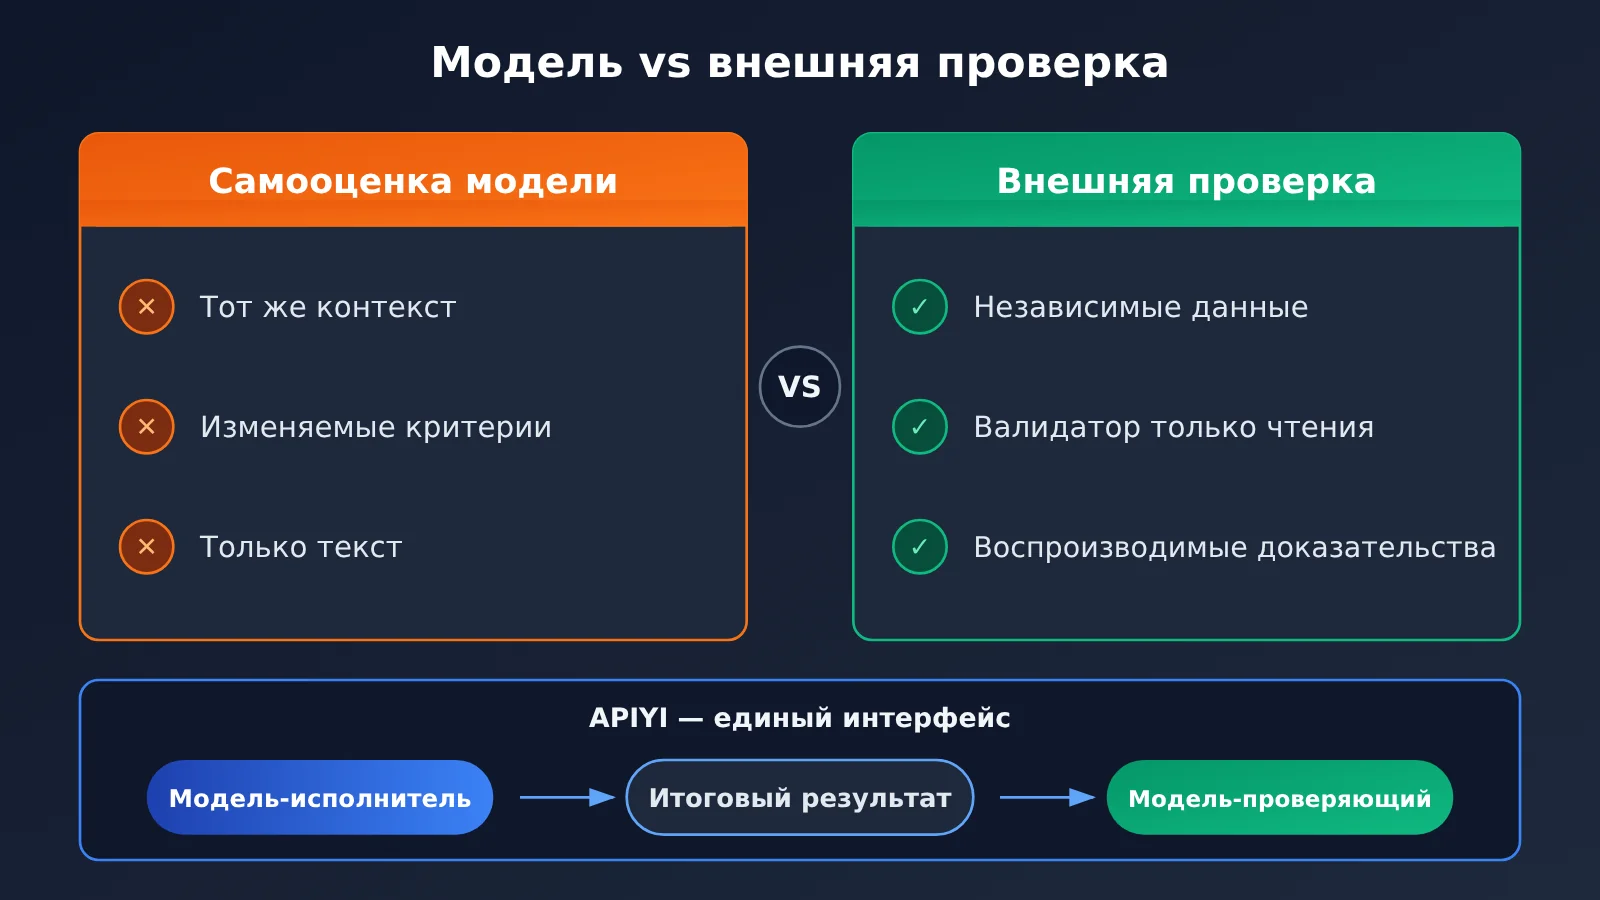
Суть внешней проверки не в том, чтобы добавить ещё один этап контроля, а в том, чтобы сделать основание для суждения независимым от собственных рассуждений модели.
| Пункт | Описание | Ценность |
|---|---|---|
| Сначала критерии | До начала работы чётко описать условия прохождения и по возможности сделать их проверяемыми | Не даёт модели задним числом переопределить цель |
| Изоляция данных | Проверять выводы на данных или сценариях, которых модель не видела | Отличает реальное открытие от подгонки post hoc |
| Приоритет инструментов | По возможности использовать валидаторы, которые можно запустить и сразу получить обратную связь | Позволяет модели самостоятельно итерироваться и снижает потребность в ручном контроле |
| Сохранение доказательств | Сохранять результаты запусков, логи и шаги воспроизведения | Даёт людям возможность проверять выводы, а не просто верить им |
| Независимая перепроверка | Оспаривать результат разными методами и с разных позиций | Помогает найти проблемы, которые пропустил отдельный валидатор |
Почему для глубоких задач ИИ нужна внешняя проверка
То, что Ризеберг называет «глубиной», — это использование инструментов, методов и знаний ведущих экспертов предметной области, погружение в исходные данные, а не работа на поверхности задачи. Чем глубже задача, тем труднее человеку интуитивно судить, верен ли результат. Профессионально сформулированный анализ оттока может читаться убедительно, но это не доказывает, что причинно-следственные выводы в нём верны.
Он также отмечает частый эффект: когда модель просят вести себя как эксперт, она часто лишь меняет словарь, а сам способ работы по сути не меняется. Самооценке трудно выявить такие проблемы, потому что оценивающий и создающий результат опираются на одни и те же допущения. Если рассуждение изначально смещено, модель при выставлении оценки может воспроизвести тот же перекос.
Смелые цели делают проверку ещё важнее. В оригинале предлагается ставить на первый взгляд неразумные цели — например, сократить время загрузки сайта с 10 секунд до 200 мс — и требовать, чтобы модель продолжала попытки. Такие цели работают потому, что 200 мс можно измерить. Если цель одновременно радикальна и непроверяема, скорее всего, получится лишь отчёт, звучащий увереннее.
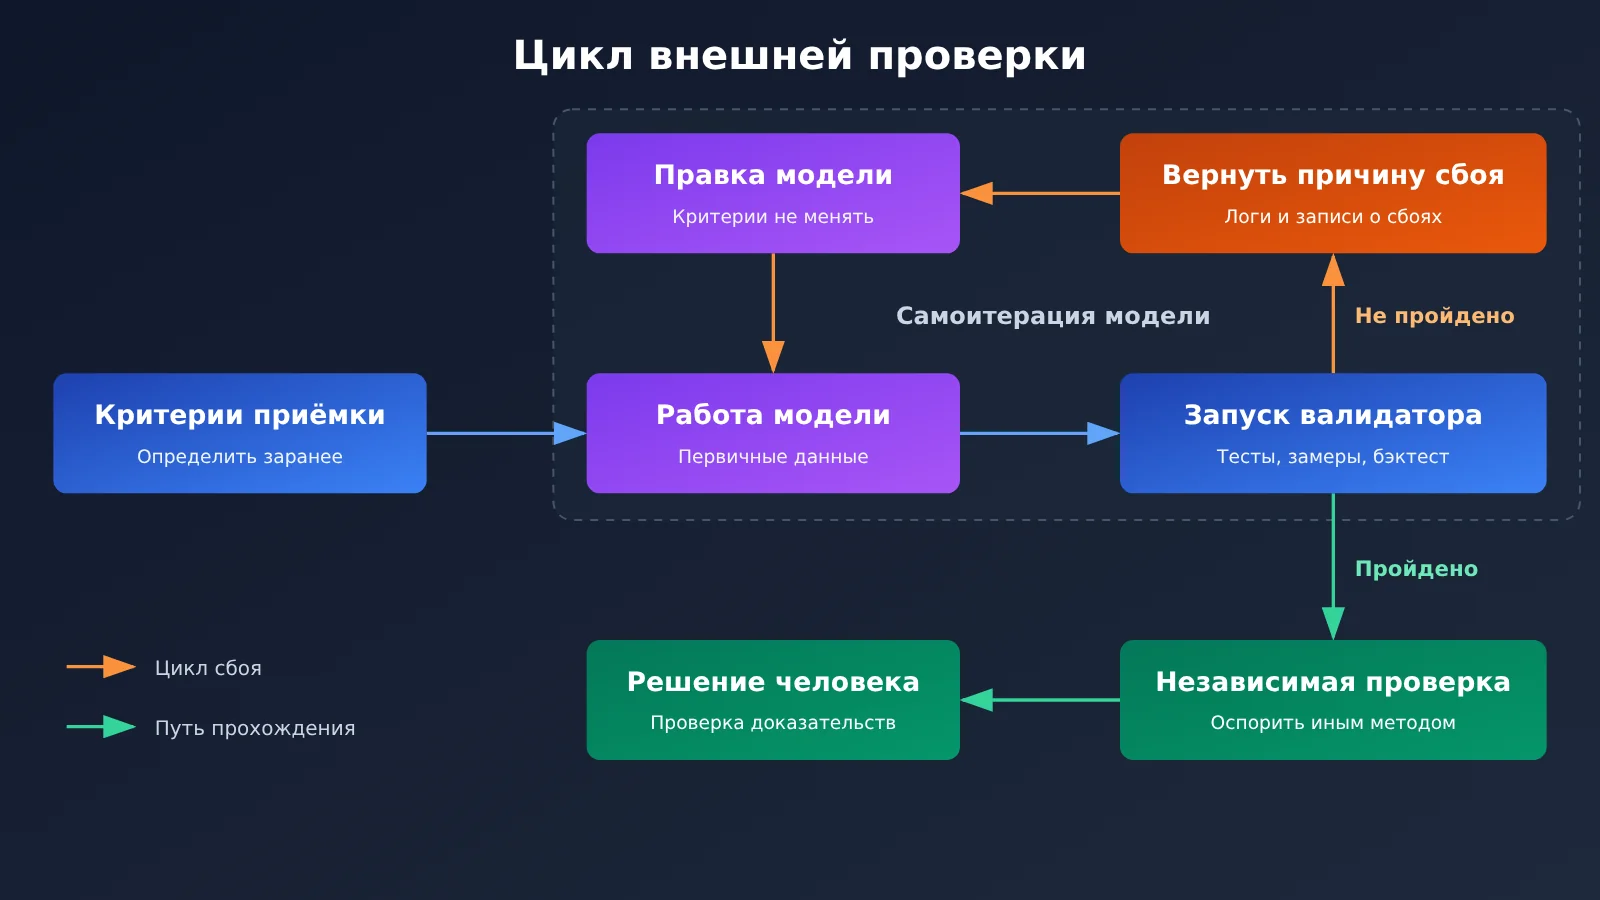
Быстрый старт внешней проверки для сложных задач AI: метод проектирования из 5 шагов
Этот подход не привязан к конкретной модели или фреймворку — можете взять любую текущую задачу и сразу применить его. Если всё реализовать пока не получается, начните с первых трёх шагов.
Шаг 1. Перепишите цель задачи в виде критериев внешней проверки
«Анализ получился полным» и «код качественный» напрямую не проверить — такие формулировки нужно переписать в условия, которые можно либо пройти, либо не пройти. Например, «исправить падение» превращается в «по исходным шагам воспроизведения программа больше не падает, и все связанные тесты проходят». Критерии нужно зафиксировать до того, как модель начнёт работу, иначе после завершения она может подогнать определение успеха под результат.
Можно сначала написать такой контракт проверки, а затем передать его модели на выполнение:
| Поле | Что нужно чётко указать | Пример |
|---|---|---|
| Конечная цель | Реальный бизнес- или инженерный результат, который нужен | Приложение остаётся стабильным, такие же падения больше не возникают |
| Исходные материалы | Первичные данные, которые модель должна использовать напрямую | Отчёт о падении, соответствие версий и Git-коммитов |
| Валидатор | Инструмент или данные, по которым определяется результат | Скрипт воспроизведения, автотесты, отложенная выборка |
| Условия прохождения | Явные пороги или правила оценки | На трёх целевых системах падение больше не воспроизводится |
| Что запрещено | Что модель не должна менять | Нельзя удалять тесты, нельзя изменять отложенную выборку |
| Доказательства выполнения | Какие результаты запуска нужно приложить | Команды, логи, записи о сбоях и итоговый результат |
| Условия остановки | Когда завершать работу или передавать человеку | После достижения лимита итераций сообщить причину блокировки |
Шаг 2: разорвать связь между выводами и проверочными данными
Когда модель выдвигает гипотезу и доказывает её на одних и тех же данных — это не внешняя проверка. Пример с оттоком пользователей из оригинальной статьи даёт хороший подход: пусть модель ищет в логах самые ранние сигналы оттока, а затем на данных, которых она не видела, докажет, что этот сигнал действительно обладает предсказательной способностью. На практике можно разделить данные по времени: ранние данные — для исследования, поздние — для проверки.
Holdout-данные лучше хранить в отдельном скрипте или у отдельного человека: модель должна получать только результат работы, а не читать детали напрямую. Если раз за разом подстраивать подход под результаты, holdout-данные постепенно тоже будут «выучены». Поэтому для важных выводов лучше дополнительно приберечь набор данных, который используется только при финальной приёмке.
Шаг 3: отдавать приоритет внешним инструментам проверки, которые модель может запускать сама
Чем ближе валидатор к реальному результату и чем быстрее обратная связь, тем самостоятельнее модель может итерировать. В таблице ниже собраны несколько способов внешней проверки для типовых задач. При выборе не стоит гнаться за единственным «самым сильным» вариантом — лучше комбинировать их в зависимости от рисков.
| Способ проверки | Что доказывает | Скорость обратной связи | Основные ограничения |
|---|---|---|---|
| Автотесты и скрипты воспроизведения | Заданное поведение соответствует ожиданиям | Быстро | Покрывают только описанные сценарии |
| Инструменты измерения производительности | Достигнут ли показатель порога | Быстро | Различия окружений могут влиять на результат |
| Бэктест на holdout-данных | Обладают ли выводы предсказательной способностью | Средне | Исторические закономерности не всегда сохраняются |
| Ревью методом «красной команды» | Насколько слабы гипотезы и цепочка доказательств | Средне | Качество оценки зависит от метода ревью |
| Теневой запуск | Работает ли решение в реальном процессе | Медленно | Долгий цикл, высокие организационные затраты |
| Выборочная проверка экспертами предметной области | Соответствуют ли результаты профессиональному суждению | Медленно | Трудно охватить в больших масштабах |
Шаг 4: встраиваем внешнюю проверку в рабочий цикл модели
Инструмент проверки начинает давать эффект непрерывных итераций только тогда, когда попадает в рабочую среду модели. Показателен пример из оригинальной статьи с исправлением падений: автор сначала дал Claude удобный доступ к отчётам о сбоях, сведения о том, какой Git-коммит соответствует каждой версии, а также возможность использовать машины на Windows, macOS и Linux. Только при этих условиях модель может самостоятельно воспроизвести проблему и проверить исправление.
Это также показывает, что внешняя проверка часто требует перестройки рабочего процесса, а не только правки промпта. Нужно открыть доступ к необходимым данным и инструментам — например, подключить источники данных через MCP-коннектор — и при этом ограничить права рамками задачи. В дизайне цикла должно быть как минимум три составляющих:
- Обратная связь о сбоях: возвращайте конкретные логи ошибок и список непройденных проверок, а не только слово «сбой».
- Лимит итераций: ограничивайте число повторов и общий бюджет, чтобы модель не застряла в бесполезном цикле.
- Защищённые объекты: тесты, скрипты проверки и данные отложенной выборки должны быть доступны только для чтения, чтобы модель не могла «пройти» проверку, поменяв сами критерии.
Шаг 5: завершаем внешнюю проверку независимой перепроверкой и параллельным запуском
То, что проверку прошёл один валидатор, ещё не значит, что вывод надёжен. В оригинале предлагается привлекать «красную команду», которая специально ищет ошибки, — например, инвесторов, играющих на понижение, и судебных бухгалтеров-экспертов. Но важно не копировать их манеру, а использовать их реальные методы исследования. Например, требовать от модели прослеживать первоисточник каждой ключевой цифры или активно искать данные, способные опровергнуть вывод.
Для изменений в процессах можно дополнительно использовать параллельный запуск. В оригинале предлагается сначала на исторических данных доказать, что новый механизм разбора мог бы выявить проблему раньше, а затем запустить его параллельно с текущим процессом на квартал. Так можно проверить реальный эффект и при этом не брать на себя риск полной замены старого процесса с самого начала.
Рекомендация по подключению: если нужно разделить выполнение и проверку между разными моделями, их можно единообразно вызывать через APIYI. APIYI предоставляет API-доступ к моделям, упомянутым в статье, и совместим с форматами интерфейсов OpenAI и Anthropic. При подключении обычно достаточно настроить
base_url,api_keyиmodelпо документации. Адрес документации: https://docs.apiyi.com
Распространённые режимы отказа при внешней валидации глубоких задач ИИ
Внешняя валидация тоже может выродиться в формальность. Эти проблемы стоит продумать ещё на этапе проектирования — иначе проверка даст лишь ложное чувство безопасности.
| Режим отказа | Типичное проявление | Как противодействовать |
|---|---|---|
| Изменение критериев | Удаление провальных кейсов или ослабление утверждений | Валидатор работает только на чтение, плюс аудит изменений |
| Переобучение на валидационной выборке | Метрики стабильно растут, а на новых данных всё ломается | Держать отдельный финальный набор для приёмки |
| Циркулярное доказательство | Выводы модели проверяются данными, которые сгенерировала та же модель | Возвращаться к исходным логам и первичным материалам |
| Проверка только формы | Формат правильный, а содержание — нет | Добавить бизнес-правила и выборочную сверку |
| Ролевая игра | Диалог звучит как эксперт, а результат не улучшился | Требовать выполнения конкретного метода и подтверждений |
Отдельно стоит сказать про «перепроверку второй моделью». Она лучше самооценки, потому что позволяет вскрыть часть слепых зон, но всё равно остаётся проверкой, основанной на суждении, и не заменяет тестирование или реальные данные. При перепроверке лучше давать только критерии задачи, исходные материалы и финальный результат — без предыдущего диалога, чтобы снизить влияние исходных рассуждений на суждение.
Примеры дизайна внешней валидации для разных глубоких задач ИИ
Приведённые примеры можно взять за отправную точку; конкретные пороги нужно определять исходя из бизнес-контекста.
| Задача | Как делают, полагаясь только на самооценку | Дизайн внешней валидации |
|---|---|---|
| Починить падение приложения | Модель объясняет принцип исправления и объявляет задачу выполненной | Воспроизвести в другой системе и убедиться, что после фикса проблема не повторяется |
| Найти сигналы оттока | Модель выдаёт правдоподобный отчёт о причинах | Проверить предсказательную способность на данных, не участвовавших в исследовании |
| Проверить причины оттока | Модель повторяет вывод «проблема в онбординге новых пользователей» | Искать в исходных данных подтверждения и опровержения |
| Ускорить загрузку | Модель перечисляет оптимизации и оценивает выигрыш | Замерить в фиксированной среде и сравнить с целевым порогом |
| Перестроить разбор бизнес-кейса | Модель доказывает, что новое решение прогрессивнее | Исторический бэктест, затем квартал параллельной работы с текущим процессом |
Понять, стоит ли задача такого дизайна, поможет простой критерий: превышает ли цена ошибки стоимость проверки. Если речь о переписывании одного письма — возможно, достаточно прочитать его один раз. Но если результат влияет на продакшн-системы или распределение ресурсов, внешнюю валидацию стоит спроектировать.
Часто задаваемые вопросы (FAQ)
Вопрос 1. Что такое внешняя проверка сложных задач ИИ?
Это проверка результата на основе данных, независимых от собственных суждений модели: например, автоматические тесты, замеры производительности, бэктест на отложенных данных и экспертная оценка. Ключевое требование — критерии оценки не должны определяться «на ходу» самой моделью, выдавшей результат.
Вопрос 2. Чем внешняя проверка отличается от самопроверки модели?
Самопроверка модели позволяет быстро находить очевидные пропуски, но и производитель, и оценщик опираются на одни и те же допущения. Внешняя проверка добавляет независимый источник доказательств и лучше подходит для оценки того, действительно ли результат корректен. Эти подходы можно сочетать, но самопроверка не может служить окончательным критерием приёмки.
Вопрос 3. Модели становятся сильнее — нужна ли ещё внешняя проверка?
Rieseberg считает, что по мере развития моделей эта проблема в конце концов может решиться, но прямо рекомендует придерживаться внешней проверки как минимум до октября 2026 года. Это практическое суждение текущего этапа. Пока надёжность самооценки моделей не подтверждена, для задач с высоким риском следует сохранять независимую проверку.
Вопрос 4. В каких сценариях внешняя проверка нужнее всего?
В основном это следующие категории задач:
— **Инженерные исправления**: устранение сбоев, оптимизация производительности и миграция данных.
— **Исследование данных**: анализ оттока, оценка причинно-следственных связей и поиск сигналов для прогнозирования.
— **Долго работающие агентные процессы**: задачи, где модель должна непрерывно работать при минимальном вмешательстве человека.
Вопрос 5. Как через API организовать перекрёстную проверку несколькими моделями?
Можно подключиться через единый APIYI — его интерфейс совместим с форматами OpenAI и Anthropic:
1. Настроить адрес интерфейса и API-ключ по документации APIYI https://docs.apiyi.com.
2. Сверить доступные модели и их стоимость на странице цен https://docs.apiyi.com/models.
3. Задать разные `model` для выполнения и для проверки; запрос на проверку не должен содержать диалог этапа выполнения.
4. Записывать замечания проверяющей модели отдельно от результатов тестов, отдавая приоритет тестам и данным.
Вопрос 6. Как оценить стоимость цикла внешней проверки?
Общая стоимость обычно зависит от числа итераций, длины контекста, длины вывода и количества проверяющих моделей. Рекомендуется сначала прогнать несколько раундов на небольшой выборке, зафиксировать фактический расход за каждый раунд, а затем оценить бюджет с учётом лимита итераций. В этой статье мы не приводим конкретные цены: стоимость моделей, правила тарификации, цена входа и выхода, а также цена кэширования — всё берётся из актуальных данных на странице цен APIYI https://docs.apiyi.com/models.
Вопрос 7. Какие есть ограничения у внешней проверки?
Тесты покрывают только заранее описанные сценарии, бэктест не гарантирует, что исторические закономерности сохранятся, а цикл теневого запуска довольно длинный. Успешная проверка означает лишь, что результат подтверждён в заданных условиях, и не равно абсолютной правильности. Когда речь идёт о юридических, финансовых вопросах и важных бизнес-решениях, окончательное решение всё равно должны принимать ответственные за это люди.
Ключевые выводы: внешняя проверка сложных задач ИИ
- Основной принцип: не принимайте самооценку модели за основание для приёмки — суждение должно опираться на независимые доказательства.
- Стандарты заранее: до начала работы запишите условия прохождения, чтобы не переопределять успех задним числом.
- Изоляция данных: проверяйте находки модели на данных, которых она не видела, чтобы избежать круговой аргументации.
- Инструменты в приоритете: валидаторы, которые можно запустить и сразу получить обратную связь, лучше всего подходят для самостоятельных итераций.
- Среда имеет значение: модели нужны данные, инструменты и среда выполнения, чтобы самостоятельно исправляться.
- Многоуровневая проверка: вторая модель нужна для поиска слепых зон и не заменяет тесты и реальные данные.
- Гибкое подключение: через APIYI можно единообразно вызывать несколько моделей и снизить затраты на подключение перекрёстной проверки.
Итог
При проектировании внешней проверки сложных задач ИИ запомните три вещи:
- Сначала превратите цель в проверяемый критерий: без условий прохождения невозможно понять, действительно ли задача выполнена.
- Сделайте доказательства независимыми от рассуждений модели: изолируйте данные, защищайте валидатор и сохраняйте полные журналы выполнения.
- Комбинируйте методы проверки по уровню риска: инструменты дают быструю обратную связь, перекрёстная проверка выявляет слепые зоны, а параллельный запуск проверяет реальный эффект.
Следующий шаг: выберите одну сложную задачу из текущих дел, сначала напишите контракт проверки, а затем позвольте модели приступить к работе. Это не только уменьшает количество ошибок, но и позволяет ставить более смелые цели: какими бы амбициозными они ни были, результат всегда можно проверить.
Если нужно построить процесс выполнения и проверки с участием нескольких моделей, можно протестировать вызовы через APIYI. Способ подключения описан на https://docs.apiyi.com; цены на модели и правила тарификации смотрите в актуальных данных на https://docs.apiyi.com/models.
📚 Справочные материалы
- Как ставить перед собой более смелые цели: практическое руководство для пользователей ИИ: китайский перевод InfoQ
- Ссылка:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Описание: практические методы по трём направлениям — выше, глубже, шире
-
How to be more ambitious: A tutorial for humans with models: оригинал Felix Rieseberg
- Ссылка:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Описание: первоисточник советов по внешней проверке и кейсов — исправление сбоев, отток пользователей и т. п.
-
Центр документации APIYI: инструкция по подключению к API
- Ссылка:
docs.apiyi.com -
Описание: используется для проверки настроек подключения в форматах, совместимых с OpenAI и Anthropic
-
Страница моделей и цен APIYI: информация о моделях и тарификации
- Ссылка:
docs.apiyi.com/models - Описание: цены на модели, правила тарификации и стоимость кэширования — всё берётся с этой страницы
Автор: техническая команда APIYI
По техническим вопросам: будем рады общению — свяжитесь с нами на главной странице сайта APIYI, а больше материалов найдёте в центре документации docs.apiyi.com