Примечание автора: разбираем двухуровневую архитектуру Router + Worker в DeepSeek Super-agent, её подход к разделению общей координации и самостоятельного выполнения задач, а также ситуации, в которых разработчикам стоит применить похожий подход в своих Agent-системах.
Если одновременно открыть четыре-пять окон с Coding Agent, быстро возникает вполне практическая проблема. В одном окне исправляют баг авторизации, в другом проверяют миграцию базы данных, а в третьем ждут результатов CI. Приходится помнить, чем занят каждый агент, кто ждёт вашего ответа и какие задачи связаны между собой. Модели действительно становятся всё более самостоятельными, но управление этими сессиями по-прежнему ложится на человека.
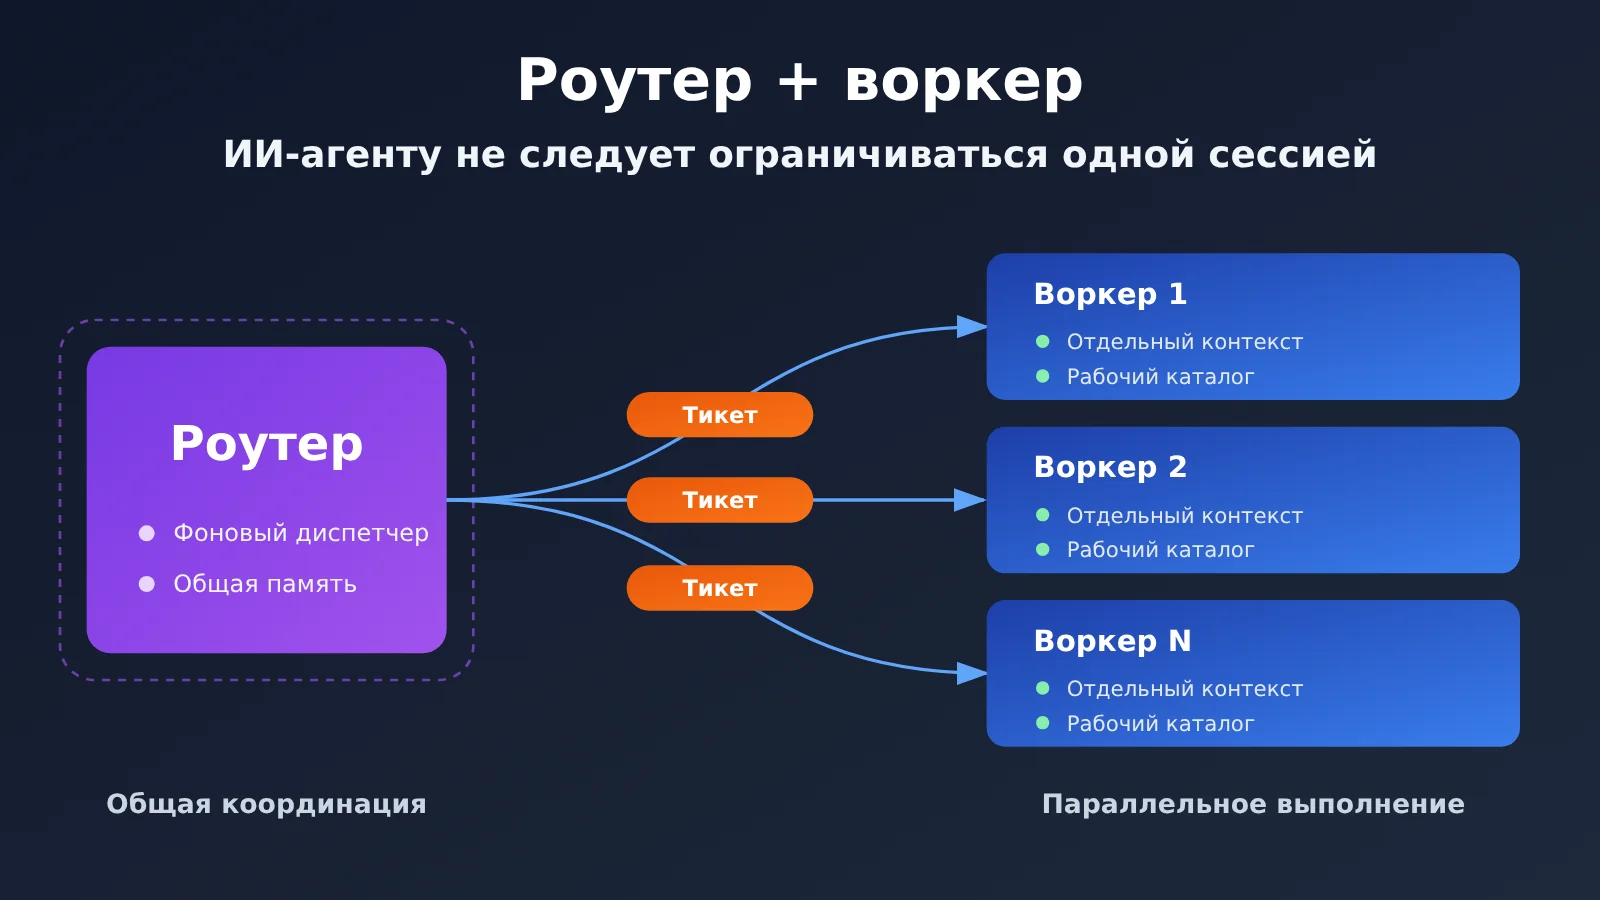
31 октября 2026 года команда DeepSeek Harness опубликовала техническую статью «Исследование дизайна Super-agent: на пути к более автономным Agent-системам» и открыла исходный код исследовательского прототипа dsh-superagent-prototype под лицензией MIT. Его ключевой элемент — двухуровневая архитектура Router + Worker: постоянно работающий Router отвечает за общую координацию, а несколько изолированных Worker выполняют конкретные задачи.
Это не уловка в духе «заставим один ИИ делать больше дел одновременно». Суть Super-agent — разделить общую координацию и самостоятельное выполнение задач на уровне архитектуры, чтобы человеку было проще управлять несколькими сессиями. В этой статье мы разберём, зачем понадобилась такая архитектура, как она работает, что показывают официальные эксперименты и какие выводы из них можно сделать для вызовов API и управления затратами.
Главное: прочитав статью, вы поймёте, какую проблему решает двухуровневая архитектура Router + Worker, и сможете определить, когда похожий подход пригодится в вашей Agent-системе.
Router + Worker: главное о проекте
Прежде чем разбирать архитектуру, уточним основные факты о релизе. Важно: DeepSeek выложила в открытый доступ исследовательский прототип, а не готовый коммерческий продукт и не новую базовую модель.
| Параметр | Подробности |
|---|---|
| Дата выпуска | 31 октября 2026 года (техническая статья и репозиторий на GitHub опубликованы в один день) |
| Разработчик | Команда DeepSeek Harness |
| Название проекта | dsh-superagent-prototype, основной язык — TypeScript, лицензия MIT |
| Статус проекта | Исследовательский прототип, а не готовый коммерческий продукт; для работы требуется DeepSeek Harness |
| Архитектура | Двухуровневая структура: Router отвечает за общую координацию, Worker — за изолированное выполнение задач |
| Что поддерживается сейчас | Отслеживание одного репозитория GitHub, опциональное подключение Feishu, управление тикетами, независимые сессии Worker и создание PR |
| Интерес сообщества | По состоянию на 2 ноября — около 8900 звёзд и 898 форков; цифры постоянно меняются |
Разработчики выделяют четыре целевых свойства Super-agent: Continuous (сохранение контекста между каналами), Productive (параллельное выполнение нескольких задач), Proactive (инициативная реакция на события в рамках предоставленных полномочий) и Persistent (постоянная работа и восстановление после некоторых сбоев). Это цели разработки, а не список возможностей, уже полностью реализованных в открытом прототипе.
Почему AI-агенту недостаточно одной сессии
Команда DeepSeek считает, что узкое место инструментов для программирования с ИИ смещается от «возможностей модели» к «вниманию человека». По повседневным наблюдениям команды, человек обычно может эффективно следить примерно за 3–5 активными сессиями агентов. Это оценка, основанная на опыте команды, а не публичная статистика масштабного исследования. Но она точно отражает ощущения многих разработчиков.
Дилемма: одна сессия или несколько
У каждого из двух распространённых подходов есть серьёзные недостатки. Архитектура Router + Worker предложена, чтобы совместить непрерывность глобального контекста с возможностью параллельной работы в фоне.
| Архитектура | Преимущества | Главная проблема |
|---|---|---|
| Одна сессия для всей работы | Глобальный контекст сохраняется естественным образом | Информация о задачах смешивается; длительные вызовы инструментов блокируют новые задачи; работа ограничена одним циклом ReAct |
| Отдельная сессия для каждой задачи | Параллельное выполнение, изоляция контекста | Нет общей памяти; человеку приходится помнить связи между задачами; диалоги и уведомления разбросаны по нескольким окнам |
| Двухуровневая архитектура Router + Worker | Централизованное глобальное состояние + изоляция контекста выполнения | Более высокий расход ресурсов на инференс; Router может стать узким местом |
Проблема одной сессии — «пробка», нескольких сессий — «разбросанность». В первом случае промежуточные шаги всех задач заполняют одно контекстное окно, во втором — вся координация ложится на человека. Идея DeepSeek — выделить на уровне системы роль, которая отвечает за «память о происходящем в целом», чтобы исполнители могли сосредоточиться на своих задачах.
Как работает двухуровневая архитектура Router + Worker
Router: глобальный уровень координации
Router — постоянно работающий логический слой. В текущем варианте архитектуры, который изучают разработчики, он реализован в основном как постоянная сессия LLM, но концептуально не обязательно должен быть привязан к одной сессии модели. Его задача — скорее управлять, чем выполнять работу:
- принимать сообщения пользователей и внешние события из GitHub, IM, CI и других источников;
- отслеживать связи между задачами и решать, нужно ли создавать новую;
- проверять полномочия, распределять задачи между Worker и координировать работу над разными задачами;
- собирать информацию для передачи человеку и при необходимости восстанавливать контекст старых задач.
Важная деталь: по мнению разработчиков, Router может вообще обходиться без инструмента Bash. Если он не выполняет сложные задачи программирования самостоятельно, длительные вызовы инструментов не блокируют его работу. При этом Router не всегда нужна самая мощная модель рассуждений: иногда для взаимодействия и распределения задач достаточно более лёгкой модели. Это даёт техническое обоснование для настройки разных моделей под разные роли.
Worker: уровень изолированного выполнения задач
Worker выполняет конкретную работу. В опубликованном прототипе одному Ticket соответствует одна сессия Executor, а у каждого Ticket есть собственная рабочая директория. Worker в рамках предоставленных полномочий меняет код, запускает тесты и обрабатывает последующие замечания. По завершении он формирует Report; если требуется решение человека, устанавливает статус Attention. Результат передаётся через исходный канал, например GitHub PR.
Контекст модели у каждого Worker независим. Это решает проблему смешивания промежуточных шагов разных задач в одном окне. Но важно помнить: отдельная сессия и отдельная директория не означают надёжной изоляции безопасности. В официальной документации по развёртыванию указано, что по умолчанию Worker выполняет команды от имени пользователя операционной системы, управляющего системой.
Как GitHub Issue проходит через Router + Worker
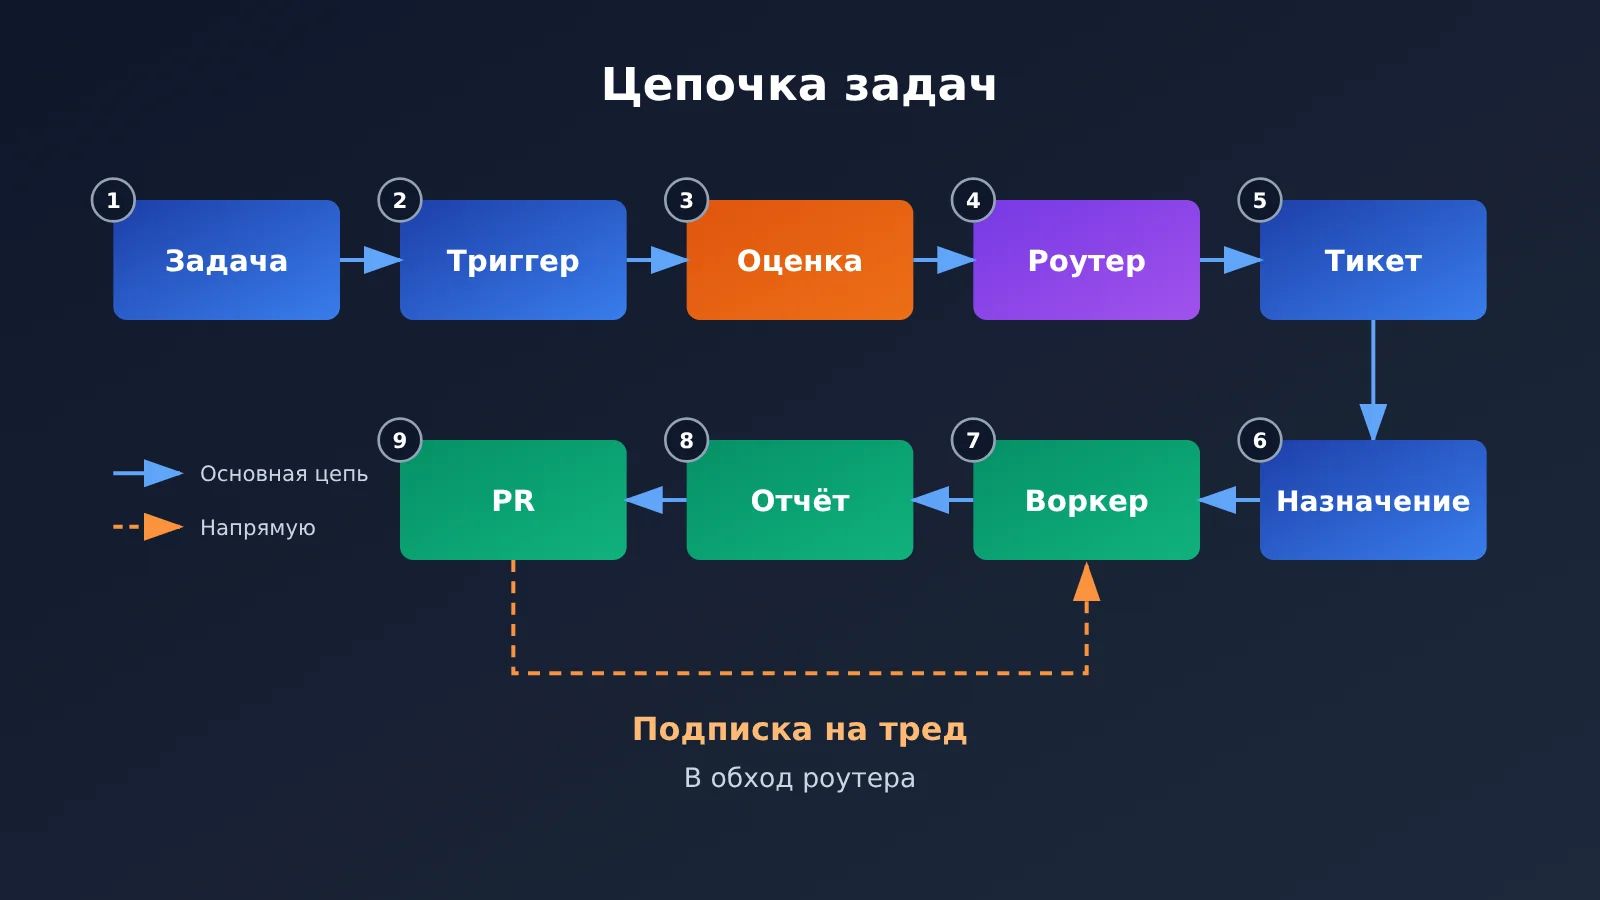
Согласно Domain Model реализации с открытым исходным кодом, цепочку обработки задачи можно представить так: Source → Trigger → Eval → Decision → Ticket → Assignment → Executor → Report. Рассмотрим пример, в котором авторизованный пользователь просит исправить баг в GitHub Issue:
- GitHub Source получает комментарий к Issue и создаёт Trigger;
- система сначала проверяет права по детерминированным правилам, а затем модель определяет, соответствует ли запрос правилам приёма задач;
- Router принимает задачу и создаёт Ticket, в котором фиксирует её объём и предоставленные полномочия (Mandate);
- система создаёт для Ticket назначение Assignment и передаёт его соответствующему Worker;
- Executor выполняет исправление в отдельной директории и отдельной сессии;
- Worker сообщает о ходе работы или представляет результат и создаёт PR;
- система передаёт результат пользователю в исходной ветке обсуждения Issue или PR.
Если затем пользователь оставит замечания в этом PR, новое сообщение можно автоматически связать с исходной задачей. Пользователю не придётся искать, «в какой сессии агента решался этот вопрос». Это конкретный пример того, как двухуровневая архитектура снижает нагрузку на человека.
Четыре ключевых решения в архитектуре Router + Worker
Двухуровневая архитектура — это лишь каркас. Работоспособной её делают несколько инженерных решений, каждое из которых отвечает на конкретную проблему:
| Решение | Какую проблему решает | Основной механизм |
|---|---|---|
| Прямая подписка на Thread | Все последующие сообщения проходят через Router, перегружая центральный узел | Worker подписывается на Thread, за который отвечает, и получает связанные события напрямую |
| Пакетная обработка в Router | При всплеске событий Router обрабатывает их по одному, что ограничивает пропускную способность | Trigger, накопившиеся во время работы модели, объединяются в один пакет для анализа |
| Inline & Spill | Контекстное окно ограничено, а передавать все данные слишком дорого | Необходимые недавние данные помещаются в окно, а от длинных материалов остаются краткое содержание и указатель для чтения |
| Цепочечное извлечение | Сложно найти информацию о прошлых задачах | Данные извлекаются последовательно по связям между Trigger, Thread, Ticket и Worker |
Прямая подписка на Thread: меньше повторных решений для Router
Допустим, Worker A отвечает за определённый PR. Тогда последующие комментарии и результаты CI для этого PR можно напрямую передавать Worker A по принадлежности к Thread. Router не придётся заново принимать решение для каждого связанного сообщения. Это типичный пример того, как частые, но малоценные решения выносятся за пределы центрального узла.
Однако у прямой подписки есть чёткие границы полномочий. В официальной документации по авторизации сказано: сообщения по подписке могут предоставлять контекст, но не могут расширять Mandate исходного Ticket. Если в последующем комментарии просят выполнить новую работу за пределами предоставленных полномочий, Worker должен вернуть запрос системе для повторной оценки. Это важно для защиты от инструкций во внешних комментариях, выходящих за рамки полномочий.
Пакетная обработка в Router: как справиться со всплеском событий
Пока Router выполняет очередной цикл рассуждений, новые Trigger накапливаются и в следующем цикле анализируются одним пакетом. Так вместо «один вызов модели на каждое сообщение» получается «несколько сообщений за один цикл рассуждений». При большом потоке событий это заметно снижает затраты на рассуждение в пересчёте на одно решение.
Inline & Spill и цепочечное извлечение: контекст как кэш
DeepSeek рассматривает контекстное окно как своего рода кэш. Inline означает, что недавняя информация, которая с высокой вероятностью понадобится, помещается прямо в окно. Например, последние комментарии к текущей задаче, связанные строки кода и необходимый окружающий код. Spill означает, что редко используемые или слишком длинные материалы остаются за пределами окна, а в нём сохраняются только краткое содержание, связанные ID и способ доступа к данным. Так можно поступить, например, с длинной историей обсуждения. Не связанные с задачей старые сообщения не нужно передавать каждый раз.
На этой основе построен Chain of Recall — цепочечное извлечение: модель может по мере необходимости восстанавливать историческую информацию, последовательно переходя по связям между объектами Trigger → Thread → Ticket → Worker. Это экономнее с точки зрения контекста, чем каждый раз передавать всю историю, и больше похоже на запрос к базе данных по индексу. Впрочем, разработчики признают, что память на протяжении нескольких месяцев и более длительных периодов всё ещё остаётся нерешённой проблемой.
Разбор результатов эксперимента Router + Worker
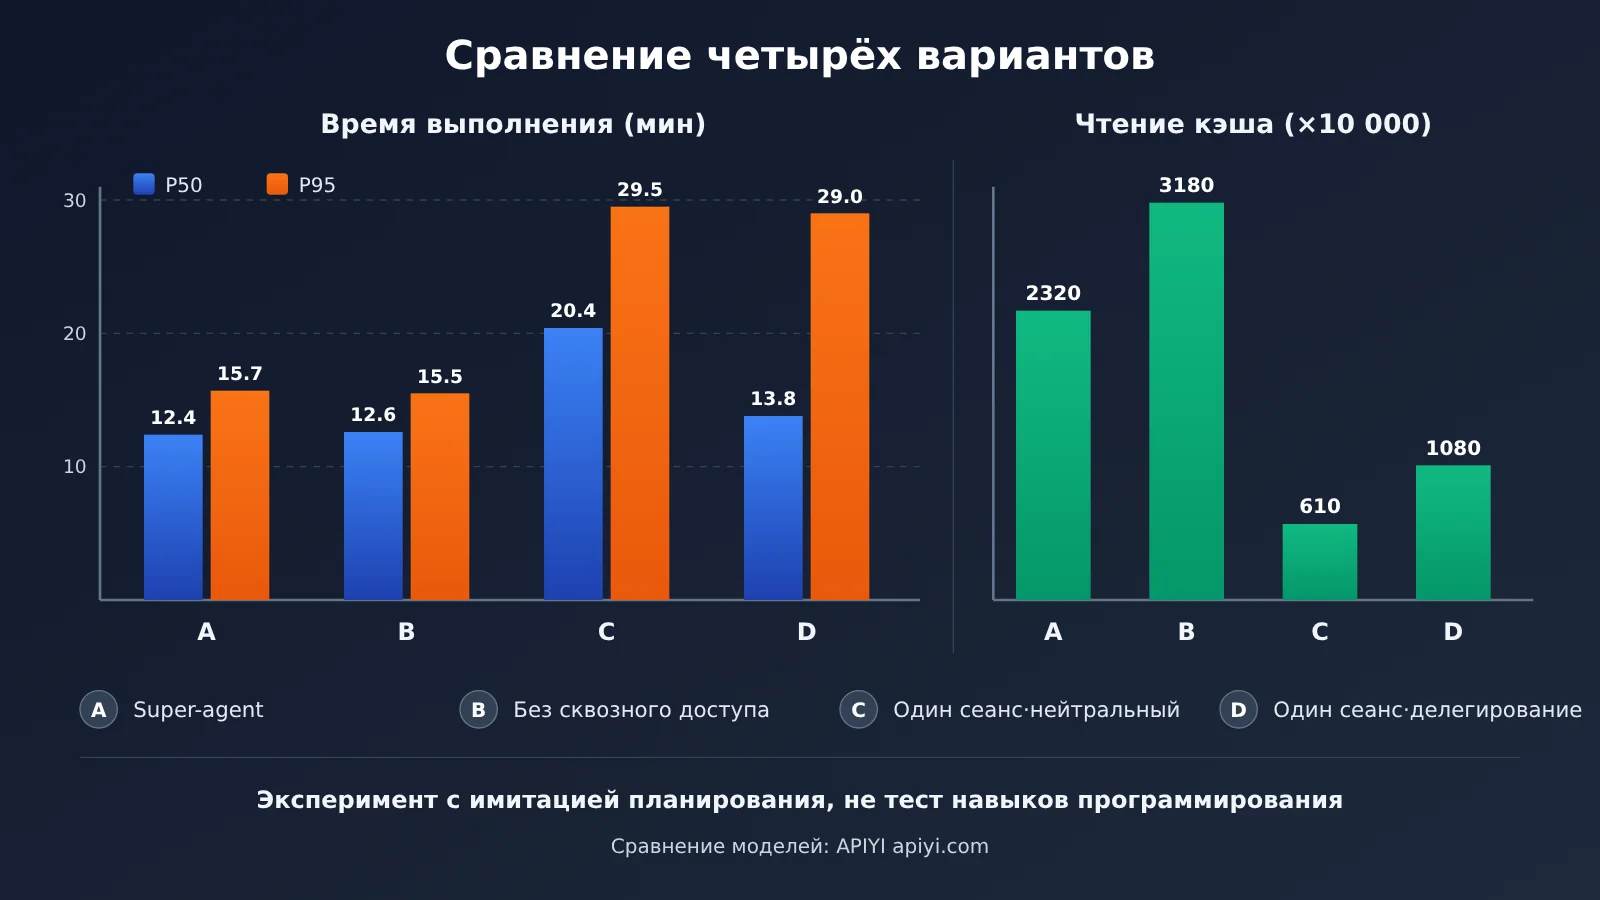
DeepSeek провела серию предварительных экспериментов с синтетической нагрузкой. Каждый прогон имитировал около 300 сообщений: примерно 20 рабочих запросов, а также неформальные беседы, последующие ответы, отмены запросов и сообщения CI. Каждый вариант запускали по пять раз. Работу по программированию заменили имитацией длительного вызова инструмента, поэтому результаты показывают эффективность системы планирования, а не качество генерации кода.
Сравнение сквозного планирования
| Вариант | Время выполнения P50 | Время выполнения P95 | Токены, прочитанные из кеша за эксперимент |
|---|---|---|---|
| Super-agent | 12,4 минуты | 15,7 минуты | Около 23,2 млн |
| Super-agent без прямой доставки по подписке | 12,6 минуты | 15,5 минуты | Около 31,8 млн |
| Один Session + Subagent, нейтральный промпт | 20,4 минуты | 29,5 минуты | Около 6,1 млн |
| Один Session + Subagent, приоритет делегирования | 13,8 минуты | 29,0 минуты | Около 10,8 млн |
По сравнению с вариантом с одной сессией и нейтральным промптом Super-agent сократил время выполнения P50 примерно на 39%, а P95 — примерно на 47%. По сравнению с вариантом, где делегирование было приоритетным, преимущество по P50 оказалось небольшим, но длинный хвост P95 заметно сократился. Иными словами, главный выигрыш двухуровневой архитектуры — самые медленные задачи больше не затягиваются так сильно.
Цена этого преимущества тоже очевидна: Super-agent прочитал из кеша примерно в 3,8 раза больше токенов, чем вариант с одной сессией и нейтральным промптом. Он использует больше параллельных сессий и вычислительных ресурсов, чтобы задачи выполнялись быстрее и стабильнее. Но это не означает, что общие расходы выросли в 3,8 раза: фактическая стоимость также зависит от цены модели, попаданий в кеш, количества обычных входных и выходных токенов, выбора моделей для Router и Worker и вызовов инструментов. Среднюю стоимость API для реальных рабочих задач разработчики пока не опубликовали.
Стоит также присмотреться к эксперименту с отключением прямой доставки по подписке. Без неё количество решений, которые должен принимать Router, выросло примерно на 30%, а количество токенов, прочитанных из кеша, — примерно на 37%. При этом время выполнения почти не изменилось. Вывод: в этом тесте прямая доставка по подписке в первую очередь сократила число вызовов модели Router и накладные расходы на контекст, а не ускорила выполнение напрямую.
Нагрузочный тест пакетной обработки Router
В этом тесте Router использовал настоящую модель, а Worker — имитацию модели:
| Показатель | Низкая плотность событий | Высокая плотность событий |
|---|---|---|
| Частота поступления событий | Около 1 в минуту | Около 40 в минуту |
| Средний размер пакета | 1,0 | 2,8 |
| Время одного запроса к модели | 2,5 секунды | 3,9 секунды |
| Время инференса в расчёте на одно решение | 6,4 секунды | 1,6 секунды |
При увеличении плотности событий отдельные запросы стали выполняться медленнее, но время инференса в расчёте на одно решение, наоборот, сократилось. Это показывает, что пакетная обработка повысила эффективную пропускную способность. Официальный вывод довольно сдержанный: при нынешнем размере команды одного Router пока достаточно, но это не значит, что один Router может обрабатывать неограниченное количество сообщений.
Как Router + Worker влияют на разработчиков
Разделение моделей: лёгкая модель для Router, выбор модели для Worker по задаче
Главный практический вывод из двухуровневой архитектуры: для разных ролей необязательно использовать одну и ту же модель. Router в основном классифицирует, распределяет и резюмирует задачи, поэтому ему подойдёт быстрая и недорогая модель. Для Worker модель выбирают по сложности задачи: там, где нужны более глубокие рассуждения, используют более мощную модель. Сам прототип также позволяет отдельно задавать поставщика и модель для Router и Worker.
Ниже — минимальный пример, в котором Router принимает решение о распределении задачи через OpenAI-совместимый интерфейс:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口,一个 Key 切换多家模型
)

ROUTER_MODEL = "your-fast-cheap-model"   # 替换为控制台中可用的轻量模型名

resp = client.chat.completions.create(
    model=ROUTER_MODEL,
    messages=[{"role": "user", "content": "判断这条 Issue 评论是否需要新建 Ticket:修复登录页 500 错误"}]
)
print(resp.choices[0].message.content)
Посмотреть пример вызовов с разделением на Router и Worker
import json
import openai
from typing import Dict

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# 角色与模型分层:模型名请替换为你实际可用的模型
ROLE_MODELS: Dict[str, str] = {
    "router": "your-fast-cheap-model",
    "worker_simple": "your-mid-tier-model",
    "worker_complex": "your-strong-reasoning-model",
}

usage_log = []  # 按 Ticket 记录 Token 消耗

def call(role: str, ticket_id: str, prompt: str) -> str:
    resp = client.chat.completions.create(
        model=ROLE_MODELS[role],
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    usage_log.append({
        "ticket": ticket_id, "role": role,
        "input": u.prompt_tokens, "output": u.completion_tokens,
    })
    return resp.choices[0].message.content

def router_dispatch(ticket_id: str, event: str) -> str:
    prompt = (
        "你是任务调度器,只做分类,不执行任务。"
        "输出 JSON:{\"accept\": bool, \"complexity\": \"simple\"|\"complex\"}\n"
        f"事件:{event}"
    )
    decision = json.loads(call("router", ticket_id, prompt))
    if not decision["accept"]:
        return "ignored"
    role = "worker_complex" if decision["complexity"] == "complex" else "worker_simple"
    return call(role, ticket_id, f"在授权范围内处理任务:{event}")

print(router_dispatch("T-001", "CI 失败:单元测试 test_login 超时"))
print(usage_log)
🎯 Техническая рекомендация: при создании многоуровневой системы агентов сначала протестируйте через APIYI apiyi.com с одним API-ключом, как лёгкие модели и модели с сильными способностями к рассуждению справляются с ролями Router и Worker. Затем определитесь с конфигурацией — так вы не будете использовать самую дорогую модель для каждой роли.
Контроль затрат: учёт по Ticket, а не только по общему счёту
Официальные эксперименты показывают, что двухуровневая архитектура потребляет больше ресурсов на инференс, поэтому расходы нужно контролировать тщательнее. Вот несколько практических подходов:
- Учитывайте токены по Ticket: разделяйте затраты на решения Router и выполнение задач Worker, чтобы понять, какие задачи обходятся дороже всего;
- Разделяйте типы расходов: отдельно учитывайте стоимость моделей, инструментов (например, поиска и получения веб-страниц) и среды выполнения;
- Следите за попаданиями в кэш: основная часть токенов Super-agent приходится на чтение из кэша, а стоимость токена при попадании в кэш и промахе может сильно отличаться. Например, согласно официальным ценам DeepSeek, разница достигает нескольких десятков раз;
- Сокращайте лишние решения: используйте подход с прямой доставкой по подписке, чтобы последующие события направлялись прямо ответственному Worker без повторного распределения через Router.
💰 Оптимизация расходов: параллельная работа нескольких Worker кратно увеличивает число вызовов. Через APIYI apiyi.com можно вызывать модели разных поставщиков с оплатой по факту использования и сравнивать реальные затраты на разные роли и модели в одном счёте. Так проще оптимизировать расходы на каждом уровне.
Когда стоит использовать Router + Worker
Двухуровневая архитектура не всегда оправдана: чем сложнее система, тем больше ресурсов она требует. Ориентироваться можно на такие критерии:
- Подходит: одновременно выполняются несколько независимых задач (например, Ticket A — исправление бага, Ticket B — проверка миграции, Ticket C — работа с CI), а события поступают из разных каналов и требуют постоянной реакции;
- Можно отложить: задач мало, они сильно зависят друг от друга или работа сосредоточена на одной сложной задаче. В таких случаях один агент или обычная команда агентов потребует меньше ресурсов;
- Сначала нужна инфраструктура: если ещё не готовы изоляция прав доступа, обработка конфликтов при изменении файлов и журналы расходов по задачам, параллельная работа может только усилить риски.
Также важно понимать, что Router + Worker и обычная команда агентов решают разные задачи. Обычная команда агентов чаще всего разбивает одну сложную задачу между ролями: исследование, разработка, тестирование и так далее. А Router в Super-agent больше сосредоточен на координации нескольких независимых задач, не вникая в технические детали каждой из них. В официальном описании также отмечается, что похожую структуру можно получить и с обычной командой агентов, если её основная сессия занимается только взаимодействием с пользователем и распределением задач. Двухуровневая архитектура — не эксклюзивная концепция DeepSeek.
Ограничения архитектуры Router + Worker и границы прототипа
При разборе такой архитектуры легко принять полный проектный план из статьи за функции, которые уже есть в прототипе с открытым исходным кодом. Если строго следовать материалам, картина такая:
- Уже поддерживается в прототипе: отслеживание одного репозитория GitHub, необязательное подключение Feishu, управление тикетами, отдельные сессии и рабочие каталоги Worker, создание PR, отображение задач, требующих вмешательства человека, в панели управления и продолжение работы по последующим сообщениям;
- Запланировано, но полноценная реализация не подтверждена: автоматическое управление несколькими репозиториями, непрерывная работа в облаке на уровне production и среда для работы с разных устройств, полноценный независимый Watchdog для автономного устранения проблем; асинхронный цикл ReAct реализован в Harness, но пока не включён по умолчанию;
- Инициативность ограничена: для задач, которые система выявляет самостоятельно, по умолчанию используется режим
observe— действия только записываются, но не выполняются; автоматическое слияние PR по умолчанию отключено.
Авторы открыто признают и несколько сложностей на уровне архитектуры. Первая — масштабирование единственного Router: официально утверждается лишь, что его хватает для команды нынешнего размера. Как распределять нагрузку между несколькими экземплярами при большем масштабе, пока неясно. Вторая — долговременная память: Inline & Spill и цепочечное извлечение информации помогают работать с контекстом на коротких и средних сроках, но хранение памяти на протяжении месяцев остаётся нерешённой задачей. Третья — границы полномочий: Router и Worker по умолчанию работают в режиме danger-full-access и выполняют действия от имени системного пользователя, который их запустил. Авторы рекомендуют использовать отдельного системного пользователя. Prompt Injection через внешние комментарии и управление учётными данными также входят в список нерешённых проблем. В сообществе публиковался и сторонний отчёт об аудите исходного кода для конкретного коммита, но полный сценарий атаки не был независимо воспроизведён, поэтому его можно рассматривать только как потенциальный риск.
Практический опыт сообщества тоже подтверждает, что перед нами именно прототип: один из пользователей успешно прошёл весь процесс от Issue до PR, следуя SETUP.md после свежего клонирования репозитория. При этом он сообщил о проблемах с распознаванием процессов Node.js 24, пропущенных сообщениях из-за задержек уведомлений GitHub и сбоях проверок в тестах при китайском языке системы.
Частые вопросы FAQ
Q1: Что такое двухуровневая архитектура Router + Worker?
Это основа DeepSeek Super-agent. Router — постоянно работающий слой глобальной координации: он принимает события, отслеживает связи между задачами и распределяет работу. Worker — изолированный исполнительный слой: каждая задача Ticket выполняется в отдельной сессии и отдельном каталоге. Главная идея — отделить общую координацию от независимого выполнения задач.
Q2: Чем Router + Worker отличается от обычной команды агентов?
Обычная команда агентов, как правило, делит сложную задачу между ролями: исследователем, программистом, тестировщиком и другими. Router + Worker больше ориентирована на координацию нескольких независимых задач, при этом Router не вникает в детали их выполнения. Если основная сессия обычной команды тоже занимается только взаимодействием с пользователем и распределением задач, получится похожая двухуровневая структура.
Q3: Доказывает ли официальный эксперимент, что Super-agent повышает эффективность программирования на 47%?
Нет. В эксперименте использовались имитации инструментов программирования, а каждую конфигурацию запускали всего 5 раз. Измерялось время выполнения задач с учётом их распределения, а не качество кода или способность к программированию. Снижение P95 примерно на 47% означает лишь то, что при этой синтетической нагрузке самые долгие задачи выполнялись быстрее. Из этого нельзя делать вывод о росте эффективности программирования в реальных условиях или сравнивать способности Super-agent с Claude Code и Codex.
Q4: Поможет ли Router + Worker сэкономить?
Не обязательно. В официальном синтетическом эксперименте объём чтения из кеша у Super-agent был примерно в 3,8 раза выше, чем у нейтральной конфигурации с одной сессией. Иными словами, он тратит больше ресурсов ради скорости и стабильности. Потенциальный способ сэкономить — разделить модели по уровням: использовать лёгкую модель для Router, а модель для Worker выбирать в зависимости от сложности задачи. Через APIYI apiyi.com можно протестировать разные комбинации моделей с единым интерфейсом, сравнить реальные расходы и выбрать подходящий вариант.
Q5: Как быстро проверить разделение моделей для Router + Worker в своём проекте?
Рекомендуем следующие шаги:
1. Зарегистрируйтесь на APIYI apiyi.com, получите API-ключ и бесплатный тестовый лимит;
2. Используйте код из этой статьи и задайте для base_url значение `https://api.apiyi.com/v1`;
3. Настройте разные модели для Router и Worker, записывайте расход токенов по каждому Ticket и сравнивайте результаты.
Благодаря совместимости с интерфейсом OpenAI для смены модели достаточно изменить параметр model.
Q6: Можно ли сразу использовать прототип с открытым исходным кодом в корпоративном продакшене?
Пока не рекомендуем. Это исследовательский прототип: по умолчанию Worker запускается от имени оператора с высокими привилегиями, GitHub Enterprise Server не поддерживается, а сообщество сообщало о пропущенных уведомлениях и других дефектах, а также о потенциальных проблемах безопасности. Лучше использовать его для проверки рабочих процессов в изолированной среде.
Главное о Router + Worker
- Суть: Super-agent — это системная архитектура поверх модели; в открытый доступ выложен исследовательский прототип, а не коммерческий продукт;
- Проблема: узким местом становятся не возможности модели, а внимание человека: одна сессия «забивается», а в нескольких легко потерять нить;
- Разделение ролей: Router занимается только общей координацией — ему могут даже не давать доступ к Bash, — а Worker самостоятельно работает в изолированной сессии;
- Ключевые механизмы: прямая доставка по подписке разгружает Router от принятия решений, пакетная обработка снижает накладные расходы на инференс, а Inline & Spill позволяет использовать контекст как кэш;
- Границы результатов: эксперименты с планированием показали сокращение времени завершения самых долгих задач, но расход токенов вырос; при этом результаты ничего не говорят о способности писать код;
- Как начать: через единый интерфейс APIYI apiyi.com можно настроить разные модели для разных ролей и учитывать расходы по тикетам.
Итоги
С помощью Router + Worker команда DeepSeek ответила на вопрос, почему AI-агенту не стоит ограничиваться одной сессией:
- Польза архитектуры: общая координация отделена от самостоятельного выполнения, поэтому связи между задачами отслеживает система, а не человек;
- Инженерные решения: прямая доставка по подписке, пакетная обработка, Inline & Spill и цепочечное извлечение данных решают соответственно проблемы нагрузки на центральный компонент, резких всплесков задач, ограниченного объёма контекста и доступа к истории;
- Трезвая оценка: эксперименты показывают компромисс между эффективностью планирования и расходом ресурсов. Масштабирование системы с одним Router, долговременная память и разграничение прав по-прежнему требуют решения.
Если вашей системе уже нужно одновременно обрабатывать несколько независимых задач, стоит присмотреться к двухуровневой архитектуре. Если задач немного и они сосредоточены в одной области, один агент по-прежнему будет более экономичным выбором. При любой архитектуре ключ к контролю расходов — распределение моделей по ролям и учёт затрат по задачам.
Чтобы быстро проверить, как разные модели работают в ролях Router и Worker, можно воспользоваться APIYI apiyi.com. Платформа предлагает OpenAI-совместимый интерфейс, оплату по фактическому использованию и бесплатный лимит для тестирования новым пользователям.
📚 Источники
- Официальная статья DeepSeek об архитектуре: исследование дизайна Super-agent — на пути к более автономным системам агентов
- Ссылка:
x.com/DeepSeekHarness/article/2116857257245987236 -
Описание: первоисточник о двухуровневой архитектуре, пяти основных модулях, результатах экспериментов и нерешённых вопросах
-
Официальный репозиторий DeepSeek на GitHub: dsh-superagent-prototype
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype -
Описание: статус проекта, исходный код, лицензия и текущая область применения
-
Документация Domain Model с открытым исходным кодом: объекты задач и модель их обработки
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Описание: определения ключевых понятий, включая Source, Trigger, Ticket и Assignment
-
Документация по авторизации и подпискам: правила для Mandate и подписок на Thread
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Описание: официальное разъяснение о том, что подписка на сообщения не расширяет полномочия
-
Документация по развёртыванию: зависимости, учётные записи и рекомендации по безопасности
- Ссылка:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/006-deployment.md -
Описание: режим работы с повышенными привилегиями и рекомендации по использованию отдельного системного пользователя
-
Официальные цены DeepSeek API: стоимость моделей и инструментов
- Ссылка:
api-docs.deepseek.com/quick_start/pricing - Описание: разница в ценах при попадании в кеш и промахе, данные для оценки расходов
Автор: техническая команда APIYI
Обсуждение технических вопросов: свяжитесь с нами на главной странице APIYI apiyi.com, чтобы обсудить архитектуру агентов и практику вызова нескольких моделей. Дополнительные материалы доступны в центре документации docs.apiyi.com