Все три реализации Tool Search решают одну и ту же задачу, но идут к ней очень по-разному. Все они дают модели в начале видеть только краткие подсказки об инструментах, а полную схему параметров загружают лишь при необходимости вызова. Отличий в основном три: у Gemini есть серверный и клиентский режимы поиска, причём клиентский позволяет подключать новые инструменты; Claude предлагает два серверных способа поиска — Regex и BM25 — и через tool_reference находит инструменты внутри уже объявленного набора; GPT группирует инструменты через namespace, а в клиентском режиме может динамически добавлять новые через tool_search_output. При выборе смотрите на то, фиксирован ли набор инструментов, как часто он меняется и какая API-архитектура уже есть у команды.
Что вы узнаете из этой статьи?
- К какому API относится Tool Search у каждого из трёх и каким полем он включается.
- Чем отличается содержимое, которое остаётся в начальном контексте модели, и какую роль играют
short_description,tool_referenceиnamespace. - Как складывается цепочка событий поиска инструментов и фактического вызова функции и где легко ошибиться при интеграции.
- Кто умеет добавлять в диалог новые инструменты, которых не было в исходном запросе.
- Как выбрать подход для корпоративного агента вроде системы заказов и склада, исходя из структуры библиотеки инструментов.
Структура статьи: сначала — даты выхода и общая логика всех трёх решений, затем отдельный разбор механизмов поиска и собственных полей Gemini, Claude и GPT, после этого — общая таблица с восемью параметрами и демонстрация трёх технических подходов на одном и том же агенте для заказов и склада. В финальной аналитической части — принципы выбора и разбор того, на что обратить внимание при адаптации протоколов в мультимодельном шлюзе.
Ключевые понятия Tool Search
| Понятие | Краткое объяснение |
|---|---|
| Каталог инструментов | Набор бизнес-инструментов для поиска: названия, описания, определения параметров и сведения о правах доступа. |
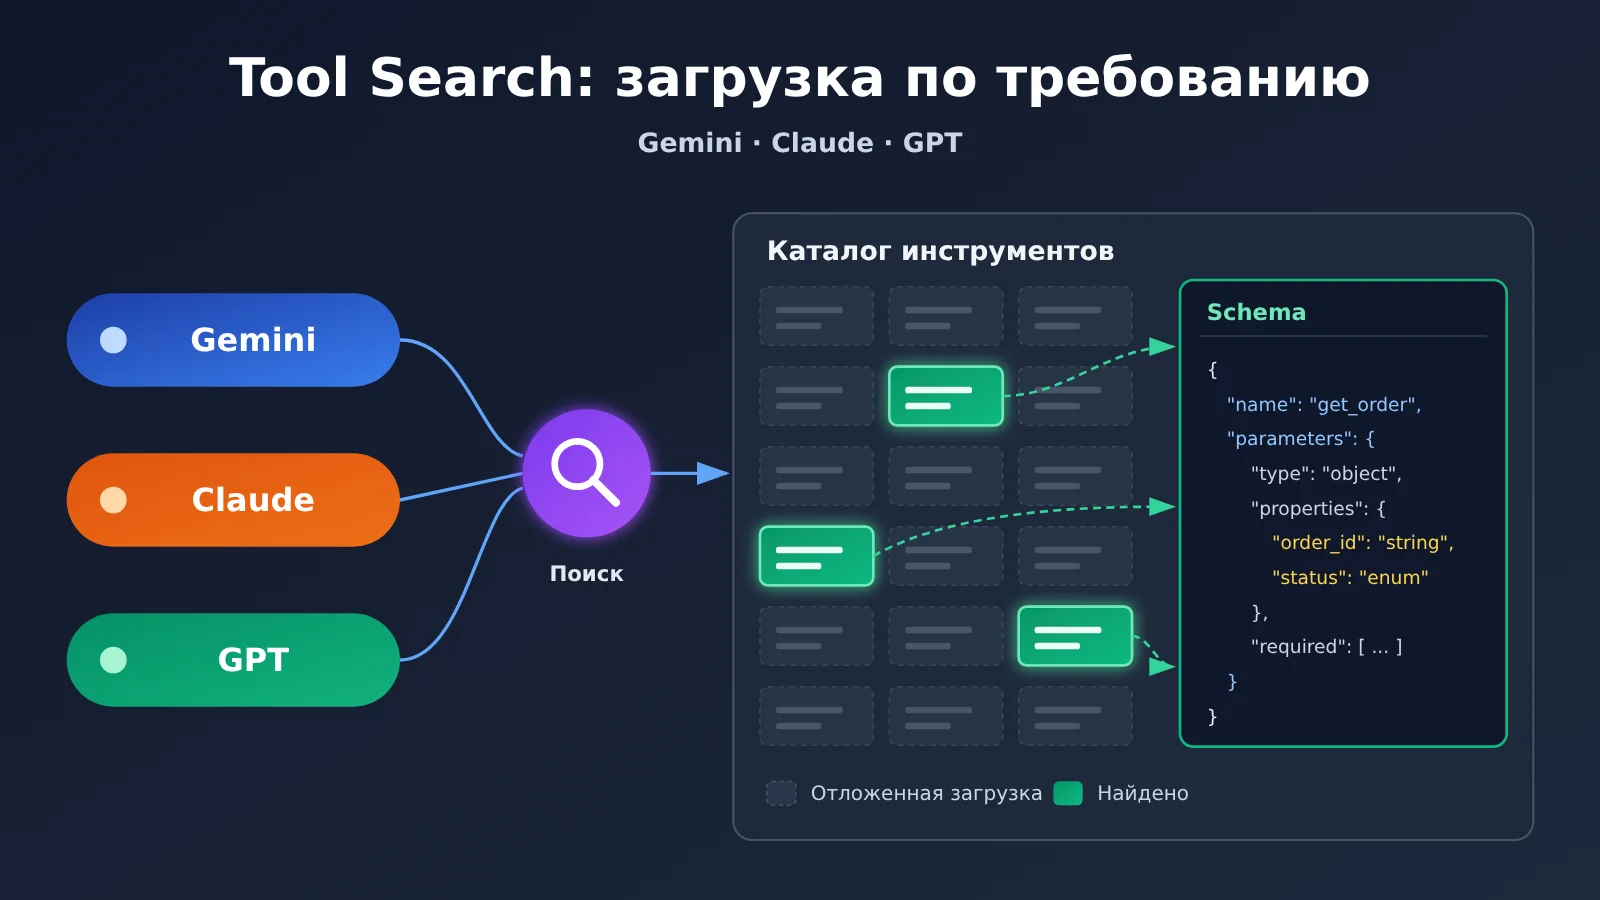
| Tool Search | Возможность находить инструменты под текущую задачу и при необходимости подгружать их полные определения. |
defer_loading |
Поле, которое применяют все три провайдера: помечает инструмент, полное определение которого загружается отложенно. |
| Regex | Сопоставление названий инструментов, описаний или параметров с помощью регулярных выражений. |
| BM25 | Классический алгоритм, который сортирует результаты поиска по релевантности текста словам запроса. |
tool_reference |
Блок содержимого, которым Claude ссылается на уже объявленный инструмент; затем API разворачивает его в полное определение. |
namespace |
Объявление в OpenAI Responses API, которое группирует связанные функции по бизнес-возможностям. |
| Динамическое внедрение инструментов | Приложение передаёт модели определения инструментов, не объявленных в исходном запросе, чтобы она могла продолжать ими пользоваться. |
tool_search_output |
Элемент ответа, который клиент OpenAI возвращает при поиске; содержит объявления найденных инструментов. |
| Удалённый MCP | Удалённый сервис, предоставляющий обнаруживаемые и исполняемые инструменты через Model Context Protocol. |
| Префикс кэша | Неизменная начальная часть ввода, которая сохраняется между несколькими вызовами модели и может быть повторно использована из кэша. |
Кратко о влиянии Tool Search
- Разработчики агентов: когда инструментов становится много, больше не нужно вставлять все схемы в контекст сразу. Но у всех трёх провайдеров разные тела запросов и события ответа, поэтому кросс-модельному агенту придётся реализовывать отдельную логику парсинга для каждого.
- Владельцы корпоративных платформ и каталогов инструментов: названия инструментов, краткие описания и способ группировки начинают напрямую влиять на качество поиска — сам каталог инструментов становится активом, который нужно проектировать.
- Ответственные за стоимость и эксплуатацию: Tool Search не обязательно экономит деньги. В официальных примерах расчётов Google приведены оба сценария — и экономия, и рост числа токенов, — так что включать его или нет, стоит решать по фактическим счетам.
Объективные факты: история выпуска и механизмы Tool Search у трёх провайдеров
Почему Gemini, Claude и GPT предлагают Tool Search
Когда агент одновременно подключён к CRM, заказам, складу, логистике, тикетам и нескольким MCP-серверам, сами объявления инструментов съедают значительную часть контекста. В документации Google говорится, что несколько десятков объявлений функций могут занимать десятки тысяч токенов. Anthropic приводила пример: пять MCP-серверов — GitHub, Slack, Sentry, Grafana и Splunk — в сумме дают 58 инструментов, и только определения инструментов занимают около 55 000 токенов.
Хронология релизов у трёх компаний такая: Anthropic выпустила Tool Search Tool 24 ноября 2025 года; OpenAI 5 марта 2026 года вместе с GPT-5.4 представила API Tool Search; Google 19 ноября 2026 года в виде превью выпустила Tool Retrieval в Gemini API. Подход у всех трёх одинаковый: модель сначала знает, какие возможности есть, а полные определения параметров читает только тогда, когда они действительно нужны.
Каждая из трёх компаний публиковала данные о производительности, но условия тестирования совершенно разные, так что ранжировать по ним нельзя. В примере Anthropic начальный контекст сократился примерно с 77 000 до 8 700 токенов, а во внутренней оценке MCP точность выбора инструментов у Claude Opus 4 выросла с 49% до 74%. OpenAI на 250 задачах MCP Atlas и 36 MCP-серверах замерила снижение общего числа токенов на 47% при неизменной точности. Google пока приводит только гипотетические расчёты: при 200 инструментах экономия около 85,6%, а при 10 инструментах в сочетании с длинным контекстом расход, наоборот, растёт примерно на 36,5%.
Gemini Tool Search: серверный и клиентский режимы поиска
Gemini Tool Retrieval работает на основе Interactions API, требует использования v1beta; старый generateContent его не поддерживает. Серверный режим включается добавлением {"type": "tool_search"} в tools, а для редко используемых function или mcp_server нужно задать defer_loading: true. Изначально модель видит только названия отложенных инструментов и short_description. Ранние тесты Google показали, что в среднем на одну запись инструмента уходит около 26 токенов. Если краткое описание не задано, вместо него используется первое предложение полного description.
Есть один момент, который легко понять неправильно: в серверном режиме разработчик всё равно должен отправлять полные определения инструментов. Даже при использовании previous_interaction_id нужно заново отправлять полный массив tools в каждом запросе. Отложенная загрузка лишь не позволяет полной схеме заранее попасть в контекст модели. Кроме того, загруженные схемы нельзя выгрузить в рамках текущей сессии; в одном запросе можно объявить не более одного tool_search; серверный и клиентский поиск нельзя смешивать в одном запросе.
| Аспект | Серверный поиск | Клиентский поиск |
|---|---|---|
execution |
server (по умолчанию) |
client |
| Кто выполняет поиск | Gemini API | Разработчик сам |
| Нужно заранее объявлять набор инструментов | Да | Нет |
defer_loading |
Применимо | Неприменимо |
| Дополнительные сетевые обращения | Нет дополнительных обращений от клиента | На каждый поиск — ещё одно обращение |
| Типичные сценарии | Большие, относительно стабильные наборы инструментов | Частный Tool Registry, мультитенантность, динамические инструменты |
В клиентском режиме модель вызывает определённую разработчиком функцию поиска (например, search_tool_registry), а приложение возвращает в function_result.result полные объекты объявлений найденных инструментов. Этот подход позволяет в ходе диалога подключать инструменты, которые не были объявлены в исходном запросе, — например, если пользователь по ходу сессии подключил новый SaaS-сервис.
Claude Tool Search: Regex, BM25 и tool_reference
Инструмент Tool Search от Claude относится к Messages API. Со стороны сервера доступны два типа поисковых инструментов: tool_search_tool_regex_20251119 — модель сама генерирует регулярное выражение, что хорошо подходит для библиотек с чётким шаблоном именования; и tool_search_tool_bm25_20251119 — модель формирует запрос на естественном языке, что удобно, когда нужно находить инструменты по описанию их возможностей. Оба способа просматривают имена инструментов, их описания, а также названия и описания параметров. У Claude поле параметров называется input_schema — в этом отличие от двух других провайдеров, где используется parameters.
Типичная цепочка событий при поиске выглядит так: сначала Claude инициирует вызов server_tool_use к встроенному поисковому инструменту, API возвращает tool_search_tool_result, в результате содержится tool_reference, затем API разворачивает его в полное определение, и в конце модель выдаёт бизнес-вызов tool_use. Anthropic отдельно поясняет: идентификатор srvtoolu_... встроенного поискового инструмента не требует, чтобы разработчик возвращал tool_result — приложению достаточно выполнить фактический бизнес-вызов tool_use.
| Правило Claude Tool Search | Официальное требование |
|---|---|
| Лимит отложенных инструментов в одном запросе | 10 000 |
| Возврат по умолчанию за один поиск | не более 5, можно изменить через limit |
| Длина Regex-запроса | не более 200 символов |
| Длина BM25-запроса | не более 500 символов |
| Неподдерживаемые модели | Claude Opus 4.1 и более ранние |
| Ограничение кэша | для инструментов с defer_loading: true нельзя задавать cache_control |
Разработчик может реализовать собственный поиск на базе embedding или других своих алгоритмов, но возвращаться всё равно должен tool_reference, а инструмент, на который ссылаются, обязан быть заранее объявлен в верхнеуровневом tools. Так что дизайн Claude ближе к сценарию «найти нужный инструмент в заранее объявленной библиотеке». Что касается MCP: в Claude через MCP Connector настраивается отложенная политика в mcp_toolset — можно задать её единообразно в default_config либо индивидуально для каждого инструмента в configs.
GPT Tool Search: Namespace и динамическое внедрение инструментов
Tool Search от OpenAI реализован в Responses API, поддерживается GPT-5.4 и более новыми совместимыми моделями и включается через tool_search и defer_loading. Его особенность — namespace: разработчики могут группировать связанные функции по бизнес-доменам вроде crm и billing. Модель сначала по названию и описанию namespace определяет, какая категория возможностей релевантна, а затем при необходимости разворачивает отложенные функции внутри группы. Так группировка инструментов становится структурой на уровне API, а не просто соглашением об именовании.
В серверном режиме цепочка событий выглядит так: tool_search_call → tool_search_output → function_call → приложение возвращает function_call_output. В клиентском режиме приложение, получив tool_search_call, само запрашивает каталог инструментов, а затем возвращает tool_search_output с тем же call_id; поле tools содержит полные объявления подходящих инструментов, и модель вызывает эти функции только на следующем ходе. Официальная документация допускает здесь возврат инструментов, которые не объявлялись в исходном запросе, и одновременно требует от разработчика строгой проверки динамической Schema и раскрытия только доверенных определений инструментов.
Что касается кеширования, OpenAI добавляет вновь найденные определения инструментов в конец контекста, чтобы меньше влиять на уже существующий кешированный префикс. По MCP есть важный нюанс: Tool Search в Responses API поддерживает обнаружение MCP-инструментов по требованию, а Agents API при поддержке со стороны модели и провайдера автоматически подключает обнаружение инструментов силами рантайма. Официально предупреждают, что эти два набора настроек нельзя напрямую применять друг к другу.
Ниже — иллюстративный запрос к Responses API, показывающий базовую структуру отложенной загрузки. Поля приведены по официальной документации OpenAI:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый endpoint APIYI
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # Ожидаем увидеть события tool_search_call / function_call и т. п.
Показать пример кода клиентского поиска и динамического внедрения
import requests

BASE_URL = "https://api.apiyi.com/v1"  # запросы Responses API проксируются через APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """Ищет во внутреннем корпоративном каталоге инструментов и фильтрует по правам пользователя (иллюстративно)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # используем тот же call_id, что и у вызова поиска
                "tools": search_registry(query)  # может содержать инструменты, не объявленные в исходном запросе
            })
    return follow_ups
# Внимание: динамически возвращаемую Schema обязательно сначала валидируйте и предоставляйте доступ только к доверенным инструментам
🚀 Рекомендация для быстрой проверки: перед подключением к реальному бизнесу можно сначала с помощью единого ключа APIYI apiyi.com по очереди вызвать GPT, Claude и Gemini, прогнать один и тот же каталог инструментов через все три, убедиться, что структура событий корректно распознаётся вашим слоем разбора, и уже потом выбирать основной вариант.
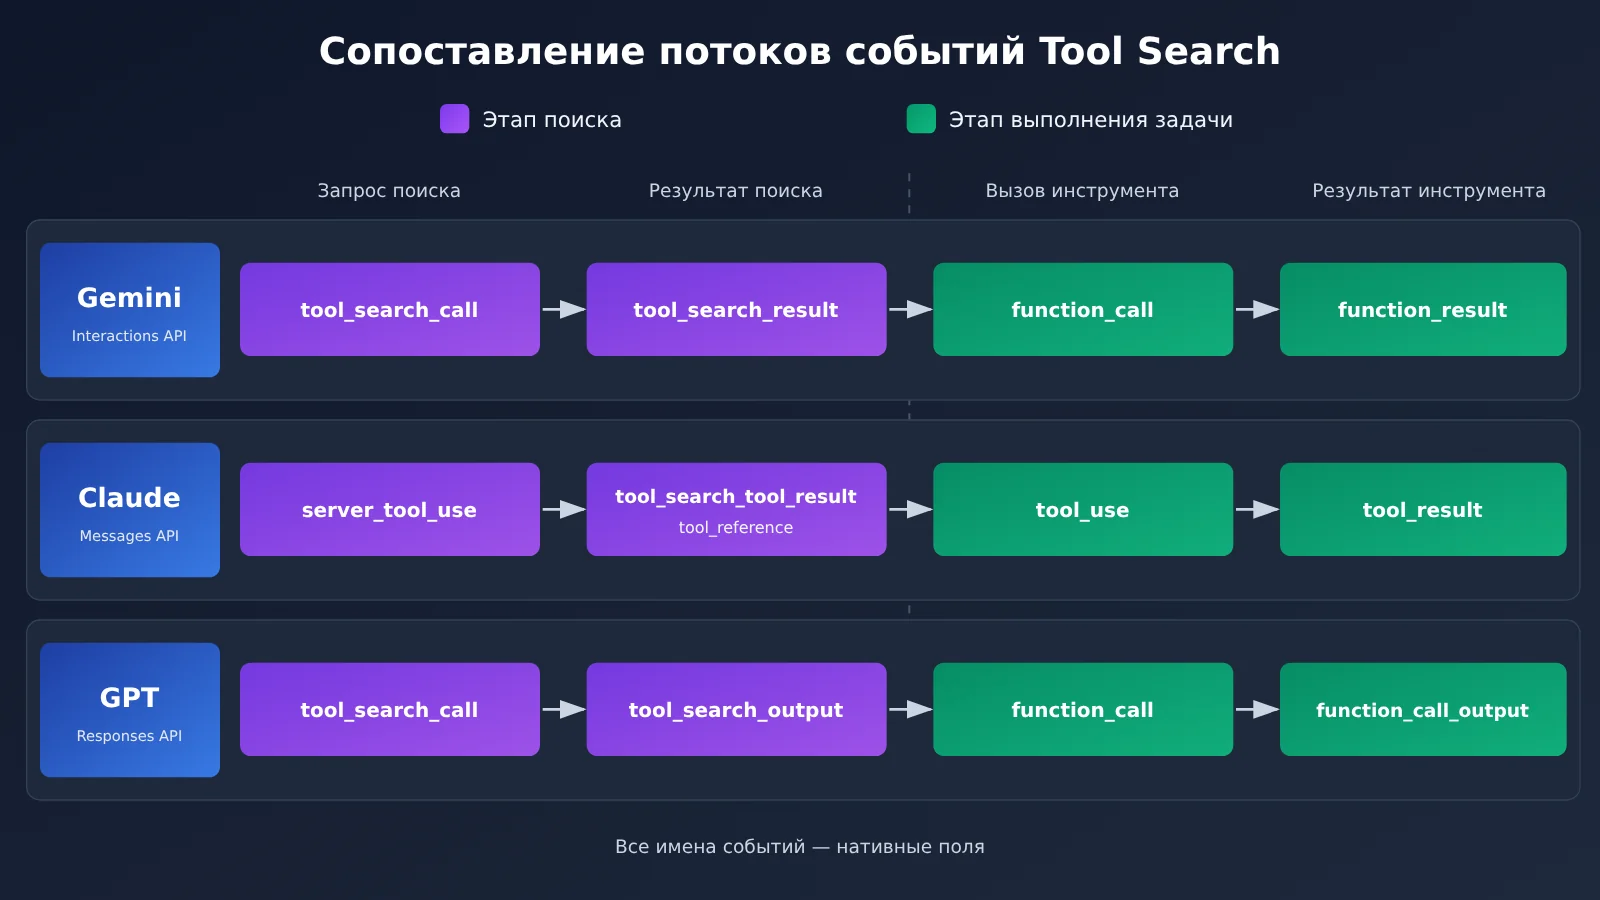
Названия событий на диаграмме выше — это нативные поля каждого провайдера. Читателям, которым нужно по очереди проверить событийные потоки на практике, можно через APIYI apiyi.com переключать модели в одном и том же наборе тестовых скриптов и сравнивать.
Сводное сравнение механизмов Tool Search у трёх провайдеров
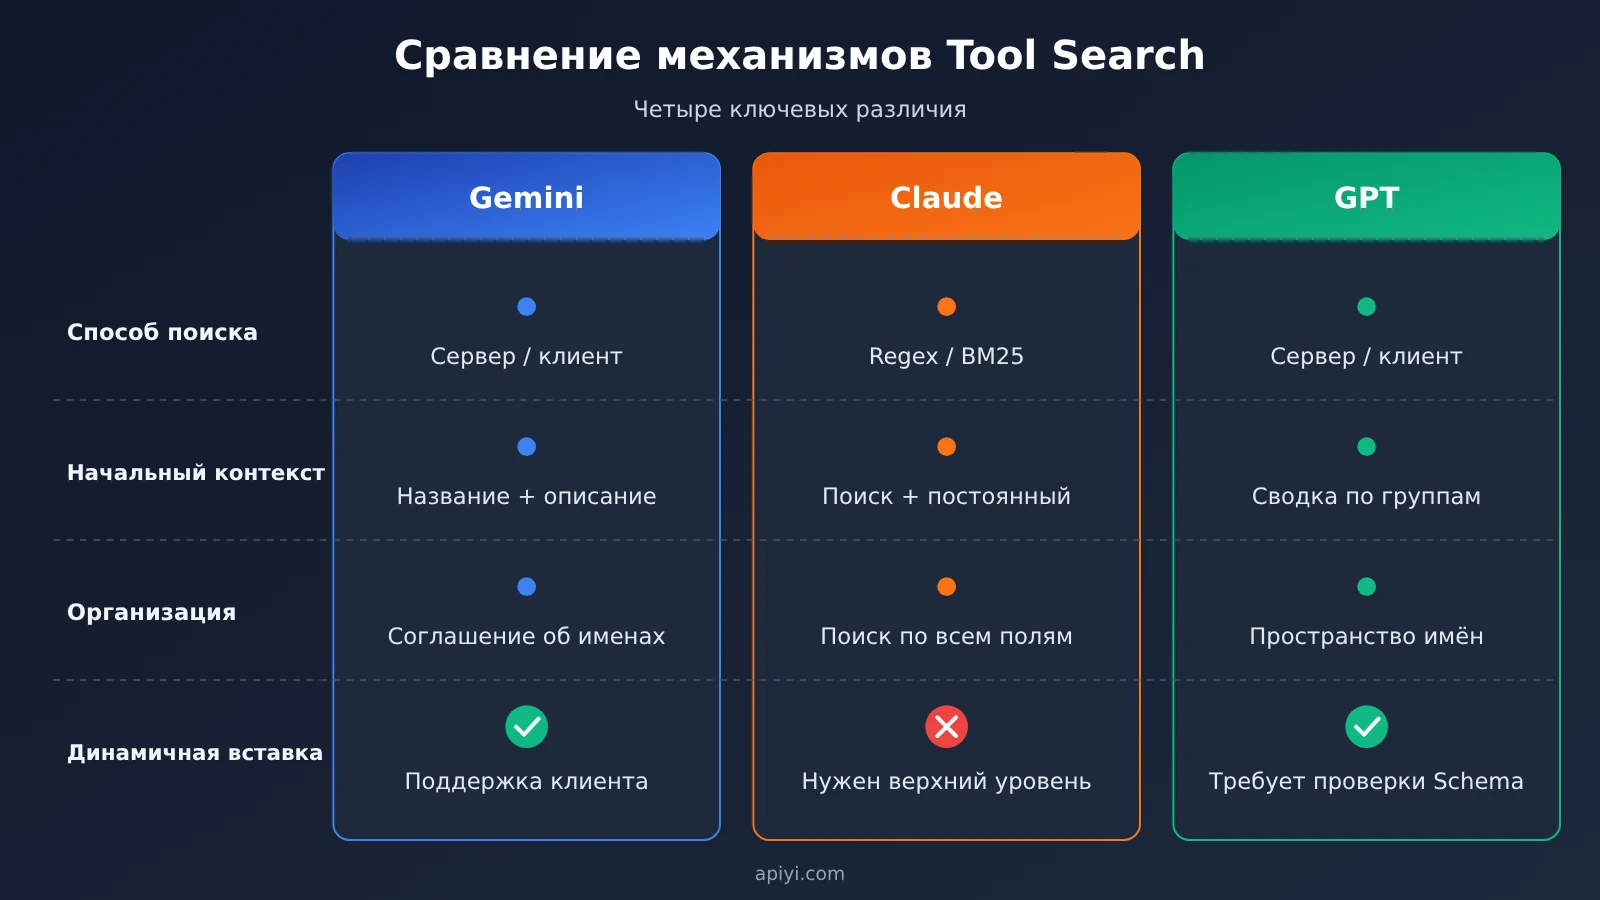
| Аспект | Gemini | Claude | GPT |
|---|---|---|---|
| API | Interactions API (v1beta) |
Messages API | Responses API |
| Способ поиска | Серверный (алгоритм не раскрыт) / клиентский | Regex / BM25 / пользовательский поиск | Серверный / клиентский |
| Что сохраняется в начальном контексте | Имя + short_description |
Инструмент поиска + инструменты без отложенной загрузки | Отложенные инструменты или сводка по namespace |
| Организация инструментов | Соглашение об именах + краткое описание | Имя, описание и параметры доступны для поиска | Группировка по namespace |
| Поле параметров | parameters |
input_schema |
parameters |
| Клиентский поиск | Поддерживается | Пользовательский поиск возвращает tool_reference |
Поддерживается (tool_search_output) |
| Динамическое добавление новых инструментов | Поддерживается в клиентском режиме | Инструменты, на которые есть ссылка, должны быть объявлены на верхнем уровне | Поддерживается в клиентском режиме, требуется проверка Schema |
| Интеграция MCP | mcp_server + defer_loading |
default_config / configs у mcp_toolset |
В Responses и Agents правила различаются |
| Кэширование и биллинг | Отдельной платы за функцию нет; следите за total_tool_use_tokens |
Отдельно не тарифицируется; для инструментов с отложенной загрузкой нельзя задать cache_control |
Новые инструменты добавляются в конец, чтобы сохранить префикс кэша |
💡 Рекомендация по выбору: таблица выше сравнивает только проверяемые правила интерфейсов. Реальный эффект зависит от вашей библиотеки инструментов и длины диалога. Рекомендуем провести небольшой A/B-тест через единый мультимодельный вход APIYI apiyi.com, а затем рассчитать стоимость по полям биллинга каждого провайдера.
Анализ и оценка: условия применимости при выборе Tool Search
Три технических подхода на примере агента заказов и склада
Представим такую бизнес-задачу: пользователь проверяет статус заказа, видит, что товар ещё не отгружен, затем смотрит остатки на складе и выясняет, можно ли назначить новую дату отправки. В системе есть девять категорий инструментов — CRM, заказы, запасы, управление складом, логистика, возвраты, биллинг, уведомления, согласования, — и в каждой категории по несколько функций.
- Путь Gemini: часто используемые запросы по заказам загружаются сразу, а запасы, управление складом и другие длиннохвостые инструменты переводятся в отложенную загрузку — для них прописывается
short_description, а серверная сторона выполняет поиск и выбирает Schema дляget_inventory. Если инструменты управления складом подключаются динамически по тенантам, переключаемся на клиентский поиск и возвращаем их из приватного Registry. - Путь Claude: если имена инструментов упорядочены (например,
inventory_*,warehouse_*), Regex даёт точное попадание; а если пользователь говорит разговорно — вроде «посмотреть, можно ли ещё пополнить запасы», — лучше подходит BM25. В итогеtool_referenceразворачивается в вызываемыйtool_use. - Путь GPT: по
crm,inventory,logisticsсоздаютсяnamespace, модель сначала определяет, что речь идёт о двух доменах — запасах и логистике, — а затем разворачивает функции внутри группы. Нового логистического провайдера, подключённого на время, можно внедрить через клиентскийtool_search_output.
Этот сценарий служит только для иллюстрации различий в механизмах и не отражает измеренные показатели успеха или задержки у трёх провайдеров.
Четыре принципа выбора для разработчиков
- Большая и стабильная библиотека инструментов: смотрите в первую очередь на возможности поиска на стороне сервера. Все три провайдера с этим справляются, но учтите: Gemini при каждом запросе заново отправляет полный массив инструментов, а у Claude лимит отложенных инструментов в одном запросе — 10 000.
- Нужен явный контроль стратегии поиска: открытые Regex и BM25 у Claude — единственное решение с явно раскрытым алгоритмом, оно подойдёт командам, которые хотят точно попадать по правилам именования. Серверные алгоритмы Gemini и GPT не раскрыты, и не стоит предполагать, что они совпадают с Claude.
- Библиотека инструментов часто меняется или её нужно фильтровать по правам пользователя: обращайте внимание на динамическое внедрение на стороне клиента. Клиентские режимы Gemini и GPT позволяют подключать новые инструменты; пользовательский поиск Claude может ссылаться только на уже объявленные инструменты, поэтому набор кандидатов нужно собирать до отправки запроса.
- Небольшой набор инструментов: расчёты Google показывают, что при 10 инструментах и длинном контексте на 30 000 токенов расход токенов, наоборот, вырастает примерно на 36,5 %. Google рекомендует при менее чем примерно 20 стабильных инструментах продолжать статическую загрузку — это ориентир и для двух других провайдеров, но проверять всё равно нужно собственными замерами.
Проблемы адаптации протоколов в шлюзе для нескольких моделей
Самая частая ошибка команд, которые делают агентов с поддержкой нескольких моделей, — считать, что «умею вызвать модель» означает «умею пользоваться Tool Search этой модели». Возможности стоит разложить на четыре уровня: доступ к модели; эндпоинты протокола (Interactions / Messages / Responses); поля объявления инструментов (tool_search, defer_loading, namespace, конфигурация MCP); выполнение и управление состоянием (события поиска, результаты функций, signature, история сессии). Если модель подключилась, это говорит только о том, что с первым уровнем всё в порядке.
Особенно важно помнить одно правило Gemini: в сессиях без состояния с store=false нельзя изменять или удалять tool_search_call, tool_search_result и их signature, иначе вернётся HTTP 400. Значит, шлюз не может произвольно сжимать или переписывать историю сообщений. Чтобы свести трёх провайдеров к единому интерфейсу Tool Search, придётся на уровне фреймворка агента вести таблицу сопоставления событий — нельзя рассчитывать, что достаточно поменять Base URL и одно и то же тело запроса подойдёт везде.
🎯 Техническая рекомендация: когда подключаете несколько моделей через агрегаторы вроде APIYI apiyi.com, сначала проверьте на небольшом трафике, полностью ли пробрасываются нужные эндпоинты и поля
tool_search,defer_loading,namespaceи т. п., и только потом ставьте Tool Search в производственную цепочку.
Переменные, за которыми стоит следить
Gemini Tool Retrieval всё ещё остаётся preview-версией, и до официального релиза интерфейс может измениться. Что касается среднего процента экономии, задержки и точности в реальной продакшн-среде, то по состоянию на 20 ноября 2026 года независимых проверяемых тестов по ним ещё нет. Одно из вероятных направлений: все три игрока передают управление каталогом инструментов разработчикам — именование, короткие описания, группировка и права доступа будут всё сильнее напоминать индексацию в поисковых системах. Перед запуском советую построить контрольный эксперимент с метриками: входные токены на старте, токены использования инструментов, доля правильного выбора инструмента, доля поисков без совпадений и среднее число поисков. А затем провести сравнительную проверку на одном и том же наборе задач в APIYI apiyi.com и других мультимодельных окружениях — так вы не поддадитесь маркетинговым цифрам одного вендора.
Больше инструментов — не значит, что агент стал умнее. Его потолок определяет другое: умеет ли он в нужный момент точно найти подходящий инструмент. Как сказано в «Лунь юй» (глава «Вэй Лин-гун»): «Ремесленник, который хочет хорошо выполнить свою работу, сначала затачивает инструмент».
Справочные материалы
- Техническая документация Google Tool Retrieval: серверный и клиентский поиск, ограничения, тарификация и примеры расчётов
- Ссылка:
aistudio.google.com/docs/tool-retrieval
- Ссылка:
- Официальное объявление Google: Introducing Tool Retrieval in the Gemini API
- Ссылка:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Ссылка:
- Документация Anthropic Tool Search Tool: Regex, BM25, tool_reference и ограничения
- Ссылка:
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Ссылка:
- Объявление Anthropic Advanced Tool Use: выпуск Tool Search и внутренняя оценка
- Ссылка:
anthropic.com/research/advanced-tool-use
- Ссылка:
- Документация OpenAI Tool Search: namespace, клиентский поиск и динамическое внедрение
- Ссылка:
developers.openai.com/api/docs/guides/tools-tool-search
- Ссылка:
- Объявление OpenAI GPT-5.4: выпуск Tool Search и тестирование MCP Atlas
- Ссылка:
openai.com/index/introducing-gpt-5-4
- Ссылка:
Автор: техническая команда APIYI
Обсудить технические вопросы: хотите подробнее разобраться с адаптацией вызова инструментов для мультимодельных агентов? Заходите на APIYI apiyi.com и свяжитесь с нами. Больше материалов по подключению — в центре документации docs.apiyi.com