Короткий ответ: новый промпт не обязательно лучше, а «выглядит лучше» — ещё не доказательство. Чтобы понять, какой шаблон статьи лучше — новый или старый, — нужно зафиксировать исходные материалы, модель и настройки генерации, менять только шаблон, а затем послойно проверять структуру, порядок и качество содержания с помощью утверждений Promptfoo. Кроме того, результаты стоит показывать по отдельным критериям, чтобы баллы за стиль не компенсировали фактические ошибки. В этой статье мы предлагаем схему эксперимента; реальных A/B-тестов мы не запускали, поэтому не приводим ни винрейта, ни оценок, ни экономии бюджета.
Что вы узнаете из статьи:
- Что умеют проверять утверждения Promptfoo
contains, JavaScript иllm-rubric— и что они доказать не могут. - Как отдельно запускать файл утверждений для уже готовых ответов модели, чтобы не генерировать их заново, когда меняются только правила оценки.
- Как построить эксперимент по сравнению старого и нового шаблонов статьи: управление переменными, проверка на трёх уровнях и представление результатов по отдельным критериям.
- Где проходят границы модели-судьи и правил-утверждений и какие затраты возникают из-за платной модели-оценщика.
Навигация: Сначала с помощью таблицы понятий объясним несколько ключевых терминов оценки Promptfoo, затем расскажем, как это влияет на контент-команды, разработчиков и ответственных за оценку. В разделе «Объективные факты» соберём только описанные в документации возможности утверждений и статус проверки. В разделе «Анализ и выводы» дадим рекомендации по дизайну эксперимента, примеры конфигурации и обсуждение ограничений, а также по пунктам отметим, что именно является рекомендацией, а не измеренным результатом.
Что нужно знать перед сравнением шаблонов промптов в Promptfoo
Эти термины будут не раз встречаться дальше. Большинство из них взято из документации по настройке Promptfoo, ещё несколько — это общие понятия, которые используются в экспериментах по оценке.
| Концепция | Краткое пояснение |
|---|---|
| Promptfoo | Инструмент с открытым исходным кодом для оценки промптов и выводов больших языковых моделей. Позволяет задавать тестовые случаи и проверки в конфигурационном файле |
| Проверка (Assertion) | Автоматическое правило проверки вывода модели, которое определяет, выполняется ли заданное условие |
| contains | Проверяет, встречается ли указанный текст в выводе; это детерминированное сопоставление строк |
| JavaScript-проверка | Более сложное условие, реализованное через выражение или функцию на JavaScript |
| llm-rubric | Просит модель оценить вывод по заданной шкале; относится к проверкам типа «оценка моделью» |
| Провайдер оценки (Grading Provider) | Модель, которая выполняет оценку для llm-rubric; её можно настроить отдельно |
| Шкала (Rubric) | Критерии для модели-оценщика, описывающие, что считается прохождением, а что — снижением балла |
| Модель-судья (LLM-as-a-Judge) | Подход, при котором большую языковую модель используют вместо человека для оценки качества вывода |
| Контроль переменных | В эксперименте меняется только один фактор (здесь — шаблон), остальные остаются неизменными |
Краткий обзор влияния оценки старого и нового шаблонов промптов
Ценность такого подхода к оценке не в том, насколько нов сам инструмент, а в том, что он превращает «мне кажется, новый шаблон лучше» в проверяемый протокол проверок. При этом разные роли получают от него разное.
| Кто участвует | Что это даёт на практике |
|---|---|
| Контент-команда и редакторы | У переработки шаблона появляется проверяемая база для приёмки; можно заметить проблемы вроде «структура правильная, но в блок фактов попали домыслы» |
| Промпт-инженеры и разработчики | Требования к шаблону можно разбить на утверждения-правила и утверждения по шкале; при изменении правил оценки не нужно заново генерировать все выходные данные |
| Ответственный за оценку | Нужно отчитываться о результатах по измерениям и чётко разграничивать доказательную силу оценки модели, срабатываний правил и ручной проверки |
| Ответственный за бюджет | Утверждения-правила почти не добавляют затрат на вызовы; llm-rubric при использовании платной модели создаёт расходы на оценку |
Объективные факты о возможностях ассертов Promptfoo
В этом разделе мы перечисляем только те возможности, которые описаны в документации Promptfoo. Мы сверялись с соответствующими страницами документации 2026-11-17, но дату первого релиза этих возможностей не проверяли, поэтому конкретных сроков появления в статье не приводим.
Ассерт contains в Promptfoo: проверяем, есть ли текст
contains — самый базовый тип ассерта: он проверяет, встречается ли в выводе модели заданный фрагмент текста. Это детерминированное сравнение строк: один и тот же вывод при каждом запуске даст один и тот же результат.
Важно подчеркнуть: успешное прохождение contains говорит лишь о том, что «этот текст найден». Оно ничего не говорит о том, хорошо ли написан абзац, в котором находится этот текст, и верно ли содержание.
Ассерты на JavaScript: сложные условия
Когда условия выходят за рамки «содержит ли», можно написать собственную логику в ассерте на JavaScript. Например, сравнить, какой из двух заголовков идёт раньше, посчитать количество определённых разделов или проверить, попадает ли фрагмент текста в конкретный раздел. Такие ассерты тоже детерминированы, а результат воспроизводим.
Оценка уже готовых выводов Promptfoo через отдельный файл ассертов
Promptfoo позволяет прогонять отдельный файл ассертов по уже сгенерированным выводам модели, без повторной генерации всех выводов. Для итераций над оценкой это важно: правила оценки обычно приходится много раз подкручивать, а сама генерация — дело долгое и затратное по числу вызовов.
llm-rubric в Promptfoo: оценка модели по рубрике
llm-rubric относится к ассертам с оценкой моделью. Он передаёт вывод и пользовательскую рубрику модели-судье, а та решает, пройдена проверка или нет, и объясняет причину. В документации сказано, что провайдера оценки можно настроить отдельно, а промпт, используемый при оценке, — задать свой.
| Тип ассерта | Как принимается решение | Детерминирован ли результат | Что доказывает | Чего не доказывает |
|---|---|---|---|---|
| contains | сравнение строк | да | заданный текст присутствует | качество абзаца, правильность содержания |
| JavaScript | собственная логика в коде | да | условия, которые можно закодировать: структура, порядок, количество | смысловые достоинства и недостатки |
| llm-rubric | оценка модели по рубрике | зависит от модели-судьи | что вывод, по мнению модели-судьи, соответствует рубрике | фактическую правильность; не заменяет проверку человеком |
Источники и статус проверки
Фактическая часть статьи опирается на следующие страницы документации Promptfoo; дата проверки — 2026-11-17:
- Документация Promptfoo по ассертам и метрикам: promptfoo.dev/docs/configuration/expected-outputs/
- Документация Promptfoo по ассертам с оценкой моделью: promptfoo.dev/docs/configuration/expected-outputs/model-graded/
- Документация Promptfoo по llm-rubric: promptfoo.dev/docs/configuration/expected-outputs/model-graded/llm-rubric/
В этой статье мы не запускали реальный A/B-эксперимент со старым и новым шаблоном. Конфигурации и процессы, которые встречаются далее, — это проектные рекомендации, а не результаты каких-либо измерений.
Сравнение старого и нового шаблонов статьи с помощью Promptfoo: анализ и выводы
Ниже — наша интерпретация и рекомендации, основанные на перечисленных выше фактах. Возьмём для примера «шаблон новостной статьи»: предположим, новый шаблон требует, чтобы статья состояла из двух разделов — «объективные факты» и «аналитические суждения», — причём факты идут первыми, анализ — после них, а в разделе фактов нельзя смешивать факты с предположениями.
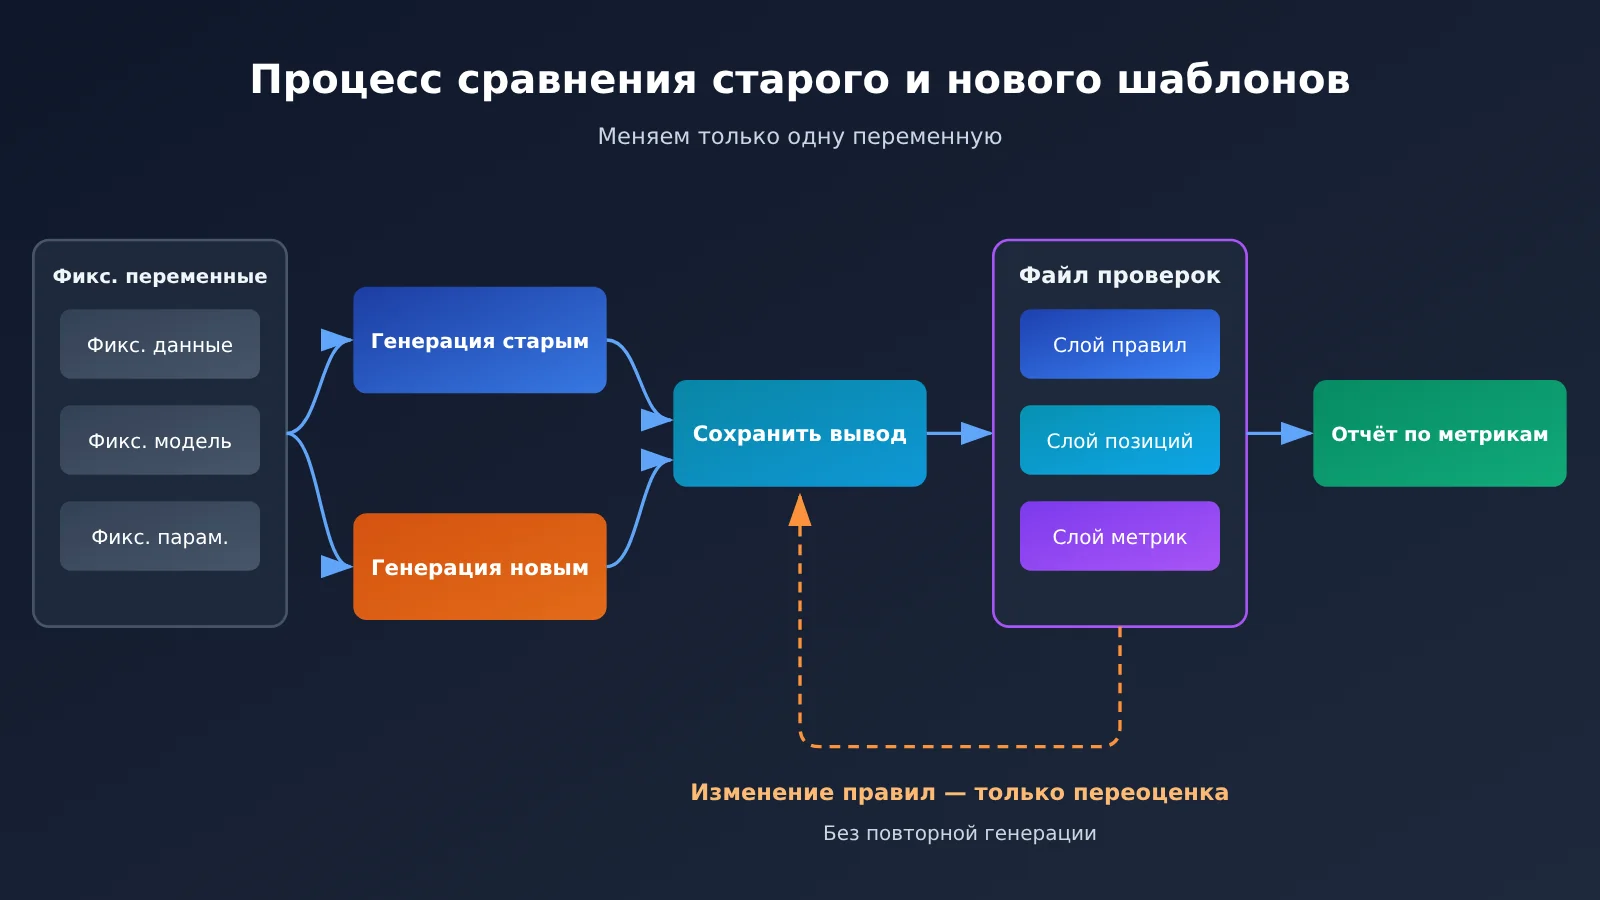
План эксперимента: при сравнении шаблонов в Promptfoo меняем только одну переменную
Самая частая ошибка при сравнении шаблонов — вместе со сменой шаблона поменять ещё и материалы, модель или параметр температуры. Тогда даже при улучшении результата невозможно понять, что именно сыграло роль: шаблон или другие факторы. Поэтому первый шаг — зафиксировать все переменные, кроме шаблона.
| Переменная | Как поступаем | Причина |
|---|---|---|
| Входные материалы | Фиксируем один и тот же набор, общий для старого и нового шаблонов | Разные материалы напрямую меняют содержание фактов |
| Модель генерации | Фиксируем одну и ту же модель и версию | Различия в стиле письма у разных моделей могут оказаться больше различий между шаблонами |
| Параметры генерации | Фиксируем температуру, максимальную длину и другие настройки | Параметры влияют на стабильность и объём вывода |
| Шаблон промпта | Единственная изменяемая переменная | Именно его мы и проверяем |
| Правила оценки | Для обеих групп используем один и тот же набор утверждений | Чтобы обе группы проходили одинаковые проверки |
Promptfoo: уровень правил и уровень позиции — сначала структура, потом порядок
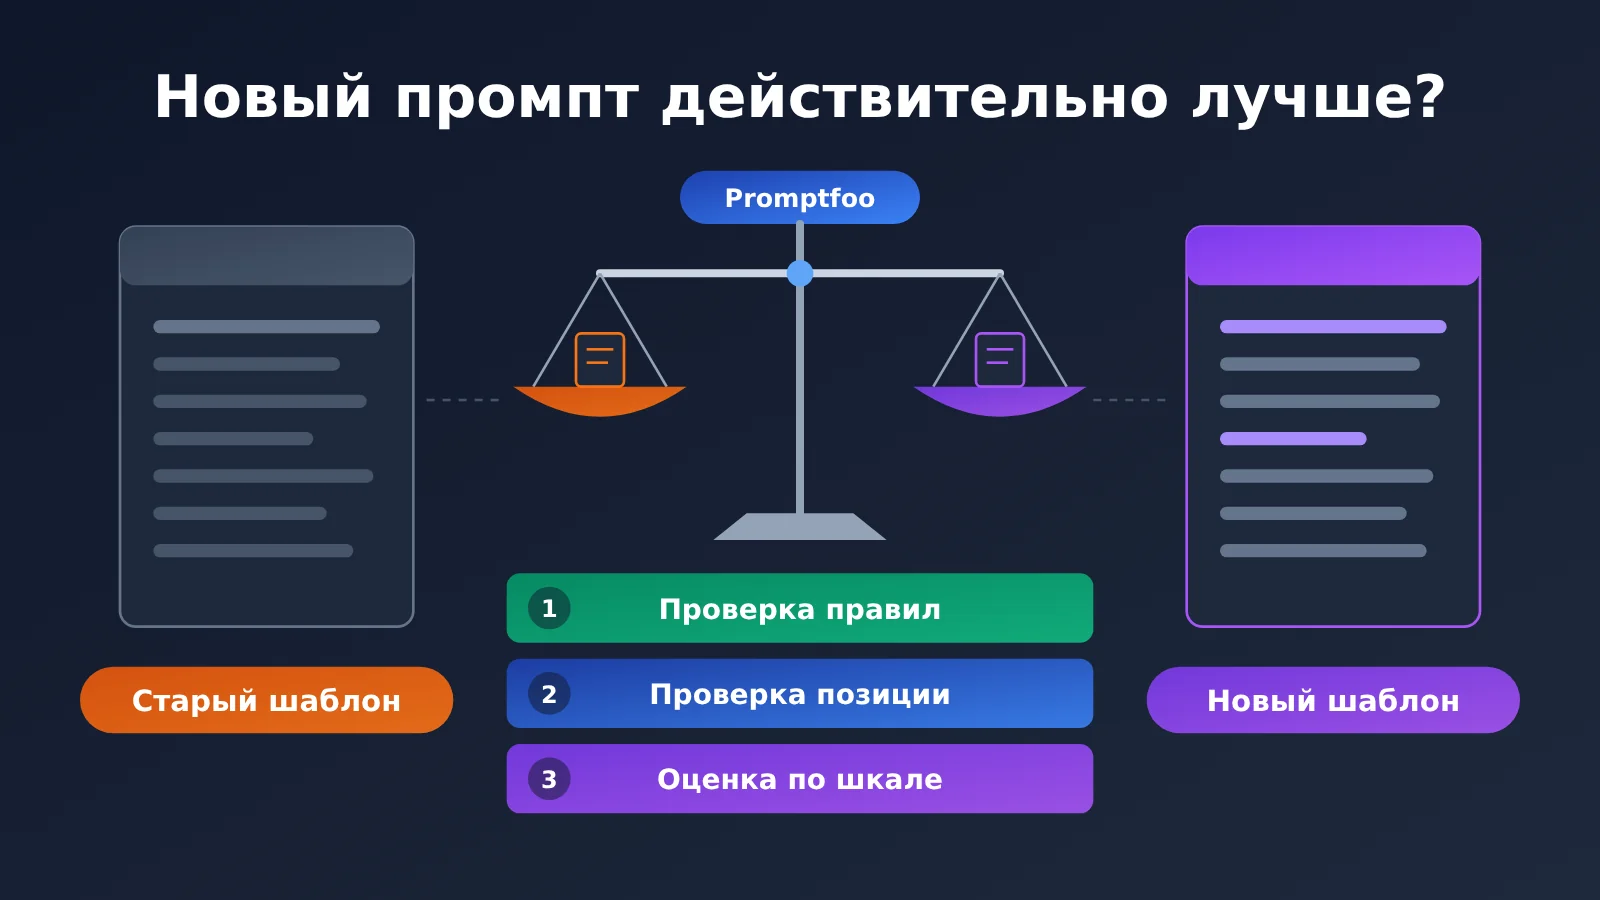
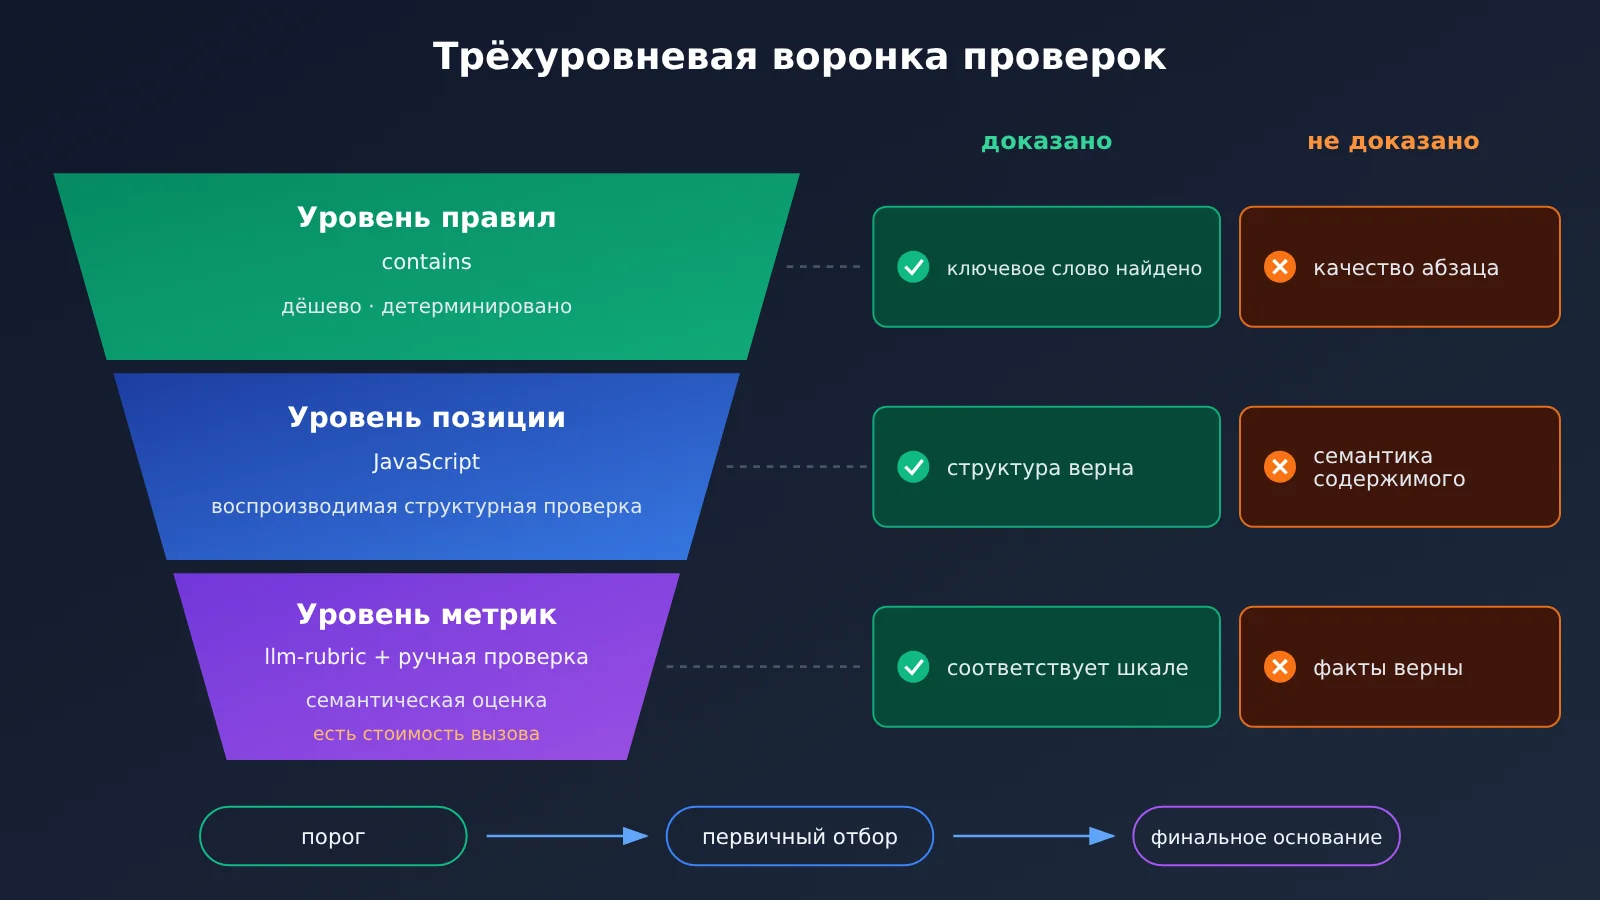
Первый уровень — проверка правил: с помощью contains убеждаемся, что в выводе присутствуют заголовки, которые требует шаблон. Второй уровень — сравнение позиций: JavaScript-утверждение проверяет, что заголовок «客观事实» (объективные факты) стоит раньше заголовка «分析判断» (аналитические суждения). Оба уровня — детерминированные проверки: дешёвые и со стабильным результатом, поэтому их удобно ставить в самое начало и отсеивать заведомо неудачный вывод.
Ниже — примерная запись утверждений; точные имена полей сверяйтесь с официальной документацией Promptfoo:
# Пример конфигурации: иллюстрирует подход, детали полей сверяйте с официальной документацией
assert:
  # Уровень правил: есть ли заголовок
  - type: contains
    value: "## 客观事实"
  - type: contains
    value: "## 分析判断"

  # Уровень позиции: раздел с фактами должен идти перед разделом с анализом
  - type: javascript
    value: |
      const a = output.indexOf('## 客观事实');
      const b = output.indexOf('## 分析判断');
      return a >= 0 && b >= 0 && a < b;
Обратите внимание: в варианте для уровня позиции сначала проверяется, что оба заголовка вообще есть. Если написать только a < b, то при отсутствии заголовка «客观事实» indexOf вернёт -1, и условие «меньше» всё равно выполнится — получится ложноположительный результат. Именно поэтому даже детерминированные утверждения нужно писать внимательно.
Уровень рубрик Promptfoo: с помощью четкой рубрики проверяем, не попали ли в раздел фактов домыслы
Все заголовки на месте, порядок правильный — но это еще не значит, что раздел фактов написан чисто. Вопрос «не попали ли в факты домыслы» — суждение семантическое, и правиловые утверждения (rule assertions) его плохо покрывают. Вот тут-то и подходит llm-rubric. Рубрику нужно писать конкретно: объяснить оценочной модели, что считается нарушением, а не спрашивать абстрактно «хорошо ли написано».
# Иллюстративная конфигурация: провайдер оценки и содержание рубрики — просто примеры
assert:
  - type: llm-rubric
    value: |
      Оценивайте только раздел «объективные факты».
      Если в этом разделе встречаются прогнозы, субъективные оценки или выводы без указания источника — считать проверку непройденной и цитировать проблемную фразу.
      Не оценивайте стиль изложения, не оценивайте другие разделы.
    provider: your-grading-model   # провайдера оценки можно настроить отдельно
Выводы уровня рубрик всё равно требуют выборочной ручной проверки. Оценочная модель может что-то пропустить, а может и ошибочно принять корректное фактическое утверждение за домысел. Надежнее всего — перепроверить каждый образец, не прошедший проверку, а из прошедших случайно отобрать часть и просмотреть вручную.
Покомпонентная подача: не даём баллам Promptfoo за стиль перекрывать фактические ошибки
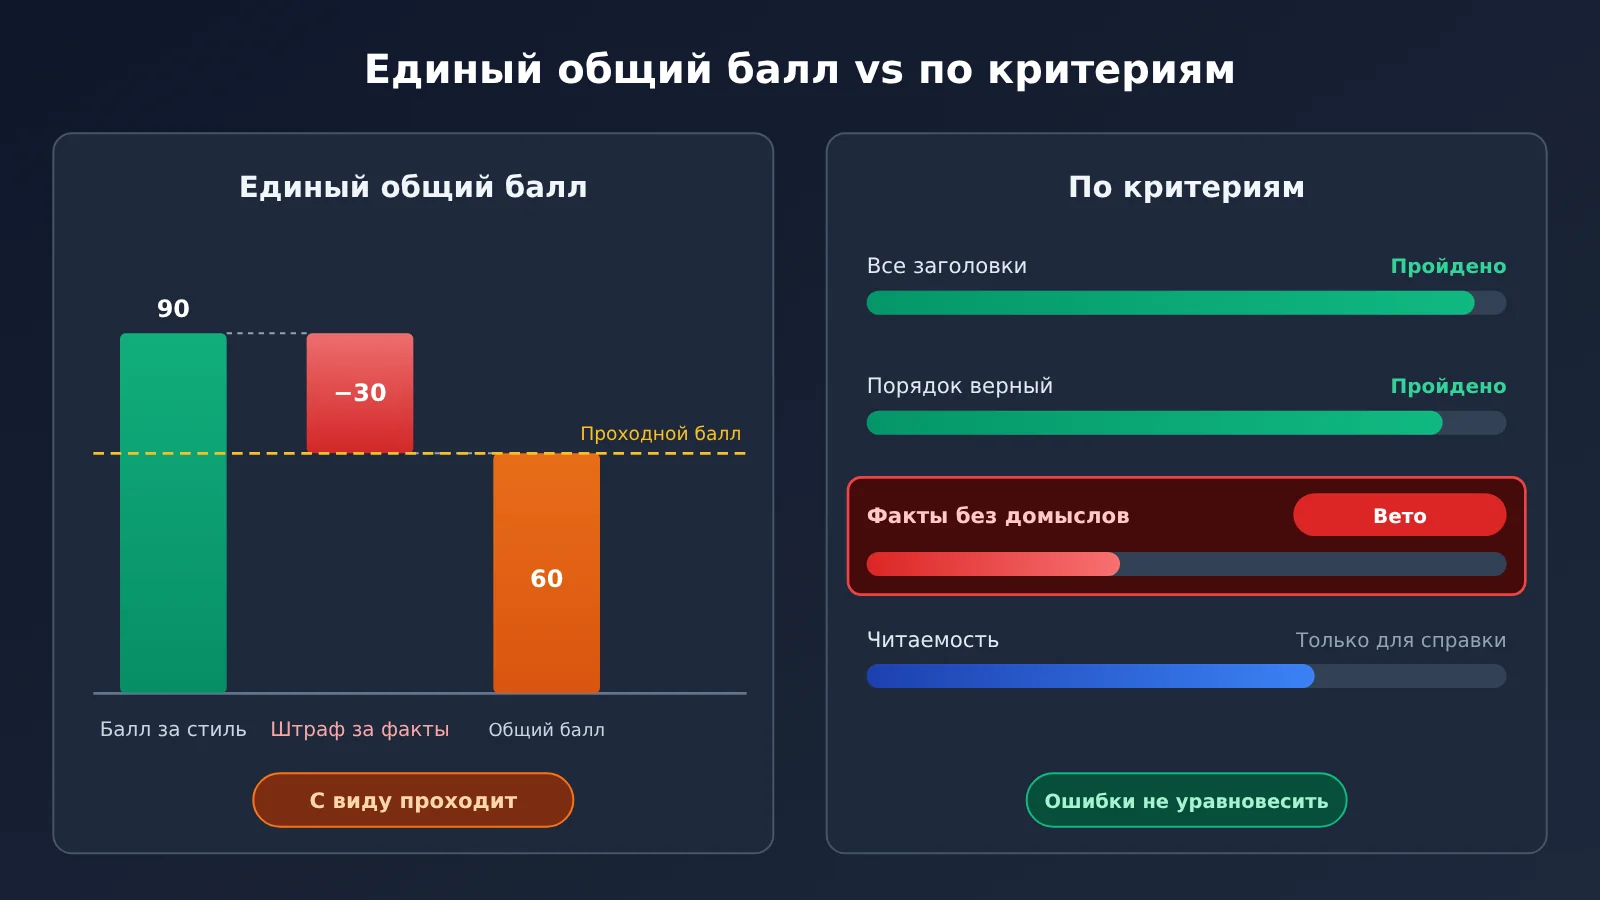
Если свести все проверки в один общий балл, текст с гладким слогом, но с домыслами в фактической части может получить примерно столько же, сколько строго структурированный, но чуть пресноватый текст. Для новостного контента такое «взаимное перекрытие» опасно. Поэтому отчёт лучше давать отдельно по каждому измерению, а по фактическим измерениям ставить право вето.
| Параметр оценки | Способ проверки | Формат подачи | Может ли быть компенсирован другими параметрами |
|---|---|---|---|
| Все обязательные заголовки на месте | contains | Доля прохождений | Нет, жёсткое требование |
| Правильный порядок разделов | JavaScript | Доля прохождений | Нет, жёсткое требование |
| В фактах нет примеси домыслов | llm-rubric + ручная проверка | Доля прохождений + список проблемных фраз | Нет, право вето |
| Изложение и читаемость | llm-rubric | Выносится отдельно | Только для справки, в компенсации не участвует |
Когда меняются только правила оценки Promptfoo, старые выводы можно переоценивать напрямую
В итерациях по оценке чаще всего меняются именно правила оценки, а не сам шаблон. Например, обнаружилось, что описание шкалы недостаточно понятное, или в проверке позиционирования пропущен граничный случай. В такой ситуации шаблон и выводы не менялись, и заново генерировать их нет смысла.
Благодаря тому, что Promptfoo умеет запускать отдельный файл утверждений по уже готовым выводам, можно полностью разделить генерацию и оценку: генерируем один раз, сохраняем выводы, и дальше при каждой правке правил перезапускаем только утверждения. Это экономит время и гарантирует, что в двух последовательных прогонах оценки на входе ровно один и тот же текст — только так сравнение имеет смысл.
Границы и стоимость судейства моделью в Promptfoo
Здесь нужно чётко оговорить три момента, чтобы не переинтерпретировать результаты оценки:
- Оценка судьи-модели не доказывает фактическую верность. llm-rubric говорит лишь о том, что вывод, с точки зрения оценочной модели, соответствует шкале; проверка фактов всё равно возвращается к исходным материалам.
- Прохождение contains означает лишь совпадение текста. Оно говорит, что заголовок присутствует, но не говорит, что качество абзаца под заголовком приемлемое.
- Платное ревью моделью стоит денег. Утверждения на правилах почти не порождают дополнительных вызовов модели, но llm-rubric вызывает оценочную модель на каждый оценённый вывод, поэтому называть весь набор оценки «полностью бесплатным» нельзя.
С учётом этих границ наша позиция такая: детерминированные утверждения хороши как «порог», оценка моделью — как «первичный отбор», а окончательной опорой для выводов о фактах остаётся человеческая проверка. У всех трёх разные задачи, и подменять друг друга они не могут.
Направления, на которые стоит обратить внимание в дальнейшем
Ниже — пока непроверенные гипотезы, они приводятся лишь как предложения для будущих экспериментов:
- Согласованность оценочной модели. Даёт ли многократная оценка одного и того же вывода стабильный результат и не перевернётся ли вывод, если взять другую оценочную модель. Если стабильности нет, шкалу нужно описывать конкретнее.
- Степень совпадения ручной проверки с оценкой модели. Именно от этого зависит, насколько можно опираться на llm-rubric для первичной фильтрации.
- Достаточно ли объёма выборки. При сравнении всего нескольких статей случайные факторы могут замаскировать различия между шаблонами, поэтому для осмысленных выводов нужно достаточно много входных материалов.
Пока по этим вопросам нет измеренных данных, к любым утверждениям в духе «насколько новый шаблон повышает долю побед» или «насколько выросла оценка» стоит относиться осторожно. Именно поэтому в статье намеренно не приводятся такие числа.
«Знание, добытое из книг, всегда поверхностно; чтобы познать суть дела, нужно действовать самому». — Лу Ю, «Ночное чтение с наставлением сыну Цзыюю»