Nota do autor: os pesos do MiniMax M3.1 Flash estão previstos para serem disponibilizados em 23 de outubro. Este artigo explica qual nível de hardware é necessário para implantá-lo localmente e compara, em quatro dimensões, o que vale mais a pena: “implantar por conta própria” ou “chamar a API diretamente”.
Vamos direto à conclusão: para a maioria dos desenvolvedores individuais e das equipes pequenas, chamar diretamente a API, que custa US$ 0,15 por milhão de tokens de entrada e US$ 0,60 por milhão de tokens de saída, sai muito mais barato e dá muito menos trabalho do que fazer a implantação por conta própria. Só vale considerar a implantação própria em três situações: quando as regras impedem que os dados saiam da rede interna, quando o volume de chamadas é alto o suficiente para manter um servidor com várias GPUs ocupado continuamente ou quando você precisa modificar ou ajustar o próprio modelo.
Este artigo não é contra o código aberto. Pesos abertos são importantes para o setor, mas “poder baixar” e “valer a pena executar por conta própria” são coisas diferentes. Já publicamos um artigo separado sobre o lançamento do M3.1 Flash; por isso, não vamos repetir as notícias aqui. Vamos responder apenas a duas perguntas: de que configuração você precisa para implantá-lo localmente e o que vale mais a pena, fazer a implantação por conta própria ou chamar a API?
O principal benefício: ao terminar de ler, você vai conseguir decidir se vale a pena esperar por esses pesos e quais informações deve verificar primeiro quando eles forem disponibilizados.
Situação dos pesos abertos do MiniMax M3.1 Flash: o que já foi confirmado e o que ainda não foi divulgado
Primeiro, vamos explicar um termo. Pesos abertos são os arquivos com os parâmetros treinados de um modelo, disponibilizados publicamente para que você possa baixá-los e executá-los no seu próprio servidor. Isso é diferente de “código aberto” e também não significa que o uso comercial esteja liberado sem restrições: as condições de uso dependem da licença.
Até a data de publicação (22 de outubro de 2026), os pesos do M3.1 Flash ainda não foram lançados oficialmente. A publicação oficial da MiniMax no X diz: “Model weights will arrive on Oct 23”, ou seja, o lançamento está previsto para 23 de outubro. O blog oficial diz apenas que eles serão lançados “em breve”. Além disso, segundo uma reportagem do RITS da Universidade de Nova York em Xangai, em 20 de outubro ainda não havia um repositório do M3.1 Flash na organização da MiniMax no Hugging Face.
Para diferenciar os níveis de confiabilidade das informações, este artigo as divide em três categorias: informações divulgadas oficialmente (pela própria MiniMax), avaliações de terceiros (como a Vals AI) e desconhecido/não divulgado.
| Item | Situação | Categoria da informação |
|---|---|---|
| Data de lançamento dos pesos | Publicação oficial no X indica 23 de outubro; o blog oficial diz apenas “em breve” | Informações divulgadas oficialmente (previsão, ainda não concretizada) |
| Tamanho do modelo | Arquitetura MoE, 428B de parâmetros no total e cerca de 23B ativos, o mesmo que o M3 | Informação oficial, repercutida pela imprensa |
| Licença | A licença do M3.1 Flash ainda não foi divulgada | Desconhecido/não divulgado |
| Requisitos de hardware para implantação | O guia oficial de implantação ainda não inclui o M3.1 Flash | Desconhecido/não divulgado |
| Relatório técnico | Ainda não foi publicado nenhum documento explicando o que mudou no Flash em relação ao M3 | Desconhecido/não divulgado |
| Modelo de referência: M3 | Os pesos estão no Hugging Face desde junho e são distribuídos sob uma licença comunitária | Informação oficial |
⚠️ Atenção: depois que os pesos forem lançados, consulte a página oficial do modelo da MiniMax no Hugging Face para confirmar os termos da licença, o tamanho dos arquivos e o hardware recomendado. Versões quantizadas republicadas pela comunidade não são validadas oficialmente; não as considere configurações oficiais.
Quais são os requisitos para implantar o MiniMax M3.1 Flash localmente?
A documentação oficial ainda não informa os requisitos de hardware do M3.1 Flash. Por isso, não vamos especular sobre a quantidade de memória de vídeo nem sobre o número de GPUs. Podemos usar como referência o M3, da geração anterior e de porte semelhante. Os dois têm o mesmo total de parâmetros (428B) e a mesma quantidade de parâmetros ativados (cerca de 23B), então o M3 ajuda a estimar a ordem de grandeza.
Primeiro, entenda o que significa “428B de parâmetros totais e 23B ativados” no MiniMax M3.1 Flash
MoE (Mistura de Especialistas) é uma arquitetura de modelo formada por várias sub-redes chamadas “especialistas”. A cada inferência, apenas algumas delas são acionadas. “Cerca de 23B de parâmetros ativados” significa que essa é a quantidade de parâmetros que participa efetivamente dos cálculos para gerar cada token. Por isso, o modelo pode ser relativamente rápido.
Mas há um ponto que costuma causar confusão: ter poucos parâmetros ativados não significa precisar de pouca memória de vídeo. Os 428B de parâmetros precisam estar carregados na memória dedicada das GPUs para que qualquer especialista possa ser acionado durante a inferência. Esse é um dos principais motivos pelos quais é difícil implantar localmente modelos MoE de grande porte.
Referência oficial da MiniMax para implantar o M3 (apenas uma estimativa de escala)
Antes, vale explicar alguns termos. MXFP8 é um formato de armazenamento de 8 bits que pode reduzir o tamanho dos arquivos do modelo e o uso de memória de vídeo. SGLang é um framework de inferência de código aberto que permite executar o modelo como um serviço de API compatível com o formato da OpenAI. TP (paralelismo de tensores) é uma técnica que divide um modelo entre várias GPUs para que elas trabalhem em conjunto.
| Modelo | Configuração de referência oficial | Tamanho dos pesos | Status |
|---|---|---|---|
| MiniMax-M3 | 8 × B200, precisão MXFP8, interface compatível com OpenAI do SGLang | Versão MXFP8: cerca de 440 GB | Experimental |
| MiniMax-M2.7 | 4 GPUs NVIDIA com bastante memória, TP 4 | Mínimo de memória de vídeo não padronizado nem divulgado | Prévia |
| MiniMax-M3.1 Flash | Ainda não incluído no guia oficial de implantação | Não divulgado | Desconhecido/não divulgado |
Reforçando: os dados do M3 na tabela não são requisitos oficiais do M3.1 Flash. Eles mostram que a configuração oficial de referência para um modelo de porte semelhante usa 8 GPUs de nível de data center, e que só os pesos em MXFP8 ocupam cerca de 440 GB. Isso está muito além do que oferecem placas de vídeo para consumidores e estações de trabalho comuns. Na prática, não é viável rodar a versão completa em casa com uma ou duas GPUs para jogos.
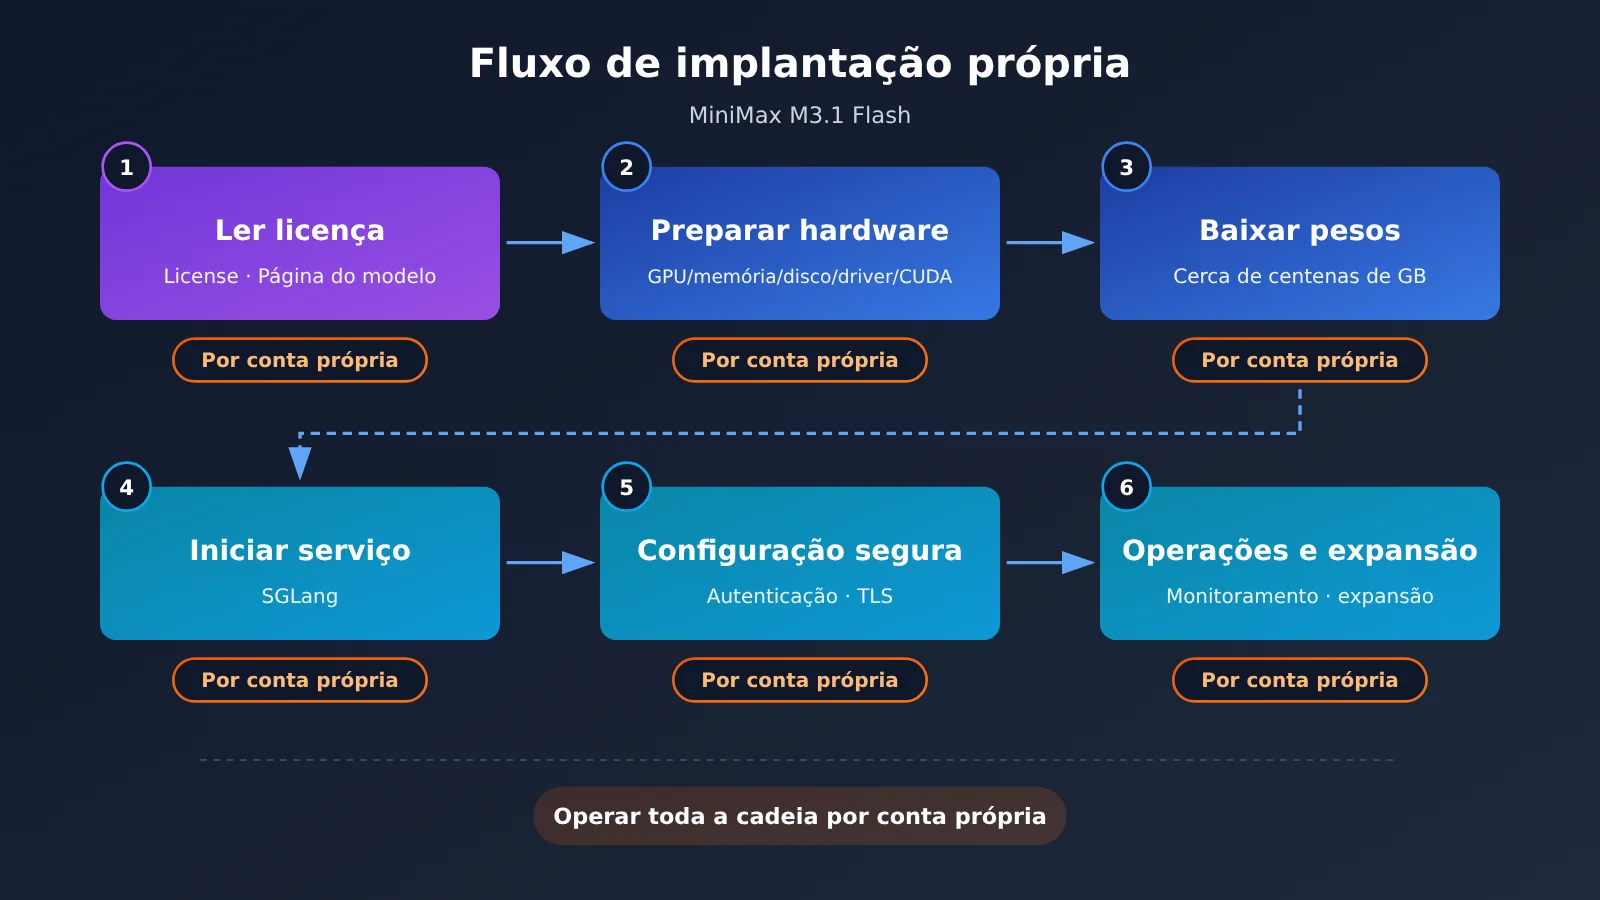
A documentação oficial da MiniMax também traz algumas recomendações para a implantação, válidas para todos os modelos de código aberto:
- Leia primeiro a licença e confira o escopo de uso para confirmar que ela permite a sua finalidade;
- Prepare o hardware conforme a página do modelo, incluindo GPU, memória, disco, drivers e versão do CUDA;
- Fixe as versões do modelo e do framework de inferência, sem acompanhar mudanças nas branches
mainoulatest; - Use apenas as fontes oficiais indicadas na página do modelo para baixar por espelhos locais, evitando arquivos adulterados.
Vale mais a pena implantar o MiniMax M3.1 Flash por conta própria ou usar a API?
Essa é a principal questão do artigo. A seguir, compare sua situação usando quatro critérios.
| Critério | Melhor usar a API diretamente | Melhor implantar por conta própria |
|---|---|---|
| Requisitos de conformidade de dados | Os dados podem ser processados por um provedor de serviços na nuvem | Regulamentos ou contratos exigem que os dados não saiam da rede interna |
| Volume de chamadas | Volume pequeno ou médio, com picos e quedas acentuados | Alto volume contínuo, suficiente para manter servidores com várias GPUs ocupados |
| Capacidade operacional da equipe | Não há profissionais dedicados à operação de GPUs | Há alguém responsável pelo cluster, pelo monitoramento e pelos plantões |
| Necessidade de modificar o modelo | Os recursos gerais do modelo são suficientes | É necessário fazer ajuste fino, alterar a estrutura ou personalizar o modelo em profundidade |
Se você se encaixar na coluna da esquerda em pelo menos dois dos três primeiros critérios, escolher a API provavelmente será a melhor opção.
Como calcular o custo da API do MiniMax M3.1 Flash
Os preços oficiais são fixos: US$ 0,15 para entrada, US$ 0,60 para saída e US$ 0,015 para leitura de cache, todos por milhão de tokens. Não há cobrança extra por contexto longo. Token é a unidade de texto usada pelo modelo para calcular a cobrança. Segundo a conversão oficial, cerca de 750 palavras em inglês equivalem a 1.000 tokens. Leitura de cache significa que conteúdos de prefixo idênticos enviados repetidamente são cobrados por um preço menor.
Veja um exemplo com base nos preços oficiais (não é um resultado de teste): com 100 milhões de tokens de entrada e 20 milhões de tokens de saída por mês, o custo é 100 × US$ 0,15 + 20 × US$ 0,60 = US$ 27. Esse já é um volume considerável para uma pessoa ou uma equipe pequena — algumas dezenas de dólares por mês.
Para calcular o custo da implantação própria, é preciso levar outros fatores em conta. Se usarmos como referência a configuração do M3 com 8 × B200, esse tipo de máquina representa uma despesa fixa contínua, tanto na compra quanto no aluguel, e continua gerando custos mesmo quando ninguém a está usando. Para diluir esse custo, o volume de chamadas normalmente precisa ser alto o bastante para manter a máquina ocupada por longos períodos — algo que a maioria das pessoas e equipes pequenas não consegue alcançar.
Um ponto importante: não é possível desativar o processo de raciocínio do M3.1 Flash. Se você não informar o effort (profundidade de raciocínio), o padrão será max. O conteúdo do raciocínio também conta como tokens de saída. Por isso, a parte de saída da cobrança pode ser maior do que você espera. Para economizar, ajuste o effort para low ou medium.
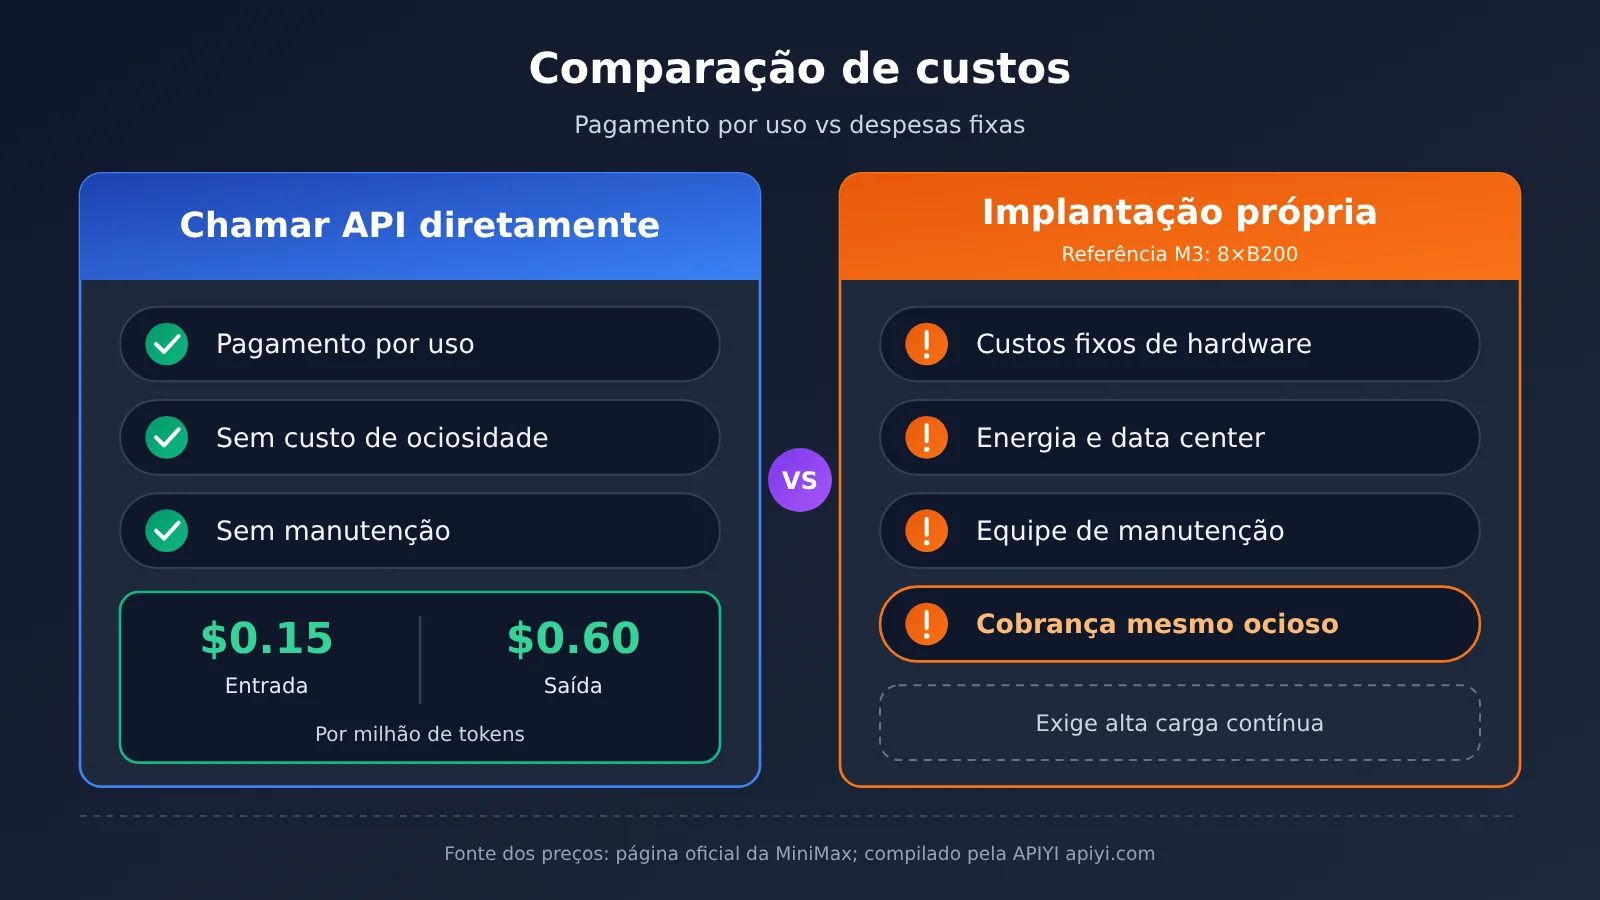
Os preços acima foram obtidos na página oficial de preços da MiniMax e compilados pela equipe técnica da APIYI apiyi.com. A tabela abaixo mostra os preços oficiais de alguns modelos frequentemente comparados:
| Modelo | Preço de entrada (por milhão de tokens) | Preço de saída (por milhão de tokens) | Plataformas disponíveis |
|---|---|---|---|
| MiniMax-M3.1-Flash | US$ 0,15 | US$ 0,60 | API oficial da MiniMax, M Plan; consulte a página de preços para saber se está disponível na APIYI |
| MiniMax-M3 (≤512K de entrada) | US$ 0,30 | US$ 1,20 | API oficial da MiniMax, APIYI apiyi.com |
| claude-opus-5-5 | US$ 4 | US$ 20 | API oficial da Anthropic, APIYI apiyi.com |
| claude-opus-5 | US$ 5 | US$ 25 | API oficial da Anthropic, APIYI apiyi.com |
💰 Dica para economizar: se quiser testar agora o desempenho da linha MiniMax, você pode começar usando o MiniMax-M3, já disponível na APIYI apiyi.com, para colocar seu fluxo de trabalho em funcionamento. Consulte a página de preços para saber se o M3.1 Flash está disponível na APIYI. Também estamos trabalhando para disponibilizá-lo em breve.
O que fica sob sua responsabilidade ao hospedar o MiniMax M3.1 Flash por conta própria
A documentação oficial da MiniMax deixa isso bem claro: os pesos de código aberto não incluem recursos da plataforma, como cache e segurança de conteúdo, e o serviço, por padrão, só aceita conexões locais. Antes de decidir hospedar o modelo por conta própria, confirme que alguém ficará responsável por cada um destes itens:
- Autenticação: adicione uma chave de acesso à interface para evitar que outras pessoas a usem sem autorização;
- Criptografia TLS: se o serviço ficar acessível externamente, use HTTPS para criptografar a transmissão e impedir que os dados sejam interceptados;
- Isolamento de rede: restrinja quais máquinas e sub-redes podem acessar o serviço de inferência;
- Monitoramento e alertas: alguém precisa acompanhar o uso da GPU, a memória de vídeo, a latência e a taxa de erros;
- Planejamento de capacidade e expansão: prepare com antecedência um plano de expansão para os horários de pico, quando as solicitações ficam na fila;
- Recuperação de falhas e atualizações: defina como recuperar o serviço se uma máquina parar e como fazer a implantação gradual de uma nova versão;
- Segurança de conteúdo: você precisará implementar a moderação do conteúdo das entradas e saídas;
- Conformidade com a licença: antes de implantar, redistribuir ou usar comercialmente, leia a licença completa e as políticas de uso.
Se não houver ninguém responsável por qualquer um desses itens, a economia com o custo dos tokens ao hospedar o modelo por conta própria pode acabar sendo consumida pelos custos de operação.
Como avaliar as capacidades do MiniMax M3.1 Flash: dados divulgados pela empresa vs. avaliações de terceiros
Antes de decidir se vale a pena fazer a implantação por conta própria, é importante entender o desempenho real do modelo. A tabela abaixo organiza os dados por nível de confiabilidade:
| Indicador | Dados | Nível de informação |
|---|---|---|
| Automation-Bench v1.0.6 | 62,2; Claude Opus 5: 50,3 | Divulgado pela própria empresa |
| BankerToolBench | 76,2, empatado com Claude Opus 5 | Divulgado pela própria empresa |
| Terminal Bench 4.0 | 38,1; Claude Opus 5: 51,8 | Divulgado pela própria empresa |
| SWE Refactor Bench | 23,0; Claude Opus 5: 31,0 | Divulgado pela própria empresa |
| Velocidade de inferência | O blog informa mais de 200 TPS no uso cotidiano e P50 acima de 170; a página do produto indica cerca de 150 tokens por segundo | Divulgado pela própria empresa (critérios diferentes) |
| Vals Index | 53,78%; 15º entre 22 modelos e 5º entre os modelos com pesos abertos | Avaliação de terceiros |
| Vals Terminal-Bench 4.0 | 25,25%; 22º entre 51 modelos | Avaliação de terceiros |
| “Custa 1/3 do M3” | Calculado por tarefa; o método específico não foi divulgado | Desconhecido/não divulgado |
TPS é o número de tokens gerados por segundo. Quanto maior esse valor, mais rápido o modelo responde.
É importante esclarecer a comparação com o Claude: a tabela da MiniMax compara o M3.1 Flash com o Claude Opus 5, não com o Opus 5.5. O Claude Opus 5.5 continua sendo o modelo flagship mais avançado da Anthropic, e a empresa não o comparou item por item com o M3.1 Flash. Portanto, não dá para concluir que o M3.1 Flash “alcançou ou superou o Opus 5.5”.
Mesmo na comparação com o Opus 5, o M3.1 Flash fica claramente atrás em tarefas de programação com cadeias longas de etapas e de refatoração, como Terminal Bench e SWE Refactor. Os resultados de terceiros da Vals também indicam um desempenho mais fraco em tarefas de Agent com cadeias longas.
Quando não usar o MiniMax M3.1 Flash — e por que não se apressar para fazer a implantação própria
Nas situações a seguir, é melhor não agir ainda:
- Planejamento complexo e grandes refatorações: tanto os dados divulgados pela própria empresa quanto as avaliações de terceiros indicam que o modelo é mais fraco em tarefas com longas cadeias de etapas. Para esse tipo de trabalho, é mais seguro usar um modelo de ponta como o Claude Opus 5.5.
- Latência extremamente crítica, sem necessidade de raciocínio profundo: não é possível desativar o modo de raciocínio. Mesmo configurado no nível
low, ele ainda gera essa sobrecarga. - Integrações que já analisam a tag
<think>do M3: no M3.1 Flash, o conteúdo de raciocínio é retornado em um campo separado. Atualize a lógica de análise antes de fazer a migração. - Licença ainda não esclarecida: a licença não havia sido divulgada antes da publicação dos pesos. Não planeje projetos comerciais contando com a implantação própria antes de conhecer os termos.
- Ninguém responsável pelo plantão: se ninguém puder cuidar da lista de operações da seção anterior, não coloque seus serviços em uma infraestrutura própria.
- Expectativa de executar a versão completa em uma placa de vídeo de consumo: considerando a escala do M3, isso não é realista. Aguarde as especificações oficiais de hardware e não confie em versões quantizadas de origem duvidosa.
Combinando MiniMax e Claude Opus 5.5 na APIYI
Para a maioria dos desenvolvedores, a questão mais prática não é “implantar por conta própria ou usar uma API”, e sim: como distribuir tarefas de diferentes níveis de dificuldade entre modelos distintos.
A APIYI permite chamar, com uma única chave, modelos internacionais como Claude, GPT e Gemini, além de modelos chineses como DeepSeek e MiniMax. Atualmente, estão disponíveis na APIYI o MiniMax-M3 (compatível com os formatos de interface da OpenAI e da Anthropic, e também disponível no grupo ClaudeCode), a série MiniMax-M2.7 e os modelos claude-opus-5-5 e claude-opus-5. Até a data de publicação, o MiniMax-M3.1-Flash ainda não aparecia na página de preços da APIYI. Consulte essa página para confirmar a disponibilidade.
Uma divisão de tarefas recomendada:
- Deixe as tarefas simples e em grande volume com o MiniMax: limpeza de dados, resumos em lote, conversão de formatos e preenchimento simples de código. Como são tarefas numerosas e de baixa complexidade individual, quanto menor o custo por chamada, melhor.
- Deixe o planejamento complexo e as refatorações com o Claude Opus 5.5: refatorações que envolvem vários arquivos, design de arquitetura e planejamento de tarefas complexas de agentes. O custo por chamada é maior, mas o retrabalho causado por erros também pode sair caro.
- Alterne entre modelos usando a mesma chave: basta mudar o nome do modelo, sem precisar manter várias contas e endereços de API.
🎯 Dica técnica: use a mesma chave na APIYI, em apiyi.com, para testar o MiniMax-M3 e o claude-opus-5-5 com tarefas reais suas. Comparar os resultados e os custos é mais confiável do que consultar qualquer benchmark.
Perguntas frequentes
Q1: Quando será possível baixar os pesos do MiniMax M3.1 Flash?
A publicação oficial no X indicou 23 de outubro como data prevista. Já o blog oficial disse apenas que isso aconteceria “mais tarde”. Até a publicação deste artigo, os pesos ainda não estavam disponíveis. Consulte a página oficial do modelo MiniMax no Hugging Face para saber das novidades.
Q2: Uma placa de vídeo para consumidores consegue executar o MiniMax M3.1 Flash?
A fabricante não divulgou os requisitos de hardware do M3.1 Flash. Como referência, a configuração oficial do M3, que tem escala semelhante, usa 8 × B200 e pesos MXFP8 com cerca de 440 GB. Na prática, é inviável executar a versão completa em uma única placa de vídeo para consumidores.
Q3: Será possível usar comercialmente o MiniMax M3.1 Flash depois que ele for disponibilizado como código aberto?
A licença ainda não foi divulgada. A fabricante lembra que o fato de os pesos serem abertos não significa que todos os modelos usem a mesma licença. Antes de implantar, redistribuir ou usar o modelo comercialmente, leia a licença completa.
Q4: Como experimentar os modelos da série MiniMax a baixo custo agora?
A forma mais simples é usar a API. Você pode acessar o M3.1 Flash pela API oficial da MiniMax ou pela assinatura M Plan (confira o valor mensal no site oficial). Se quiser gerenciar vários modelos com uma única chave API, você já pode invocar o MiniMax-M3 disponível na APIYI, em apiyi.com. Para saber se o M3.1 Flash está disponível, consulte a página de preços da APIYI.
Q5: O MiniMax M3.1 Flash pode substituir o Claude Opus 5.5?
Não é recomendável pensar dessa forma. A fabricante comparou o modelo apenas com o Claude Opus 5, e o M3.1 Flash ficou atrás em tarefas de programação com cadeias longas de etapas. Uma abordagem mais adequada é dividir o trabalho: usar o MiniMax para tarefas em lote e o Opus 5.5 para planejamento complexo e refatoração. Na APIYI, você pode fazer essa combinação com uma única chave API.
Principais pontos sobre os pesos abertos do MiniMax M3.1 Flash
- Os pesos ainda não foram disponibilizados: o lançamento está previsto para 23 de outubro. Consulte a página oficial do modelo no Hugging Face para confirmar.
- A licença e os requisitos de hardware ainda não foram divulgados: não compre equipamentos nem planeje cronogramas com base em suposições.
- A escala é comparável à do M3: são necessários 8 × B200 e cerca de 440 GB de pesos MXFP8 — uma configuração de data center.
- A API é mais econômica: com preços de US$ 0,15/US$ 0,60, ela é muito mais prática do que a infraestrutura própria para a maioria das pessoas e equipes pequenas.
- A autoinstalação atende a poucos casos: é mais indicada para cenários com requisitos rigorosos de conformidade, volume enorme de chamadas ou necessidade de modificar o modelo.
- A comparação é com o Opus 5: o Opus 5.5 continua sendo o principal modelo da Anthropic, e a empresa não publicou uma comparação item a item.
- Use os modelos em conjunto: na APIYI, em apiyi.com, você pode usar uma única chave API para combinar o MiniMax e o Claude Opus 5.5.
Resumo
Os principais pontos sobre os pesos abertos do MiniMax M3.1 Flash:
- Situação atual: os pesos têm lançamento previsto para 23 de outubro. A licença e os requisitos oficiais de hardware para implantação ainda não foram divulgados. Consulte a página oficial do modelo para obter as informações mais recentes;
- Configuração: como referência, o M3, de escala semelhante, requer 8 GPUs da classe B200 na configuração oficial — algo fora do alcance de equipamentos pessoais;
- Como decidir: avalie quatro fatores: conformidade, volume de chamadas, capacidade operacional e necessidade de modificar o modelo. Na maioria dos casos, usar a API é mais econômico.
Quando os pesos forem disponibilizados, leia primeiro a licença e as especificações oficiais de hardware para decidir se vale a pena montar sua própria infraestrutura. Na prática, uma solução mais eficiente para o negócio é usar modelos diferentes para tarefas com níveis distintos de complexidade. Na APIYI, em apiyi.com, você pode testar, com uma única chave API, a combinação entre os modelos da série MiniMax e o claude-opus-5-5.
📚 Referências
- Blog oficial de lançamento da MiniMax: anúncio de lançamento do M3.1 Flash e dados divulgados pela própria empresa
- Link:
minimax.io/blog/minimax-m31f -
Observação: declarações oficiais de que os preços, a velocidade e os pesos serão divulgados “mais tarde”
-
Página oficial de preços da MiniMax: preços por uso de cada modelo
- Link:
platform.minimax.io/docs/guides/pricing -
Observação: comparação de preços entre o M3.1 Flash e o M3
-
Guia oficial de implantação própria da MiniMax: configuração de referência para implantar modelos de código aberto
- Link:
platform.minimax.io/docs/guides/local-deploy -
Observação: configuração de referência do M3 com 8 × B200 e cuidados para a implantação própria
-
Página de avaliação da Vals AI: resultados de avaliação de terceiros do M3.1 Flash
- Link:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Observação: posição no Vals Index e pontuações por categoria
-
Hugging Face – MiniMax-M3: pesos do M3 e licença da comunidade
- Link:
huggingface.co/MiniMaxAI/MiniMax-M3 -
Observação: quando os pesos do M3.1 Flash forem disponibilizados, eles poderão ser consultados na mesma organização
-
Documentação do SGLang – MiniMax-M3: instruções de implantação com framework de inferência
- Link:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - Observação: tamanho da versão MXFP8 do M3 e como executá-la
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para consultar mais materiais, acesse o centro de documentação em docs.apiyi.com.