Nota do autor: todos têm “Flash” no nome, mas a modalidade de entrada, os endpoints e o multiplicador de grupo são diferentes. Este artigo segue a ordem “primeiro a página do modelo, depois os preços, por fim a escolha por tarefa” para explicar como escolher um modelo Flash.
Muita gente escolhe modelos da linha Flash assim: se o nome tem Flash, já trata como “rápido e barato” e então entrega tarefas de programação, leitura de imagens e cálculo de fórmulas ao mesmo modelo. O problema dessa abordagem é que os modelos com Flash no nome não têm a mesma modalidade de entrada nem os mesmos endpoints disponíveis. Alguns só aceitam texto; outros conseguem ler imagens e vídeos; e alguns sequer funcionam via /v1/messages.
Este não é um ranking de “quem é o mais forte”. O artigo não declara qual modelo é globalmente mais forte ou mais barato; apenas oferece um roteiro executável para escolher modelos Flash: primeiro, ver os tipos de entrada e a finalidade descritos na página do modelo; depois, comparar preço de entrada, preço de saída e preço de leitura de cache; por fim, chegar a um modelo específico conforme a tarefa.
Valor central: depois de ler este artigo, você conseguirá escolher um modelo Flash com a modalidade compatível de acordo com seu tipo de entrada (texto puro, capturas de tela de gráficos, vídeos longos). Também saberá quais tarefas que exigem raciocínio pesado não devem ser entregues ao Flash por padrão.
Pontos-chave para escolher um modelo Flash
| Ponto-chave | Descrição | Valor |
|---|---|---|
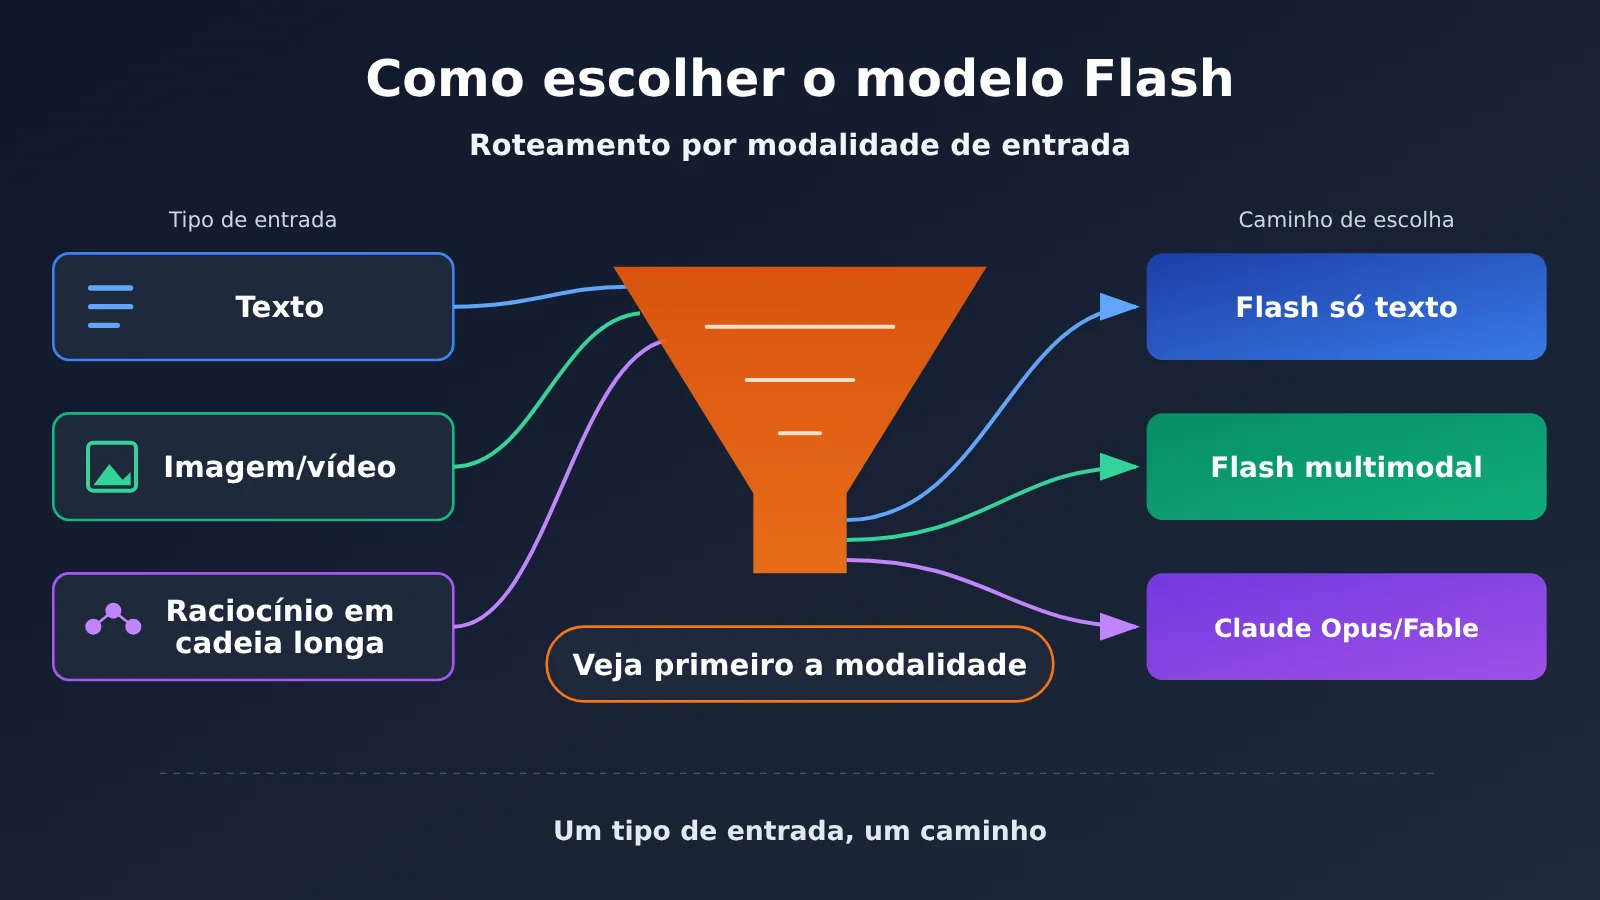
| Primeiro, veja a modalidade de entrada | O tipo de entrada indicado na página do modelo (texto/imagem/vídeo/áudio) determina se ele aceita os seus dados | Evita mandar uma captura de tela para um modelo que só aceita texto |
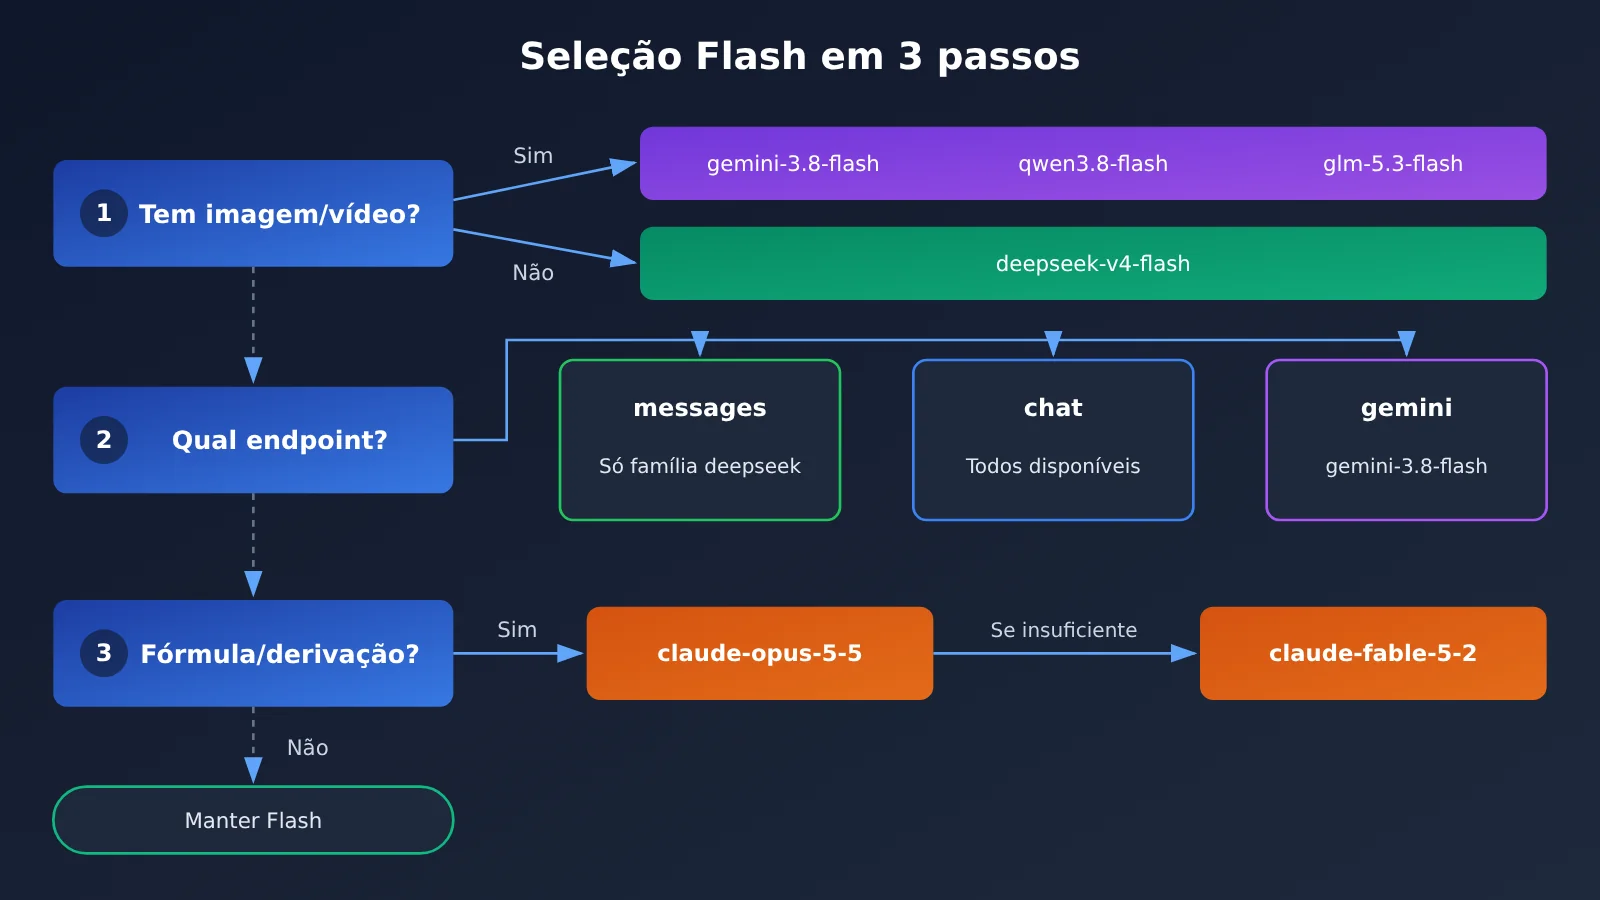
| Depois, veja o endpoint | O suporte de cada modelo aos endpoints chat, messages e gemini varia | Evita erro direto na interface depois de trocar de modelo |
| Compare os três preços | Preço de entrada, preço de saída e leitura de cache precisam ser vistos juntos, e depois multiplicados pelo multiplicador de grupo | A estimativa da fatura fica mais próxima do real |
| Divida por tarefa | Para ler gráficos e corrigir código curto, use um Flash com modalidade compatível | O custo de tarefas em volume fica controlável |
| Para raciocínio pesado, escolha outro | Fórmulas, provas e trabalhos técnicos de cadeia longa não usam Flash por padrão | Deixe os problemas difíceis para modelos de posicionamento mais alto |
Por que não dá para escolher um modelo Flash só pelo nome
“Flash” é apenas o nome que o fabricante dá a uma faixa de modelos, e cada empresa tem uma definição diferente para ele. Na página de modelos do APIYI (docs.apiyi.com/models.md), dá para ver que vários modelos chamados Flash têm modalidades de entrada que vão de “somente texto” a “texto, imagem, vídeo, áudio”. Os endpoints também variam de “chat e messages” a “apenas chat”.
Então, ao escolher um modelo Flash, o nome só ajuda a delimitar “este é um modelo voltado para volume e baixa latência”. O que realmente determina se dá para usar são as três colunas de informação na página do modelo: tipo de entrada, endpoints suportados e multiplicador de grupo. Todos os dados abaixo vêm da página do modelo e da tabela geral de modelos. A data de verificação é 2026-11-17, e os dados da tabela geral foram atualizados em 2026-11-16 09:39 (UTC+8), com preços unitários padrão por milhão de tokens.
Comparativo de modalidades de entrada e endpoints dos modelos Flash
A tabela abaixo reúne, num só lugar, as modalidades de entrada e os endpoints de alguns modelos Flash. O primeiro passo da seleção é justamente eliminar aqui os modelos em que “a modalidade não bate” e “o endpoint não bate”.
| ID do modelo | Modalidade de entrada | Saída | Endpoint | Outras observações na página do modelo |
|---|---|---|---|---|
deepseek-v4-flash |
Somente texto | Texto | chat, messages | Saída estruturada não suportada; suporta chamada de ferramentas, raciocínio profundo opcional e cache de comandos |
deepseek-v4.1-flash |
Sem página de modelo própria | — | chat, messages | Apenas uma linha na tabela geral; as capacidades ficam sujeitas a esclarecimentos oficiais posteriores |
gemini-3.8-flash |
Texto, imagem, vídeo, áudio | Texto | chat, gemini (sem messages) | Raciocínio profundo ativado por padrão, com níveis low/medium/high; especificações oficiais ainda não publicadas |
qwen3.8-flash |
Texto, imagem, vídeo | Texto | Somente chat | Janela de contexto 1,000,000, saída máxima 131,072 |
glm-5.3-flash |
Texto, imagem, vídeo | Texto | Somente chat | Janela de contexto 1,000,000, saída máxima 128,000; raciocínio profundo ativado por padrão |
Dois pontos merecem atenção especial. Primeiro: os dados de “somente texto”, janela de contexto 1,048,576 e saída máxima 393,216 do deepseek-v4-flash vêm todos da página do modelo v4 e não podem ser transportados para o deepseek-v4.1-flash. O v4.1 hoje tem apenas uma linha na tabela geral; se as capacidades não estão claras, não vale a pena supor. Segundo: se o seu projeto usa a interface /v1/messages no estilo Anthropic, os modelos Flash multimodais não funcionam por esse caminho — é preciso mudar para o endpoint chat.
Como comparar preços e grupos dos modelos Flash
Depois de validar modalidade e endpoint, é hora de conferir o preço. Trocar de modelo altera a conta diretamente, e o preço de tabela não é igual ao valor efetivamente cobrado, porque o grupo do token no APIYI apiyi.com tem multiplicadores. A tabela abaixo lista o preço padrão e o grupo indicado na página do modelo.
| ID do modelo | Preço de entrada | Preço de saída | Leitura de cache | Grupo e multiplicador |
|---|---|---|---|---|
deepseek-v4-flash |
$0.44 | $1.32 | $0.01408 | ClaudeCode 0.95×; CodexResponses, Default, SVIP 1× |
deepseek-v4.1-flash |
$0.3 | $1.2 | $0.006 | ClaudeCode, CodexResponses, Default, SVIP |
gemini-3.8-flash |
$0.75 | $3.75 | $0.075 | Gemini_Reverse 0.5×; Default, SVIP 1× |
qwen3.8-flash |
$0.114 | $0.3876 | $0.01425 | Default, SVIP 1× |
glm-5.3-flash |
$0.15 | $0.5 | $0.03 | CodexResponses, Default, SVIP |
claude-opus-5-5 |
$4 | $20 | $0.2 | ver tabela geral de modelos |
claude-fable-5-2 |
$8 | $40 | $0.2 | sem grupo Claude_Reverse |
Três pontos de conferência na conta dos modelos Flash
Este artigo não tira a conclusão de “quem é mais barato” por você, porque o custo real depende da sua proporção de entrada e saída e da taxa de acerto de cache. Sugerimos fazer sua própria conferência em três passos:
- Observe a proporção entrada/saída: em tarefas de ver imagens e ler documentos, a entrada é grande e a saída é pequena, então o preço de entrada pesa mais; em tarefas de gerar código longo e relatórios longos, o preço de saída pesa mais.
- Observe a leitura de cache: em cenários com comando de sistema fixo e chamadas repetidas, o preço de leitura de cache afeta significativamente o total da conta.
- Multiplique pelo fator do grupo: o mesmo
gemini-3.8-flash, passando pelo grupo Gemini_Reverse, é cobrado a 0.5×; pelo Default, a 1× — a conta não dá o mesmo número.
💰 Dica de custo: o grupo ao qual o token está vinculado muda diretamente o resultado da cobrança. Antes de trocar de modelo, confirme no console do APIYI apiyi.com qual é o grupo do token atual e então estime multiplicando o preço de tabela acima pelo fator, para não descobrir a mudança na conta só depois de ir para produção.
Escolha de modelos Flash por tarefa
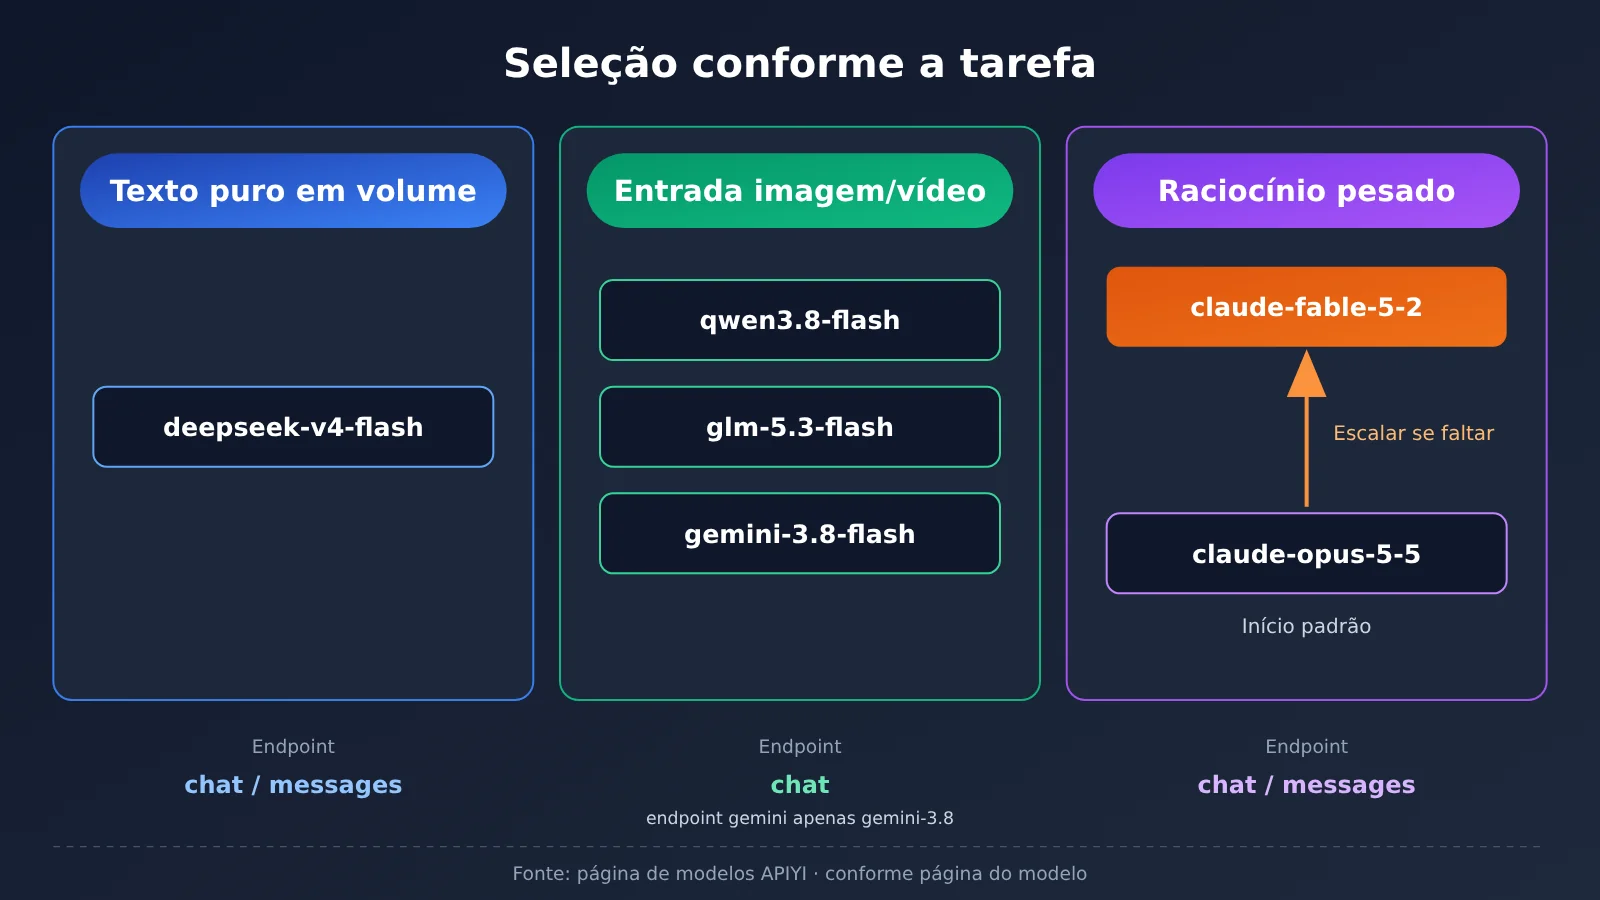
Depois de conferir modalidades, endpoints e preços, dá para partir para a aplicação por tarefa. A tabela abaixo traz uma ideia de seleção conforme a tarefa. Essa divisão de papéis é uma avaliação baseada nas informações das páginas dos modelos; as capacidades específicas devem ser conferidas na página do modelo.
| Tipo de tarefa | Características de entrada | Modelos candidatos | Critério de escolha |
|---|---|---|---|
| Editar código curto, processamento de texto com alta concorrência | Somente texto | deepseek-v4-flash |
A página do modelo diz que ele é focado em alta concorrência e baixa latência; suporta o endpoint messages |
| Ver capturas de tela e alterar código, ler gráficos | Texto + imagem | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
A modalidade de entrada inclui imagem e há suporte a compreensão visual |
| Análise de documentos e vídeos longos | Texto + vídeo | qwen3.8-flash, glm-5.3-flash, gemini-3.8-flash |
A modalidade de entrada inclui vídeo; a página do modelo qwen cita explicitamente esse tipo de cenário de alto volume |
| Entradas com áudio | Texto + áudio | gemini-3.8-flash |
Entre os modelos listados, apenas a página dele menciona entrada de áudio |
| Fórmulas, provas, tarefas técnicas de cadeia longa | Derivação pesada | claude-opus-5-5 → claude-fable-5-2 |
Nenhuma das quatro páginas dos modelos Flash trata computação científica como especialidade |
Seleção do modelo Flash para tarefas de codificação
Se a entrada tiver apenas código e texto explicativo, o modelo cuja modalidade corresponde é o deepseek-v4-flash. O texto original da página do modelo diz: “MoE com 284B de parâmetros totais e 13B ativados, com foco em alta concorrência e baixa latência” — isso é o que está na página do modelo, não dados medidos neste artigo. Ele suporta tanto o endpoint chat quanto o endpoint messages, sendo o que exige menos alterações ao conectar com clientes no estilo Anthropic. Vale observar que a coluna de saída estruturada está marcada como não suportada; se você depende de JSON Schema para restringir a saída, é preciso tratar isso de outra forma.
Se a tarefa de codificação incluir capturas de tela — por exemplo, “ajustar o front-end seguindo este design” — é preciso mudar para um Flash multimodal. A página do qwen3.8-flash diz textualmente que ele é “adequado para cenários de alto volume como codificação visual, análise de documentos e de vídeos longos”. A página do glm-5.3-flash informa 320B de parâmetros totais, 18B ativados, e pontuação 84.3 no Terminal-Bench 2.1. Esses dois conjuntos de números vêm da página do modelo, não são medições deste artigo, e também não significam que ele seja de forma abrangente superior aos outros modelos.
Seleção do modelo Flash para leitura de imagens e vídeos longos
Para ler gráficos, interpretar capturas de tela de PDF e analisar vídeos longos, a modalidade dos três modelos Flash multimodais corresponde. A diferença está principalmente nos endpoints e na coluna de recursos: o gemini-3.8-flash suporta adicionalmente entrada de áudio e execução de código, além de poder usar o endpoint gemini; o qwen3.8-flash e o glm-5.3-flash têm apenas o endpoint chat. No gemini-3.8-flash e no glm-5.3-flash, o raciocínio profundo vem habilitado por padrão — fique atento a isso em tarefas de alto volume sensíveis à latência.
Tarefas de derivação pesada não devem usar o modelo Flash por padrão
Aqui vale deixar claro onde fica o limite: o Flash não é totalmente incapaz de fazer cálculos, mas nenhuma das quatro páginas de modelo lista cálculo científico, provas ou física como especialidade — então não faz sentido entregar esse tipo de tarefa a ele por padrão. No anúncio de 2026-11-09, a Anthropic posicionou o Claude Fable 5.2 no topo dos trabalhos técnicos mais difíceis e recomendou que a maioria das tarefas de código e de conhecimento comece pelo Opus 5.5, subindo para o Fable apenas quando não bastar.
Os dois já estão disponíveis no APIYI, com IDs de modelo claude-opus-5-5 e claude-fable-5-2. O preço deles é visivelmente mais alto que o da faixa Flash, então o mais razoável é fazer uma divisão: tarefas de volume vão para o Flash, e só derivação de fórmulas, provas e análise técnica de cadeia longa sobem de nível.
Primeiros passos com os modelos Flash
Depois de definir o modelo, o processo de integração é simples. A APIYI oferece uma interface compatível com OpenAI, e uma única chave API permite chamar todos os modelos acima. A seguir, listo os pontos de configuração no estilo da documentação de ajuda.
Passo 1: configurar a base_url e os endpoints dos modelos Flash
- No cliente, defina a
base_urlcomohttps://api.apiyi.com/v1e preencha a chave API com o token que você criou no console. - Escolha o caminho conforme o modelo: todos os modelos podem usar
/v1/chat/completions; apenasdeepseek-v4-flash(e odeepseek-v4.1-flash, conforme indicado na tabela geral) pode usar/v1/messages; ogemini-3.8-flashtambém pode usar o endpoint Gemini. - No campo
modeldo corpo da requisição, informe o ID do modelo, por exemploqwen3.8-flash.
Passo 2: organizar as requisições dos modelos Flash conforme a modalidade de entrada
- Somente texto: em
messages, basta colocarrolee ocontentem texto; isso vale para odeepseek-v4-flash. - Com imagem: no formato chat, escreva
contentcomo um array, com itens de texto usandotypeigual atexte itens de imagem usandotypeigual aimage_url. Envie apenas para modelos que suportam entrada de imagem. - Ativar streaming: defina
streamcomotrue, o que é ideal para cenários de alta concorrência que precisam do primeiro token retornado rapidamente.
Passo 3: checklist antes de trocar de modelo Flash
- O novo modelo suporta o endpoint que você usa atualmente? Quem usa messages e migra para um Flash multimodal precisa passar a usar chat.
- O novo modelo suporta os recursos dos quais você depende? Por exemplo, a saída estruturada é marcada como não suportada no
deepseek-v4-flash. - Qual é o multiplicador do novo modelo no grupo de tokens atual?
🚀 Início rápido: recomendo primeiro usar o crédito gratuito de teste para novos usuários em APIYI apiyi.com, enviar o mesmo lote de entradas reais para duas ou três opções de modelos Flash, comparar a qualidade das saídas e o consumo de tokens, e só então decidir a troca definitiva. Basta alterar o campo
modelpara alternar entre os diferentes modelos.
Perguntas frequentes (FAQ)
Q1: O que significa “modelo Flash”?
Flash é o nome que os fabricantes dão a uma categoria de modelos mais voltada a alto volume e baixa latência — não é um padrão único. Os Flash de fabricantes diferentes variam bastante em modalidade de entrada, endpoint e suporte a recursos. Na hora de escolher, olhe a página do modelo, não apenas o nome.
Q2: deepseek-v4-flash e deepseek-v4.1-flash são intercambiáveis?
Não dá para assumir isso de saída. O v4.1 hoje tem só uma linha na tabela geral: entrada US$ 0,3, saída US$ 1,2, leitura de cache US$ 0,006, endpoints chat e messages. A quantidade de parâmetros, a janela de contexto e o “somente texto” do v4 não podem ser transportados para o v4.1. Antes de trocar, baseie-se na tabela geral e nas descrições de modelo que vierem depois.
Q3: Por que meu cliente no estilo Claude não consegue chamar o gemini-3.8-flash?
Porque os endpoints do `gemini-3.8-flash` são chat e gemini, não há messages. `qwen3.8-flash` e `glm-5.3-flash` também só têm chat. Se você precisa do endpoint messages, os únicos candidatos que sobram são os Flash da linha deepseek.
Q4: Por que o mesmo modelo cobra valores diferentes conforme o token?
Por causa do multiplicador de grupo, que é diferente. Por exemplo, o `gemini-3.8-flash` é 0,5× no grupo Gemini_Reverse e 1× no Default. Para entender a relação entre tokens e grupos, consulte a documentação do APIYI em docs.apiyi.com/faq/token-and-groups.md.
Q5: Como faço para chamar esses modelos Flash rapidamente via API?
Cadastre-se no APIYI (apiyi.com) e crie um token, defina o base_url como `https://api.apiyi.com/v1`, escolha o caminho chat ou messages conforme o modelo e preencha o `model` com o ID correspondente. Novos usuários têm cota gratuita de teste, então dá para validar primeiro em pequena escala.
Q6: Os modelos Flash conseguem fazer derivação matemática ou cálculo científico?
Dão conta de cálculos comuns, mas nenhuma das páginas de modelo lista cálculo científico, demonstrações ou física como especialidade. Para fórmulas, provas e tarefas técnicas de cadeia longa, a recomendação é começar pelo `claude-opus-5-5` e, se não bastar, subir para o `claude-fable-5-2`.
Q7: Dá para usar a pontuação do Terminal-Bench na página do modelo como base direta para escolher?
O texto original da página do `glm-5.3-flash` diz que a pontuação no Terminal-Bench 2.1 é 84,3 — isso é o que está escrito na página do modelo, não um teste feito por este artigo. Serve como sinal de referência, mas não significa que o modelo seja mais forte em todas as tarefas; no fim, ainda vale validar com seus próprios dados reais.
Principais conclusões para escolher modelos Flash
- Nome não é capacidade: modelos com “Flash” no nome têm modalidades de entrada e endpoints diferentes.
- Primeiro passo: veja a modalidade: para texto puro, escolha
deepseek-v4-flash; para imagem e vídeo, escolha um Flash multimodal. - Segundo passo: veja o endpoint: o endpoint
messagessó é suportado pela linha deepseek; a maioria dos Flash multimodais só usa o endpointchat. - Terceiro passo: confira a conta: veja preço de entrada, preço de saída e leitura de cache juntos, e depois aplique o multiplicador do grupo de tokens.
- Os números da página do modelo precisam indicar a fonte: número de parâmetros, Terminal-Bench e “adequado para codificação visual” são todos textos originais da página do modelo.
- Não use Flash como padrão para derivação pesada: provas de fórmulas começam com
claude-opus-5-5e, se não bastar, avance paraclaude-fable-5-2. - Valide em pequenos lotes antes de trocar: use a cota gratuita na APIYI para executar entradas reais e só então decida pela troca oficial.
Resumo
A escolha do modelo Flash se resume a uma frase: alinhe pela modalidade de entrada, não faça um corte único pelo nome.
- Comece pela página do modelo: confirme os tipos de entrada, endpoints e recursos suportados e elimine os modelos que não encaixam.
- Depois compare preços: veja preço de entrada, preço de saída e leitura de cache em conjunto com a proporção das suas chamadas, e aplique o multiplicador do grupo de tokens.
- Separe por tarefa: tarefas de alto volume, como ler gráficos e fazer alterações curtas em código, ficam com o Flash de modalidade compatível; tarefas de derivação pesada ficam com Claude Opus 5.5 ou Fable 5.2.
Preços e capacidades serão atualizados; na hora de escolher, use a página do modelo do dia. A recomendação é usar a mesma chave API na APIYI apiyi.com para comparar alguns modelos candidatos em pequenos lotes e, depois, decidir com base na sua fatura e na qualidade da saída.
📚 Referências
-
Anúncio da Anthropic — Claude Fable e Mythos 5.2: posicionamento do Fable 5.2 e recomendações de uso a partir do Opus 5.5
- Link:
anthropic.com/claude-fable-and-mythos-5-2 - Descrição: entenda a lógica de divisão de modelos para tarefas de raciocínio pesado
- Link:
-
Visão geral dos modelos Claude: lista oficial de modelos e instruções de uso da Anthropic
- Link:
platform.claude.com/docs/en/about-claude/models/overview - Descrição: recomendações de uso do Opus e do Fable em linha com o anúncio
- Link:
-
Tabela geral e páginas de modelos do APIYI: preços, grupos, endpoints e modalidades de entrada
- Link: central de documentação
models.mde páginas de cada modelo (deepseek-v4-flash,gemini-3-8-flash,qwen3-8-flash,glm-5-3-flash) - Descrição: fonte de todos os preços e dados de capacidade deste artigo; antes de escolher o modelo, consulte a versão mais recente
- Link: central de documentação
Autor: Equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI. Para mais informações sobre modelos e grupos, acesse a central de documentação em docs.apiyi.com