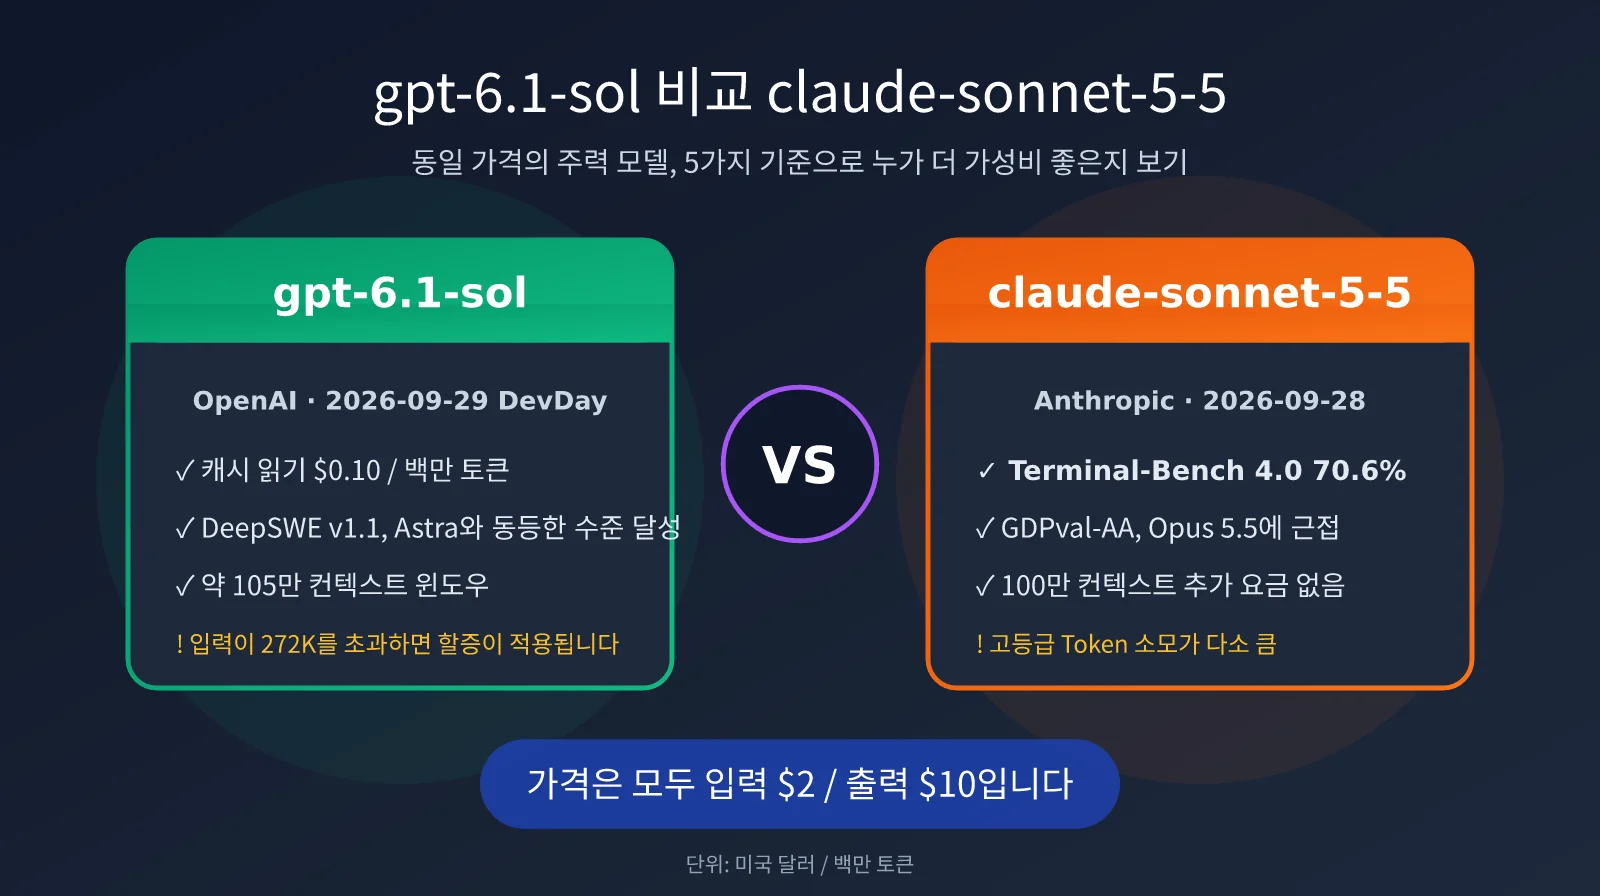
9월 28일 Anthropic이 claude-sonnet-5-5를 출시했고, 바로 다음 날 OpenAI는 DevDay에서 gpt-6.1-sol을 선보였어요. 두 회사의 차세대 주력 모델은 거의 동시에 출시됐으며, 가격표도 똑같습니다. 입력 $2, 출력 $10(토큰 100만 개당)이에요. 많은 개발자가 처음에는 “둘 다 저렴해졌으니 아무거나 고르면 되겠네”라고 생각하지만, 실제 프로덕션 환경에서는 단일 작업 비용, 긴 컨텍스트 과금, 에이전트 성능 측면에서 가격표만으로는 알 수 없는 차이가 훨씬 큽니다. 이 글에서는 5가지 관점에서 gpt-6.1-sol과 claude-sonnet-5-5의 실질적인 차이를 분석해 브랜드 선호나 계정 접근성에 흔들리지 않고, 사용 시나리오에 맞춰 합리적으로 선택할 수 있도록 도와드릴게요.
핵심 가치: 이 글을 읽고 나면 코딩 에이전트, 사무 문서, 긴 컨텍스트 검색, 고동시성 일괄 처리 등의 상황에서 gpt-6.1-sol과 claude-sonnet-5-5 중 무엇을 선택하고 어떻게 조합해야 하는지 명확히 알 수 있어요.
gpt-6.1-sol과 claude-sonnet-5-5 핵심 사양 한눈에 보기
먼저 흔한 오해 하나를 짚고 넘어갈게요. 엄밀히 말하면 두 모델 모두 정가가 인하된 것은 아닙니다. claude-sonnet-5-5는 Sonnet 5의 $2/$10 가격을 그대로 유지했고, gpt-6.1-sol 역시 이전 세대인 gpt-6-sol과 정가가 같습니다. 이른바 ‘가격 인하’는 두 가지 측면에서 나타나요. 첫째, 플래그십급 성능이 주력 모델 가격대로 내려왔습니다. gpt-6.1-sol은 gpt-6-astra 가격의 5분의 1이고, claude-sonnet-5-5는 Opus 5.5 가격의 절반이에요. 둘째, 숨은 비용이 줄었습니다. gpt-6.1-sol은 캐시 입력 가격이 $0.20에서 $0.10으로 절반으로 낮아졌고, claude-sonnet-5-5는 도구 호출 횟수를 줄여 단일 작업 비용을 최대 약 30% 절감할 수 있어요.
| 항목 | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| 출시일 | 2026-09-29(DevDay) | 2026-09-28 |
| 모델 ID | gpt-6.1-sol |
claude-sonnet-5-5 |
| 컨텍스트 윈도우 | 약 105만 토큰 | 100만 토큰 |
| 최대 출력 | 128K | 128K(Batch 베타에서는 최대 300K) |
| 추론 수준 | low / medium(기본값) / high / xhigh / max | low / medium / high(API 기본값) / xhigh / max |
| 사고 모드 | 수준별 조절 가능 | 적응형 사고, 비활성화 불가 |
| 동일 계열 플래그십 | gpt-6-astra($10/$50) | Claude Opus 5.5($4/$20) |
| 사용 가능 플랫폼 | APIYI apiyi.com, OpenAI 공식 API | APIYI apiyi.com, Anthropic 공식 API |
사양표에서 확인할 수 있는 핵심 차이는 두 모델의 기본 추론 수준이 다르다는 점입니다. gpt-6.1-sol의 기본값은 medium인 반면, claude-sonnet-5-5 API의 기본값은 high예요. 기본 파라미터만으로 두 모델을 비교하면 Sonnet에 한 단계 더 오래 ‘생각할’ 여유를 주는 셈이라, 토큰 사용량과 지연 시간도 당연히 같은 출발선에 있지 않게 됩니다. 공정하게 비교하려면 양쪽 모두 reasoning_effort를 명시적으로 지정하는 것이 좋습니다.
🎯 테스트 팁: 두 모델을 비교할 때는 반드시 동일한 추론 수준과 프롬프트를 고정하세요. APIYI apiyi.com에서 하나의 API 키로 gpt-6.1-sol과 claude-sonnet-5-5를 동시에 호출하고,
model파라미터만 바꾸면 A/B 테스트를 진행할 수 있습니다. 계정이나 네트워크 차이로 인한 교란 변수를 피할 수 있어요.
gpt-6.1-sol과 claude-sonnet-5-5의 5가지 핵심 차이
차이 1: 코딩 에이전트, claude-sonnet-5-5가 터미널 작업에서 앞서요
코딩은 두 모델이 가장 치열하게 경쟁하는 영역이지만, 각사가 공개한 벤치마크는 완전히 겹치지 않아 따로 살펴봐야 해요. claude-sonnet-5-5는 Terminal-Bench 4.0에서 공식 점수 70.6%를 기록했으며, Sonnet 5의 10.3%에서 크게 상승했습니다. 심지어 Opus 5.5의 66.4%도 넘어섰어요. Artificial Analysis의 독립 재평가에서는 64%를 기록해 Opus 5.5와 gpt-6-astra의 60%보다도 높았습니다. SWE-Bench Pro에서는 81.3%, CursorBench 4.0에서는 55.5%를 기록해 Opus 5.5 다음 순위에 올랐습니다.
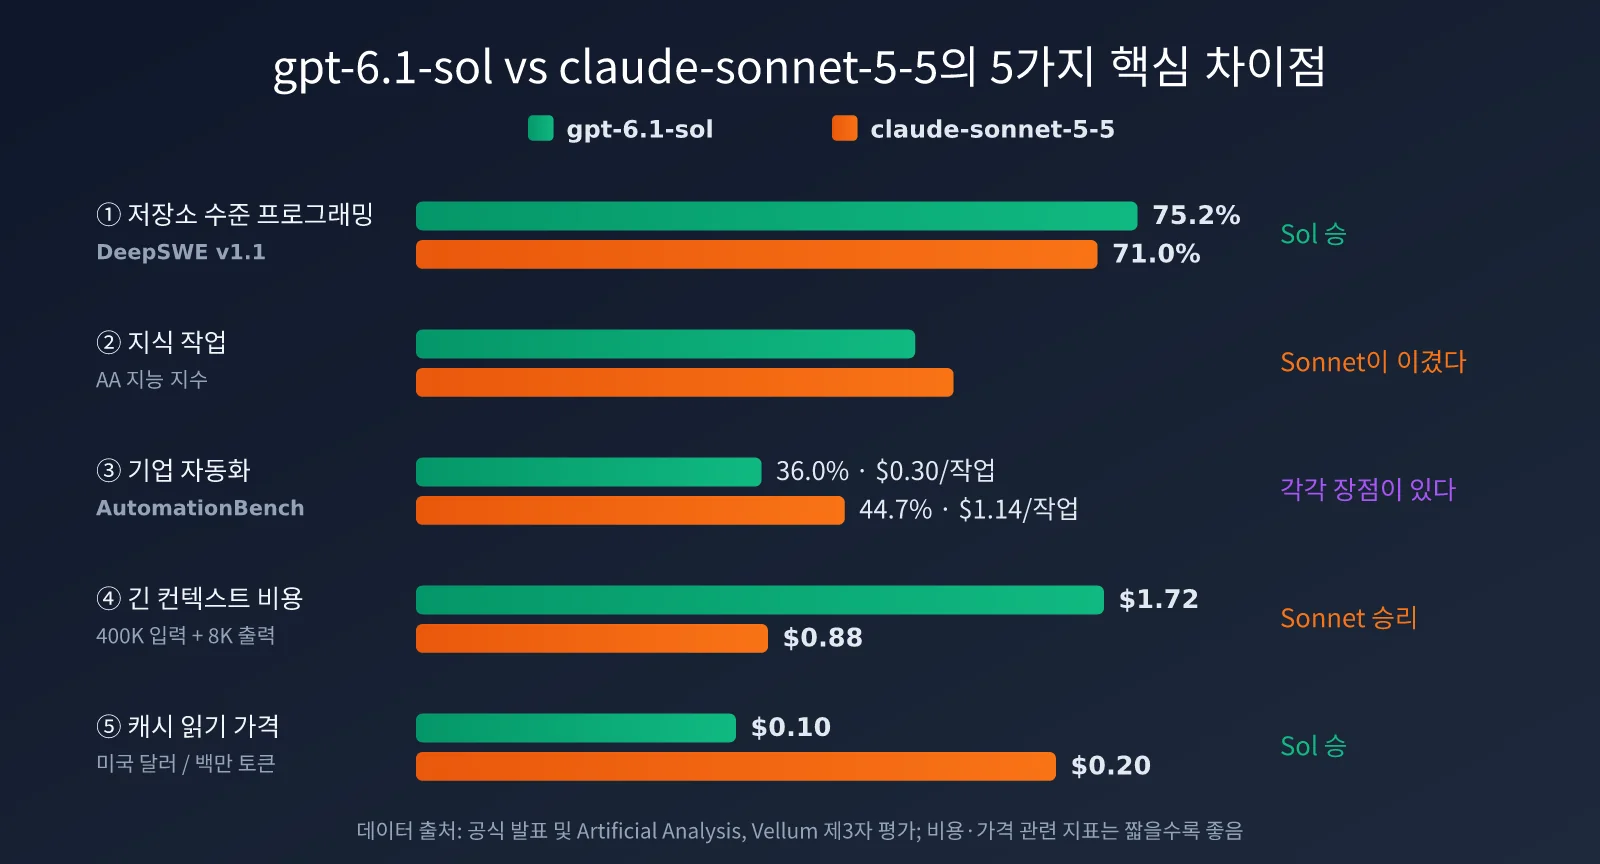
gpt-6.1-sol 측에서는 OpenAI가 DeepSWE v1.1에서의 75.2%를 핵심 성과로 내세웁니다. 이는 gpt-6-astra의 74.8%보다 약간 높고, 작업당 비용은 약 $1.50로 Astra의 5분의 1 미만이에요. 서드파티 집계에서는 claude-sonnet-5-5가 이 벤치마크에서 71.0%를 기록했습니다. 즉, 터미널 기반 에이전트 코딩에서는 claude-sonnet-5-5 쪽의 근거가 더 강하고, 리포지토리 수준 소프트웨어 엔지니어링 작업에서는 gpt-6.1-sol의 비용 효율이 더 돋보입니다.
차이 2: 지식 업무, claude-sonnet-5-5는 Opus에 근접해요
사무 중심의 지식 업무에서는 claude-sonnet-5-5의 성과가 매우 인상적입니다. GDPval-AA v2.1에서 1844점을 받아 Opus 5.5의 1846점과 사실상 동률이었고, AA-Briefcase에서는 1811점으로 역시 Opus를 바짝 추격했습니다. Artificial Analysis 지능 지수에서는 claude-sonnet-5-5가 56점으로 2위를 기록했으며, Opus 5.5보다 단 2점 낮았습니다. gpt-6.1-sol(max)은 52점이에요.
반면 gpt-6.1-sol은 문서 분석에서 강점이 있습니다. GDP.pdf 벤치마크에서 32.0%를 기록해 gpt-6-astra의 32.2%에 거의 근접했고, Opus 5.5의 28.8%를 앞섰습니다. 작업당 비용은 약 $0.38입니다. 기업 업무 프로세스 자동화 벤치마크인 AutomationBench에서는 claude-sonnet-5-5가 44.7%로 gpt-6.1-sol의 36.0%를 앞섰지만, 전자의 작업당 비용은 약 $1.14이고 후자는 $0.30에 불과합니다.
차이 3: 컴퓨터 조작, 두 모델 모두 실용 구간에 진입했어요
컴퓨터 조작(Computer Use) 측면에서 gpt-6.1-sol은 OSWorld 2.0에서 71.4%를 기록했습니다. gpt-6-astra의 73.5%와는 2.1%포인트 차이이며, 작업당 비용은 약 $1.30입니다. claude-sonnet-5-5는 OSWorld 2.1에서 80.1%를 기록해 Opus 5.5의 81.8%에 근접했습니다. 다만 두 OSWorld 버전은 테스트 세트가 다르므로 점수를 직접 비교할 수는 없어요. 그래도 두 모델 모두 데스크톱 애플리케이션을 안정적으로 조작할 수 있는 수준에 도달했다는 점은 분명합니다.
차이 4: 긴 컨텍스트 과금, gpt-6.1-sol에는 숨은 기준선이 있어요
가장 놓치기 쉽지만 청구 금액에 가장 큰 영향을 줄 수 있는 차이입니다. gpt-6.1-sol은 약 105만 Token의 컨텍스트 윈도우를 지원하지만, 한 번의 요청에서 입력이 272K Token을 넘으면 전체 요청의 입력과 캐시는 2배, 출력은 1.5배 요금이 적용됩니다. 반면 claude-sonnet-5-5의 100만 Token 컨텍스트 윈도우에는 긴 컨텍스트 할증이 없으며, 전체 구간에서 표준 요금이 적용됩니다. 업무에서 매뉴얼 전체나 코드 리포지토리 전체를 컨텍스트에 자주 넣는다면, 이 차이만으로도 모델 선택 결론이 달라질 수 있어요.
차이 5: Token 효율과 캐시, gpt-6.1-sol이 더 절약돼요
gpt-6.1-sol의 캐시 읽기 가격은 $0.10으로 claude-sonnet-5-5의 $0.20의 절반입니다. 에이전트 루프처럼 프리픽스가 반복되는 비율이 높은 환경에서는 이점이 뚜렷해요. 한편 claude-sonnet-5-5는 높은 추론 설정에서 Token 소비량이 큰 편입니다. Artificial Analysis는 max 설정에서 작업당 약 19.3만 Token을 출력하는 것으로 측정했는데, 이는 현재까지 측정된 수치 중 가장 높습니다. 독립 테스트에서도 API 기본 high 설정은 medium보다 출력 Token을 거의 두 배 더 소비했지만, 품질 향상은 뚜렷하지 않은 것으로 나타났습니다.
| 벤치마크 / 지표 | gpt-6.1-sol | claude-sonnet-5-5 | 우세 |
|---|---|---|---|
| Terminal-Bench 4.0(공식) | 미공개 | 70.6% | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75.2% | 71.0% | gpt-6.1-sol |
| GDPval-AA v2.1 | 미공개(이전 세대 gpt-6-sol은 1487) | 1844 | claude-sonnet-5-5 |
| GDP.pdf 문서 분석 | 32.0% | 미공개 | gpt-6.1-sol |
| AutomationBench | 36.0%(작업당 약 $0.30) | 44.7%(작업당 약 $1.14) | 품질은 Sonnet, 비용은 Sol |
| AA 지능 지수 | 52 | 56 | claude-sonnet-5-5 |
| 캐시 읽기 가격 | $0.10 / 100만 | $0.20 / 100만 | gpt-6.1-sol |
💡 데이터 안내: 위 벤치마크는 OpenAI, Anthropic의 공식 발표와 Artificial Analysis, Vellum 등 서드파티 평가를 바탕으로 합니다. 기관마다 테스트 버전과 추론 설정이 다르므로, 실제 업무 샘플로 직접 비교 테스트를 진행하는 편이 어떤 순위표보다 더 참고할 만합니다.
gpt-6.1-sol과 claude-sonnet-5-5의 실제 비용 비교
표시 가격이 같다고 실제 청구 금액까지 같은 것은 아니에요. 아래에서는 세 가지 대표적인 워크로드를 기준으로 요청 1회당 비용을 추산해 봤습니다(캐시 쓰기 제외, 공식 표시 가격 기준). 차이가 어디에서 발생하는지 한눈에 확인할 수 있어요.
| 워크로드 시나리오 | 요청 구성 | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| 에이전트 루프(높은 캐시 적중률) | 입력 100K(캐시 90% 적중) + 출력 5K | 약 $0.079 | 약 $0.088 |
| 일반 대화 | 입력 5K + 출력 1K | 약 $0.020 | 약 $0.020 |
| 초장문 컨텍스트 검색 | 입력 400K(캐시 없음) + 출력 8K | 약 $1.72(할증 적용) | 약 $0.88 |
| 일괄 처리(Batch) | 표시 가격의 50% | $1 / $5 | $1 / $5 |
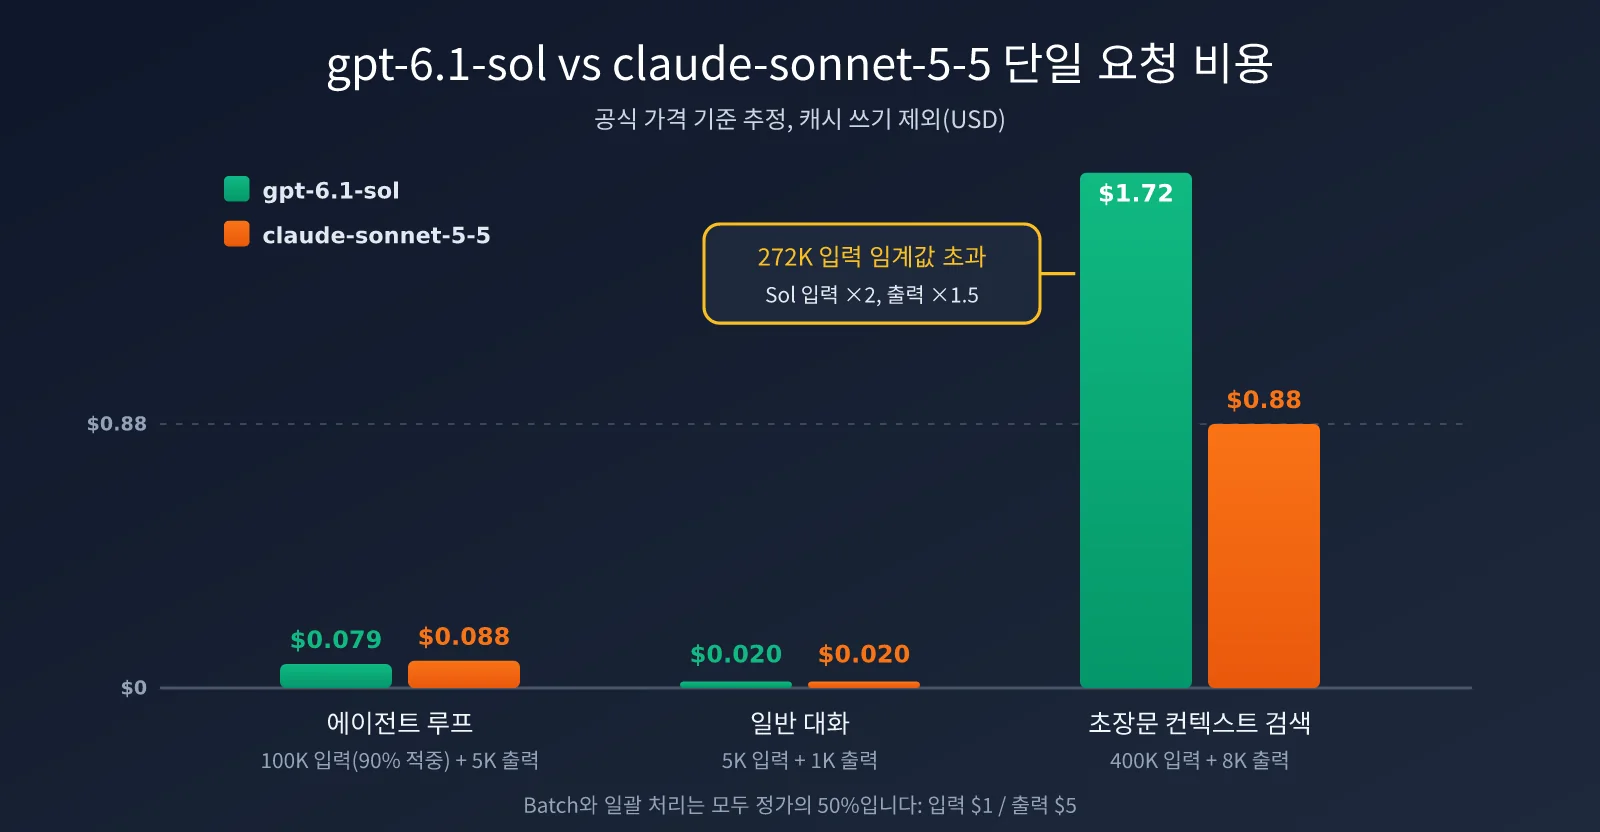
결론은 명확해요. 접두사 반복률이 높은 에이전트 루프에서는 gpt-6.1-sol이 더 저렴한 캐시 읽기 가격 덕분에 약 10% 유리합니다. 일반 대화에서는 두 모델의 비용이 거의 같고요. 반면 요청당 입력이 272K를 넘으면 claude-sonnet-5-5의 비용은 gpt-6.1-sol의 절반 수준으로 내려갑니다.
여기에 Token 효율도 함께 고려해야 해요. claude-sonnet-5-5를 high 또는 max 단계로 실행하면 실제 출력 Token이 두 배까지 늘어날 수 있어, 긴 컨텍스트에서의 비용 이점이 상쇄될 수 있습니다. 따라서 Sonnet을 잘 활용하려면 추론 단계를 제어하는 것이 핵심이에요.
같은 코드로 두 모델을 빠르게 비교하기
OpenAI 호환 인터페이스를 이용하면 model 파라미터만 바꿔 두 모델을 나란히 테스트할 수 있어요. 아래는 가장 간단한 예시입니다.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스, 두 모델이 하나의 Key를 공유
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # 동일한 단계를 고정해 공정하게 비교
        messages=[{"role": "user", "content": "为这个函数补充单元测试:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
펼쳐서 보기: 소요 시간 및 비용 통계를 포함한 전체 비교 스크립트
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 통합 인터페이스
)

# 백만 Token당 가격: 입력, 캐시 읽기, 출력
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "用 Python 实现一个带过期时间的 LRU 缓存,并写出测试",
    "阅读以下需求,输出数据库表结构设计与索引建议:订单、用户、优惠券",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 빠른 시작: 아직 Anthropic 계정이 없거나 해외 결제 및 휴대폰 인증에서 막혔다면, APIYI apiyi.com에서 바로 가입해 테스트 크레딧을 받을 수 있어요. 하나의 Key로 gpt-6.1-sol과 claude-sonnet-5-5를 모두 호출할 수 있어, 두 공식 계정을 각각 개설하는 번거로움을 줄일 수 있습니다.
gpt-6.1-sol과 claude-sonnet-5-5의 사용 시나리오 추천
업무마다 품질, 비용, 지연 시간에 두는 비중이 달라요. 아래에서 일반적인 시나리오별 추천을 확인해 보세요.
| 비즈니스 시나리오 | 추천 모델 | 핵심 이유 |
|---|---|---|
| 터미널 기반 코딩 에이전트(Claude Code 계열) | claude-sonnet-5-5 | Terminal-Bench 4.0에서 앞서며, 도구 호출 횟수가 더 적음 |
| 저장소 단위 코드 수정, Codex 워크플로 | gpt-6.1-sol | DeepSWE에서 Astra와 동률, 작업당 비용 약 $1.50 |
| 초장문 문서 / 전체 저장소 코드 분석(>272K) | claude-sonnet-5-5 | 긴 컨텍스트 할증이 없고, Sol 대비 비용이 약 절반 |
| 고동시성 고객 상담, RAG 질의응답(높은 캐시 적중률) | gpt-6.1-sol | 캐시 읽기 $0.10, 접두사 재사용이 많을수록 비용 절감 |
| 보고서 작성, 표 작업 및 오피스 지식 업무 | claude-sonnet-5-5 | GDPval-AA에서 Opus 5.5와 거의 동률 |
| PDF 문서 파싱, 정보 추출 | gpt-6.1-sol | GDP.pdf에서 Astra와 동률, 작업당 약 $0.38 |
| 보안 연구, 침투 테스트 보조 | gpt-6.1-sol | Sonnet 5.5는 내장된 사이버 보안 보호 기능으로 거절률이 높아짐 |
gpt-6.1-sol을 선택하기 좋은 대표 시나리오
gpt-6.1-sol은 비용에 민감하고, 요청량이 많으며, 접두사 반복률이 높은 업무에 가장 잘 맞아요. 예를 들어 지능형 고객 상담, 지식 베이스 질의응답, 대량 데이터 정제처럼 시스템 프롬프트와 검색 컨텍스트를 많이 재사용하는 경우가 대표적입니다. 캐시 읽기 가격이 $0.10이므로 재사용 비율이 높을수록 이점도 계속 커져요.
환각률도 눈에 띄게 개선됐습니다. 낮은 추론 단계에서 사실 오류율은 이전 세대의 11.4%에서 7.7%로 낮아졌어요. 따라서 low 또는 medium 단계로 대량의 가벼운 작업을 처리하기에 적합합니다. 또한 OpenAI는 gpt-6.1-sol에 Ultrafast 단계를 곧 제공할 예정인데, 생성 속도는 최대 초당 약 300 Token이며 가격은 표준 단계의 6배입니다. 실시간 상호작용 제품에서는 선택지가 될 수 있어요.
claude-sonnet-5-5를 선택하기 좋은 대표 시나리오
claude-sonnet-5-5는 작업이 복잡하고, 컨텍스트가 매우 길며, 한 번에 성공할 확률이 중요한 업무에 더 적합합니다. 에이전트 작업에서는 Sonnet 5가 12~13회의 도구 호출로 처리하던 일을 보통 약 3회 호출만으로 끝낼 수 있고, 출력 속도도 이전 세대보다 30% 이상 빨라졌어요. 법무 검토, 코드베이스 마이그레이션, 장문 보고서 작성처럼 대량의 자료를 한 번에 컨텍스트에 넣어야 하는 작업에서는 추가 비용 없는 100만 컨텍스트가 특히 유리합니다.
다만 claude-sonnet-5-5는 Sonnet 5와 비교해 몇 가지 인터페이스 호환성 변경이 있어요. 사고 모드를 끌 수 없고, 도구를 강제로 지정하던 tool_choice: "tool" 옵션도 제거됐습니다. 기존 코드가 이런 동작에 의존하고 있다면, 마이그레이션 전에 반드시 회귀 테스트를 진행하세요.
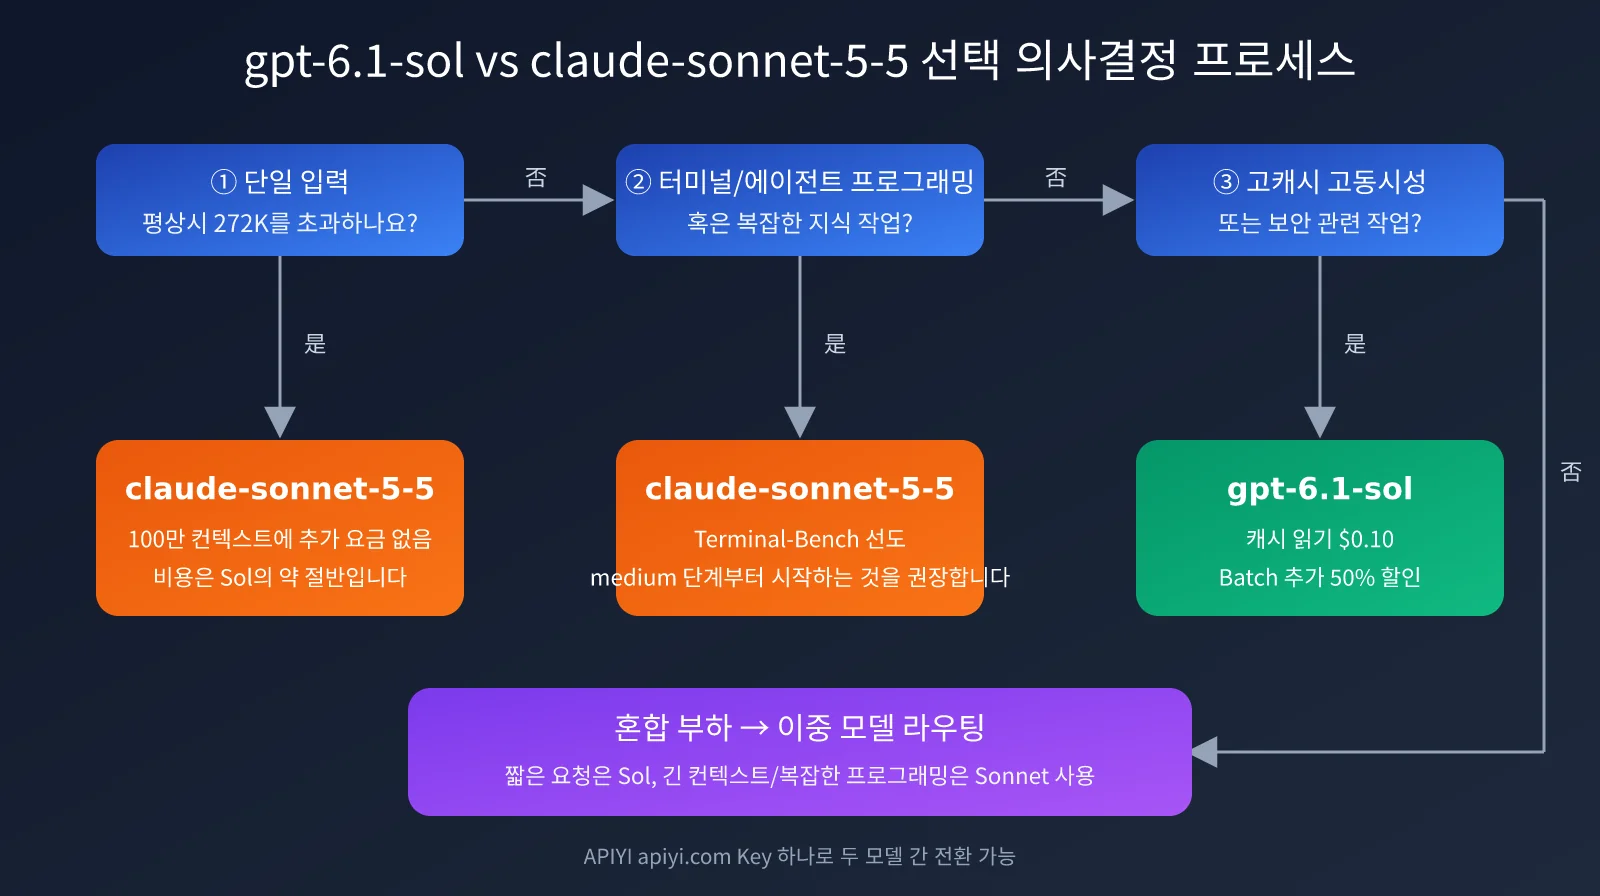
🎯 아키텍처 제안: 두 모델 중 하나만 골라야 하는 것은 아니에요. APIYI apiyi.com으로 간단한 모델 라우팅을 구성해 보세요. 짧은 요청과 캐시 적중률이 높은 트래픽은 gpt-6.1-sol로 보내고, 초장문 컨텍스트 및 복잡한 프로그래밍 작업은 claude-sonnet-5-5로 보내면 됩니다. 하나의 OpenAI 호환 인터페이스에서 필요에 따라 전환할 수 있어요.
gpt-6.1-sol과 claude-sonnet-5-5 비교를 위한 의사결정 가이드
앞선 분석을 실행 가능한 의사결정 단계로 정리하면 다음과 같아요.
- 먼저 입력 길이를 확인하세요: 일반적인 요청이 272K Token을 초과한다면 claude-sonnet-5-5를 우선 선택하고, 아니라면 다음 단계로 넘어가세요.
- 그다음 작업 유형을 보세요: 터미널/에이전트 코딩이나 복잡한 지식 작업에는 claude-sonnet-5-5가 더 적합하고, 저장소 수준의 코드 수정과 PDF 파싱에는 gpt-6.1-sol이 더 잘 맞아요.
- 이후 트래픽 구조를 살펴보세요: 캐시 적중률이 높고 동시성이 큰 서비스라면, gpt-6.1-sol의 비용 우위는 규모가 커질수록 더욱 커집니다.
- 마지막으로 추론 수준을 조정하세요: 어떤 모델을 선택하든 우선 medium부터 테스트하세요. 특히 claude-sonnet-5-5는 API 기본값인 high를 바로 사용하지 않도록 주의해야 해요. Token 사용량이 두 배로 늘어날 수 있습니다.
| 우선순위 | 추천 선택 | 대안 전략 |
|---|---|---|
| 품질 우선, 충분한 예산 | claude-sonnet-5-5(medium/high) | 어려운 작업만 Opus 5.5로 업그레이드 |
| 비용 우선, 대규모 트래픽 | gpt-6.1-sol(low/medium) | 실시간이 아닌 작업은 Batch로 50% 할인 적용 |
| 속도 우선, 실시간 상호작용 | gpt-6.1-sol(Ultrafast 출시 후) | claude-sonnet-5-5 low 수준 |
| 안정성 우선, 단일 장애점 방지 | 듀얼 모델 라우팅 | 한쪽이 속도 제한에 걸리면 다른 쪽으로 자동 전환 |
브랜드 선호도나 접근 가능성은 기술 선택의 결정 요인이 되어서는 안 돼요. Claude 공식 계정은 지역, 결제 수단 등에 대한 요구 사항이 더 엄격해서 실제로 진입 장벽이 높습니다. 하지만 이는 모델 성능이 아니라 연결 계층의 문제예요. 통합 API 플랫폼에 연결 계층을 맡기면 작업 성능과 비용만을 기준으로 모델을 선택할 수 있습니다.
자주 묻는 질문
Q1: gpt-6.1-sol과 claude-sonnet-5-5는 정말 모두 가격이 인하됐나요?
표시 가격 자체는 변하지 않았으며, 두 모델 모두 $2/$10을 유지하고 있습니다. 실제 ‘가격 인하’의 의미는 다릅니다. gpt-6.1-sol은 gpt-6-astra에 가까운 성능을 5분의 1 가격으로 제공하고, 캐시 읽기 비용도 $0.20에서 $0.10으로 낮췄어요. claude-sonnet-5-5는 Opus 가격의 절반으로 Opus 5.5에 가까운 성능을 제공하며, 도구 호출 횟수를 줄여 작업당 비용을 최대 약 30% 절감합니다. 따라서 두 모델을 비교할 때는 단가보다 작업 1건당 총비용을 봐야 해요.
Q2: Anthropic 계정이 없는데 claude-sonnet-5-5는 어떻게 호출하나요?
Anthropic 공식 계정은 가입 가능 지역, 휴대폰 번호, 결제 수단에 모두 조건이 있습니다. 개인 개발자나 국내 팀은 이 단계에서 막히는 경우가 많아요. 간단한 방법은 APIYI apiyi.com을 통해 호출하는 것입니다. 이 플랫폼은 OpenAI 호환 인터페이스를 제공하므로 base_url을 https://api.apiyi.com/v1로 바꾸고, model을 claude-sonnet-5-5로 설정하면 됩니다. 그 밖의 비즈니스 코드는 수정할 필요가 없어요.
Q3: gpt-6.1-sol의 105만 컨텍스트 윈도우를 끝까지 사용해도 되나요?
사용할 수는 있지만 과금에 주의해야 합니다. 단일 입력이 272K Token을 초과하면 요청 전체의 입력 및 캐시 가격은 두 배가 되고, 출력 가격은 1.5배가 됩니다. 비즈니스상 초장문 컨텍스트가 꼭 필요하다면 먼저 검색 기반 압축을 적용하거나, 이 부분의 요청을 장문 컨텍스트 할증이 없는 claude-sonnet-5-5로 라우팅하는 것을 권장해요.
Q4: claude-sonnet-5-5가 가끔 예상보다 비싼 이유는 무엇인가요?
주된 원인은 추론 수준입니다. API 기본 수준이 high이고 사고 모드도 끌 수 없어서, 단순한 작업에서도 불필요한 사고 Token이 많이 생성될 수 있어요. 독립 테스트에 따르면 medium 수준은 Sonnet 5와 Token 사용량이 비슷하면서도 성능은 더 좋았습니다. 따라서 일상적인 작업에서는 명시적으로 medium으로 설정하는 것을 권장합니다.
Q5: 코딩 작업에서는 결국 어떤 모델을 선택해야 하나요?
Claude Code 같은 터미널형 에이전트로 다단계 개발을 주로 한다면 claude-sonnet-5-5의 Terminal-Bench 성적이 더 설득력 있습니다. 반면 저장소 수준의 버그 수정이 주력이고 Codex 워크플로에서 사용한다면, gpt-6.1-sol은 더 낮은 작업당 비용으로 gpt-6-astra와 비슷한 수준에 도달했어요. 팀 여건이 된다면 두 모델을 모두 연결하고 작업 유형에 따라 분기하는 방식이 가장 안정적입니다.
정리
gpt-6.1-sol과 claude-sonnet-5-5를 비교했을 때 절대적인 승자는 없어요. claude-sonnet-5-5는 에이전트 코딩, 지식 작업, 지능 지수에서 더 강하며 100만 토큰 컨텍스트에도 추가 요금이 없어요. 반면 gpt-6.1-sol은 캐시 가격, 저장소 수준 코드 수정, 문서 파싱, 단일 작업 비용 측면에서 더 유리해 대규모·고재사용 프로덕션 트래픽에 적합해요. 두 모델의 정가는 같지만, 실제 청구 비용 차이는 입력 길이, 캐시 적중률, 추론 등급이라는 세 가지 변수에서 발생해요.
실무에서는 다음 3단계로 진행하면 돼요. 먼저 이 글의 의사결정 흐름으로 주력 모델을 정하고, 비교 스크립트로 실제 작업에서 동일한 추론 등급을 고정한 A/B 테스트를 진행하세요. 마지막으로 작업 유형별 이중 모델 라우팅을 구성해 각 요청이 가장 비용 효율적인 모델로 전달되도록 하면 됩니다.
Anthropic과 OpenAI의 공식 계정을 각각 개설하는 절차를 건너뛰고 싶다면, APIYI apiyi.com을 통해 gpt-6.1-sol과 claude-sonnet-5-5를 통합 호출하는 방법을 추천해요. 이 플랫폼은 OpenAI 공식 형식과 호환되는 인터페이스를 제공하며, 하나의 Key로 두 모델을 자유롭게 전환할 수 있어 모델 선정 테스트와 프로덕션 환경의 멀티모델 라우팅에 특히 적합합니다.
참고 자료:
– OpenAI 공식 발표: GPT-6.1 Sol 소개 openai.com/index/introducing-gpt-6-1-sol
– Anthropic 공식 발표: Claude Sonnet 5.5 소개 anthropic.com/claude-sonnet-5-5
– Artificial Analysis 지능 지수 평가: artificialanalysis.ai
– Vellum의 GPT-6.1 Sol 벤치마크 해설: vellum.ai/blog
– The Decoder의 Claude Sonnet 5.5 보도: the-decoder.com
저자 소개: APIYI 기술팀은 AI 대규모 언어 모델 API 연동과 엔지니어링 실무에 집중하고 있어요. gpt-6.1-sol과 claude-sonnet-5-5의 모델 선정 및 비용 최적화 경험은 APIYI apiyi.com을 통해 자유롭게 공유해 주세요.