작성자 주: OpenAI는 2026년 11월 2일 내부 Git 백엔드 Pando를 공개했어요. 이 글에서는 ‘10주 만에 프로덕션에 도입’했다는 사실을 중심으로 사람과 AI의 역할 분담, 테스트 체계, 마이그레이션 과정을 살펴보고, 일반 팀도 참고할 수 있는 에이전트 엔지니어링 방법을 정리해요.
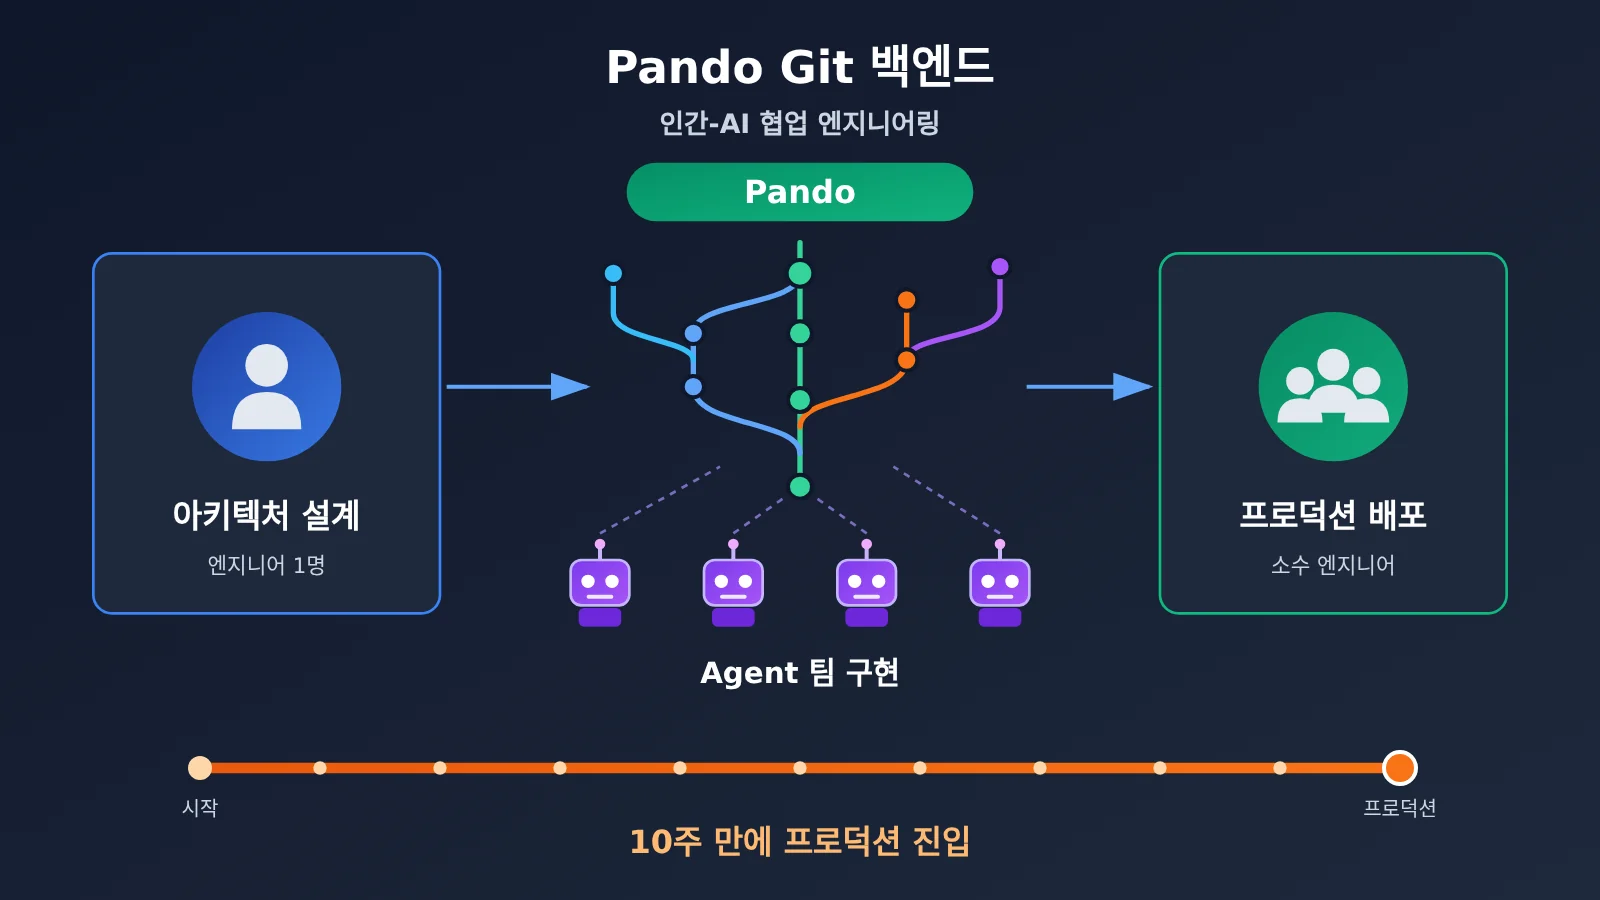
2026년 11월 2일, OpenAI는 기술 글 《Scaling Git at OpenAI》를 통해 모노레포의 모든 개발 활동을 지원하는 새 Git 백엔드 Pando를 공개했어요. Pando는 착수부터 프로덕션 트래픽을 처리하기까지 약 10주가 걸렸어요. 핵심 아키텍처는 엔지니어 한 명이 설계했고, 구현은 여러 에이전트 팀이 맡았으며, 배포는 소수의 엔지니어가 완료했어요. 이런 사실은 ‘한 사람이 AI를 지휘해 인프라를 만들었다’는 이야기로 포장되기 쉬워요. 하지만 OpenAI가 공개한 세부 내용을 보면, 실제로 중요한 역할을 한 것은 체계적인 엔지니어링 제약과 검증 체계였어요.
이 글은 AI 코딩 신화를 전하는 글이 아니에요. OpenAI가 공식적으로 공개한 사실과 아직 공개하지 않은 정보를 구분해 살펴봐요. 예를 들어 투입 인원 규모, 토큰 비용, 작업 기록, 사람이 코드를 직접 수정한 비율은 공개되지 않았어요.
이 글에서 얻을 수 있는 것: Pando를 구축한 이유와 Codex 에이전트 팀이 맡은 역할, 에이전트가 인프라 개발에 참여할 수 있도록 한 검증 방법, 그리고 이 방법을 자신의 프로젝트에 적용하는 방법을 알아볼 수 있어요.
Pando 핵심 정보 한눈에 보기: Codex Agent 팀이 만들어낸 결과
먼저 공식적으로 확인된 정보를 표로 정리했어요. Pando는 Git과 호환되는 서버 측 백엔드예요. 새로운 버전 관리 프로토콜도, GitHub를 직접 대체하는 서비스도 아닙니다.
| 정보 항목 | 상세 내용 |
|---|---|
| 발표일 | 2026년 11월 2일, 공식 글 《Scaling Git at OpenAI》 |
| 작성자 | Aaron Friel, Taylor Blau, Ted Nyman(OpenAI 기술 담당자) |
| 프로젝트 기간 | 시작부터 프로덕션 투입까지 약 10주, 2026년 4월부터 프로덕션 트래픽 처리 |
| 구현 언어 | 서버 측은 주로 Rust로 처음부터 구축했으며, 기존 시스템의 의존성을 이어받지 않도록 했어요 |
| 사람과 AI의 역할 분담 | 엔지니어 한 명이 핵심 아키텍처를 설계하고, 여러 Agent 팀이 구현했으며, 소수의 엔지니어가 배포했어요 |
| 프로덕션 성과 | Push 지연 시간의 중앙값이 약 80% 감소했고, 하루에 약 1 PB의 Git 데이터를 전송해요 |
| 공개 상태 | 2026-11-03 기준, 서버 소프트웨어, API, 요금은 공개되지 않았어요 |
OpenAI가 Codex Agent로 Git 백엔드를 다시 구축한 이유
Pando는 코드 커밋 규모가 폭발적으로 늘어나면서 시작됐어요. 공식 그래프는 2024년 1분기에 메인 브랜치에 병합된 Commit 수를 기준으로 이후 분기별 증가율을 보여줘요. 아래 표에는 일부 시점만 추렸어요.
| 분기 | 2024 Q1 대비 Commit 증가율 | 설명 |
|---|---|---|
| 2024 Q4 | +98% | 거의 두 배 |
| 2025 Q4 | +264% | 기존 시스템이 수요를 따라가기 어려워지기 시작 |
| 2026 Q1 | +432% | Pando 프로젝트 진행 단계 |
| 2026 Q3 | +1,378% | 기준 시점의 약 14.78배 |
| 2026 Q4 | +2,442% | 공식 예측치이며, 완료된 분기의 실적이 아님 |
여기서 꼭 구분해야 할 점이 있어요. Commit 수는 코드 줄 수, PR 수, 개발 생산성과 같지 않아요. 따라서 이를 근거로 “코드량이 25배 늘었다”거나 “Codex가 엔지니어의 효율을 25배 높였다”고 말할 수는 없어요. OpenAI는 Codex 덕분에 엔지니어가 더 많은 작업을 동시에 진행할 수 있게 됐고, 그 결과 병렬 브랜치, Push, 병합, CI 작업, Fetch와 Clone 요청도 늘어났다고 설명해요.
2025년 4분기 무렵에는 기존 시스템에서 Push와 Fetch가 느려지고 병합이 실패하는 등의 문제가 발생했어요. 신뢰성이 90% 아래로 떨어질 때도 있었어요. 다만 이 지표의 집계 기준과 시간별 추이는 공개되지 않았기 때문에, “제출의 10% 이상이 실패했다”는 뜻으로 해석해서도 안 돼요.
Pando 기술 아키텍처의 4가지 핵심 설계
Pando는 Git을 버린 게 아니라 백엔드의 저장, 참조 업데이트, 데이터 전달 방식을 새로 설계했어요. 이 설계를 살펴보면 “사람이 어떤 중요한 트레이드오프를 선택했는지” 이해할 수 있어요.
- 브랜치별 독립 업데이트: 전체 저장소에 대해 단일 시점의 일관된 스냅샷을 유지하는 대신, 각 브랜치가 독립적으로 버전을 관리해요. 같은 Ref를 수정하는 요청만 조율하며 인과적 일관성 모델을 사용해요. 그 대신 여러 브랜치를 한 번에 읽을 때 각 브랜치가 서로 다른 시점의 상태일 수 있어요.
- Packfile 저장 및 재사용: Push할 때마다 수신한 Packfile을 변경 불가능한 데이터로 Blob Store에 저장해요. Fetch할 때는 클라이언트의 have/want에 따라 기존 Packfile을 선택하고, Git의 packfile-uri 메커니즘으로 다운로드 주소를 전달해요. 클라이언트마다 반복해서 패키징하고 압축할 필요가 없어요.
- 지역 캐시 Express: 여러 지역에 클러스터와 로컬 캐시를 배포하고, 일관성 해싱으로 요청을 분배해요. Packfile 캐시 적중률은 99%를 넘어요. 이는 Git 데이터 캐시로, 대규모 언어 모델 API의 Prompt Caching과는 달라요.
- 백그라운드 계층형 Compaction: LSM Tree처럼 작은 Packfile을 단계적으로 병합해 연속된 버전 구간을 포괄하는 큰 집합을 만들어요. 현재 모노리포에서는 L4 수준까지 사용하고 있어요.
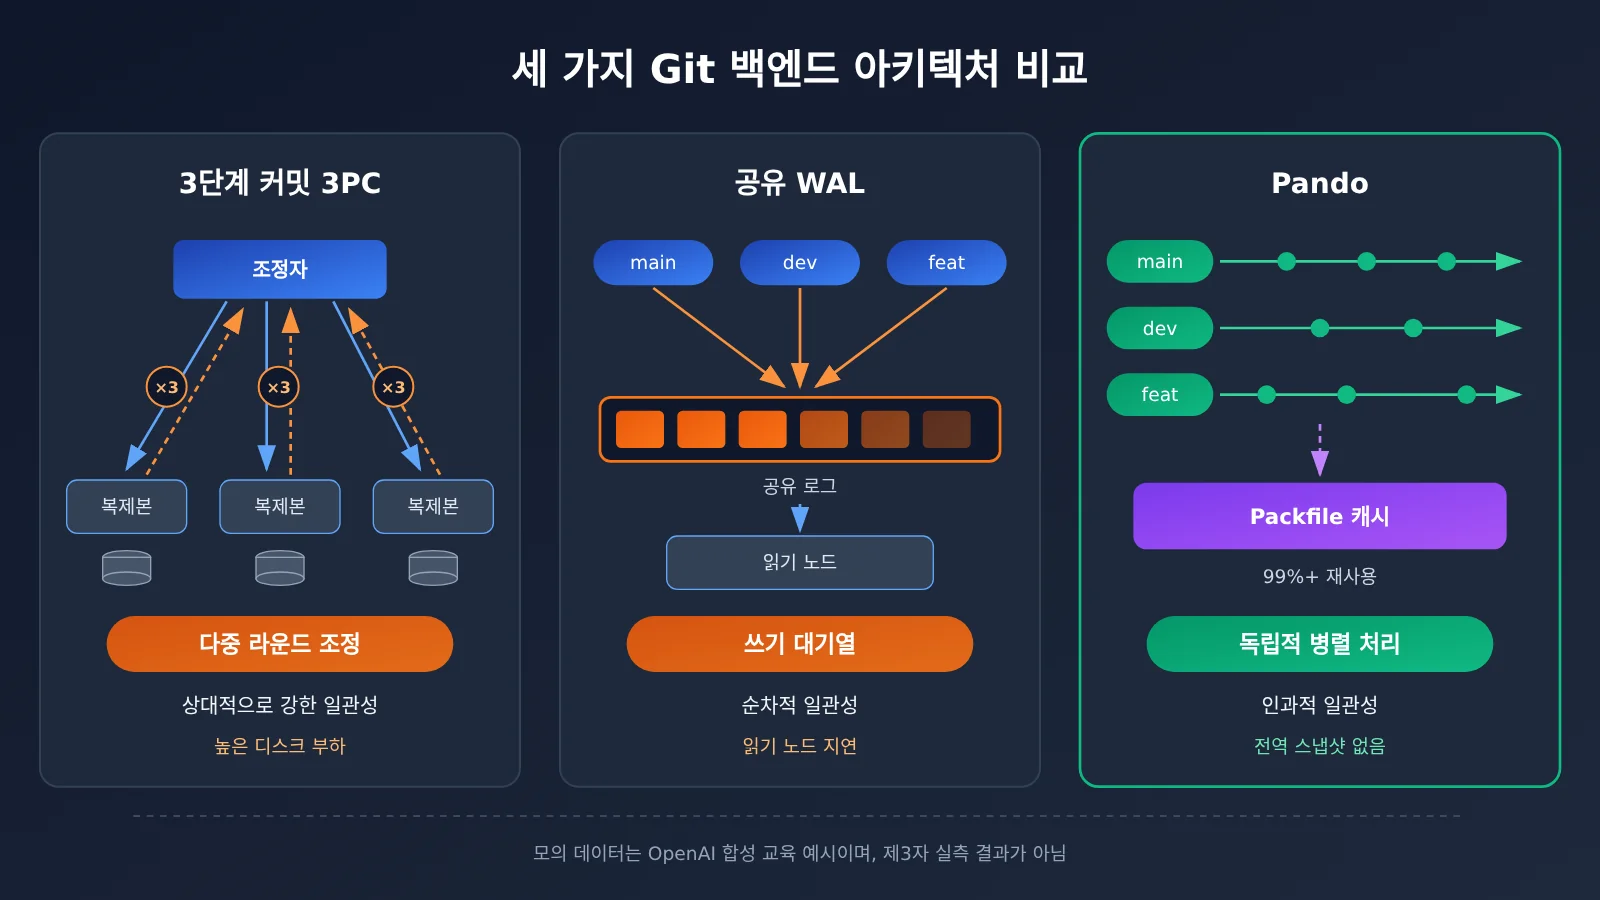
공식 자료에서는 세 가지 아키텍처를 비교하고, 클라이언트 1,000개가 총 10,000회 Push하는 시뮬레이션도 진행했어요. 이는 OpenAI가 만든 교육용 합성 시뮬레이션이며, 제3자의 독립적인 벤치마크는 아니에요.
| 아키텍처 | 쓰기 방식 | 일관성 | 주요 병목 |
|---|---|---|---|
| 3단계 커밋 3PC | 여러 전체 복제본이 쓰기를 조율 | 비교적 강함 | 여러 차례의 조율과 디스크 부하로 동시 쓰기 속도 저하 |
| 공유 WAL | 모든 업데이트가 하나의 로그를 두고 경쟁 | 순차 일관성 | 쓰기 속도가 적용 속도보다 빠를 때 읽기 노드가 뒤처짐 |
| Pando | 각 Ref가 독립적인 원자적 트랜잭션 사용 | 인과적 일관성 | 전체 저장소의 단일 시점 스냅샷 포기 |
공식적으로 공개된 프로덕션 데이터도 있어요. 시간당 Packfile 전달량은 최고 57 TB를 넘었고, 전체 바이트의 99% 이상이 로컬 디스크 캐시에서 제공됐어요. 표준 클라우드 가상 머신에서는 Clone과 Fetch가 10 Gbps 링크를 모두 활용할 수 있었어요. Push의 메타데이터 읽기·쓰기는 O(1), Fetch 계획 단계의 메타데이터 읽기는 O(log Δ)예요. 이 복잡도는 종단 간 네트워크 소요 시간이 아니라 메타데이터 작업에 대한 설명이에요.
Codex Agent 팀은 어떻게 역할을 나눠 Pando를 완성했을까?
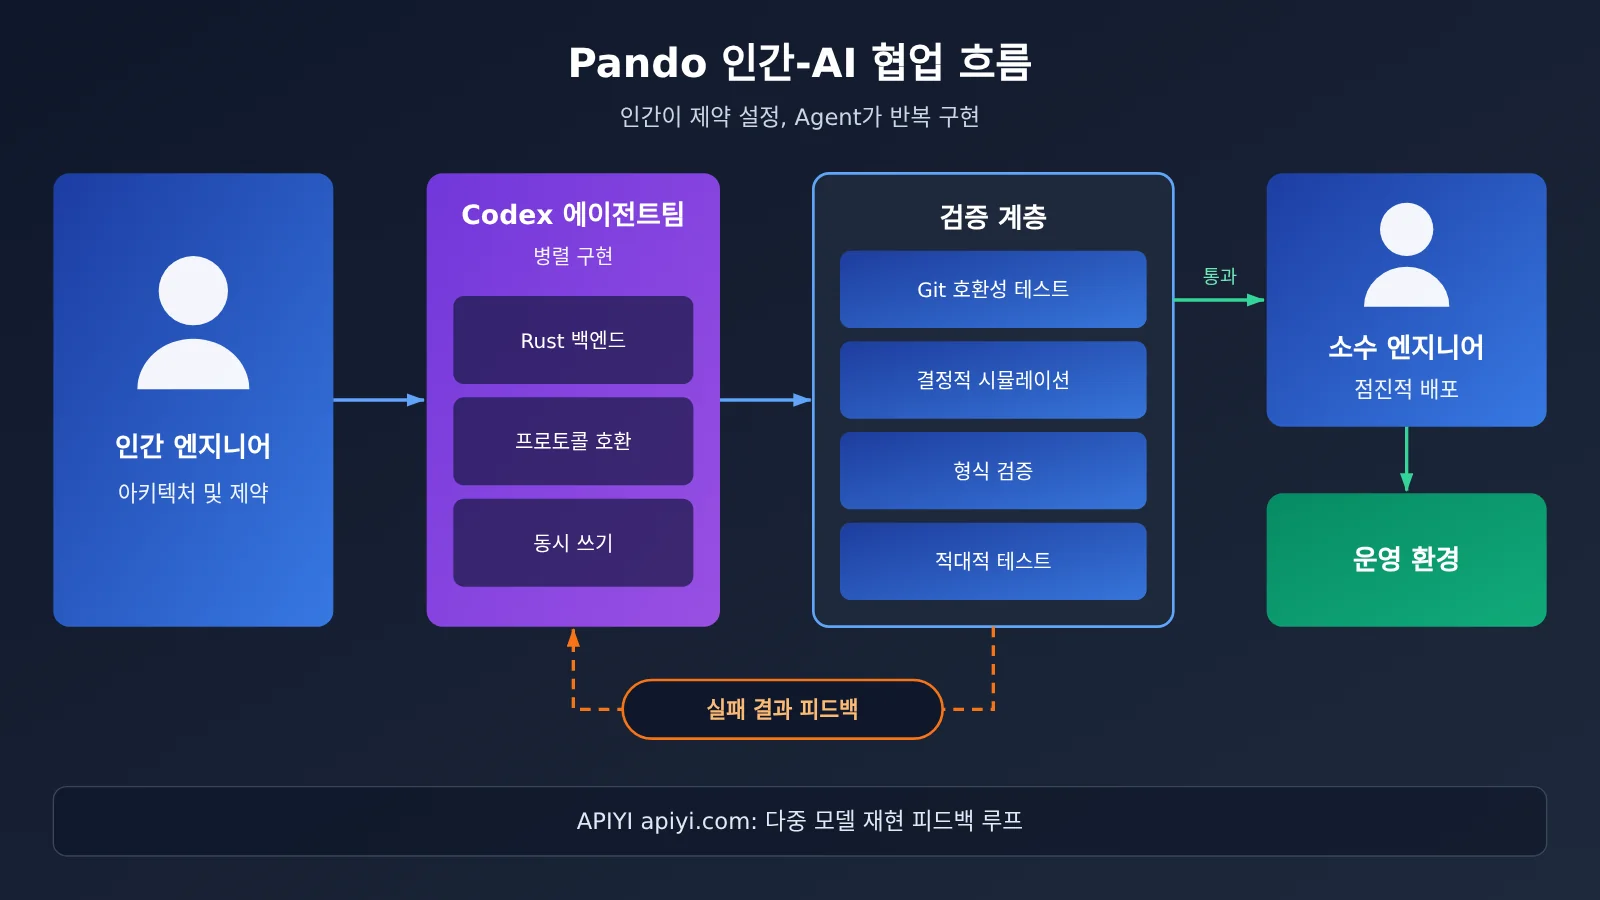
“한 명의 엔지니어가 핵심을 설계했다”는 말이 프로젝트에 한 사람만 참여했다는 뜻은 아니에요. 마찬가지로 “Agent 팀이 구현했다”는 말도 모든 코드를 AI가 작성했다는 뜻은 아니죠. 공식적으로 공개된 작업 범위를 바탕으로 역할을 정리하면 다음과 같아요. 다만 OpenAI는 각 Agent의 구체적인 작업 목록을 공개하지 않았어요.
| 역할 | 담당 업무 | 이 역할이 맡은 이유 |
|---|---|---|
| 아키텍처 엔지니어(사람) | 기존 시스템의 병목 판단, Git 프로토콜 호환성 유지, 브랜치별 독립 업데이트와 Packfile 재사용 선택, 저장소 전체의 강한 일관성 포기 | 되돌리기 어려운 기술적 선택으로 시스템의 경계를 결정하기 때문 |
| Codex 등 Agent 팀 | Rust 백엔드 구현, Push/Fetch 프로토콜 호환성 확보, 동시 쓰기, 성능 최적화, 경계 사례 수정 | 구현량이 많고 테스트로 반복 검증할 수 있어 병렬 반복 작업에 적합하기 때문 |
| 검증용 Agent | 장시간 세션을 실행해 경계 사례 탐색, Daybreak 기능을 갖춘 모델로 상시 적대적 테스트 수행 | 지속적인 작업이 필요해 사람이 같은 빈도를 유지하기 어렵기 때문 |
| 배포 엔지니어(사람) | 점진적인 트래픽 전환, 신규·기존 시스템 동기화, 수백 개 연동 항목 마이그레이션 | 프로덕션 위험 관리와 조직 간 조율에 사람이 책임져야 하기 때문 |
핵심은 사람이 아키텍처와 제약 조건, 수용 기준을 정하고, Agent가 대량의 구현과 반복 작업을 맡으며, 엔지니어가 프로덕션 마이그레이션과 시스템 안정성을 책임진다는 점이에요. 공식 자료에는 사람이 직접 개발한 대조군이 없어 Codex가 프로젝트를 몇 배나 가속했는지는 계산할 수 없어요.
Pando 테스트 체계: Codex Agent가 인프라 개발에 참여할 수 있는 이유
Pando는 인프라 소프트웨어예요. 문제가 생기면 브랜치가 올바른 커밋을 가리키는지, Push 과정에서 객체가 유실되지 않는지, Fetch로 전체 이력을 가져오는지에 영향을 줘요. 일반 웹페이지는 오류가 나도 새로고침하면 되지만, Git 백엔드 오류는 회사 전체의 개발을 멈출 수 있어요. 그래서 OpenAI는 Agent에 더 긴 프롬프트가 아니라 실행 가능한 검증 시스템을 제공했어요.
Git 호환성 테스트: 컴파일이 아닌 동작 검증
OpenAI는 Git Conformance Test Suite를 구축해 Agent가 서버 구현을 수정한 뒤, 동작이 표준 Git의 예상과 일치하는지 직접 확인할 수 있도록 했어요. 검증 대상에는 Ref 업데이트, Push, Fetch, Packfile 전송, 프로토콜 호환성이 포함돼요. 핵심은 단순히 “코드가 컴파일되고 단위 테스트를 통과하는지”가 아니라 “Git과 동일하게 동작하는지”를 확인하는 거예요. 공식적으로 테스트 케이스 수는 공개되지 않았어요.
결정적 동시성 시뮬레이션: 경쟁 상태 재현하기
분산 시스템에서 가장 어려운 오류는 여러 작업이 뒤섞여 실행될 때 발생하는 경우가 많아요. OpenAI는 Deterministic Simulation Harnesses를 사용해 시스템 상태와 동시 이벤트를 반복 재현할 수 있는 방식으로 시뮬레이션해요. 이를 통해 경쟁 상태, Git 협상 문제, Packfile 계획 오류와 회귀 문제를 찾아내요. 예를 들어 두 Agent가 같은 브랜치를 동시에 수정할 때 충돌하는 두 업데이트가 모두 성공으로 판정되어서는 안 돼요. 또 브랜치 포인터를 업데이트하기 전에 새 커밋 객체를 읽을 수 있어야 해요. 이는 테스트 목표를 설명하기 위한 예시이며, 공식적으로 개별 공개된 테스트 케이스는 아니에요.
Lean과 TLA+ 형식 검증: 시점에 주의
공식 발표에 따르면 GPT-6 Astra는 Agent가 Lean과 TLA+로 형식 명세를 작성하도록 도왔어요. 이렇게 만들어진 “Theory of Pando”는 불변 조건을 확인하고, 오류를 찾아 수정하며, 특정 속성을 증명하는 데 사용돼요. 여기에는 두 가지 한계가 있어요. 첫째, 검증 대상은 지정된 속성이므로 시스템의 모든 코드 경로가 수학적으로 증명됐다는 뜻은 아니에요. 둘째, 공식 설명에 따르면 새 모델이 차례로 등장한 뒤 성능과 안정성을 높이는 데 지속적으로 활용됐어요. 따라서 이 모든 작업을 최초 10주에 이루어진 것으로 볼 수는 없어요.
장시간 Agent 세션과 적대적 보안 테스트
OpenAI는 여러 차례 이어진 Agent 세션이 수백 시간 동안 실행되며 엣지 케이스 문제를 찾고 수정했다고도 밝혔어요. Daybreak 기능을 갖춘 모델은 Git과 Pando를 대상으로 지속적인 적대적 테스트를 수행했어요. 다만 Agent 수, 세션당 실행 시간, 토큰 사용량, 수정된 버그 수, 사람의 감독 빈도는 공개되지 않았어요. 따라서 “Agent가 사람의 감독 없이 수백 시간 연속으로 코드를 작성했다”고 추론할 수는 없어요. 주목할 점은 Agent를 최초 코드 생성뿐 아니라 지속적인 검증에도 활용한다는 사고방식의 변화예요.
OpenAI가 공개한 Git Fork에서도 이러한 지속적인 개선을 간접적으로 확인할 수 있어요. 예를 들어 2026년 8월의 index-pack 병렬 해싱, 10월의 요청 제한 시 재시도와 완료된 Pack 재사용 등의 패치가 있어요. 하지만 이 커밋들은 모두 2026년 4월 최초 운영 배포 이후에 이루어졌으므로, 마찬가지로 10주 내 산출물로 볼 수는 없어요.
Pando의 점진적 마이그레이션: Codex Agent가 코드를 작성했다고 바로 프로덕션에 쓸 수 있는 것은 아니에요
10주는 프로젝트 시작부터 프로덕션 도입까지 걸린 시간이지, 시스템이 완전히 성숙해지기까지의 전체 시간은 아니에요. Pando는 전형적인 무중단 점진적 마이그레이션 방식으로 도입됐어요. 공식 발표에 따르면 과정은 대략 다음과 같아요.
- Pando를 기존 시스템 앞에 읽기·쓰기 패스스루 프록시로 배치하고, 신규 백엔드와 기존 백엔드를 동기화했어요.
- 실제 요청에서 동일한 요청을 병합하고 Git 데이터를 캐싱했어요. 그 결과 일부 트래픽을 이전한 뒤 오히려 기존 시스템의 부담이 줄었어요.
- 내부 Git CLI 래퍼를 통해 개발 클라이언트를 단계적으로 이전했어요.
- 기존 API, Webhook, 저장소 다운로드 방식에 의존하는 수백 개의 연동 기능과 Review, Change Request 워크플로를 이전했어요.
- 마이그레이션용 Codex Skills를 제공해 개발자가 Codex의 도움을 받아 로컬 저장소와 마이그레이션 환경을 준비할 수 있게 했어요.
- 개선된 Git 클라이언트를 엔지니어의 기기와 ChatGPT 데스크톱 앱에 배포했어요.
공식 발표에 따르면 전체 마이그레이션 과정에서 엔지니어링 작업이 중단되지는 않았지만, 롤백 비율과 장애 분포, 실패 사례는 공개되지 않았어요. 기술 책임자라면 ‘10주’라는 숫자보다 이 과정에 주목할 만해요. 기존 워크플로와의 호환성 확보, 연동 기능 이전, 단계적 트래픽 전환은 새로운 시스템을 개발하는 것만큼이나 복잡한 경우가 많으니까요.
Pando 영향 분석: Agent 개발자와 기술팀에 어떤 의미가 있을까요?
Agent 개발자에게 미치는 영향
- 검증 능력이 Agent의 한계를 결정해요: Pando는 Agent가 핵심 구현에 참여할 수 있게 해줘요. 단, Agent가 신뢰할 수 있는 피드백을 받으려면 호환성 테스트, 결정론적 시뮬레이션, 형식화된 명세가 필요해요.
- Agent의 역할이 확장되고 있어요: 코드 작성뿐 아니라 엣지 케이스를 지속적으로 찾고, 적대적 테스트와 사용자 마이그레이션을 지원하는 역할까지 맡아요.
기술 책임자에게 미치는 영향
- AI Coding은 후속 작업의 부하를 늘려요: 커밋이 늘어나면 CI, 코드 리뷰, 코드 호스팅에도 부담이 전해져요. OpenAI는 2026년 7월 별도 글에서 내부 주간 PR 수가 이전 4분기보다 두 배 이상 늘었고, 코드 리뷰가 새로운 병목 중 하나가 됐다고 밝혔어요.
- 무작정 Pando를 직접 구축할 필요는 없어요: 대형 Monorepo의 규모 문제는 AI 시대 이전부터 있었으며, 대부분의 팀은 Git 백엔드를 새로 구축할 필요가 없어요.
Harness Engineering 사례와 비교
2026년 2월, OpenAI는 또 다른 독립 프로젝트를 공개했어요. 빈 저장소에서 시작해 Codex가 제품 코드를 작성했고, 약 5개월 동안 100만 줄 규모의 코드와 약 1,500개의 PR이 만들어졌어요. 초기에는 엔지니어 3명이 이끌었어요. 이 프로젝트와 Pando는 팀과 프로세스가 달라 데이터를 섞어 비교할 수는 없지만, 엔지니어가 시스템 설계, 테스트 환경, Agent 워크플로 설계를 점점 더 많이 맡는다는 공통된 추세를 보여줘요. 이 프로젝트의 경험에는 작업을 작은 단위로 나누고, 각 브랜치에 독립적인 실행 환경을 제공하며, Agent가 로그와 지표에 접근할 수 있게 하는 것이 포함돼요. 또 전체 지식 베이스를 프롬프트에 넣는 대신 AGENTS.md로 지침을 제공했어요.
Hacker News에서는 다른 의견도 나왔어요. 회의적인 쪽은 커밋 증가가 곧 품질 향상을 뜻하지는 않는다고 보고, 긍정적인 쪽은 코드 작성 비용이 낮아져 더 많은 소규모 프로젝트가 가능해졌다고 봐요. 이는 커뮤니티의 의견이지 통계적 결론은 아니에요.
Codex Agent 팀의 방법 활용하기: 테스트 주도 피드백 루프
Pando에서 가장 쉽게 응용할 수 있는 건 규모가 아니라 Agent가 실행 가능한 피드백을 받는 구조예요. 아래는 모델이 패치를 생성하고, 테스트 결과를 다시 받아 수정하는 최소한의 테스트 주도 루프입니다.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # 테스트할 코딩 모델로 교체
    messages=[{"role": "user", "content": "根据以下失败测试修复函数:..."}]
)
print(resp.choices[0].message.content)
전체 테스트 피드백 루프 구현 보기
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是严格遵守约束的工程 Agent。"
    "只修改指定文件,不得改动测试;输出完整的新文件内容。"
)

def run_tests() -> tuple[bool, str]:
    """실행 가능한 검증을 수행하며, Pando의 호환성 테스트에 해당해요"""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 轮:测试全部通过,等待人工审核")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求与约束:\n{spec}\n\n当前代码:\n{source}\n\n测试输出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("达到轮次上限,转交人类工程师处理")
    return False

agent_loop("src/ref_store.py", "同一分支的并发更新必须只有一个成功")
🚀 빠른 시작: 이런 피드백 루프를 구축할 때는 APIYI apiyi.com에서 무료 테스트 크레딧을 받아 시작할 수 있어요. 하나의 API 키로 여러 코딩 모델을 전환하며 테스트 세트에서의 수정 성공률을 비교해 보세요.
Pando의 방식을 일반 팀이 실행할 수 있는 프레임워크로 정리하면 다음과 같아요. 공식 공개 내용을 바탕으로 한 제안이며, OpenAI가 공개한 Pando 전용 워크플로는 아닙니다.
| 단계 | 핵심 작업 | 대응하는 Pando 사례 | 활용 도구 |
|---|---|---|---|
| 목표와 경계 설정 | 반드시 호환해야 할 프로토콜과 타협할 수 없는 지표 명확화 | Git 프로토콜 호환성 유지 | 설계 문서, AGENTS.md |
| 검증 환경 구축 | 호환성 테스트, 동시성 시뮬레이션, 회귀 검사 | Conformance 테스트와 결정적 시뮬레이션 | pytest, 속성 기반 테스트, TLA+ |
| Agent 작업 분담 | 작은 단위의 작업, 독립 브랜치, 자동 테스트 실행 | 여러 Agent 팀이 구현 | APIYI apiyi.com 등을 통한 다중 모델 호출 |
| 사람의 검토 | 주요 선택과 트레이드오프, 모듈 간 의존성, 보안 영향 검토 | 사람이 아키텍처 관리 | 코드 리뷰 규칙 |
| 점진적 배포 | 적은 트래픽으로 시작하고 기존 시스템과의 호환성 유지 | 읽기·쓰기 패스스루 프록시, 단계적 마이그레이션 | 카나리 배포, 모니터링 지표 |
자주 묻는 질문 FAQ
Q1: Pando란 무엇인가요?
Pando는 OpenAI 내부에서 사용하는 Git 호환 서버 백엔드로, 단일 코드베이스의 모든 개발 활동을 지원해요. 표준 Git 프로토콜과 클라이언트는 유지하면서 참조 업데이트, Packfile 스토리지 재사용, 캐시 전달 방식을 새로 설계해 다수의 에이전트와 엔지니어가 동시에 커밋하고 읽을 수 있도록 했어요.
Q2: Pando는 한 사람이 Codex로 만든 건가요?
아니요. 공식 설명에 따르면 한 명의 엔지니어가 핵심 아키텍처를 설계하고, 여러 에이전트 팀이 구현했으며, 소수의 엔지니어가 배포했어요. 참여 인원, 사람이 직접 수정한 코드의 비율, 에이전트 설정은 공개되지 않았어요. 모든 코드를 Codex가 생성했다거나 사람이 검토하지 않았다는 설명도 없어요.
Q3: Pando는 언제 출시됐으며, 외부에서도 사용할 수 있나요?
Pando는 2026년 4월부터 프로덕션 트래픽을 처리하기 시작했고, 기술 문서는 2026년 11월 2일에 공개됐어요. 2026년 11월 3일 기준으로 공개된 서버, API, 가격 또는 외부 공개 일정은 없어요. 공개된 것은 OpenAI의 Git 클라이언트 포크와 일부 업스트림 패치뿐이며, 이는 Pando 서버가 오픈소스로 공개됐다는 뜻이 아니에요.
Q4: 모든 검증 작업이 10주 안에 완료됐나요?
그렇게 이해하면 안 돼요. 공식 설명에 따르면 새 모델이 등장할 때마다 Pando 개선에 계속 활용했어요. GPT-6 Astra가 지원한 Lean/TLA+ 형식 검증 작업, 수백 시간의 에이전트 세션, 적대적 테스트가 모두 처음 10주 안에 이뤄졌는지는 확인할 수 없어요. 공개된 Git 패치도 대부분 최초 프로덕션 적용 이후에 나왔어요.
Q5: API로 비슷한 에이전트 테스트 피드백 루프를 구축하려면 어떻게 하나요?
작은 모듈부터 시작하는 것이 좋아요.
1. APIYI apiyi.com에 가입해 API 키와 무료 테스트 크레딧을 받으세요.
2. 실행 가능한 테스트나 호환성 검사를 먼저 작성한 뒤 모델이 코드를 수정하도록 하세요.
3. 본문의 코드를 사용해 base_url을 `https://api.apiyi.com/v1`로 설정하고, “생성—테스트—로그 피드백”을 반복하세요.
OpenAI 호환 인터페이스이므로 model 파라미터만 수정하면 모델을 전환할 수 있어 수정 효과를 비교하기 편해요.
Q6: 일반 팀이 Pando의 방식을 그대로 적용할 때 어떤 제약이 있나요?
크게 세 가지가 있어요. 첫째, 토큰과 인프라 비용이 공개되지 않아 실제 비용을 알 수 없어요. 둘째, Pando는 높은 수준의 검증 체계에 의존하므로 테스트가 없는 프로젝트에서 에이전트가 대량의 코드를 작성하면 위험이 더 커요. 셋째, 10주라는 결과를 비슷한 규모의 모든 프로젝트에 적용할 수는 없어요. 먼저 핵심이 아닌 모듈에서 APIYI apiyi.com을 소액으로 시험하고, 피드백 루프가 효과적인지 확인한 뒤 범위를 넓히는 것이 좋아요.
Pando와 Codex Agent 핵심 요약 Key Takeaways
- Pando란: OpenAI 내부의 Git 호환 백엔드로, 약 10주 만에 프로덕션에 도입됐으며 외부에는 공개되지 않았어요.
- 구축 배경: Codex로 동시 커밋이 늘어나면서 기존 시스템에 속도 저하와 병합 실패 등의 문제가 생겼어요.
- 사람과 Agent의 역할: 사람은 아키텍처와 제약 조건을 정하고, Agent는 구현을 반복 개선하며, 엔지니어는 배포를 담당해요.
- 성공의 핵심: 호환성 테스트, 결정론적 시뮬레이션, 형식 검증이 신뢰할 수 있는 피드백을 제공했어요.
- 시간 범위: 이후에 등장한 새 모델과 검증 방법을 모두 초기 10주에 포함해서는 안 돼요.
- 도입 방식: 읽기·쓰기 패스스루 프록시와 단계적 트래픽 전환을 통해 일상적인 개발을 중단하지 않고 마이그레이션했어요.
- 시작하는 방법: 먼저 테스트를 구축하고, APIYI apiyi.com을 통해 여러 모델의 피드백 루프를 검증해 보세요.
요약
Pando 사례의 핵심은 다음과 같아요.
- 규모에 따른 인프라 개선: AI 코딩으로 인한 커밋 증가는 Git, CI, 코드 리뷰에도 영향을 미쳐요. Pando는 이런 부담에 대응하기 위한 엔지니어링 결과물이에요.
- Agent의 성과는 검증에 달려 있어요: Codex Agent 팀이 인프라 구현에 참여할 수 있었던 것은 실행 가능한 호환성 테스트, 동시성 시뮬레이션, 형식적 명세가 있었기 때문이에요.
- 사람의 의사결정은 여전히 중요해요: 아키텍처 선택, 일관성 경계, 프로덕션 마이그레이션은 모두 엔지니어가 책임져요.
대부분의 팀이 참고할 것은 ‘10주’라는 숫자가 아니라 명확한 제약 조건, 실행 가능한 테스트, 업무 분담, 지속적인 피드백, 사람의 핵심 의사결정이라는 다섯 가지 요소예요. 완전 자동화부터 추구하기보다 테스트가 잘 갖춰진 작은 모듈에서 Agent의 피드백 루프를 먼저 검증한 뒤 범위를 넓혀 보세요.
APIYI apiyi.com을 통해 효과를 빠르게 검증해 보는 것도 좋아요. OpenAI 호환 인터페이스와 신규 사용자 무료 크레딧을 제공해 같은 피드백 루프에서 여러 코딩 모델을 비교하기 편리해요.
📚 참고 자료
- OpenAI 공식 기술 글 Scaling Git at OpenAI: Pando 아키텍처, 마이그레이션 및 성능 데이터의 주요 출처
- 링크:
openai.com/index/scaling-git-at-openai -
설명: 2026-11-02에 게시되었으며, 이 글의 핵심 근거 자료예요.
-
OpenAI Harness Engineering: Codex가 개발을 주도한 또 다른 내부 프로젝트
- 링크:
openai.com/index/harness-engineering -
설명: Agent 엔지니어링 방법론을 이해하는 데 도움이 되지만, Pando 데이터와 혼용해서는 안 돼요.
-
Custom Code Review Rules for Codex: AI 코딩으로 발생한 코드 리뷰 병목
- 링크:
developers.openai.com/blog/custom-code-review-rules-for-codex -
설명: 내부 주간 PR 수 증가와 AGENTS.md 리뷰 규칙을 소개해요.
-
OpenAI 공개 Git 포크: 클라이언트 개선 코드 저장소
- 링크:
github.com/openai/git -
설명: packfile-uri 등의 개선 사항이 포함되어 있지만, Pando 서버 소스 코드는 아니에요.
-
OpenAI Git 패치 추적: 업스트림 기여 기록
- 링크:
oai-git.openai.chatgpt.site - 설명: 운영 환경에 적용한 후에도 지속된 엔지니어링 개선 사항을 확인할 수 있어요.
작성자: APIYI 기술팀
기술 교류: APIYI 웹사이트 홈에서 문의해 주세요. 더 많은 Agent 개발 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.