작성자 주: 이 글은 FrontierHarness v1.1의 전체 26,040회 실행이 모두 끝난 뒤의 최종 순위표만 해설해요. 모델별로 21개 harness를 나란히 비교하고, APIYI에서 해당 모델 ID가 실제로 개방한 프로토콜과 가격을 대조합니다.
Codex CLI, Claude Code, OpenCode, Pi 같은 코딩 Agent를 쓰면서 기반 모델을 자주 바꾸는 분이라면, “어떤 harness가 최고인가”라는 질문에 통일된 답이 없다는 걸 이미 느끼고 있을 거예요. 2026-11-10에 Runta의 Guanlan Dai가 FrontierHarness v1.1을 시작하며 던진 질문이 바로 이것이었어요: when you switch models, should you switch harnesses too? 2026-11-15 기준 라이브 순위표에는 running 0, scored 26,040으로 표시되고, 21개 harness × 5개 모델 × 62개 태스크 × 4회 시도가 전부 완료됐어요.
이건 “어떤 harness 하나가 모든 면에서 1위”라는 식의 순위표 해설이 아니에요. 최종 순위표에서 통과율 1위와 회당 통과 비용이 가장 저렴한 harness는 서로 다르고, 다섯 모델 각각에서 가장 저렴한 harness도 다 달라요. 이 글에서는 이 결론들을 모델별로 쪼개서 한 칸씩 정리해 볼게요.
핵심 가치: 이 글을 다 읽고 나면 모델별로 나뉜 FrontierHarness 최종 순위표 비교를 손에 쥐게 돼요. 모델을 바꿀 때 어느 열을 봐야 하는지, 어떤 예전 숫자는 더 이상 쓸 수 없는지, 그리고 연동 전에 어느 프로토콜을 확인해야 하는지까지 알게 됩니다.
FrontierHarness 최종 순위 기준: 어떤 harness가 최고인지 판단하기 전에 규칙부터 확인하세요
FrontierHarness의 모든 실행은 Runta runtime에서 이루어지며, 동일한 리소스 제한을 사용해요. 각 harness × model 조합은 248회를 모두 실행해야 최종 결과로 인정되므로, 라이브 방송 중 순위는 새로운 결과에 따라 계속 바뀌어요. 아래 표는 v1.1 최종 순위표의 채점 기준을 정리한 것이며, 이후 모든 비교는 이 기준을 따릅니다.
| 기준 항목 | v1.1 최종 순위표 설정 | 비교 시 의미 |
|---|---|---|
| 데이터셋 | [email protected], 62개 과제 |
모든 harness가 같은 문제 세트를 풀어요 |
| 규모 | 21개 harness, 문제당 4회, 조합당 248회, 모델당 5,208회, 총 26,040회 | 모든 셀의 분모가 같아 횡적 비교가 가능해요 |
| 실행 환경 | 1–4 vCPU, 2–8 GB 메모리, 32 GB 디스크, 단일 문제 타임아웃 15분~8시간 | 머신 차이를 배제해요 |
| 추론 설정 | 추론 제공자 Baseten, 다섯 모델 모두 effort가 max | 모델 측 변수를 통일해요 |
| 통과률 | 통과 수 ÷ 점수에 반영되는 시도 수; 타임아웃과 reward hacking은 실패로 처리되고, 인프라 오류는 반영되지 않아요 | 답안을 몰래 보면 점수를 못 받아요 |
| 비용 | 정가 × 보고된 token | 순위표 알고리즘이며, 어떤 플랫폼의 청구서도 아니에요 |
| 신뢰도 | 과제별 95% bootstrap | 차이가 작은 순위는 신중히 해석해야 해요 |
자주 공유되는 몇 가지 수치가 있는데, 이것들은 모두 v1.1 최종 순위표가 아니에요. v1.0은 Kimi K3 한 모델에서만 9개의 harness, 12가지 구성, 360회를 테스트했고, 여기서 Codex의 66.7% 통과률과 $3.47의 과제 중위 비용은 모두 v1.0에 속해요. 2026-11-11의 중간 스냅샷에서는 1회 통과당 비용이 $0.57에서 $1.32 사이, 통과률이 56.2%에서 77.6% 사이였는데, 이 역시 절반쯤 진행된 상태일 뿐이에요. 같은 날 누군가 “GLM-5.3에는 KimiCode가 최고, Kimi-K3에는 Codex가 최고”라고 썼지만, 최종 순위표의 1회 통과당 비용 기준으로 다시 정렬하면 이런 주장은 모두 성립하지 않아요.
어떤 harness가 가장 좋을까: FrontierHarness 전체 최종 순위 비교
아래 표는 21개 harness가 다섯 개 모델에서 거둔 성적을 한데 모아, ‘통과 1회당 비용’이 낮은 순서대로 정리한 거예요. 모든 달러 금액은 FrontierHarness 최종 순위에서 정가에 보고된 토큰 수를 곱해 계산한 값입니다.
| 순위 | harness | 통과당 비용 | 작업당 평균 비용 | 통과율 |
|---|---|---|---|---|
| 1 | Codex CLI | $0.937 | $0.573 | 61.1% |
| 2 | Pi | $0.976 | $0.563 | 57.7% |
| 3 | Oh My Pi | $0.983 | $0.564 | 57.3% |
| 4 | ZCode | $1.06 | $0.659 | 61.9% |
| 5 | KimiCode | $1.09 | $0.653 | 60.2% |
| 6 | OpenCode | $1.12 | $0.646 | 57.4% |
| 7 | Maka | $1.13 | $0.654 | 57.7% |
| 8 | MiniMax Code | $1.14 | $0.647 | 56.8% |
| 9 | DeepSeek Harness: Minimal | $1.15 | $0.661 | 57.4% |
| 10 | Hermes Agent | $1.16 | $0.692 | 59.9% |
| 11 | Cline CLI | $1.19 | $0.689 | 57.7% |
| 12 | Grok Build | $1.20 | $0.723 | 60.0% |
| 13 | Alma | $1.22 | $0.731 | 59.7% |
| 14 | DeepSeek Harness: Standard | $1.27 | $0.697 | 55.0% |
| 15 | DeepSeek Harness: Creator | $1.27 | $0.713 | 56.1% |
| 16 | mini-SWE-agent | $1.29 | $0.757 | 58.6% |
| 17 | DeepSeek Harness: Code | $1.32 | $0.732 | 55.2% |
| 18 | Exo | $1.36 | $0.691 | 50.6% |
| 19 | GitHub Copilot CLI | $1.38 | $0.787 | 56.9% |
| 20 | Claude Code | $1.55 | $0.915 | 58.9% |
| 21 | Antigravity CLI | $1.63 | $0.897 | 55.0% |
전체 최종 순위의 두 가지 1위
전체 최종 순위에서 두 가지 1위가 나와요. 전체 통과율 1위는 ZCode(61.9%)이고, 통과 1회당 비용이 가장 저렴한 건 Codex CLI($0.937)예요. 이 두 문장은 반드시 함께 봐야 해요. Codex CLI의 통과율은 61.1%로 ZCode보다 0.8%포인트 낮지만, 통과 1회당 비용은 약 $0.12 더 저렴해요. 반대로 ZCode는 ‘문제를 더 많이 통과시키고 싶을 때’ 더 안정적인 선택이에요. 가장 비싼 Antigravity CLI는 통과 1회당 $1.63으로, Codex CLI의 약 1.74배입니다. 전체 통과율은 Exo의 50.6%에서 ZCode의 61.9% 사이에 분포하고, 차이는 11.3%포인트예요.
오해하기 쉬운 부분이 두 가지 있어요. 첫째, 네 개의 DeepSeek Harness는 같은 버전 0.2.1-rc.3의 네 가지 구성(Minimal, Standard, Creator, Code)이지, 네 개의 독립 제품이 아니에요. 둘째, Alma는 통과 1회당 비용 기준으로는 13위지만 통과율 기준으로는 6위로, ZCode, Codex CLI, KimiCode, Grok Build, Hermes Agent 다음에 위치해요. 11월 11일 스냅샷에서 Alma가 3위, 72.7%를 기록했다는 이야기는 중간 데이터에 해당하니, 최종 순위의 59.7%를 기준으로 삼아야 해요.
모델을 바꾼 뒤 어떤 harness가 가장 좋을까: FrontierHarness 5개 모델 컬럼별 정리
전체 집계는 평균 수준만 알려줄 뿐, 실제로 청구서를 결정하는 건 당신이 가진 그 모델의 컬럼이에요. 아래 표에서 “가장 저렴한”은 모두 해당 모델 페이지에서 통과당 비용이 가장 낮은 harness를 뜻하고, 통과 수의 분모는 전부 248이에요.
| 모델 | 평균 작업당 비용 (harness 평균) | 통과당 가장 저렴 | 통과율 최고 | 동일 모델 내 가장 비쌈 |
|---|---|---|---|---|
| GLM-5.3 | $0.968 | Codex CLI $0.803, 57.7% | ZCode 58.9%, $1.48 | Exo $2.72, 50.0% |
| GLM-5.3-Flash | $0.193 | Pi $0.223, 58.1% | Hermes Agent 60.9%, $0.328 | DeepSeek Harness: Minimal $0.484, 55.2% |
| DeepSeek-V4.1-Flash-1017 | $0.185 | OpenCode $0.177, 61.3% | ZCode 69.0%, $0.222 | Cline CLI $0.860, 63.3% |
| Muse Spark Open | $1.01 | Oh My Pi $1.21, 58.9% | Grok Build 59.7%, $1.77 | Claude Code $3.75, 52.8% |
| Kimi-K3 | $1.12 | Oh My Pi $1.45, 57.7% | mini-SWE-agent 64.9%, $2.02 | Antigravity CLI $2.73, 56.9% |
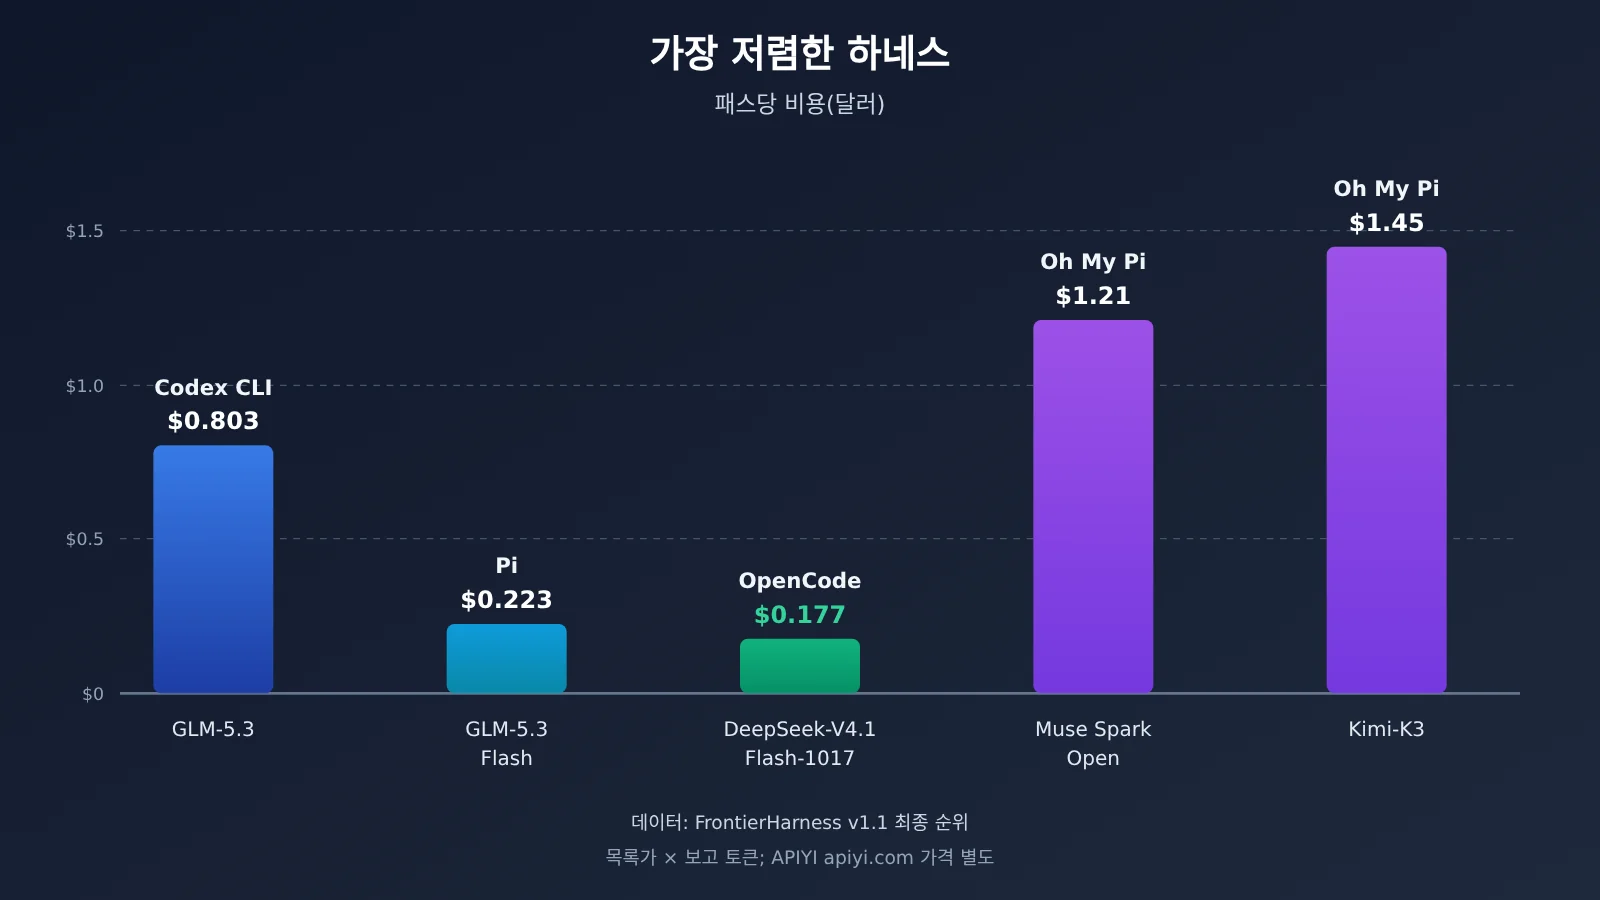
결론 1: 다섯 모델의 최저 비용 하네스는 서로 같지 않아요
다섯 열의 최저 비용 하네스는 각각 Codex CLI, Pi, OpenCode, Oh My Pi, Oh My Pi로, 서로 다른 네 가지 하네스예요. 전체 1위인 Codex CLI는 GLM-5.3 열에서만 최저 비용을 차지했고, GLM-5.3-Flash에서는 $0.226으로 Pi보다 아주 조금 비쌌어요. 그래서 모델을 바꿀 때는 하네스도 다시 따져봐야 하고, 예전 조합을 그대로 쓰면 안 돼요.
결론 2: 모델을 바꿀 때의 비용 차이가 하네스를 바꿀 때보다 커요
모델별로 작업 한 번당 평균 비용을 보면 DeepSeek-V4.1-Flash-1017의 $0.185에서 Kimi-K3의 $1.12까지로, 약 6.1배 차이예요. 하네스별로 전체 평균 작업 한 번당 비용을 보면 가장 낮은 건 Pi의 $0.563, 가장 높은 건 Claude Code의 $0.915로 차이가 2배도 안 돼요. 즉 FrontierHarness 최종 순위에서는 어떤 하네스를 고르는 것보다 어떤 모델을 고르는 것이 작업 비용에 더 큰 영향을 줘요.
결론 셋: 자체 harness가 자체 모델에서 가장 저렴하지도 않았다
DeepSeek-V4.1-Flash-1017 열에서 통과 1회당 비용을 기준으로 보면, DeepSeek Harness의 네 가지 설정은 Code $0.243 / 64.1%, Minimal $0.256 / 63.7%, Creator $0.273 / 64.9%, Standard $0.292 / 62.1%였어요. 가장 저렴하지도(OpenCode $0.177), 최고 통과율도(ZCode 69.0%, 171/248 — 이건 전체 조합 가운데 통과율이 가장 높은 항목이기도 해요) 차지하지 못했죠. Claude Code는 이 열에서 68.1%, Codex CLI는 $0.237 / 67.3%였어요. 같은 열에서 가장 비싼 Cline CLI는 시도 1회당 6.77M tokens를 쓰면서 통과 1회당 $0.860으로, OpenCode의 약 4.9배였어요. 물론 이 배수는 이 한 쌍에만 해당하는 이야기예요.
Kimi-K3 열도 같아요. 통과 1회당 비용 기준으로 자체 harness인 KimiCode는 $1.84 / 60.1%로 Oh My Pi의 $1.45보다 비쌌고, 통과율도 mini-SWE-agent의 64.9%, Alma와 ZCode의 64.1%보다 낮았어요. 전체에서 통과율이 가장 낮은 항목도 여기서 나왔죠. Exo + Kimi-K3, 43.5%, 108/248이에요.
시나리오별 추천: 모델에 따라 어떤 harness가 가장 좋을까
위의 열별 결론을 실제 선택으로 옮기면, 「어떤 모델을 쓰는가 + 비용이 더 중요한가 통과율이 더 중요한가」라는 두 축으로 나눌 수 있어요.
GLM-5.3을 쓸 때
- 통과 1회당 비용이 중요하다면: Codex CLI, $0.803, 57.7%, 시도 1회당 약 1.86M tokens.
- 통과율이 중요하다면: ZCode, 58.9%. 하지만 통과 1회당 $1.48로 Codex CLI의 두 배에 가까워요.
- 주의할 점: KimiCode는 이 열에서 $1.55 / 58.1%로, 앞서 내놓았던 중간 결론은 여기서 성립하지 않아요.
GLM-5.3-Flash를 쓸 때
- 비용이 중요하다면: Pi($0.223)와 Codex CLI($0.226)가 사실상 동률이고, 후자는 통과율 59.3%로 조금 더 높아요.
- 통과율이 중요하다면: Hermes Agent 60.9%, 통과 1회당 $0.328. ZCode 60.1%, $0.264는 절충안이에요.
DeepSeek-V4.1-Flash-1017을 쓸 때
- 비용이 중요하다면: OpenCode, $0.177, 61.3%.
- 통과율이 중요하다면: ZCode, 69.0%, 통과 1회당 $0.222로 가장 저렴한 것보다 약 $0.045만 비싸요. 이 열에서는 통과율을 좇는 비용이 아주 낮은 편이에요.
Muse Spark Open이나 Kimi-K3를 쓸 때
- Muse Spark Open: Oh My Pi가 가장 저렴해요($1.21). Grok Build의 통과율이 가장 높고(59.7%), Claude Code는 시도 1회당 9.79M tokens, 통과 1회당 $3.75로 이 열에서 가장 비싼 항목이에요.
- Kimi-K3: Oh My Pi가 가장 저렴하고($1.45, 시도 1회당 942k tokens), mini-SWE-agent의 통과율이 가장 높아요(64.9%). Codex CLI는 $1.78 / 63.7%로 어느 쪽도 손해가 없어요.
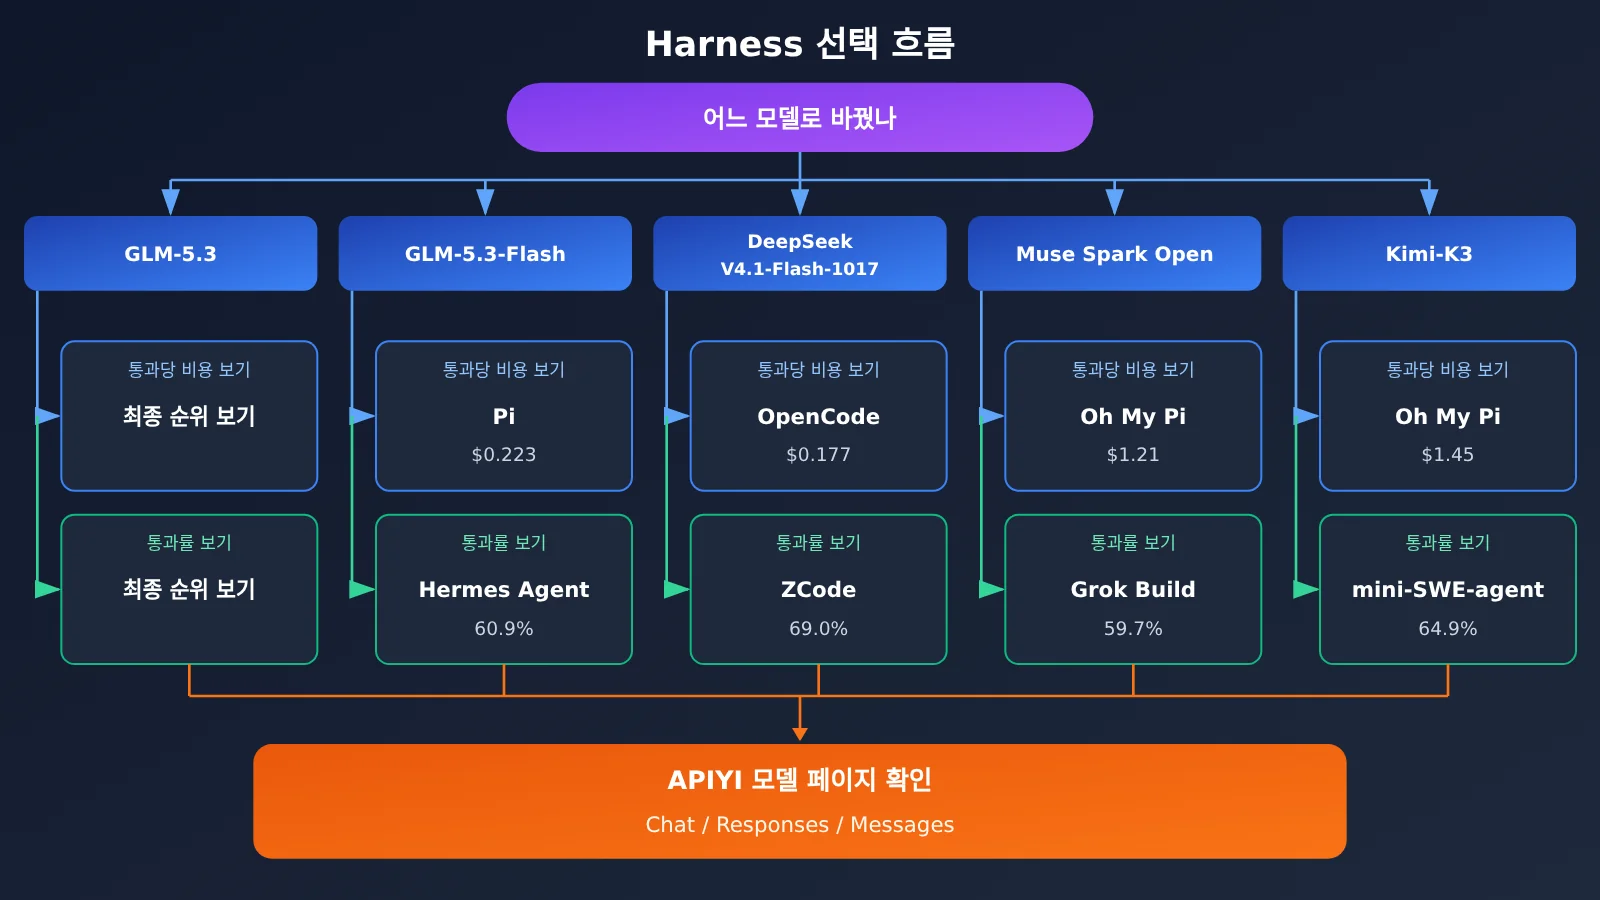
의사결정 가이드: harness 프로토콜과 APIYI 모델 ID 비교
리더보드의 harness와 플랫폼 엔드포인트가 일대일로 대응하지는 않아요. Codex CLI 성적이 좋다고 해서 여러분이 가진 모델 ID에서 Responses가 열려 있다는 뜻은 아니에요. Claude Code도 마찬가지로 먼저 Messages 열을 확인해야 해요. 각 harness에서 작업을 실행할 때마다 토큰을 소모하고, harness를 바꾸거나 모델을 바꾸면 청구서가 바로 달라져요. 그래서 특정 셀을 시험해 보기 전에, APIYI apiyi.com의 모델 페이지에서 이 ID가 Chat, Responses, Messages 중 무엇을 지원하는지 확인한 다음, harness의 base_url을 https://api.apiyi.com/v1로 지정하는 걸 권장해요.
아래 표는 APIYI 문서의 2026-11-15 기준 기본 가격(달러 / 1M tokens)이에요. 위 리더보드의 카탈로그 가격과는 서로 다른 숫자라, 섞어서 계산하면 안 돼요.
| 모델 ID | 입력 | 캐시 읽기 | 출력 | Chat | Responses | Messages | 그룹 |
|---|---|---|---|---|---|---|---|
glm-5.3 |
$1.4 | $0.259 | $4.396 | 지원 | 미지원 | 지원 | ClaudeCode 0.95×, Default, SVIP |
glm-5.3-flash |
$0.15 | $0.03 | $0.5 | 지원 | 모델 페이지: 미지원 | 모델 페이지: 미지원 | CodexResponses, Default, SVIP |
deepseek-v4.1-flash-1017 |
$0.3 | $0.006 | $1.2 | 지원 | 종합표에 없음 | 지원 | ClaudeCode, Default, SVIP |
deepseek-v4.1-flash |
$0.3 | $0.006 | $1.2 | 지원 | 그룹 참고 | 지원 | CodexResponses 하나 추가 |
kimi-k3 |
$3 | $0.3 | $15 | 지원 | 미지원 | 미지원 | Default, SVIP |
| Muse Spark Open | 아직 미등록 | — | — | — | — | — | — |
몇 군데는 하나씩 설명할게요:
glm-5.3은 Messages를 사용할 수 있고, ClaudeCode 그룹 0.95×가 있어서 Claude Code 같은 harness와 함께 쓰기 좋아요. 이 0.95×는glm-5.3에만 적용돼요. Responses는 사용할 수 없어요.glm-5.3-flash는 종합표와 모델 페이지에 두 군데가 서로 맞지 않아서, 두 가지 설명을 모두 남겨 둘게요. 그룹에는 CodexResponses가 적혀 있지만 모델 페이지에는 Responses와 Messages 모두 미지원이라고 나와요. 종합표의 유형 열에는 ‘텍스트’라고 되어 있지만, 모델 페이지에는 입력에 텍스트, 이미지, 동영상이 포함된다고 적혀 있어요.deepseek-v4.1-flash-1017은 Messages를 사용할 수 있지만, 종합표에서는 CodexResponses를 확인할 수 없어요. Responses가 필요하다면 다른 항목인deepseek-v4.1-flash를 봐야 해요.kimi-k3는 Chat Completions만 지원해서, Codex CLI나 Claude Code를 쓰기 전에 harness가 Chat 프로토콜을 받을 수 있는지 먼저 확인해야 해요.- 경제형
deepseek-v4-1-flash-economy-261017의 가격은 입력 $0.24, 출력 $0.96, 캐시 읽기 $0.006이고, chat만 지원해요. APIYI의 실시간 안내에 따르면, 이 모델은 표준 버전과 동일한 V4.1-Flash-1017 가중치를 로드하지만 생성 속도가 더 느려요. 강조하고 싶은 점은 FrontierHarness가 이 ID를 테스트한 적이 없기 때문에, 리더보드의 통과율을 이 모델에 그대로 적용할 수 없다는 거예요. - Muse Spark Open은 아직 등록되지 않았어요. 이 모델은 최대한 빨리 등록할게요. 모델명과 가격은 플랫폼의 모델 목록을 기준으로 확인해 주세요.
💡 선택 가이드: 먼저 모델을 기준으로 최종 리더보드의 해당 열에서 후보 harness를 골라내고, 프로토콜 기준으로 연결되지 않는 조합을 걸러 낸 다음, 같은 작업 세트로 소규모 시험 실행을 해 보세요. APIYI apiyi.com에서 하나의 Key로
glm-5.3,kimi-k3같은 ID를 전환하면 ‘모델 교체’와 ‘harness 교체’라는 두 변수를 분리해서 테스트할 수 있어요.
| 목표 | 먼저 볼 항목 | 최종 순위 후보 |
|---|---|---|
| 모델은 아직 정하지 않았고, 안정적인 하네스만 원한다 | 전체 집계 | Codex CLI(통과 1회당 비용 최저), ZCode(통과율 최고) |
| 모델은 정했고 비용을 낮추고 싶다 | 해당 모델의 통과 1회당 비용 | 다섯 모델별 표의 「최저」 열 참고 |
| 모델은 정했고 통과율을 높이고 싶다 | 해당 모델의 통과율 | 다섯 모델별 표의 「최고」 열 참고 |
| 총예산을 줄이고 싶다 | 모델 평균 작업 1회당 비용 | 모델을 먼저 바꾸고, 그다음 하네스를 바꾸기 |
자주 묻는 질문(FAQ)
Q1: FrontierHarness는 무엇이고, “어느 harness가 가장 좋은가”라는 질문에 어떻게 답하나요?
FrontierHarness는 Runta가 시작한 코딩 Agent 하네스 평가입니다. v1.1은 21개의 하네스를 5개의 모델에 각각 올려 62개 작업, 문제당 4회씩 실행하고, 같은 환경에서 통과율과 비용을 집계합니다. 단일 우승자를 내놓는 대신, 모델마다 각각 한 줄씩 순위를 제시합니다.
Q2: Codex CLI와 ZCode 중 누가 1위인가요?
둘 다 1위이지만, 기준이 다릅니다. 통과 1회당 비용 기준으로는 Codex CLI가 $0.937로 1위이고, 통과율 기준으로는 ZCode가 61.9%로 1위입니다. 예산을 우선하는지 성공률을 우선하는지에 따라 달라집니다.
Q3: v1.0의 66.7%와 11월 11일 순위는 여전히 참고할 수 있나요?
최종 순위로 보면 안 됩니다. v1.0은 Kimi K3와 하네스 9개만 측정했고 총 360회였습니다. 11월 11일은 v1.1이 절반쯤 진행된 시점의 스냅숏입니다. 2026-11-15 라이브 순위를 보면 26,040회가 이미 완료된 상태이니, 이때의 최종 순위를 기준으로 삼아야 합니다.
Q4: Claude Code로 GLM-5.3을 실행할 때 주의할 점은?
최종 순위에는 Claude Code가 GLM-5.3에서 기록한 조합이 별도로 표시되지 않아서, 성적을 바로 추론할 수 없습니다. 프로토콜 측면에서는 `glm-5.3`이 Messages를 지원하고, APIYI apiyi.com에는 ClaudeCode 그룹 0.95×도 있어서 연동 조건은 갖춰져 있습니다.
Q5: 내 환경에서 특정 조합을 재현하려면 어떻게 하나요?
FrontierHarness는 자체 테스트 진입점을 제공해서, 자신의 모델 키로 같은 환경에서 실행할 수 있습니다. 플랫폼 쪽에서 하는 방법은 이렇습니다. 먼저 모델 ID가 하네스가 요구하는 프로토콜을 지원하는지 확인한 다음, 하네스의 base_url을 `https://api.apiyi.com/v1`로 설정합니다. 신규 사용자는 무료 테스트 크레딧으로 몇 문제 먼저 실행해 볼 수 있습니다.
Q6: 이 최종 순위에는 어떤 한계가 있나요?
표에 나온 달러는 카탈로그 가격에 보고된 토큰을 곱해 계산한 값이라, 실제 플랫폼 청구서와는 다릅니다. 또 모든 모델의 effort가 max로 설정되어 있어서, 다른 단계로 바꾸면 결과가 달라질 수 있습니다. 게다가 일부 순위 간 차이는 95% 신뢰구간 안에 있어서, 인접한 순위를 과도하게 해석해서는 안 됩니다.
어떤 harness가 가장 좋을까: 핵심 요점
- 만능 셸은 없다: 다섯 모델의 가장 저렴한 harness가 서로 다른 네 개의 셸에 나뉘어 있어요.
- 두 개의 1위가 공존한다: ZCode는 통과율 61.9%로 가장 높고, Codex CLI는 통과 1회당 $0.937로 가장 저렴해요.
- 비용은 셸보다 모델이 더 크게 결정한다: 모델 간 평균 작업 비용 차이는 약 6.1배인 반면, 셸 간 차이는 2배 미만이에요.
- 자사 셸이 유리하지 않다: 통과 1회당 비용 기준으로 DeepSeek의 네 가지 등급과 KimiCode 모두 자사 모델에서 가장 저렴한 자리를 차지하지 못했어요.
- 최고 셀: ZCode + DeepSeek-V4.1-Flash-1017, 69.0%, 171/248.
- 연동 전에 프로토콜부터 확인: APIYI 모델 페이지에서 Chat, Responses, Messages 세 항목을 확인한 뒤 셸을 선택하세요.
정리
FrontierHarness v1.1 최종 순위표가 “어떤 harness가 가장 좋은가”에 내놓는 답은 모델에 따라 봐야 한다는 것이에요.
- 전체 1위가 둘: 통과율은 ZCode, 통과 1회당 비용은 Codex CLI예요.
- 모델을 바꾸면 셸도 다시 봐야 한다: 다섯 열의 가장 저렴한 셸은 각각 Codex CLI, Pi, OpenCode, Oh My Pi, Oh My Pi예요.
- 예산은 모델부터: 모델이 만드는 평균 작업 비용 차이가 셸을 바꿔서 생기는 차이보다 커요.
실제로 선택할 때는 최종 순위표에서 사용하는 모델의 열을 먼저 찾고, 프로토콜이 맞는지 확인하면 돼요. APIYI apiyi.com을 통해 통합 인터페이스로 모델 ID를 전환하고, 후보 조합을 소규모로 시험 실행해 보길 권해요.
📚 참고 자료
- FrontierHarness 라이브 리더보드: v1.1 최종 순위 및 모델별 데이터
- 링크:
frontierharness.org/live/ -
설명: 2026-11-15 기준 scored 26,040으로 표시되며, 이 글에 나오는 모든 리더보드 수치의 출처예요
-
FrontierHarness 자체 테스트 진입점: 자신의 Key로 동일한 환경에서 실행
- 링크:
frontierharness.org/evaluate-your-own-harness/ -
설명: 특정 harness × model 조합을 재현하는 데 적합해요
-
Guanlan Dai 게시글: v1.1의 문제 설정과 규모 설명
- 링크:
x.com/guanlan/status/2120192585235046712 -
설명: 248회를 거쳐야 최종이 된다는 점, 추론 스폰서 등 배경 정보를 포함해요
-
APIYI 모델 총표: 각 모델 ID의 가격, 엔드포인트 및 그룹
- 링크:
docs.apiyi.com/models - 설명: 이 글의 가격 데이터 기준 시점은 2026-11-15 09:36(UTC+8)이에요
작성자: APIYI 기술 팀
기술 교류: APIYI 공식 홈페이지 첫 화면을 통해 저희에게 연락해 주세요. harness와 모델 조합 선택에 대해 함께 논의하고 싶어요