gemini-4-argon は2026年10月13日にリリースされました。多くの開発者が接続直後に429エラーに遭遇しています。並列リクエストを増やすとすぐにエラーが出るだけでなく、単一のリクエストでも失敗することがあります。多くの人はまず「AI Studioの並列数上限が低すぎる」と考えがちですが、その見立てはおそらく正しくありません。この記事では、gemini-4-argon の AI Studio における実際のレート制限の仕組みを解説し、実践的な429エラー対策を紹介します。
「リトライを追加すれば解決」といった、ありきたりな解説ではありません。まず、重要な事実を確認しましょう。Googleは現在、gemini-4-argon の統一された固定並列数を公開していません。そのため、ネット上で見かける「並列数10」「並列数50」といった数字には、根拠がありません。
この記事で得られること:RPM、TPM、消費速度、上流の処理能力という4種類の429エラーの原因を見分け、指数バックオフやレート制限の実装方法を把握できます。また、APIYI(apiyi.com)の大規模並列処理向けチャネルを利用して、AI Studioの単一プロジェクトのクォータによるボトルネックを回避する方法も紹介します。
gemini-4-argon の重要ポイント
まず、この記事の結論を表にまとめました。各項目の詳細は、後続のセクションで順に解説します。
| 要点 | 説明 | メリット |
|---|---|---|
| 公開された固定並列数はない | Googleはgemini-4-argon の統一された並列数上限を公開しておらず、RPM、TPM、RPDなどの指標に基づいてレート制限を行っています | 誤った数字を前提にしたキャパシティ計画を避けられる |
| RPMと並列数は別物 | 処理中のリクエスト数は、1分あたりのリクエスト数だけでなく、リクエストの平均処理時間にも左右されます | 必要な並列数を適切に見積もれる |
| 制限はプロジェクト単位 | 同じプロジェクトで複数のキーを作成しても、クォータは増えません | キーの切り替えに時間を費やさずに済む |
| 10分間の消費上限 | Tier 1は$10、Tier 2は$50、Tier 3は$200です | 「RPMを超えていないのに429が出る」現象を説明できます |
| 429には段階的な対応が必要 | まず元のレスポンスを確認し、レート制限、バックオフ、利用チャネルの切り替え、クォータの引き上げを順に行います | 優先順位に沿って問題を解決できます |
| APIYIの大規模並列処理向けチャネル | APIYI(apiyi.com)はgemini-4-argon の大規模並列処理に対応しており、RPMが500以下ならレート制限を気にせず利用できます | 中小規模のサービスなら、すぐに利用を始められます |
429エラーは、必ずしも並列数の超過が原因ではない
429を「並列数が多すぎる」と考える開発者は少なくありません。しかし、Googleのレート制限の仕組みでは、並列数は独立した指標ではありません。429 RESOURCE_EXHAUSTEDが発生する原因は、1分あたりのリクエスト数、1分あたりの入力トークン数、1日あたりのリクエスト数、10分間のローリング消費額、あるいは新モデルのリリース初期における上流の処理能力不足など、さまざまです。
gemini-4-argon はリリースからまだ1週間も経っておらず、上流リソースの増強も進行中です。そのため、クォータに十分な余裕があっても、容量が逼迫して一時的にリクエストが拒否されることがあります。429の原因を調べるときは、むやみに並列数を下げるのではなく、まずどの種類の制限に該当したのかを確認しましょう。
gemini-4-argon の AI Studio における同時実行数は?
結論:一律に適用される公開済みの固定値はありません。 AI Studio では、プロジェクトごとに gemini-4-argon の RPM、TPM、RPD の上限が設定されています。具体的な数値は Tier やプロジェクトの状態によって異なるため、管理画面で確認してください。
AI Studio における5種類の制限指標
Google の公式な制限の仕組みは、次の表のように整理できます。いずれかの上限に達すると、429 エラーが返される可能性があります。
| 制限指標 | 意味 | 429 の原因になるか |
|---|---|---|
| RPM | 1分あたりのリクエスト数 | なる |
| TPM | 1分あたりの入力トークン数 | なる |
| RPD | 1日あたりのリクエスト数 | なる |
| 消費速度 | 10分間のローリングウィンドウにおける API の消費額 | なる |
| 実際のサービス容量 | Google の上流側で利用可能なリソース | 可能性あり |
最後の項目に注意してください。容量不足は「パラメーターを調整しても解決できない」ケースです。トラフィックを減らす、時間をおいて再試行する、または別のチャネルに切り替えることで対処します。
RPM と同時実行数の関係
RPM は「1分間のリクエスト総数」、同時実行数は「同じ時点で処理中のリクエスト数」です。この2つはリクエストの処理時間によって関係します。たとえば、上限が60 RPMのプロジェクトの場合(あくまで計算例であり、Argon の実際の上限ではありません):
- リクエストの平均処理時間が5秒なら、理論上の平均処理中リクエスト数は約5件です。
- リクエストの平均処理時間が30秒なら、理論上の平均処理中リクエスト数は約30件です。
- 60件のリクエストを一斉に送ると、1分間の総数が上限内でも、短時間のレート制限や容量制限にかかる可能性があります。
3つ目のケースは、特に見落とされがちです。負荷テスト用のスクリプトで「一度にまとめて並列リクエストを送る」ケースは少なくありません。このような突発的なトラフィックは、一定のペースで送る場合よりもレート制限にかかりやすく、総リクエスト数が上限内であっても制限されることがあります。
管理画面で gemini-4-argon の実際の上限を確認する方法
Google AI Studio の Rate Limits ページ(aistudio.google.com/usage にアクセスし、rate-limit タブに切り替えます)を開いてください。公式のレート制限ドキュメント ai.google.dev/gemini-api/docs/rate-limits からも確認できます。対象のプロジェクトと gemini-4-argon を選ぶと、有効な RPM、TPM、RPD と現在の Tier を確認できます。
Google は、制限は API キーごとではなくプロジェクトごとに計算されると明記しています。つまり、同じプロジェクトで API キーをいくつ作成しても、上限が倍増することはありません。「複数の API キーをローテーションして容量を増やす」という方法は、AI Studio では使えません。
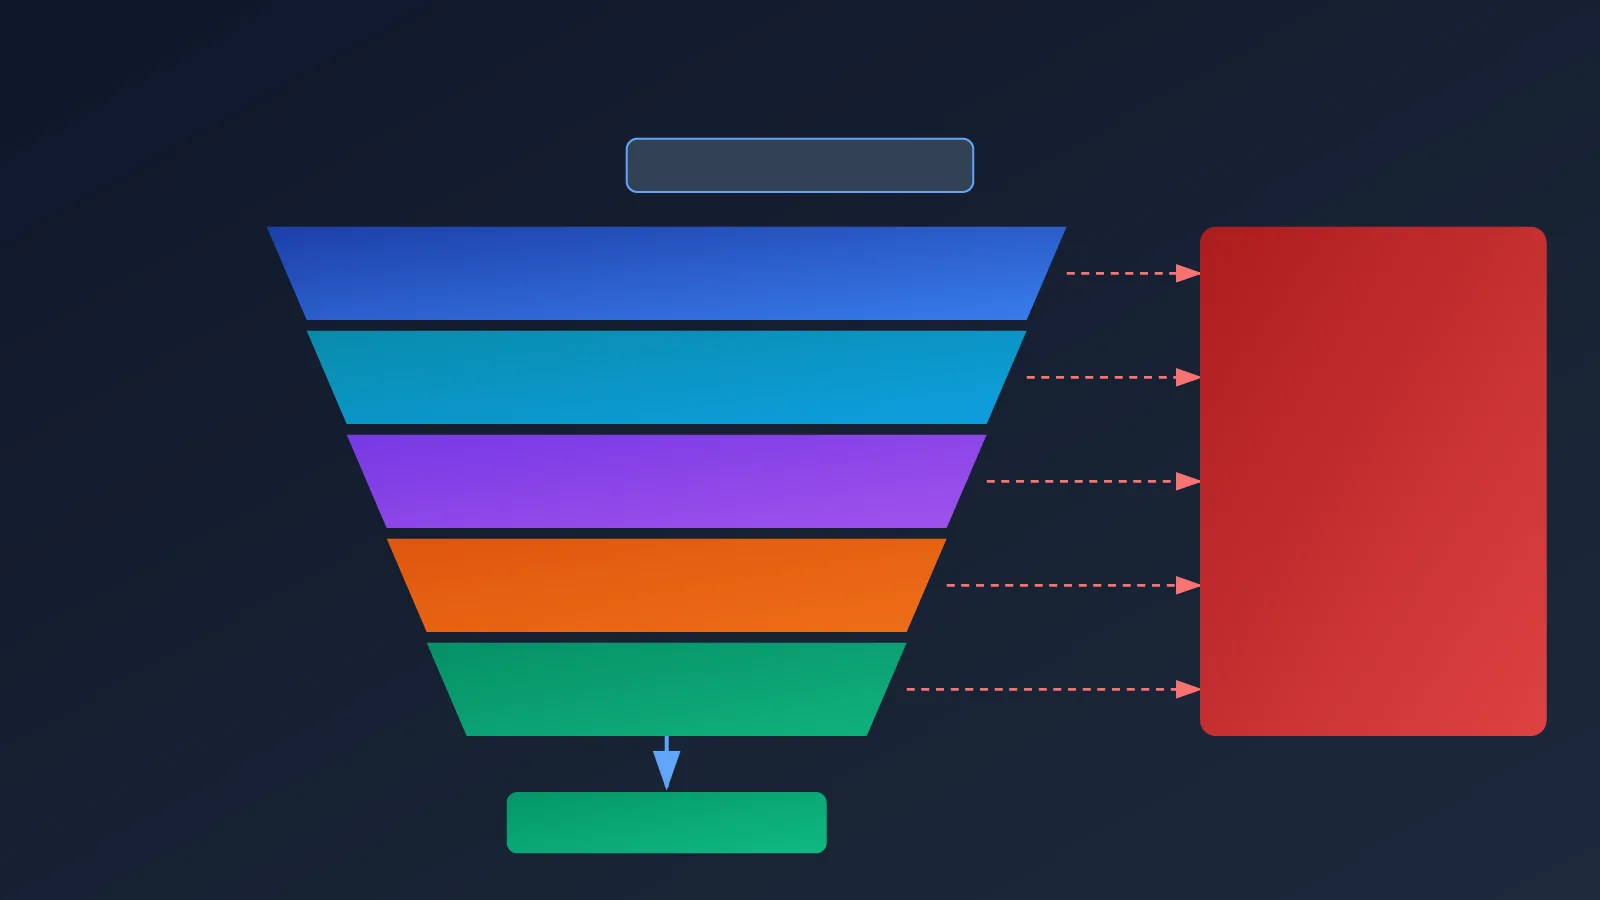
gemini-4-argonで429が頻発する5つの原因
制限指標を把握したところで、実際によくあるケースを見ていきましょう。gemini-4-argonで報告されている429エラーの大半は、次の5つの原因に当てはまります。
- 瞬間的なリクエストレートの超過:バッチ処理や負荷テストのスクリプトから一度に大量のリクエストを送ると、リクエストが集中し、RPMの瞬間的な処理能力を超えることがあります。
- TPMの上限到達:長いコンテキストや大きなドキュメントを入力すると、トークンを急速に消費します。リクエスト数が少なくても、先にTPMの上限に達することがあります。
- 10分間の消費上限到達:見落とされやすい制限です。詳しくは後述します。
- 1日のRPD上限到達:しばらく運用してから429が発生し始める場合、1日の割り当てを使い切った可能性があります。
- 上流側の処理能力不足:新モデルの公開直後はリソースが逼迫し、割り当てに余裕があってもリクエストが拒否されることがあります。
見落としやすい原因:10分間の消費上限
Googleの公式ドキュメントによると、2026年10月15日の更新時点で、アカウントの各Tierには10分間のローリングウィンドウ内での消費上限が設定されています。
| アカウントTier | 10分間の消費上限 |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
たとえば、Tier 1のアカウントで10分間の累計消費額が$10に達すると、RPMとTPMのどちらにも余裕があっても、429 RESOURCE_EXHAUSTEDが返されることがあります。次世代モデルであるgemini-4-argonは、旧モデルより1回あたりの呼び出しコストが高くなる可能性があります。長いコンテキストを使うリクエストでは消費額が急増しやすく、「リクエスト数は多くないのに制限される」よくある原因になっています。
また、Googleのドキュメントに記載されているArgon Batch APIの割り当ては、バッチ処理キューのトークン割り当てです。リアルタイムAPIの同時実行数の割り当てとして使うことはできません。
gemini-4-argonの429はどこで発生している?
現象によって原因は異なります。やみくもにパラメーターを調整するより、症状に応じて調べるほうが効率的です。
| 現象 | 優先して調べる項目 | 対処の考え方 |
|---|---|---|
| 同時実行数を上げるとすぐに429が頻発する | 瞬間的なリクエストレート、RPM、上流側の処理能力 | リクエストを均等に送る段階的な負荷テストを行う。同時実行数を固定しても、RPMが一定になるとは限りません |
| しばらく運用すると429が発生し始める | 10分間の消費上限、RPD、TPMの累積 | 消費額の推移と1日の割り当て使用量を確認する |
| 単一リクエストやごく低い同時実行数でも429が発生する | 上流側の処理能力不足、アカウントまたはプロジェクトの制限 | 元のレスポンスを確認し、利用するチャネルの切り替えを検討する |
| 複数のAPIキーで同時に429が発生する | 複数のAPIキーが同じプロジェクトに属し、割り当てを共有している | プロジェクト全体のトラフィックを減らすか、独立した割り当てを持つチャネルを利用する |
原因の切り分けで特に重要な情報は2つあります。1つ目は、AI StudioアカウントのTierが1、2、3のどれか。2つ目は、429エラーの元の内容です。特にerror.message、error.details、レスポンスヘッダーのRetry-Afterを確認してください。この2点があれば、アカウントの割り当て不足、リクエスト過多、Googleの新モデルArgon自体の供給不足のどれが原因か、ほぼ判断できます。原因によって適切な対処法はまったく異なります。
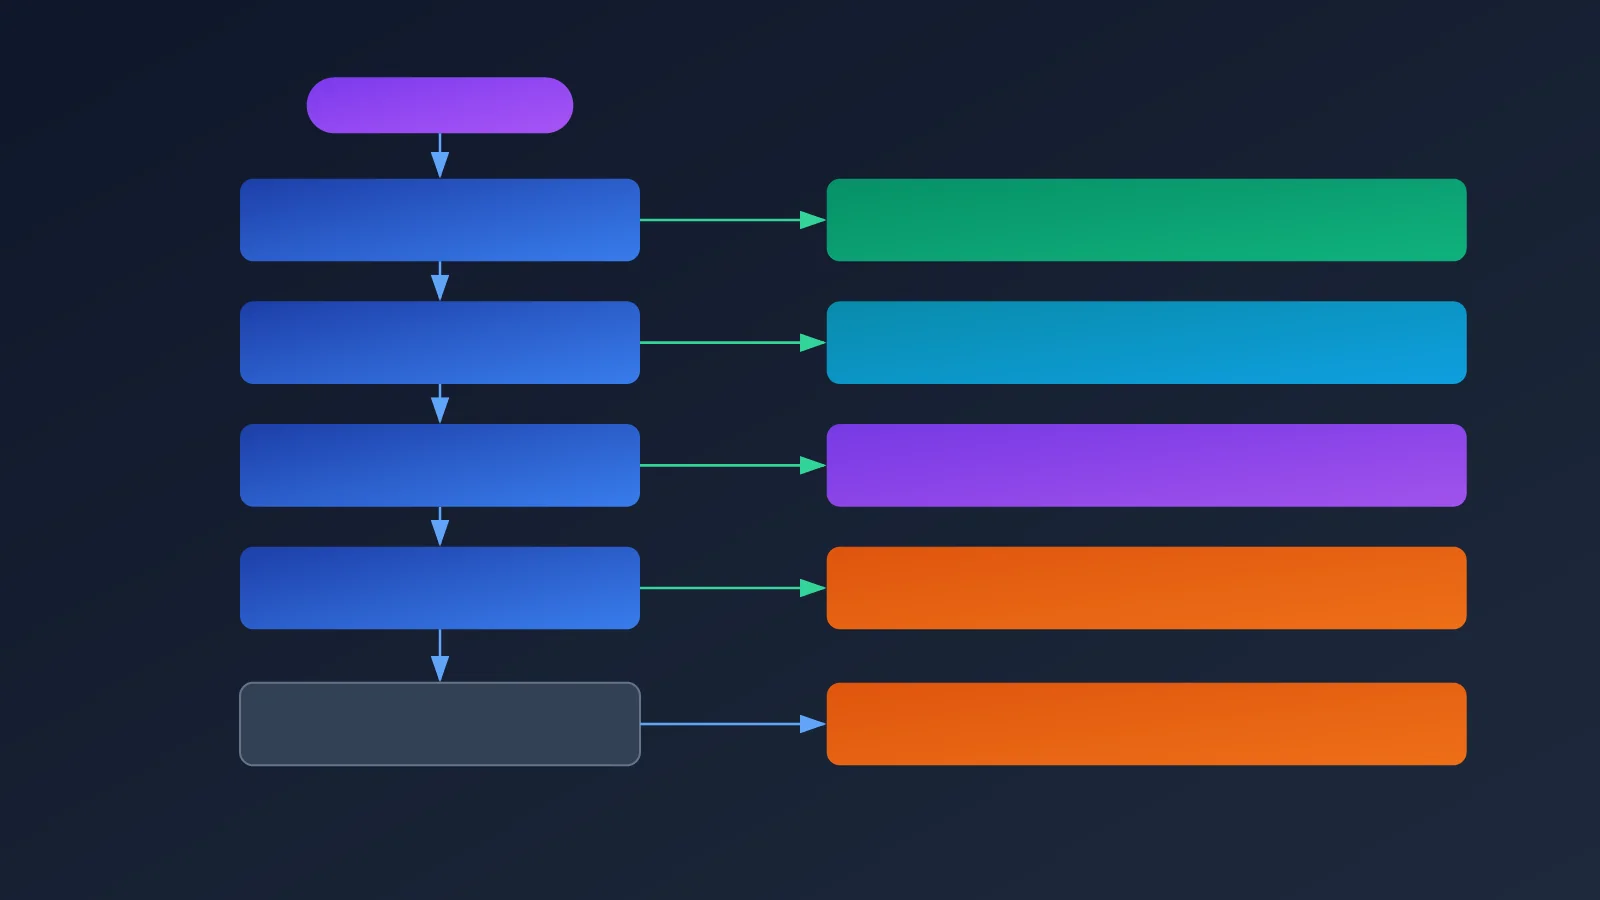
gemini-4-argon の 429 を解決する6つのステップ
以下では、実際の対応優先度に沿って対策を紹介します。P0は最初に必ず行うべき対応、P2は長期的な計画です。
| 優先度 | 対策 | 効果 |
|---|---|---|
| P0 | 429の元のレスポンスとRetry-Afterを確認する |
具体的なレート制限の原因を特定する |
| P0 | プロジェクトごとにRPM、TPM、利用額を制限する | クォータ超過の継続を防ぐ |
| P0 | 429発生時に指数バックオフで再試行し、ランダムなジッターを加える | 突発的なレート制限を緩和する |
| P1 | 429発生時に、独立したクォータを持つ正常なチャネルへ自動で切り替える | 成功率を高める |
| P1 | Tierをアップグレードするか、Googleに上限引き上げを申請する | 長期的な処理能力を増やす |
| P2 | Vertex AIや、ほかの正規の認可を受けたチャネルを検討する | リソースの供給を拡大する |
ステップ1:429の元のレスポンスを確認する
ステータスコードを見るだけですぐに再試行するのは避けましょう。まず、エラーボディとレスポンスヘッダー全体を出力し、error.message、error.details、Retry-Afterを確認します。上流サービスから待機時間が指定されている場合は、自分で間隔を決めるのではなく、まずその時間に従いましょう。
ステップ2:クライアント側で事前にレート制限する
RPMは管理画面で確認できる上限の70〜80%に抑え、TPMは別途管理します。また、10分間の利用額も監視しましょう。余裕を持たせることで、トラフィックの急増や上流サービスの変動に備えられます。リクエスト数だけを制限し、トークン数や利用額を見落としているチームは少なくありません。その結果、「RPMは超えていないのに拒否される」という状況が起きます。
ステップ3:指数バックオフとランダムなジッターを使う
Googleは429が発生した場合、1秒、2秒、4秒、8秒のように待機時間を延ばす指数バックオフを推奨しています。さらにランダムなジッターを加えることで、大量のリクエストが同時に再試行され、二次的な混雑が起きるのを防げます。再試行は最大2〜3回とし、上流から再試行時間が返された場合は、そちらを優先してください。
ステップ4:429が続く場合はチャネルを切り替える
同じプロジェクトで429が続く場合は、そこでの再試行を続けないでください。レート制限をさらに悪化させるだけです。正しくは、トラフィックを減らすか、独立したクォータを持つ正常なチャネルに切り替えます。集約サービスを利用するメリットは、まさにここにあります。APIYI(apiyi.com)経由で呼び出せば、リクエストを複数の独立したクォータを持つチャネルに分散できるため、単一のAI Studioプロジェクトに負荷を集中させずに済みます。
ステップ5:Tierのアップグレードまたは上限引き上げを申請する
長期的な容量不足は、アカウントのTierをアップグレードするか、Googleに上限引き上げを申請して解決する必要があります。Tierが上がるとRPMやTPMの上限が緩和されるだけでなく、10分間の利用上限も$10から$50、さらに$200へと引き上げられます。ただし、上限引き上げには時間と利用実績が必要なため、通常はサービスのリリース予定に間に合いません。
ステップ6:ほかの正規の認可を受けたチャネルを検討する
ビジネスの規模が継続的に拡大する場合は、Vertex AIやほかの正規の認可を受けたチャネルを検討し、リソースの供給を拡大できます。単一障害点のリスクを抑えるには、複数のチャネルを並行して利用する方法も有効です。
新しいチャネルを導入する際の負荷テスト
Argonのチャネルを新たに導入する場合は、まず並列数を5〜10に設定して負荷テストを行うことをおすすめします。これは初期テスト用の設定であり、公式の並列数上限ではない点にご注意ください。その後、段階的に負荷を増やし、各段階でリクエストを均等に送信します。プロバイダー、Googleプロジェクト、モデルごとに429の発生率、実際のRPM、TPM、10分間の利用額、リクエスト時間を記録し、安定していることを確認してから次の段階に進みましょう。
gemini-4-argon をすぐに試す:APIYI経由で呼び出す
理論の説明はここまでにして、コードを見てみましょう。APIYIはOpenAI互換のインターフェースを提供しているため、base_urlを変更するだけでgemini-4-argonを呼び出せます。
最小限のサンプル
以下の10数行のコードで、呼び出しを実行できます。
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェースを使用
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
完全なコードを表示:指数バックオフ、ランダムなジッター、Retry-Afterに対応した並列呼び出し
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIの統一インターフェースを使用
)

MAX_RETRIES = 3       # 再試行は最大2〜3回
BASE_DELAY = 1.0      # 指数バックオフの開始値:1、2、4、8秒


def call_argon(prompt: str) -> str:
    """gemini-4-argonを呼び出し、429発生時は指数バックオフを行い、Retry-Afterを優先する"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 上流から返されたRetry-Afterを優先する
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 集団での再試行を避けるため、ランダムなジッターを加える
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 並列数5から負荷テストを開始する。公式の上限ではない
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
すぐに試す:APIYI(apiyi.com)に登録してAPIキーを取得し、上記のコードでgemini-4-argonの呼び出しを確認する方法がおすすめです。OpenAI互換の統一インターフェースを利用できるため、複数のGoogleプロジェクトを自分で申請・管理する必要はありません。
クライアント側でレート制限する簡単な方法
再試行だけでなく、「レート制限にぶつからないようにする」ことも重要です。以下は、トークンバケット方式を参考にしたシンプルなレートリミッターです。リクエストの間隔を均一にし、急激な負荷の集中を防ぎます。
import threading
import time


class RateLimiter:
    """指定したRPMに合わせてリクエストを均等に許可し、瞬間的な負荷の集中を防ぐ"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 管理画面の上限の70〜80%を目安に設定

# 呼び出しのたびに実行する:
# limiter.wait()
呼び出し関数の入口にレートリミッターを置き、前述のバックオフ再試行と組み合わせることで、「事前のレート制限」と「事後のバックオフ」の二重の保護を実現できます。
APIYIのgemini-4-argon大規模同時実行チャネル
AI Studioに直接接続する際のボトルネックは、1つのプロジェクトに割り当てられるクォータが固定されていることです。Tier 1アカウントでは、10分間の利用額が10ドルを超えないようにする必要もあります。一方、API集約サービスなら、トラフィックをそれぞれ独立したクォータを持つ複数のチャネルに分散できます。特定のチャネルで429エラーが続いた場合も、正常なチャネルへ自動で切り替えられます。
APIYI(apiyi.com)では現在、大規模同時実行に対応したgemini-4-argonを提供しています。RPM 500以下なら、レート制限をほとんど気にせず利用できます。ぜひお試しください。 ほとんどの中小規模アプリや社内ツール、自動化ワークフロー、テスト・負荷試験であれば、この範囲で日常的なニーズを十分にカバーできます。Tier、プロジェクトのクォータ、10分間の利用額制限を気にする必要はありません。
| 比較項目 | AI Studioに直接接続 | APIYI経由で呼び出し |
|---|---|---|
| クォータの割り当て | 1つのプロジェクトを複数のキーで共有 | 複数のチャネルに独立したクォータがあり、プラットフォームが振り分け |
| 429エラーへの対応 | バックオフや切り替えを自前で実装 | プラットフォーム側で正常なチャネルへ優先的に切り替え。クライアント側は基本的なリトライで対応可能 |
| 利用額制限 | Tierごとの10分間の利用額上限が適用される | GoogleアカウントのTierを自分で管理する必要なし |
| 接続方法 | プロジェクトの申請とTierの設定が必要 | OpenAI互換の統一インターフェース。base_urlを差し替えるだけ |
| 適した規模 | トラフィックが少ない場合、または上位Tierにアップグレード済みの場合 | RPM 500以下ならレート制限を気にせず利用可能 |
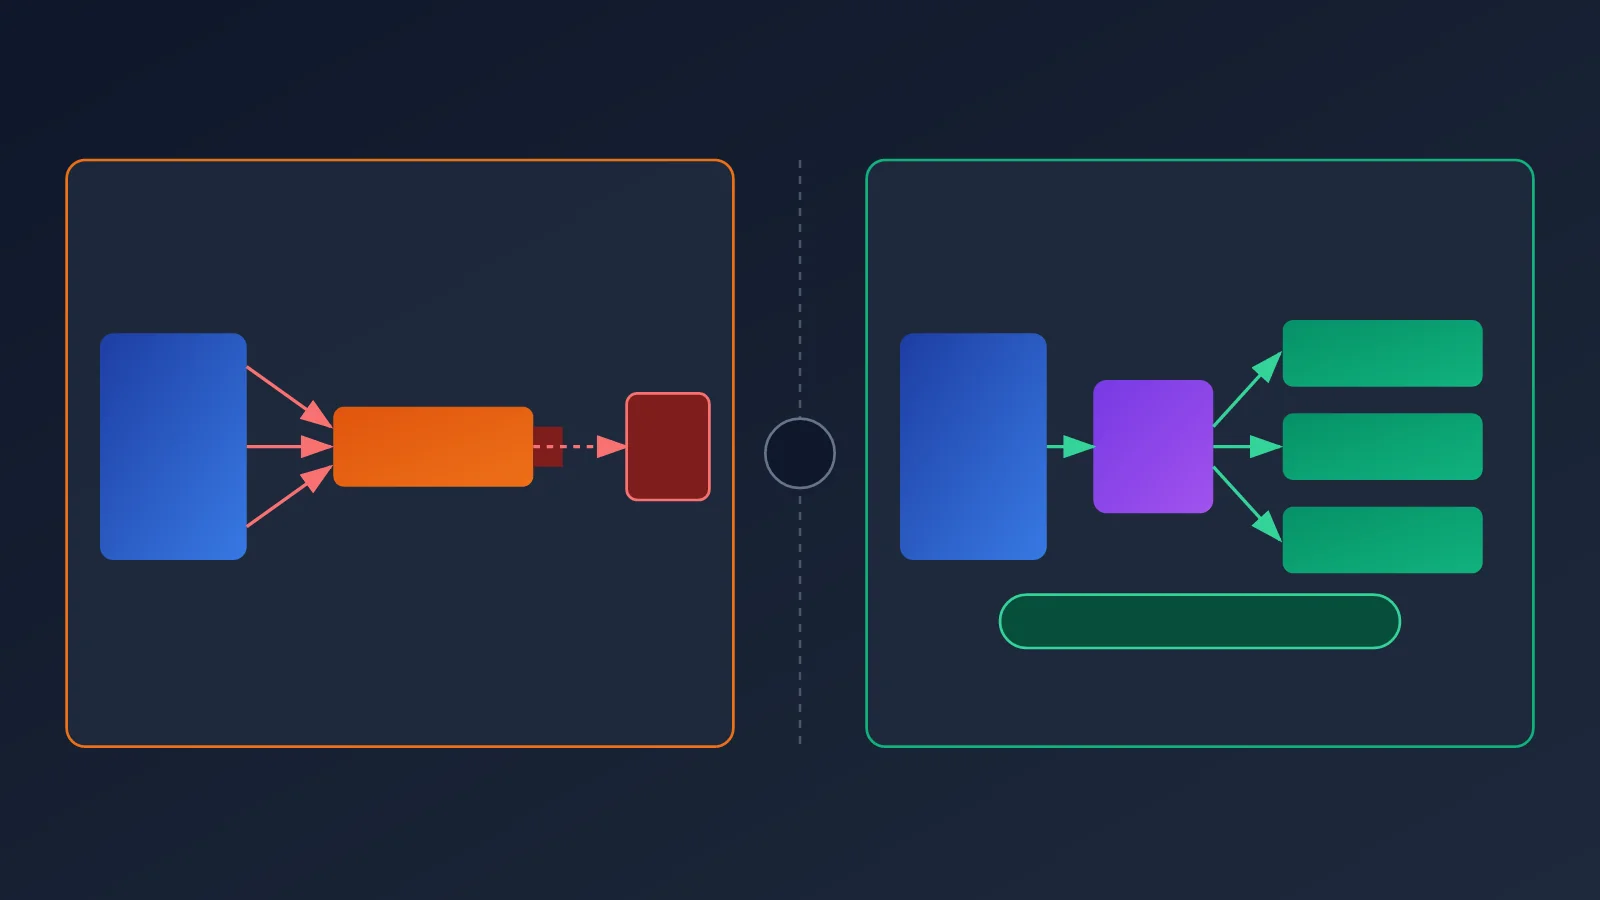
🎯 技術的なアドバイス:業務のピーク時のトラフィックがRPM 500以内であれば、APIYI(apiyi.com)経由でgemini-4-argonを呼び出し、業務ロジックの開発に集中できます。想定トラフィックがこの範囲を超える場合は、段階的に負荷試験を行い、早めにプラットフォームへ容量について相談しておくことをおすすめします。
大規模同時実行チャネルを利用する場合も、クライアント側で指数バックオフを設定し、適切なタイムアウトを設けておくと安心です。ネットワークの揺らぎや上流側の一時的な不安定さは起こり得ます。適切なリトライ処理を実装しておけば、極端な状況でもサービスを安定して稼働させやすくなります。
よくある質問(FAQ)
Q1: gemini-4-argon の AI Studio 上での同時実行数は、実際どのくらいですか?
Google は、統一された固定の同時実行数を公開していません。実際の制限は、プロジェクトの RPM、TPM、RPD、および 10 分間の消費上限によって決まります。AI Studio の Rate Limits ページで対象のプロジェクトとモデルを選択し、確認してください。ネット上で広まっている具体的な同時実行数には公式の根拠がないため、キャパシティ計画の参考にするのはおすすめしません。
Q2: APIキーを複数作成すれば、gemini-4-argon の割り当てを増やせますか?
増やせません。Google は、制限が APIキーごとではなくプロジェクトごとに適用されると明示しています。同じプロジェクト内の複数のキーは、同じ割り当てを共有します。独立した割り当てを確保するには、別々の Google プロジェクトを用意するか、APIYI(apiyi.com)のような複数チャネルを統合したサービスを利用する必要があります。
Q3: RPM と TPM の上限を超えていないのに、429 が返されるのはなぜですか?
最もよくある原因は、10 分間の消費上限に達していることです。Tier 1 は $10、Tier 2 は $50、Tier 3 は $200 です。また、新モデルの公開直後は上流の処理容量が不足し、割り当て内のリクエストでも拒否されることがあります。原因を確認するには、元のエラーレスポンスに含まれる `error.details` も確認してください。
Q4: 429 が発生したとき、どのように再試行するのが適切ですか?
1、2、4、8 秒のように待機時間を段階的に延ばす指数バックオフを採用し、ランダムな揺らぎを加えてください。再試行は最大 2~3 回とし、レスポンスヘッダーに `Retry-After` が含まれている場合は、その値を優先します。同じプロジェクトで 429 が続く場合は、再試行を続けるのではなく、トラフィックを減らすか、独立した割り当てを利用できるチャネルに切り替えてください。
Q5: APIYI を使って gemini-4-argon をすばやく呼び出すにはどうすればよいですか?
1. APIYI(apiyi.com)にアクセスしてアカウントを登録し、APIキーを取得します。
2. コード内の `base_url` を `https://api.apiyi.com/v1` に設定します。
3. モデル名を `gemini-4-argon` に設定すれば、この記事のサンプルコードを実行できます。
APIYI は gemini-4-argon の大規模な同時実行に対応しています。RPM 500 以下であれば、レート制限をほとんど気にせず利用でき、すばやい検証や中小規模の本番運用に適しています。
Q6: APIYI を使えば、429 は発生しなくなりますか?
RPM 500 以下の通常の利用範囲であれば、レート制限をほとんど気にせず利用できます。ただし、上流サービスでは一時的な変動が起きる可能性があるため、基本的な指数バックオフによる再試行は引き続き設定しておくことをおすすめします。業務トラフィックがこの範囲を超える場合は、段階的な負荷テストを行い、APIYI(apiyi.com)を通じてプラットフォーム側にキャパシティを確認してください。
Q7: Batch API の割り当てを、リアルタイムの同時実行数の参考にできますか?
できません。Google のドキュメントに記載されている Argon Batch API の割り当ては、バッチ処理キューのトークン数に関するものです。オフラインの一括処理に使われるもので、リアルタイム API の同時実行数や RPM の制限とは別の仕組みです。相互に当てはめることはできません。
gemini-4-argon の 429 対策:重要なポイント
- 固定の同時実行数はない:Google は gemini-4-argon の統一された同時実行上限を公開していません。実際の割り当ては管理画面で確認してください。
- RPM と同時実行数は別の指標:同時実行数はリクエストの処理時間によって変わります。一定のペースで送る場合より、トラフィックが急増したときのほうがレート制限に達しやすくなります。
- 制限はプロジェクト単位:APIキーを増やしても容量は増えず、同じプロジェクト内で割り当てを共有します。
- 10 分間の消費上限に注意:Tier 1~Tier 3 の上限はそれぞれ $10、$50、$200 です。RPM の上限を超えていなくても、429 が返されることがあります。
- バックオフ・流量制御・切り替えを組み合わせる:ランダムな揺らぎを加えた指数バックオフを行い、429 が続く場合は独立した割り当てを利用できるチャネルに切り替えてください。
- 大規模な同時実行も手軽に:APIYI(apiyi.com)は gemini-4-argon の大規模な同時実行に対応しており、RPM 500 以下であればレート制限をほとんど気にせず利用できます。
まとめ
gemini-4-argon で AI Studio 上の 429 エラーが頻発する主な原因は、「同時実行数が少なすぎる」ことではありません。RPM、TPM、RPD、10分間の消費速度、新モデルの上流側の容量など、複数の制限が重なっているためです。対策も段階的に進めましょう。まず元のレスポンスを確認し、こちらからリクエスト速度を制限します。そのうえで、指数バックオフとランダムなジッターを組み合わせ、429 が続く場合は別のチャネルに切り替えます。長期的には、Tier のアップグレードや利用可能なチャネルの拡大によって容量を増やす方法があります。
配額を気にせず開発に集中したい方には、API集約サービスの活用が現実的です。APIYI(apiyi.com)を利用すれば、手軽に動作を検証できます。gemini-4-argon の大規模な同時呼び出しに対応しており、RPM 500以下であれば安心してご利用いただけます。ぜひお試しください。
参考資料
- Google AI Studio の使用量とレート制限ページ: プロジェクト単位の RPM、TPM、RPD、Tier を確認できます
- リンク:
aistudio.google.com/usage -
説明:プロジェクトと gemini-4-argon を選択すると、実際の配額を確認できます
-
Gemini API のレート制限に関するドキュメント: 公式のレート制限の仕組みと、429 エラーへの対処方法を確認できます
- リンク:
ai.google.dev/gemini-api/docs/rate-limits - 説明:10分間の消費上限や、指数バックオフに関する推奨事項が記載されています
著者: APIYI Team
技術的な情報交換: gemini-4-argon の 429 エラーの調査・対処経験について、ぜひコメント欄でご共有ください。接続に関する資料は APIYI のドキュメントセンター(docs.apiyi.com)をご覧ください。