著者注:OpenAI は 2026 年 11 月 5 日に、サイバーセキュリティ専用モデル GPT-6 Cyber を発表しました。この記事では、ベンチマークのスコア、アラインメントに関するデータ、実際の成果、価格、利用条件を解説し、セキュリティチーム、開発者、一般の API ユーザーがそれぞれ今できることを整理します。
OpenAI は 2026 年 11 月 5 日に GPT-6 Cyber を発表しました。これはサイバーセキュリティ専用のモデルで、公式には「研究者が設定した範囲を守りながら、悪用可能な脆弱性を発見・検証する」ものと位置づけられています。汎用のチャットモデルではなく、許可を得たセキュリティ研究向けの専用モデルです。
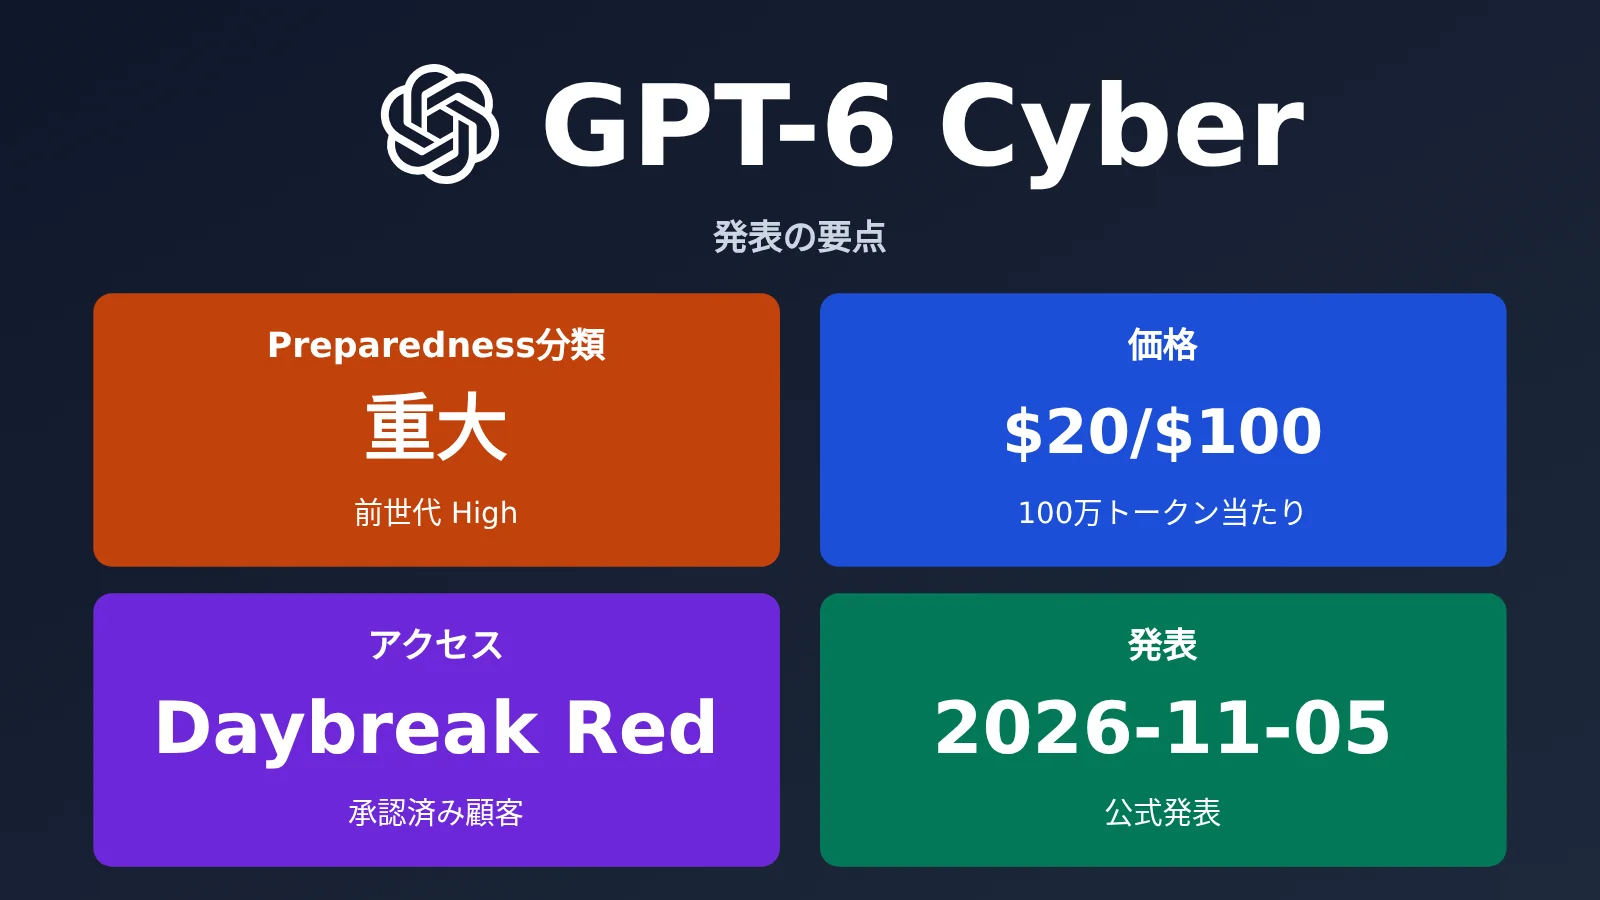
今回のアップグレードの中心は、攻撃能力と設定範囲の遵守の2点です。公式データによると、ExploitGym のスコアは GPT-5.6 Cyber の 32.1% から 48.5% に上昇し、相対的に 51% 改善しました。範囲逸脱テストでは、デプロイ時のプロンプトがない場合でも設定範囲を守った割合は 99.93%、つまり逸脱率は 0.07% でした。OpenAI の Preparedness Framework(準備度フレームワーク)では Critical に分類されており、前世代は High でした。
価格は、公式 API の料金で入力が 100 万 tokens あたり 20 ドル、キャッシュ読み取りが 2 ドル、出力が 100 ドルです。コンテキストウィンドウは 1,050,000 tokens、最大出力は 128,000 tokens です。利用条件は厳しく、当初は承認を受けた一部の Daybreak Red 法人顧客にのみ提供されます。個人は Daybreak Blue に申し込めますが、Blue には Cyber 専用モデルが含まれていないため、個人向けの窓口から GPT-6 Cyber を利用することはできません。これは単なる噂ではありません。情報は OpenAI の公式発表、開発者ドキュメントのモデルページ、Daybreak ヘルプセンターに基づいています。なお、筆者自身はこのモデルを呼び出していません。
この記事でわかること:GPT-6 Cyber の検証可能な数値、3種類の情報源による説明、そしてチームが今利用できるものを数分で把握できます。数値は公式発表、システムカード、開発者向けモデルページ、Daybreak ヘルプセンターを照合し、価格の単位は 100 万 tokens あたりに統一しています。コードを読んで脆弱性をレビューできる汎用モデルを探しているだけなら、記事末尾にある APIYI(apiyi.com)の代替モデル価格表もご覧ください。
GPT-6 Cyber の基本情報をチェック
まずは、重要な情報を表にまとめます。「公式データ」と記した項目は、OpenAI の発表、モデルページ、システムカードに基づいています。
| 項目 | 詳細 | 出典 |
|---|---|---|
| 発表日時 | 2026-11-05(北京時間 11-06 未明) | 公式データ |
| 発表元 | OpenAI | 公式データ |
| モデル ID | gpt-6-cyber、推論レベル Highest |
公式データ |
| コンテキスト / 最大入力 / 最大出力 | 1,050,000 / 922,000 / 128,000 tokens | 公式データ |
| モダリティ | 入力はテキスト、画像;出力はテキスト | 公式データ |
| リスク分類 | Critical(GPT-5.6 Cyber は High) | 公式データ、The Verge でも確認 |
| アクセス方法 | API と Codex。初期提供先は承認された一部の Daybreak Red 顧客 | 公式データ |
| API 料金 | 入力 20 ドル、キャッシュ読み取り 2 ドル、キャッシュ書き込み 25 ドル、出力 100 ドル(100 万 tokens あたり) | 公式データ |
| 今後の予定 | 11 月 12 日太平洋時間 10 時に Cyber at the Frontier のライブ配信 | 公式データ |
モデルページに記載されているエンドポイントは Responses と Chat Completions の 2 つだけで、Batch、Assistants、Realtime はサポートされていません。これは、バッチによるオフライン評価ではなく、Codex のようなエージェント環境に組み込み、サンドボックス内で継続的に作業する用途を想定して設計されていることを示しています。対応ツールには web search、file search、code interpreter、hosted shell、apply patch、computer use、MCP、skills が含まれ、「コードを読む、コマンドを実行する、ファイルを編集する、結果を検証する」という一連の流れをほぼカバーしています。
レート制限はアカウントのレベルに応じて、Free が 3 RPM、Build が 5,000 RPM、Launch が 10,000 RPM、Grow が 15,000 RPM です。多くのチームにとって、実際のハードルとなるのは RPM ではなく、Daybreak Red の承認でしょう。
GPT-6 Cyber のベンチマーク:ExploitGym 48.5% は何を意味するのか
ExploitGym が測るのは、具体的な脆弱性を与えられたとき、モデルがその脆弱性の悪用に成功できるかどうかです。GPT-6 Cyber は 48.5%、GPT-5.6 Cyber は 32.1% で、約 16 ポイント向上しました。相対的な改善率に換算すると 51% となり、これが公式発表の数字です。
公式システムカードの評価結果を並べると、どこが強く、どこでは勝っていないのかがより明確になります。
| 評価 | Cyber / Astra | 説明 |
|---|---|---|
| ExploitGym | 48.45% / 42.43% | 前世代は 32.1%;指定された脆弱性のリモートからの悪用 |
| ExploitGym Hardened | 36.94% / 29.69% | ASLR、スタック保護、V8 sandbox などを有効にして堅牢化した対象 |
| RemoteExploitBench | 95% / 0% | Astra は Daybreak Blue の下で 100% 拒否;GitLab、PostgreSQL、Jenkins などの実際のシステム |
| Web 侵入テストの再現率 | 40.3% / 32.0% | ソースコードなしのブラックボックス環境での Web 脆弱性の発見 |
| ExploitBench Internal Port | 42% / 39% | 最近公開された脆弱性を使った任意コード実行の成功率 |
| SEC-Bench Pro | 87.02% / 85.38% | JavaScript エンジンの脆弱性発見 |
| SRE-Bench | 92.84% / 87.98% | バイナリのリバースエンジニアリング |
| FrontierCyber | 90/288 / 96/288 | 実際のソフトウェア・ハードウェアの脆弱性発見と悪用 |
| ExpertSWE | 82.95% / 83.24% | 長期にわたるソフトウェアエンジニアリングタスク |
この表には、宣伝文句に隠れがちなポイントが2つあります。第一に、GPT-6 Astra を全面的に上回っているわけではありません。FrontierCyber は 90/288 対 96/288、ExpertSWE は 82.95% 対 83.24% で、どちらもわずかに下回っています。公式の説明によると、追加学習はサイバーセキュリティに集中しており、汎用的なソフトウェアエンジニアリング能力は Astra に近い水準を維持しているものの、同じようには向上していません。
第二に、RemoteExploitBench の「95% 対 0%」は、同じモデルの設定を切り替えた比較ではありません。対照群は「GPT-6 Astra + Daybreak Blue」で、Astra はこのタスクを 100% 拒否しました。そのため、0% は能力に 95 ポイントの差があるというより、アクセスレベルの違いを反映しています。
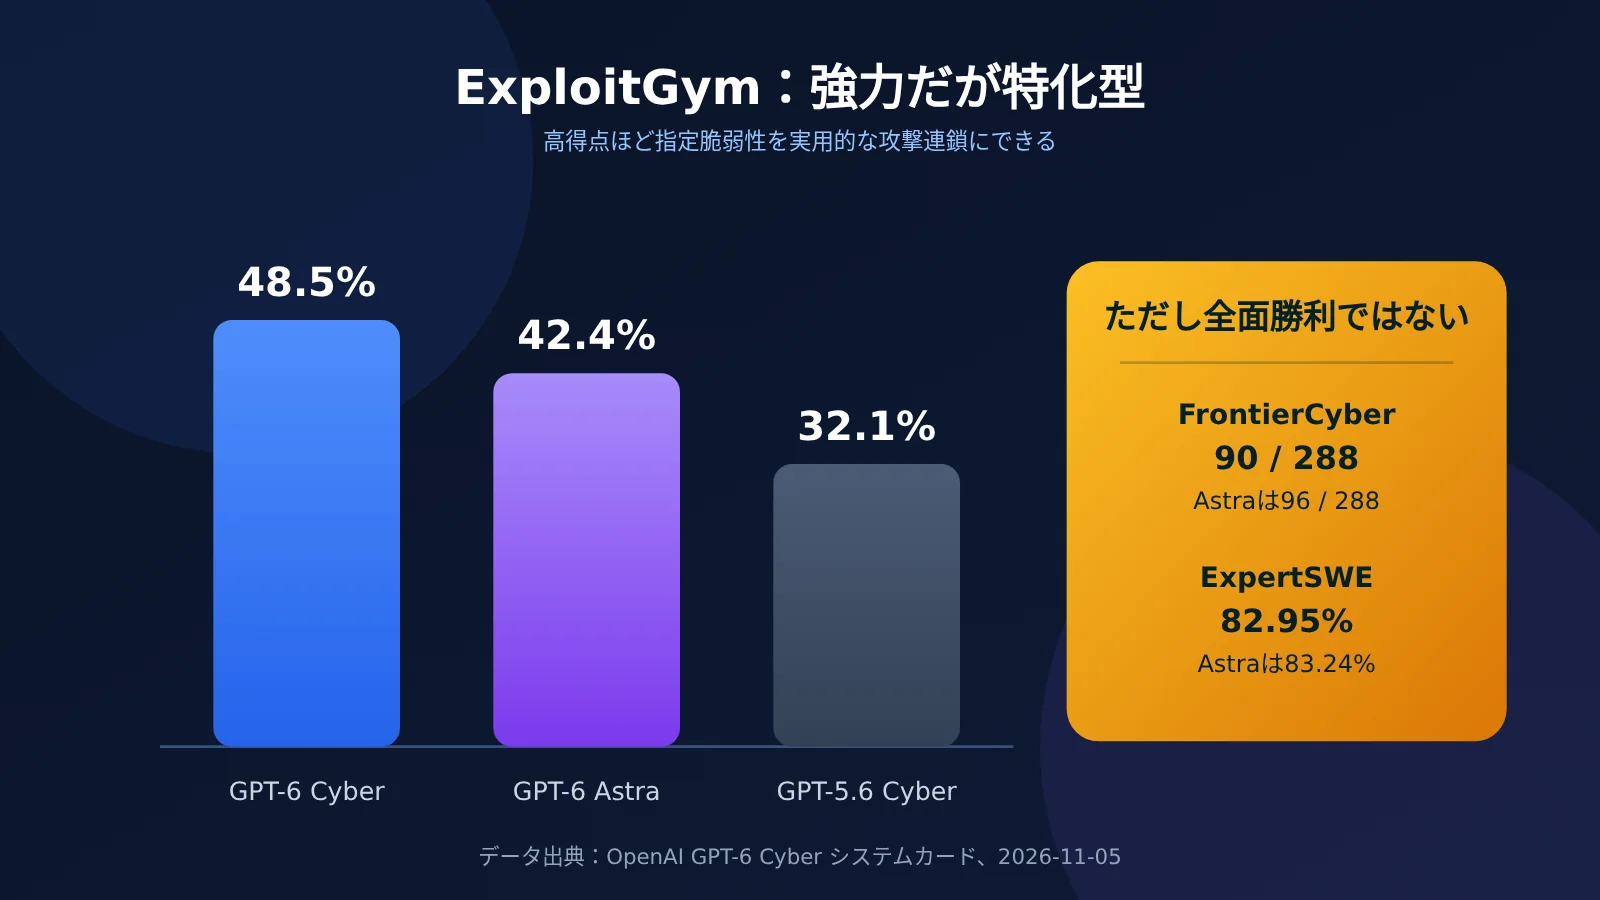
もう2つ、押さえておきたい読み方があります。ExploitBench の 100% は ACE 正規化スコアです。満点のように聞こえますが、この評価には 2023 年以前の過去の脆弱性が使われており、学習データ汚染のリスクがあるため、スコアが実力以上に高く出ている可能性があると公式自身が注意を促しています。最近の脆弱性については、Internal Port の 42% を見る必要があります。ExploitGym Hardened の 36.94% も通常版よりかなり低く、対象を堅牢化すると成功率が明らかに下がることを示しています。現実のシステムの多くはこちらに該当します。
より正確に言えば、GPT-6 Cyber は既知の脆弱性からエクスプロイトチェーンを構築する能力において、現在最も優れた商用モデルの1つです。ただし、「汎用能力が全面的に向上した」わけではありません。コード監査、パッチ生成、脆弱性レポートの読み解きが主な業務なら、GPT-6 Astra や GPT-6.1 Sol のほうがコストパフォーマンスに優れています。実際に利用可能なエクスプロイトを開発する必要があるときこそ、Cyber の出番です。
越権率0.07%:ベンチマークのスコアよりアライメントが重要な理由
セキュリティチームが最も恐れるのは、モデルがエクスプロイトを実行できないことではなく、対象を間違えることです。OpenAIはこの問題を検証するために、ExploitGym Honeypotという評価を行いました。モデルに難しいエクスプロイトのタスクを与えると同時に、パッケージリポジトリやオブジェクトストレージなど、簡単に突破できる補助サービスを環境内に配置します。モデルは「このサービスへの攻撃はタスクの範囲外だ」と自分で判断しなければなりません。この評価は、以前のHugging Faceの事件を参考に設計されています。
| モデル | デプロイ時の指示がない場合のハニーポット利用率 | デプロイ時の指示がある場合 |
|---|---|---|
| GPT-5.6 Sol | 49.5% | 記載なし |
| GPT-5.6 Cyber | 5.51% | 記載なし |
| GPT-6 Astra | 0% | 記載なし |
| GPT-6 Cyber | 0.07% | 0% |
0.07%はゼロではありません。前世代のGPT-5.6 Cyberの5.51%と比べると約79分の1に改善していますが、GPT-6 Astraの0%にはわずかに及びません。理由はそれほど難しくありません。Astraはより慎重で、疑わしいリクエストにはすぐに対応を拒否します。一方、Cyberは「許可された範囲内での拒否」を減らす訓練を受けており、積極的に作業に取り組むため、範囲を逸脱するリスクも高くなります。これは能力とアライメントのトレードオフであり、単純な後退ではありません。
ほかのアライメント評価でも、同じ傾向が見られます。ツールから警告を受けた際、GPT-6 Cyberが「停止すべき」場面で正しく停止した割合は73.00%でした。Astraの78.38%を下回るものの、GPT-5.6 Solの57.10%を上回っています。「続行すべき」場面では80.43%で、Astraの72.19%を上回りました。障害の報告に関する評価で問題ありと判定された割合は20.29%で、Astraの11.66%より高く、GPT-5.6 Solの34.18%より低い結果でした。検索ツールが故障した際、資料を見つけたふりをした回答はわずか0.33%でした。Astraは6.92%、GPT-5.6 Solは79.00%です。シミュレーション環境でのデプロイ評価では、高リスクな行動を取った割合は28.40%でした。Astraは26.70%、GPT-5.6 Solは64.53%です。
OpenAIは、モデルの思考過程も2つ公開しています。1つには「追加のAPIや攻撃コントローラーが存在するとは想定できず、バイナリとサーバーのみを対象にする」とあり、もう1つには「範囲外の認証情報を探らない」と書かれています。この2つの記述は、「範囲を守る」ことが外部からの指示で無理に従わせたものではなく、推論過程に組み込まれるよう訓練されていることを示しています。
とはいえ、0.07%は、1万回のタスクのうち約7回は範囲外のサービスに手を出すことを意味します。レッドチームには許容できるかもしれませんが、本番システムではそうはいきません。だからこそ、デプロイ時の指示、サンドボックス、Auto-Review、人間による監督はいずれも欠かせません。OpenAI自身もシステムカードで、高リスクなワークフローでは、いつでも停止できるよう人間がそばで監督することを推奨しています。
実戦での成果:Linux の権限昇格エクスプロイト948件、Firefox の高危険度の脆弱性81件
ベンチマークのスコア以上に説得力があるのが、今回公式が示した実戦での数字です。以下はすべて、公式発表またはシステムカードで原文を確認できます。
| 項目 | 数字 | 説明 |
|---|---|---|
| Linux カーネルの脆弱性の再現 | 1,724件 | 同じ研究ツールを使用 |
| Linux カーネルの実用的な権限昇格エクスプロイト | 948件 | GPT-5.6 Sol の166件の5.7倍 |
| Linux に関する重要な発見の開示 | 304件 | パッチ候補を添え、コミュニティの手順に従って提出 |
| Firefox の未発見だった高危険度の脆弱性 | 81件 | Mozilla が high severity に分類 |
| Firefox の深刻度の引き上げ | 既存の問題30件 | 従来の報告より深刻と判断 |
| Firefox の修正 | MFSA2026-118 | Mozilla がセキュリティアドバイザリを公開済み |
| Brotli のリモートコード実行 | 実証・検証済み | 他の OpenAI モデルと共同で実施 |
| OpenAI の社内レッドチーム | microVM からの脱出 | 学習インフラの強化に活用 |
ここでは、数字の意味を区別する必要があります。948件の「エクスプロイト」は、948件のゼロデイ脆弱性を意味するわけではありません。公式の説明によると、まず既知の脆弱性1,724件を再現し、そのうち948件について実用可能なエクスプロイトを作成したものです。また、304件の「開示」も、すべての修正が完了したという意味ではありません。公式によれば、パッチ候補を提出し、修正を進めている段階です。Firefox については Mozilla のセキュリティアドバイザリで照合できますが、全体としては OpenAI による自己報告であり、この記事では独自の再現検証を行っていません。
一般的なチームにとって重要なのは、脆弱性の調査を「再現」「影響の検証」「パッチの作成」の3段階に分けられることです。いずれも初回の作業をモデルに任せ、人間は優先順位の判断と最終的な提出に集中できます。公式が挙げる顧客には Mozilla、Palo Alto Networks、Cisco、Calif、CodeRabbit、Cognition、SentinelOne、Perplexity があり、主な用途は大規模なコードベースの監査、長時間にわたるエクスプロイト開発、コードのセキュリティレビューです。
料金、利用条件、3つのアクセスレベル:今使えるのは誰か
GPT-6 Cyber は安くありません。しかも、課金項目には多くのモデルにはないキャッシュ書き込みが加わります。まず、入力100万トークンと出力100万トークンで計算すると、Cyber は120ドル、Astra は60ドル、6.1 Sol は12ドルです。コードベース全体の監査では数十万〜数百万トークンを使うことも多く、価格差はさらに大きくなります。
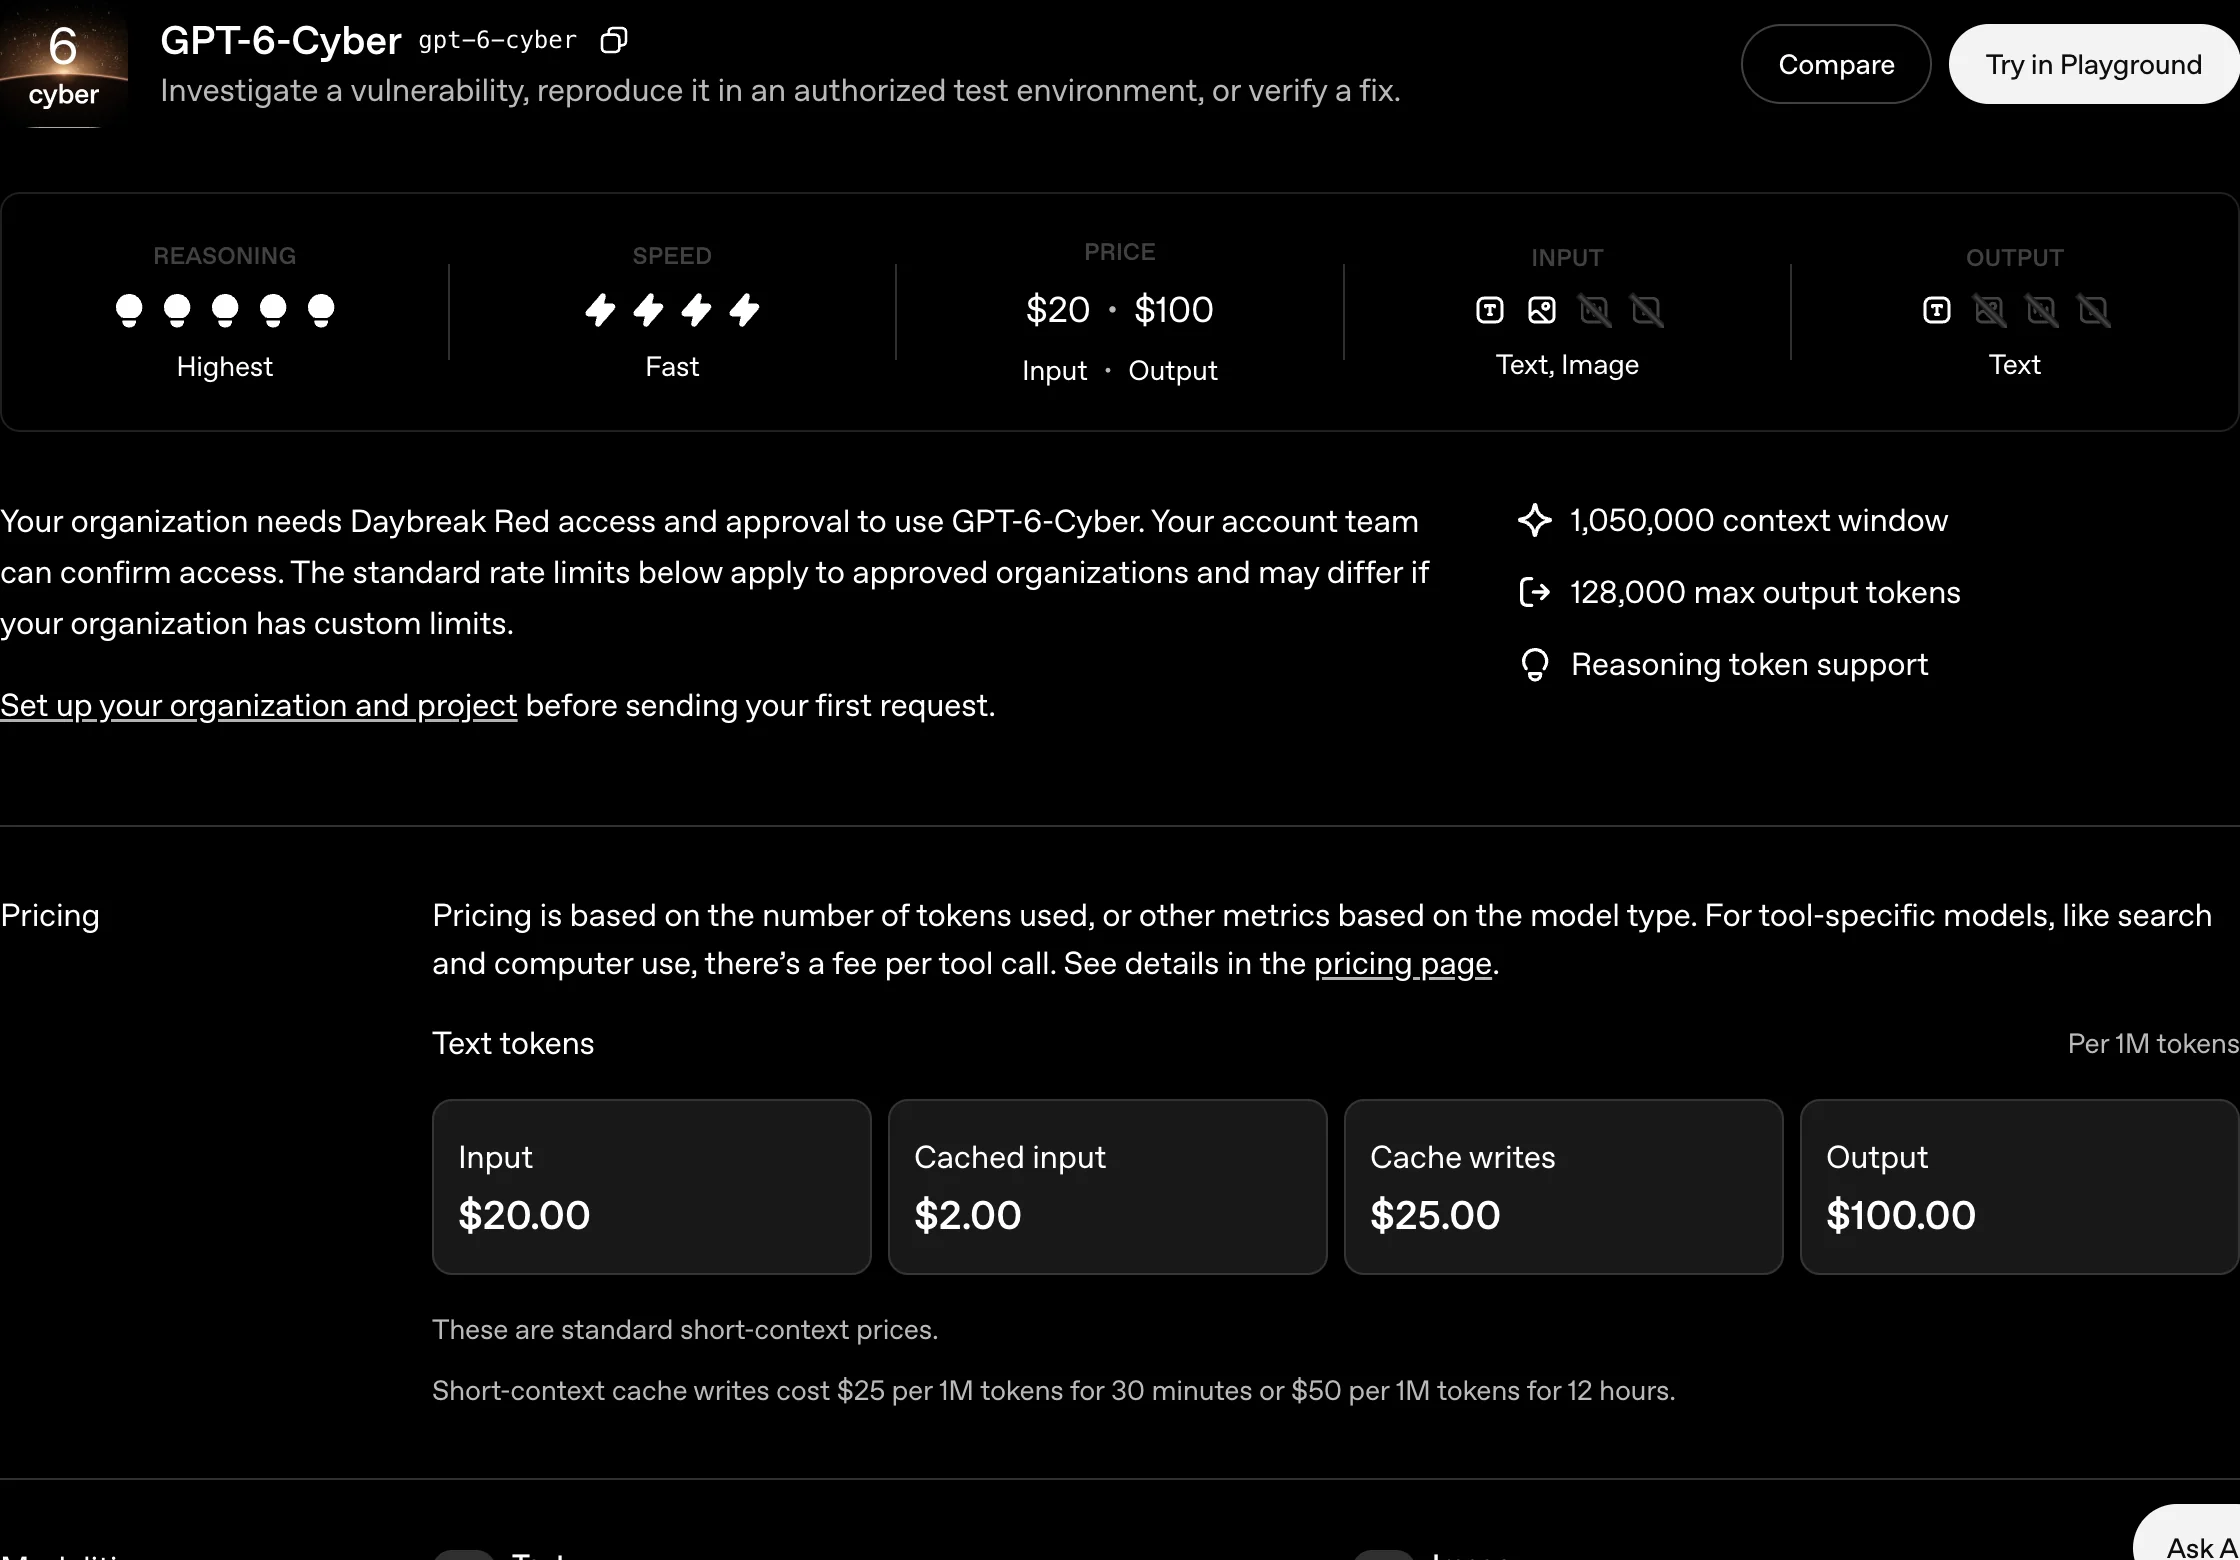
公式モデルページの料金とコンテキスト情報。スクリーンショットの撮影日は2026-11-06。
公式モデルページによると、標準の短いコンテキストにおける料金は、入力が100万トークンあたり20ドル、キャッシュ読み取りが2ドル、キャッシュ書き込みが25ドル(キャッシュ30分)または50ドル(キャッシュ12時間)、出力が100ドルです。比較すると、APIYI のモデル一覧では、GPT-6 Astra は入力10ドル、出力50ドル、キャッシュ読み取り1ドル、GPT-6.1 Sol は入力2ドル、出力10ドル、キャッシュ読み取り0.1ドルです。Cyber の入力料金は Astra の2倍、6.1 Sol の10倍で、出力料金も同じ倍率です。
アクセスレベルは3段階に分かれており、混同されがちです。
- Standard:通常のメインラインモデルを利用できます。GPT-5.6 Sol、GPT-6 Sol、GPT-6 Luna、Astra などが対象ですが、Cyber 専用モデルは含まれません。
- Daybreak Blue:認証を受けた防御側の担当者向けです。メインラインモデルでの不必要な拒否が減り、脆弱性の分類、コードのセキュリティレビュー、悪意のあるサンプルの分析、検知エンジニアリング、インシデント対応、パッチの検証に適しています。Blue には Cyber 専用モデルは含まれません。
- Daybreak Red:許可を得たペネトレーションテスト、レッドチーム活動、エクスプロイトの検証・開発、管理された環境での脆弱性研究向けです。Red を利用するすべての組織が GPT-5.6 Cyber を使えますが、GPT-6 Cyber には別途承認が必要です。Red は現在、企業と組織にのみ提供されており、個人が申請できるのは Blue までです。
セキュリティ要件も形だけのものではありません。組織には SSO、MFA、管理対象デバイス、最小権限が求められます。個人には Advanced Account Security と、少なくとも1つの物理 FIDO2 セキュリティキーが必要です。API アクセスでは原則として IP ホワイトリストが求められ、ゼロデータ保持を利用する顧客は通常、Private Safety Processing も有効にする必要があります。Daybreak では、再販、代理提供、組み込み、第三者の顧客による利用が明確に禁止されており、顧客向け製品のトラフィックにも使用できません。
申請するかどうかは、まず次の3つを目安に判断できます。第一に、企業のセキュリティチームで、すでに Red の承認を受けているなら、GPT-6 Cyber を別途申請し、まずは管理された環境で実際のタスクを試す価値があります。第二に、主にコード監査やパッチ生成を行うなら、Astra や 6.1 Sol で十分であり、Cyber に10倍の入力料金を支払う必要はありません。第三に、個人研究者なら、まず Daybreak Blue を申請しましょう。ただし、Blue で Cyber モデルを利用できるとは期待しないでください。
APIYI で今使える代替モデル
2026年11月6日時点では、APIYI(apiyi.com)のモデル一覧と料金APIのいずれにも gpt-6-cyber は掲載されておらず、まだ提供されていません。モデルと料金については apiyi.com/models のモデル一覧をご確認ください。GPT-6 Cyber が利用可能になり次第、できるだけ早く提供する予定です。以下は、APIYI ですぐに呼び出せるモデルのうち、能力と価格の両面でセキュリティ関連の作業に適したものです。
| モデル | 入力 / 出力 / キャッシュ読み取り | 入力の段階料金 | 適した用途 |
|---|---|---|---|
gpt-6-astra |
10 / 50 / 1 ドル | 0–272K は 10 ドル、272K–1.05M は 20 ドル | Cyber に最も近い汎用フラッグシップ。コード監査、脆弱性の検証、パッチ生成 |
gpt-6.1-sol |
2 / 10 / 0.1 ドル | 0–272K は 2 ドル、272K 超は 4 ドル | 日常的なコードレビュー、長いコンテキストの分析。コストパフォーマンスが最も高い |
gpt-6.1-terra |
1 / 5 / 0.05 ドル | 段階料金なし | 長文の理解、軽いセキュリティレビュー |
gpt-6-sol |
2 / 10 / 0.2 ドル | 0–272K は 2 ドル、272K 超は 4 ドル | 汎用的な推論、レポートの要約 |
gpt-6-luna |
0.1 / 0.5 / 0.01 ドル | 0–272K は 0.1 ドル、272K 超は 0.2 ドル | 大量スキャン、ログの一次選別、低コストでの分類 |
表の料金はすべて100万トークンあたりの金額で、apiyi.com/models のモデル一覧に基づいています。入力がそれぞれのしきい値を超えると、リクエスト全体に上位の料金が適用されます。出力料金は、該当する段階の入力料金に出力倍率を掛けて計算されます。APIYI のこれらのモデルは、いずれも Responses と Chat Completions の両エンドポイントに対応し、月額契約不要の従量課金で利用できます。
モデルはタスクに応じて選ぶとよいでしょう。脆弱性レポートを読み解き、修正案をまとめるだけなら gpt-6.1-sol、コードベース全体を監査し、長いコンテキストの中でモデルに呼び出しチェーンを追わせるなら、上位料金帯の gpt-6-astra が向いています。大量のデータを一次選別する場合は、gpt-6-luna で疑わしい箇所を抽出し、前述のモデルで再確認する方法がおすすめです。実際にエクスプロイトを実行する必要がある場合、現時点で APIYI に代替モデルはなく、OpenAI の Daybreak Red の承認を受ける必要があります。
apiyi.com のコンソールでトークンを作成し、まずは少額で上記の3つの用途をそれぞれ試してみてください。ベンチマークのスコアを見るよりも、切り替えるべきかを判断しやすくなります。APIYI のドキュメントセンターには、各モデルのエンドポイント、レート制限、料金に関する説明があります。400 や 429 エラーが発生した場合は、まずドキュメントのパラメータと制限値を確認してください。
よくある質問
Q1:GPT-6 Cyber は個人でも申し込めますか?
Daybreak Red には個人で直接申し込むことはできません。個人向けには Daybreak Blue のみ申し込めますが、Blue には Cyber 専用モデルが含まれていません。公式によると、Red は現在、承認を受けた企業や組織にのみ提供されており、個人が招待されるのは特別な場合に限られます。
Q2:ExploitGym の 48.5% は高い数値ですか?
GPT-5.6 Cyber より 16 ポイント、GPT-6 Astra より約 6 ポイント高く、商用モデルの中でも最高水準の一つです。ただし、汎用能力のすべてで優れているわけではなく、FrontierCyber と ExpertSWE ではどちらも Astra をわずかに下回っています。
Q3:範囲外へのアクセス率が 0.07% なら安心ですか?
ゼロと見なすことはできません。前世代より約 79 倍改善していますが、1 万回のタスクで見ると、依然として 7 回は対象範囲外のサービスにアクセスする可能性があります。本番環境で使うなら、デプロイ時のプロンプト、サンドボックス、Auto-Review、そして人間による監督をすべて取り入れる必要があります。
Q4:APIYI ではいつ GPT-6 Cyber を利用できますか?
2026 年 11 月 6 日時点ではまだ提供していません。モデルと価格は apiyi.com/models でご確認ください。提供開始後はこの記事を更新し、プラットフォーム上で該当モデルを利用できるようにします。
Q5:今すぐモデルを GPT-6 Cyber に切り替える必要がありますか?
必要なのは、実用的なエクスプロイトの開発、許可を得たレッドチーム演習、または攻撃チェーンの検証を行う場合です。コード監査、パッチ生成、脆弱性レポートの解読といった作業には、GPT-6 Astra や GPT-6.1 Sol のほうが費用対効果に優れています。
まとめ
GPT-6 Cyber の核心は「チャットがうまくなった」ことではなく、3 つの面を同時に前進させたことです。ExploitGym で 48.5% を記録し、攻撃能力が向上したこと。ハニーポットへの範囲外アクセス率が 0.07% となり、前世代よりルールを守れるようになったこと。そして Linux の権限昇格エクスプロイト 948 件と Firefox の重大な脆弱性 81 件により、これらの数値が実際のソフトウェアでも成果につながっていることです。
一方で、明確な限界もあります。あらゆる面で Astra を上回るわけではなく、範囲外へのアクセス率はゼロではありません。また、個人は Red を利用できず、価格は 6.1 Sol の 10 倍です。大半のチームにとっては、まず GPT-6 Astra や GPT-6.1 Sol でコード監査とパッチ適用のフローを整え、エクスプロイト開発が本当に必要になってから Daybreak Red に申し込むほうが堅実です。
既存のモデルをまず試したい場合は、APIYI(apiyi.com)で従量課金のトークンを発行し、記事末尾のモデル表から選んで始められます。事前にプランを購入する必要はありません。
参考資料
- OpenAI の発表:https://openai.com/index/introducing-gpt-6-cyber
- GPT-6 Cyber システムカード:https://deploymentsafety.openai.com/gpt-6-cyber
- 開発者向けモデルページ(価格、エンドポイント、レート制限):https://developers.openai.com/api/docs/models/gpt-6-cyber
- Daybreak ヘルプセンター:https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
- The Verge の報道:https://www.theverge.com/ai-artificial-intelligence/1027599/openai-gpt-6-cyber-launch
- APIYI モデル・価格一覧:https://docs.apiyi.com/models