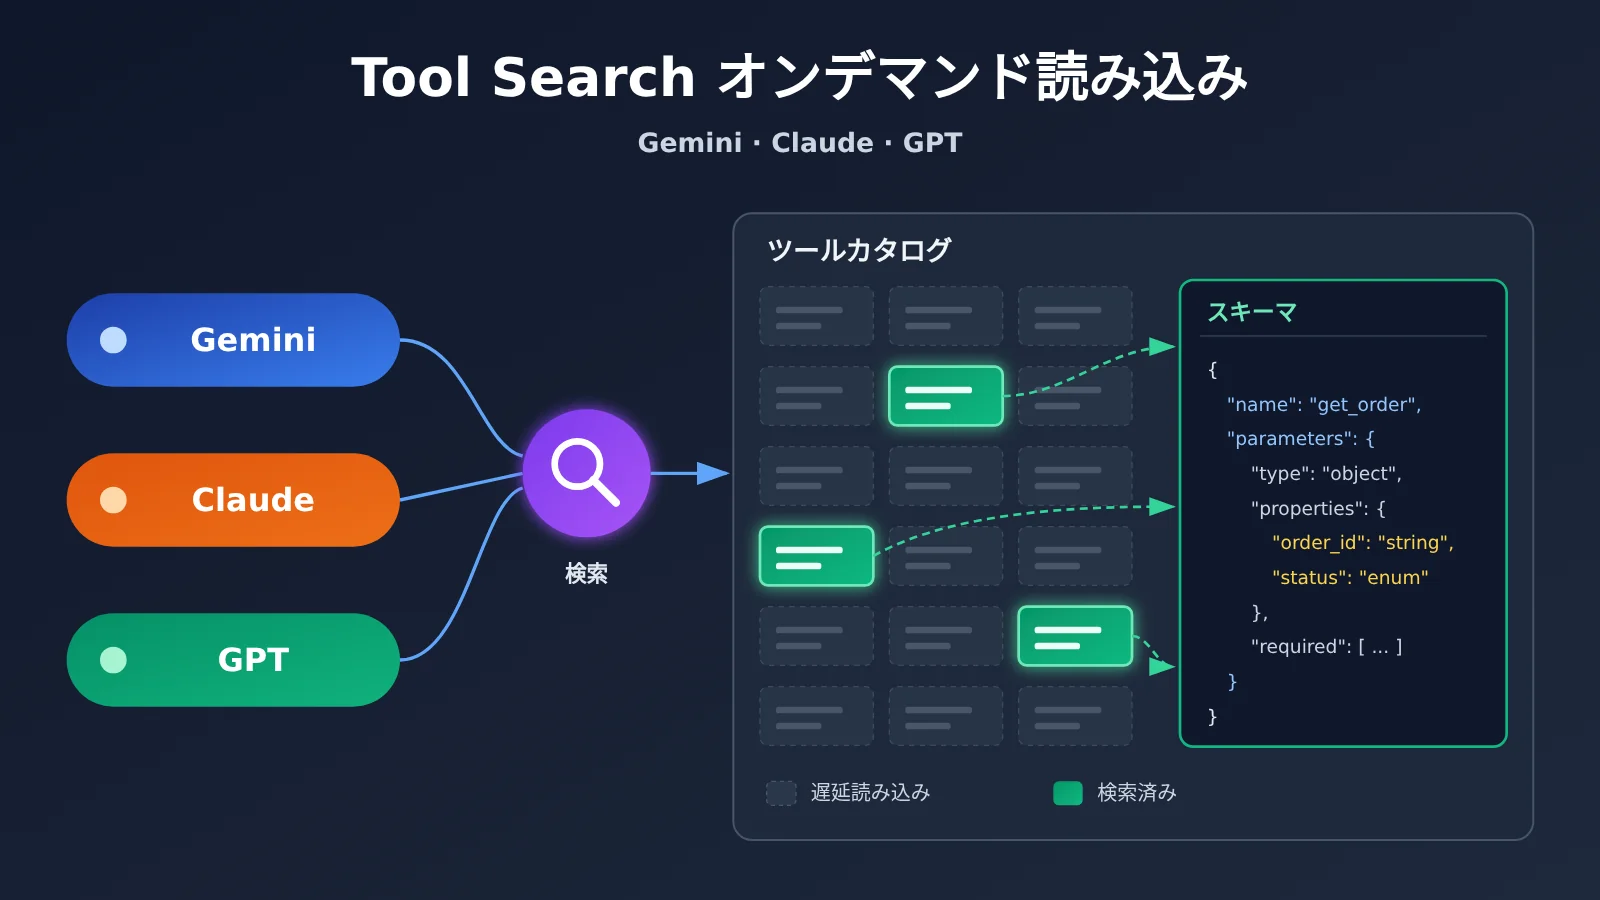
3社の Tool Search は同じ課題を解決していますが、実装アプローチは大きく異なります。 3社はいずれも、モデルが開始時にツールの簡潔な手がかりだけを見て、呼び出しが必要になった時点で完全なパラメータスキーマを読み込む仕組みです。主な違いは3点です。Gemini にはサーバー側とクライアント側の2種類の検索モードがあり、クライアント側検索では新しいツールを導入できます。Claude は Regex と BM25 という2種類のサーバー側検索方式を公開し、tool_reference を通じて、宣言済みのツールセット内で探索を行います。GPT は namespace でツールをグループ化し、クライアント側モードでは tool_search_output によって新しいツールを動的に注入できます。選定時には、ツールライブラリが固定かどうか、頻繁に変化するかどうか、そしてチームの既存 API アーキテクチャを確認する必要があります。
この記事でわかること
- 3社の Tool Search はそれぞれどの API に属し、どのフィールドで有効化するのか。
- モデルの初期コンテキストに保持される内容の違い、および
short_description、tool_reference、namespaceがそれぞれ果たす役割。 - ツール検索と実際の関数呼び出しのイベントチェーンがどう構成されるか、適合時にどこで間違えやすいか。
- どのベンダーが、最初のリクエストに含まれていない新しいツールを会話中に追加できるか。
- 注文・在庫のような企業 Agent に対して、ツールライブラリの構造に応じてどう選ぶか。
目次:本文ではまず3社の公開時期と共通の考え方を説明し、続いて Gemini、Claude、GPT の検索メカニズムと固有フィールドをそれぞれ詳しく解説します。その後、1つの総合表で8つの観点を比較し、同じ注文・在庫 Agent を使って3つの技術ルートを実演します。最後の分析パートでは選定原則を示し、クロスモデルゲートウェイがプロトコル適合で注意すべき問題について議論します。
知っておきたい Tool Search の関連概念
| 概念 | 簡単な説明 |
|---|---|
| ツールカタログ | 検索対象となる業務ツールの集合で、名前、説明、パラメータ定義、権限情報を含みます |
| Tool Search | 現在のタスクに応じて必要なツールを検索し、必要に応じてその完全な定義をインポートする機能 |
defer_loading |
3社すべてが採用しているフィールドで、ツールの完全な定義の遅延読み込みを示します |
| Regex | 正規表現を使って、ツール名、説明、パラメータの手がかりを照合します |
| BM25 | クエリ語とテキストの関連性に基づいて検索結果をランク付けする古典的アルゴリズム |
tool_reference |
Claude が宣言済みツールを参照するために使用するコンテンツブロックで、その後 API によって完全な定義に展開されます |
namespace |
OpenAI Responses API において、関連する関数を業務上の機能単位でグループ化して宣言するもの |
| 動的ツール注入 | アプリケーションが初期リクエストで宣言されていないツール定義をモデルに渡し、引き続き使用させること |
tool_search_output |
OpenAI クライアントが検索時に返す、一致するツール宣言のレスポンス項目 |
| リモート MCP | Model Context Protocol を通じて、発見可能で実行可能なツールを提供するリモートサービス |
| キャッシュプレフィックス | 複数のモデル呼び出し間で一貫性を保ち、キャッシュを再利用できる入力の冒頭部分 |
Tool Search の影響をひと目で
- エージェント開発者:ツールが増えても、すべてのスキーマを一度にコンテキストへ詰め込む必要はなくなります。ただし3社のリクエストボディと返却イベントはそれぞれ異なるため、モデルをまたぐエージェントでは解析ロジックを個別に実装する必要があります。
- 企業プラットフォームとツールカタログの保守担当者:ツールの命名、簡潔な説明、グループ化の方法が検索結果に直接影響し始め、ツールカタログ自体が設計すべき資産になっています。
- コストと運用の責任者:Tool Search は必ずしもコスト削減にはなりません。Google の公式試算ではトークンが節約されるケースと増加するケースの両方が示されているため、有効化するかどうかは実際の請求額に基づいて判断してください。
客観的事実:3社のTool Search公開経緯と仕組み
なぜGemini、Claude、GPTはいずれもTool Searchを提供するのか
1つのエージェントがCRM、注文、在庫、物流、チケット、複数のMCPサーバーを同時に接続すると、ツール宣言そのものが大量のコンテキストを消費します。Googleのドキュメントでは、数十個の関数宣言で数万トークンを占める可能性があると述べています。Anthropicは次のような例を挙げています。GitHub、Slack、Sentry、Grafana、Splunkの5つのMCPサーバーに合計58個のツールがあり、ツール定義だけでも約55,000トークンになるというものです。
3社の発表タイムラインは次のとおりです。Anthropicは2025年11月24日にTool Search Toolをリリースしました。OpenAIは2026年3月5日にGPT-5.4とともにAPI Tool Searchをリリースしました。Googleは2026年11月19日にGemini APIのTool Retrievalをプレビュー版としてリリースしました。3社の基本的なアプローチは共通しています。モデルはまず利用可能な機能を把握し、実際に必要になった時点で完全なパラメータ定義を読み込みます。
3社はそれぞれ性能データを公表していますが、テスト条件がまったく異なるため、単純に比較してランキングに使うことはできません。Anthropicの事例では、初期コンテキストが約77,000トークンから約8,700トークンに減少し、社内MCP評価においてClaude Opus 4のツール選択精度が49%から74%に向上しました。OpenAIはMCP Atlasの250タスク、36個のMCPサーバーで、総トークン数が47%削減され、精度は維持されたと報告しています。Googleは現時点では仮説に基づく試算のみを示しています。ツールが200個の場合は約85.6%削減、10個のツールを長いコンテキストと組み合わせた場合は逆に約36.5%増加します。
Gemini Tool Search:サーバー側とクライアント側の2つの検索モード
Gemini の Tool Retrieval は Interactions API に依存しており、v1beta の使用が必須です。旧来の generateContent ではサポートされません。サーバー側モードを有効にするには、tools に {"type": "tool_search"} を追加し、さらに利用頻度の低い function または mcp_server に defer_loading: true を設定します。モデルが最初に参照できるのは、遅延対象ツールの名前と short_description だけです。Google の初期テストでは、各ツールエントリが平均約26トークンでした。短い説明が設定されていない場合は、完全な description の最初の文が代わりに使われます。
誤解しやすい点が1つあります。サーバー側モードでも、開発者は完全なツール定義を送信する必要があります。previous_interaction_id を使用していても、リクエストごとに完全な tools 配列を再送信する必要があります。遅延読み込みは、完全な Schema を事前にモデルのコンテキストへ入れないようにするだけです。さらに、一度読み込まれた Schema は現在のセッション内ではアンロードできません。1つのリクエストで宣言できる tool_search は最大1つです。サーバー側検索とクライアント側検索を同じリクエスト内で混在させることはできません。
| 項目 | サーバー側検索 | クライアント側検索 |
|---|---|---|
execution |
server(デフォルト) |
client |
| 検索の実行主体 | Gemini API が担当 | 開発者が独自に構築 |
| ツールライブラリの事前宣言 | 必要 | 不要 |
defer_loading |
適用可 | 適用不可 |
| 追加のラウンドトリップ | クライアント側の追加ラウンドトリップなし | 検索ごとに1回追加のラウンドトリップ |
| 典型的なユースケース | 大規模で比較的固定されたツールセット | プライベートな Tool Registry、マルチテナント、動的ツール |
クライアント側モードでは、モデルが開発者定義の検索関数(たとえば search_tool_registry)を呼び出し、アプリケーションが function_result.result 内で一致した完全なツール宣言オブジェクトを返します。この方式では、元のリクエストで宣言されていないツールを会話の途中で導入できます。たとえば、ユーザーがセッション中に新しい SaaS サービスを一時的に接続した場合などです。
Claude Tool Search:Regex、BM25、tool_reference
Claude の Tool Search Tool は Messages API に属し、サーバー側で2種類の検索ツールタイプを提供します。tool_search_tool_regex_20251119 はモデルが正規表現を生成する方式で、命名規則が明確なツールライブラリに適しています。tool_search_tool_bm25_20251119 はモデルが自然言語クエリを生成する方式で、能力の記述からツールを発見するのに適しています。どちらの方式も、ツール名、説明、パラメータ名、パラメータの説明を検索対象にします。Claude のパラメータフィールドは input_schema で、これは他の2社の parameters とは異なります。
典型的な検索のイベントチェーンは次のとおりです。まず Claude が server_tool_use で組み込み検索ツールを呼び出し、API が tool_search_tool_result を返します。その結果には tool_reference が含まれ、API がそれを完全な定義に展開し、最後にモデルが業務レベルの tool_use を生成します。Anthropic は特に、組み込み検索ツールの srvtoolu_... 識別子については開発者が tool_result を返す必要がなく、アプリケーションは実際の業務 tool_use を実行するだけでよいと説明しています。
| Claude Tool Search のルール | 公式の規定 |
|---|---|
| 1リクエストあたりの遅延ツール上限 | 10,000 個 |
| 1回の検索でデフォルトで返される数 | 最大5個、limit で調整可能 |
| Regex クエリの長さ | 最大200文字 |
| BM25 クエリの長さ | 最大500文字 |
| サポート対象外のモデル | Claude Opus 4.1 およびそれ以前のモデル |
| キャッシュの制約 | defer_loading: true のツールには cache_control を設定できない |
開発者は embedding などの独自アルゴリズムでカスタム検索を実装することもできますが、返されるのは依然として tool_reference であり、参照されるツールはトップレベルの tools で既に宣言されている必要があります。そのため Claude の設計は「事前に宣言されたツールライブラリから必要なツールを見つけ出す」ことに近いものです。MCP については、Claude は MCP Connector の mcp_toolset 設定で遅延ポリシーを構成でき、default_config で一括設定することも、configs でツールごとに個別設定することもできます。
GPT Tool Search:Namespaceと動的ツール注入
OpenAIのTool SearchはResponses APIにあり、GPT-5.4以降の互換モデルによってサポートされています。同様に tool_search と defer_loading で有効化されます。その特徴は namespace です。開発者は関連する関数を crm、billing などの業務ドメインごとにグループ化でき、モデルはまずネームスペースの名前と説明に基づいてどの種類の能力が関連するかを判断し、必要に応じてグループ内の遅延関数を展開します。これによりツールのグループ化はAPIレベルの構造となり、単なる命名規則にとどまりません。
サーバーモードのイベントチェーンは tool_search_call → tool_search_output → function_call → アプリが function_call_output を返す、という流れです。クライアントモードでは、アプリは tool_search_call を受け取ると自身でツールカタログを検索し、同じ call_id で tool_search_output を返します。その tools フィールドにはマッチした完全なツール宣言が含まれ、モデルは次のラウンドでこれらの関数を呼び出します。公式ドキュメントでは、ここで元のリクエストで宣言されていないツールを返すことがサポートされており、同時に開発者には動的Schemaを厳格に検証し、信頼できるツール定義のみを公開することが求められています。
キャッシュの面では、OpenAIは新たに発見されたツール定義をコンテキストの後部に追加することで、既存のキャッシュプレフィックスへの影響を抑えます。MCPに関しては注意が必要です。Responses APIのTool SearchはMCPツールのオンデマンド検出をサポートし、Agents APIではモデルとプロバイダーが対応している場合、ランタイムがツール検出を自動的に組み込みます。公式ドキュメントは、2つの設定をそのまま相互に流用できないことを明確に注意喚起しています。
以下は遅延ローディングの基本構造を示すResponses APIのリクエスト例です。フィールドはOpenAI公式ドキュメントに準拠しています:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換エントリポイント
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # tool_search_call / function_call などのイベントが期待される
クライアント側の検索と動的注入のサンプルコードを見る
import requests

BASE_URL = "https://api.apiyi.com/v1"  # APIYI経由でResponses APIリクエストを転送
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """社内プライベートツールカタログを検索し、ユーザー権限でフィルタリング(例示)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # 検索呼び出しと同じcall_idを使用
                "tools": search_registry(query)  # 初期リクエストで宣言されていないツールを含めることができる
            })
    return follow_ups
# 注意:動的に返されるSchemaは必ず事前に検証し、信頼できるツールのみを公開すること
🚀 迅速な検証の提案:実際の業務に接続する前に、APIYI apiyi.com の統一キーを使ってGPT、Claude、Geminiをそれぞれ呼び出し、同じツールカタログを3社それぞれで一通り実行してみましょう。イベント構造があなたのパース層で正しく認識できることを確認してから、メインのソリューションを決めるとよいでしょう。
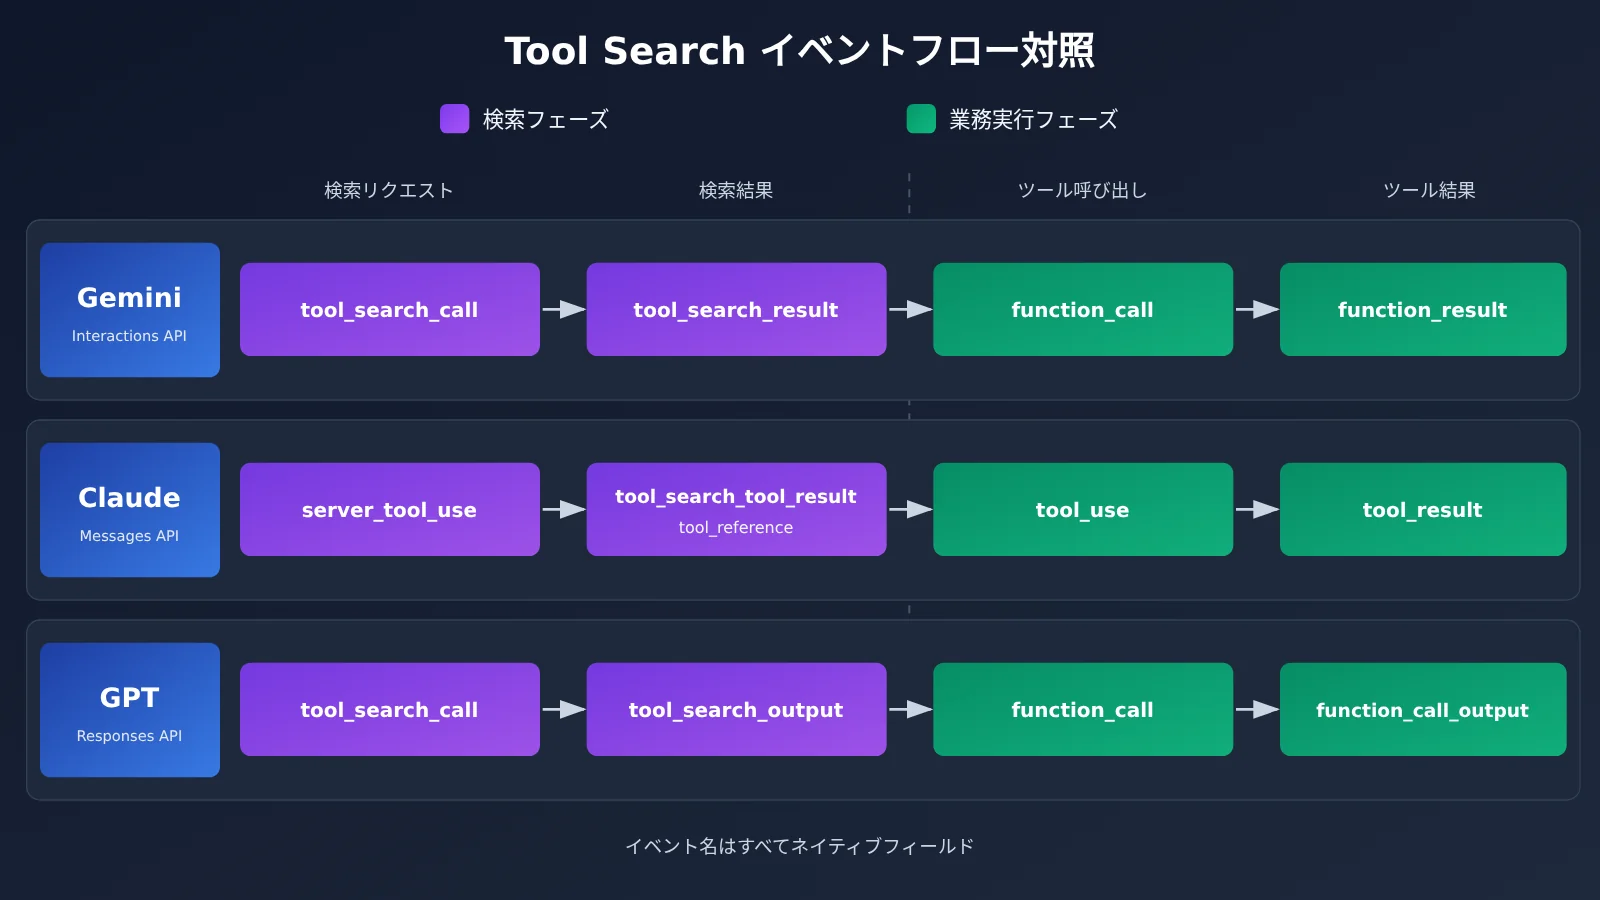
上図のイベント名はすべて各社のネイティブなフィールド名です。各社のイベントフローを実際に検証したい読者は、APIYI apiyi.com 経由で同一のテストスクリプトを使い、モデルを切り替えて比較できます。
3社のTool Search機構を集中比較
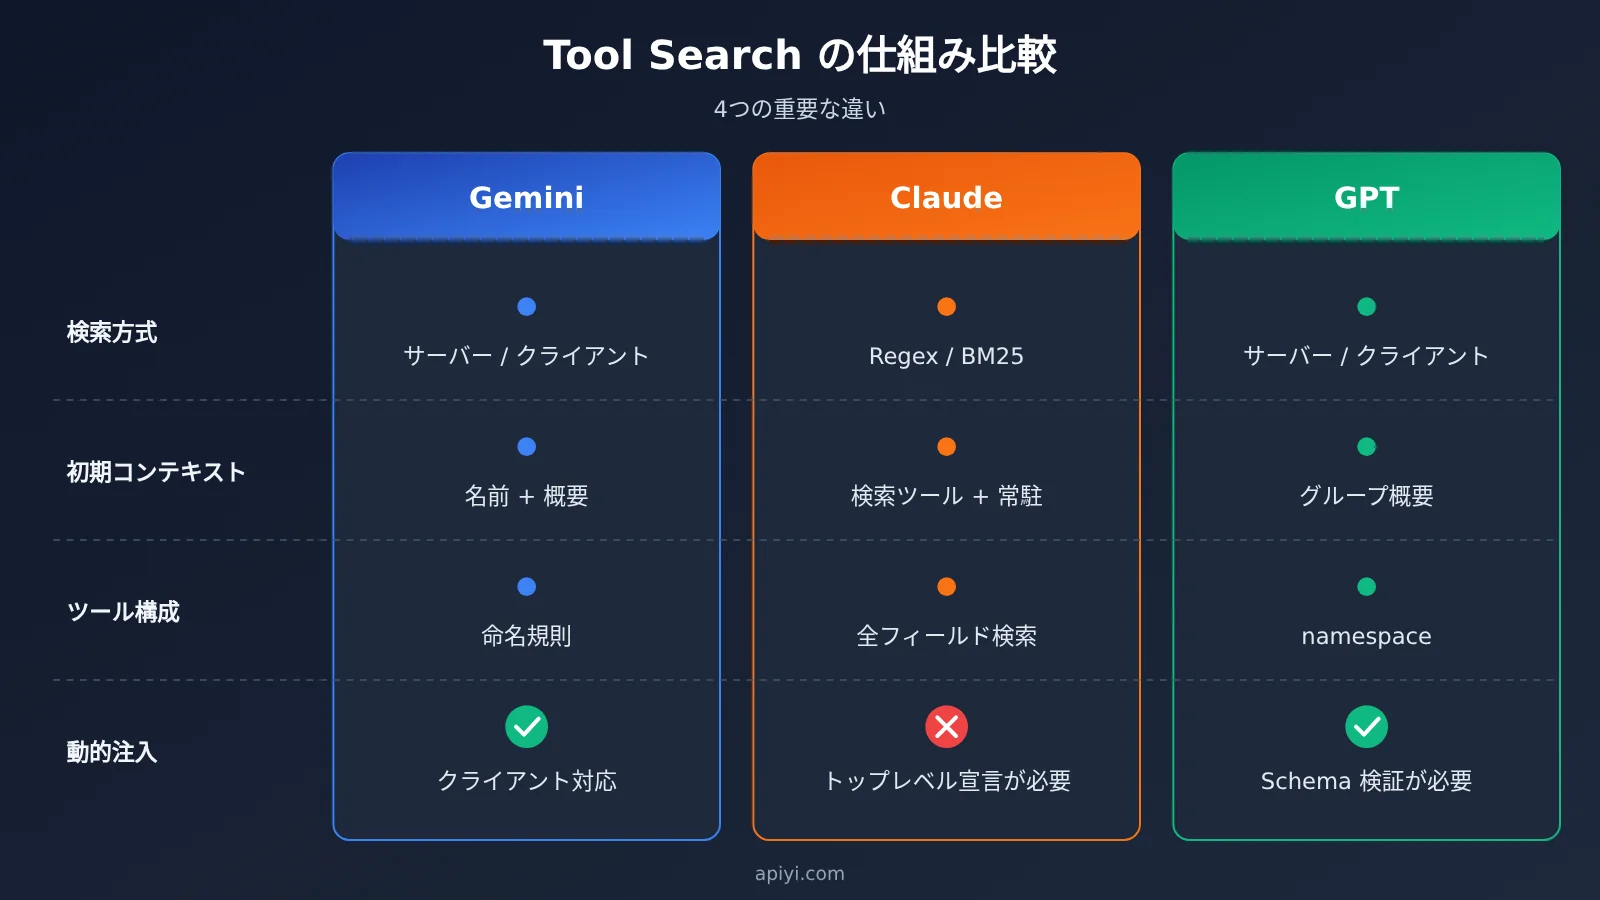
| 観点 | Gemini | Claude | GPT |
|---|---|---|---|
| 所属 API | Interactions API(v1beta) |
Messages API | Responses API |
| 検索方式 | サービス側(アルゴリズムは非公開)/クライアント側 | Regex / BM25 / カスタム検索 | サービス側/クライアント側 |
| 初期コンテキストに残る内容 | 名前 + short_description |
検索ツール + 遅延なしのツール | 遅延ツールまたは namespace の概要 |
| ツールの整理方法 | 命名規則 + 短い説明 | 名前・説明・パラメータのいずれも検索対象 | namespace によるグループ化 |
| パラメータのフィールド | parameters |
input_schema |
parameters |
| クライアント側検索 | 対応 | カスタム検索が tool_reference を返す |
対応(tool_search_output) |
| 新規ツールの動的追加 | クライアントモードで対応 | 参照するツールは最上位で宣言済みである必要あり | クライアントモードで対応、Schemaの検証が必要 |
| MCP 統合 | mcp_server + defer_loading |
mcp_toolset の default_config / configs |
Responses と Agents でルールが異なる |
| キャッシュと課金 | 独立した機能料金なし。total_tool_use_tokens に注目 |
別途課金なし。遅延ツールには cache_control を設定できない |
新規ツールを末尾に追加してキャッシュのプレフィックスを保護 |
💡 選び方のヒント:上の表は検証可能なインターフェース仕様だけを比較したものです。実際の効果はツール群や会話の長さによって変わります。APIYI apiyi.com のマルチモデル統合エンドポイントを使って小規模サンプルのA/Bテストを行い、各社の請求項目と照らし合わせながらコストを試算することをおすすめします。
分析と判断:Tool Search 選定の適合条件
注文・在庫エージェントで3つの技術アプローチを読み解く
次のような業務要件を想定してみます。ユーザーが注文状況を問い合わせ、商品がまだ発送されていないことを確認し、続いて在庫を照会し、新たな発送日を設定できるか判断する、という流れです。システムには CRM、注文、在庫、倉庫スケジューリング、物流、返金、請求、通知、承認の9種類のツールがあり、それぞれに複数の関数があります。
- Gemini のアプローチ:よく使う注文照会は直接ロードし、在庫や倉庫スケジューリングなどのロングテールなツールは遅延ロードに設定します。さらに
short_descriptionを適切に記述し、サーバー側の検索でget_inventoryのスキーマを選び出します。倉庫スケジューリングツールがテナントごとに動的に有効化される場合は、クライアント側検索に切り替え、プライベート Registry から返します。 - Claude のアプローチ:ツールの命名が規則的(
inventory_*、warehouse_*など)であれば、Regex で正確にマッチできます。ユーザーが「まだ補充できるか見てみて」のような口語で話す場合は、BM25 のほうが適しています。最終的にtool_referenceが、呼び出し可能なtool_useに展開されます。 - GPT のアプローチ:
crm、inventory、logisticsごとにnamespaceを作成し、モデルがまず在庫と物流の2つのドメインが関わることを判断してから、グループ内の関数を展開します。一時的に接続する新しい物流事業者は、クライアント側のtool_search_outputを通じて注入できます。
このシナリオはあくまで仕組みの違いを説明するためのものであり、3社の実測成功率やレイテンシを表すものではありません。
開発者向けの4つの選択原則
- ツールライブラリが大きく、固定的である:まずサーバー側の検索機能に注目します。3社ともカバーできますが、Gemini はリクエストごとに完全なツール配列を再送信する必要があり、Claude は1リクエストあたりの遅延ツール上限が10,000個である点に注意が必要です。
- 検索戦略を明示的に制御したい:Claude が公開している Regex と BM25 は、アルゴリズムを明確に開示している唯一の方式であり、命名規則に基づいて正確にヒットさせたいチームに適しています。Gemini と GPT のサーバー側アルゴリズムは開示されていないため、Claude と同じだと推測すべきではありません。
- ツールライブラリが頻繁に変わる、またはユーザー権限でフィルタリングする必要がある:クライアント側の動的注入に注目します。Gemini と GPT のクライアントモードはいずれも新しいツールを導入できます。Claude のカスタム検索は宣言済みのツールのみを参照できるため、リクエスト送信前に候補セットを組み立てておく必要があります。
- ツール規模が小さい:Google の計算例では、10個のツールと30,000トークンの長いコンテキストを組み合わせると、トークン使用量がかえって約36.5%増加しました。Google は、安定したツールが約20個未満の場合は引き続き静的ロードを使用することを推奨しています。この点は他2社にも参考になりますが、それぞれで実測が必要です。
クロスモデルゲートウェイのプロトコル適合問題
クロスモデル Agent を開発するチームが最もハマりやすい落とし穴は、「このモデルを呼び出せる」ことと「このモデルの Tool Search が使える」ことを同一視してしまうことです。能力は4つの層に分解できます。モデルアクセス、プロトコルエンドポイント(Interactions / Messages / Responses)、ツール宣言フィールド(tool_search、defer_loading、namespace、MCP 設定)、実行と状態管理(検索イベント、関数結果、signature、セッション履歴)です。モデル接続に成功しただけでは、第1層に問題がないことしかわかりません。
特に注意すべきは Gemini のルールです。store=false のステートレスセッションでは、tool_search_call、tool_search_result およびその signature を変更・削除できません。変更や削除を行うと HTTP 400 が返されます。つまり、ゲートウェイが履歴メッセージを勝手に圧縮したり書き換えたりすることはできません。3社を統一された Tool Search インターフェースに抽象化するには、Agent フレームワークの層でイベントマッピングテーブルを維持する必要があります。Base URL を変えるだけで同じリクエストボディがそのまま使えると期待してはいけません。
🎯 技術的な推奨:APIYI apiyi.com のようなアグリゲーションプラットフォーム経由で複数モデルに接続する場合は、まず少量のトラフィックで対象エンドポイントと
tool_search、defer_loading、namespaceなどのフィールドが完全に透過的に渡されるか確認してから、Tool Search を本番経路に組み込むことをおすすめします。
注目し続けるべき変数
Gemini Tool Retrieval はまだプレビュー版であり、正式リリース前にインターフェースが変更される可能性があります。実際の本番環境における平均節約率、レイテンシ、精度については、2026年11月20日時点で検証可能な独立系テストがまだ存在しません。予想される方向性の一つは、3社がそろって「ツールカタログのガバナンス」を開発者に委ねるようになるという点です。命名、簡潔な説明、グループ化、権限は、ますます検索システムのインデックス設計に近づいていきます。リリース前には、初期入力Token、ツール使用Token、正しいツール選択率、マッチなし検索率、平均検索回数に基づいて対照実験を設計し、APIYI apiyi.com のようなマルチモデル環境で同じタスクセットを横断的に検証することをおすすめします。単一ベンダーの宣伝数値に引きずられないようにしましょう。
ツールが増えることは、Agent がより賢くなることを意味しません。必要なときに適切なツールを正確に見つけられるかどうかが、Agent の上限を決めるのです。『論語・衛霊公』の言葉にもある通り、「工欲善其事,必先利其器」(仕事をうまくやりたいなら、まず道具を研ぐべきである)。
参考資料
- Google Tool Retrieval 技術ドキュメント:サーバー側とクライアント側の検索、制限、課金、計算例
- リンク:
aistudio.google.com/docs/tool-retrieval
- リンク:
- Google 公式発表:Introducing Tool Retrieval in the Gemini API
- リンク:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- リンク:
- Anthropic Tool Search Tool ドキュメント:Regex、BM25、tool_reference と制限
- リンク:
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- リンク:
- Anthropic Advanced Tool Use 発表:Tool Search のリリースと社内評価
- リンク:
anthropic.com/research/advanced-tool-use
- リンク:
- OpenAI Tool Search ドキュメント:namespace、クライアント側検索、動的注入
- リンク:
developers.openai.com/api/docs/guides/tools-tool-search
- リンク:
- OpenAI GPT-5.4 発表:Tool Search のリリースと MCP Atlas テスト
- リンク:
openai.com/index/introducing-gpt-5-4
- リンク:
作者:APIYI 技術チーム
技術交流:マルチモデル Agent のツール呼び出し適応についてさらに議論したい場合は、APIYI apiyi.com からお問い合わせください。その他の接続資料は docs.apiyi.com のドキュメントセンターでご確認いただけます。