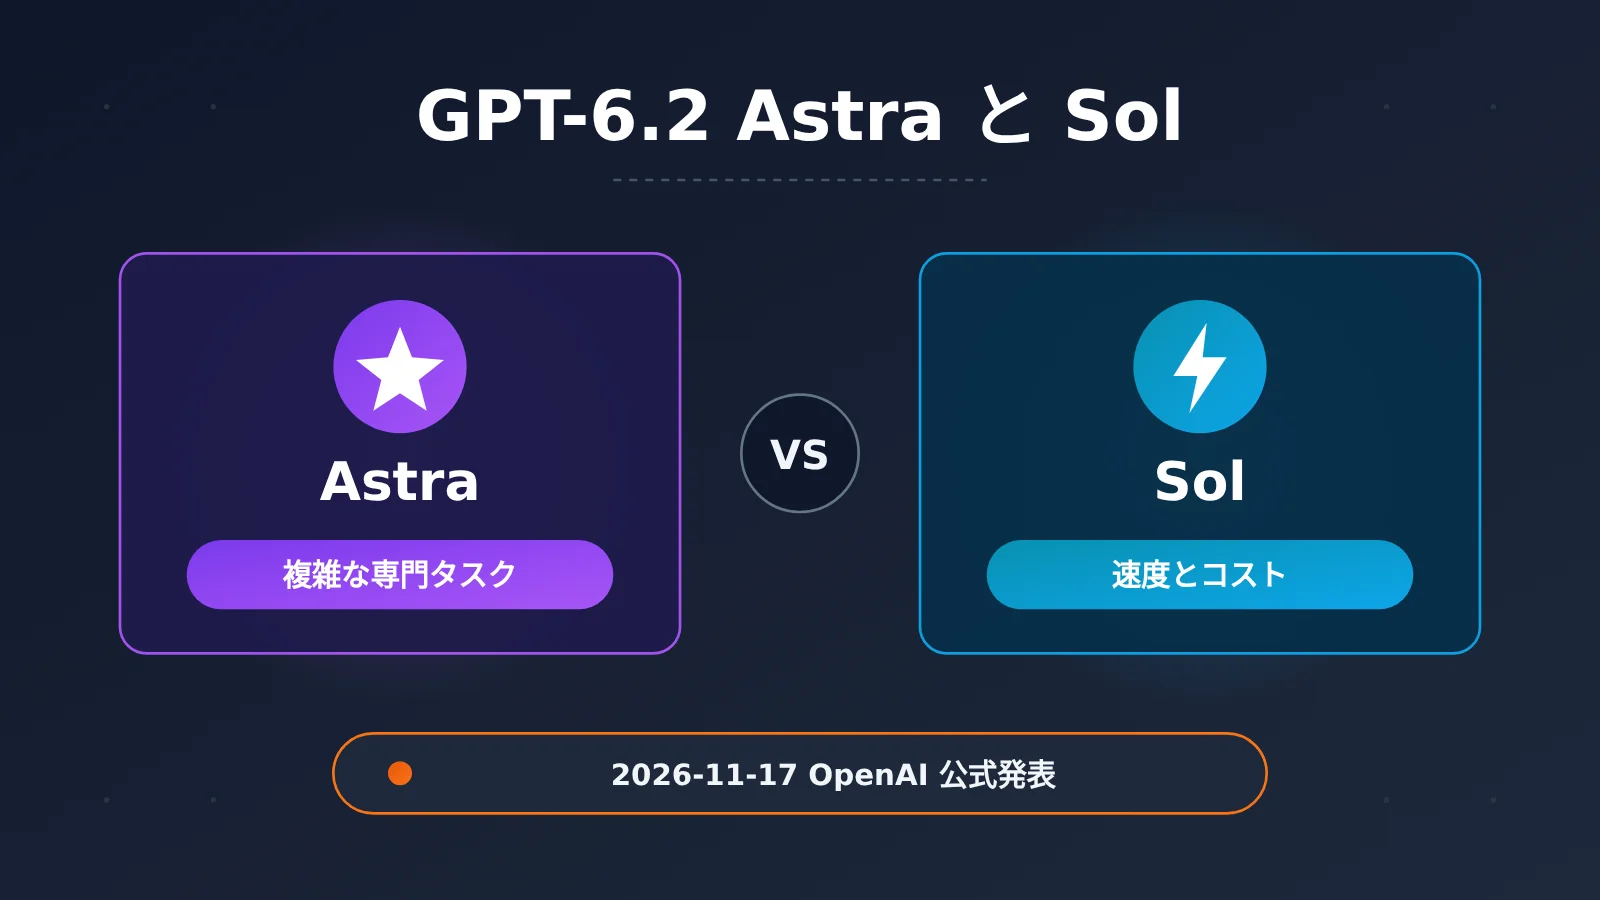
直接回答: OpenAIは2026年11月17日にGPT-6.2 AstraとGPT-6.2 Solを公開しました。公式レポートによると、両モデルともGDPval v2でそれぞれの前世代を上回っており、Astraは出力トークン数も22%削減しています。モデル選定では、複雑で高価値、失敗時のコストが高い専門タスクにはAstraを、高頻度で速度とコストを重視するタスクにはSolを優先してください。 なお、今回はChatGPT Work、Codex、API向けに段階的に提供され、通常のChatGPT対話は今回の提供対象に含まれません。そのため、通常のChatだけを使っている場合は、今回のリリースを理由に当面のワークフローを変える必要はありません。
この記事を読むと分かること
- GPT-6.2 AstraとSolの公開日、公式情報源、提供チャネル。
- 公式発表のGDPval v2、ALE、FrontierCode 2.0のデータがそれぞれ何を示すのか、また何を示さないのか。
- 2モデルの入力・出力能力の境界、および公式APIの標準価格構造。
- 一般ユーザーと開発者がそれぞれAstraとSolのどちらを選ぶべきか。
目次: 後半ではまず概念表を使って、評価指標の名称やキャッシュ課金などの用語を説明し、続いて「影響サマリー」で今回のリリースと利用者層の関係を整理します。本文の第1部では公式の事実を集中的に示し、1.1 提供範囲、1.2 公式評価、1.3 能力の境界、1.4 価格を扱います。第2部は編集部の判断として、アップグレードの実際の意味、2モデルの役割分担、選定の推奨事項、接続検証の方法を論じます。
To Know:まずはこれらの概念を理解しましょう
以下の用語は公式資料と本文の両方に登場します。まずこれらの意味を把握しておけば、評価データや価格の読み間違いを避けられます。
| 概念 | 簡単な説明 |
|---|---|
| GPT-6.2 Astra | 今回のリリースにおいて、複雑で専門的なタスクに寄ったポジショニングのモデル。公式API価格は高め |
| GPT-6.2 Sol | 今回のリリースにおいて、速度とコストに寄ったポジショニングのモデル。公式API価格はAstraの約4分の1 |
| GDPval v2 | OpenAI公式が使用する評価のひとつ。今回のAstraとSolの主要な比較データはこれに由来する |
| ALE | 公式レポートに記載されたもうひとつの評価。今回はAstraの改善スコアのみが公表された |
| FrontierCode 2.0 | 公式レポートにおけるプログラミング系の評価。今回はmax推論段階でのSolとAstraの差の比較に使用された |
| パーセントポイント | 2つの百分率の差。たとえば50%から56.2%への変化は6.2ポイントの向上 |
| 推論段階(max) | モデルに設定可能な推論強度の段階。maxは最も多くの推論計算を投入する設定を指す |
| 出力トークン | モデルが生成した内容に対して消費される課金単位。出力が簡潔であるほど、通常はコストが低くなる |
| キャッシュ読み取り | 繰り返し利用されるプロンプト内容がキャッシュにヒットした際に、より低い価格で課金される部分 |
| キャッシュ書き込み | 書き込みトークンは対応する保持期間の書き込み料率で課金され、同一バッチのトークンには通常の入力料金が重複して課されない |
| 272K長コンテキストしきい値 | 1回のリクエストの入力が約27.2万トークンを超えると、リクエスト全体がより高い料率で課金される |
| ChatGPT Work | OpenAIが業務シーン向けに提供するChatGPT製品。今回の提供開始チャネルのひとつ |
| Codex | OpenAIがプログラミングシーン向けに提供する製品。今回の提供開始チャネルのひとつ |
GPT-6.2 Astra と Sol がユーザー層別に与える影響の概要
- 一般の ChatGPT ユーザー: 今回の一般向け Chat は提供対象外のため、短期的に日常の利用体験がこれによって直接変わることはありません。
- ChatGPT Work ユーザー: 段階的な提供の中で新しいモデルに触れることになり、主にどのタスクを Astra に任せ、どのタスクを Sol に任せるかを判断する必要があります。
- Codex ユーザーとプログラマー: FrontierCode 2.0 の公式データによると、Sol はこのテストで Astra に近い性能を示しており、自身のコードベースで比較してみる価値があります。
- API 開発者: 2つのモデルの価格差は明らかで、さらにキャッシュと 272K の長コンテキストに関する課金ルールがあるため、モデルルーティングとプロンプト設計が請求額に直接影響します。
- 動画生成を必要とするクリエイター: 新モデルは入力がテキストと画像、出力がテキストであり、ネイティブな動画生成モデルではないため、この種のニーズに直接影響はありません。
一、GPT-6.2 Astra と Sol のリリースに関する客観的事実
本セクションでは公式に公開された情報のみを提示します。本文中のすべての評価データは OpenAI の公式レポートによるもので、APIYI チームによる実測ではありません。また、私たちはベンチマークやインタビューを一切行っていません。
1.1 GPT-6.2 Astra と Sol の公開時期と提供範囲
OpenAI は2026年11月17日に公式ページで GPT-6.2 Astra と Sol を発表しました。本記事の情報確認日は2026年11月18日です。公式発表ページ、ヘルプセンタードキュメント、開発者向けモデルページが現時点で最も直接的な情報源です。具体的なURLは文末の参考資料に記載しています。
| 情報項目 | 詳細 |
|---|---|
| 公開日 | 2026年11月17日 |
| 発表元 | OpenAI |
| 公開モデル | GPT-6.2 Astra、GPT-6.2 Sol |
| 提供開始場所 | ChatGPT Work、Codex、API、段階的に開放 |
| 今回の対象外 | 一般の ChatGPT 会話(Chat) |
| 入力モダリティ | テキスト、画像 |
| 出力モダリティ | テキスト |
| 公式ソース | openai.com 発表ページ、help.openai.com ヘルプドキュメント、developers.openai.com モデルページ |
「段階的に開放」とは、公開当日にすべてのアカウントで新モデルが利用できるわけではないという意味です。ChatGPT Work や Codex で一時的に入口が見つからない場合は、正常な段階的リリースの現象です。公式ヘルプドキュメントの説明を参照してください。
1.2 GPT-6.2 Astra と Sol の公式評価データ
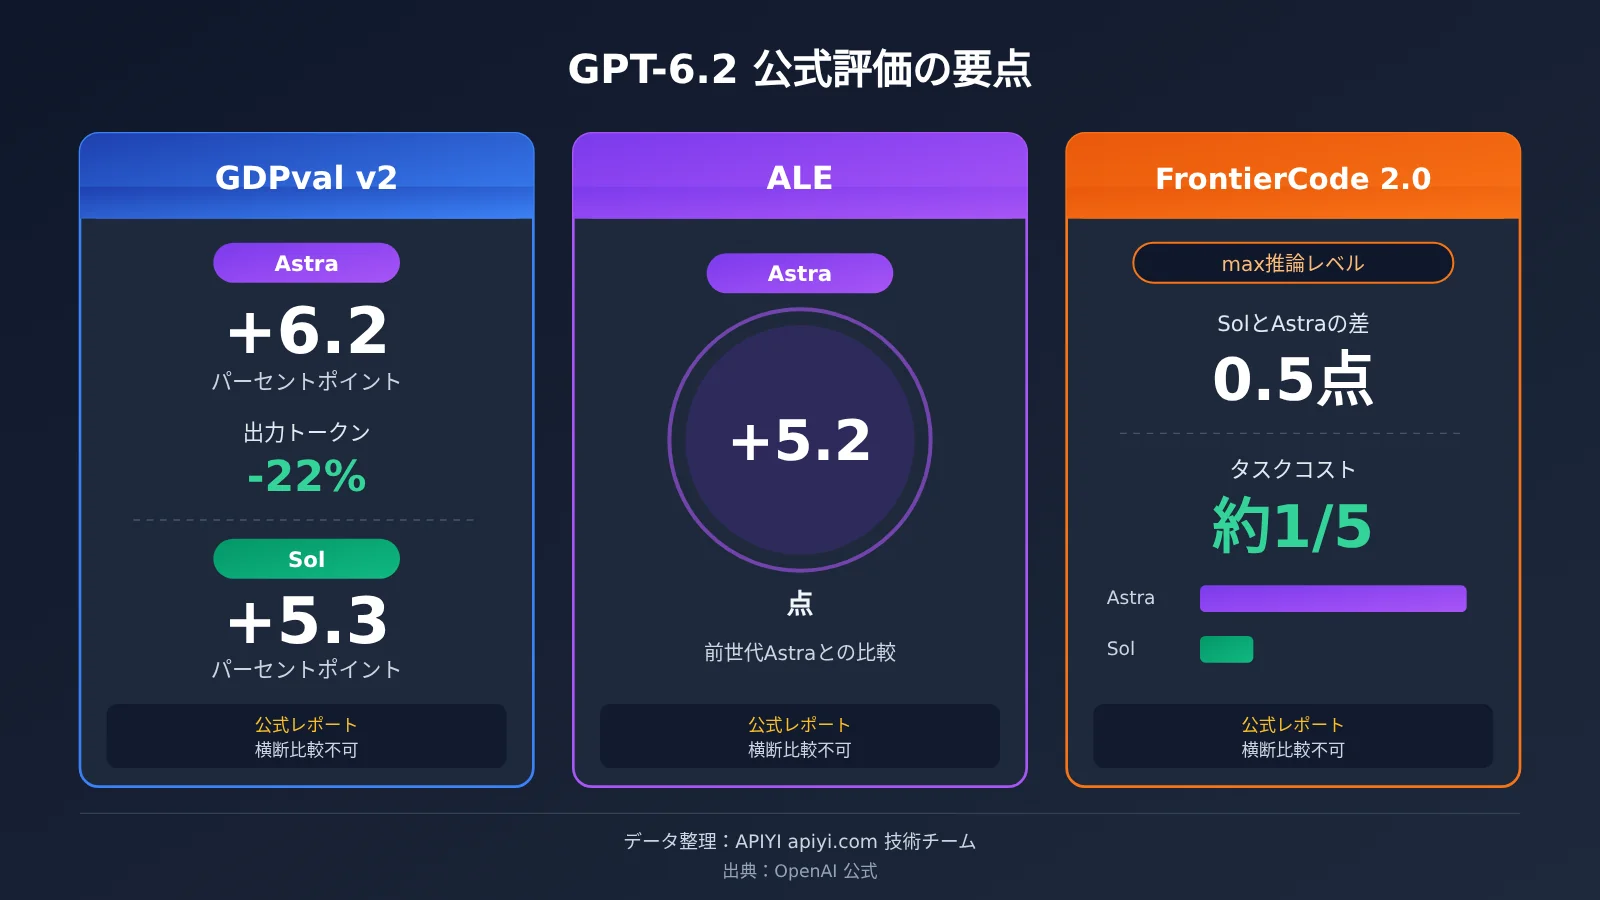
公式レポートには3組のデータが示されています。それぞれ異なる評価に基づき、比較対象も異なるため、混同して比較することはできません。以下の表は元の基準に従って整理したものです。
| 評価 | モデル | 公式レポート結果 | 比較対象 |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | 6.2ポイント向上、出力トークン22%削減 | GPT-6 Astra |
| GDPval v2 | GPT-6.2 Sol | 5.3ポイント向上 | GPT-6.1 Sol |
| ALE | GPT-6.2 Astra | 5.2点向上 | 前世代 Astra |
| FrontierCode 2.0(max推論モード) | GPT-6.2 Sol | Astraとの差は0.5点以内、タスクコストはAstraの約1/5 | GPT-6.2 Astra |
ここで注目すべき点が3つあります。第一に、Astra と Sol の GDPval v2 における前世代の比較対象は異なります。Astra は GPT-6 Astra と、Sol は GPT-6.1 Sol と比較されているため、6.2 と 5.3 という数字でどちらがより大きく進歩したかを直接比較することはできません。第二に、ALE は「点」、GDPval v2 は「ポイント」を使用しており、単位と評価方法が異なります。第三に、FrontierCode 2.0 の結論は同テストの max 推論モードにのみ成立し、公式は Sol がすべてのタスクで Astra との差が0.5点以内であるとも、すべてのシナリオでコストが1/5で済むとも述べていません。
1.3 GPT-6.2 Astra と Sol の能力の境界
公式のモデル資料によると、両モデルはテキストと画像を入力として受け取り、出力はテキストです。つまり、画像を読み、スクリーンショットを分析し、グラフを理解したうえで、テキストで回答やコードを返すことができますが、それ自体はネイティブな動画生成モデルではありません。
動画生成が目的であれば、今回のリリースではその能力は直接提供されていません。資料を読み、レポートを書き、コードを書き、多段階の分析を行うことが目的であれば、今回のアップグレードはあなたの仕事とより密接に関わっています。
1.4 GPT-6.2 Astra と Sol の公式 API 標準価格
公式の開発者向けモデルページで標準価格が公開されています。単位は100万トークンあたりです。以下は公式価格であり、任何の第三者プラットフォームの見積もりを表すものではありません。
| 課金項目 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 非キャッシュ入力 | $8 | $2 |
| キャッシュ読み取り | $0.4 | $0.1 |
| 出力 | $40 | $10 |
| キャッシュ書き込み | 対応する保持期間の書き込み料率で課金され、通常の入力料金は重複して加算されない | 対応する保持期間の書き込み料率で課金され、通常の入力料金は重複して加算されない |
| 入力が 272K を超える場合 | リクエスト全体の入力およびキャッシュ料率 ×2、出力 ×1.5 | リクエスト全体の入力およびキャッシュ料率 ×2、出力 ×1.5 |
キャッシュの課金は重複して合算しないでください。 入力量は、通常入力、キャッシュ読み取り、30分キャッシュ書き込み、12時間キャッシュ書き込みという4つの互いに排他的な部分に分ける必要があります。通常入力量 = 総入力量 − キャッシュ読み取り量 − すべてのキャッシュ書き込み量です。各部分はそれぞれ対応する料率を掛け、同じ書き込みトークンに対して通常入力価格で重ねて課金されることはありません。たとえば Astra の Standard 短コンテキストでは、30分書き込み価格は $10/100万トークンであり、これはその部分の完全な書き込み料率であって、$8 の通常入力価格にさらに $10 を上乗せするものではありません。公式キャッシュ課金の説明
272K ルールには特に注意が必要です。これは超過分だけを値上げするのではなく、1回のリクエストの入力が 272K トークンを超えた場合、リクエスト全体の入力とキャッシュの料率が倍になり、出力料率は1.5倍になります。資料庫全体を一度にコンテキストへ詰め込む習慣のあるユーザーは、請求額が予想よりかなり高くなる可能性があります。
二、GPT-6.2 Astra と Sol の分析・評価
以下の内容は、APIYI 編集チームが前出の公式情報に基づいて行った解釈であり、公式の結論でも、私たちの実測結果でもありません。傾向に関する部分はあくまで判断です。ご自身のタスクに照らして検証してください。
2.1 GPT-6.2 Astra と Sol は今回何をアップグレードしたのか
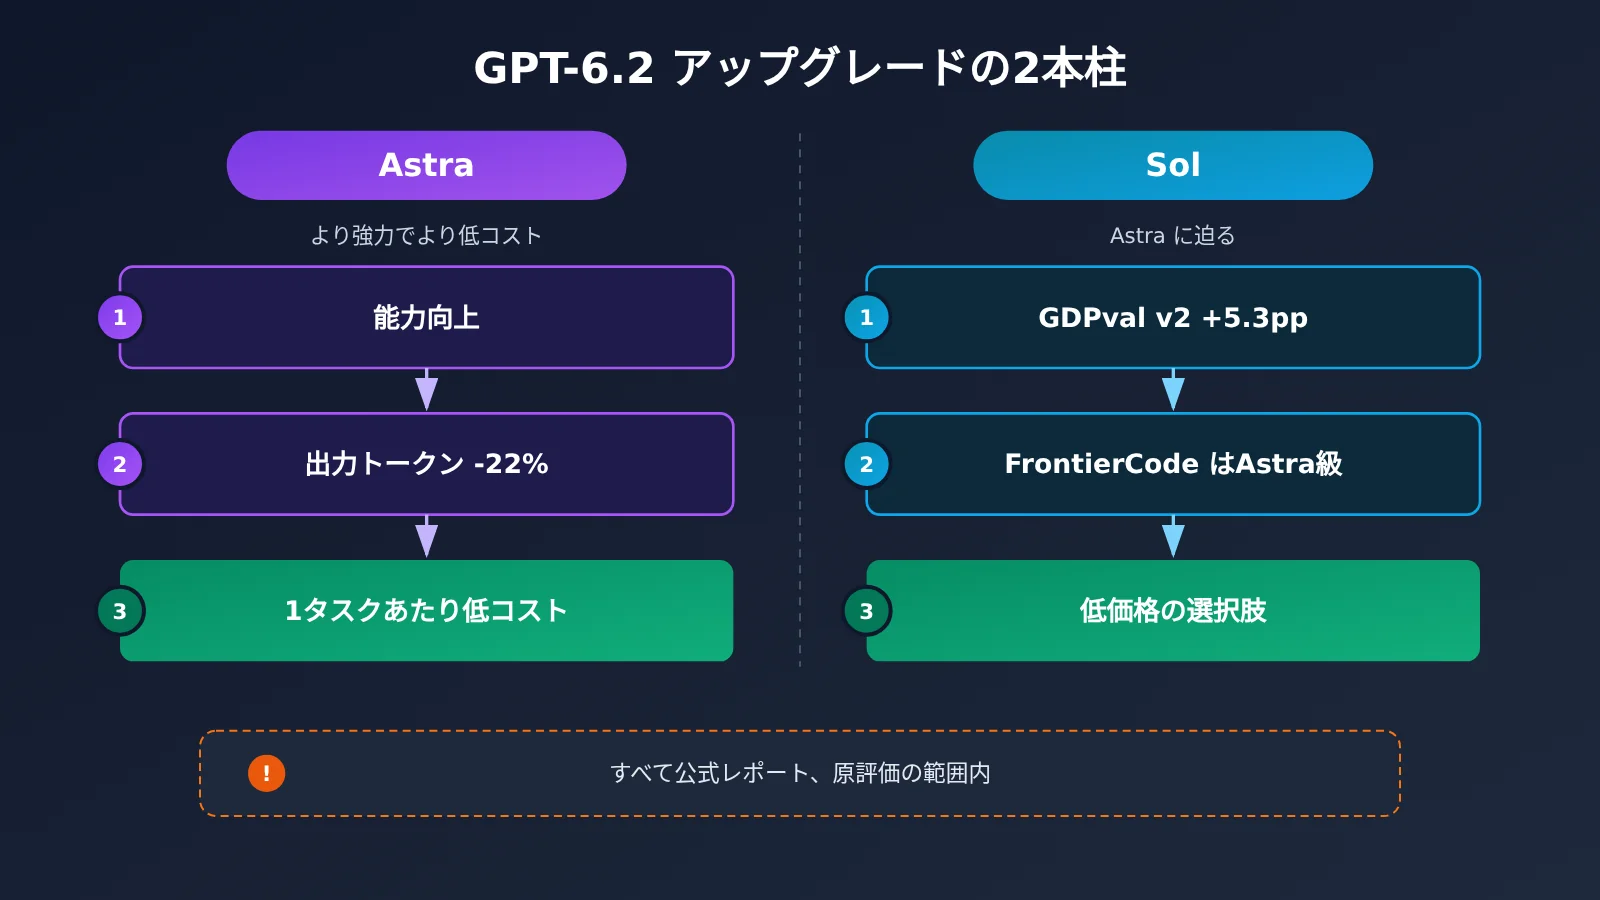
公式データから見ると、今回のアップグレードは大きく2つの主軸にまとめられます。ひとつは Astra の「より高性能、かつより省リソース」です。GDPval v2 で6.2ポイント向上させると同時に、出力トークンを22%削減しました。この22%は当該評価における出力トークン消費量の変化であり、回答1回あたりの見える分量や節約率を直接推算することはできません。
もうひとつは Sol の「追い上げ」です。GDPval v2 で5.3ポイント向上し、さらに FrontierCode 2.0 の max 推論モードでは Astra との差が0.5ポイント以内に収まっています。これは公式が Sol を、能力が遜色なく、価格ははるかに安い選択肢へと押し上げようとしていることを示しています。ただし「追い上げ」という判断は現時点では単一のプログラミングテストにのみ裏付けられており、執筆・分析・長文ドキュメントなどのタスクに当てはまるかどうかは、さらに多くのデータが必要です。
2.2 GPT-6.2 Astra と Sol の役割分担
以下の表では、2つのモデルを同じ観点で比較します。このうち「適するシーン」列は編集部の判断であり、価格と公式評価の方向性に基づく推測です。もう一方のモデルがそのシーンでまったく使えないという意味ではありません。
| 観点 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| 位置づけの傾向 | 複雑・専門的・高付加価値なタスク | 速度とコストに敏感なタスク |
| 公式価格(入力/出力) | $8 / $40 | $2 / $10 |
| 公式ベンチマークのハイライト | GDPval v2 で +6.2 ポイント、出力トークン -22%、ALE +5.2 ポイント | GDPval v2 で +5.3 ポイント、FrontierCode 2.0 の max ティアでは Astra との差が 0.5 ポイント以内 |
| 適するシーン(編集部の判断) | 重要なレポート、複雑なコードリファクタリング、多段階推論、ミスのコストが高い意思決定支援 | バッチ処理、日常的な質疑応答、定型的なプログラミング、高頻度の呼び出し、プロトタイプ検証 |
| 注意点 | 単価が高く、長いコンテキストではコスト増大がより顕著になる | プログラミングベンチマークでは Astra に近いが、すべてのタスクに一般化することはできない |
| 利用できる経路 | ChatGPT Work、Codex、公式 API。APIYI apiyi.com などのサードパーティ集約プラットフォームでは、モデル一覧を基準にしてください | 同上 |
見落とされやすいポイントがあります。公式価格では Sol の単価は Astra の約 1/4 ですが、FrontierCode 2.0 におけるタスクコストは約 1/5 です。この差は不自然ではありません。タスクコストは実際に消費するトークン数にも左右されるからです。つまり、コストを比較する際は単価だけでなく「同じタスクを完了するまでの総費用」を見るべきだということも示しています。
公式価格に基づく概算例を挙げます。1回のリクエストで入力 10万トークン、出力 1万トークン、キャッシュが関与しない場合、Astra は約 $0.8 + $0.4 = $1.2、Sol は約 $0.2 + $0.1 = $0.3 です。実際の費用は推論ティア、出力長、キャッシュヒットによって変動します。具体的な費用の試算は本記事では扱いません。
2.3 一般ユーザーは GPT-6.2 Astra と Sol のどちらを選ぶべきか
ChatGPT Work を利用する一般ユーザーの場合は、「一度間違えたときのコスト」を基準に判断するとよいでしょう。作業を間違えるとやり直しに時間がかかる場合や、重要な意思決定に影響する場合は、たとえば契約書の要点整理、複雑なデータ分析、正式なレポートの下書きなどが該当しますが、こうした作業は Astra を優先してください。一方、作業が簡単で量が多く、結果をすぐ確認できる場合は、たとえばメールの文面調整、会議議事録の整理、日常的な調べものなどが該当しますが、これらは通常 Sol で十分です。
Codex ユーザーの場合、FrontierCode 2.0 のデータは試す価値のある方向性を示しています。まず Sol で通常の開発作業を処理し、モジュールをまたぐリファクタリング、原因特定が難しいバグ、アーキテクチャ設計などに遭遇したときに Astra へ切り替えるという方法です。ただし、これは単一のテストに基づく提案であり、最終的には自分のコードベース上での性能を基準にしてください。
通常の ChatGPT チャットのみを利用している場合、今回のリリースにはこの入口は含まれていません。公式に対象範囲の拡大が発表されるまでは、今回のリリースに向けて準備する必要はありません。
2.4 開発者が API で GPT-6.2 Astra と Sol を検証する方法
開発者にとって最も確実な方法は、同じ実タスクのセットで両方のモデルをそれぞれ呼び出し、品質、レイテンシ、実際の token 消費量を比較することです。以下のサンプルは公式 SDK ドキュメントに基づいて書き直したもので、まだ実行検証は行っていません。OpenAI 公式インターフェースを使用しており、モデル ID は公式モデルページを基準にしてください。サードパーティのプラットフォームを使用する場合は、まずそのプラットフォームのモデルリストで該当モデルが利用可能であることを確認してください。本記事では、いかなるサードパーティプラットフォームの提供開始状況も検証していません。
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # 公式 API、キーは環境変数で提供
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # モデル ID は公式またはプラットフォームのモデルリストを基準にしてください
    messages=[{"role": "user", "content": "この要件ドキュメントのリスクポイントを 3 文で要約してください"}]
)
print(response.choices[0].message.content)
Astra と Sol の比較呼び出しの完全なコードを見る
import time
import openai

client = openai.OpenAI(
    api_key=__import__("os").environ["OPENAI_API_KEY"]  # 公式 API、キーは環境変数で提供
)

# モデル ID は公式モデルページまたはプラットフォームのモデルリストを基準にしてください
MODELS = ["gpt-6.2-astra", "gpt-6.2-sol"]

# 自分の実際のタスクに置き換えてください。単一の公開評価だけを見ないようにしましょう
TASKS = [
    "次の関数を読んで潜在的な並行処理の問題を指摘してください:...",
    "この会議記録を 5 つの ToDo に整理してください:...",
]

def run(model: str, prompt: str) -> dict:
    start = time.time()
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
        )
        usage = resp.usage
        return {
            "model": model,
            "seconds": round(time.time() - start, 2),
            "input_tokens": usage.prompt_tokens,
            "output_tokens": usage.completion_tokens,
            "answer": resp.choices[0].message.content,
        }
    except Exception as e:
        return {"model": model, "error": str(e)}

for task in TASKS:
    for model in MODELS:
        result = run(model, task)
        print(result)
同時に、入力の総量、キャッシュ読み取り、保存期間ごとに区別されたキャッシュ書き込み、課金対象出力(推論を含む)、およびツール使用量を記録し、実際のサービスプロバイダーとサービスティアの料率で計算してください。公式価格は公式 API の見積もりにのみ適用されます。また、単一リクエストの入力を 272K token 以内に抑え、リクエスト全体がより高い料率を引き起こすのを避けることをおすすめします。
🎯 技術的なアドバイス:同じコードの中で複数のモデルを比較する必要がある場合は、APIYI apiyi.com の OpenAI 互換インターフェースを利用できます。1 つの API キーで OpenAI、Claude、Gemini などの主要モデルを切り替えられます。GPT-6.2 シリーズがすでにプラットフォームで提供されているかどうかは、プラットフォームのモデルリストを基準にしてください。
2.5 GPT-6.2 Astra と Sol、今後注目すべき変数
1つ目の変数は提供範囲です。標準の Chat は今回の対象外で、公式が対象を拡大するかどうか、そしていつ拡大するかについての公開情報はまだありません。これは大多数の一般ユーザーがいつ新しいモデルを使えるようになるかを左右します。2つ目の変数は、より多くのタスクタイプに関するデータです。Sol がプログラミング以外でも Astra に迫れるかどうかは、サードパーティやより多くの公式評価によって答えが出る必要があります。
3つ目の変数は実際のコストパフォーマンスです。Astra の出力トークンが22%削減されるというのは GDPval v2 上での結果であり、ご自身のタスクに置き換えた場合に同じ比率になるとは限りません。発表会の数字をもとに一度で長期的な方針を決めるのではなく、実際の呼び出しデータを継続的に記録することをおすすめします。
『論語・衛霊公』に曰く、「工欲善其事、必先利其器」(仕事をうまく成し遂げようとするなら、まずその道具をよく研ぐ必要がある)。
📚 参考資料
OpenAI API 更新ログ(公開日の確認)
-
OpenAI 公式発表ページ:GPT-6.2 Astra と Sol の発表告知および公式評価
- リンク: 公式原文
- 説明: 公開日時、GDPval v2、ALE、FrontierCode 2.0 のデータソース
-
OpenAI ヘルプセンター:ChatGPT Work と Codex の説明
- リンク: 公式原文
- 説明: 提供入口と段階的開放の範囲
-
OpenAI 開発者ドキュメント – GPT-6.2 Astra:モデル資料と API 価格
- リンク: 公式原文
- 説明: 入出力モダリティ、標準価格、長コンテキストの課金ルール
-
OpenAI 開発者ドキュメント – GPT-6.2 Sol:モデル資料と API 価格
- リンク: 公式原文
- 説明: 入出力モダリティ、標準価格、長コンテキストの課金ルール
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のサイトトップページからお気軽にお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターをご覧ください