著者注:本記事は、FrontierHarness v1.1 の全 26,040 回の実行が終了した後の最終ランキングのみを読み解きます。モデル別に 21 個の harness を比較し、APIYI 上で関連モデル ID が実際に公開しているプロトコルと価格を照合します。
Codex CLI、Claude Code、OpenCode、Pi のようなコーディング Agent をすでに使っていて、頻繁に基盤モデルを切り替えているなら、「どの harness が最適か」という問いに統一的な答えはまずありません。2026-11-10、Runta の Guanlan Dai が FrontierHarness v1.1 を立ち上げ、そのまま投げかけた問いは、モデルを切り替えるとき、harness も切り替えるべきなのか? でした。2026-11-15 時点で、ライブリーダーボードは running 0、scored 26,040 を示し、21 個の harness × 5 モデル × 62 タスク × 4 試行がすべて実行完了しています。
これは「ある harness が総合首位」というランキング解説ではありません。最終ランキングでは、通過率トップと、通過 1 回あたりのコストが最も安い harness は同じではありません。5 つのモデルそれぞれで最も安い harness も同一ではなく、本記事ではこれらの結論をモデルごとに分解し、1 項目ずつ明確に説明します。
本記事の価値:読み終えると、モデル別に分かれた FrontierHarness 最終ランキングの比較表が手に入り、モデルを切り替えるときにどの列を見るべきか、どの古い数値が使えなくなるか、接続前にどのプロトコルを確認すべきかがわかります。
FrontierHarness 最終ランキングの基準:どのハーネスが最良かを判断する前にルールを確認しよう
FrontierHarness のすべての実行は Runta runtime 内で行われ、同一のリソース制限が適用されます。各ハーネス × モデルの組み合わせは 248 回の実行を完了して初めて最終結果とみなされるため、ライブ配信中の順位は新しい結果に応じて刻々と変わります。以下の表は v1.1 最終ランキングのスコアリング基準をまとめたもので、以降のすべての比較はこれを基準にします。
| 基準項目 | v1.1 最終ランキングの設定 | 比較時の意味 |
|---|---|---|
| データセット | [email protected]、62 タスク |
すべてのハーネスが同じ問題セットを解く |
| 規模 | 21 個のハーネス、各タスク 4 回、各組み合わせ 248 回、各モデル 5,208 回、合計 26,040 回 | 各セルの分母が一致し、横比較が可能 |
| 実行環境 | 1–4 vCPU、2–8 GB メモリ、32 GB ディスク、1 タスクあたりのタイムアウト 15 分〜8 時間 | マシン差異を排除 |
| 推論設定 | 推論プロバイダー Baseten、5 モデルすべて effort は max | モデル側の変数を統一 |
| 通過率 | 通過数 ÷ 成績に算入される試行;タイムアウトと reward hacking は失敗、インフラストラクチャエラーは算入しない | 答えを盗み見ても得点にはならない |
| コスト | カタログ価格 × 報告 token | ランキング算出のアルゴリズムであり、どのプラットフォームの請求額でもない |
| 信頼度 | タスクごとに 95% bootstrap | 差がごく小さい順位は慎重に解釈する |
よくシェアされる数値がいくつかありますが、それらはいずれも v1.1 最終ランキングではありません。v1.0 は Kimi K3 という 1 つのモデルだけで 9 個のハーネス、12 種類の設定、360 回をテストしており、Codex の通過率 66.7% とタスクあたりのコスト中央値 $3.47 はいずれも v1.0 のものです。2026-11-11 の中間スナップショットでは、通過 1 回あたりのコストが $0.57〜$1.32、通過率が 56.2%〜77.6% でしたが、これも同じく途中経過の状態にすぎません。同日に「GLM-5.3 には KimiCode が最適、Kimi-K3 には Codex が最適」と書いた人がいましたが、最終ランキングの通過 1 回あたりのコストで並べ替えると、これらの主張はどれも成立しなくなります。
どの harness がベストか:FrontierHarness 全体最終ランキング比較
以下の表は、21 種類の harness が 5 つのモデルで記録した成績をまとめ、「1 回合格あたりのコスト」が低い順に並べたものです。ドル建ての数値はすべて、FrontierHarness の最終ランキングでカタログ価格に報告 token 数を掛けて算出されています。
| 順位 | harness | 1 回合格あたりのコスト | タスク 1 回あたりの平均コスト | 合格率 |
|---|---|---|---|---|
| 1 | Codex CLI | $0.937 | $0.573 | 61.1% |
| 2 | Pi | $0.976 | $0.563 | 57.7% |
| 3 | Oh My Pi | $0.983 | $0.564 | 57.3% |
| 4 | ZCode | $1.06 | $0.659 | 61.9% |
| 5 | KimiCode | $1.09 | $0.653 | 60.2% |
| 6 | OpenCode | $1.12 | $0.646 | 57.4% |
| 7 | Maka | $1.13 | $0.654 | 57.7% |
| 8 | MiniMax Code | $1.14 | $0.647 | 56.8% |
| 9 | DeepSeek Harness: Minimal | $1.15 | $0.661 | 57.4% |
| 10 | Hermes Agent | $1.16 | $0.692 | 59.9% |
| 11 | Cline CLI | $1.19 | $0.689 | 57.7% |
| 12 | Grok Build | $1.20 | $0.723 | 60.0% |
| 13 | Alma | $1.22 | $0.731 | 59.7% |
| 14 | DeepSeek Harness: Standard | $1.27 | $0.697 | 55.0% |
| 15 | DeepSeek Harness: Creator | $1.27 | $0.713 | 56.1% |
| 16 | mini-SWE-agent | $1.29 | $0.757 | 58.6% |
| 17 | DeepSeek Harness: Code | $1.32 | $0.732 | 55.2% |
| 18 | Exo | $1.36 | $0.691 | 50.6% |
| 19 | GitHub Copilot CLI | $1.38 | $0.787 | 56.9% |
| 20 | Claude Code | $1.55 | $0.915 | 58.9% |
| 21 | Antigravity CLI | $1.63 | $0.897 | 55.0% |
全体最終ランキングで 2 つの「第 1 位」
全体で合格率が最も高いのは ZCode(61.9%)、1 回合格あたりのコストが最も安いのは Codex CLI($0.937)で、この 2 つは必ずセットで見る必要があります。Codex CLI の合格率は 61.1% で、ZCode よりわずか 0.8 ポイント低いだけですが、1 回合格あたりのコストは約 $0.12 安くなります。一方、ZCode は「より多くの問題に合格したい」場面で、より安定した選択肢になります。最も高コストな Antigravity CLI は 1 回合格あたり $1.63 で、Codex CLI の約 1.74 倍です。全体の合格率は Exo の 50.6% から ZCode の 61.9% の間に収まり、その差は 11.3 ポイントです。
誤解しやすい点が 2 つあります。1 つ目は、4 つの DeepSeek Harness は同一バージョン 0.2.1-rc.3 の 4 種類の構成(Minimal、Standard、Creator、Code)であり、4 つの独立した製品ではないということです。2 つ目は、Alma は 1 回合格あたりのコストでは 13 位、合格率では 6 位で、ZCode、Codex CLI、KimiCode、Grok Build、Hermes Agent の後に位置します。11 月 11 日時点のスナップショットで Alma が 3 位、72.7% という記述は途中段階のデータであり、最終ランキングの 59.7% を基準にしてください。
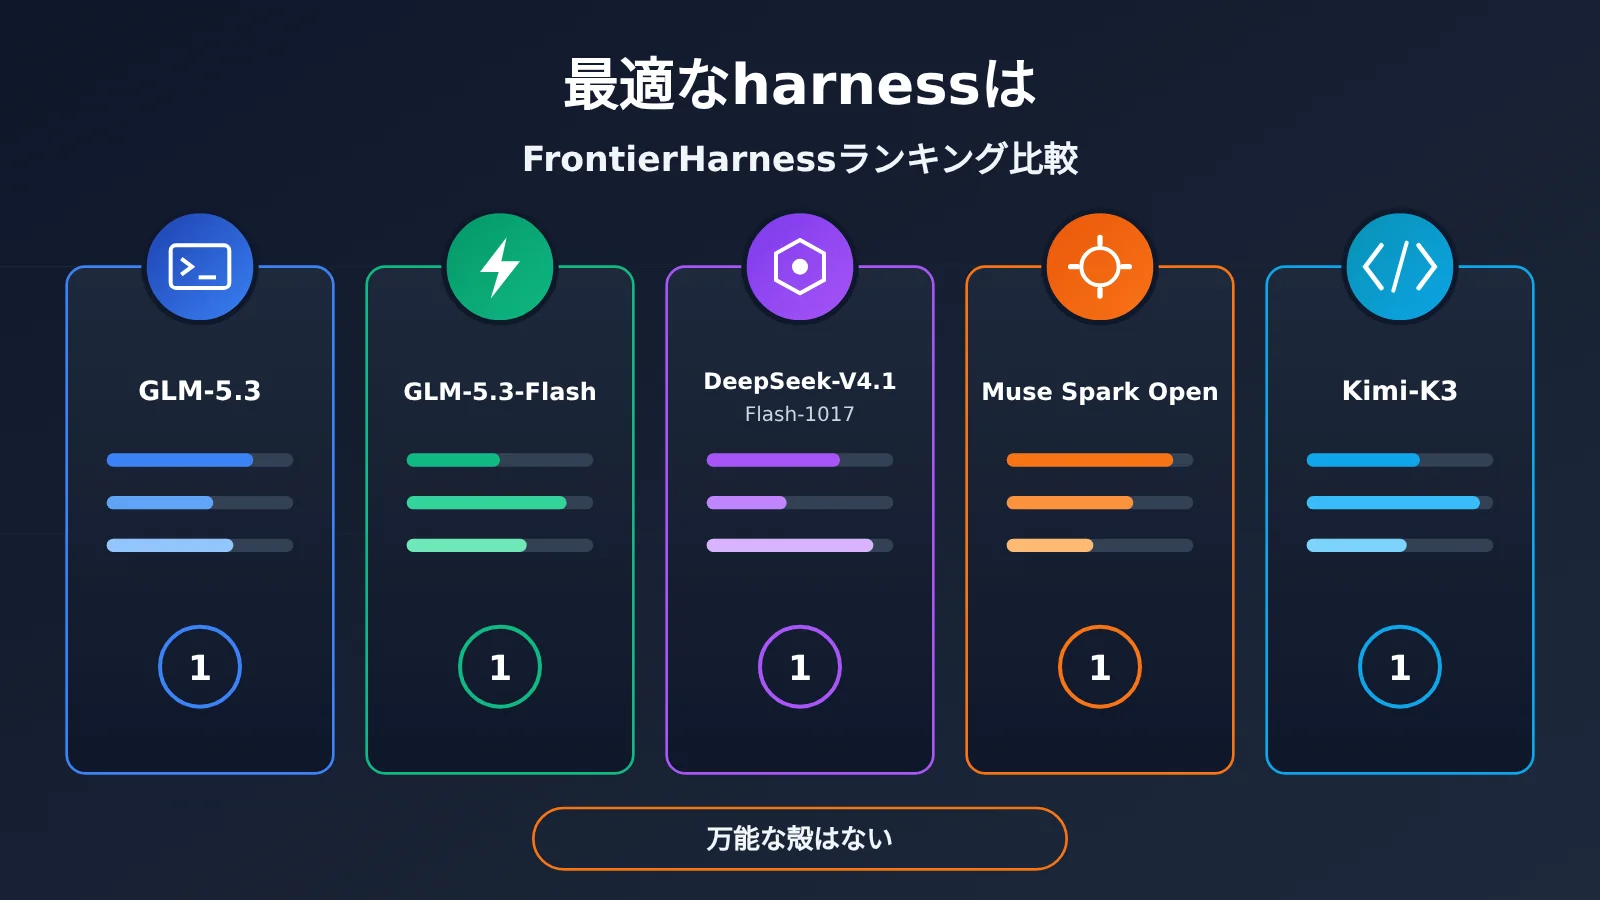
モデルを変えたとき、どのharnessが最適か:FrontierHarness 5モデル別の内訳
全体の集計では平均値しか分かりません。実際に請求額を決めるのは、手元のモデルの列です。下の表の「最安」は、いずれもそのモデルのページで1回あたりの通過コストが最も低い harness を指し、通過数の分母はすべて 248 です。
| モデル | タスク1回あたりの平均コスト(harness 平均) | 1回通過あたりの最安 | 通過率が最高 | 同一モデル内で最高額 |
|---|---|---|---|---|
| GLM-5.3 | $0.968 | Codex CLI $0.803、57.7% | ZCode 58.9%、$1.48 | Exo $2.72、50.0% |
| GLM-5.3-Flash | $0.193 | Pi $0.223、58.1% | Hermes Agent 60.9%、$0.328 | DeepSeek Harness: Minimal $0.484、55.2% |
| DeepSeek-V4.1-Flash-1017 | $0.185 | OpenCode $0.177、61.3% | ZCode 69.0%、$0.222 | Cline CLI $0.860、63.3% |
| Muse Spark Open | $1.01 | Oh My Pi $1.21、58.9% | Grok Build 59.7%、$1.77 | Claude Code $3.75、52.8% |
| Kimi-K3 | $1.12 | Oh My Pi $1.45、57.7% | mini-SWE-agent 64.9%、$2.02 | Antigravity CLI $2.73、56.9% |
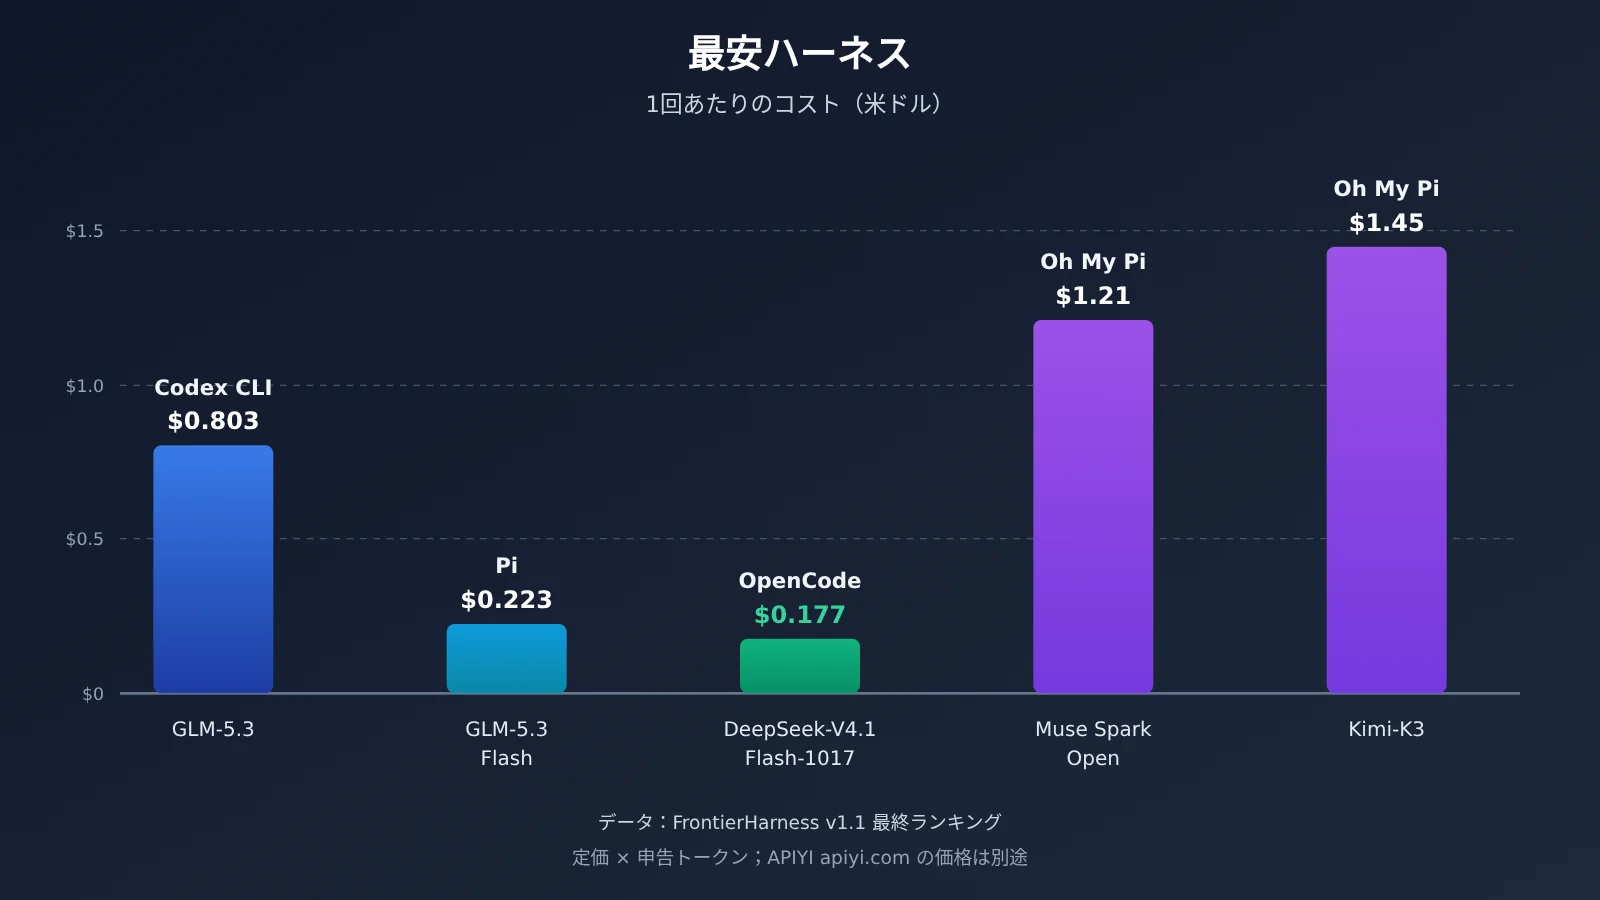
結論1:5つのモデルで最も安いハーネスは同一ではない
5列それぞれの最安シェルは Codex CLI、Pi、OpenCode、Oh My Pi、Oh My Pi で、4種類の異なるシェルです。総合1位の Codex CLI が最安を取ったのは GLM-5.3 の列だけで、GLM-5.3-Flash では $0.226 と Pi よりわずかに高いだけでした。つまり、モデルを切り替える際にはハーネスも見直す必要があり、以前の組み合わせをそのまま流用することはできません。
結論2:モデル変更によるコスト差はシェル変更より大きい
モデル別に1タスクあたりの平均コストを見ると、DeepSeek-V4.1-Flash-1017 の $0.185 から Kimi-K3 の $1.12 まで、およそ6.1倍の開きがあります。一方、ハーネス別の全体平均1タスクあたりコストは、最も低い Pi が $0.563、最も高い Claude Code が $0.915 で、差は2倍未満です。つまり FrontierHarness の最終ランキングでは、モデルを先に選ぶことがタスクコストに与える影響のほうが、シェルを先に選ぶ場合よりも大きいということです。
結論3:自社ハーネスは自社モデルで最安値を取れなかった
DeepSeek-V4.1-Flash-1017の列では、合格あたりのコストで見ると、DeepSeek Harnessの4段階はそれぞれCode $0.243 / 64.1%、Minimal $0.256 / 63.7%、Creator $0.273 / 64.9%、Standard $0.292 / 62.1%でした。最安値(OpenCode $0.177)も、最高合格率(ZCode 69.0%、171/248。これは全組み合わせの中で最高の合格率を記録したマスでもあります)も取れていません。Claude Codeはこのマスで68.1%、Codex CLIは$0.237 / 67.3%です。同じ列で最も高いCline CLIは1試行あたり6.77Mトークンを消費し、合格あたり$0.860で、OpenCodeの約4.9倍でした。この倍率はこの組み合わせに限った話です。
Kimi-K3の列も同じです。合格あたりのコストで見ると、自社ハーネスのKimiCodeは$1.84 / 60.1%で、Oh My Piの$1.45に及ばず、合格率もmini-SWE-agentの64.9%、AlmaとZCodeの64.1%を下回ります。全体で最も低い合格率のマスもここにあります。Exo + Kimi-K3で43.5%、108/248です。
シナリオ別のおすすめ:モデルごとに最適なハーネスを選ぶ
ここまでの列ごとの結論を実際の選択に落とし込むと、「どのモデルを使うか + コストと合格率のどちらを重視するか」で分けられます。
GLM-5.3を使う場合
- 合格あたりのコストを重視する場合:Codex CLI、$0.803、57.7%、1試行あたり約1.86Mトークン。
- 合格率を重視する場合:ZCode、58.9%。ただし合格あたり$1.48で、Codex CLIの約2倍です。
- 注意点:KimiCodeはこの列で$1.55 / 58.1%となり、以前の暫定的な見方はもう通用しません。
GLM-5.3-Flashを使う場合
- コストを重視する場合:Pi($0.223)とCodex CLI($0.226)はほぼ互角で、後者の合格率は59.3%とやや上回ります。
- 合格率を重視する場合:Hermes Agent 60.9%、合格あたり$0.328。ZCodeは60.1%、$0.264でバランス型の選択肢です。
DeepSeek-V4.1-Flash-1017を使う場合
- コストを重視する場合:OpenCode、$0.177、61.3%。
- 合格率を重視する場合:ZCode、69.0%、合格あたり$0.222で、最安のものより約$0.045高いだけです。この列では、合格率を追求するコストはとても低いです。
Muse Spark OpenまたはKimi-K3を使う場合
- Muse Spark Open:Oh My Piが最も安く($1.21)、Grok Buildが最も高い合格率(59.7%)。Claude Codeは1試行あたり9.79Mトークン、合格あたり$3.75で、この列で最も高いマスです。
- Kimi-K3:Oh My Piが最も安く($1.45、1試行あたり942kトークン)、mini-SWE-agentが最も高い合格率(64.9%)。Codex CLIは$1.78 / 63.7%で、コストと合格率のどちらでも大きく見劣りしません。
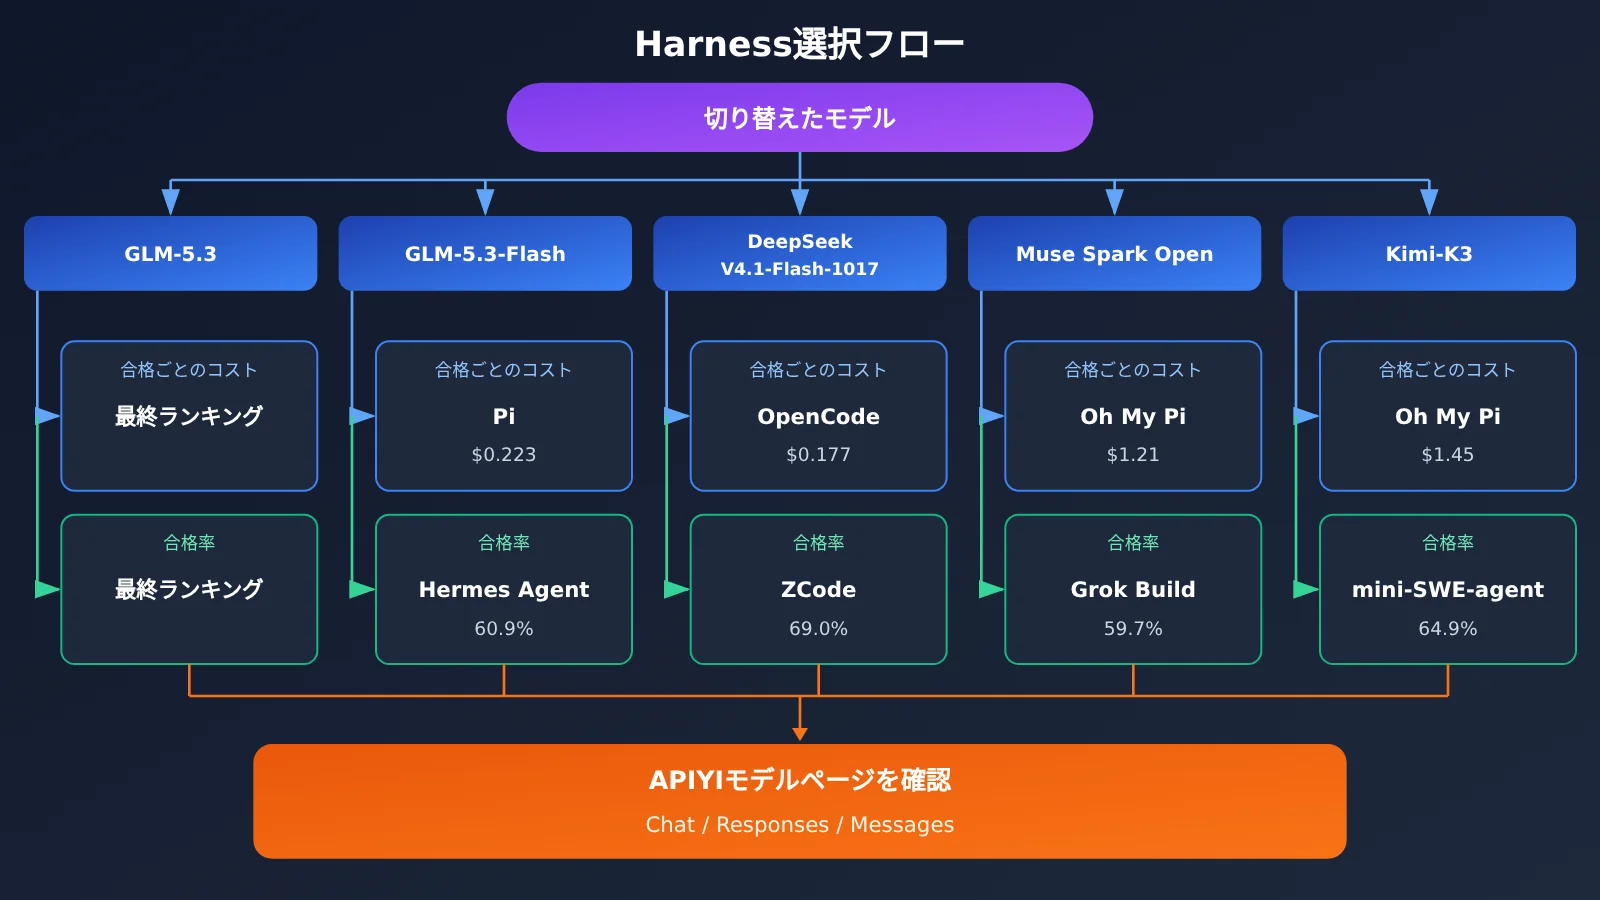
意思決定のヒント:harness プロトコルと APIYI モデル ID の対応表
ランキング上の harness とプラットフォームのエンドポイントは一対一で対応しているわけではありません。Codex CLI のスコアが良くても、手元のモデル ID で Responses が開放されているとは限りません。Claude Code も同じで、まず Messages の列を確認する必要があります。どの harness もタスクを実行するとトークンを消費し、シェルを変えてもモデルを変えても請求額は直接変わります。そのため、あるマス目を試す前に、まず APIYI apiyi.com のモデルページでその ID が Chat、Responses、Messages のどれを開放しているかを確認し、そのうえで harness の base_url を https://api.apiyi.com/v1 に向けることをおすすめします。
以下の表は APIYI ドキュメントにおける 2026-11-15 時点のデフォルト価格(米ドル / 1M tokens)で、上記のランキングのカタログ価格とは別系統の数字です。両者を混ぜて計算することはできません。
| モデル ID | 入力 | キャッシュ読み | 出力 | Chat | Responses | Messages | グループ |
|---|---|---|---|---|---|---|---|
glm-5.3 |
$1.4 | $0.259 | $4.396 | 対応 | 非対応 | 対応 | ClaudeCode 0.95×、Default、SVIP |
glm-5.3-flash |
$0.15 | $0.03 | $0.5 | 対応 | モデルページ:非対応 | モデルページ:非対応 | CodexResponses、Default、SVIP |
deepseek-v4.1-flash-1017 |
$0.3 | $0.006 | $1.2 | 対応 | 総表になし | 対応 | ClaudeCode、Default、SVIP |
deepseek-v4.1-flash |
$0.3 | $0.006 | $1.2 | 対応 | グループ欄参照 | 対応 | CodexResponses が追加 |
kimi-k3 |
$3 | $0.3 | $15 | 対応 | 非対応 | 非対応 | Default、SVIP |
| Muse Spark Open | 未掲載 | — | — | — | — | — | — |
いくつか、項目ごとに補足が必要な点があります:
glm-5.3は Messages を利用でき、ClaudeCode グループの 0.95× も用意されています。Claude Code のようなシェルと組み合わせるのに適しています。この 0.95× はglm-5.3だけのものです。Responses は利用できません。glm-5.3-flashは総表とモデルページで 2 か所の不一致があり、両方の記述をそのまま残しています。グループ欄には CodexResponses が記載されていますが、モデルページでは Responses も Messages も非対応と書かれています。総表のタイプ列は「テキスト」、モデルページは入力にテキスト・画像・動画を含むと記載されています。deepseek-v4.1-flash-1017は Messages を利用できますが、総表からは CodexResponses が読み取れません。Responses が必要な場合は、もう一方のdeepseek-v4.1-flashを確認してください。kimi-k3は Chat Completions のみです。Codex CLI や Claude Code を使う前に、その harness が Chat プロトコルに接続できるかを確認する必要があります。- 経済版の
deepseek-v4-1-flash-economy-261017は、入力 $0.24、出力 $0.96、キャッシュ読み $0.006 で、chat のみを開放しています。APIYI のリアルタイム情報によると、標準版と同じ V4.1-Flash-1017 の重みを読み込んでおり、生成はより遅くなります。強調しておきたいのは、FrontierHarness はこの ID をテストしておらず、ランキング上の通過率をそのまま当てはめることはできないという点です。 - Muse Spark Open はまだ掲載されていません。このモデルはできるだけ早く掲載する予定です。型番と価格はプラットフォームのモデル一覧を基準にしてください。
💡 選び方のヒント:まずモデルごとに、最終ランキングの該当列から候補となるシェルを選び出し、次にプロトコルで接続できない組み合わせを除外し、最後に同じタスク群で小規模な試運転を行います。APIYI apiyi.com で 1 つのキーを使って
glm-5.3、kimi-k3などの ID を切り替えれば、「モデルの変更」と「シェルの変更」という 2 つの変数を分けてテストできます。
| あなたの目標 | まず見るべき列 | 最終ランキング候補 |
|---|---|---|
| モデルが未定で、堅実なハーネスだけ欲しい | 全体集計 | Codex CLI(1回あたりの通過コストが最安)、ZCode(通過率が最高) |
| モデルは確定済みで、コストを抑えたい | 該当モデルの1回あたり通過コスト | 5モデル別リストの「最安」列を参照 |
| モデルは確定済みで、通過率を追求したい | 該当モデルの通過率 | 5モデル別リストの「最高」列を参照 |
| 総予算を圧縮したい | モデルの1タスクあたり平均コスト | まずモデルを変え、次にハーネスを変える |
よくある質問(FAQ)
Q1:FrontierHarnessとは何ですか。どのように「どのハーネスが最良か」を答えるのですか?
FrontierHarness は Runta が主催するコーディングAgentハーネスの評価です。v1.1 では21個のハーネスが5つのモデル上でそれぞれ62タスクを、各タスク4回ずつ実行し、同一環境で通過率とコストを集計します。提示されるのは単一の王者ではなく、モデルごとのランキング列です。
Q2:Codex CLI と ZCode はいったいどちらが1位なのですか?
両方とも1位ですが、基準が異なります。1回あたりの通過コストでは Codex CLI が $0.937 で1位、通過率では ZCode が 61.9% で1位です。予算を優先するか成功率を優先するかで選んでください。
Q3:v1.0 の 66.7% や11月11日のランキングはまだ参考になりますか?
最終ランキングとしては使えません。v1.0 は Kimi K3 と9個のハーネスのみを対象に、計360回の実行でした。11月11日は v1.1 の実行途中のスナップショットです。2026-11-15 のライブランキングでは26,040回の実行が完了しており、この時点の最終ランキングを基準にすべきです。
Q4:Claude Code で GLM-5.3 を実行する際の注意点は?
最終ランキングには Claude Code と GLM-5.3 の組み合わせが個別に掲載されていないため、その成績を直接推測することはできません。プロトコルレベルでは、`glm-5.3` は Messages をサポートしており、APIYI apiyi.com には ClaudeCode グループ 0.95× もありますから、接続条件は整っています。
Q5:自分の環境で特定のマスを再現するにはどうすればよいですか?
FrontierHarness はセルフテスト用の入り口を提供しており、自分のモデルキーを使って同一環境で実行できます。プラットフォーム側の手順は、まずモデルIDがハーネスに必要なプロトコルを開放していることを確認し、次にハーネスの base_url を `https://api.apiyi.com/v1` に設定します。新規ユーザーは無料テスト枠を使って、まず数問だけ試すこともできます。
Q6:この最終ランキングにはどのような限界がありますか?
ランキング上のドルはカタログ価格に報告トークン数を掛けて算出しており、実際のプラットフォームでの請求額とは異なります。また、すべてのモデルで effort を max に設定しているため、他の設定に変えると結果が変わる可能性があります。さらに、一部の順位差は95%信頼区間内に収まっているため、隣接する順位を過度に解釈すべきではありません。
どのハーネスが最適か 主なポイント
- 万能なハーネスは存在しない:5つのモデルで最も安価なハーネスは、4種類の異なるハーネスに分かれた。
- 2つの首位が共存:通過率はZCodeが61.9%で最高、1回の通過あたりのコストはCodex CLIが$0.937で最安。
- コストへの影響はハーネスよりモデルが大きい:モデル間の平均タスクコスト差は約6.1倍、ハーネス間は2倍未満。
- 自社ハーネスは優位ではない:1回の通過あたりのコストで見ると、DeepSeekの4ティアとKimiCodeはいずれも自社モデルで最安を獲得できなかった。
- 最高の1マス:ZCode + DeepSeek-V4.1-Flash-1017、69.0%、171/248。
- 接続前にプロトコルを確認:APIYIのモデルページでChat、Responses、Messagesの3列を確認してからハーネスを選ぶ。
まとめ
FrontierHarness v1.1の最終ランキングにおける「どのハーネスが最適か」への答えは、モデルごとに見るべき、というものです。
- 総合で2つの首位:通過率はZCode、1回の通過あたりのコストはCodex CLI。
- モデルを変えたらハーネスも見直し:5列の最安ハーネスはそれぞれCodex CLI、Pi、OpenCode、Oh My Pi、Oh My Pi。
- 予算はまずモデルで判断:モデルによる平均タスクコストの差は、ハーネスを変えることによる差より大きい。
実際に選ぶ際は、まず最終ランキングであなたが使うモデルの列を探し、そのうえでプロトコルが接続可能かを確認しましょう。APIYI apiyi.com 経由で統一インターフェースを使いモデルIDを切り替え、候補の組み合わせを小規模に試すことをおすすめします。
📚 参考資料
- FrontierHarness ライブリーダーボード:v1.1 の最終ランキングとモデル別の内訳データ
- リンク:
frontierharness.org/live/ -
説明:2026-11-15 時点で「scored 26,040」と表示されています。本記事に掲載するすべてのランキング数値の出典です。
-
FrontierHarness セルフ評価用エントリ:ご自身のAPIキーを使って同一環境で実行
- リンク:
frontierharness.org/evaluate-your-own-harness/ -
説明:特定の harness × model の組み合わせを再現するのに適しています。
-
Guanlan Dai の投稿:v1.1 の問題設定と規模についての説明
- リンク:
x.com/guanlan/status/2120192585235046712 -
説明:248回に達して初めて最終となる仕組みや、推論スポンサーなどの背景情報を含みます。
-
APIYI モデル一覧:各モデルIDの価格、エンドポイント、グループ
- リンク:
docs.apiyi.com/models - 説明:本記事の価格データは、2026-11-15 09:36(UTC+8)時点のものです。
著者:APIYI 技術チーム
技術交流:APIYI 公式サイトのトップページからお問い合わせください。harness とモデルの組み合わせ選定について、ぜひご相談ください。