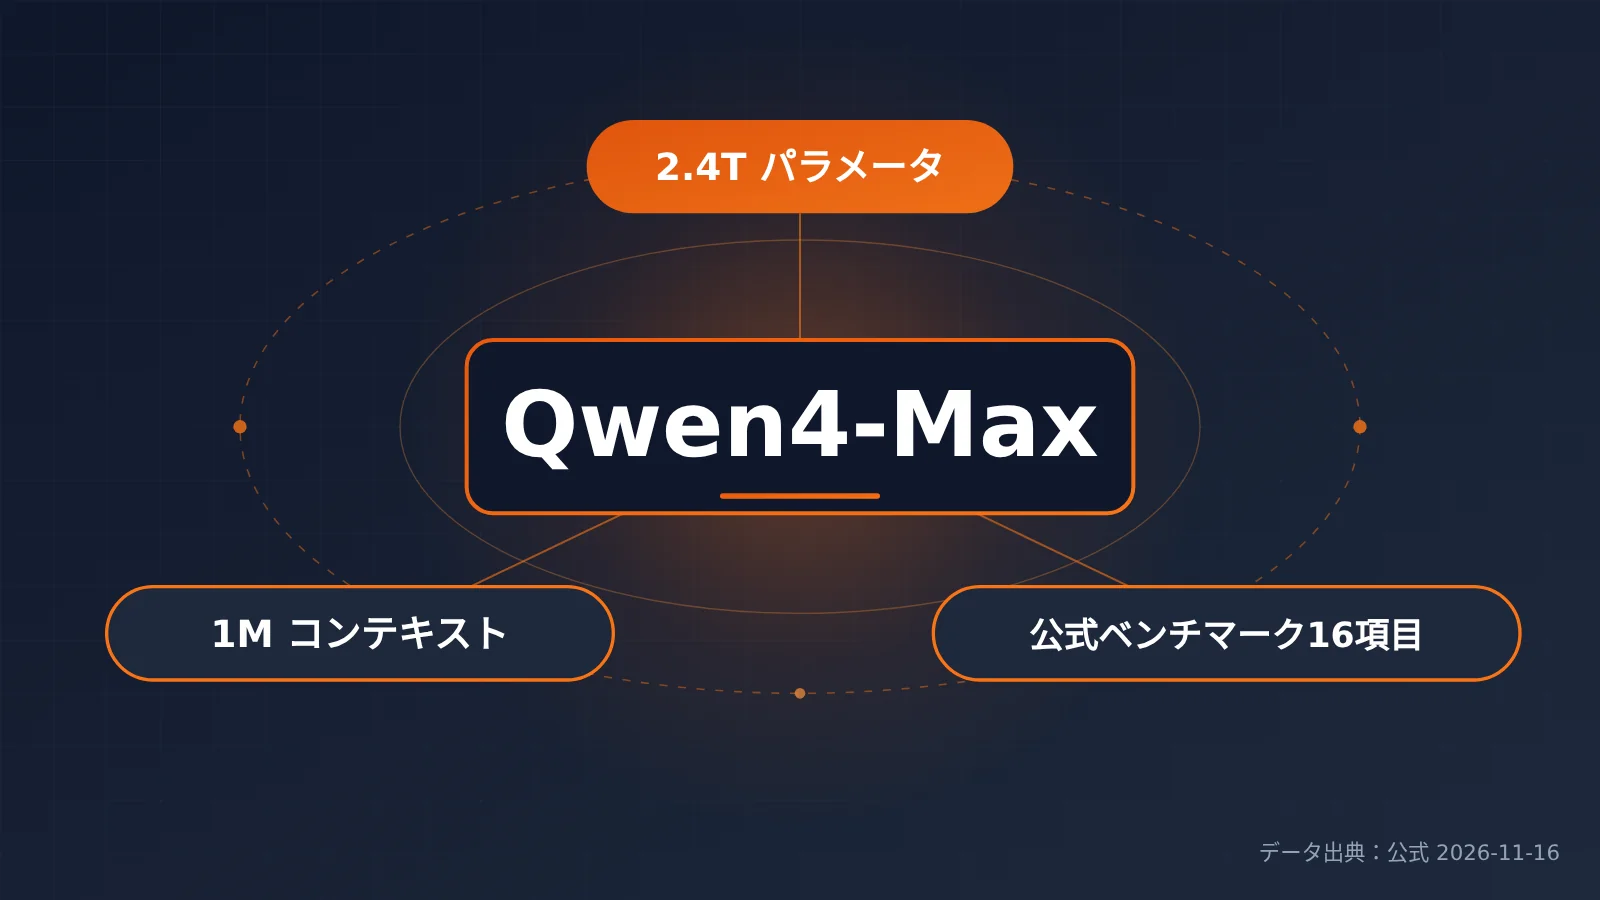
アリババのTongyiチームは2026年11月16日午前、Qwen4-Maxを発表しました。基幹パラメータは2.4T、コンテキストは1Mで、同時に16項目のベンチマークを含む比較チャートも公開しています。
先に結論から言うと、Qwen4-Maxが本当にリードしているのはトークン効率と長期的なタスク遂行力であり、すべての項目で1位というわけではありません。 公式が自己申告した16項目のベンチマークでは、4項目で1位、4項目で2位を獲得しています。一方、ターミナル操作、プログラム構築、チャート理解、動画理解の各項目では、同じチャート内のトップ競合に依然として明確な差をつけられています。
本記事の情報源は次の3種類のみです。2026年11月16日の公式発表資料、arena.ai「Code Arena WebDev」公開リーダーボードの最終スナップショット(2026年11月14日)、そしてQwenCloudとQwen AIプラットフォームに掲載されている2つの価格です。未公開のパラメータ詳細や第三者による再現結果は本記事の範囲外です。もしQwen3.8-Maxや他のフラッグシップモデルを現在運用しているなら、読み終えた後に3種類のタスクごとに乗り換えの要否を判断し、入力価格・出力価格・キャッシュ価格を使ってご自身でコストを試算してみてください。
Qwen4-Max リリース情報の概要
| 情報項目 | 詳細 |
|---|---|
| リリース日時 | 2026-11-16 10:01(UTC+8) |
| 発表元 | アリババ Qwen(通義千問)チーム |
| パラメータ規模 | 2.4T のバックボーンパラメータ。token ごとに 71B をアクティブ化し、別途 328B の N-gram Embedding パラメータを持つ |
| コンテキスト | 1M、ネイティブ視覚 |
| 公式チャネル | QwenCloud API、Qwen Studio、QwenWork、Qoder、Qwen App |
| オープンソース計画 | 公式はより小さいサイズの Qwen4 について重みをオープンソース化すると表明。Max 自体についてはオープンソース化に言及なし |
リリースの流れから見ると、今回のアップデートは単なる1つの API モデルの更新にとどまりません。Qwen4-Max は QwenWork(オフィス)と Qoder(プログラミング)という2つの自社製品にも同時に投入されています。公式資料でも、エージェントの長時間タスクと業界向けデリバリーに重点が置かれ、純粋な Q&A 能力を主な売り文句にはしていません。
Qwen4-Max アーキテクチャの3つの変更点
公式ブログでは3つの構造変更が挙げられており、以下でそれぞれがどんな問題を解決するのかを説明します。
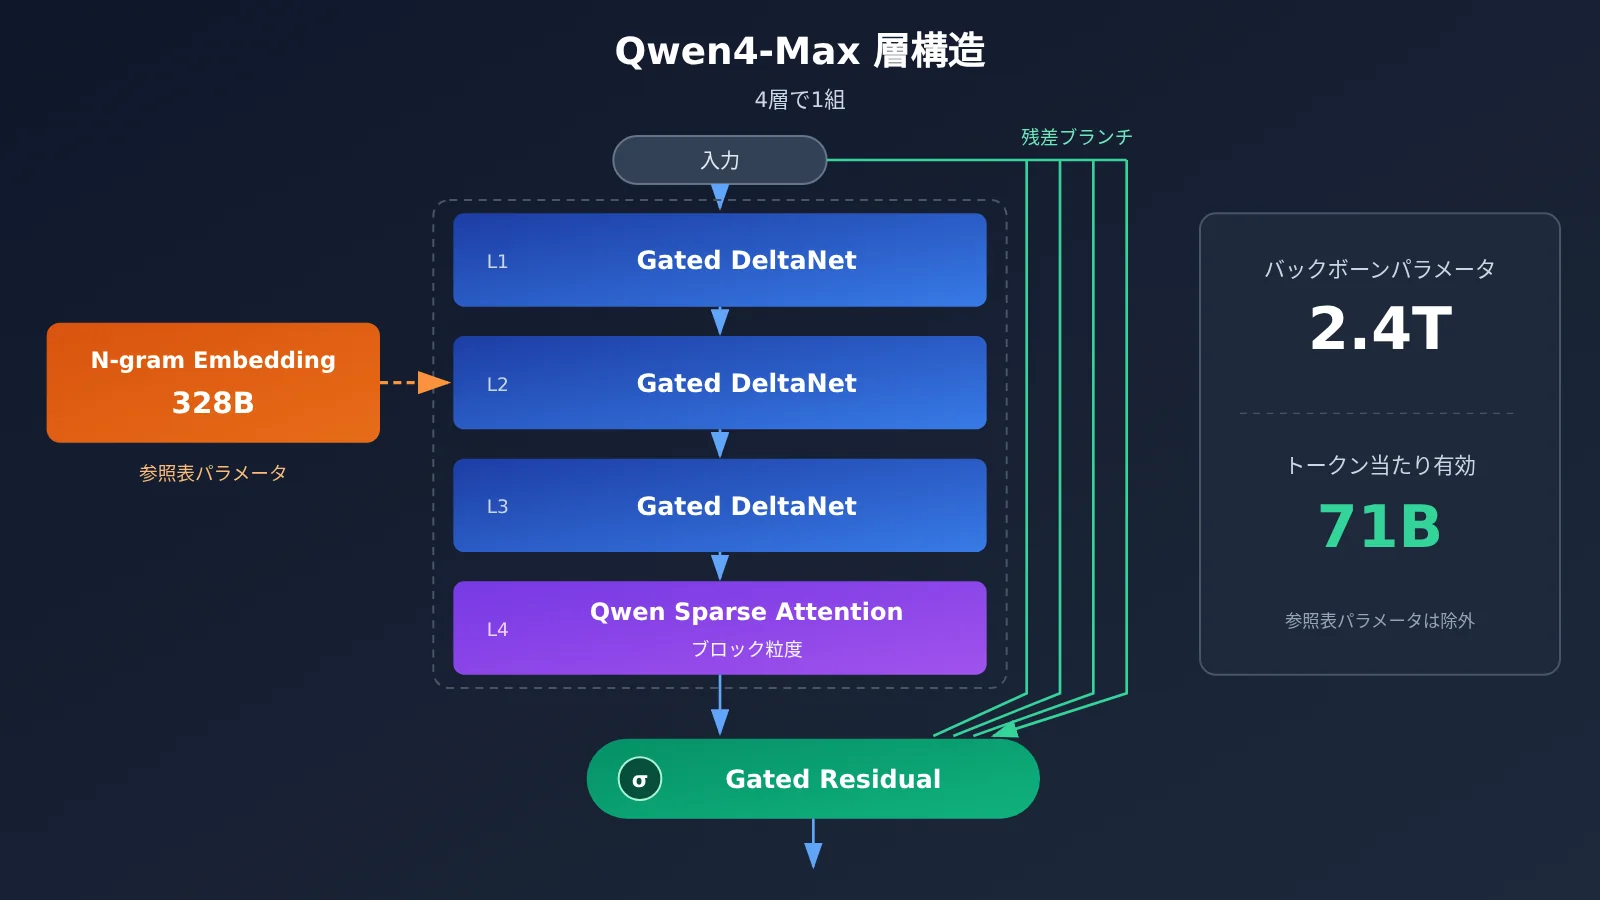
- GDN + QSA ハイブリッドアテンション:4層ごとに3層が Gated DeltaNet を使用し、残りの1層が Qwen Sparse Attention を使用して、block 単位でコンテキストを選択します。この構成の主な目的は、1M の長いコンテキストにおける計算コストを下げることです。
- Gated Residual:残差パスを4本の並列分岐に分割し、ゲート制御を介して統合することで、深層ネットワークの表現力を高めます。
- N-gram Embedding:2層目でルックアップ(テーブル参照)を行い、局所的な token パターンを補完します。328B の追加パラメータはここに由来し、これらはルックアップ用のパラメータで、token ごとのアクティブ化計算には含まれません。
注意が必要なのは、2.4T がバックボーンパラメータの総量であり、token ごとに実際にアクティブ化されるのは 71B だという点です。他のモデルと「パラメータサイズ」を比較する際は、双方が同じ基準で語っているかをまず確認してください。
Qwen4-Max の仕様とプロトコル
| 仕様項目 | Qwen4-Max |
|---|---|
| コンテキストウィンドウ | 1M |
| 最大入力 | 991K(思考モードでは 983K) |
| 最大出力 | 393K |
| 最大思考チェーン | 262K |
| TPM | 500万 |
| 互換プロトコル | OpenAI Chat Completions、Responses、Anthropic Messages、DashScope |
デフォルト reasoning_effort |
high(Qwen3.8-Max のデフォルトは xhigh) |
最後の行は見落とされやすい点です。Qwen4-Max のデフォルト推論レベルは high で、前世代のデフォルト xhigh より1段低くなっています。デフォルトパラメータのまま新旧世代を比較すると、確認される token 削減の一部はモデル自体ではなく、このレベル差に由来する可能性があります。A/B テストを行う場合は、reasoning_effort を明示的に同じ値に設定することをおすすめします。
Qwen4-Max の公式ベンチマーク16項目:優位な点と劣る点
以下の表のスコアはすべて、公式に公開された同一の図に由来し、公式の自己申告によるものです。図中の競合モデルのスコアもアリババ自身が測定したものであり、Anthropic、OpenAI、Moonshot AI が公表した公式成績として扱うことはできません。なお、CodeArena と AgentArena は LM Arena から、AA-Briefcase と AutomationBench-AA は Artificial Analysis から、APEX-Agents は Mercor のランキングから引用しています。JobBench はアリババが更新後のデータセットと評価コードを使って独自にテストしたものです。
| ベンチマーク | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev(Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1(Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | 未表記 |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena(Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
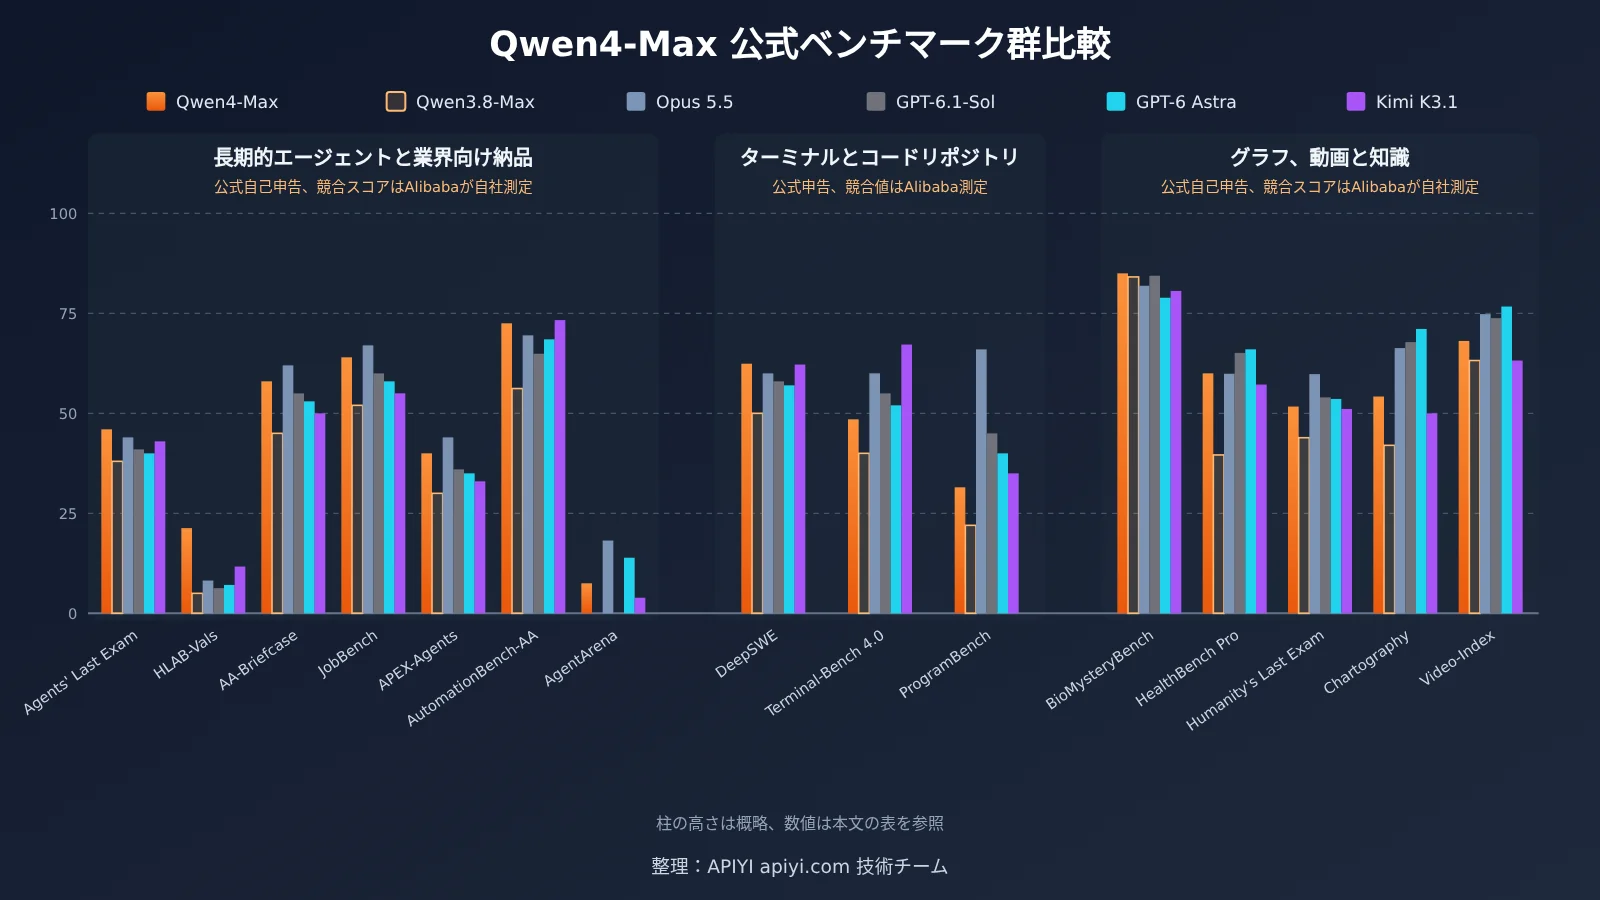
Qwen4-Max が首位の項目
Qwen4-Max が1位を獲得したのは4項目です。DeepSWE、Agents’ Last Exam、HLAB-Vals、BioMysteryBench がそれに当たります。このうち HLAB-Vals の差が最も大きく、21.3 点は2位の Kimi K3.1 の約2倍です。DeepSWE は Kimi よりわずか 0.2 点高いだけで、この差はほぼ互角と見なせます。
さらに4項目で2位につけています。AA-Briefcase、JobBench、APEX-Agents、AutomationBench-AA です。最初の3項目は1位が Opus 5.5、最後の1項目は1位が Kimi K3.1 です。これらのベンチマークはいずれも長期的なエージェント作業やホワイトカラー業務の成果物に寄ったもので、今回ベンダーがアピールしている方向性でもあります。
Qwen4-Max が後れを取っている項目
ターミナルとプログラム構築は、今回最も明白な弱点です。Terminal-Bench 4.0 の 48.5 点は6モデル中5位で、1位の Kimi より 18.7 点低い結果です。ProgramBench の 31.5 点は Opus 5.5 の半分にも届きません。エージェントが主にシェル上でビルド、デバッグ、デプロイを行う場合、この2項目は DeepSWE よりも参考価値が高いでしょう。
チャートと動画の理解も同様に後れています。Chartography と Video-Index はどちらも4位で、1位の GPT-6 Astra とはそれぞれ 16.9 点、8.6 点の差があります。Humanity’s Last Exam も4位です。つまり「ネイティブ視覚」とは、能力を備えているという意味であって、この分野でリードしていることを示すものではありません。
Code Arena 公開ランキングにおける Qwen4-Max の位置
arena.ai の Code Arena WebDev 公開ランキングの最終スナップショット(2026-11-14)は、1,007,405票、159モデルを集計したものです。Qwen4-Max(xHigh)は1750点で6位、「Preliminary」と表示され、票数はまだ1,814票のみです。ページに表示されるタスクあたりコストのP50は$4.18です。上位は順に、Claude Fable 5.2、Claude Opus 5.5、Claude Sonnet 5.5、Gemini 4 Carbon(Preliminary)、GPT-6 Astraとなります。
前世代のQwen3.8-Max(0902)は同じランキングで1676点、16位でした。そのため今回の世代では74点、10順位の向上となります。ただしQwen4-Maxの票数はまだ少ないため、今後の順位は変わる可能性があります。
Qwen4-Max のトークン効率と「コスト6割減」はどこから来るのか
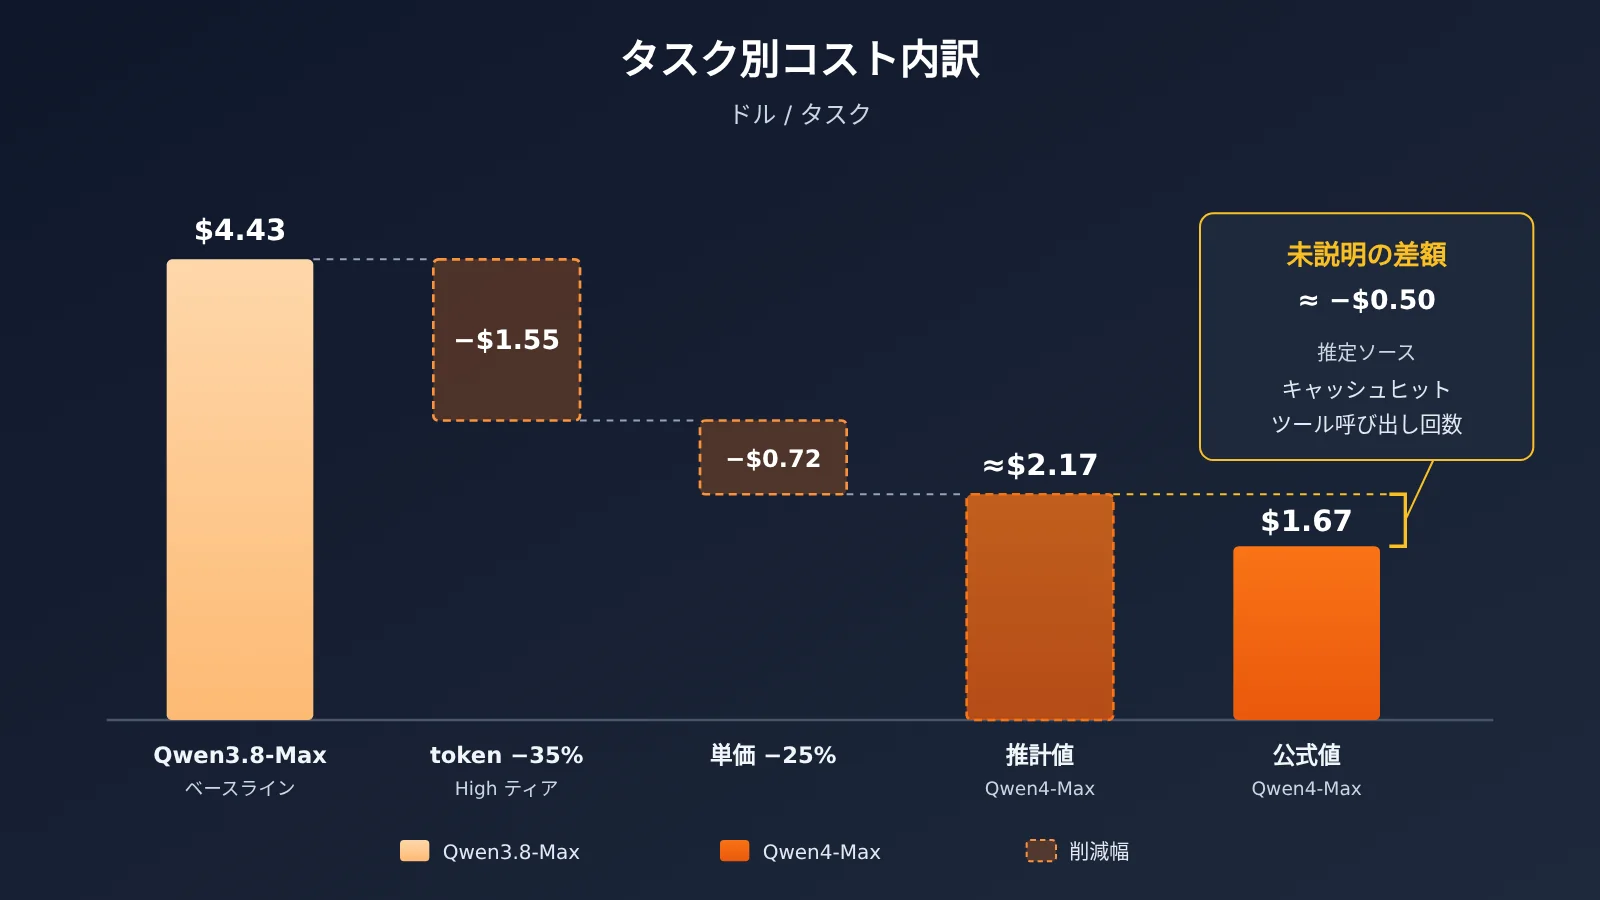
公式の効率数値は、同社が独自に構築したWork360シナリオベンチマークに基づいています。このベンチマークは26の第1階層領域、182の第2階層領域、721の第3階層領域で構成されています。Qwen4-Maxのスコアは52.69、Qwen3.8-Maxは47.74です。トークン消費量は、Work360のXhigh設定で約24%少なく、High設定で約35%少なくなっています。Terminal-Bench 4.0では、両設定でそれぞれ約48%、約49%少なくなります。
タスクあたりの平均コストについて、公式発表の数値は$4.43から$1.67への低下です。中国語ブログでの表記では¥26.58から¥11.16へ下がり、58%減となります。ドル建ての数値で計算した降幅は約62%です。ただし「トークン35%減 × 単価25%減」だけで推算すると、0.65 × 0.75 ≈ 0.49、つまり約51%減となります。この中間の差分について公式は説明していません。考えられる要因はキャッシュヒット率の向上やツール呼び出しターンの減少ですが、これはあくまで推測であり、確認済みの原因として扱うことはできません。
安全性の面では、Last Secure Code Benchの関数レベルにおける「機能と脆弱性の両方の通過率」が22.0%から31.8%に向上しました。関数、ファイル、リポジトリの3つの粒度すべてで安全なコードを生成する割合は、8%から14.7%に向上しています。絶対値は依然として高くなく、生成されたコードには引き続き人手によるレビューが必要です。
Qwen4-Max の料金計算方法
以下に、Qwen4-Max の公式価格、前世代モデルの公式価格、および APIYI の現行価格をまとめます。単位はすべて 米ドル / 1M tokens、データ取得日は 2026-11-16 です。
| 課金項目 | Qwen4-Max(QwenCloud 公式) | Qwen3.8-Max(公式) | qwen3.8-max(APIYI apiyi.com 現行価格) |
|---|---|---|---|
| 入力 | $1.5 | $2 | $1.65 |
| 出力 | $4.5 | $6 | $4.95 |
| キャッシュ読み取り / ヒット | $0.075 | $0.25 | $0.20625 |
| 5分間の明示的キャッシュ作成 | $1.875 | — | — |
| 1時間の明示的キャッシュ作成 | $3 | — | — |
人民元価格は Qwen AI プラットフォームの表示を基準とし、単位は 人民元 / 1M tokens、データ取得日は 2026-11-16 です:
- 入力 ¥10、出力 ¥30、キャッシュヒット ¥0.5
- 5分間の明示的キャッシュ作成 ¥12.5、1時間の明示的キャッシュ作成 ¥20
前世代の公式価格と比較すると、Qwen4-Max の入力価格と出力価格はそれぞれ 25% 低く、キャッシュ読み取り価格は 70% 低くなっています。キャッシュ読み取り価格の下げ幅が最も大きく、これは長時間稼働するエージェントに大きな影響を与えます。なぜなら、マルチターンのタスクでは、大量に繰り返されるシステムプロンプトや履歴コンテキストがキャッシュ価格で課金されるためです。
自分でコストを見積もる場合は、次の式で分解して計算できます:キャッシュ未命中の入力 × 入力価格 + キャッシュヒット × キャッシュ価格 + 明示的キャッシュ作成量 × 作成価格 + 出力(思考連鎖を含む)× 出力価格。仮の例を挙げると、あるタスクで 1M の入力があり、そのうち 60万がキャッシュヒットし、出力が 10万だとします。Qwen4-Max の公式価格で計算すると約 $0.6 + $0.045 + $0.45 ≈ $1.10 になります。同じトークン量で Qwen3.8-Max の公式価格を使って計算すると約 $1.55 です。実際の差には、トークン消費量の変化もさらに加わるため、最も確実な方法は自分の実際のログを使って再計算することです。
💰 コスト計算のヒント:APIYI では現在、qwen4-max はまだ提供していませんが、できるだけ早くこのモデルを提供する予定です。具体的なモデル名と価格は、apiyi.com プラットフォームのモデル一覧を基準にしてください。提供開始までは、プラットフォーム上の
qwen3.8-maxを使ってコストのベースラインを確立し、新型号が公開されたら2つの請求明細を直接比較するとよいでしょう。
シナリオ別に Qwen4-Max への切り替えを判断する方法
| シナリオ | Qwen4-Max の性能(公式発表) | 推奨 |
|---|---|---|
| 長時間実行のエージェント作業と業界向け納品(オフィス自動化、リサーチ、納品ドキュメント) | HLAB-Vals、Agents’ Last Exam で1位。APEX、JobBench、AA-Briefcase で2位。token 消費も明らかに少ない | 優先的に評価すべき。Qwen3.8-Max からのアップグレード効果が最も分かりやすい |
| ターミナルとコードリポジトリ(shell エージェント、ビルド、複数リポジトリ横断の修正) | DeepSWE は1位だがリードはわずか。Terminal-Bench は5位、ProgramBench は4位 | ターミナル操作が中心のタスクは、まず Kimi K3.1 や Opus 5.5 と比較してから判断する |
| フロントエンド WebDev | Code Arena 公開ランキング6位、1750点(Preliminary) | コストパフォーマンス重視の選択肢にはなるが、首位ではない |
| グラフ・動画理解、マルチモーダル長文ドキュメント | Chartography、Video-Index はいずれも4位 | 画像や動画を多く読むワークフローでは、当面これだけに頼るのはおすすめしない |
| 生物・医療分野のQ&A | BioMysteryBench 1位、HealthBench Professional 3位 | テストに組み入れてよいが、ドメイン専門家によるレビューが必要 |
より確実な方法はタスクを振り分けることです。長時間実行のエージェント作業やドキュメント納品といったタスクは Qwen4-Max に任せ、ターミナル中心の重いタスクやグラフ・動画系のタスクは、現時点でそれらに強いモデルに引き続き任せます。こうすれば、すべてのトラフィックを一度に移行する必要はなく、token 節約によるメリットを先に得られます。
🎯 モデル選定のヒント:この振り分けが成り立つ前提は、同じコードでモデルを切り替えられることです。APIYI apiyi.com は OpenAI 互換インターフェースを提供しており、1つの APIキーで複数のフラッグシップモデルを呼び出せます。
modelフィールドを差し替えるだけで A/B テストができます。
Qwen4-Max クイックスタート
公式チャネルは QwenCloud API で、OpenAI Chat Completions、Responses、Anthropic Messages、DashScope の4種類のプロトコルをサポートしており、既存の OpenAI SDK や Anthropic SDK からそのまま接続できます。接続時は以下の点に注意してください。
- モデルを確認:公式モデル ID は
qwen4-maxと表記されます。モデルページを基準にしてください。デフォルトのreasoning_effortはhighです。比較テストでは同じレベルを明示的に指定してください。たとえばxhighです。 - 出力領域を確保:最大出力 393K、最大思考連鎖 262K。長いタスクでは
max_tokensまたは対応するパラメータを十分大きく設定してください。そうしないと、思考連鎖が出力枠を埋めてしまいます。 - キャッシュを有効化:暗黙的キャッシュのヒット時料金は $0.075 です。システムプロンプトが長く、繰り返し使われる場合は、5分または1時間の明示的キャッシュを使う価値があるか評価してください。キャッシュの作成には別途料金が必要で、再利用回数が少なすぎる場合はかえって割高になります。
- 比較対象を準備:APIYI に登録して APIキーを取得し、
base_urlをhttps://api.apiyi.com/v1に、modelをqwen3.8-maxに設定して、同じタスク群で旧モデルの token 消費量とスコアをベースラインとして測定します。 - 新型モデルの提供開始後に切り替え:qwen4-max が APIYI に掲載された後は、
modelフィールドを変更するだけで、その他のコードはそのままに、新旧2世代の比較データを直接取得できます。
🚀 クイックスタート:新規ユーザーは APIYI apiyi.com で登録すると無料テスト枠を獲得でき、まず
qwen3.8-maxのベースラインを測定するのに十分です。その後モデルを切り替える際に再接続は不要です。
Qwen4-Max よくある質問(FAQ)
Q1:Qwen4-Max とは何ですか?
Qwen4-Max は、Qwen(通義千問)が 2026-11-16 に発表したフラッグシップモデルです。2.4T のバックボーンパラメータを持ち、トークンあたり 71B を活性化します。ネイティブで視覚入力をサポートし、コンテキスト長は 1M です。主に長期的なエージェントタスクや業界向けのデリバリー業務を想定しています。
Q2:Qwen4-Max と Qwen3.8-Max の違いはどこにありますか?
公式が自己申告した 16 項目のベンチマークでは、Qwen4-Max はすべての項目で Qwen3.8-Max-0902 を上回っています。Code Arena の公開リーダーボードでは 74 ポイント高いスコアです。公式価格では、入力と出力がそれぞれ 25% 低く、キャッシュ読み取りは 70% 低くなっています。また、両者のデフォルトの推論レベルは異なり、それぞれ `high` と `xhigh` です。
Q3:16 項目のスコアは信頼できますか?
これらのスコアはすべて公式の自己申告であり、競合モデルのスコアもアリババ自身が測定したものです。現時点で第三者による再現はありません。参考にできる外部シグナルは Code Arena WebDev の公開リーダーボードです。2026-11-14 の最終スナップショットでは Qwen4-Max が 6 位に入っていますが、まだ Preliminary ステータスで、票数も少なくなっています。
Q4:「コスト6割削減」はそのまま自社の業務に当てはめられますか?
そのまま当てはめることはできません。この数字は公式の Work360 シナリオに基づくもので、トークン数と単価から単純に試算した結果よりも削減幅が大きくなっています。その差分について公式は説明していません。実際の削減率はキャッシュヒット率、ツール呼び出しのラウンド数、推論レベルによって変わるため、自社のタスクログを使って試算する必要があります。
Q5:APIYI 経由で Qwen4-Max を呼び出せますか?
2026-11-16 11:00 時点では、APIYI のモデル一覧にまだ qwen4-max はありません。できるだけ早く追加する予定です。現在販売中の Qwen フラッグシップは `qwen3.8-max` で、価格は入力 $1.65、出力 $4.95、キャッシュ読み取り $0.20625(単位:1M トークン)です。追加の進捗と価格は apiyi.com のモデル一覧を基準にしてください。
Q6:Qwen4-Max にはどのような弱点がありますか?
ターミナル操作(Terminal-Bench で 5 位)、プログラム構築(ProgramBench で 4 位)、グラフと動画の理解(いずれも 4 位)、そして HLE(4 位)は、同じ図の中のトップ競合他社に後れを取っています。セーフコードのダブルパス率は向上しているものの、31.8% にとどまっています。また、Max サイズについては現時点でオープンウェイトを公開する予定はありません。
まとめ:Qwen4-Max は乗り換える価値があるのか
- ポジショニング:2.4T のバックボーンに、トークンあたり 71B をアクティブ化、100 万トークンのコンテキストウィンドウを備えたフラッグシップモデル。長時間稼働するエージェントと業界向けデリバリーを主な狙いとしています。
- 強かった項目:公式が自己申告した 16 項目のベンチマークで 4 項目の 1 位、4 項目の 2 位を獲得。主にエージェント系とホワイトカラー業務の成果物系ベンチマークで上位に立っています。
- 弱かった項目:ターミナル操作、プログラム構築、チャート、動画、そして HLE はいずれも 4 位または 5 位。1 つのモデルですべてのタスクをカバーすることはできません。
- 公開リーダーボードでの位置:Code Arena WebDev の最終版スナップショット(2026-11-14)で 6 位、1750 点。ステータスは依然として Preliminary です。
- コスト:公式の単価は 25% 低下、キャッシュ読み取りは 70% 低下し、トークン消費も明確に減っています。「6 割削減」については自社データで検証する必要があります。
主要なワークロードが長時間稼働するエージェントとドキュメント納品であれば、Qwen4-Max は優先的に評価する価値があります。一方、ターミナル操作が中心のタスクやチャート・動画の理解であれば、現時点でより強いモデルへ引き続き振り分けることをおすすめします。qwen4-max の提供開始前には、APIYI apiyi.com の OpenAI 互換インターフェース経由で qwen3.8-max を使い、コストと効果のベースラインを確立しておきましょう。新型号がリリースされたら、フィールドを 1 つ変更するだけで比較を完了できます。
📚 参考資料
- Qwen 公式 X 投稿:Qwen4-Max リリース告知
- リンク:
x.com/Alibaba_Qwen/status/2122148127520289151 -
説明:公開日時と公式の提供チャネル
-
Qwen 公式ブログ(中国語):アーキテクチャ、仕様、16項目のベンチマークスコアと効率の数値
- リンク:
qwen.ai/blog?id=qwen4-max -
説明:本記事のアーキテクチャ、仕様、ベンチマークデータはすべてこの記事に基づいています
-
QwenCloud モデルページ:米ドル建ての表示価格
- リンク:
qwencloud.com/models/qwen4-max -
説明:米ドル / 1M tokens あたりの入力・出力・キャッシュ価格
-
千问AI平台 モデルページ:人民元建ての表示価格
- リンク:
qianwenai.com/models/qwen4-max -
説明:人民元 / 1M tokens あたりの価格
-
arena.ai Code Arena WebDev:公開リーダーボード
- リンク:
arena.ai - 説明:本記事で引用しているのは 2026-11-14 時点の最終リーダーボードのスナップショットです
著者:APIYI 技術チーム
技術的なお問い合わせ:モデルの掲載状況や接続方法について詳しく知りたい方は、APIYI のウェブサイトトップページからお問い合わせください。ドキュメントは docs.apiyi.com をご覧ください。