Pada 28 September, Anthropic merilis claude-sonnet-5-5, lalu sehari setelahnya OpenAI meluncurkan gpt-6.1-sol di DevDay. Model utama generasi terbaru dari kedua perusahaan ini hadir hampir bersamaan, dengan harga yang persis sama: input $2 dan output $10 (per satu juta Token). Reaksi awal banyak developer adalah, “keduanya lebih murah, pilih saja salah satu.” Namun, saat benar-benar digunakan di produksi, perbedaan biaya per tugas, penagihan konteks panjang, dan performa agen jauh lebih besar daripada yang terlihat di tabel harga. Artikel ini akan mengurai perbedaan nyata antara gpt-6.1-sol dan claude-sonnet-5-5 dari 5 dimensi, agar Anda bisa memilih secara rasional berdasarkan skenario penggunaan, tanpa dipengaruhi preferensi merek atau akses akun.
Nilai utama: Setelah membaca artikel ini, Anda akan memahami model mana yang perlu dipilih dan bagaimana memadukannya untuk agen pemrograman, dokumen kerja, pencarian konteks panjang, serta pemrosesan batch berkonkurensi tinggi.
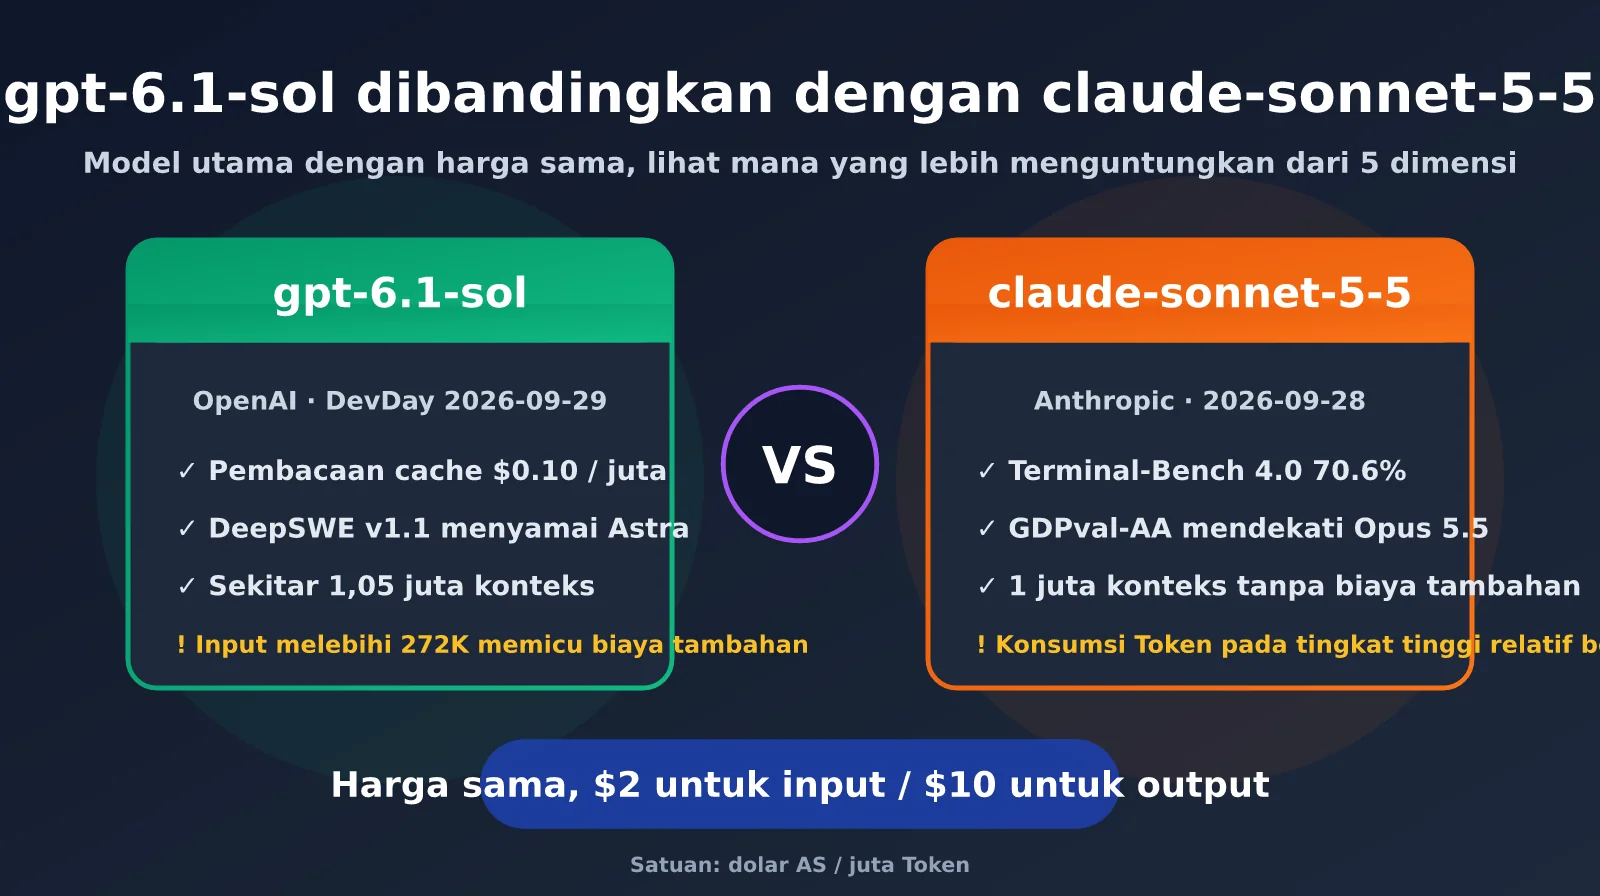
Ringkasan parameter utama gpt-6.1-sol dan claude-sonnet-5-5
Mari luruskan dulu salah satu kesalahpahaman yang umum: secara ketat, harga resmi kedua model ini tidak turun. claude-sonnet-5-5 melanjutkan harga $2/$10 dari Sonnet 5, sementara gpt-6.1-sol juga memiliki harga resmi yang sama dengan generasi sebelumnya, gpt-6-sol. Klaim “lebih murah” sebenarnya terlihat dalam dua aspek. Pertama, kemampuan kelas flagship kini tersedia pada harga model utama: gpt-6.1-sol hanya seperlima harga gpt-6-astra, sedangkan claude-sonnet-5-5 hanya setengah harga Opus 5.5. Kedua, biaya tersembunyi menurun: biaya input cache gpt-6.1-sol dipangkas setengah dari $0,20 menjadi $0,10, sedangkan claude-sonnet-5-5 dapat menurunkan biaya per tugas hingga sekitar 30% dengan mengurangi jumlah pemanggilan tool.
| Parameter | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| Tanggal rilis | 2026-09-29 (DevDay) | 2026-09-28 |
| ID model | gpt-6.1-sol |
claude-sonnet-5-5 |
| Jendela konteks | Sekitar 1,05 juta Token | 1 juta Token |
| Output maksimum | 128K | 128K (bisa mencapai 300K pada Batch versi uji coba) |
| Tingkat penalaran | low / medium (default) / high / xhigh / max | low / medium / high (default API) / xhigh / max |
| Mode berpikir | Dapat disesuaikan berdasarkan tingkat | Penalaran adaptif, tidak dapat dinonaktifkan |
| Flagship satu keluarga | gpt-6-astra ($10/$50) | Claude Opus 5.5 ($4/$20) |
| Platform yang tersedia | APIYI apiyi.com, API resmi OpenAI | APIYI apiyi.com, API resmi Anthropic |
Dari tabel parameter, terlihat satu perbedaan penting: tingkat penalaran default keduanya tidak sama. gpt-6.1-sol secara default menggunakan medium, sedangkan API claude-sonnet-5-5 menggunakan high secara default. Jika Anda membandingkannya langsung dengan parameter bawaan, Sonnet pada dasarnya diberi satu tingkat “berpikir” tambahan. Wajar bila konsumsi Token dan latensinya tidak berada pada titik awal yang sama. Untuk perbandingan yang adil, sebaiknya tentukan reasoning_effort secara eksplisit pada kedua model.
🎯 Saran pengujian: Saat membandingkan kedua model, pastikan tingkat penalaran dan petunjuk yang digunakan sama. Kami menyarankan Anda memakai satu kunci API yang sama melalui APIYI apiyi.com untuk memanggil gpt-6.1-sol dan claude-sonnet-5-5, lalu cukup ubah parameter
modeluntuk menjalankan pengujian A/B. Dengan begitu, variabel pengganggu dari perbedaan akun atau jaringan dapat dihindari.
5 Perbedaan Inti gpt-6.1-sol vs claude-sonnet-5-5
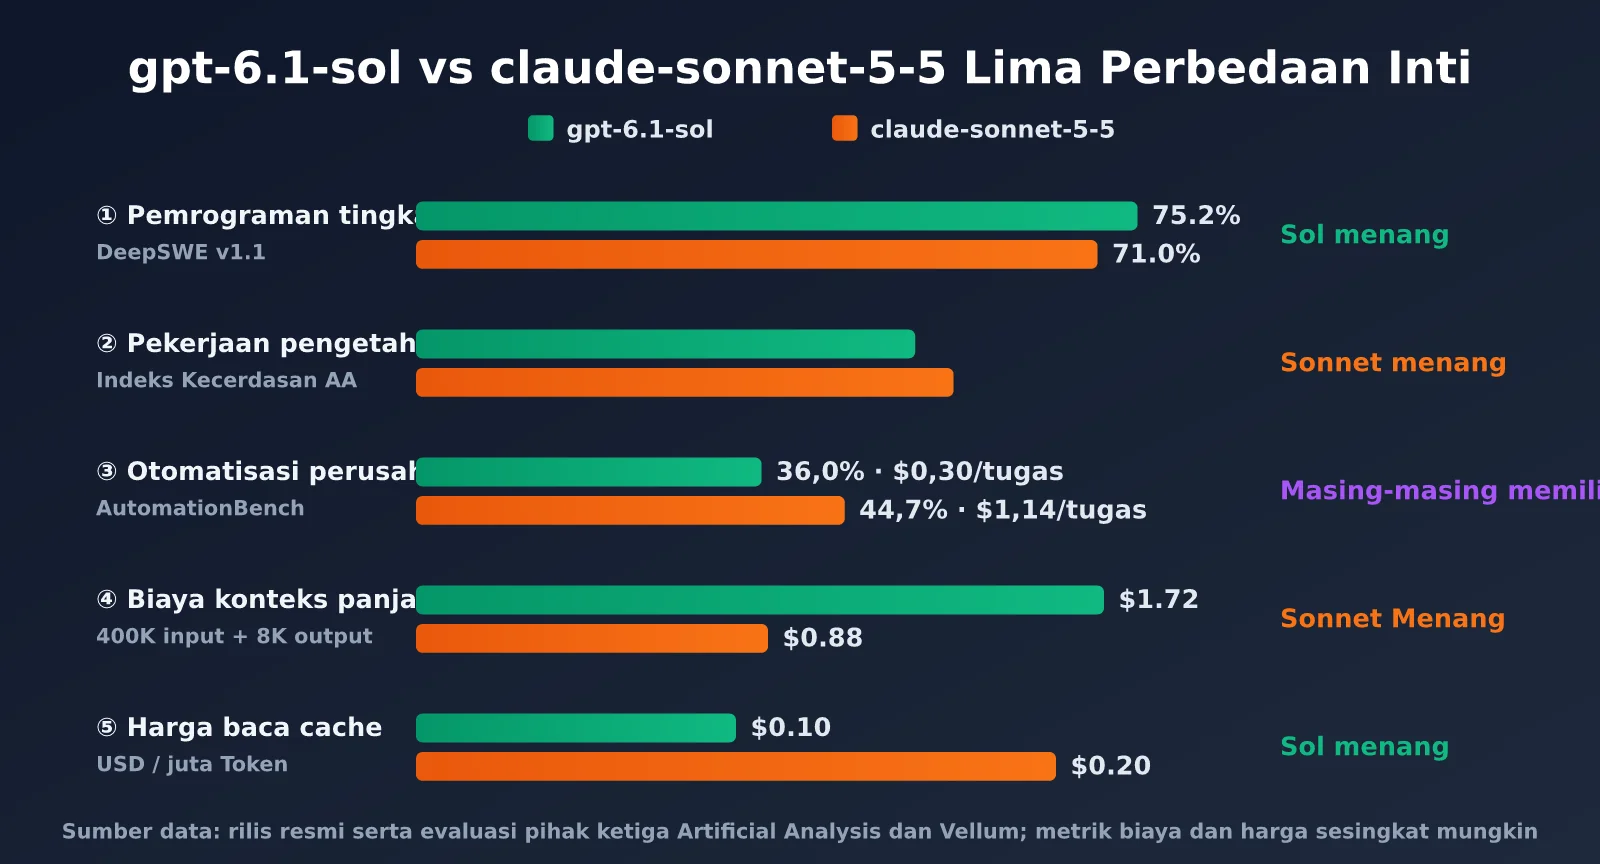
Perbedaan 1: Agen pemrograman, claude-sonnet-5-5 unggul dalam tugas berbasis terminal
Pemrograman adalah area persaingan paling ketat antara kedua model ini. Namun, benchmark yang dipublikasikan masing-masing pihak tidak sepenuhnya sama, jadi perlu dilihat secara terpisah. Pada Terminal-Bench 4.0, skor resmi claude-sonnet-5-5 adalah 70,6%, melonjak jauh dari 10,3% milik Sonnet 5, bahkan melampaui Opus 5.5 yang memperoleh 66,4%. Pengujian ulang independen dari Artificial Analysis menghasilkan 64%, juga lebih tinggi daripada Opus 5.5 dan gpt-6-astra yang sama-sama berada di 60%. Model ini meraih 81,3% pada SWE-Bench Pro dan 55,5% pada CursorBench 4.0, hanya kalah dari Opus 5.5.
Di sisi gpt-6.1-sol, OpenAI menonjolkan hasil DeepSWE v1.1: gpt-6.1-sol mencetak 75,2%, sedikit lebih tinggi dibandingkan 74,8% milik gpt-6-astra, dengan biaya per tugas hanya sekitar $1,50—kurang dari seperlima biaya Astra. Dalam rangkuman pihak ketiga, claude-sonnet-5-5 memperoleh 71,0% pada benchmark yang sama. Artinya, untuk pemrograman agen yang digerakkan terminal, bukti keunggulan claude-sonnet-5-5 lebih kuat; sedangkan untuk tugas rekayasa perangkat lunak tingkat repositori, gpt-6.1-sol menawarkan rasio biaya-kinerja yang lebih menonjol.
Perbedaan 2: Pekerjaan berbasis pengetahuan, claude-sonnet-5-5 mendekati Opus
Untuk pekerjaan berbasis pengetahuan di lingkungan kantor, performa claude-sonnet-5-5 sangat menonjol. Skornya di GDPval-AA v2.1 mencapai 1844, nyaris imbang dengan Opus 5.5 yang mendapat 1846. Pada AA-Briefcase, model ini meraih 1811, juga sangat dekat dengan Opus.
Dalam Indeks Kecerdasan Artificial Analysis, claude-sonnet-5-5 berada di posisi kedua dengan 56 poin, hanya terpaut 2 poin dari Opus 5.5. Sementara itu, gpt-6.1-sol (max) memperoleh 52 poin.
gpt-6.1-sol punya keunggulannya sendiri dalam analisis dokumen. Pada benchmark GDP.pdf, model ini mencapai 32,0%, hampir menyamai 32,2% dari gpt-6-astra dan melampaui 28,8% milik Opus 5.5, dengan biaya sekitar $0,38 per tugas. Pada AutomationBench untuk otomatisasi alur kerja perusahaan, claude-sonnet-5-5 unggul dengan 44,7% dibandingkan 36,0% milik gpt-6.1-sol. Namun, biaya per tugas model pertama sekitar $1,14, sedangkan yang kedua hanya $0,30.
Perbedaan 3: Pengoperasian komputer, keduanya sudah masuk rentang praktis
Untuk pengoperasian komputer (Computer Use), gpt-6.1-sol meraih 71,4% di OSWorld 2.0, hanya terpaut 2,1 poin dari 73,5% milik gpt-6-astra, dengan biaya sekitar $1,30 per tugas. claude-sonnet-5-5 memperoleh 80,1% di OSWorld 2.1, mendekati 81,8% milik Opus 5.5.
Perlu diperhatikan bahwa set pengujian OSWorld pada kedua versi ini berbeda, sehingga skornya tidak bisa dibandingkan secara langsung. Meski begitu, keduanya sudah terbukti mampu mengoperasikan aplikasi desktop secara stabil.
Perbedaan 4: Tarif jendela konteks panjang, gpt-6.1-sol memiliki ambang tersembunyi
Ini adalah perbedaan yang paling mudah terlewat, sekaligus paling berpengaruh pada tagihan. Walaupun gpt-6.1-sol mendukung jendela konteks sekitar 1,05 juta Token, begitu input dalam satu permintaan melebihi 272K Token, seluruh input dan cache pada permintaan tersebut dikenai tarif 2 kali lipat, sementara output dikenai tarif 1,5 kali lipat.
Sementara itu, jendela konteks 1 juta Token milik claude-sonnet-5-5 tidak memiliki biaya tambahan untuk konteks panjang; seluruh penggunaan tetap dihitung dengan harga standar. Jika bisnis Anda sering memasukkan satu buku panduan penuh atau seluruh repositori kode ke dalam konteks, perbedaan ini saja sudah cukup untuk mengubah keputusan pemilihan model.
Perbedaan 5: Efisiensi Token dan cache, gpt-6.1-sol lebih hemat
Harga pembacaan cache gpt-6.1-sol adalah $0,10, setengah dari claude-sonnet-5-5 yang mengenakan $0,20. Ini menjadi keunggulan jelas dalam skenario seperti loop agen, ketika prefiks berulang dalam jumlah besar.
Di sisi lain, konsumsi Token claude-sonnet-5-5 pada tingkat penalaran tinggi cenderung besar. Artificial Analysis mengukur bahwa mode max menghasilkan sekitar 193 ribu Token per tugas, tertinggi di antara model yang telah diuji sejauh ini. Pengujian independen juga menemukan bahwa mode high bawaan API mengonsumsi hampir dua kali lebih banyak Token output dibandingkan mode medium, tetapi peningkatan kualitasnya tidak terlihat signifikan.
| Benchmark / metrik | gpt-6.1-sol | claude-sonnet-5-5 | Unggul |
|---|---|---|---|
| Terminal-Bench 4.0 (resmi) | Belum dipublikasikan | 70,6% | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75,2% | 71,0% | gpt-6.1-sol |
| GDPval-AA v2.1 | Belum dipublikasikan (gpt-6-sol generasi sebelumnya: 1487) | 1844 | claude-sonnet-5-5 |
| Analisis dokumen GDP.pdf | 32,0% | Belum dipublikasikan | gpt-6.1-sol |
| AutomationBench | 36,0% (sekitar $0,30/tugas) | 44,7% (sekitar $1,14/tugas) | Kualitas: Sonnet, biaya: Sol |
| Indeks Kecerdasan AA | 52 | 56 | claude-sonnet-5-5 |
| Harga pembacaan cache | $0,10 / juta | $0,20 / juta | gpt-6.1-sol |
💡 Catatan data: Benchmark di atas berasal dari publikasi resmi OpenAI dan Anthropic, serta evaluasi pihak ketiga seperti Artificial Analysis dan Vellum. Versi pengujian dan tingkat penalaran yang digunakan tiap lembaga berbeda. Kami menyarankan Anda menjalankan pengujian perbandingan menggunakan sampel bisnis nyata sendiri, karena hasilnya jauh lebih relevan daripada peringkat apa pun.
Perbandingan biaya nyata gpt-6.1-sol dan claude-sonnet-5-5
Harga daftar yang sama tidak berarti tagihannya sama. Berikut estimasi biaya per permintaan untuk tiga beban kerja umum (tidak termasuk penulisan cache, dihitung berdasarkan harga resmi), agar terlihat jelas dari mana perbedaannya berasal.
| Skenario beban kerja | Komposisi permintaan | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| Loop agen (cache tinggi) | Input 100K (cache hit 90%) + output 5K | sekitar $0.079 | sekitar $0.088 |
| Percakapan umum | Input 5K + output 1K | sekitar $0.020 | sekitar $0.020 |
| Pencarian konteks sangat panjang | Input 400K (tanpa cache) + output 8K | sekitar $1.72 (terkena tarif premium) | sekitar $0.88 |
| Pemrosesan batch (Batch) | Diskon 50% dari harga daftar | $1 / $5 | $1 / $5 |
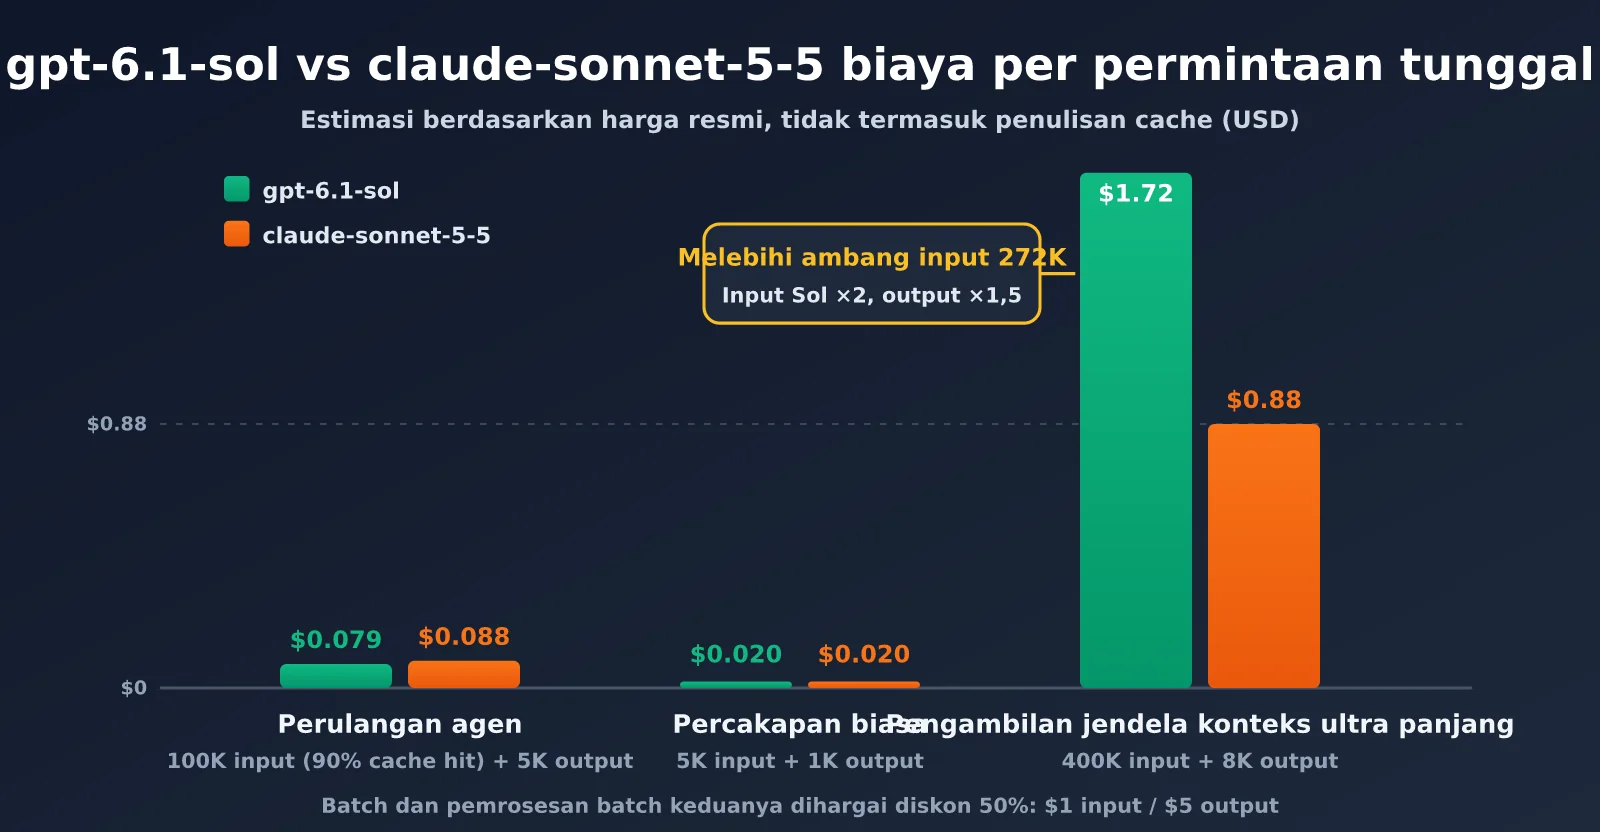
Kesimpulannya cukup jelas: pada loop agen dengan pengulangan prefiks tinggi, gpt-6.1-sol unggul sekitar 10% berkat biaya pembacaan cache yang lebih murah; untuk percakapan umum, keduanya nyaris sama; begitu input per permintaan melebihi 272K, biaya claude-sonnet-5-5 hanya sekitar separuh dari gpt-6.1-sol. Selain itu, faktor efisiensi Token juga perlu diperhitungkan. Jika claude-sonnet-5-5 berjalan pada tingkat high atau max, Token output aktual dapat berlipat ganda dan menghapus keunggulannya untuk konteks panjang. Karena itu, mengontrol tingkat penalaran adalah kunci untuk menggunakan Sonnet secara efektif.
Bandingkan dua model dengan cepat menggunakan kode yang sama
Melalui antarmuka yang kompatibel dengan OpenAI, Anda hanya perlu mengganti parameter model untuk menguji kedua model secara berdampingan. Berikut contoh paling sederhana:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI, kedua model memakai satu Key yang sama
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # Tetapkan tingkat yang sama agar perbandingan adil
        messages=[{"role": "user", "content": "Tambahkan unit test untuk fungsi ini:def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
Buka untuk melihat: skrip perbandingan lengkap dengan statistik waktu dan biaya
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka terpadu APIYI
)

# Harga per satu juta Token: input, pembacaan cache, output
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "Implementasikan cache LRU dengan waktu kedaluwarsa menggunakan Python, lalu tulis pengujiannya",
    "Baca kebutuhan berikut, lalu keluarkan desain struktur tabel database dan rekomendasi indeks: pesanan, pengguna, kupon",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 Mulai cepat: Jika Anda belum memiliki akun Anthropic, atau terkendala pembayaran internasional maupun verifikasi nomor ponsel, Anda bisa langsung mendaftar di APIYI apiyi.com untuk memperoleh kredit uji coba. Satu Key dapat memanggil gpt-6.1-sol dan claude-sonnet-5-5, tanpa perlu membuka akun resmi dari dua penyedia secara terpisah.
Rekomendasi skenario untuk gpt-6.1-sol dan claude-sonnet-5-5
Setiap bisnis memiliki prioritas berbeda untuk kualitas, biaya, dan latensi. Berikut rekomendasi berdasarkan skenario umum.
| Skenario bisnis | Model yang direkomendasikan | Alasan utama |
|---|---|---|
| Agen pemrograman berbasis terminal (seperti Claude Code) | claude-sonnet-5-5 | Unggul di Terminal-Bench 4.0, membutuhkan lebih sedikit pemanggilan alat |
| Perbaikan kode skala repositori, alur kerja Codex | gpt-6.1-sol | Menyamai Astra di DeepSWE, biaya per tugas sekitar $1.50 |
| Analisis dokumen sangat panjang / seluruh kode repositori (>272K) | claude-sonnet-5-5 | Tanpa tarif premium untuk konteks panjang, biaya sekitar setengah dari Sol |
| Layanan pelanggan berkonkurensi tinggi, tanya jawab RAG (cache tinggi) | gpt-6.1-sol | Pembacaan cache $0.10, makin banyak penggunaan ulang prefiks makin hemat |
| Penulisan laporan, tabel, dan pekerjaan pengetahuan perkantoran | claude-sonnet-5-5 | Hampir menyamai Opus 5.5 di GDPval-AA |
| Parsing dokumen PDF, ekstraksi informasi | gpt-6.1-sol | Menyamai Astra di GDP.pdf, sekitar $0.38 per tugas |
| Riset keamanan, bantuan pengujian penetrasi | gpt-6.1-sol | Sonnet 5.5 memiliki perlindungan keamanan siber bawaan, sehingga tingkat penolakan meningkat |
Skenario umum untuk memilih gpt-6.1-sol
gpt-6.1-sol paling cocok untuk bisnis yang sensitif terhadap biaya, memiliki volume permintaan tinggi, dan tingkat pengulangan prefiks yang besar. Contohnya layanan pelanggan cerdas, tanya jawab basis pengetahuan, serta pembersihan data batch. Karena petunjuk sistem dan konteks pengambilan data sangat sering digunakan ulang, harga pembacaan cache sebesar $0.10 dapat terus memperbesar keunggulannya.
Tingkat halusinasinya juga meningkat secara signifikan. Pada tingkat penalaran rendah, tingkat kesalahan faktual turun dari 11.4% pada generasi sebelumnya menjadi 7.7%. Karena itu, model ini cocok digunakan pada tingkat low atau medium untuk menjalankan tugas ringan dalam jumlah besar. Selain itu, OpenAI akan meluncurkan tingkat Ultrafast untuk gpt-6.1-sol, dengan kecepatan pembuatan hingga sekitar 300 Token/detik dan harga 6 kali tingkat standar. Ini dapat menjadi pilihan untuk produk yang membutuhkan interaksi real-time.
Skenario umum untuk memilih claude-sonnet-5-5
claude-sonnet-5-5 lebih cocok untuk bisnis dengan tugas kompleks, konteks sangat panjang, dan kebutuhan tingkat keberhasilan tinggi dalam sekali jalan. Dalam tugas agen, model ini biasanya hanya membutuhkan sekitar 3 pemanggilan alat untuk menyelesaikan pekerjaan yang memerlukan 12–13 pemanggilan pada Sonnet 5. Kecepatan output-nya juga lebih dari 30% lebih cepat dibanding generasi sebelumnya. Untuk peninjauan dokumen hukum, migrasi basis kode, atau penulisan laporan panjang yang membutuhkan banyak materi dimasukkan sekaligus ke dalam konteks, jendela konteks 1 juta tanpa tarif premium sangat menguntungkan.
Perlu diingat, claude-sonnet-5-5 memiliki beberapa perubahan antarmuka yang tidak kompatibel dengan Sonnet 5: mode berpikir tidak dapat dinonaktifkan, dan tool_choice: "tool" untuk memaksa penggunaan alat telah dihapus. Jika kode lama Anda bergantung pada perilaku tersebut, pastikan melakukan pengujian regresi sebelum migrasi.
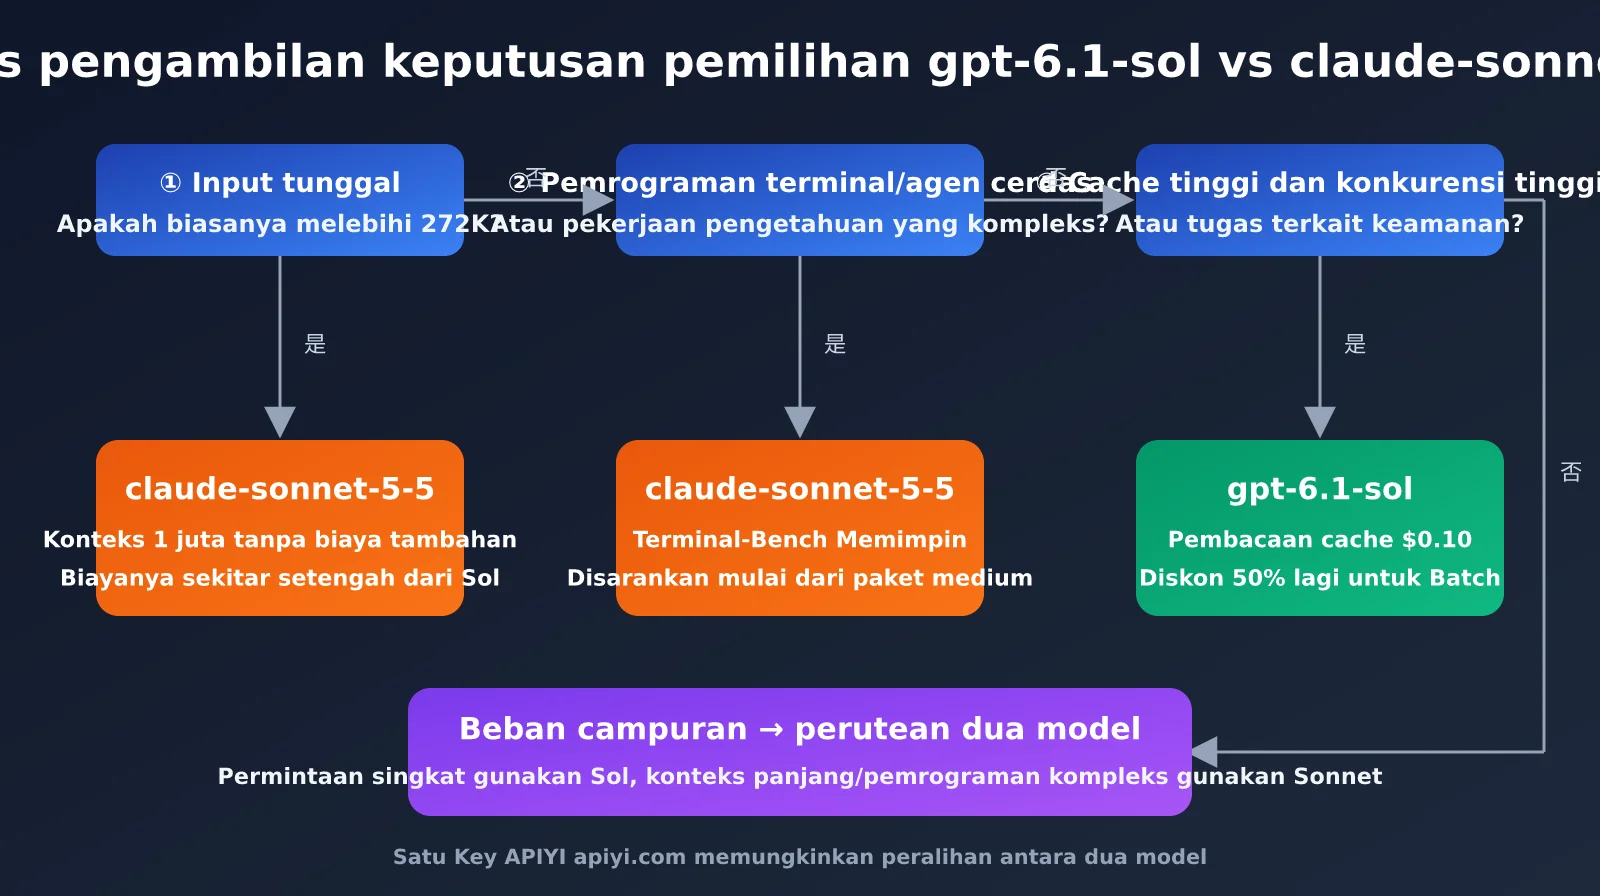
🎯 Saran arsitektur: Kedua model ini tidak harus dipilih salah satu saja. Kami menyarankan membangun perutean model sederhana melalui APIYI apiyi.com: arahkan permintaan singkat dan trafik dengan cache tinggi ke gpt-6.1-sol, sementara konteks sangat panjang serta tugas pemrograman kompleks ke claude-sonnet-5-5. Keduanya dapat diganti sesuai kebutuhan melalui antarmuka yang kompatibel dengan OpenAI.
Rekomendasi Keputusan: gpt-6.1-sol vs claude-sonnet-5-5
Ringkas analisis sebelumnya menjadi langkah pengambilan keputusan yang bisa langsung diterapkan:
- Cek panjang input terlebih dahulu: jika permintaan rutin melebihi 272K Token, prioritaskan claude-sonnet-5-5; jika tidak, lanjut ke langkah berikutnya.
- Lihat jenis tugas: pemrograman terminal/agen dan pekerjaan pengetahuan kompleks lebih cocok untuk claude-sonnet-5-5; perbaikan kode tingkat repositori dan parsing PDF lebih cocok untuk gpt-6.1-sol.
- Kemudian cek struktur trafik: untuk bisnis dengan rasio cache hit tinggi dan konkurensi besar, keunggulan biaya gpt-6.1-sol akan semakin terasa seiring skala bertambah.
- Terakhir, atur tingkat penalaran: apa pun model yang dipilih, mulai pengujian dari medium. Khusus claude-sonnet-5-5, hindari langsung memakai high bawaan API karena konsumsi Token bisa berlipat dua.
| Prioritas Anda | Pilihan utama | Strategi cadangan |
|---|---|---|
| Kualitas prioritas, anggaran mencukupi | claude-sonnet-5-5(medium/high) | Tingkatkan ke Opus 5.5 hanya untuk tugas sulit |
| Biaya prioritas, trafik sangat besar | gpt-6.1-sol(low/medium) | Gunakan Batch dengan diskon 50% untuk tugas nonreal-time |
| Kecepatan prioritas, interaksi real-time | gpt-6.1-sol(setelah Ultrafast tersedia) | claude-sonnet-5-5 tingkat low |
| Stabilitas prioritas, menghindari titik kegagalan tunggal | Routing dua model | Otomatis beralih ke model lain saat salah satu terkena rate limit |
Adapun preferensi merek dan kemudahan akses seharusnya bukan faktor penentu dalam pemilihan teknologi. Akun resmi Claude memang memiliki persyaratan lebih ketat terkait wilayah, metode pembayaran, dan lainnya, sehingga hambatan penggunaannya lebih tinggi. Namun, ini adalah masalah lapisan akses, bukan kemampuan model. Setelah lapisan akses ditangani oleh platform API terpadu, Anda dapat memilih model sepenuhnya berdasarkan performa tugas dan biaya.
Pertanyaan Umum
Q1: Apakah gpt-6.1-sol dan claude-sonnet-5-5 benar-benar sama-sama turun harga?
Pada level harga resmi, keduanya tidak berubah dan tetap di $2/$10. “Penurunan harga” yang sebenarnya terletak pada hal berikut: gpt-6.1-sol menawarkan kemampuan mendekati gpt-6-astra dengan harga seperlima, sementara pembacaan cache juga turun dari $0.20 menjadi $0.10; claude-sonnet-5-5 menawarkan kemampuan mendekati Opus 5.5 dengan harga setengah Opus, serta dapat menurunkan biaya per tugas hingga sekitar 30% melalui lebih sedikit pemanggilan alat. Karena itu, saat membandingkan keduanya, fokuslah pada total biaya per tugas, bukan harga per unit.
Q2: Bagaimana memanggil claude-sonnet-5-5 tanpa akun Anthropic?
Akun resmi Anthropic memiliki persyaratan untuk wilayah pendaftaran, nomor ponsel, dan metode pembayaran. Pengembang individu serta tim di dalam negeri sering kali terhambat pada tahap ini. Cara sederhana adalah memanggilnya melalui APIYI apiyi.com. Platform ini menyediakan antarmuka yang kompatibel dengan OpenAI; cukup ubah base_url menjadi https://api.apiyi.com/v1 dan atur model ke claude-sonnet-5-5, tanpa perlu mengubah kode bisnis lainnya.
Q3: Apakah 1,05 juta konteks pada gpt-6.1-sol aman digunakan sepenuhnya?
Bisa, tetapi perhatikan perhitungannya. Jika input sekali kirim melebihi 272K Token, harga input dan cache untuk seluruh permintaan menjadi dua kali lipat, sedangkan harga output menjadi 1,5 kali lipat. Jika bisnis memang membutuhkan jendela konteks yang sangat panjang, sebaiknya lakukan kompresi melalui retrieval terlebih dahulu, atau arahkan permintaan tersebut ke claude-sonnet-5-5 yang tidak mengenakan premi konteks panjang.
Q4: Mengapa claude-sonnet-5-5 terkadang lebih mahal dari perkiraan?
Penyebab utamanya adalah tingkat penalaran. Tingkat default API-nya adalah high, sementara mode berpikir tidak dapat dinonaktifkan. Pada tugas sederhana, ini mudah menghasilkan banyak Token berpikir yang tidak diperlukan. Pengujian independen menunjukkan bahwa konsumsi Token pada tingkat medium setara dengan Sonnet 5, tetapi hasilnya lebih baik. Karena itu, untuk tugas harian sebaiknya secara eksplisit atur ke medium.
Q5: Untuk skenario pemrograman, sebaiknya pilih yang mana?
Jika Anda terutama menggunakan agen berbasis terminal, seperti Claude Code, untuk pengembangan multilangkah, skor Terminal-Bench claude-sonnet-5-5 lebih meyakinkan. Jika fokus utama Anda adalah perbaikan bug tingkat repositori dan penggunaan dalam alur kerja Codex, gpt-6.1-sol menyamai gpt-6-astra dengan biaya per tugas yang lebih rendah. Jika kondisi tim memungkinkan, pilihan paling aman adalah mengintegrasikan keduanya dan mengarahkan tugas berdasarkan jenisnya.
Ringkasan
Dalam perbandingan gpt-6.1-sol dan claude-sonnet-5-5, tidak ada pemenang mutlak. claude-sonnet-5-5 lebih unggul untuk pemrograman berbasis agen, pekerjaan berbasis pengetahuan, dan indeks kecerdasan, serta menawarkan jendela konteks 1 juta tanpa biaya tambahan. Sementara itu, gpt-6.1-sol lebih unggul dalam harga cache, perbaikan kode tingkat repositori, parsing dokumen, dan biaya untuk tugas tunggal; cocok untuk trafik produksi berskala besar dengan tingkat penggunaan ulang tinggi. Harga dasar keduanya sama; faktor yang benar-benar membedakan tagihan adalah panjang input, tingkat cache hit, dan tingkat penalaran.
Dalam praktiknya, Anda bisa menjalankannya dalam tiga langkah: pertama, gunakan alur keputusan dalam artikel ini untuk menentukan model utama; kedua, gunakan skrip perbandingan untuk menjalankan pengujian A/B pada tugas nyata dengan tingkat penalaran yang sama; terakhir, bangun routing dua model berdasarkan jenis tugas agar setiap permintaan menggunakan model dengan rasio biaya-kinerja terbaik.
Jika ingin melewati proses pendaftaran dua akun resmi Anthropic dan OpenAI, Anda dapat menggunakan APIYI apiyi.com untuk memanggil gpt-6.1-sol dan claude-sonnet-5-5 secara terpusat. Antarmuka platform ini kompatibel dengan format resmi OpenAI; cukup dengan satu Key, Anda dapat beralih bebas di antara kedua model. Solusi ini sangat cocok untuk pengujian pemilihan model dan routing multimodel di lingkungan produksi.
Referensi:
– Rilis resmi OpenAI: Pengenalan GPT-6.1 Sol openai.com/index/introducing-gpt-6-1-sol
– Rilis resmi Anthropic: Pengenalan Claude Sonnet 5.5 anthropic.com/claude-sonnet-5-5
– Evaluasi Indeks Kecerdasan Artificial Analysis: artificialanalysis.ai
– Ulasan benchmark GPT-6.1 Sol dari Vellum: vellum.ai/blog
– Liputan The Decoder tentang Claude Sonnet 5.5: the-decoder.com
Tentang penulis: Tim teknis APIYI, berfokus pada integrasi API Model Bahasa Besar AI dan praktik rekayasa. Silakan berdiskusi melalui APIYI apiyi.com mengenai pemilihan gpt-6.1-sol dan claude-sonnet-5-5 serta optimasi biaya.