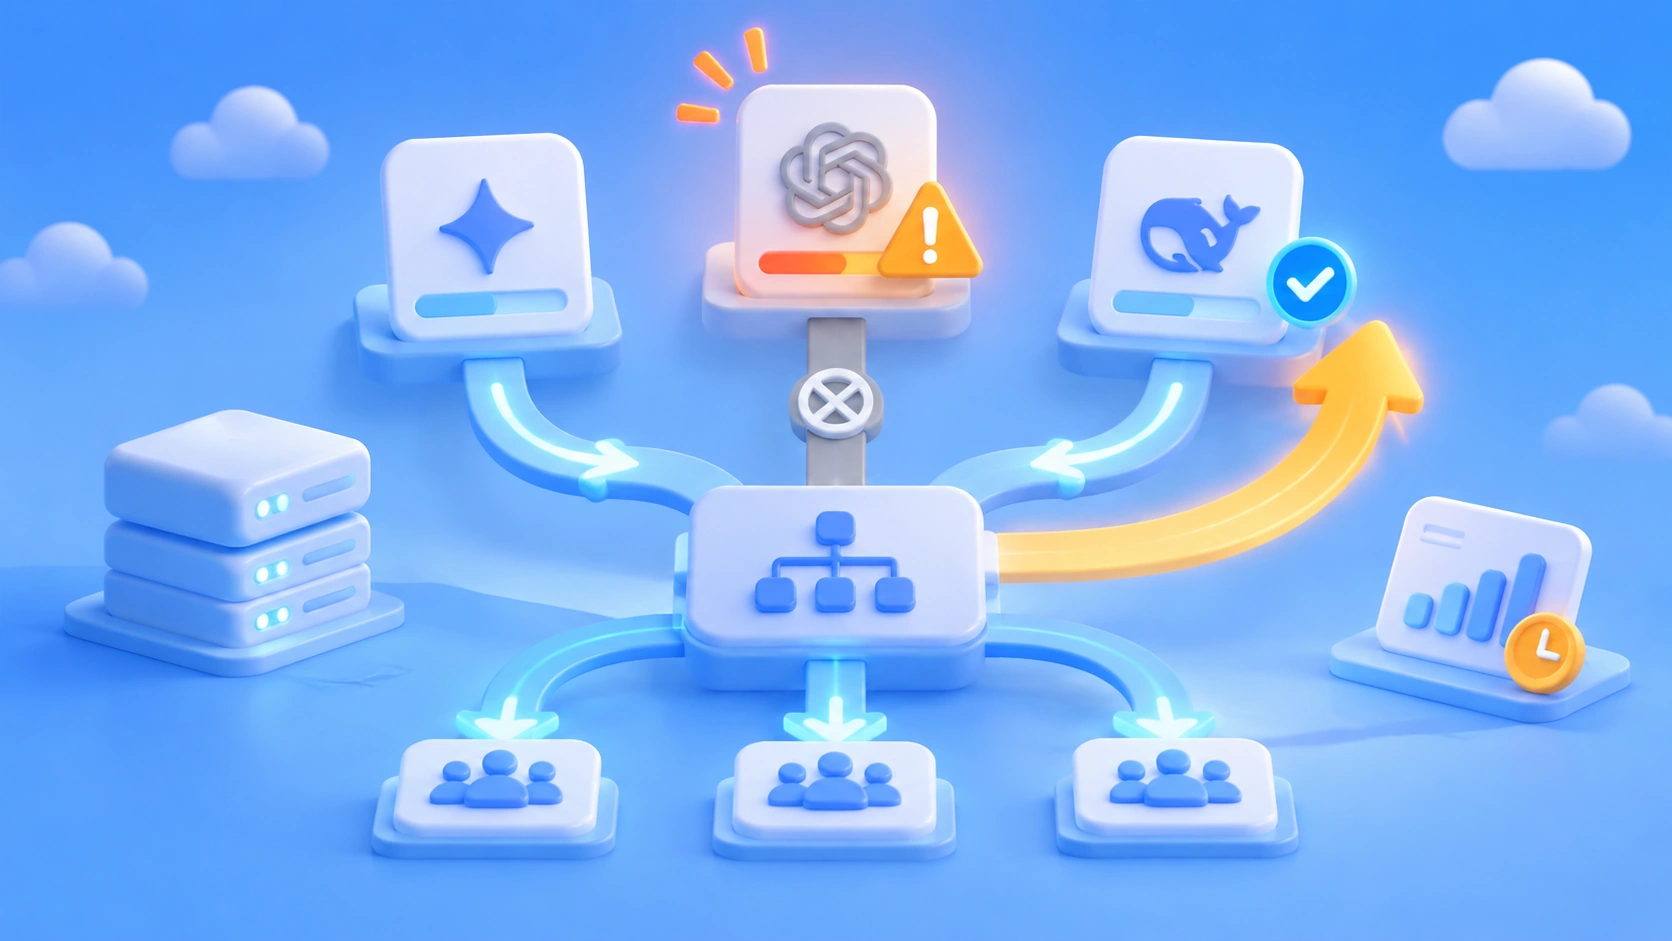
Catatan penulis: Kuota habis, pembatasan laju, dan timeout sudah bisa diperkirakan pada hari peluncuran model baru. Artikel ini membahas 5 poin desain: pelapisan model, pemetaan model cadangan, antrean prioritas, penjadwalan di luar jam sibuk, serta pemantauan dan anggaran. Ada juga daftar periksa kapasitas untuk hari peluncuran.
Kesimpulannya: kuota yang langsung habis saat model baru diluncurkan bukanlah kejutan, melainkan bagian dari siklus peluncuran produk. Kuota gratis menarik banyak pengguna untuk mencoba, trafik memuncak pada hari peluncuran, sementara penyedia layanan butuh waktu untuk menambah kapasitas. Gabungan faktor ini membuat keterbatasan kapasitas hampir tak terhindarkan. Yang perlu dilakukan di sisi aplikasi adalah merancang peralihan antar-model dan penjadwalan di luar jam sibuk sebelum peluncuran, bukan menunggu 429 muncul lalu terus mencoba ulang.
Artikel ini bukan panduan untuk “menambah jumlah percobaan ulang”. Percobaan ulang hanya membantu mengatasi gangguan sesaat, bukan kuota yang habis atau beban berlebih di sisi penyedia. Pada hari peluncuran, yang menentukan bukan jumlah percobaan ulang, melainkan pelapisan dan antrean yang sudah disiapkan sebelumnya. Setelah membaca artikel ini, Anda akan mendapatkan metode desain kapasitas yang bisa langsung diterapkan: pelapisan model, pemetaan model cadangan, antrean prioritas, penjadwalan di luar jam sibuk, serta pemantauan dan anggaran. Anda juga akan tahu kapan harus beralih, kapan harus mengantre, dan kapan harus berhenti.
Mengapa batas penggunaan mudah tercapai saat model baru dirilis
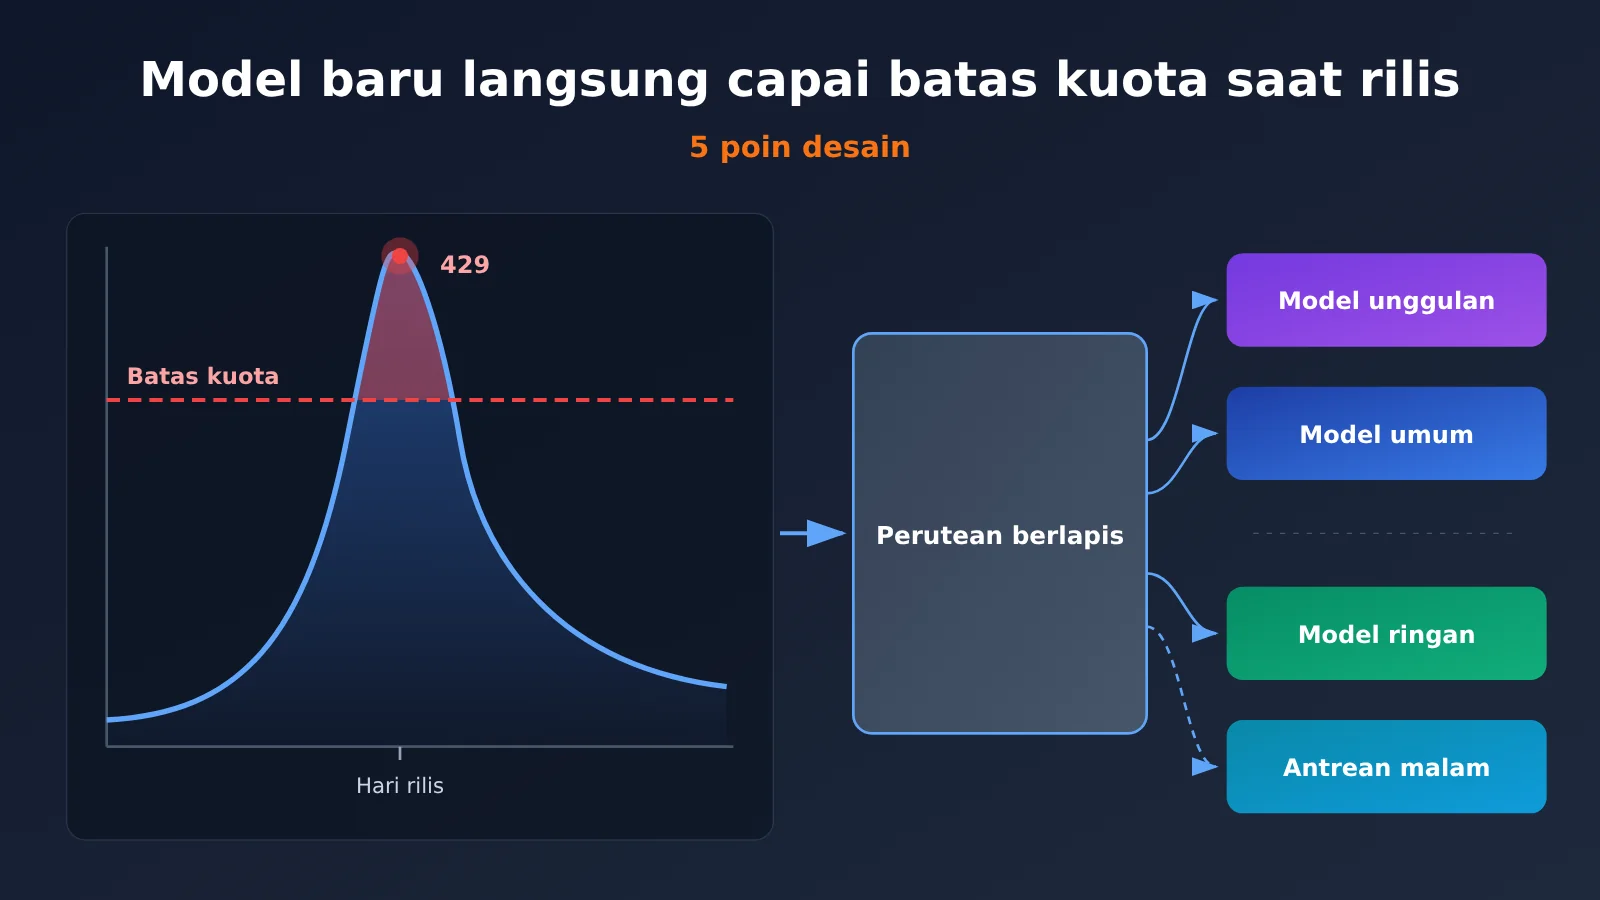
Intinya, batas penggunaan mudah tercapai pada hari perilisan karena permintaan melonjak bersamaan, sementara penambahan kapasitas membutuhkan waktu. Aplikasi perlu dirancang dengan menganggap hal ini sebagai kejadian yang bisa diantisipasi.
Contoh terbaru adalah Hy4 dari Tencent. Menurut pernyataan publik Tencent, Hy4 pertama kali tersedia di WorkBuddy pada 4 November. Pada hari pertama, banyak pengguna mencapai batas penggunaan. Tencent kemudian meningkatkan kapasitas klaster inferensi hingga sepuluh kali lipat dan menaikkan kuota gratis. Tencent menyarankan pengguna yang mencapai batas untuk beralih ke Hy3 atau mengerjakan tugas yang tidak mendesak pada malam hari. Tencent juga memperpanjang masa penggunaan gratis terbatas Hy3 hingga 15 November pukul 23:59.
Perlu digarisbawahi bahwa kejadian ini terjadi di tingkat produk WorkBuddy, yaitu pada kuota penggunaan untuk pengguna akhir, dan tidak bisa langsung disamakan dengan pembatasan laju API. Kuota produk biasanya dihitung berdasarkan akun atau tingkat keanggotaan, sedangkan pembatasan laju API mengatur kecepatan dan konkurensi berdasarkan Key, organisasi, atau model. Kondisi pemicu dan cara penanganannya pun berbeda. Meski begitu, polanya berlaku secara umum: begitu model baru diluncurkan, permintaan bisa membanjir dalam waktu yang sangat singkat.
Skala permintaan sendiri juga meningkat pesat. Pada 4 November, DeepSeek mengungkapkan bahwa Harness memiliki sekitar 1,54 juta pengguna aktif harian dan mengonsumsi sekitar 92 triliun token per hari. Angka-angka ini dilaporkan oleh perusahaan sendiri, bukan hasil audit pihak ketiga. Jadi, angka tersebut hanya cocok untuk memahami skalanya, bukan sebagai dasar yang presisi untuk perencanaan kapasitas. Meski begitu, angka ini cukup menunjukkan bahwa konsumsi token aplikasi berbasis Agent sudah jauh melampaui skenario percakapan biasa.
Empat penyebab batas penggunaan mudah tercapai pada model baru
| Penyebab | Bentuknya | Dampak pada aplikasi |
|---|---|---|
| Kuota gratis atau uji coba | Model baru sering disertai kuota uji coba, sehingga menarik banyak pengguna untuk mencoba secara bersamaan | Kuota cepat habis dan muncul 402 atau 429 |
| Akses yang terkonsentrasi | Trafik pada hari perilisan, masa promosi, dan jam kerja siang hari saling bertumpuk | Lonjakan puncak bisa mencapai 3-10 kali trafik harian |
| Tugas panjang yang menyita sumber daya | Agent melakukan banyak putaran, pemanggilan alat, dan menggunakan konteks panjang | Setiap permintaan menggunakan banyak token dan menyita sumber daya inferensi lebih lama |
| Penambahan kapasitas penyedia yang terlambat | Penambahan kapasitas klaster inferensi membutuhkan waktu | Muncul 5xx, antrean, timeout, bahkan fluktuasi kualitas keluaran |
Dari keempat penyebab ini, yang bisa langsung dikendalikan oleh aplikasi hanyalah pola permintaan dan cara penjadwalannya sendiri. Jadi, daripada berharap penyedia mampu menahan lonjakan, lebih baik siapkan pengalihan trafik dan penyangga di sisi aplikasi.
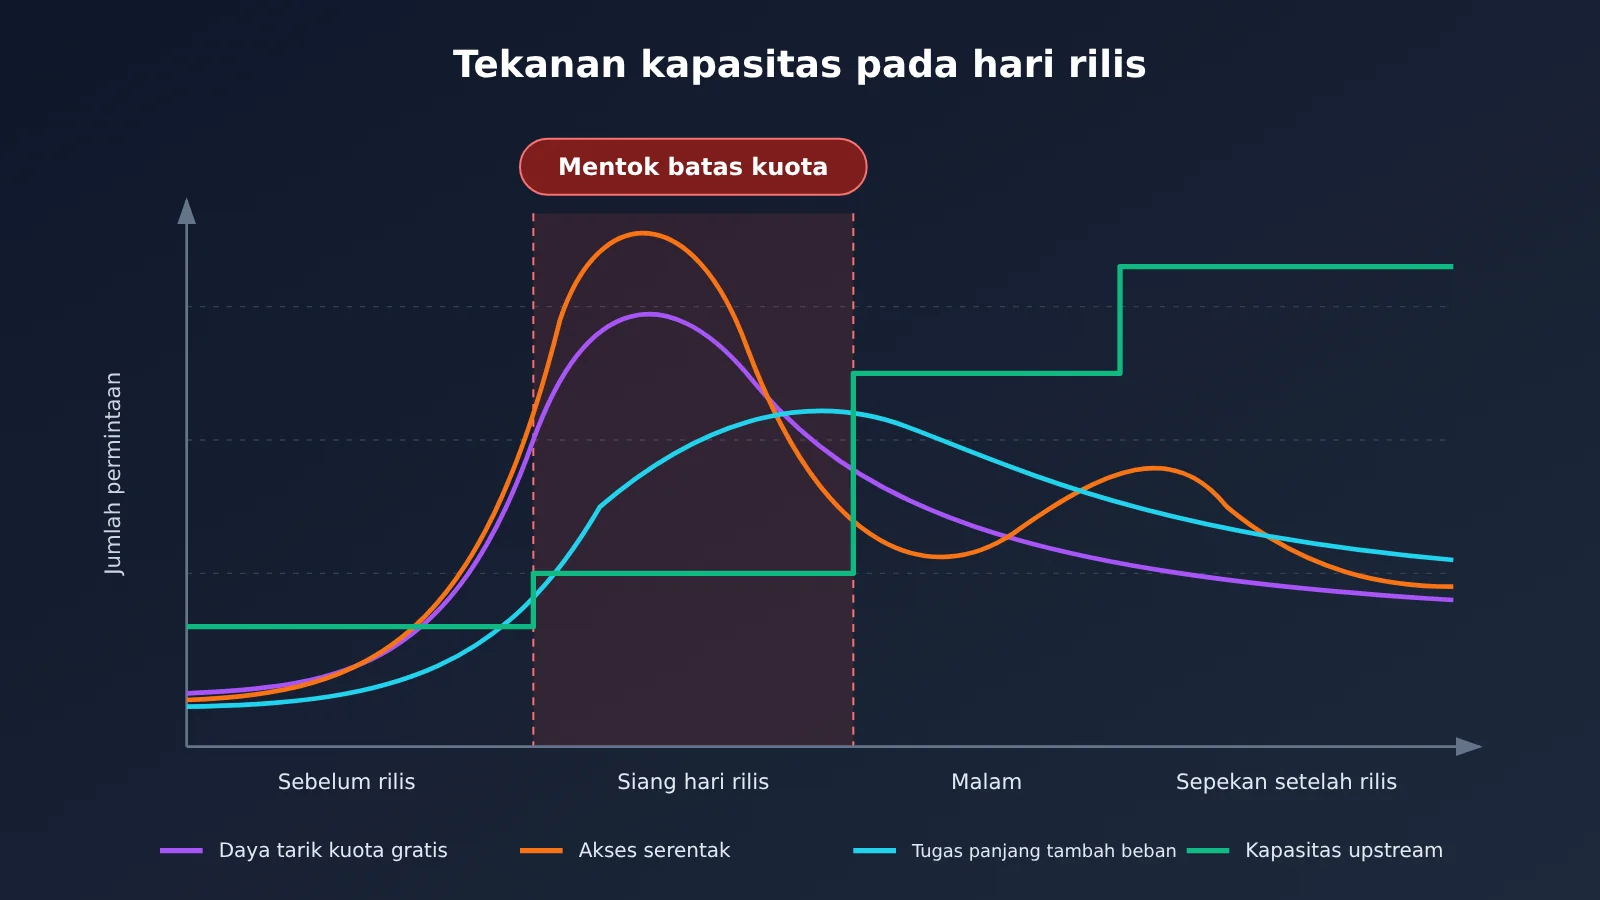
Lima jenis masalah kapasitas saat model baru mencapai batas kuota
Intinya: mencapai batas kuota bukan satu jenis kesalahan, melainkan lima masalah kapasitas yang berbeda. Masing-masing perlu ditangani dengan cara yang sesuai.
Banyak tim memasukkan semua kegagalan ke dalam logika percobaan ulang yang sama. Justru inilah yang bisa memperparah insiden pada hari peluncuran. Saat kuota habis, percobaan ulang hanya akan terus gagal. Saat layanan upstream kelebihan beban, percobaan ulang yang terlalu sering malah menambah kepadatan. Tabel berikut memisahkan kelima masalah tersebut agar kamu lebih mudah merancang penanganannya.
| Masalah | Kode status umum | Penyebab | Penanganan |
|---|---|---|---|
| Kuota habis | 402, 429 |
Kuota gratis, kuota uji coba, atau saldo akun habis | Hentikan percobaan ulang, beralih ke model cadangan, atau minta pengguna menambah kuota |
| Batas laju atau konkurensi | 429, sering disertai Retry-After |
RPM, TPM, atau konkurensi per Key atau per model melampaui batas | Tunggu sesuai Retry-After; jika waktu tunggu melampaui ambang batas, beralih model atau masukkan ke antrean |
| Kapasitas upstream tidak mencukupi | 500, 502, 503, 529 |
Klaster inferensi kelebihan beban atau mengalami gangguan sebagian | Lakukan beberapa percobaan ulang dengan jeda eksponensial, lalu beralih ke model cadangan jika terus gagal |
| Tugas panjang menyita kapasitas | Waktu habis, koneksi terputus | Agent dengan banyak putaran, pemanggilan alat, atau konteks panjang membuat satu permintaan terlalu berat | Pecah tugas, batasi konteks, dan sediakan pool konkurensi terpisah untuk tugas panjang |
| Lonjakan pada jam sibuk | 429 dan 5xx muncul bersamaan |
Trafik menumpuk pada siang hari, hari peluncuran, atau selama acara | Gunakan antrean prioritas dan jadwalkan tugas di luar jam sibuk; tunda tugas yang tidak mendesak |
Ada dua hal dalam tabel yang perlu digarisbawahi. Pertama, 429 sendiri ambigu: penyebabnya bisa berupa batas laju yang terlampaui atau kuota yang habis. Untuk memastikannya, periksa pesan kesalahan dalam isi respons dan Retry-After. Kedua, kode kelebihan beban seperti 529 menandakan bahwa layanan upstream sementara tidak dapat melayani permintaan. Dalam situasi ini, mengurangi frekuensi permintaan lebih efektif daripada mempercepat percobaan ulang.
Setelah memahami perbedaan kode kesalahan, barulah lima aspek desain berikutnya punya dasar yang jelas: kapan harus beralih, kapan harus mengantre, dan kapan harus langsung berhenti.
5 Poin Desain untuk Pergantian Multimodel dan Penjadwalan di Luar Jam Sibuk
Kesimpulannya, lima poin desain ini menjawab lima pertanyaan: “pakai model yang mana, ganti ke model apa, siapa yang lebih dulu memakai, kapan digunakan, dan berapa biayanya”. Jika salah satunya terlewat, masalahnya akan terlihat pada hari peluncuran.
Poin desain 1: Pengelompokan model berdasarkan tingkat kemampuan
Cara melakukannya: Bagi model menjadi tiga tingkat berdasarkan kemampuan dan biaya: unggulan, umum, dan ringan. Lalu, petakan tugas bisnis ke tingkat yang sesuai berdasarkan prioritas dan kesulitannya. Gunakan tingkat unggulan untuk penalaran kompleks dan pembuatan kode yang krusial; tingkat umum untuk tanya jawab sehari-hari, rangkuman, dan penulisan ulang; serta tingkat ringan untuk tugas sederhana seperti klasifikasi, ekstraksi, dan pengenalan maksud. Saat model baru diluncurkan, biasanya model tersebut hanya menerima sebagian trafik di tingkat unggulan, bukan langsung menggantikan seluruh trafik.
Kapan diterapkan: Pengelompokan ini merupakan konfigurasi standar, bukan sesuatu yang baru diaktifkan saat terjadi gangguan. Dalam operasional sehari-hari, konfigurasi ini menentukan tujuan default setiap jenis tugas. Pada hari peluncuran, Anda hanya perlu menyesuaikan proporsinya.
Cara memvalidasi: Ambil kumpulan soal evaluasi yang tetap untuk setiap tingkat, lalu catat tingkat kelulusan, latensi P95, dan biaya token per tugas. Pastikan kualitas tidak turun secara signifikan saat tingkat ringan menangani tugas sederhana.
Dalam praktiknya, hambatan terbesar sering kali adalah “setiap menambahkan penyedia, perlu satu set SDK dan kunci API lagi”. Melalui platform agregasi seperti APIYI apiyi.com, satu kunci API dapat digunakan untuk memanggil model dari OpenAI, Claude, Gemini, dan penyedia lainnya. Antarmukanya kompatibel dengan format OpenAI, sehingga saat mengelompokkan model, Anda hanya perlu mengubah nama model tanpa harus mengelola autentikasi dan klien terpisah untuk setiap tingkat.
Poin desain 2: Pemetaan model cadangan
Cara melakukannya: Tentukan setidaknya satu model cadangan untuk setiap model utama. Saat membuat pemetaan, periksa enam aspek satu per satu: tingkat kemampuan, panjang konteks, dukungan pemanggilan alat, kemampuan output terstruktur, harga, dan wilayah ketersediaan. Dukungan pemanggilan alat dan output terstruktur paling sering terlewat. Jika model cadangan tidak mendukung format pemanggilan fungsi yang sama, Agent akan langsung terhenti setelah peralihan.
Kapan peralihan dipicu: Tetapkan kondisi peralihan sebagai aturan yang spesifik, misalnya 5xx terjadi 2 kali berturut-turut, Retry-After pada 429 melebihi waktu tunggu yang dapat diterima tugas, latensi P95 terus melampaui dua kali baseline, atau ada respons yang secara eksplisit menyatakan kuota habis. Jangan gunakan aturan “beralih pada setiap kegagalan”, karena gangguan sesaat pun bisa memicu terlalu banyak peralihan.
Cara memvalidasinya: Jalankan kumpulan soal yang sama pada model utama dan model cadangan. Bandingkan tingkat kelulusan, tingkat keberhasilan validasi output terstruktur, dan tingkat keberhasilan pemanggilan alat. Jika selisihnya melampaui batas toleransi bisnis, pilih ulang model cadangannya.
| Tingkat | Tugas yang sesuai | Model utama | Model cadangan | Kondisi peralihan |
|---|---|---|---|---|
| Flagship | Penalaran kompleks, kode kritis, perencanaan Agent | Model flagship yang baru dirilis | Flagship generasi sebelumnya atau model setara dari penyedia lain | 5xx terjadi 2 kali berturut-turut; Retry-After pada 429 melebihi 30 detik |
| Umum | Tanya jawab, ringkasan, penulisan ulang, pembuatan laporan | Model umum andalan | Model umum setara dari penyedia lain | Latensi P95 melebihi 2 kali baseline selama 5 menit |
| Ringan | Klasifikasi, ekstraksi, perutean, pengenalan maksud | Model ringan | Model ringan dari penyedia lain | Tingkat 5xx melebihi 5%; kuota habis |
| Batch | Analisis offline, pelabelan data, evaluasi | Model berbiaya rendah apa pun yang tersedia | Tidak beralih, langsung ditunda | Tidak langsung beralih, masuk ke antrean malam |
| Platform yang tersedia | Akses terpadu untuk semua tingkat di atas | APIYI apiyi.com, API resmi setiap penyedia | Sama seperti di kolom sebelumnya | Mengacu pada konsol dan dokumentasi |
Ambang batas dalam tabel hanyalah contoh dan perlu disesuaikan dengan baseline bisnis Anda.
💡 Saran degradasi layanan: Jika tidak ingin mengelola seluruh logika peralihan sendiri di aplikasi, Anda bisa memanfaatkan kemampuan platform. Dalam keterangan resminya, APIYI apiyi.com menyatakan bahwa platformnya menggunakan deployment multinode, perutean cerdas, degradasi otomatis, dan load balancing untuk membantu mengurangi beban saat terjadi gangguan parsial pada layanan upstream. Untuk kondisi pemicu dan aturan peralihan yang spesifik, lihat dokumentasi resmi. Aplikasi tetap disarankan memiliki pemetaan cadangan sendiri sebagai pengaman.
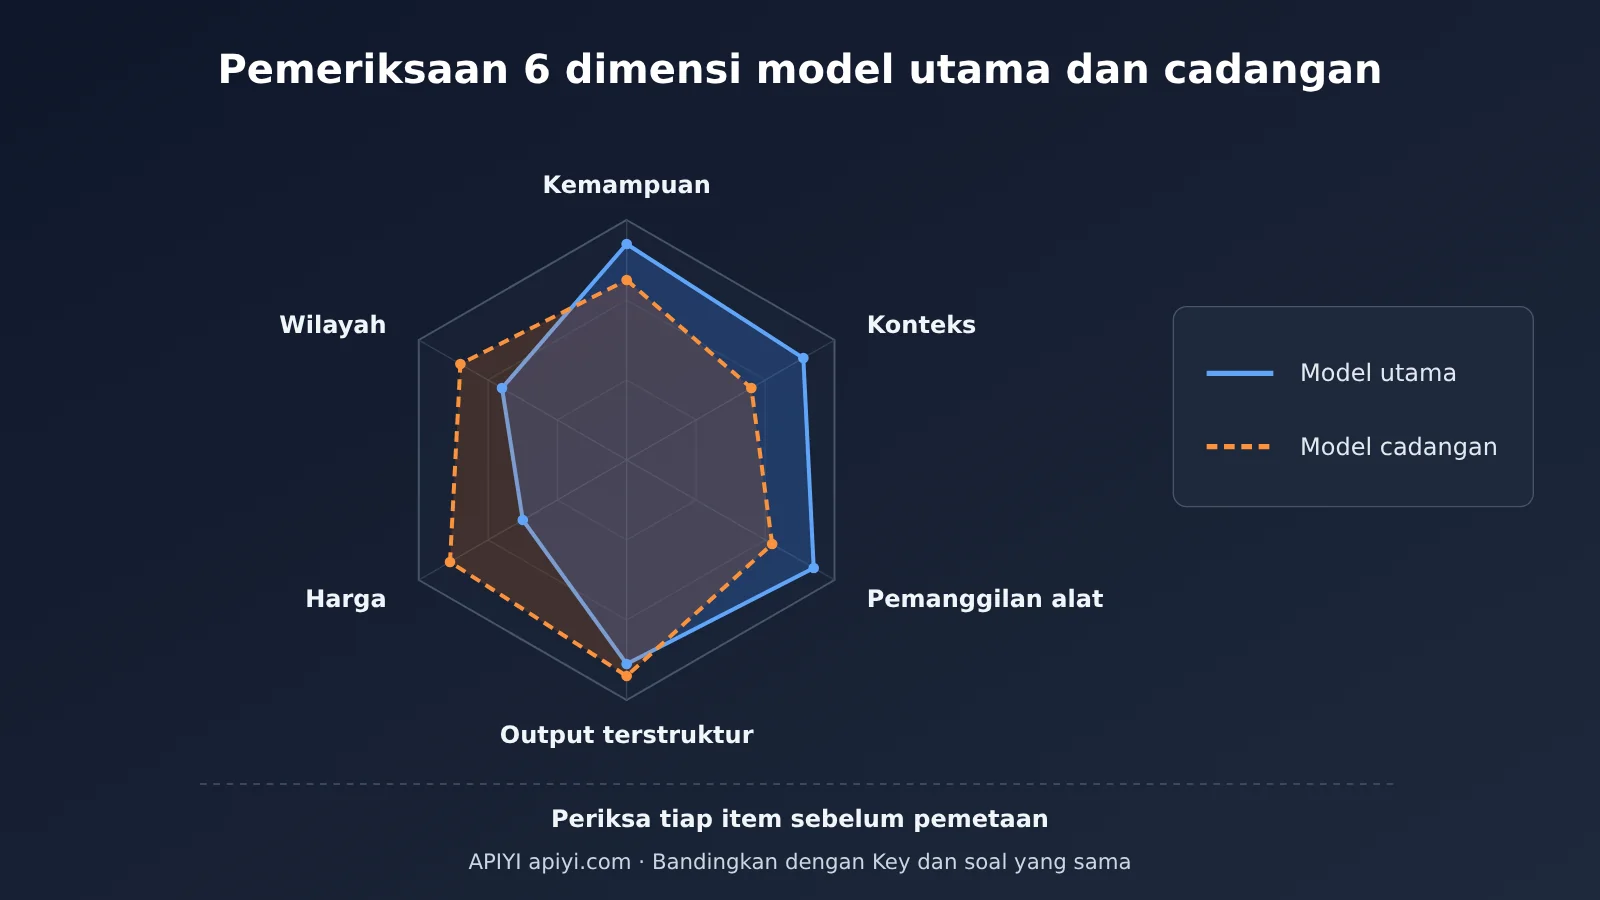
Poin desain 3: Antrean prioritas
Cara menerapkannya: Bagi permintaan ke dalam tiga tingkat prioritas: tugas berbayar atau mendesak, tugas internal, dan tugas batch. Tugas mendesak langsung menggunakan model utama; tugas internal dialihkan ke model cadangan saat model utama sibuk; tugas batch masuk ke antrean untuk menunggu. Setiap antrean perlu memiliki batas konkurensi maksimum, waktu antre maksimum, dan strategi pengalihan saat batas waktu terlampaui. Dengan begitu, satu tugas yang berjalan lama tidak akan menghabiskan seluruh kapasitas konkurensi.
Kapan diterapkan: Antrean mulai berlaku ketika tingkat 429 atau panjang antrean model utama melewati ambang batas. Permintaan berprioritas rendah tidak lagi berebut kapasitas konkurensi model utama.
Cara memverifikasinya: Antrean harus bisa dipantau. Setidaknya, Anda perlu melihat panjang antrean, rata-rata waktu tunggu, dan tingkat pembatalan. Saat uji beban, sengaja picu pembatasan laju pada model utama, lalu pastikan latensi tugas mendesak tetap stabil dan tugas berprioritas rendah masuk antrean, bukan gagal.
Ada satu prinsip wajib: permintaan yang tidak idempoten tidak boleh dicoba ulang secara otomatis. Untuk operasi seperti membuat pesanan, mengirim pesan, menulis ke basis data, atau memanggil alat eksternal berbayar, periksa statusnya terlebih dahulu setelah terjadi kegagalan. Pastikan apakah operasi sebelumnya sudah berhasil sebelum memutuskan untuk mengirimnya lagi. Anda dapat membuat kunci idempotensi untuk permintaan semacam ini agar server bisa mendeteksi dan menghapus duplikat. Mencoba ulang semua kesalahan secara otomatis adalah penyebab umum penagihan dan penulisan data ganda pada hari peluncuran.
Poin desain 4: Penjadwalan di luar jam sibuk
Cara menerapkannya: Identifikasi tugas yang bisa menoleransi penundaan, seperti laporan offline, peringkasan batch, pelabelan data, dan evaluasi regresi. Jalankan tugas tersebut pada malam hari atau saat beban rendah. Salah satu saran Tencent kepada pengguna yang mencapai batas Hy4 adalah memindahkan tugas yang tidak mendesak ke malam hari. Pendekatan ini juga berlaku untuk pemanggilan API.
Kapan dipicu: Dua mekanisme pemicu bisa digunakan bersamaan. Pertama, berdasarkan jendela waktu: jalankan tugas batch secara rutin pada malam hari saat beban rendah. Kedua, berdasarkan beban: ketika tingkat 429 atau latensi P95 pada siang hari melewati ambang batas, tunda otomatis eksekusi antrean batch.
Cara memverifikasinya: Periksa apakah volume permintaan pada jam sibuk siang hari menurun, serta apakah tingkat penyelesaian dan tingkat percobaan ulang akibat kegagalan tugas malam hari masih dalam batas yang dapat diterima. Tugas yang gagal dapat dicoba ulang, tetapi tetap harus mengikuti prinsip idempotensi.
Poin desain 5: Pemantauan dan anggaran
Cara menerapkannya: Pisahkan statistik penggunaan berdasarkan Key, model, dan jenis tugas, bukan hanya melihat totalnya. Saat total penggunaan terlihat stabil, konsumsi token untuk satu tugas Agent mungkin sudah naik dua kali lipat. Hal ini baru terlihat jika statistik dipisahkan berdasarkan dimensinya. Tetapkan juga anggaran dan peringatan sementara untuk hari peluncuran. Ambang peringatan boleh sedikit dilonggarkan, tetapi batas maksimum anggaran harus tetap ada.
Kapan dipicu: Aturan peringatan sebaiknya mencakup empat sinyal: lonjakan tingkat 429, lonjakan tingkat 5xx, konsumsi token per tugas yang melampaui nilai dasar, dan penggunaan anggaran harian yang melewati persentase tertentu.
Cara memverifikasinya: Sebelum peluncuran, lakukan uji coba dengan trafik kecil. Pastikan dasbor memisahkan data berdasarkan dimensi dengan benar dan peringatan sampai dalam waktu yang diharapkan.
| Metrik | Dimensi yang diperhatikan | Keterangan |
|---|---|---|
Tingkat 429 |
Key, model | Bedakan antara pelampauan batas laju dan kuota yang habis |
Tingkat 5xx |
Model | Tentukan apakah penyedia upstream mengalami kelebihan beban dan picu pengalihan |
| Latensi P95 | Model, jenis tugas | Hitung tugas berdurasi panjang secara terpisah agar tidak menaikkan nilai dasar keseluruhan |
| Panjang antrean dan waktu tunggu | Antrean prioritas | Pantau apakah tugas berprioritas rendah menumpuk |
| token/tugas, biaya/tugas | Jenis tugas | Interaksi multi-putaran Agent dan pemanggilan alat dapat meningkatkan konsumsi secara signifikan |
| Jumlah pengalihan dan tingkat keberhasilan fallback | Pemetaan model utama dan cadangan | Periksa apakah model cadangan benar-benar berhasil menangani trafik |
Statistik biaya dapat diperoleh melalui fitur platform. Konsol APIYI apiyi.com menyediakan daftar model serta informasi penggunaan, tagihan, dan log. Fitur ini berguna untuk memeriksa konsumsi aktual berdasarkan Key dan model pada hari peluncuran. Padukan dengan pelacakan berdasarkan dimensi tugas di sistem sendiri agar “berapa yang dibelanjakan” dan “untuk apa” bisa terlihat jelas.
Untuk memperkirakan kapasitas, gunakan jumlah pengguna aktif harian, volume permintaan, dan rata-rata token untuk menghitung QPS puncak, lalu kalikan dengan faktor peningkatan akibat interaksi multi-putaran Agent dan pemanggilan alat. Beban puncak pada hari peluncuran bisa mencapai 3–10 kali beban harian. Sebaiknya siapkan kapasitas cadangan sebesar 30%–50%, atau model cadangan yang siap digunakan kapan saja. Perkiraan yang hanya berdasarkan skenario chat akan sangat meremehkan konsumsi akibat konteks panjang dan pemanggilan alat.
Panduan cepat beralih antar-model: cara memvalidasi fallback
Kesimpulannya: jalur cadangan yang belum pernah diuji sama saja dengan tidak punya jalur cadangan. Validasi fallback harus selesai sebelum rilis.
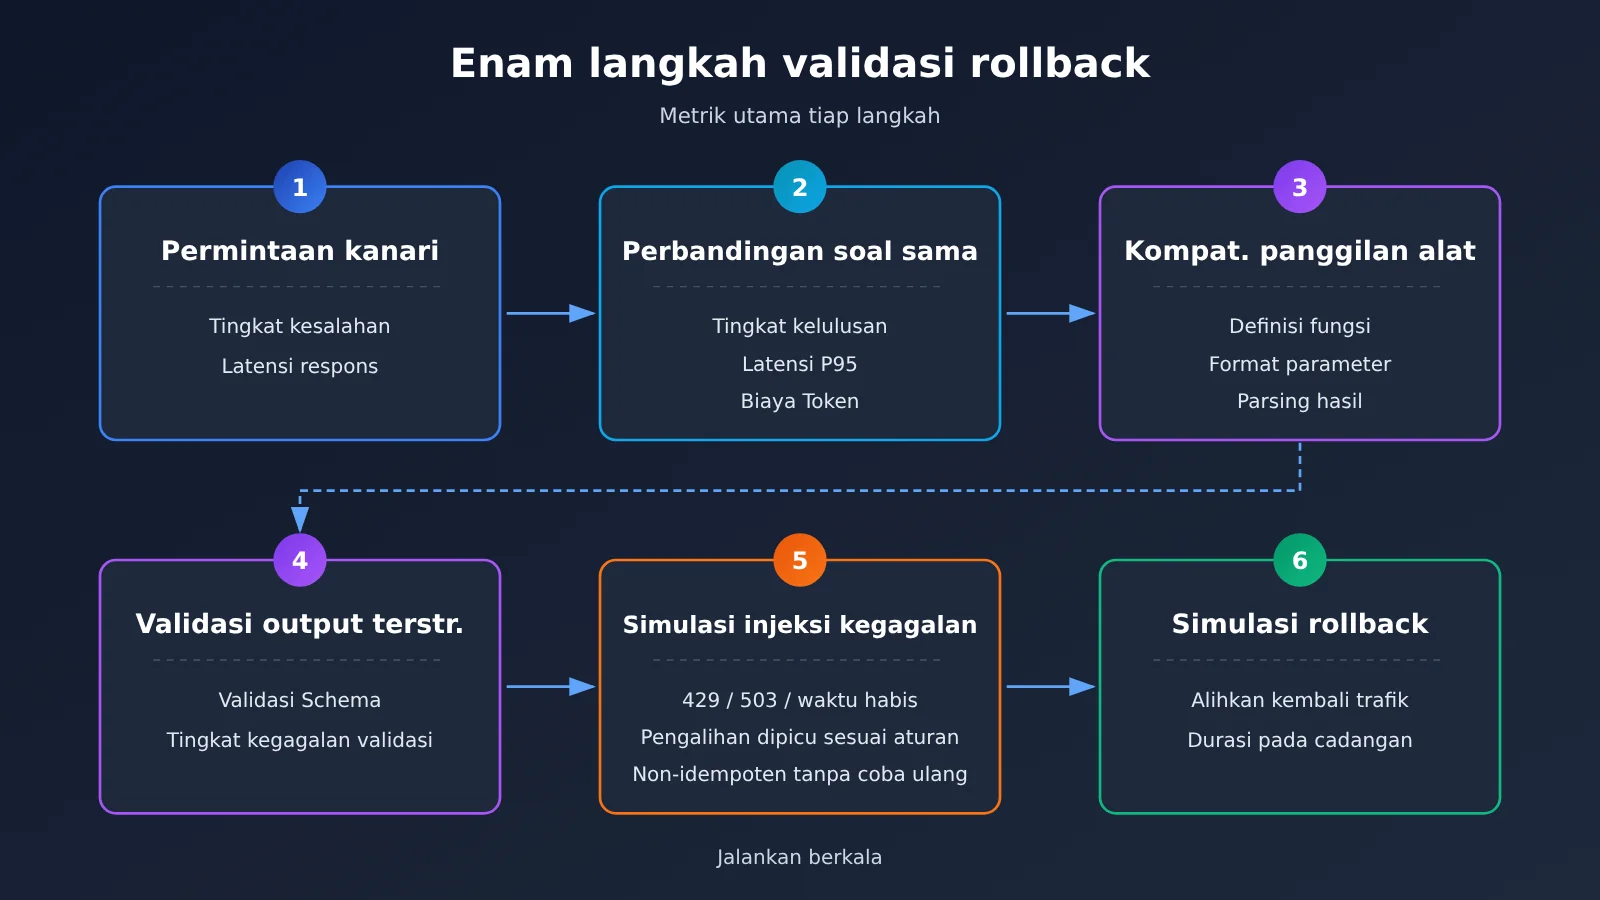
Perubahan pada integrasinya tidak rumit. Jika sudah menggunakan SDK yang kompatibel dengan OpenAI, cukup atur base_url ke https://api.apiyi.com/v1 dan ganti api_key dengan kunci yang disediakan platform. Model utama dan model cadangan dapat ditukar dengan mengubah parameter model, tanpa perlu menambahkan klien baru. Yang benar-benar membutuhkan waktu adalah validasinya. Lakukan dengan urutan berikut:
- Permintaan canary: Kirim sebagian kecil lalu lintas nyata ke model cadangan, lalu pantau tingkat kesalahan dan latensi.
- Perbandingan dengan soal yang sama: Jalankan model utama dan model cadangan pada set evaluasi yang sama, lalu bandingkan tingkat kelulusan, latensi P95, dan biaya token.
- Kompatibilitas pemanggilan alat: Periksa satu per satu apakah definisi fungsi, format parameter, dan penguraian respons berjalan dengan benar pada model cadangan.
- Validasi output terstruktur: Validasi output JSON terhadap schema dan catat tingkat kegagalannya.
- Simulasi injeksi gangguan: Simulasikan
429,503, dan timeout untuk memastikan peralihan terpicu sesuai aturan dan permintaan non-idempoten tidak dicoba ulang secara otomatis. - Simulasi pengembalian: Setelah model utama pulih, pastikan lalu lintas kembali dialihkan sesuai harapan dan tidak terlalu lama bertahan di model cadangan.
Sebaiknya lakukan simulasi fallback secara berkala, bukan hanya sekali sebelum rilis. Penyedia model merilis pembaruan versi, sementara petunjuk dan definisi alat Anda juga terus berubah. Pemetaan yang divalidasi tiga bulan lalu belum tentu masih berlaku hari ini.
🚀 Mulai cepat: Daftar di APIYI apiyi.com dan dapatkan kredit uji coba gratis. Gunakan Key yang sama untuk membandingkan model utama dan model cadangan dengan soal yang sama, lalu tentukan pemetaan untuk hari rilis. Harga dan ketersediaan model mengacu pada konsol dan dokumentasi.
Pertanyaan Umum FAQ
Kesimpulannya: sebagian besar pertanyaan pada hari peluncuran bisa dijawab dengan prinsip “kenali jenis kesalahannya dulu, lalu putuskan apakah perlu beralih, mengantre, atau berhenti”.
Q1: Perlukah membatasi laju di sisi aplikasi sebelum hari peluncuran model baru?
Sebaiknya, ya. Mengatur batas konkurensi dan antrean prioritas di sisi aplikasi lebih mudah dikendalikan daripada menunggu pembatasan `429` dari penyedia. Kamu bisa menentukan pengguna dan tugas mana yang diprioritaskan, sedangkan pembatasan dari penyedia tidak membedakan prioritas bisnismu. Ambang batasnya bisa ditentukan berdasarkan beban puncak normal, lalu dikalikan dengan perkiraan faktor kenaikannya.
Q2: Haruskah langsung beralih model saat mendapat 429?
Belum tentu. Periksa `Retry-After` terlebih dahulu. Jika waktu tunggunya masih bisa diterima untuk tugas tersebut, tunggu lalu coba lagi. Jika melebihi ambang batas atau respons menyatakan kuota habis, barulah beralih ke model cadangan. Saat menggunakan satu kunci untuk memanggil model dari berbagai penyedia melalui APIYI apiyi.com, kamu hanya perlu mengubah nama model. Dengan begitu, ambang batas bisa diatur lebih spesifik tanpa harus langsung mengalihkan semuanya setiap kali muncul `429`.
Q3: Bagaimana cara mengantrekan tugas yang tidak mendesak?
Buat antrean dan kelompok konkurensi terpisah untuk tugas yang tidak mendesak, lalu tetapkan waktu antre maksimum. Jika waktunya habis, jangan buang tugasnya, tetapi tunda pelaksanaannya sampai malam atau di luar jam sibuk. Pantau panjang antrean, waktu tunggu, dan tingkat tugas yang ditinggalkan. Tugas yang gagal bisa dicoba lagi, tetapi untuk tugas non-idempoten, statusnya harus diperiksa terlebih dahulu.
Q4: Apakah fallback otomatis bisa menurunkan kualitas hasil?
Bisa, jadi sebelum menerapkannya, bandingkan hasil model dengan soal yang sama dan pastikan selisih kualitasnya masih dapat diterima untuk kebutuhan bisnis. Deskripsi resmi APIYI apiyi.com menyatakan bahwa layanan ini mendukung fallback otomatis dan penyeimbangan beban, tetapi aturan peralihannya mengacu pada dokumentasi resmi. Perbedaan hasil setelah peralihan juga perlu kamu uji dengan kumpulan evaluasimu sendiri. Untuk tugas yang sensitif terhadap kualitas, lebih baik mengantre dan menunggu model utama daripada langsung beralih.
Q5: Bagaimana membedakan kuota produk yang habis dari pembatasan laju API?
Lihat sumber dan dasar perhitungannya. Kuota produk muncul di aplikasi yang digunakan pengguna akhir, misalnya kuota Hy4 di WorkBuddy. Kuota ini dihitung per akun dan biasanya ditunjukkan melalui pesan di antarmuka. Pembatasan laju API muncul dalam respons API sebagai `429`, yang mungkin disertai `Retry-After`, dan dihitung berdasarkan kunci API, organisasi, atau model. Untuk yang pertama, kamu bisa beralih model di dalam produk atau menunggu kuota pulih. Untuk yang kedua, gunakan backoff, antrean, dan pemetaan model cadangan.
Poin Penting: Peralihan Multimodel dan Penjadwalan di Luar Jam Sibuk
Kesimpulannya: stabilitas pada hari peluncuran bergantung pada pelapisan model, antrean, dan anggaran yang disiapkan sebelumnya.
- Keterbatasan kapasitas bisa diperkirakan: batas penggunaan pada hari peluncuran model baru adalah bagian dari siklus produk, jadi perlu diantisipasi sejak awal.
- Kesalahan harus diklasifikasikan:
402,429,5xx, dan batas waktu masing-masing memerlukan penanganan berbeda, bukan percobaan ulang yang sama. - Pelapisan sebelum peralihan: petakan tugas ke tiga lapisan—unggulan, umum, dan ringan. Model baru awalnya hanya menangani sebagian lalu lintas.
- Periksa pemetaan model cadangan: pastikan kemampuan, konteks, pemanggilan alat, output terstruktur, harga, dan wilayah sesuai satu per satu.
- Hentikan percobaan ulang untuk permintaan nonidempoten: setelah gagal, periksa status sebelum memutuskan untuk mengirim ulang.
- Kurangi beban puncak: jadwalkan tugas yang bisa ditunda pada malam hari, dan sisakan kapasitas konkurensi pada siang hari untuk tugas mendesak.
- Pisahkan pemantauan berdasarkan dimensi: gunakan log penggunaan APIYI apiyi.com untuk memeriksa pemakaian aktual berdasarkan Key dan model.
Ringkasan dan Daftar Periksa Kapasitas Hari Peluncuran
Kesimpulannya: pada hari peluncuran, yang menentukan bukan jumlah percobaan ulang, melainkan pelapisan dan antrean yang sudah disiapkan.
Model baru yang langsung mencapai batas penggunaan biasanya disebabkan oleh gabungan kuota gratis, akses serentak, tugas berdurasi panjang, dan keterlambatan penambahan kapasitas di sisi penyedia. Di sisi aplikasi, Anda bisa menggunakan pelapisan model untuk menentukan tujuan default, menyiapkan pemetaan model cadangan, melindungi tugas penting dengan antrean prioritas, mengurangi beban puncak melalui penjadwalan di luar jam sibuk, serta memantau risiko dan biaya melalui pemantauan dan anggaran. Daftar periksa berikut dibagi menjadi dua kelompok tindakan: sebelum dan pada hari peluncuran. Daftar ini bisa langsung digunakan untuk peninjauan sebelum peluncuran.
| Tahap | Poin pemeriksaan | Kriteria selesai |
|---|---|---|
| Sebelum peluncuran | Validasi model utama dan cadangan | Kedua model lolos perbandingan dengan pertanyaan yang sama, validasi pemanggilan alat, dan output terstruktur |
| Sebelum peluncuran | Bedakan kode kesalahan | 402, 429, 500, 503, 529, dan batas waktu masing-masing memiliki jalur penanganan tersendiri |
| Sebelum peluncuran | Hentikan percobaan ulang nonidempoten | Percobaan ulang otomatis dilarang untuk operasi tulis dan pemanggilan alat berbayar; periksa status terlebih dahulu setelah gagal |
| Sebelum peluncuran | Antrean prioritas | Tersedia tiga tingkat prioritas, dengan konfigurasi konkurensi maksimum, waktu antre maksimum, dan penurunan layanan saat batas waktu tercapai |
| Sebelum peluncuran | Daftar tugas di luar jam sibuk | Buat daftar tugas batch yang bisa ditunda hingga malam hari dan konfigurasikan aturan pemicu berdasarkan beban |
| Sebelum peluncuran | Simulasi | Selesaikan simulasi injeksi kegagalan, peralihan, dan pengembalian, lalu catat hasilnya |
| Hari peluncuran | Pemantauan | Pantau tingkat 429, tingkat 5xx, latensi P95, dan panjang antrean berdasarkan Key, model, dan tugas |
| Hari peluncuran | Anggaran | Tetapkan anggaran sementara dan peringatan; longgarkan ambang batas, tetapi tetap pertahankan batas maksimum |
| Hari peluncuran | Pemantauan peralihan | Perhatikan jumlah peralihan dan tingkat keberhasilan kembali ke model utama; setelah pulih, kembali sesuai rencana |
| Hari peluncuran | Pemberitahuan bisnis | Beri tahu pihak bisnis lebih awal tentang kemungkinan keterlambatan dan cakupan penurunan layanan |
Jika Anda sedang bersiap untuk peluncuran model berikutnya, coba jalankan model utama dan cadangan menggunakan satu Key melalui APIYI apiyi.com. Lalu, gunakan log penggunaan di konsol untuk menetapkan anggaran dan terapkan daftar periksa ini satu per satu.
📚 Referensi
Kesimpulan: Referensi berikut digunakan untuk memeriksa cara mengakses model dan kemampuan platform. Untuk parameter spesifik, lihat dokumentasi resmi terbaru.
- Pusat Dokumentasi APIYI: Daftar model, penjelasan antarmuka, serta informasi penggunaan dan tagihan
- Tautan:
docs.apiyi.com -
Keterangan: Lihat model yang tersedia, penggunaan antarmuka yang kompatibel dengan OpenAI, serta penjelasan tentang fallback otomatis
-
Penjelasan Kode Kesalahan OpenAI API: Arti kesalahan pembatasan laju seperti
429dan saran penanganannya - Tautan:
platform.openai.com/docs/guides/error-codes -
Keterangan: Pahami perbedaan antara pembatasan laju dan kuota yang habis
-
Penjelasan Kesalahan Anthropic API: Termasuk cara menangani kesalahan akibat beban berlebih
- Tautan:
docs.anthropic.com/en/api/errors - Keterangan: Pahami arti kesalahan
529akibat beban berlebih
Penulis: Tim Teknis APIYI
Diskusi teknis: Hubungi kami melalui halaman utama situs APIYI. Untuk informasi integrasi lainnya, kunjungi pusat dokumentasi di docs.apiyi.com