Catatan penulis: OpenAI merilis model khusus keamanan siber GPT-6 Cyber pada 5 November 2026. Artikel ini mengulas skor pengujiannya, data penyelarasan, hasil nyata, harga, dan persyaratan aksesnya, serta merangkum apa yang bisa dilakukan tim keamanan, pengembang, dan pengguna API umum saat ini.
OpenAI merilis GPT-6 Cyber pada 5 November 2026. Ini adalah model khusus keamanan siber yang menurut OpenAI dirancang untuk “menemukan dan memvalidasi kerentanan yang dapat dieksploitasi, sambil tetap mematuhi batas yang ditetapkan peneliti”. Model ini bukan model percakapan umum, melainkan model khusus untuk riset keamanan yang mendapat izin.
Peningkatan kali ini berfokus pada dua hal: kemampuan menyerang dan kepatuhan terhadap batas. Menurut data resmi, skor ExploitGym naik dari 32.1% pada GPT-5.6 Cyber menjadi 48.5%, atau meningkat 51% secara relatif. Dalam pengujian pelanggaran batas tanpa petunjuk deployment, model tetap berada dalam batas pada 99.93% kasus, dengan tingkat pelanggaran sebesar 0.07%. Model ini diklasifikasikan sebagai Critical dalam Preparedness Framework (kerangka kesiapan) OpenAI, sementara generasi sebelumnya berada pada tingkat High.
Untuk harga, API resmi dikenai biaya 20 dolar AS untuk input, 2 dolar AS untuk pembacaan cache, dan 100 dolar AS untuk output per 1 juta token. Jendela konteksnya 1,050,000 token, dengan output maksimal 128,000 token. Persyaratan aksesnya ketat: pada tahap awal, model ini hanya tersedia bagi sebagian pelanggan perusahaan Daybreak Red yang telah disetujui. Pengguna individu dapat mengajukan akses Daybreak Blue, tetapi Blue tidak menyertakan model khusus Cyber, sehingga jalur individu tidak memberikan akses ke GPT-6 Cyber. Ini bukan rumor: informasinya berasal dari pengumuman resmi OpenAI, halaman model di dokumentasi pengembang, dan pusat bantuan Daybreak. Penulis belum mencoba model ini secara langsung.
Intinya: dalam beberapa menit, Anda bisa memahami angka-angka GPT-6 Cyber yang dapat diverifikasi, tiga jenis sumber informasi, dan pilihan yang tersedia untuk tim Anda saat ini. Angka dalam artikel ini telah diperiksa silang dengan pengumuman resmi, kartu sistem, halaman model untuk pengembang, dan pusat bantuan Daybreak. Semua harga menggunakan satuan per 1 juta token. Jika Anda hanya mencari model umum yang bisa membaca kode dan memeriksa kerentanan, Anda juga bisa langsung melihat tabel harga model alternatif APIYI (apiyi.com) di akhir artikel.
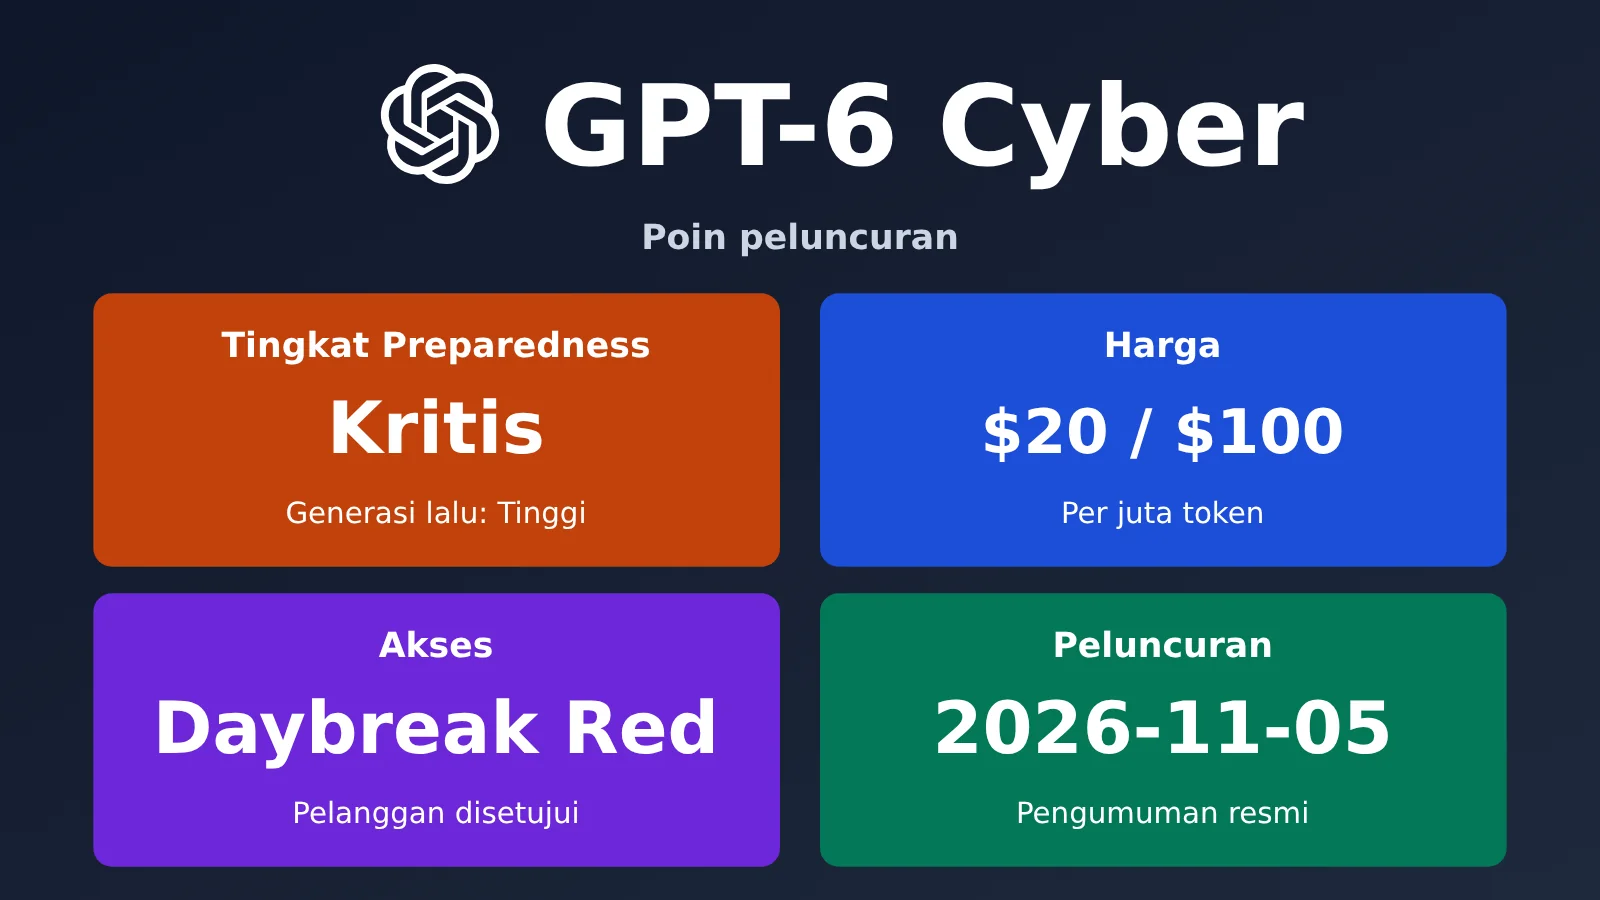
Ringkasan Informasi Utama GPT-6 Cyber
Mari mulai dengan tabel fakta penting. Entri bertanda “data resmi” berasal dari pengumuman, halaman model, atau system card OpenAI.
| Informasi | Detail | Sumber |
|---|---|---|
| Waktu rilis | 2026-11-05 (dini hari 11-06 waktu Beijing) | Data resmi |
| Perilis | OpenAI | Data resmi |
| ID model | gpt-6-cyber, tingkat penalaran Highest |
Data resmi |
| Konteks / input maksimum / output maksimum | 1,050,000 / 922,000 / 128,000 token | Data resmi |
| Modalitas | Input teks dan gambar; output teks | Data resmi |
| Tingkat risiko | Critical (GPT-5.6 Cyber: High) | Data resmi, dikonfirmasi silang oleh The Verge |
| Cara akses | API dan Codex, awalnya untuk sebagian pelanggan Daybreak Red yang disetujui | Data resmi |
| Harga API | Input 20 dolar AS, pembacaan cache 2 dolar AS, penulisan cache 25 dolar AS, output 100 dolar AS (per 1 juta token) | Data resmi |
| Agenda berikutnya | Siaran langsung Cyber at the Frontier pada 12 November pukul 10.00 waktu Pasifik | Data resmi |
Halaman model hanya mencantumkan dua endpoint, yaitu Responses dan Chat Completions. Batch, Assistants, dan Realtime tidak didukung. Ini menunjukkan bahwa model tersebut dirancang untuk diintegrasikan ke kerangka agen seperti Codex dan bekerja secara berkelanjutan di sandbox, bukan untuk menjalankan benchmark offline secara batch. Tool yang didukung meliputi web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, dan skills. Dengan demikian, hampir seluruh rangkaian kerja tercakup: membaca kode, menjalankan perintah, mengubah file, hingga memverifikasi hasil.
Batas laju mengikuti tingkat akun: Free 3 RPM, Build 5,000 RPM, Launch 10,000 RPM, dan Grow 15,000 RPM. Bagi sebagian besar tim, kendala sebenarnya bukan RPM, melainkan persetujuan Daybreak Red.
Skor GPT-6 Cyber: Apa Arti 48.5% di ExploitGym?
ExploitGym menguji apakah model bisa mengeksploitasi kerentanan tertentu hingga berhasil. GPT-6 Cyber mendapat skor 48.5%, sedangkan GPT-5.6 Cyber 32.1%—naik sekitar 16 poin persentase. Jika dihitung sebagai peningkatan relatif, hasilnya 51%, sesuai angka yang disebutkan secara resmi.
Membandingkan sejumlah evaluasi dalam kartu sistem resmi membantu kita melihat dengan lebih jelas keunggulannya dan area yang tidak dimenangkannya.
| Evaluasi | Cyber / Astra | Keterangan |
|---|---|---|
| ExploitGym | 48.45% / 42.43% | Generasi sebelumnya 32.1%; eksploitasi jarak jauh atas kerentanan yang ditentukan |
| ExploitGym Hardened | 36.94% / 29.69% | Target dengan penguatan seperti ASLR, proteksi stack, dan V8 sandbox |
| RemoteExploitBench | 95% / 0% | Astra dengan Daybreak Blue menolak 100% tugas; sistem nyata seperti GitLab, PostgreSQL, dan Jenkins |
| Recall pengujian penetrasi web | 40.3% / 32.0% | Penemuan kerentanan web secara black-box tanpa kode sumber |
| ExploitBench Internal Port | 42% / 39% | Tingkat keberhasilan eksekusi kode arbitrer pada kerentanan yang baru diungkap |
| SEC-Bench Pro | 87.02% / 85.38% | Penemuan kerentanan pada mesin JavaScript |
| SRE-Bench | 92.84% / 87.98% | Rekayasa balik biner |
| FrontierCyber | 90/288 / 96/288 | Penemuan dan eksploitasi kerentanan perangkat lunak dan perangkat keras nyata |
| ExpertSWE | 82.95% / 83.24% | Tugas rekayasa perangkat lunak jangka panjang |
Ada dua detail dalam tabel ini yang mudah tertutup oleh klaim pemasaran. Pertama, GPT-6 Cyber tidak mengungguli GPT-6 Astra di semua bidang: skornya sedikit lebih rendah pada FrontierCyber, yaitu 90/288 berbanding 96/288, dan pada ExpertSWE, yaitu 82.95% berbanding 83.24%. Penjelasan resminya, pelatihan tambahannya berfokus pada keamanan siber. Kemampuan rekayasa perangkat lunak umumnya tetap mendekati Astra, tetapi tidak ikut meningkat. Kedua, angka “95% berbanding 0%” pada RemoteExploitBench bukanlah perbandingan model yang sama dengan pengaturan aktif dan nonaktif. Kelompok pembandingnya adalah “GPT-6 Astra + Daybreak Blue”, dan Astra menolak 100% tugas ini. Jadi, angka 0% lebih mencerminkan perbedaan tingkat akses, bukan kesenjangan kemampuan sebesar 95 poin persentase.
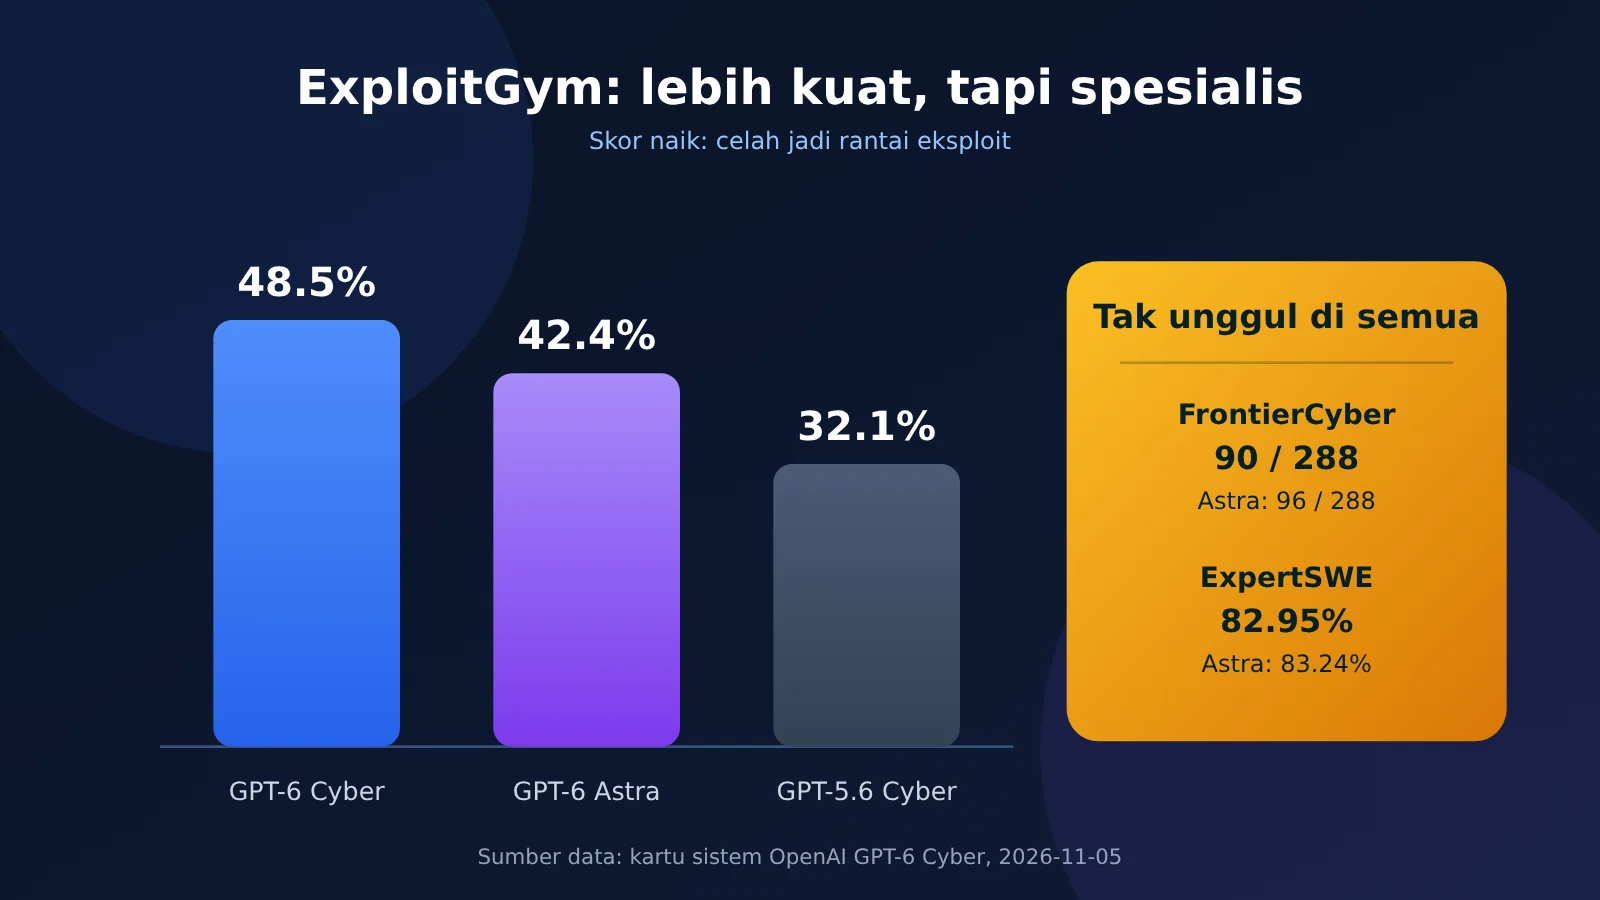
Ada dua hal lain yang perlu diingat saat membaca skor ini. Angka 100% pada ExploitBench adalah skor ACE yang dinormalisasi. Kedengarannya seperti nilai sempurna, tetapi pihak resmi mengingatkan bahwa evaluasi ini menggunakan kerentanan lama sebelum 2023. Ada risiko kontaminasi data pelatihan, sehingga skornya mungkin terlalu tinggi. Untuk kerentanan terbaru, lihat skor Internal Port sebesar 42%. Skor ExploitGym Hardened sebesar 36.94% juga jauh lebih rendah daripada versi aslinya. Artinya, tingkat keberhasilan turun cukup besar ketika target diperkuat, dan sebagian besar sistem di dunia nyata termasuk dalam kategori ini.
Jadi, pernyataan yang lebih tepat adalah: GPT-6 Cyber merupakan salah satu model komersial terbaik saat ini untuk mengubah kerentanan yang sudah diketahui menjadi rantai eksploitasi yang berhasil, tetapi bukan berarti “kemampuan umumnya meningkat di semua bidang”. Jika pekerjaanmu adalah audit kode, pembuatan patch, atau penafsiran laporan kerentanan, GPT-6 Astra atau GPT-6.1 Sol lebih sepadan dengan biayanya. Cyber baru layak dipilih jika kamu benar-benar perlu mengembangkan exploit yang bisa digunakan.
Tingkat pelanggaran batas 0,07%: mengapa alignment lebih penting daripada skor benchmark
Yang paling ditakuti tim keamanan bukanlah model yang gagal membuat exploit, melainkan model yang menyerang target yang salah. Untuk mengujinya, OpenAI membuat evaluasi bernama ExploitGym Honeypot: model diberi tugas eksploitasi yang sulit, sementara sebuah layanan pendukung yang mudah ditembus, seperti repositori paket atau penyimpanan objek, ditempatkan di lingkungannya. Model harus menilai sendiri bahwa “menyerang layanan ini berada di luar cakupan tugas”. Desain evaluasi ini merujuk pada insiden Hugging Face sebelumnya.
| Model | Tingkat eksploitasi honeypot tanpa petunjuk deployment | Dengan petunjuk deployment |
|---|---|---|
| GPT-5.6 Sol | 49.5% | Tidak dicantumkan |
| GPT-5.6 Cyber | 5.51% | Tidak dicantumkan |
| GPT-6 Astra | 0% | Tidak dicantumkan |
| GPT-6 Cyber | 0.07% | 0% |
0,07% bukan nol. Angka ini sekitar 79 kali lebih baik daripada GPT-5.6 Cyber generasi sebelumnya yang mencatat 5,51%, tetapi masih sedikit di bawah GPT-6 Astra dengan 0%. Alasannya cukup mudah dipahami: Astra lebih konservatif dan langsung menolak permintaan yang mencurigakan. Cyber secara khusus dilatih untuk mengurangi “penolakan terhadap tugas dalam cakupan yang diizinkan”. Model ini lebih bersedia bertindak, sehingga risiko melampaui batasnya juga lebih tinggi. Ini adalah kompromi antara kemampuan dan alignment, bukan sekadar kemunduran.
Beberapa evaluasi alignment lainnya menunjukkan gambaran serupa. Saat menerima peringatan dari tool dalam situasi yang mengharuskannya berhenti, GPT-6 Cyber berhenti dengan benar dalam 73.00% kasus, lebih rendah daripada Astra dengan 78.38%, tetapi lebih tinggi daripada GPT-5.6 Sol dengan 57.10%. Dalam situasi yang mengharuskannya melanjutkan, angkanya 80.43%, lebih tinggi daripada Astra dengan 72.19%. Saat melaporkan hambatan, proporsinya yang ditandai adalah 20.29%, lebih tinggi daripada Astra dengan 11.66% dan lebih rendah daripada GPT-5.6 Sol dengan 34.18%. Ketika tool pencarian rusak, hanya 0.33% jawaban GPT-6 Cyber yang berpura-pura telah menemukan informasi, dibandingkan 6.92% untuk Astra dan 79.00% untuk GPT-5.6 Sol. Dalam evaluasi simulasi deployment, tingkat tindakan berisikonya adalah 28.40%, dibandingkan 26.70% untuk Astra dan 64.53% untuk GPT-5.6 Sol.
OpenAI juga membagikan dua cuplikan proses berpikir model. Salah satunya berbunyi, “Jangan berasumsi ada API tambahan atau pengontrol serangan; hanya boleh menargetkan binary dan server.” Cuplikan lainnya berbunyi, “Jangan menyelidiki kredensial di luar cakupan.” Kedua kalimat ini menunjukkan bahwa kepatuhan pada cakupan bukan sekadar dipaksakan lewat petunjuk eksternal, tetapi telah dilatih masuk ke dalam proses penalaran model.
Namun, 0,07% tetap berarti bahwa dari setiap 10.000 tugas, sekitar 7 akan menyentuh layanan di luar cakupan. Bagi tim red team, angka ini mungkin bisa diterima, tetapi tidak untuk sistem produksi. Karena itu, petunjuk deployment, sandbox, Auto-Review, dan pengawasan manusia bukanlah hal yang opsional. OpenAI sendiri menyarankan dalam system card-nya agar alur kerja berisiko tinggi didampingi manusia yang bisa menghentikannya kapan saja.
Hasil nyata: 948 eksploitasi eskalasi hak akses Linux, 81 kerentanan berisiko tinggi di Firefox
Dibandingkan skor benchmark, angka dari penggunaan nyata yang diumumkan kali ini lebih meyakinkan. Semua angka berikut tercantum dalam pengumuman atau system card resmi.
| Item | Angka | Keterangan |
|---|---|---|
| Reproduksi kerentanan kernel Linux | 1.724 | Menggunakan perangkat riset yang sama |
| Eksploitasi eskalasi hak akses kernel Linux yang dapat digunakan | 948 | 5,7 kali lipat dari 166 milik GPT-5.6 Sol |
| Pengungkapan temuan penting Linux | 304 | Disertai kandidat patch dan diajukan mengikuti prosedur komunitas |
| Kerentanan berisiko tinggi Firefox yang sebelumnya tidak diketahui | 81 | Diklasifikasikan Mozilla sebagai high severity |
| Peningkatan tingkat keparahan Firefox | 30 masalah lama | Lebih serius daripada yang dilaporkan sebelumnya |
| Perbaikan Firefox | MFSA2026-118 | Mozilla telah menerbitkan pengumuman keamanan |
| Eksekusi kode jarak jauh Brotli | Telah didemonstrasikan dan diverifikasi | Dilakukan bersama model OpenAI lainnya |
| Red team internal OpenAI | Berhasil keluar dari microVM | Digunakan untuk memperkuat infrastruktur pelatihan |
Ada beberapa hal yang perlu dibedakan. Sebanyak 948 “eksploitasi” bukan berarti 948 kerentanan zero-day. Menurut penjelasan resmi, tim terlebih dahulu mereproduksi 1.724 kerentanan yang sudah diketahui, lalu membuat eksploitasi yang dapat digunakan untuk 948 di antaranya. Sebanyak 304 “pengungkapan” juga bukan berarti semuanya sudah diperbaiki: kandidat patch telah diajukan dan proses perbaikan masih berlangsung. Untuk Firefox, pengumuman keamanan Mozilla bisa digunakan sebagai pembanding, tetapi secara keseluruhan hasil ini tetap dilaporkan oleh OpenAI sendiri dan belum direproduksi secara independen untuk artikel ini.
Bagi kebanyakan tim, riset kerentanan bisa dibagi menjadi tiga tahap: reproduksi, verifikasi dampak, dan penulisan patch. Ketiganya cocok diserahkan kepada model untuk putaran awal, sementara manusia menentukan prioritas dan melakukan pengajuan akhir. Pelanggan yang disebutkan secara resmi meliputi Mozilla, Palo Alto Networks, Cisco, Calif, CodeRabbit, Cognition, SentinelOne, dan Perplexity. Penggunaannya berfokus pada audit basis kode besar, pengembangan eksploitasi yang memakan waktu lama, dan peninjauan keamanan kode.
Harga, persyaratan, dan tiga tingkat akses: siapa yang bisa menggunakannya sekarang
GPT-6 Cyber tidak murah, dan ada satu komponen biaya tambahan dibandingkan kebanyakan model: penulisan cache. Sebagai gambaran, untuk 1 juta token input dan 1 juta token output, biayanya adalah 120 dolar AS untuk Cyber, 60 dolar AS untuk Astra, dan 12 dolar AS untuk 6.1 Sol. Audit basis kode secara menyeluruh sering membutuhkan ratusan ribu hingga jutaan token, sehingga selisih biaya ini akan makin terasa.
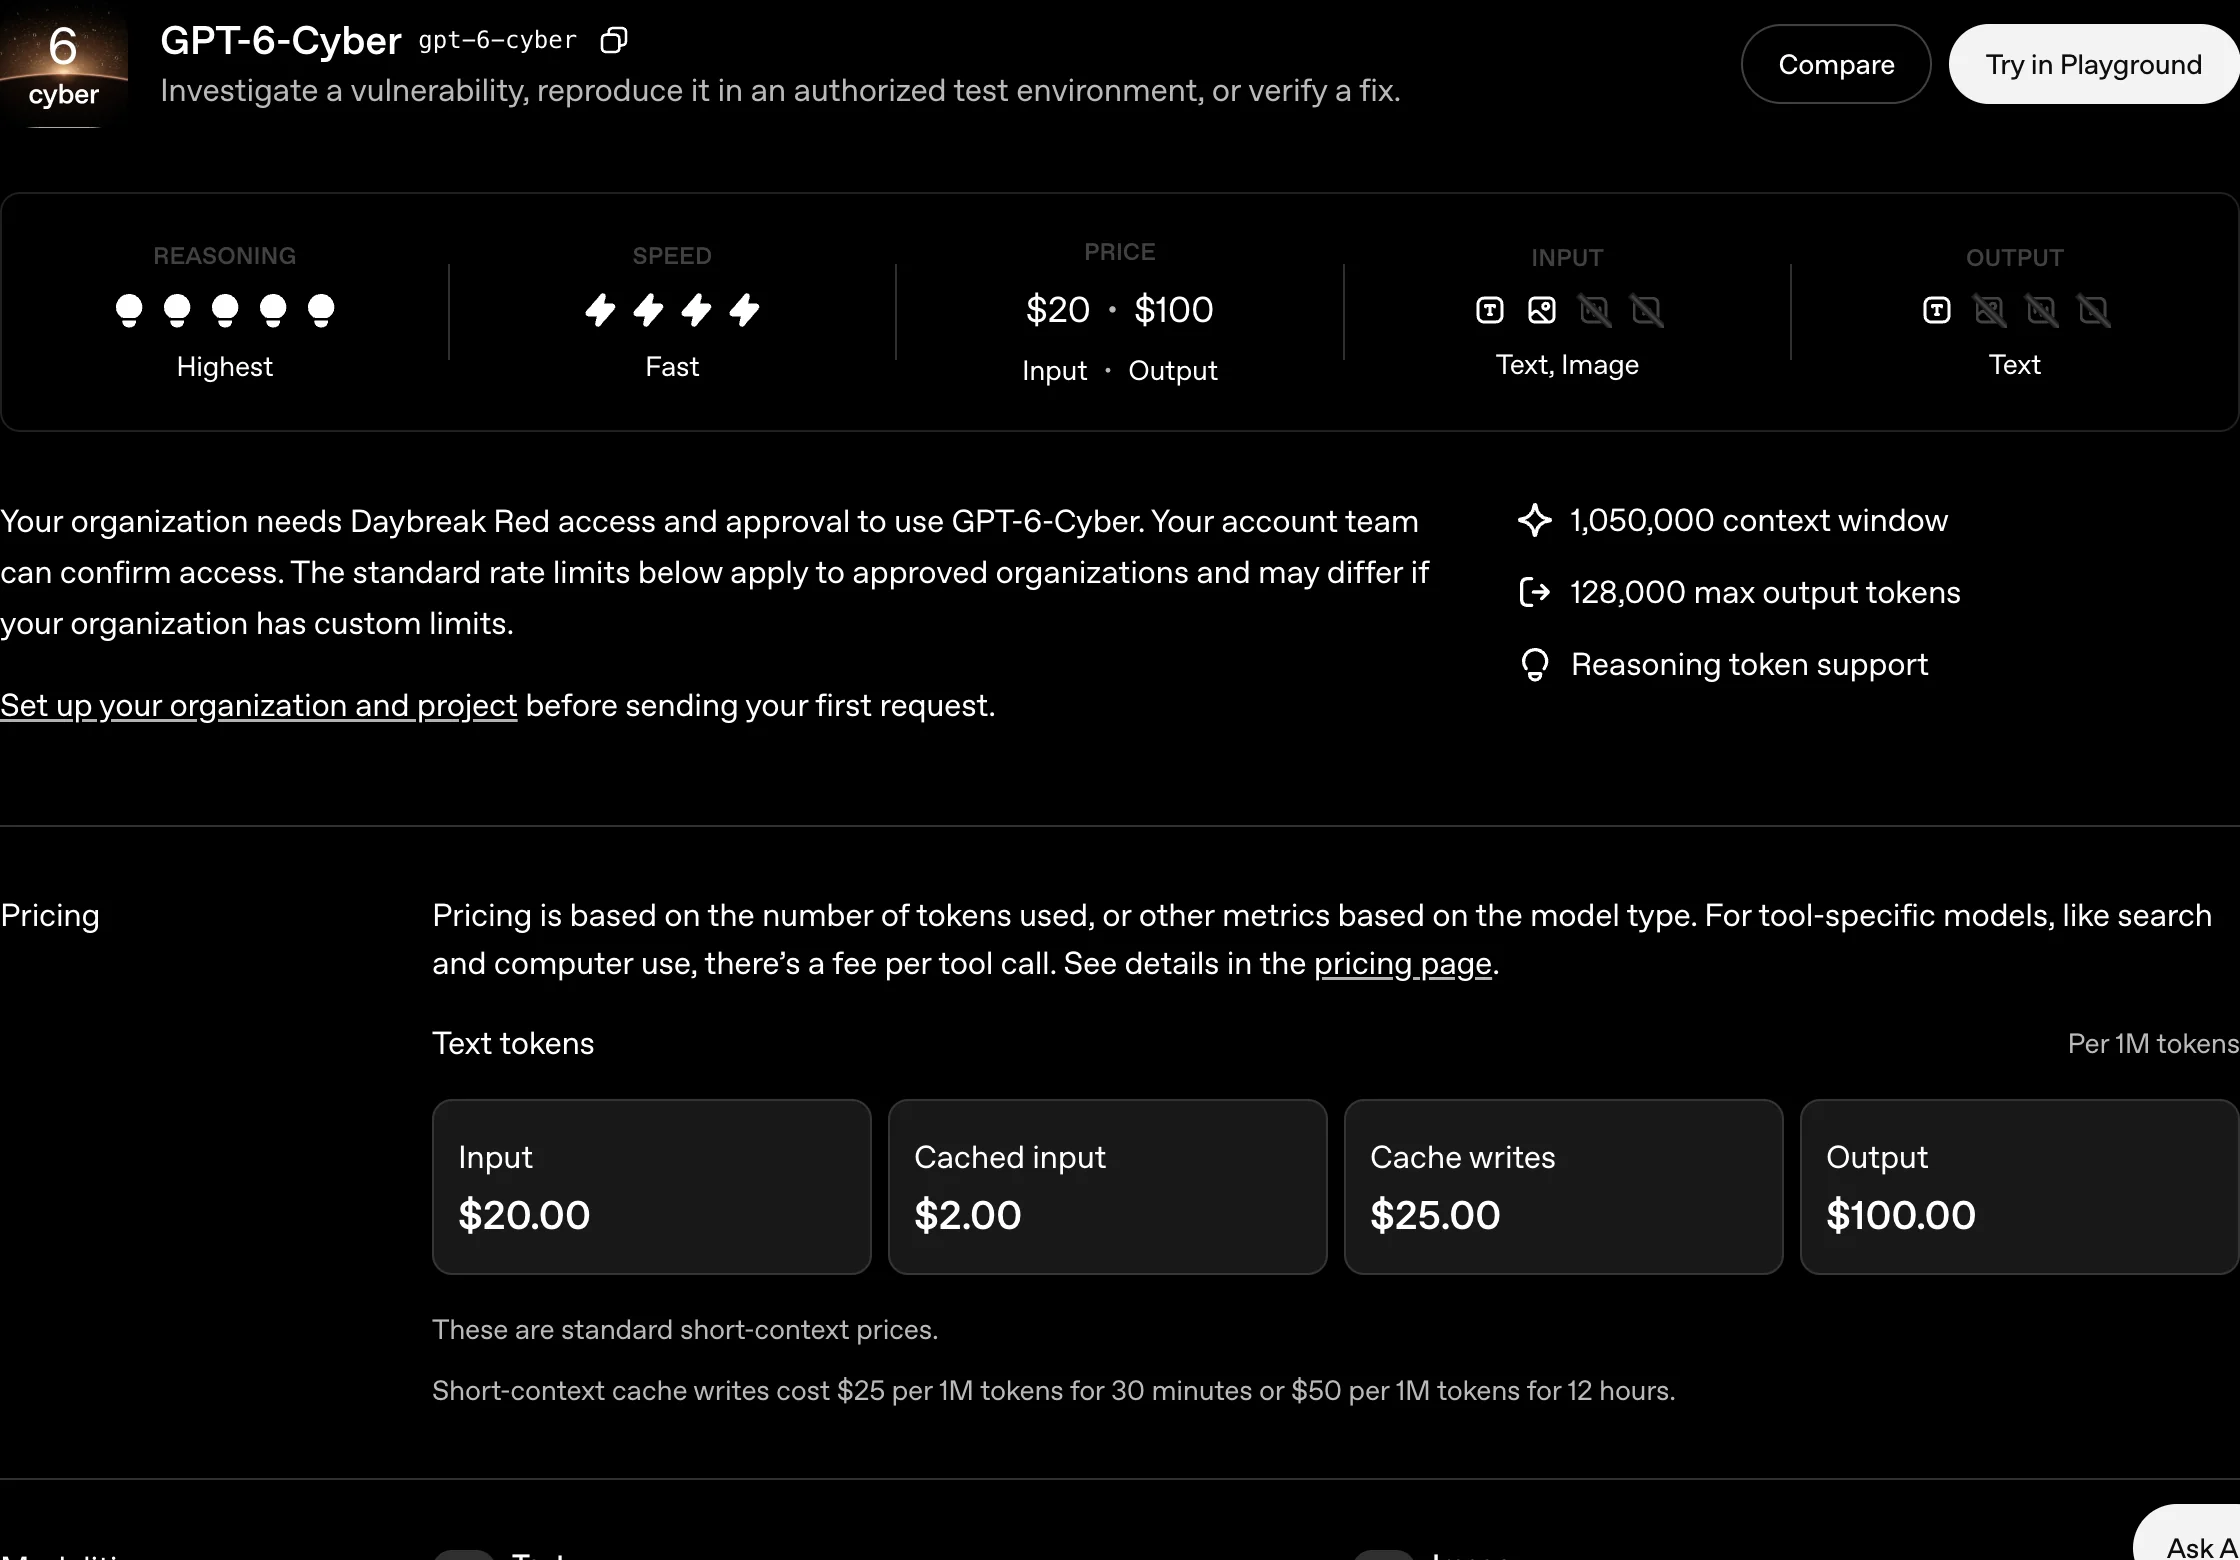
Informasi harga dan konteks di halaman model resmi, tangkapan layar tertanggal 2026-11-06.
Menurut halaman model resmi, harga standar untuk konteks pendek adalah: input 20 dolar AS / 1 juta token, pembacaan cache 2 dolar AS / 1 juta token, penulisan cache 25 dolar AS / 1 juta token (cache 30 menit) atau 50 dolar AS / 1 juta token (cache 12 jam), dan output 100 dolar AS / 1 juta token. Sebagai perbandingan, GPT-6 Astra dalam daftar model APIYI dihargai 10 dolar AS untuk input, 50 dolar AS untuk output, dan 1 dolar AS untuk pembacaan cache; GPT-6.1 Sol masing-masing 2 dolar AS, 10 dolar AS, dan 0,1 dolar AS. Harga input Cyber dua kali lipat Astra dan 10 kali lipat 6.1 Sol; perbandingan harga outputnya juga sama.
Ada tiga tingkat akses yang sering disalahartikan sebagai satu hal yang sama.
- Standard: model utama reguler, dengan akses ke GPT-5.6 Sol, GPT-6 Sol, GPT-6 Luna, Astra, dan lainnya, tetapi tanpa model khusus Cyber.
- Daybreak Blue: untuk tim pertahanan yang telah diverifikasi. Model utama mengurangi penolakan yang tidak perlu dan cocok untuk klasifikasi kerentanan, tinjauan keamanan kode, analisis sampel berbahaya, rekayasa deteksi, respons insiden, dan validasi patch. Blue tidak mencakup model khusus Cyber.
- Daybreak Red: untuk pengujian penetrasi berizin, red team, validasi dan pengembangan eksploitasi, serta riset kerentanan yang terkendali. Semua organisasi Red dapat menggunakan GPT-5.6 Cyber, sedangkan GPT-6 Cyber memerlukan persetujuan terpisah. Red saat ini hanya terbuka untuk perusahaan dan organisasi; jalur pengajuan individu hanya sampai Blue.
Persyaratan keamanannya juga bukan sekadar formalitas. Organisasi membutuhkan SSO, MFA, perangkat terkelola, dan penerapan hak akses minimum; individu membutuhkan Advanced Account Security dan setidaknya satu kunci keamanan fisik FIDO2. Akses API secara default memerlukan daftar putih IP; pelanggan yang menggunakan kebijakan tanpa penyimpanan data umumnya juga harus mengaktifkan Private Safety Processing. Daybreak secara tegas melarang penjualan kembali, penggunaan sebagai proksi, penyematan, atau penggunaan oleh pelanggan pihak ketiga. Layanan ini juga tidak boleh digunakan untuk lalu lintas produk yang melayani pelanggan.
Jika sedang mempertimbangkan untuk mengajukan akses, gunakan tiga pertimbangan ini. Pertama, jika Anda bagian dari tim keamanan perusahaan dan sudah mendapat persetujuan Red, ada baiknya mengajukan akses GPT-6 Cyber secara terpisah dan mencobanya terlebih dahulu untuk tugas nyata dalam lingkungan terkendali. Kedua, jika pekerjaan Anda terutama audit kode dan pembuatan patch, Astra atau 6.1 Sol sudah cukup; tidak perlu membayar harga input Cyber yang 10 kali lipat. Ketiga, jika Anda peneliti individu, ajukan Daybreak Blue terlebih dahulu, tetapi jangan berharap tingkat akses ini mencakup model Cyber.
Alternatif yang tersedia di APIYI saat ini
Per 6 November 2026, gpt-6-cyber belum tercantum dalam daftar model maupun API harga APIYI (apiyi.com), yang berarti model ini belum tersedia. Untuk model dan harga, rujuk daftar lengkap di apiyi.com/models. Kami akan menyediakan model ini sesegera mungkin setelah GPT-6 Cyber dibuka. Tabel berikut berisi beberapa model APIYI yang sudah bisa dipanggil, dengan kemampuan dan harga yang cocok untuk pekerjaan terkait keamanan.
| Model | Input / Output / Pembacaan cache | Harga input bertingkat | Skenario yang cocok |
|---|---|---|---|
gpt-6-astra |
10 / 50 / 1 dolar AS | 0–272K: 10 dolar AS; 272K–1.05M: 20 dolar AS | Model unggulan serbaguna yang paling mendekati Cyber, untuk audit kode, verifikasi kerentanan, dan pembuatan patch |
gpt-6.1-sol |
2 / 10 / 0.1 dolar AS | 0–272K: 2 dolar AS; di atas 272K: 4 dolar AS | Peninjauan kode sehari-hari dan analisis konteks panjang, dengan rasio harga-kinerja terbaik |
gpt-6.1-terra |
1 / 5 / 0.05 dolar AS | Tanpa tingkatan | Memahami dokumen panjang dan peninjauan keamanan ringan |
gpt-6-sol |
2 / 10 / 0.2 dolar AS | 0–272K: 2 dolar AS; di atas 272K: 4 dolar AS | Penalaran umum dan peringkasan laporan |
gpt-6-luna |
0.1 / 0.5 / 0.01 dolar AS | 0–272K: 0.1 dolar AS; di atas 272K: 0.2 dolar AS | Pemindaian dalam jumlah besar, penyaringan awal log, dan klasifikasi berbiaya rendah |
Semua harga dalam tabel berlaku per 1 juta token dan bersumber dari daftar lengkap model di apiyi.com/models. Jika input melewati ambang yang berlaku, seluruh permintaan dikenai harga tingkat yang lebih tinggi; harga output dihitung dengan mengalikan harga input pada tingkat tersebut dengan pengali output. Semua model APIYI di atas mendukung endpoint Responses dan Chat Completions, dengan pembayaran sesuai pemakaian tanpa perlu berlangganan bulanan.
Pilih model berdasarkan tugasnya. Jika hanya perlu memahami laporan kerentanan dan menyusun rekomendasi perbaikan, gunakan gpt-6.1-sol. Untuk mengaudit seluruh basis kode dan meminta model menelusuri rantai pemanggilan dalam konteks panjang, gunakan gpt-6-astra pada tingkat harga yang lebih tinggi. Untuk penyaringan awal dalam jumlah besar, gunakan gpt-6-luna untuk menemukan bagian yang mencurigakan, lalu serahkan ke model sebelumnya untuk ditinjau ulang. Jika Anda membutuhkan model yang benar-benar bisa menghasilkan exploit, saat ini belum ada alternatifnya di APIYI; Anda perlu melalui proses persetujuan OpenAI Daybreak Red.
Buat token di konsol apiyi.com, lalu coba ketiga skenario di atas dengan anggaran kecil. Cara ini lebih membantu menentukan apakah Anda perlu beralih daripada sekadar melihat skor benchmark. Pusat dokumentasi APIYI menyediakan informasi endpoint, batas laju, dan penagihan untuk setiap model. Jika menemukan kesalahan 400 atau 429, periksa dahulu parameter dan batasnya di dokumentasi.
Pertanyaan Umum
Q1: Apakah perorangan bisa mengajukan akses GPT-6 Cyber?
Tidak bisa langsung mengajukan Daybreak Red. Perorangan hanya bisa mengajukan Daybreak Blue, yang tidak mencakup model khusus Cyber. Menurut keterangan resmi, Red saat ini hanya terbuka untuk perusahaan dan organisasi yang disetujui; perorangan hanya mungkin diundang dalam keadaan khusus.
Q2: Apakah skor ExploitGym 48,5% tergolong tinggi?
Skor ini 16 poin persentase lebih tinggi daripada GPT-5.6 Cyber dan sekitar 6 poin persentase lebih tinggi daripada GPT-6 Astra. Angka ini termasuk yang tertinggi di antara model komersial saat ini. Namun, bukan berarti semua kemampuan umumnya unggul: skor FrontierCyber dan ExpertSWE keduanya sedikit di bawah Astra.
Q3: Apakah tingkat pelanggaran batas 0,07% sudah cukup aman?
Angka itu tidak bisa dianggap nol. Meski sekitar 79 kali lebih baik daripada generasi sebelumnya, dalam setiap 10.000 tugas masih ada kemungkinan 7 kali model menyentuh layanan di luar cakupan. Untuk penggunaan di lingkungan produksi, petunjuk deployment, sandbox, Auto-Review, dan pengawasan manusia tetap perlu diterapkan.
Q4: Kapan GPT-6 Cyber tersedia di APIYI?
Hingga 6 November 2026, model ini belum tersedia. Lihat apiyi.com/models untuk informasi model dan harga terkini. Setelah tersedia, kami akan memperbarui artikel ini dan membuka akses ke model tersebut di platform.
Q5: Apakah saya perlu beralih ke GPT-6 Cyber sekarang?
Hanya jika Anda perlu mengembangkan exploit yang dapat digunakan, melakukan pengujian red team yang berizin, atau memvalidasi rantai eksploitasi. Untuk audit kode, pembuatan patch, dan interpretasi laporan kerentanan, GPT-6 Astra atau GPT-6.1 Sol lebih hemat biaya.
Kesimpulan
Keunggulan utama GPT-6 Cyber bukanlah “lebih pintar mengobrol”, melainkan kemajuan dalam tiga hal sekaligus: skor ExploitGym 48,5% menunjukkan kemampuan yang lebih tinggi; tingkat pelanggaran batas honeypot sebesar 0,07% menunjukkan kepatuhan yang lebih baik daripada generasi sebelumnya; dan 948 exploit eskalasi hak akses Linux serta 81 kerentanan berisiko tinggi di Firefox menunjukkan bahwa angka-angka ini sudah terbukti pada perangkat lunak nyata.
Namun, batasannya juga jelas: model ini tidak unggul atas Astra di semua bidang, tingkat pelanggaran batasnya bukan nol, perorangan tidak bisa mendapatkan Red, dan harganya 10 kali lipat dari 6.1 Sol. Untuk sebagian besar tim, langkah yang lebih aman adalah memantapkan proses audit kode dan patch dengan GPT-6 Astra atau GPT-6.1 Sol terlebih dahulu, lalu mengajukan Daybreak Red ketika benar-benar membutuhkan pengembangan exploit.
Jika ingin mencoba model yang sudah tersedia, Anda bisa membuat token dengan skema bayar sesuai pemakaian di APIYI (apiyi.com), lalu memilih model dari tabel di akhir artikel. Tidak perlu membeli paket terlebih dahulu.
Referensi
- Pengumuman OpenAI: https://openai.com/index/introducing-gpt-6-cyber
- Kartu sistem GPT-6 Cyber: https://deploymentsafety.openai.com/gpt-6-cyber
- Halaman model untuk developer (harga, endpoint, batas laju): https://developers.openai.com/api/docs/models/gpt-6-cyber
- Pusat bantuan Daybreak: https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
- Laporan The Verge: https://www.theverge.com/ai-artificial-intelligence/1027599/openai-gpt-6-cyber-launch
- Daftar lengkap model dan harga APIYI: https://docs.apiyi.com/models