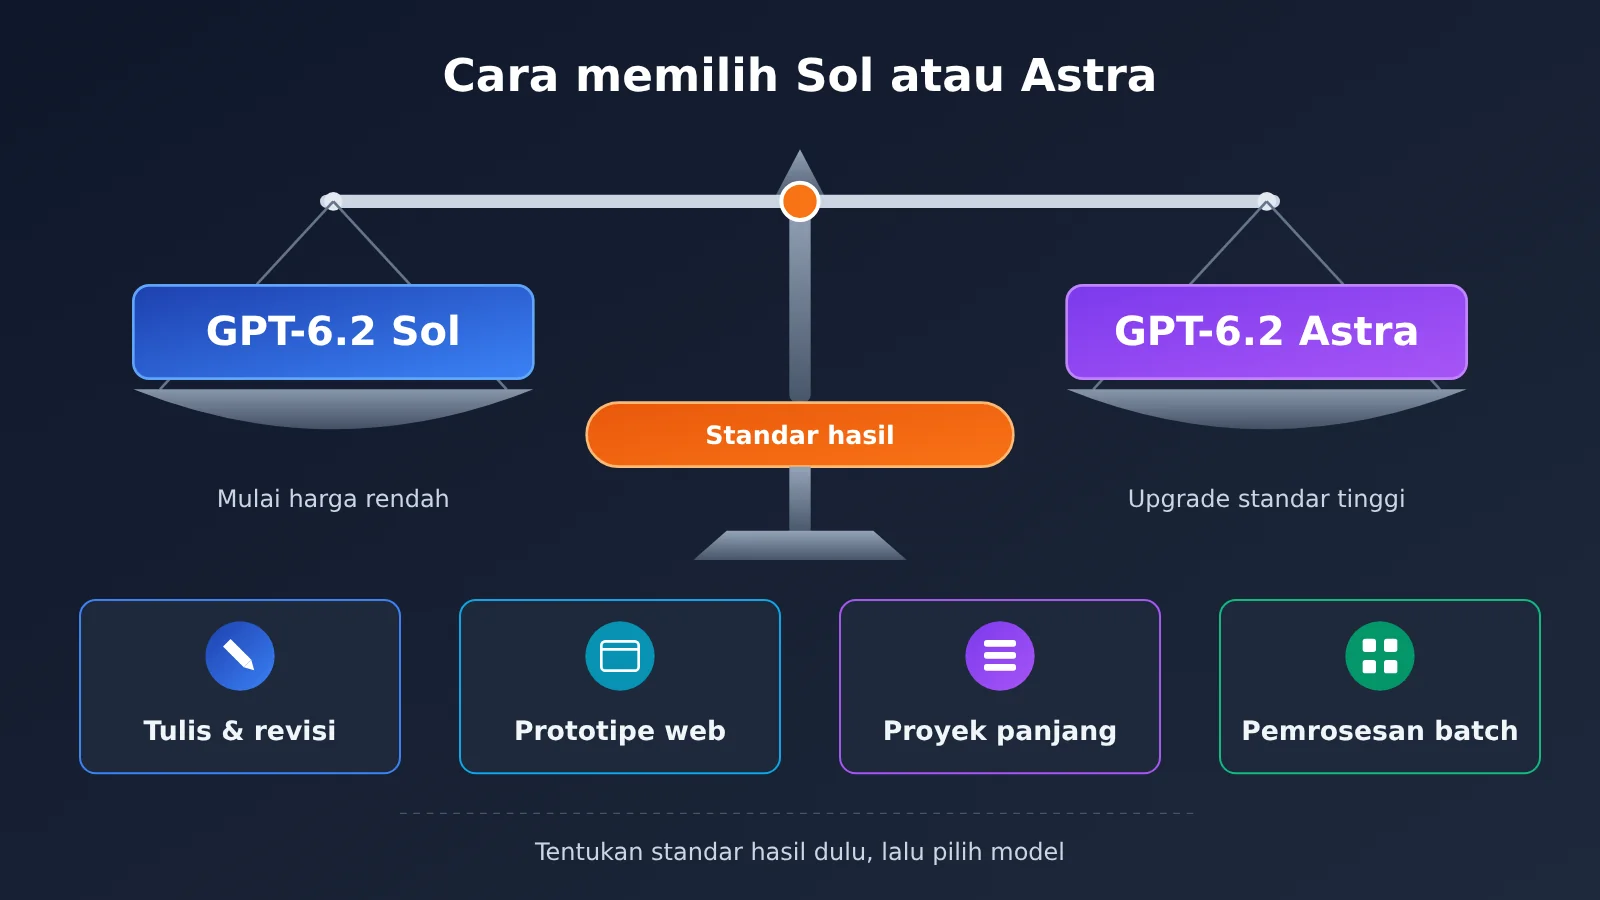
Jawaban langsung: Untuk sebagian besar tugas penulisan sehari-hari, prototipe halaman web, dan tugas pemrosesan batch, mulailah dengan GPT-6.2 Sol; hanya ketika keluaran Sol tidak memenuhi standar pengiriman yang telah Anda tetapkan sebelumnya, atau ketika biaya rework sudah melebihi selisih harga, barulah beralih ke GPT-6.2 Astra. Harga resmi API keduanya berbeda 4 kali lipat. Evaluasi resmi menunjukkan bahwa pada sebagian tugas, selisih keduanya tidak besar, tetapi hasil ini hanya berlaku untuk evaluasi tertentu dan tidak bisa langsung dijadikan kesimpulan umum. Jadi, kunci pilihan ini bukanlah model mana yang lebih kuat, melainkan seberapa tinggi standar pengiriman yang dibutuhkan tugas Anda.
Rekomendasi di atas adalah saran editorial, bukan panduan pemilihan model resmi dari OpenAI, dan juga bukan kesimpulan dari pengujian kami sendiri. Data evaluasi yang dikutip dalam artikel ini semuanya berasal dari laporan resmi OpenAI.
Apa yang bisa Anda pelajari dari artikel ini?
- Waktu rilis, cakupan ketersediaan, kemampuan input-output, dan harga resmi API GPT-6.2 Sol serta Astra.
- Angka mana dalam evaluasi resmi yang bisa menjelaskan masalah, dan angka mana yang tidak bisa digeneralisasi.
- Dari model mana harus mulai untuk 4 jenis skenario: penulisan dan revisi sehari-hari, prototipe halaman web, proyek panjang yang kompleks, serta pemrosesan batch yang sensitif terhadap anggaran; kapan harus beralih ke Astra, dan bagian mana yang wajib diperiksa manusia.
- Satu tabel pencatatan uji A/B yang bisa langsung disalin dan digunakan, untuk membandingkan akurasi fakta, kegunaan, jumlah putaran rework, dan total biaya.
Indeks: Mulailah dengan tabel konsep “To Know” dan ringkasan dampak untuk memahami istilah serta makna rilis ini bagi berbagai kelompok pengguna. Bagian 1 merangkum fakta objektif, termasuk informasi rilis, evaluasi resmi, dan aturan harga. Bagian 2 adalah analisis dan penilaian editorial, yang menyajikan tabel keputusan per skenario, metode estimasi biaya, serta alur uji A/B, dan diakhiri dengan tautan sumber.
Untuk Diketahui: Konsep Terkait GPT-6.2 Sol dan Astra
| Konsep | Penjelasan Singkat |
|---|---|
| GPT-6.2 Astra | Model dengan posisi lebih tinggi dan harga lebih mahal dalam seri GPT-6.2 yang dirilis OpenAI pada 17 November 2026 |
| GPT-6.2 Sol | Model lain yang dirilis pada hari yang sama, dengan harga resmi API sekitar seperempat dari Astra |
| GDPval v2 | Salah satu evaluasi yang digunakan dalam laporan resmi OpenAI; artikel ini hanya mengutip besaran peningkatan yang diberikan resmi |
| ALE (Agents’ Last Exam) | Mengevaluasi alur kerja profesional multi-langkah; besaran peningkatan dalam artikel ini menggunakan GPT-6 Astra sebagai basis dan tidak dicampur dengan GDPval v2 |
| FrontierCode 2.0 | Evaluasi kategori pemrograman dalam laporan resmi; perbandingan biaya yang dikutip artikel ini hanya berlaku dalam pengujian ini |
| Tingkat penalaran max | Tingkat tertinggi dalam pengaturan intensitas penalaran model, biasanya berarti lebih banyak pemikiran dan biaya lebih tinggi |
| Poin persentase | Selisih antara dua persentase, misalnya dari 50% ke 56,2% berarti peningkatan 6,2 poin persentase |
| Pembacaan cache | Konten input yang digunakan berulang kali yang mengenai cache akan ditagih dengan tarif satuan yang lebih rendah |
| Penulisan cache | Biaya yang timbul saat menulis konten ke cache; keterangan resmi menyatakan bahwa ini dikenakan biaya tambahan |
| Ambang 272K | Setelah input satu permintaan melebihi sekitar 272 ribu token, seluruh permintaan akan ditagih dengan pengali yang lebih tinggi |
| Standar penyerahan | Prasyarat pemilihan yang diajukan editor: menuliskan terlebih dahulu “sampai sejauh mana hasilnya dianggap layak pakai” |
Sekilas Dampak GPT-6.2 Sol dan Astra
- Pengguna ChatGPT biasa: Dokumentasi bantuan resmi menunjukkan bahwa putaran ini terutama dibuka secara bertahap untuk ChatGPT Work dan Codex, sedangkan Chat biasa tidak termasuk dalam cakupan peluncuran kali ini, jadi dalam jangka pendek Anda mungkin belum merasakan perubahan.
- Pengembang dan tim kecil: Kedua model akan dibuka secara bertahap melalui API. Karena selisih harga satuan mencapai 4 kali, strategi perutean model akan langsung memengaruhi tagihan, jadi layak dirancang sejak awal.
- Pembuat konten: Input kedua model adalah teks dan gambar, dengan output berupa teks; keduanya tidak memiliki kemampuan pembuatan video asli, sehingga tidak bisa menggantikan alat pembuat video.
- Pengguna pemrosesan batch yang sensitif terhadap anggaran: Aturan pengganda setelah input panjang melewati 272K sangat berdampak pada biaya pemrosesan dokumen panjang dalam jumlah besar, dan ini lebih penting daripada sekadar membandingkan harga satuan.
1. Fakta Objektif GPT-6.2 Sol dan Astra
Bagian ini hanya merangkum informasi publik resmi dari OpenAI, tanpa menyertakan penilaian editorial. Tanggal verifikasi adalah 18 November 2026.
1.1 Peluncuran dan Cakupan Ketersediaan GPT-6.2 Sol dan Astra
OpenAI pada 17 November 2026 secara bersamaan merilis GPT-6.2 Astra dan GPT-6.2 Sol. Menurut penjelasan resmi, kedua model akan dibuka secara bertahap untuk ChatGPT Work, Codex, dan API; Chat biasa tidak termasuk dalam cakupan peluncuran gelombang ini. “Dibuka secara bertahap” berarti waktu akses untuk tiap akun bisa berbeda, dan detailnya mengikuti dokumentasi bantuan resmi.
Dari sisi bentuk kemampuannya, kedua model mendukung input teks dan gambar, dengan output berupa teks. Materi resmi tidak menyebutkan kemampuan pembuatan video native. Jika kebutuhan Anda adalah membuat video, peluncuran ini belum bisa langsung memenuhinya.
1.2 Data Evaluasi Resmi GPT-6.2 Sol dan Astra
Tabel berikut merangkum kesimpulan evaluasi dalam laporan resmi. Perhatikan bahwa setiap baris adalah evaluasi independen dan baseline pembandingnya juga berbeda, sehingga angka dari baris berbeda tidak boleh dibandingkan secara horizontal.
| Evaluasi | Objek | Hasil laporan resmi | Batasan penggunaan |
|---|---|---|---|
| GDPval v2 | GPT-6.2 Astra | Meningkat 6.2 poin persentase dibandingkan GPT-6 Astra, dengan token keluaran berkurang 22% | Baseline pembanding adalah Astra generasi sebelumnya |
| GDPval v2 | GPT-6.2 Sol | Meningkat 5.3 poin persentase dibandingkan GPT-6.1 Sol | Baseline pembanding adalah GPT-6.1 Sol, berbeda dari baseline Astra |
| ALE | GPT-6.2 Astra | Meningkat 5.2 poin dibandingkan GPT-6 Astra | Satuannya adalah “poin”, tidak boleh dicampur dengan “poin persentase” dari GDPval |
| FrontierCode 2.0 | Sol vs Astra | Saat keduanya berada di tingkat penalaran max, selisih antara Sol dan Astra berada dalam 0.5 poin, dan biaya tugas sekitar 1/5 dari Astra | Hanya berlaku pada pengujian dan tingkat penalaran tersebut, bukan kesimpulan biaya yang berlaku umum |
Semua data di atas berasal dari laporan resmi OpenAI, bukan hasil pengujian tim ini. Mengenai penurunan token keluaran Astra sebesar 22%, angka ini diberikan dalam konteks GDPval v2; apakah dapat digeneralisasi ke tugas spesifik Anda perlu diverifikasi sendiri.
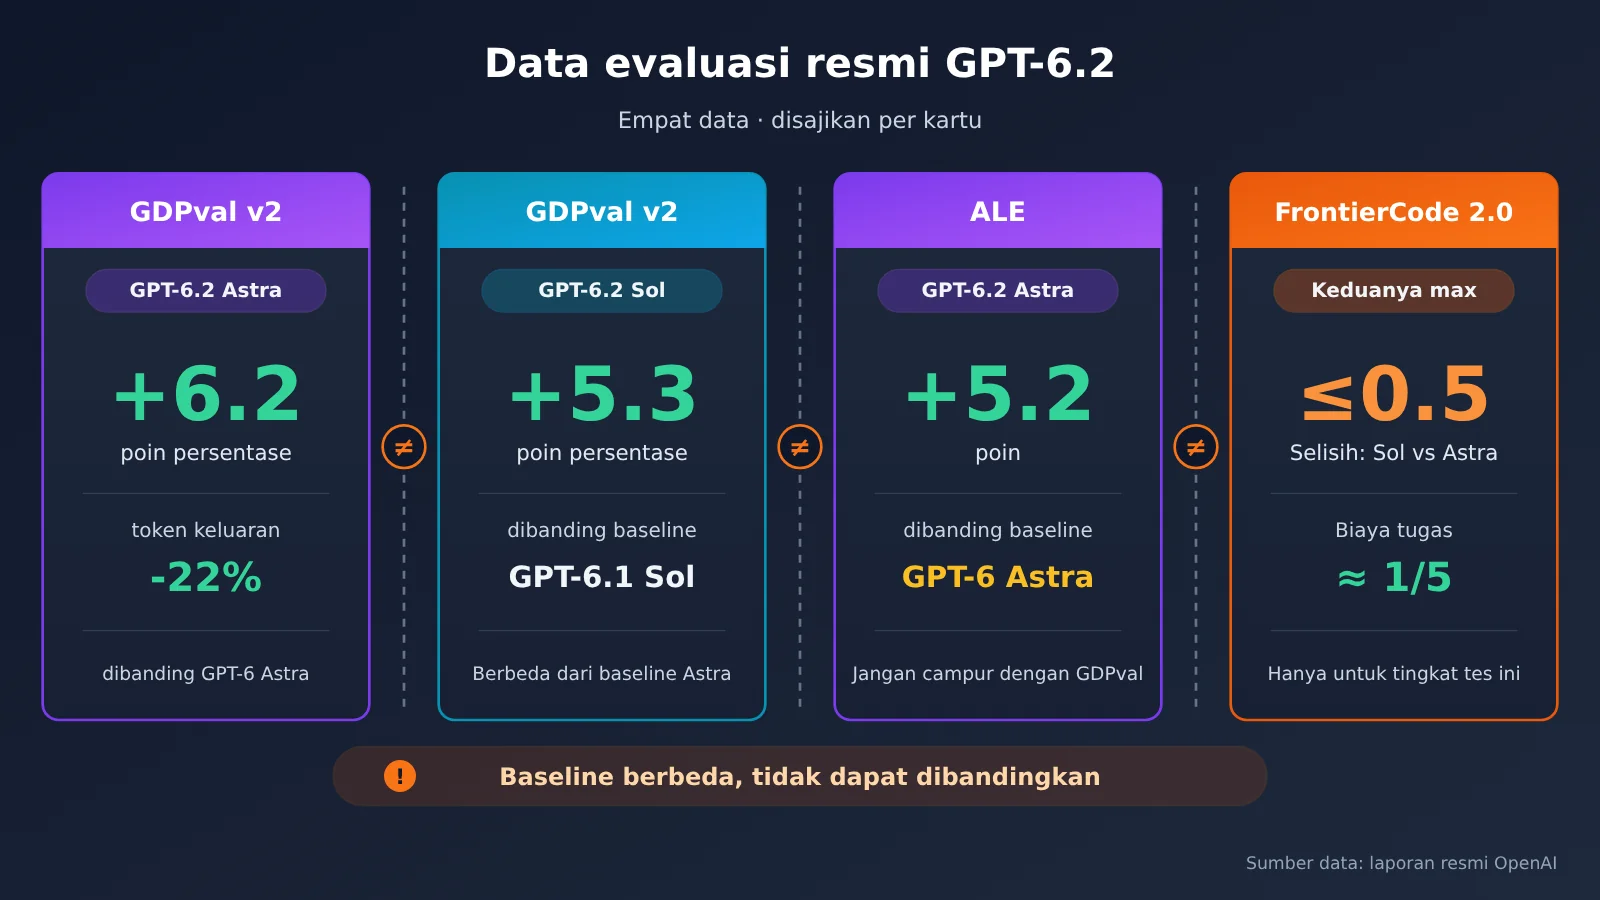
Gambar di atas memecah 4 evaluasi menjadi kartu-kartu terpisah agar pembaca tidak keliru membandingkan angka dari baseline yang berbeda. Jika Anda ingin membuat perbandingan pada data bisnis Anda sendiri, Anda dapat mencatat hasilnya mengikuti templat di bagian 2.4, lalu beralih model dalam kode yang sama melalui antarmuka kompatibel OpenAI seperti APIYI apiyi.com.
1.3 Aturan harga API resmi GPT-6.2 Sol dan Astra
Berikut adalah harga API standar resmi, dalam dolar AS per juta token:
| Item penagihan | GPT-6.2 Astra | GPT-6.2 Sol | Keterangan |
|---|---|---|---|
| Input non-cache | $8 | $2 | Sol adalah 1/4 dari Astra |
| Pembacaan cache | $0.4 | $0.1 | Harga satuan input setelah cache ditemukan (cache hit) |
| Output | $40 | $10 | Sol adalah 1/4 dari Astra |
| Penulisan cache | Dikenakan biaya terpisah | Dikenakan biaya terpisah | Rincian sesuai halaman model resmi |
| Input melebihi 272K | Tarif input dan cache seluruh permintaan ×2, output ×1.5 | Sama seperti di kiri | Dihitung untuk seluruh permintaan, bukan hanya bagian yang melebihi |
Baris terakhir perlu diperhatikan secara khusus. Setelah melewati ambang 272K, pengali berlaku untuk seluruh permintaan, bukan hanya bagian token yang melebihi ambang tersebut. Untuk tugas yang perlu memasukkan banyak dokumen panjang, aturan ini harus dihitung terpisah dalam anggaran, dan jangan hanya melihat harga satuan dasar.
💡 Keterangan harga: Tabel di atas adalah harga standar API resmi OpenAI. Harga dan ketersediaan platform pihak ketiga perlu diverifikasi secara terpisah. Artikel ini tidak memverifikasi status peluncuran kedua model ini di APIYI apiyi.com, mohon mengacu pada daftar model platform.
2. Cara memilih GPT-6.2 Sol dan Astra: analisis serta pertimbangan editor
Konten berikut merupakan inferensi dan saran editor berdasarkan fakta di Bagian 1, bukan mewakili pandangan resmi OpenAI, dan belum kami verifikasi melalui pengujian sendiri.
2.1 Tentukan dulu standar hasil, baru pilih GPT-6.2 Sol atau Astra
Banyak orang saat memilih model langsung bertanya “mana yang lebih kuat”. Namun data resmi FrontierCode 2.0 menunjukkan sudut pandang lain: dalam pengujian ini, ketika keduanya berada pada tingkat penalaran max, selisih Sol dan Astra berada dalam 0.5 poin, tetapi biaya tugas hanya sekitar 1/5. Meskipun kesimpulan ini tidak bisa digeneralisasi, itu cukup menunjukkan bahwa manfaat dari “lebih kuat” mungkin kecil, sementara selisih biaya bisa besar.
Jadi, editor menyarankan agar sebelum memilih model, jawab tiga pertanyaan: siapa yang akan menggunakan hasil ini? seberapa besar biaya jika terjadi kesalahan? berapa putaran revisi yang bisa diterima? Semakin jelas jawabannya, semakin mudah menilai apakah Sol sudah cukup. Jika standar hasil tidak ditulis dengan jelas, beralih ke Astra hanya akan mengulang uji coba dengan cara yang lebih mahal.
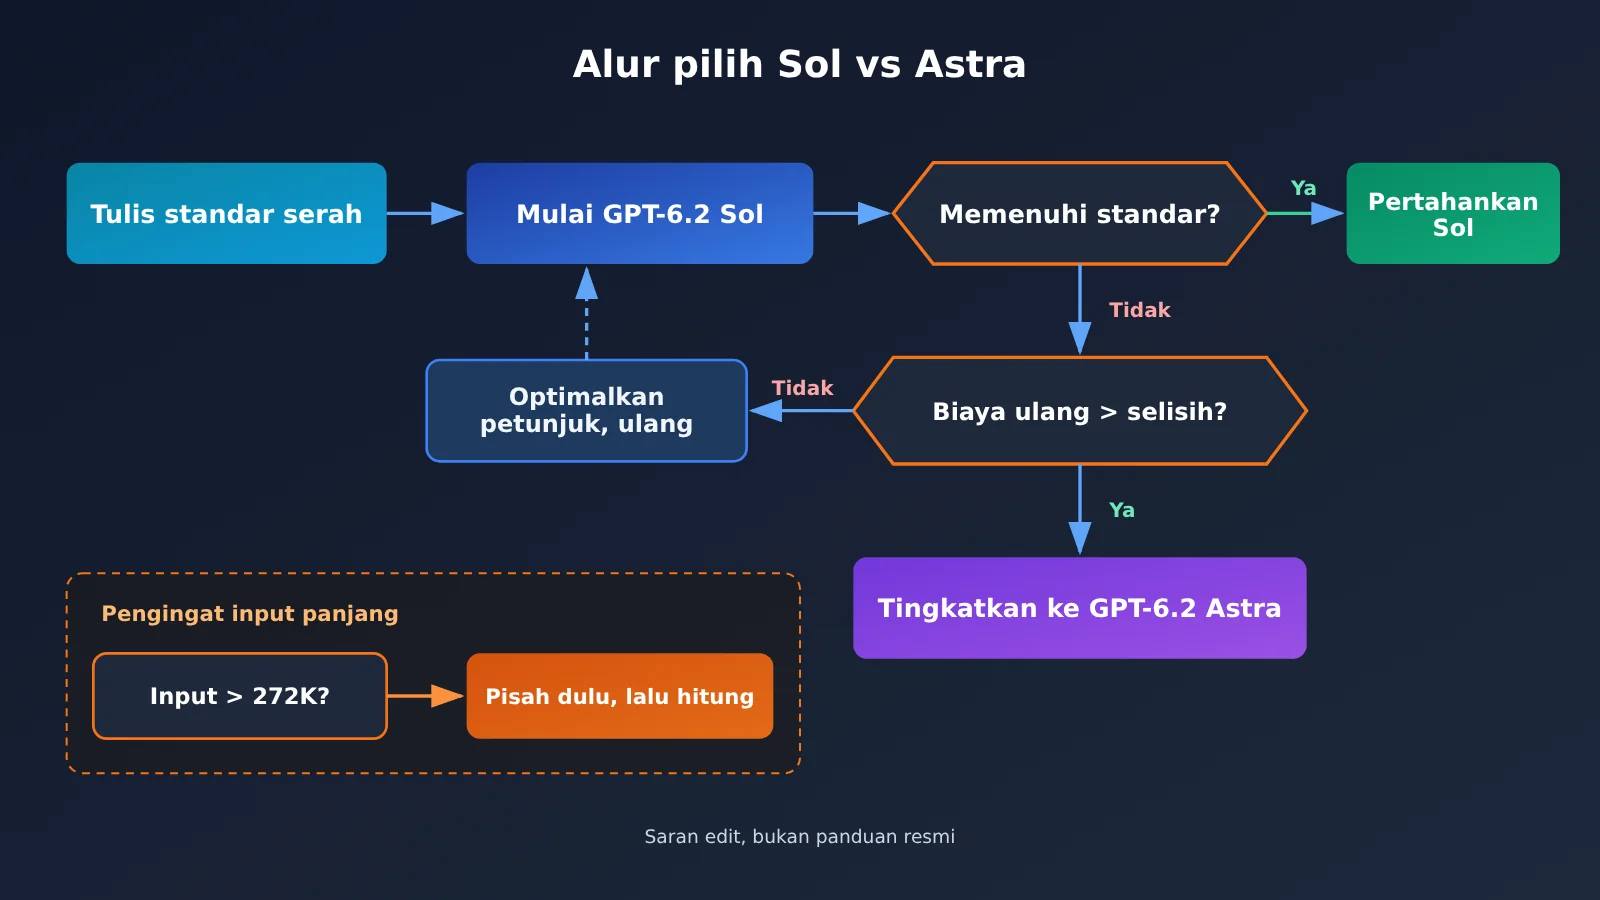
2.2 Tabel keputusan 4 skenario untuk GPT-6.2 Sol dan Astra
Tabel berikut adalah saran editorial, bukan panduan resmi. “Pemicu peningkatan” berarti ketika kondisi ini muncul, Astra layak dicoba; “titik pemeriksaan manual” adalah langkah yang tidak boleh dilewatkan apa pun model yang digunakan.
| Skenario | Model awal | Pemicu peningkatan ke Astra | Titik yang wajib diperiksa manual |
|---|---|---|---|
| Penulisan dan revisi sehari-hari | GPT-6.2 Sol | Setelah 2–3 putaran berturut-turut masih tidak sesuai persyaratan nada atau struktur; perlu menangani artikel panjang dengan argumentasi yang ketat | Fakta, data, kutipan, dan nama orang; ada tidaknya perubahan makna asli tanpa izin |
| Prototipe halaman web | GPT-6.2 Sol | Logika interaksi mencakup beberapa halaman, kode yang dihasilkan Sol berulang kali mengalami kesalahan status; perlu mereproduksi gambar desain dengan fidelitas tinggi | Jalankan sungguhan di browser; validasi formulir, adaptasi mobile; apakah paket dependensi benar-benar ada |
| Proyek panjang yang kompleks | Tergantung standar pengiriman, bisa langsung coba Astra | Rantai tugas panjang, ketergantungan konteks banyak, satu kesalahan dapat menyebabkan pekerjaan ulang besar di hilir | Node keputusan penting, konsistensi lintas file, cakupan pengujian |
| Pemrosesan batch yang sensitif anggaran | GPT-6.2 Sol | Tingkat kesalahan dalam sampel melebihi ambang yang Anda tetapkan, dan biaya koreksi pasca-pemrosesan lebih tinggi | Pemeriksaan sampel secara proporsional; apakah satu input melebihi 272K; tingkat hit cache |
Dalam skenario penulisan dan revisi sehari-hari, kesulitannya biasanya akurasi fakta dan kesesuaian gaya, bukan kedalaman penalaran. Memulai dengan Sol lebih hemat biaya, tetapi apa pun model yang digunakan, data dan kutipan harus diverifikasi manual.
Dalam skenario prototipe halaman web, “bisa berjalan” adalah standar wajib yang dapat dinilai secara objektif. Untuk menentukan apakah Sol cukup, perlu menjalankannya secara nyata dan memeriksa interaksi inti, kondisi error, serta adaptasi mobile; tidak bisa hanya berdasarkan satu kali keberhasilan menjalankan untuk memutuskan peningkatan.
Proyek panjang yang kompleks adalah skenario yang paling beralasan untuk langsung mempertimbangkan Astra. Laporan resmi menunjukkan output token GDPval v2 berkurang 22%, dengan GPT-6 Astra lama sebagai baseline perbandingan, sehingga tidak bisa dipakai untuk memperkirakan penghematan relatif terhadap GPT-6.2 Sol. Total biaya tugas kedua model baru masih perlu diverifikasi sendiri di bawah standar pengiriman yang sama. Untuk pemrosesan batch yang sensitif anggaran, prioritaskan pengendalian panjang input per item agar tidak memicu pengali 272K.
2.3 Metode Estimasi Biaya GPT-6.2 Sol dan Astra
Berikut ini perhitungan ilustratif berdasarkan harga resmi standar, untuk menjelaskan dampak aturan penagihan, dan bukan merupakan konsumsi tugas nyata apa pun. Asumsikan satu permintaan dengan input 50K token (tanpa cache) dan output 5K token:
- Sol: 0,05 × $2 + 0,005 × $10 = $0,15
- Astra: 0,05 × $8 + 0,005 × $40 = $0,60
Jika input ditingkatkan menjadi 300K token dan output 10K token, maka pengali 272K akan terpicu:
- Sol: 0,3 × $4 + 0,01 × $15 = $1,35
- Astra: 0,3 × $16 + 0,01 × $60 = $5,40
Dari ilustrasi ini dapat dilihat dua hal. Pertama, pada penggunaan token yang sama, selisih harga keduanya stabil di sekitar 4 kali. Kedua, setelah melewati 272K, biaya satu permintaan akan meningkat secara signifikan. Untuk tugas batch, memecah dokumen panjang ke bawah ambang batas mungkin mengurangi biaya tambahan konteks panjang, tetapi penghematan bersih bergantung pada konteks yang berulang, permintaan tambahan, dan kehilangan kualitas, sehingga tidak bisa diasumsikan otomatis lebih hemat daripada mengganti model.
Biaya sebenarnya juga bergantung pada panjang output aktual dan jumlah putaran pengerjaan ulang. Jika Sol rata-rata membutuhkan 3 putaran untuk memenuhi standar, sedangkan Astra hanya 1 putaran, selisih tagihan akhir akan menyusut, dan inilah alasan Bagian 2.4 menyarankan pencatatan “jumlah putaran pengerjaan ulang”.
Kode berikut hanya merupakan contoh integrasi dan tidak diuji secara aktual dalam artikel ini. Skrip A/B menghasilkan estimasi ekuivalen harga resmi standar saat tanpa cache dan input tidak melebihi 272K, bukan tagihan aktual pihak ketiga; biaya pihak ketiga harus dihitung berdasarkan tarif aktualnya.
Kode contoh di bawah ini digunakan untuk berganti model dalam satu set kode yang sama. ID model mengacu pada penamaan di halaman model resmi; silakan gunakan daftar model aktual platform yang Anda gunakan sebagai acuan:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI, ketersediaan model mengacu pada daftar platform
)

response = client.chat.completions.create(
    model="gpt-6.2-sol",  # Ubah menjadi "gpt-6.2-astra" saat perlu upgrade
    messages=[{"role": "user", "content": "按以下交付标准改写这段文案:……"}]
)
print(response.choices[0].message.content)
print(response.usage)  # Catat penggunaan token untuk menghitung total biaya
Lihat skrip perbandingan A/B (menjalankan dua model untuk tugas yang sama dan mencatat penggunaan)
import openai

PRICES = {  # Estimasi setara harga standar resmi, bukan tagihan aktual pihak ketiga; hanya berlaku untuk permintaan ≤272K tanpa cache
    "gpt-6.2-sol":   {"input": 2.0, "output": 10.0},
    "gpt-6.2-astra": {"input": 8.0, "output": 40.0},
}

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Beralih model melalui antarmuka terpadu APIYI
)

def run_once(model: str, prompt: str) -> dict:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    if u.prompt_tokens > 272000 or cached:
        raise ValueError("此简化估算仅适用于输入≤272K且无缓存的请求")
    p = PRICES[model]
    cost = u.prompt_tokens / 1e6 * p["input"] + u.completion_tokens / 1e6 * p["output"]
    return {
        "model": model,
        "output": resp.choices[0].message.content,
        "input_tokens": u.prompt_tokens,
        "output_tokens": u.completion_tokens,
        "official_standard_equivalent_usd": round(cost, 4),
    }

task = "在这里放同一个任务的完整提示词和交付标准"
for m in PRICES:
    r = run_once(m, task)
    print(r["model"], r["input_tokens"], r["output_tokens"], r["official_standard_equivalent_usd"])
🚀 Saran memulai: Kunci dari A/B testing adalah “tugas yang sama, petunjuk yang sama, standar penyerahan yang sama”. Saat memakai antarmuka yang kompatibel dengan OpenAI seperti APIYI apiyi.com, Anda cukup mengubah parameter
modeluntuk beralih model, sehingga lebih mudah mengendalikan variabel. Sebelum diluncurkan, pastikan model target sudah muncul di daftar model platform.
2.4 Templat Catatan Pengujian A/B GPT-6.2 Sol dan Astra
Di bawah ini adalah templat kosong; silakan isi dengan hasil pengujian Anda sendiri. Sebaiknya pilih setidaknya 3–5 tugas representatif untuk setiap skenario dan catat masing-masing secara terpisah. Jangan menarik kesimpulan hanya berdasarkan satu hasil.
| Dimensi pemeriksaan | Cara mencatat | GPT-6.2 Sol | GPT-6.2 Astra |
|---|---|---|---|
| Akurasi fakta | Periksa data, kutipan, dan nama satu per satu; catat jumlah kesalahan | ||
| Kelayakan penggunaan | Apakah memenuhi kriteria penyerahan yang telah ditulis sebelumnya (ya / tidak / sebagian) | ||
| Jumlah putaran pengerjaan ulang | Berapa putaran yang dibutuhkan dari hasil pertama hingga memenuhi standar | ||
| Token input / output | Akumulasi tiap putaran; perhatikan apakah melebihi 272K | ||
| Total biaya | Dihitung dari akumulasi token tiap putaran, termasuk putaran pengerjaan ulang | ||
| Waktu kerja manual | Jumlah menit yang dihabiskan untuk memeriksa dan merevisi | ||
| Kesimpulan | Model mana yang akan dijadikan default untuk tugas ini ke depannya |
Saat mengisi, sebaiknya lihat “total biaya” dan “waktu kerja manual” secara bersamaan. Jika nilai waktu kerja manual yang dihemat Astra melebihi biaya API tambahan, beralih ke Astra adalah keputusan yang wajar. Jika sebaliknya, tetaplah menggunakan Sol dan fokuskan energi pada penyempurnaan petunjuk serta kriteria penyerahan.
2.5 Bagaimana Tim Kecil Merancang Routing untuk GPT-6.2 Sol dan Astra
Untuk tim kecil, editor menyarankan pendekatan routing “default Sol, tingkatkan ke Astra berdasarkan kondisi”. Secara konkret, Anda bisa menuliskan kondisi pemicu dari tabel di bagian 2.2 ke dalam alur kerja: misalnya, jika suatu jenis tugas mengalami rework terus-menerus melebihi jumlah putaran yang ditetapkan, sistem otomatis beralih ke Astra untuk menghasilkan ulang, dan mencatat alasannya di log. Setelah terkumpul selama beberapa waktu, Anda akan mendapatkan dasar pemilihan model berdasarkan data bisnis Anda sendiri, yang lebih andal daripada evaluasi umum mana pun.
Routing semacam ini membutuhkan lapisan akses yang memudahkan pergantian model. APIYI apiyi.com menyediakan antarmuka yang kompatibel dengan OpenAI, satu kunci API saja sudah bisa memanggil beberapa model utama, cocok untuk membangun routing seperti ini. Namun, sebelum seri GPT-6.2 benar-benar muncul di daftar model platform, jalankan dulu alur kerjanya dengan model yang sudah ada.
Ada satu hal lagi yang perlu terus dipantau: kedua model masih dalam tahap pembukaan bertahap, sehingga harga resmi, cakupan peluncuran, dan informasi halaman model bisa saja diperbarui. Penilaian berikut bersifat prediksi: seiring munculnya lebih banyak evaluasi pihak ketiga, kesenjangan antara Sol dan Astra pada tugas-tugas tertentu akan tampak lebih terperinci daripada yang ditunjukkan dalam laporan resmi. Pada saat itu, tabel catatan A/B Anda sendiri akan lebih bernilai referensi daripada skor tunggal mana pun.
Referensi
- Halaman rilis resmi OpenAI: catatan rilis dan evaluasi resmi GPT-6.2 Astra dan Sol
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol/ - Keterangan: Data GDPval v2, ALE, dan FrontierCode 2.0 dalam artikel ini semuanya berasal dari halaman tersebut
- Tautan:
- Pusat Bantuan OpenAI: penjelasan ketersediaan ChatGPT Work dan Codex
- Tautan:
help.openai.com/en/articles/20001275-chatgpt-work-and-codex - Keterangan: cakupan peluncuran dan informasi pembukaan bertahap
- Tautan:
- Materi model GPT-6.2 Astra: halaman model API resmi
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-astra - Keterangan: harga, cache, dan aturan penagihan konteks panjang
- Tautan:
- Materi model GPT-6.2 Sol: halaman model API resmi
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol - Keterangan: harga, cache, dan aturan penagihan konteks panjang
- Tautan:
Model akan terus berevolusi, dan pendekatan yang lebih andal adalah menuliskan standar pengiriman terlebih dahulu, lalu membandingkannya dengan tugas yang sama. Jika Anda ingin membandingkan beberapa model dalam satu basis kode, Anda dapat terhubung melalui APIYI apiyi.com, lalu mencatat hasilnya sesuai templat dalam artikel ini.
Segala sesuatu yang dipersiapkan lebih dahulu akan berhasil, yang tidak dipersiapkan akan gagal. — 《Liji·Zhongyong》
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui beranda APIYI apiyi.com; materi integrasi lebih lanjut dapat diakses di pusat dokumentasi docs.apiyi.com