Tim Tongyi Alibaba merilis Qwen4-Max pada pagi 2026-11-16. Parameter utamanya 2.4T, konteks 1M, sekaligus disertai grafik perbandingan berisi 16 skor benchmark.
Langsung ke kesimpulan: yang benar-benar unggul dari Qwen4-Max adalah efisiensi token dan penyelesaian tugas jangka panjang, bukan berarti ia peringkat pertama di semua kategori. Dari 16 skor benchmark yang dilaporkan sendiri oleh pihak resmi, ia meraih 4 peringkat pertama dan 4 peringkat kedua; untuk operasi terminal, pembuatan program, pemahaman grafik, dan pemahaman video, ia masih tertinggal jelas dari pesaing teratas di grafik yang sama.
Sumber informasi artikel ini hanya tiga jenis: materi rilis resmi 2026-11-16, snapshot papan peringkat akhir publik Code Arena WebDev dari arena.ai (2026-11-14), serta harga yang tercantum di QwenCloud dan platform AI Qianwen. Detail parameter yang belum diumumkan dan hasil reproduksi pihak ketiga tidak termasuk dalam cakupan artikel ini. Jika Anda saat ini sedang menjalankan Qwen3.8-Max atau model unggulan lain, setelah membaca Anda dapat menilai berdasarkan tiga jenis tugas apakah perlu beralih, lalu menghitung sendiri dengan harga input, harga output, dan harga cache.
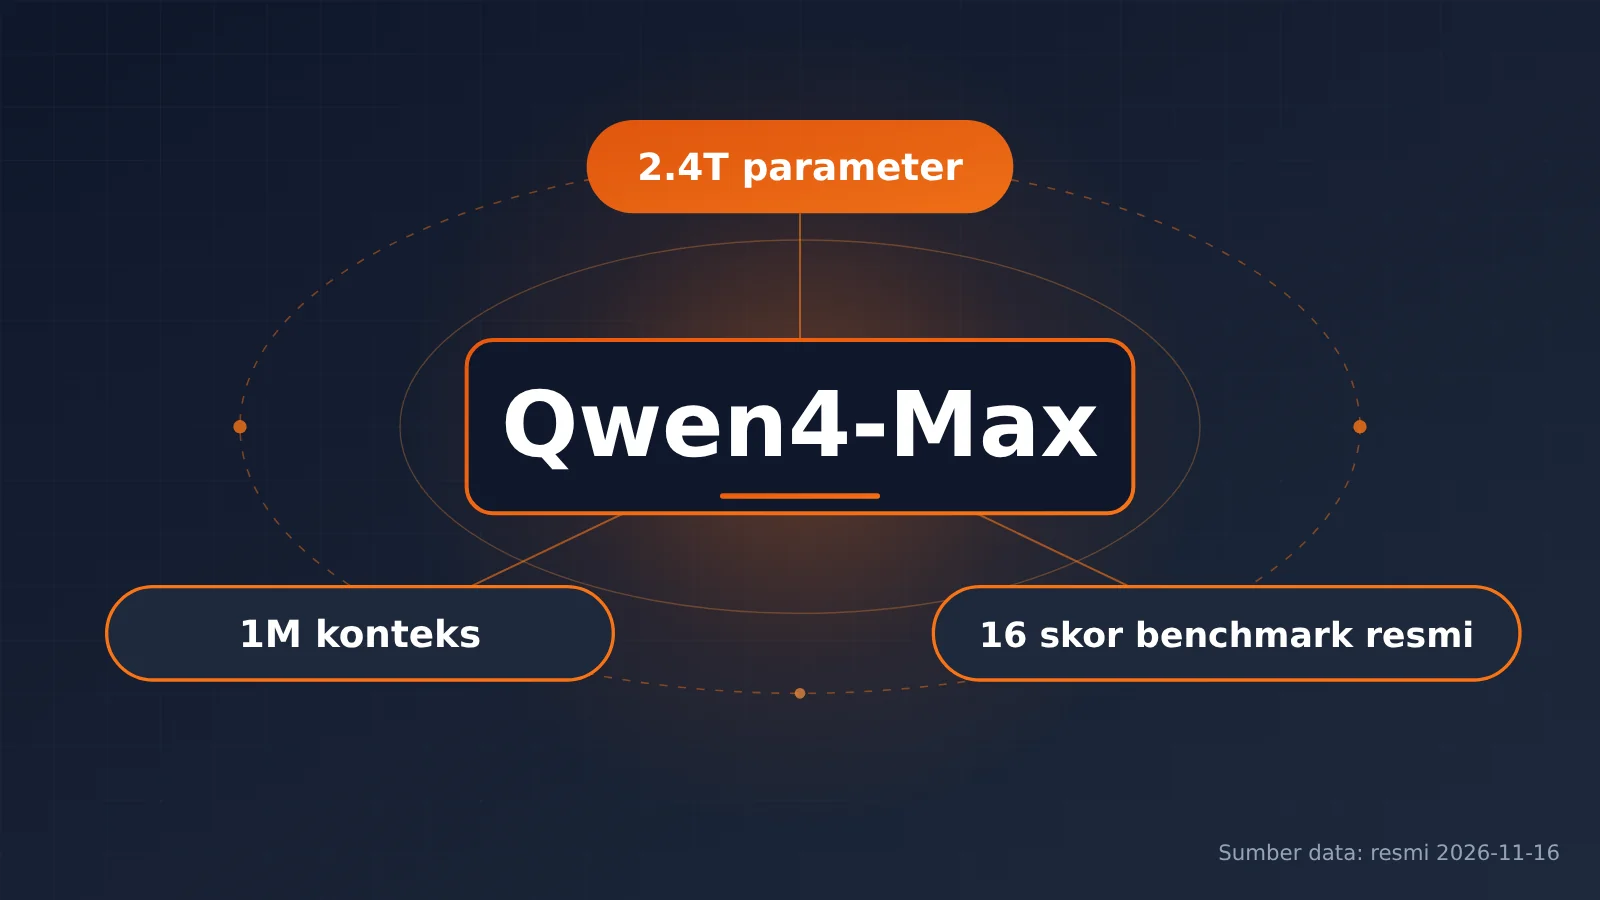
Sekilas Info Peluncuran Qwen4-Max
| Item informasi | Detail |
|---|---|
| Waktu rilis | 2026-11-16 10:01 (UTC+8) |
| Pihak yang merilis | Tim Alibaba Tongyi Qianwen (Qwen) |
| Skala parameter | 2,4T parameter backbone, 71B aktif per token, ditambah 328B parameter N-gram Embedding |
| Konteks | 1M, visi native |
| Saluran resmi | QwenCloud API, Qwen Studio, QwenWork, Qoder, Aplikasi Qwen |
| Rencana open source | Pihak resmi menyatakan Qwen4 ukuran lebih kecil akan dirilis dengan bobot terbuka; Max sendiri tidak disebut akan open source |
Kalau melihat ritme peluncurannya, ini bukan sekadar pembaruan satu model API. Qwen4-Max sekaligus masuk ke dua produk milik mereka sendiri, QwenWork (perkantoran) dan Qoder (pemrograman), dan materi resminya juga menekankan tugas panjang berbasis agent serta pengiriman solusi industri, bukan menjadikan kemampuan tanya-jawab murni sebagai andalan.
Tiga Perubahan Arsitektur Qwen4-Max
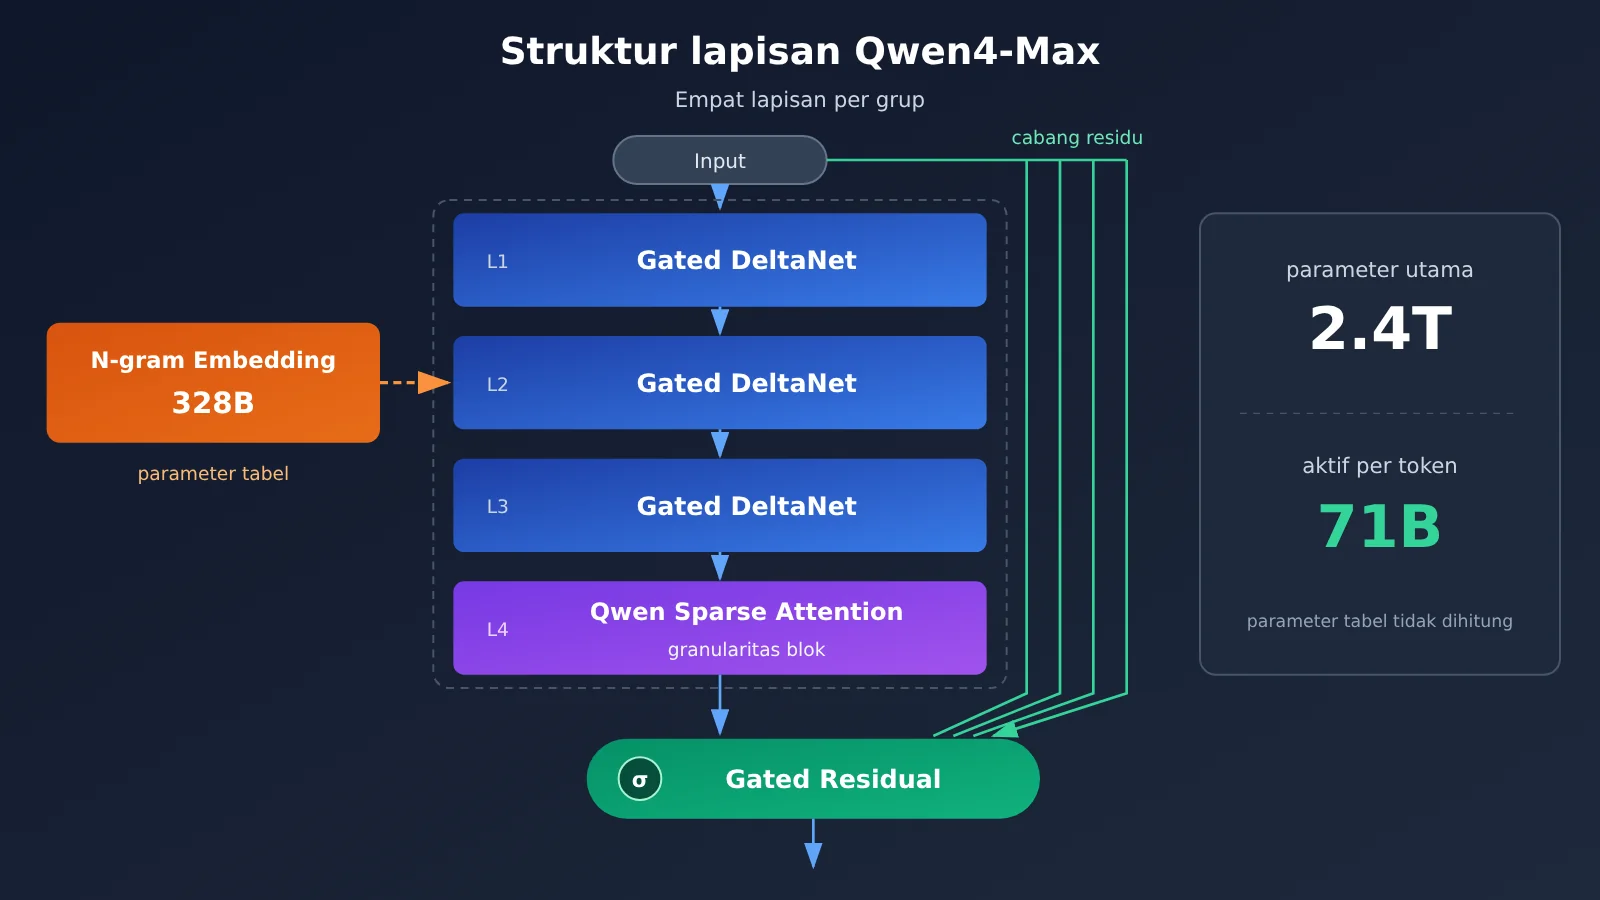
Blog resmi mencantumkan tiga perubahan struktural. Berikut penjelasan satu per satu soal masalah apa yang mereka selesaikan:
- Perhatian hibrida GDN + QSA: Dari setiap empat lapisan, tiga memakai Gated DeltaNet, satu lapisan lagi memakai Qwen Sparse Attention, dengan pemilihan konteks pada granularitas block. Tujuan utama susunan ini adalah menekan biaya komputasi pada konteks panjang 1M.
- Gated Residual: Jalur residual dipecah menjadi empat cabang paralel, lalu digabung lewat gating, untuk meningkatkan kapasitas representasi jaringan yang dalam.
- N-gram Embedding: Melakukan lookup tabel di lapisan kedua untuk melengkapi pola token lokal. 328B parameter tambahan berasal dari sini; mereka adalah parameter lookup, tidak ikut dihitung dalam aktivasi per token.
Perlu dicatat, 2,4T adalah total parameter backbone, sedangkan yang benar-benar aktif per token adalah 71B. Saat membandingkan “ukuran parameter” dengan model lain, pastikan dulu keduanya memakai definisi yang sama.
Spesifikasi dan Protokol Qwen4-Max
| Item spesifikasi | Qwen4-Max |
|---|---|
| Jendela konteks | 1M |
| Input maksimum | 991K (983K dalam mode berpikir) |
| Output maksimum | 393K |
| Rantai berpikir maksimum | 262K |
| TPM | 5 juta |
| Protokol yang kompatibel | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
reasoning_effort default |
high (Qwen3.8-Max defaultnya xhigh) |
Baris terakhir mudah terlewat. Tingkat penalaran default Qwen4-Max adalah high, satu tingkat lebih rendah daripada xhigh yang menjadi default generasi sebelumnya. Kalau Anda membandingkan dua generasi ini langsung dengan parameter default, sebagian penghematan token yang terlihat berasal dari perbedaan tingkat tersebut, bukan sepenuhnya dari modelnya. Saat melakukan uji A/B, sebaiknya set reasoning_effort secara eksplisit ke nilai yang sama.
16 Skor Benchmark Resmi Qwen4-Max: Unggul dan Tertinggal
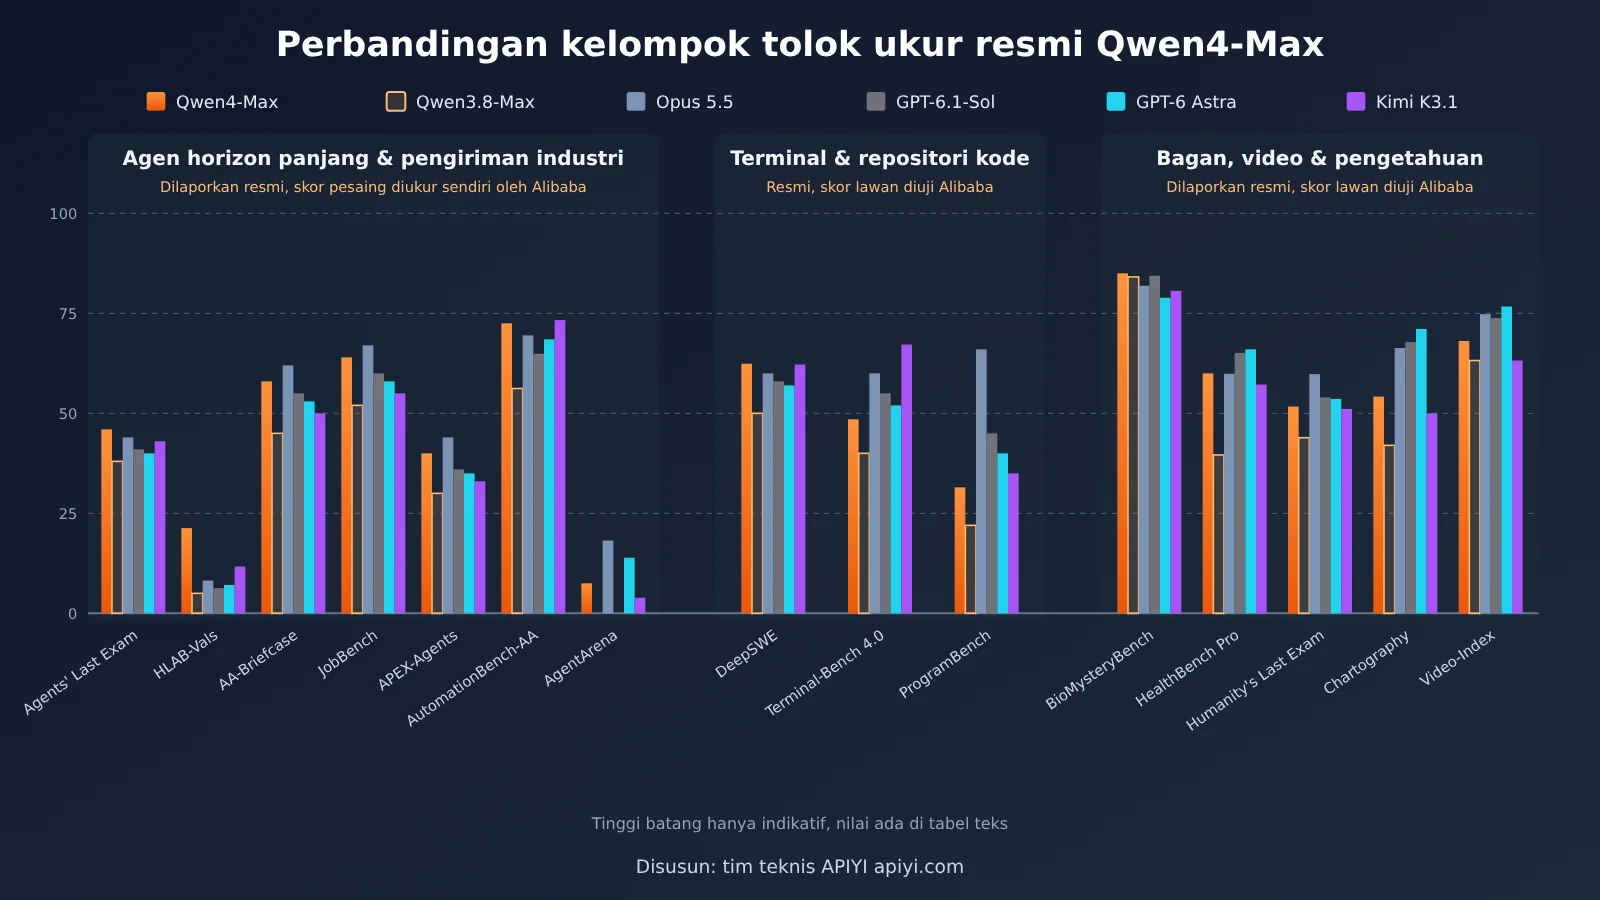
Semua skor dalam tabel di bawah ini berasal dari satu gambar resmi yang sama dan merupakan klaim resmi dari pihak Alibaba sendiri. Skor para pesaing dalam gambar itu juga diukur sendiri oleh Alibaba, sehingga tidak boleh dianggap sebagai hasil resmi yang diumumkan oleh Anthropic, OpenAI, atau Moonshot AI. CodeArena dan AgentArena dikutip dari LM Arena; AA-Briefcase dan AutomationBench-AA dikutip dari Artificial Analysis; APEX-Agents dikutip dari peringkat Mercor; sedangkan JobBench diuji sendiri oleh Alibaba dengan dataset dan kode evaluasi yang telah diperbarui.
| Benchmark | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | Tidak dicantumkan |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Benchmark yang Unggul untuk Qwen4-Max
Ada empat benchmark yang menempatkan Qwen4-Max di posisi pertama: DeepSWE, Agents’ Last Exam, HLAB-Vals, dan BioMysteryBench. Di antara semuanya, HLAB-Vals punya selisih paling besar; skor 21,3 poinnya sekitar dua kali lipat Kimi K3.1 yang ada di posisi kedua. DeepSWE hanya unggul 0,2 poin atas Kimi, jadi selisih ini praktis bisa dianggap imbang.
Empat benchmark lain menempatkannya di posisi kedua: AA-Briefcase, JobBench, APEX-Agents, dan AutomationBench-AA. Tiga benchmark pertama dimenangkan Opus 5.5, sedangkan yang terakhir dimenangkan Kimi K3.1. Benchmark-benchmark ini cenderung menguji agen long-horizon dan penyelesaian pekerjaan white-collar, yang memang menjadi arah utama yang ditonjolkan pihak resmi kali ini.
Benchmark yang Tertinggal untuk Qwen4-Max
Terminal dan build program adalah kelemahan paling jelas kali ini. Skor 48,5 pada Terminal-Bench 4.0 menempatkannya di posisi kelima dari enam model, tertinggal 18,7 poin dari Kimi yang ada di posisi pertama. Skor 31,5 pada ProgramBench bahkan belum mencapai setengah skor Opus 5.5. Jika agen Anda terutama menjalankan build, debug, dan deployment di shell, dua benchmark ini lebih relevan sebagai acuan daripada DeepSWE.
Pemahaman grafik dan video juga tertinggal. Chartography dan Video-Index sama-sama berada di posisi keempat, masing-masing tertinggal 16,9 poin dan 8,6 poin dari GPT-6 Astra di posisi pertama. Humanity’s Last Exam juga berada di posisi keempat. Jadi, “visi native” berarti kemampuannya sudah dimiliki, bukan berarti Qwen4-Max unggul di area ini.
Posisi Qwen4-Max di Papan Peringkat Publik Code Arena
Snapshot peringkat akhir papan peringkat publik arena.ai Code Arena WebDev (2026-11-14) memiliki total 1,007,405 suara dan 159 model. Qwen4-Max (xHigh) berada di peringkat 6 dengan 1750 poin, ditandai sebagai Preliminary, hanya memiliki 1,814 suara, dan halaman menampilkan biaya per tugas P50 sebesar $4.18. Di atasnya secara berurutan adalah Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon (Preliminary), dan GPT-6 Astra.
Generasi sebelumnya, Qwen3.8-Max (0902), di papan peringkat yang sama memperoleh 1676 poin dan peringkat 16, sehingga generasi ini naik 74 poin dan 10 peringkat. Namun jumlah suara Qwen4-Max masih relatif sedikit, sehingga peringkat berikutnya mungkin masih berubah.
Efisiensi Token Qwen4-Max dan Asal Klaim “Biaya Turun 60%”
Angka efisiensi resmi berasal dari benchmark skenario Work360 yang mereka bangun sendiri. Benchmark ini memiliki 26 domain tingkat pertama, 182 domain tingkat kedua, dan 721 domain tingkat ketiga. Qwen4-Max memperoleh skor 52.69, sedangkan Qwen3.8-Max 47.74. Dalam hal konsumsi token, tingkat Xhigh Work360 sekitar 24% lebih sedikit dan tingkat High sekitar 35% lebih sedikit; pada Terminal-Bench 4.0, kedua tingkat masing-masing sekitar 48% dan 49% lebih sedikit.
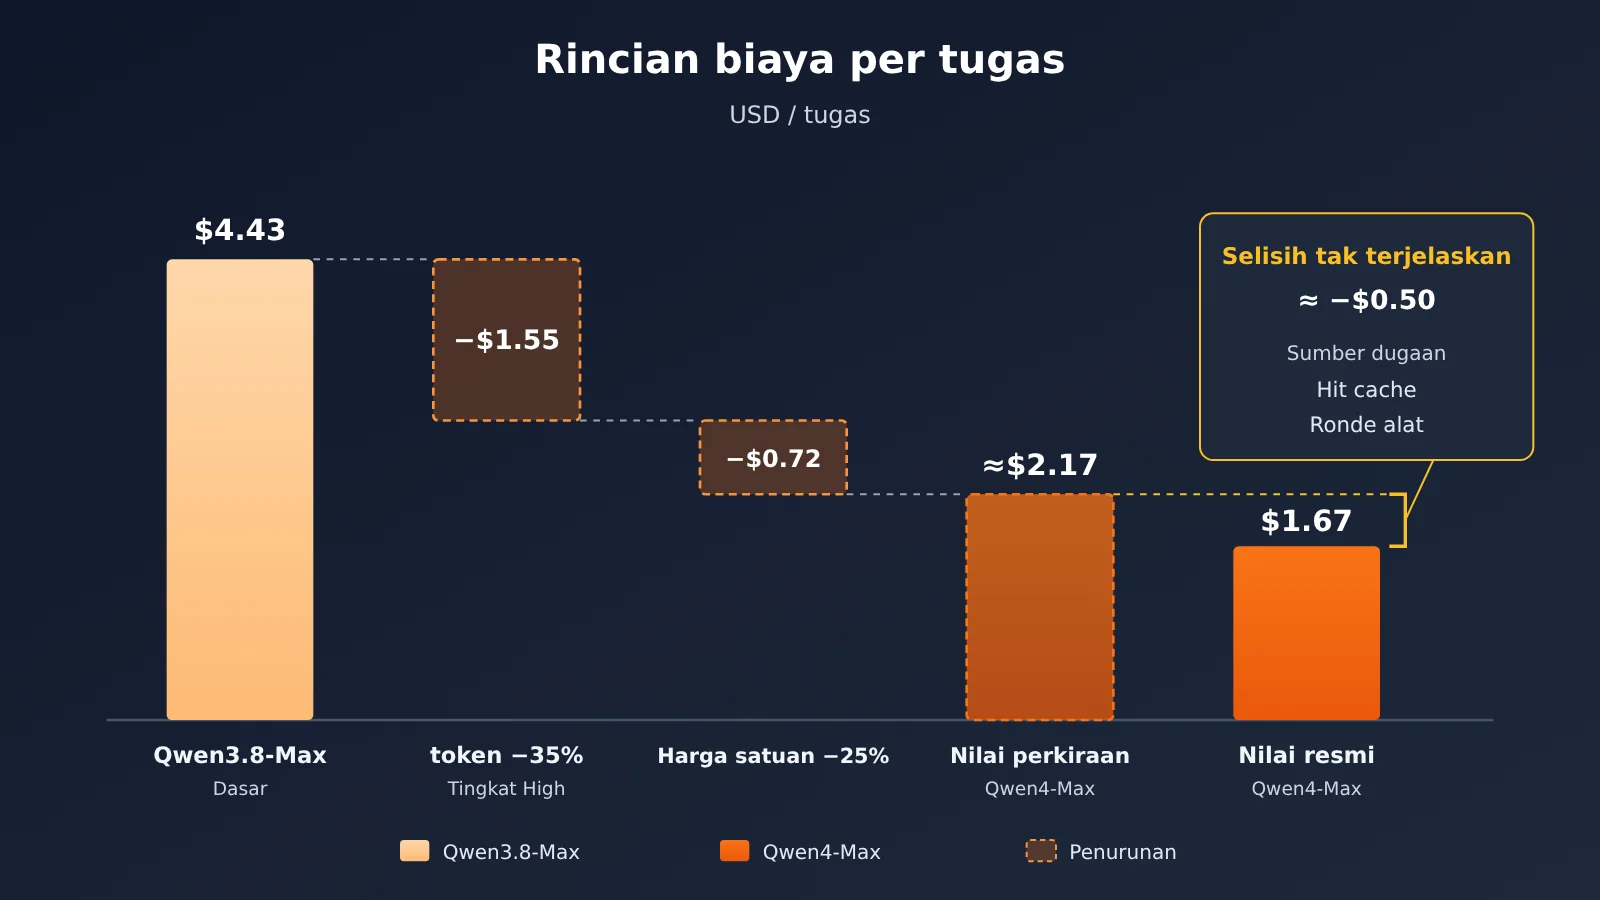
Untuk biaya rata-rata per tugas, angka resmi turun dari $4.43 menjadi $1.67; versi blog berbahasa Mandarin mencatat ¥26.58 turun menjadi ¥11.16, dengan penurunan 58%. Berdasarkan angka dolar, penurunannya sekitar 62%. Tetapi jika hanya menggunakan “token 35% lebih sedikit × harga satuan turun 25%” untuk memperkirakan, hasilnya sekitar 0.65 × 0.75 ≈ 0.49, yakni turun sekitar 51%. Selisih di antaranya tidak dijelaskan oleh pihak resmi; sumber yang lebih mungkin adalah meningkatnya rasio cache hit dan berkurangnya putaran pemanggilan alat, tetapi ini hanya dugaan dan tidak bisa dianggap sebagai penyebab yang sudah terkonfirmasi.
Dari sisi keamanan, pada Last Secure Code Bench, “tingkat kelulusan ganda untuk fungsionalitas dan kerentanan” di level fungsi naik dari 22.0% menjadi 31.8%. Proporsi yang menghasilkan kode aman pada ketiga granularitas—fungsi, file, dan repositori—naik dari 8% menjadi 14.7%. Nilai absolutnya masih belum tinggi, dan kode yang dihasilkan tetap memerlukan peninjauan manual.
Bagaimana cara menghitung harga Qwen4-Max
Di bawah ini tercantum harga resmi Qwen4-Max, serta harga resmi model generasi sebelumnya dan harga saat ini di APIYI. Semua dalam dolar AS / 1M token, dengan tanggal pengambilan data 2026-11-16.
| Komponen biaya | Qwen4-Max (resmi QwenCloud) | Qwen3.8-Max (resmi) | qwen3.8-max (harga saat ini di APIYI apiyi.com) |
|---|---|---|---|
| Input | $1.5 | $2 | $1.65 |
| Output | $4.5 | $6 | $4.95 |
| Baca cache / cache hit | $0.075 | $0.25 | $0.20625 |
| Pembuatan cache eksplisit 5 menit | $1.875 | — | — |
| Pembuatan cache eksplisit 1 jam | $3 | — | — |
Harga dalam yuan mengacu pada platform Qwen AI, dengan unit yuan / 1M token, tanggal pengambilan data 2026-11-16:
- Input ¥10, output ¥30, cache hit ¥0.5
- Pembuatan cache eksplisit 5 menit ¥12.5, pembuatan cache eksplisit 1 jam ¥20
Dibandingkan dengan harga resmi generasi sebelumnya, harga input dan output Qwen4-Max masing-masing lebih rendah 25%, sedangkan harga baca cache lebih rendah 70%. Penurunan harga baca cache paling besar, dan ini berdampak jelas pada agen jangka panjang, karena dalam tugas multi-putaran banyak system prompt dan konteks historis yang berulang akan ditagih dengan harga cache.
Saat memperkirakan biaya sendiri, Anda bisa memecahnya dengan rumus ini: input yang tidak kena cache × harga input + cache hit × harga cache + volume pembuatan cache eksplisit × harga pembuatan + output (termasuk rantai pemikiran) × harga output. Contoh hipotetis: sebuah tugas memiliki 1M input, dengan 600 ribu di antaranya cache hit, dan output 100 ribu. Dengan harga resmi Qwen4-Max, perhitungannya sekitar $0.6 + $0.045 + $0.45 ≈ $1.10; dengan jumlah token yang sama, menggunakan harga resmi Qwen3.8-Max sekitar $1.55. Selisih sebenarnya juga harus memperhitungkan perubahan konsumsi token, jadi cara paling andal adalah menjalankan ulang perhitungan dengan log asli Anda sendiri.
💰 Tips hitung biaya: APIYI saat ini belum menyediakan qwen4-max. Kami akan segera menambahkan model ini; nama model dan harga spesifik mengacu pada daftar model di platform apiyi.com. Sebelum tersedia, Anda bisa menggunakan
qwen3.8-maxdi platform untuk membangun baseline biaya, lalu membandingkan langsung kedua tagihan setelah model baru tersedia.
Cara menentukan apakah perlu beralih ke Qwen4-Max berdasarkan skenario
| Skenario | Performa Qwen4-Max (klaim resmi) | Saran |
|---|---|---|
| Agen jangka panjang dan deliverable industri (otomatisasi kantor, riset, dokumen deliverable) | HLAB-Vals, Agents’ Last Exam peringkat pertama; APEX, JobBench, AA-Briefcase peringkat kedua; token jauh lebih hemat | Prioritaskan evaluasi; manfaat upgrade dari Qwen3.8-Max paling jelas |
| Terminal dan repositori kode (agen shell, build, modifikasi lintas repo) | DeepSWE peringkat pertama tetapi keunggulannya tipis; Terminal-Bench peringkat kelima, ProgramBench peringkat keempat | Untuk tugas yang dominan operasi terminal, bandingkan dulu dengan Kimi K3.1 dan Opus 5.5 sebelum memutuskan |
| Frontend WebDev | Peringkat 6 di papan publik Code Arena, 1750 poin (Preliminary) | Bisa menjadi pilihan hemat biaya, tetapi bukan peringkat teratas |
| Pemahaman diagram dan video, dokumen panjang multimodal | Chartography, Video-Index keduanya peringkat keempat | Untuk alur kerja yang banyak membaca gambar dan video, untuk sementara tidak disarankan hanya mengandalkannya |
| Tanya jawab biologi dan medis | BioMysteryBench peringkat pertama; HealthBench Professional peringkat ketiga | Bisa dimasukkan dalam pengujian, tetapi perlu ditinjau oleh pakar domain |
Pendekatan yang cukup aman adalah memisahkan alur: tugas seperti agen jangka panjang dan penyampaian dokumen diserahkan ke Qwen4-Max, sementara tugas berat di terminal serta tugas diagram dan video tetap diberikan kepada model yang saat ini lebih unggul di bidang tersebut. Dengan begitu, Anda tidak perlu memigrasikan semua trafik sekaligus, tetapi tetap bisa menikmati penghematan token lebih dulu.
🎯 Saran pemilihan model: Syarat untuk memisahkan alur adalah kemampuan beralih model dengan basis kode yang sama. APIYI apiyi.com menyediakan antarmuka yang kompatibel dengan OpenAI, sehingga satu kunci API dapat memanggil beberapa model unggulan dari berbagai penyedia; cukup ganti kolom
modeluntuk melakukan uji A/B.
Mulai Cepat dengan Qwen4-Max
Kanal resminya adalah QwenCloud API, yang mendukung empat protokol: OpenAI Chat Completions, Responses, Anthropic Messages, dan DashScope. OpenAI SDK atau Anthropic SDK yang sudah Anda miliki bisa langsung terhubung. Perhatikan beberapa hal berikut saat mengintegrasikan:
- Pastikan modelnya: ID model resmi ditulis
qwen4-max, dan halaman model adalah acuan utamanya. Nilai defaultreasoning_effortadalahhigh; saat pengujian perbandingan, tentukan tingkat yang sama secara eksplisit, misalnyaxhigh. - Sisihkan ruang output: Output maksimum 393K, rantai pemikiran maksimum 262K. Untuk tugas panjang, atur
max_tokensatau parameter terkait dengan cukup besar, kalau tidak rantai pemikiran akan memenuhi kuota output. - Aktifkan cache: Harga cache implisit yang terpakai adalah $0.075. Jika system prompt cukup panjang dan akan digunakan berulang, Anda bisa menilai apakah layak memakai cache eksplisit 5 menit atau 1 jam; membuat cache需 membayar terpisah, dan bila frekuensi penggunaan ulang terlalu sedikit justru tidak menguntungkan.
- Siapkan kelompok pembanding: Setelah mendaftar di APIYI, dapatkan API Key, atur
base_urlmenjadihttps://api.apiyi.com/v1, isimodeldenganqwen3.8-max, lalu jalankan sekumpulan tugas yang sama untuk memperoleh konsumsi token dan skor model lama sebagai garis dasar. - Beralih setelah model baru tersedia: Setelah qwen4-max tersedia di APIYI, Anda hanya perlu mengubah field
model, kode lainnya tetap tidak berubah, dan Anda langsung bisa mendapatkan data perbandingan antara generasi baru dan lama.
🚀 Mulai Cepat: Pengguna baru yang mendaftar di APIYI apiyi.com akan mendapatkan kuota uji gratis, cukup untuk menjalankan garis dasar
qwen3.8-maxterlebih dahulu; nanti saat berganti model tidak perlu integrasi ulang.
FAQ Pertanyaan Umum Qwen4-Max
Q1: Apa itu Qwen4-Max?
Qwen4-Max adalah model unggulan yang dirilis oleh Qwen pada 16 November 2026. Model ini menggunakan 2,4T parameter backbone, mengaktifkan 71B per token, mendukung input visual secara native, dengan konteks 1M, dan terutama ditujukan untuk agen jarak jauh serta tugas pengiriman industri.
Q2: Apa perbedaan antara Qwen4-Max dan Qwen3.8-Max?
Dalam 16 skor benchmark yang dilaporkan sendiri oleh pihak resmi, Qwen4-Max lebih tinggi dari Qwen3.8-Max-0902 di setiap item. Di papan peringkat publik Code Arena, selisihnya 74 poin. Untuk harga resmi, input dan output masing-masing 25% lebih rendah, dan baca cache 70% lebih rendah. Selain itu, tingkat inferensi default keduanya berbeda, yaitu `high` dan `xhigh`.
Q3: Apakah 16 skor benchmark itu kredibel?
Skor-skor ini semuanya dilaporkan sendiri oleh pihak resmi, dan skor lawan juga diukur sendiri oleh Alibaba, saat ini belum ada replikasi pihak ketiga. Sinyal eksternal yang bisa dijadikan referensi adalah papan peringkat publik Code Arena WebDev: dalam snapshot daftar akhir pada 14 November 2026, Qwen4-Max berada di peringkat 6, tetapi masih berstatus Preliminary dengan jumlah suara yang sedikit.
Q4: Apakah “biaya turun 60%” bisa langsung diterapkan ke bisnis saya?
Tidak bisa langsung diterapkan. Angka ini berasal dari skenario Work360 resmi, penurunannya lebih tinggi daripada hasil perhitungan sederhana berdasarkan token dan harga satuan, selisih di antaranya tidak dijelaskan oleh pihak resmi. Penurunan aktual Anda bergantung pada tingkat hit cache, jumlah putaran pemanggilan alat, dan tingkat inferensi, sehingga perlu diukur menggunakan log tugas Anda sendiri.
Q5: Apakah Qwen4-Max bisa dipanggil melalui APIYI?
Hingga 16 November 2026 pukul 11:00, qwen4-max belum ada di daftar model APIYI, kami akan segera menambahkannya. Model unggulan Qwen yang dijual saat ini adalah `qwen3.8-max`, dengan harga input $1.65, output $4.95, dan baca cache $0.20625 (satuan: 1M tokens). Progres penambahan dan harga mengacu pada daftar model di apiyi.com.
Q6: Apa saja kekurangan Qwen4-Max?
Operasi terminal (Terminal-Bench peringkat kelima), pembangunan program (ProgramBench peringkat keempat), pemahaman grafik dan video (keduanya peringkat keempat), serta HLE (peringkat keempat) semuanya tertinggal dari pesaing teratas di grafik yang sama. Tingkat kelulusan ganda untuk kode aman meskipun ada peningkatan, hanya 31,8%. Selain itu, ukuran Max saat ini tidak memiliki rencana untuk membuka bobot model.
Ringkasan: Apakah Qwen4-Max Layak untuk Diganti?
- Posisi: Model unggulan dengan backbone 2.4T, mengaktifkan 71B parameter per token, dan jendela konteks 1M, berfokus pada agent jarak jauh (long-horizon) dan penyelesaian pekerjaan di tingkat industri.
- Kategori unggulan: Dari 16 skor resmi yang dilaporkan sendiri, meraih 4 peringkat pertama dan 4 peringkat kedua, yang terutama terkonsentrasi pada tolok ukur bertipe agent dan penyelesaian pekerjaan kelas pekerja kantoran (white-collar).
- Kategori tertinggal: Operasi terminal, pembangunan program, grafik/diagram, video, dan HLE semuanya berada di peringkat keempat atau kelima. Satu model tidak bisa menutupi semua tugas.
- Posisi di papan peringkat publik: Snapshot papan akhir Code Arena WebDev (2026-11-14) berada di peringkat ke-6 dengan 1750 poin, masih berstatus Preliminary.
- Biaya: Harga satuan resmi turun 25%, baca cache turun 70%, dan konsumsi token juga berkurang secara signifikan; klaim “turun enam puluh persen” perlu diverifikasi dengan data Anda sendiri.
Jika beban kerja utama Anda adalah agent jarak jauh dan penyelesaian dokumen, Qwen4-Max layak diprioritaskan untuk dievaluasi; jika tugas Anda berat di terminal atau pemahaman grafik dan video, sebaiknya tetap dialihkan ke model yang saat ini lebih kuat. Sebelum qwen4-max dirilis, Anda bisa lebih dulu menggunakan antarmuka yang kompatibel dengan OpenAI dari layanan proksi API APIYI apiyi.com, membangun baseline biaya dan hasil dengan qwen3.8-max, lalu setelah model baru tersedia, cukup mengubah satu kolom untuk menyelesaikan perbandingan.
📚 Referensi
- Postingan X resmi Qwen: Pengumuman rilis Qwen4-Max
- Tautan:
x.com/Alibaba_Qwen/status/2122148127520289151 -
Keterangan: Waktu rilis dan kanal resmi yang tersedia
-
Blog resmi Qwen (bahasa Mandarin): arsitektur, spesifikasi, 16 hasil benchmark, dan angka efisiensi
- Tautan:
qwen.ai/blog?id=qwen4-max -
Keterangan: Arsitektur, spesifikasi, dan data benchmark dalam artikel ini semuanya bersumber dari tulisan tersebut
-
Halaman model QwenCloud: harga terdaftar dalam dolar AS
- Tautan:
qwencloud.com/models/qwen4-max -
Keterangan: Harga input, output, dan cache dalam USD / 1M token
-
Halaman model platform Qianwen AI: harga terdaftar dalam RMB
- Tautan:
qianwenai.com/models/qwen4-max -
Keterangan: Harga dalam RMB / 1M token
-
arena.ai Code Arena WebDev: papan peringkat publik
- Tautan:
arena.ai - Keterangan: Yang dikutip dalam artikel ini adalah snapshot papan peringkat final per 2026-11-14
Penulis: Tim Teknis APIYI
Komunikasi teknis: Jika Anda ingin mengetahui progres peluncuran model dan cara integrasinya, silakan hubungi kami melalui halaman utama situs APIYI; dokumentasi tersedia di docs.apiyi.com