Note de l’auteur : les poids de MiniMax M3.1 Flash devraient être publiés le 23 octobre. Cet article explique le niveau de matériel nécessaire pour le déployer en local et compare, selon 4 critères, ce qui est le plus avantageux entre « l’héberger soi-même » et « appeler directement l’API ».
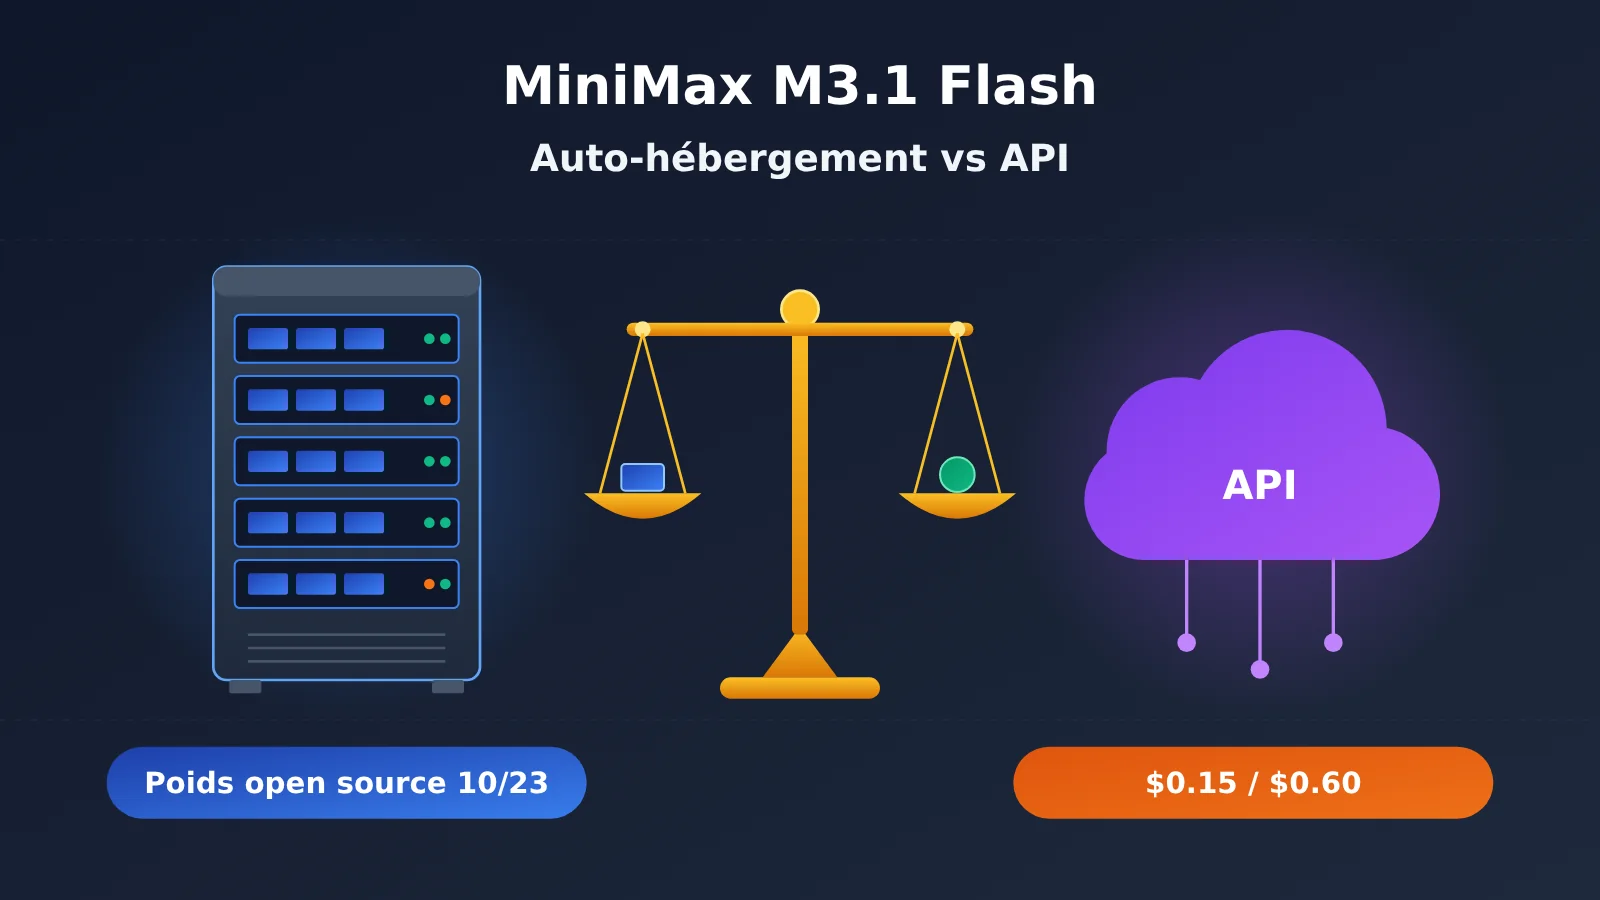
Pour résumer : pour la grande majorité des développeurs indépendants et des petites équipes, appeler directement l’API, à 0,15 $ par million de tokens en entrée et 0,60 $ en sortie, coûte beaucoup moins cher et demande bien moins d’efforts que de déployer le modèle soi-même. L’auto-hébergement ne vaut le coup que dans trois cas : si la réglementation interdit de faire sortir les données de votre réseau interne, si votre volume d’appels est assez élevé pour faire tourner en permanence un serveur multi-GPU à pleine charge, ou si vous devez modifier ou ajuster le modèle lui-même.
Cet article ne cherche pas à vous dissuader d’utiliser l’open source. Les poids ouverts sont précieux pour le secteur, mais « pouvoir les télécharger » et « avoir intérêt à les faire tourner soi-même » sont deux choses différentes. Notre site a déjà publié un article consacré à l’annonce de MiniMax M3.1 Flash ; nous n’y reviendrons donc pas ici. Cet article répond à deux questions : quelle configuration faut-il pour un déploiement local, et qu’est-ce qui est le plus avantageux entre l’auto-hébergement et l’appel à l’API ?
L’essentiel : après avoir lu cet article, vous saurez s’il vaut la peine d’attendre la publication des poids et quelles informations vérifier en priorité lorsqu’ils seront disponibles.
État des poids ouverts de MiniMax M3.1 Flash : ce qui est confirmé et ce qui n’a pas encore été annoncé
Commençons par définir un terme. Les poids ouverts désignent les fichiers de paramètres entraînés d’un modèle, publiés pour que vous puissiez les télécharger et les exécuter sur vos propres serveurs. Ce n’est pas la même chose que le « code source ouvert », et cela ne signifie pas non plus que vous pouvez les utiliser librement à des fins commerciales : les conditions d’utilisation dépendent de la licence.
À la date de publication (22 octobre 2026), les poids de M3.1 Flash n’ont pas encore été officiellement publiés. Dans un message publié sur X, MiniMax indique : « Model weights will arrive on Oct 23 », c’est-à-dire qu’ils devraient être publiés le 23 octobre. Le blog officiel parle seulement d’une publication « ultérieure ». Par ailleurs, selon un article de RITS, à l’Université de New York à Shanghai, aucun dépôt M3.1 Flash n’était encore disponible sur l’espace Hugging Face de MiniMax au 20 octobre.
Pour distinguer les différents niveaux de fiabilité, cet article répartit les informations en trois catégories : déclarations officielles (publiées par MiniMax), évaluations tierces (comme celles de Vals AI) et inconnu/non communiqué.
| Élément | État actuel | Catégorie |
|---|---|---|
| Date de publication des poids | Le message officiel sur X annonce le 23 octobre ; le blog officiel indique seulement « ultérieurement » | Déclarations officielles (publication prévue, pas encore effectuée) |
| Taille du modèle | Architecture MoE, 428 B de paramètres au total, environ 23 B activés, comme M3 | Information officielle, relayée par les médias |
| Licence | La licence de M3.1 Flash n’a pas encore été annoncée | Inconnu/non communiqué |
| Configuration matérielle requise pour le déploiement | Le guide de déploiement officiel ne mentionne pas encore M3.1 Flash | Inconnu/non communiqué |
| Rapport technique | Aucune explication n’a encore été publiée sur les différences entre Flash et M3 | Inconnu/non communiqué |
| Modèle de référence M3 | Ses poids sont disponibles sur Hugging Face depuis juin, sous une licence communautaire | Information officielle |
⚠️ À noter : une fois les poids publiés, vérifiez les conditions de licence, la taille des fichiers et la configuration matérielle recommandée sur la page officielle du modèle MiniMax sur Hugging Face. Les versions quantifiées republiées par la communauté ne sont pas validées par MiniMax : ne les considérez pas comme des configurations officielles.
Quelle configuration faut-il pour déployer MiniMax M3.1 Flash en local ?
Les exigences matérielles de M3.1 Flash n’ont pas encore été publiées officiellement. Nous n’allons donc pas spéculer sur la mémoire vidéo nécessaire ni sur le nombre de GPU. Le modèle M3 de la génération précédente, de taille comparable, peut servir de point de repère : les deux modèles comptent 428B de paramètres au total, dont environ 23B activés. On peut s’appuyer sur M3 pour estimer les ordres de grandeur.
Comprendre les « 428B paramètres au total, 23B paramètres activés » de MiniMax M3.1 Flash
Le MoE (mélange d’experts) est une architecture composée de nombreux sous-réseaux, appelés « experts ». À chaque étape de l’inférence, seule une partie d’entre eux est sollicitée. Les quelque 23B paramètres « activés » correspondent au nombre de paramètres qui participent réellement aux calculs pour chaque token généré, ce qui peut accélérer le traitement.
Mais attention à une idée reçue : un petit nombre de paramètres activés ne signifie pas que le modèle demande peu de mémoire vidéo. Il faut charger les 428B paramètres au complet dans la mémoire des GPU pour pouvoir faire appel à n’importe quel expert pendant l’inférence. C’est l’une des principales raisons pour lesquelles le déploiement local des grands modèles MoE exige du matériel conséquent.
Configuration de référence officielle de MiniMax M3 (à titre indicatif uniquement)
Quelques termes à connaître. MXFP8 est un format de stockage en précision 8 bits qui permet de réduire la taille des fichiers du modèle et l’occupation mémoire. SGLang est un framework d’inférence open source qui permet d’exécuter le modèle sous forme de service API compatible avec le format OpenAI. TP (parallélisme tensoriel) consiste à répartir un modèle sur plusieurs cartes graphiques qui travaillent ensemble.
| Modèle | Configuration officielle de référence | Taille des poids | Statut |
|---|---|---|---|
| MiniMax-M3 | 8 × B200, précision MXFP8, interface compatible OpenAI de SGLang | Environ 440 GB pour la version MXFP8 | Expérimental |
| MiniMax-M2.7 | 4 GPU NVIDIA à grande mémoire, TP 4 | Mémoire vidéo minimale unifiée non publiée | Preview |
| MiniMax-M3.1 Flash | Le guide de déploiement officiel ne le couvre pas encore | Non publiée | Inconnu / non publié |
Rappel : les données de M3 dans le tableau ne sont pas les exigences officielles de M3.1 Flash. Elles montrent qu’une configuration de référence officielle pour un modèle de taille comparable nécessite 8 GPU de niveau centre de données, et que les poids MXFP8 occupent à eux seuls environ 440 GB. C’est bien au-delà des capacités des cartes graphiques grand public et des stations de travail classiques. Il n’est donc pas réaliste de faire tourner la version complète chez soi avec une ou deux cartes graphiques de jeu.
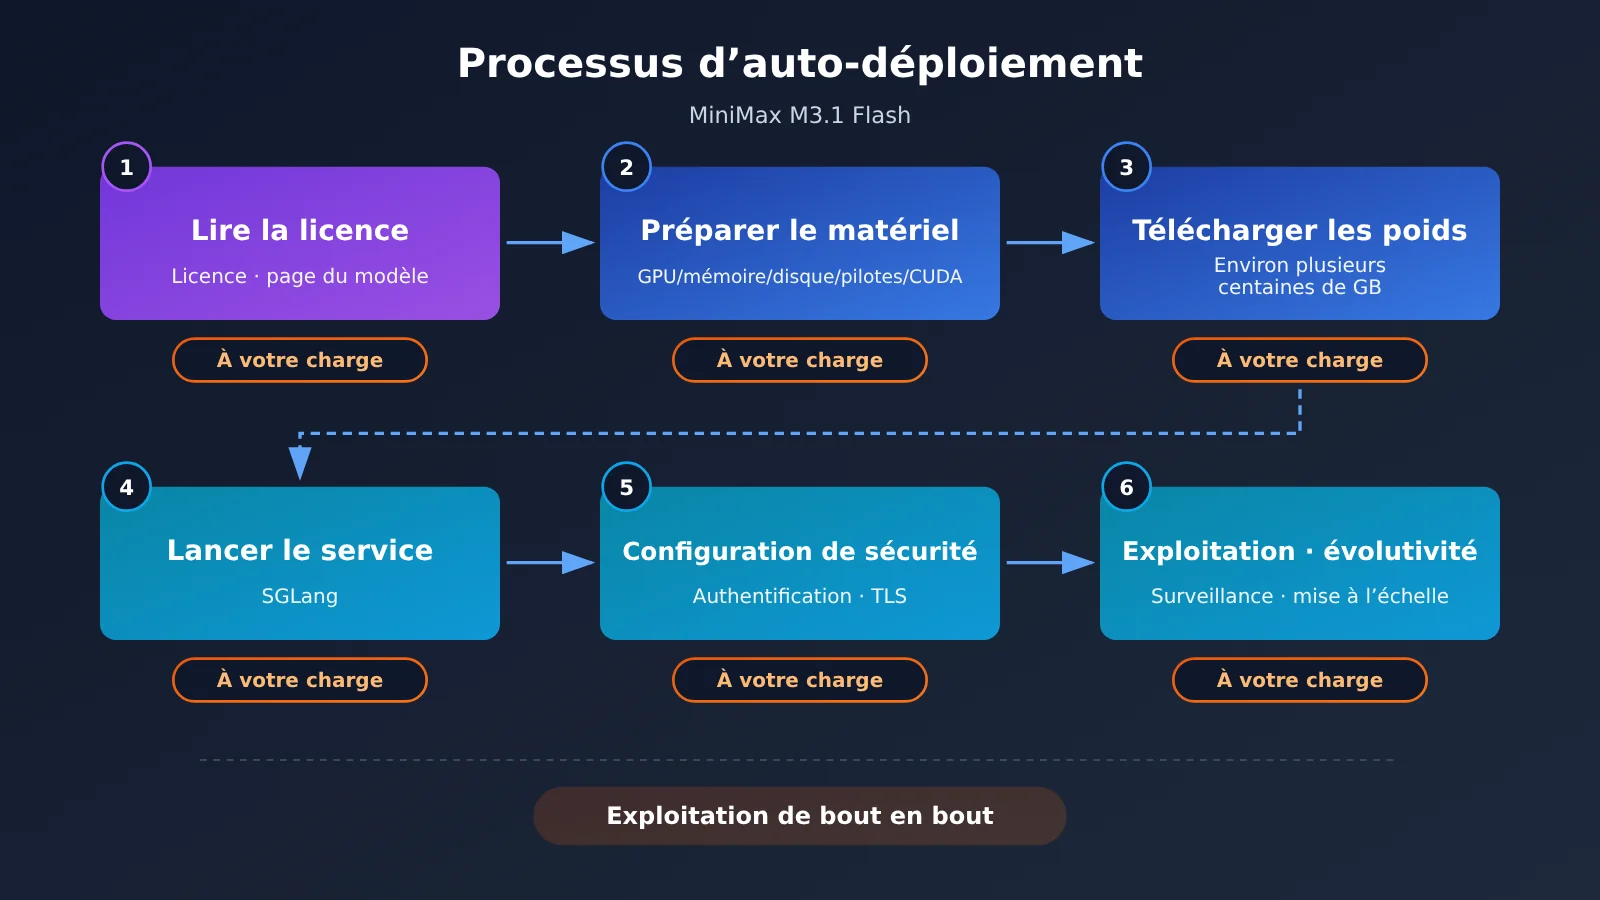
La documentation officielle de déploiement de MiniMax donne également quelques conseils à suivre avant le déploiement, applicables à tous les modèles open source :
- Commencez par lire la licence et vérifier le périmètre d’utilisation autorisé ;
- Préparez le matériel en fonction de la page du modèle : GPU, mémoire, stockage, pilotes et version de CUDA ;
- Verrouillez les versions du modèle et du framework d’inférence : évitez de suivre les branches
mainoulatestau gré des mises à jour ; - Pour les miroirs de téléchargement en Chine, utilisez uniquement les sources officielles indiquées sur la page du modèle, afin d’éviter de télécharger des fichiers altérés.
MiniMax M3.1 Flash : est-il plus avantageux de l’héberger soi-même ou d’utiliser l’API ?
C’est la question centrale de cet article. Pour y répondre, examinons quatre critères et voyons où se situe votre situation.
| Critère | Plutôt utiliser directement l’API | Plutôt héberger le modèle soi-même |
|---|---|---|
| Exigences de conformité des données | Les données peuvent être traitées par un fournisseur de services cloud | La réglementation ou le contrat exige que les données restent sur le réseau interne |
| Volume d’appels | Volume faible ou moyen, avec des pics et des creux marqués | Volume important et soutenu, permettant d’utiliser pleinement un serveur équipé de plusieurs GPU |
| Capacité de l’équipe à assurer l’exploitation | Pas de spécialiste dédié à l’exploitation des GPU | Une personne est chargée du cluster, de la supervision et des permanences |
| Besoin de modifier le modèle | Les capacités générales du modèle suffisent | Besoin d’affiner le modèle, de modifier son architecture ou de le personnaliser en profondeur |
Si au moins deux des trois premiers critères correspondent à la colonne de gauche, choisir l’API est généralement une valeur sûre.
Comment calculer le coût de l’API MiniMax M3.1 Flash
Les tarifs officiels sont fixes : 0,15 $ pour les entrées, 0,60 $ pour les sorties et 0,015 $ pour la lecture du cache. Ces prix sont calculés par million de tokens, sans supplément pour les longues fenêtres de contexte. Un token est l’unité de texte utilisée pour la facturation du modèle. Selon l’équivalence donnée par MiniMax, environ 750 mots en anglais correspondent à 1 000 tokens. La lecture du cache désigne la facturation à tarif réduit des contenus identiques envoyés à plusieurs reprises.
Prenons un exemple basé sur les tarifs officiels — il ne s’agit pas d’une mesure réelle : pour 100 millions de tokens en entrée et 20 millions en sortie par mois, le coût est de 100 × 0,15 $ + 20 × 0,60 $ = 27 $. C’est déjà un volume conséquent pour un particulier ou une petite équipe, mais cela représente seulement quelques dizaines de dollars par mois.
Pour l’auto-hébergement, le calcul est différent. Si l’on prend comme référence la configuration du M3 avec 8 × B200, l’achat ou la location de ce type de machine représente une dépense fixe et récurrente, même lorsqu’elle n’est pas utilisée. Pour amortir ce coût, il faut généralement un volume d’appels suffisamment élevé pour maintenir la machine à forte charge. La plupart des particuliers et des petites équipes n’atteignent pas ce niveau.
À noter : le processus de réflexion de M3.1 Flash ne peut pas être désactivé. Si le paramètre effort (profondeur de réflexion) n’est pas renseigné, le niveau maximal est utilisé par défaut. Les tokens de réflexion sont également comptabilisés comme des tokens de sortie. La part liée aux sorties peut donc être plus élevée que prévu sur la facture. Pour réduire les coûts, vous pouvez régler effort sur low ou medium.
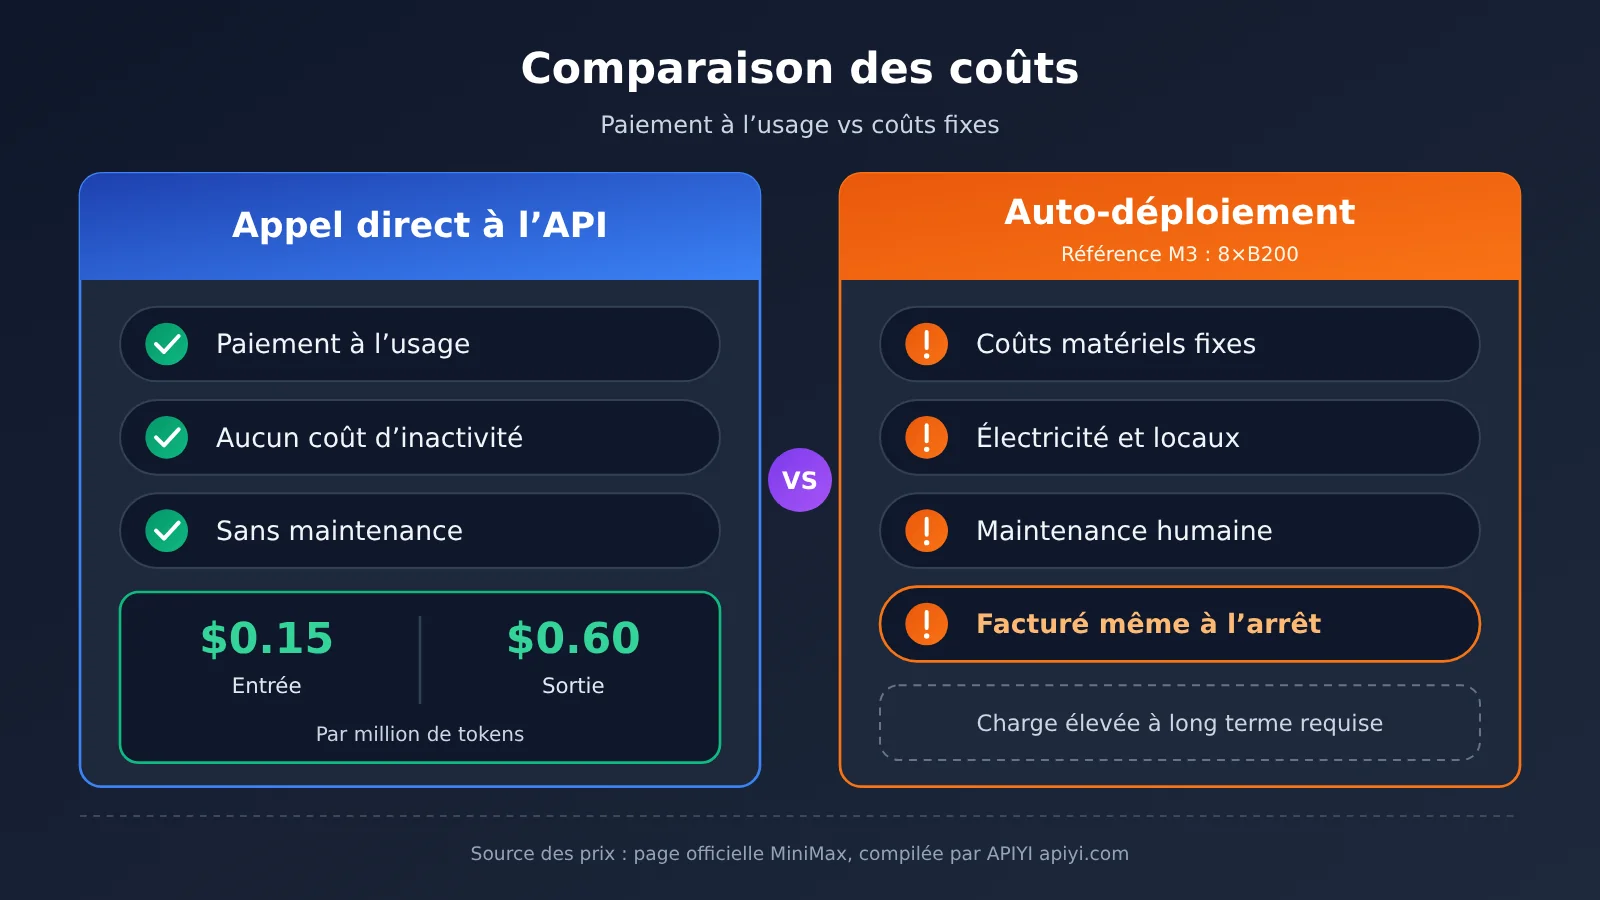
Les tarifs présentés ci-dessus proviennent de la page officielle de MiniMax et ont été compilés par l’équipe technique d’APIYI apiyi.com. Le tableau ci-dessous récapitule les tarifs officiels de quelques modèles souvent comparés :
| Modèle | Prix des entrées (par million de tokens) | Prix des sorties (par million de tokens) | Plateformes disponibles |
|---|---|---|---|
| MiniMax-M3.1-Flash | 0,15 $ | 0,60 $ | API officielle MiniMax, M Plan ; disponibilité sur APIYI à vérifier sur la page des tarifs |
| MiniMax-M3 (≤512K en entrée) | 0,30 $ | 1,20 $ | API officielle MiniMax, APIYI apiyi.com |
| claude-opus-5-5 | 4 $ | 20 $ | API officielle d’Anthropic, APIYI apiyi.com |
| claude-opus-5 | 5 $ | 25 $ | API officielle d’Anthropic, APIYI apiyi.com |
💰 Conseil pour maîtriser les coûts : si vous souhaitez tester dès maintenant les performances de la gamme MiniMax, vous pouvez commencer par appeler MiniMax-M3, déjà disponible sur APIYI apiyi.com, afin de valider votre processus. La disponibilité de M3.1 Flash sur APIYI est à vérifier sur la page des tarifs ; nous ferons au plus vite pour le proposer.
Ce que vous devrez prendre en charge après avoir auto-hébergé MiniMax M3.1 Flash
La documentation officielle de MiniMax est très claire : les poids du modèle en open source n’incluent pas les fonctionnalités de la plateforme, comme la mise en cache ou la sécurité des contenus. Par défaut, le service n’écoute que sur la machine locale. Avant de vous lancer dans l’auto-hébergement, vérifiez que quelqu’un est bien responsable de chacun des points suivants :
- Authentification : ajoutez une clé d’accès à l’interface pour éviter que n’importe qui puisse l’utiliser ;
- Chiffrement TLS : si le service est accessible depuis l’extérieur, utilisez HTTPS pour chiffrer les échanges et empêcher l’interception des données ;
- Isolation réseau : limitez l’accès au service d’inférence à certaines machines ou plages d’adresses IP ;
- Surveillance et alertes : quelqu’un doit suivre l’utilisation du GPU, la mémoire vidéo, la latence et le taux d’erreur ;
- Planification de la capacité et mise à l’échelle : préparez à l’avance une solution pour augmenter la capacité lorsque les requêtes s’accumulent aux heures de pointe ;
- Reprise après incident et mises à niveau : prévoyez comment rétablir le service en cas de panne et déployer progressivement les nouvelles versions ;
- Sécurité des contenus : vous devrez ajouter vous-même la modération des contenus entrants et sortants ;
- Conformité de la licence : lisez attentivement l’intégralité de la licence et des politiques d’utilisation avant tout déploiement, redistribution ou usage commercial.
Si personne n’est responsable de l’un de ces points, les économies réalisées sur les frais liés aux jetons risquent d’être absorbées par les coûts d’exploitation.
Que vaut MiniMax M3.1 Flash ? Déclarations officielles et évaluations indépendantes
Avant de décider si vous allez le déployer vous-même, mieux vaut connaître ses performances réelles. Le tableau ci-dessous classe les données selon leur niveau de fiabilité :
| Indicateur | Résultat | Niveau d’information |
|---|---|---|
| Automation-Bench v1.0.6 | 62,2, contre 50,3 pour Claude Opus 5 | Déclaration officielle |
| BankerToolBench | 76,2, à égalité avec Claude Opus 5 | Déclaration officielle |
| Terminal Bench 4.0 | 38,1, contre 51,8 pour Claude Opus 5 | Déclaration officielle |
| SWE Refactor Bench | 23,0, contre 31,0 pour Claude Opus 5 | Déclaration officielle |
| Vitesse de génération | Le blog annonce plus de 200 TPS au quotidien et plus de 170 en P50 ; la page produit indique environ 150 tokens par seconde | Déclaration officielle (chiffres divergents) |
| Vals Index | 53,78 % : 15e sur 22 modèles et 5e parmi les modèles à poids ouverts | Évaluation indépendante |
| Vals Terminal-Bench 4.0 | 25,25 % : 22e sur 51 modèles | Évaluation indépendante |
| « Un coût égal au tiers de celui de M3 » | Calculé par tâche, mais la méthode exacte n’a pas été publiée | Inconnu / non communiqué |
TPS désigne le nombre de tokens générés par seconde. Plus ce chiffre est élevé, plus la réponse arrive vite.
Il faut préciser le modèle de référence utilisé pour la comparaison avec Claude : dans le tableau de MiniMax, il s’agit de Claude Opus 5, et non d’Opus 5.5. Claude Opus 5.5 reste le modèle phare le plus puissant d’Anthropic. L’entreprise ne l’a pas comparé point par point à M3.1 Flash ; on ne peut donc pas conclure que ce dernier « égale ou dépasse Opus 5.5 ».
Même face à Opus 5, M3.1 Flash accuse un retard net sur les tâches de programmation et de refactorisation qui nécessitent de longues chaînes d’actions, comme Terminal Bench et SWE Refactor. Les résultats indépendants de Vals montrent eux aussi des faiblesses sur les tâches d’agent à longue chaîne d’actions.
Quand éviter MiniMax M3.1 Flash et ne pas se précipiter sur l’auto-hébergement
Dans les cas suivants, mieux vaut ne pas se lancer tout de suite :
- Planification complexe et refonte à grande échelle : les évaluations publiées par l’éditeur et les tests indépendants indiquent que le modèle est moins performant sur les tâches qui comportent de nombreuses étapes. Pour ce type de travail, un modèle phare comme Claude Opus 5.5 est un choix plus sûr.
- Latence très importante et absence de besoin en raisonnement approfondi : le mode réflexion ne peut pas être désactivé. Même réglé sur low, il entraîne un surcoût de raisonnement.
- Intégration existante qui analyse les balises
<think>de M3 : avec M3.1 Flash, le contenu de réflexion est renvoyé dans un champ distinct. Il faut donc adapter l’ancienne logique d’analyse avant de migrer. - Licence pas encore clarifiée : la licence n’avait pas été publiée au moment de la mise à disposition des poids. Évitez donc de planifier un auto-hébergement pour un projet commercial avant d’en connaître les conditions.
- Personne pour assurer l’astreinte : si personne n’est responsable de la liste de contrôle opérationnelle de la section précédente, ne faites pas reposer votre activité sur un service auto-hébergé.
- Volonté d’exécuter la version complète sur une carte graphique grand public : au vu de la taille de M3, ce n’est pas réaliste. Attendez les indications officielles sur le matériel nécessaire et méfiez-vous des versions quantifiées dont la source est incertaine.
Associer MiniMax et Claude Opus 5.5 sur APIYI
Pour la plupart des développeurs, la question la plus concrète n’est pas « auto-hébergement ou API ? », mais plutôt : comment répartir les tâches entre différents modèles selon leur difficulté ?
APIYI permet d’appeler depuis une seule clé API des modèles internationaux comme Claude, GPT et Gemini, ainsi que des modèles chinois comme DeepSeek et MiniMax. Parmi les modèles actuellement disponibles sur APIYI, on trouve MiniMax-M3 (compatible avec les formats d’API OpenAI et Anthropic, et accessible dans le groupe ClaudeCode), la série MiniMax-M2.7, ainsi que claude-opus-5-5 et claude-opus-5. À la date de publication, MiniMax-M3.1-Flash n’apparaît pas encore sur la page des tarifs d’APIYI. Vérifiez cette page pour savoir s’il est disponible.
Voici une répartition recommandée :
- Confiez les tâches répétitives et peu coûteuses à MiniMax : nettoyage de données, résumés en série, conversion de formats, complétion de code simple… Pour les tâches nombreuses mais peu difficiles prises individuellement, un prix unitaire bas est avantageux.
- Confiez la planification complexe et les refontes à Claude Opus 5.5 : refonte sur plusieurs fichiers, conception d’architecture, planification de tâches complexes pour un agent… Le coût à l’appel est plus élevé, mais les erreurs et les reprises coûtent encore plus cher.
- Changez de modèle avec la même clé API : il suffit de modifier le nom du modèle, sans avoir à gérer plusieurs comptes ni différentes adresses d’API.
🎯 Conseil technique : sur APIYI apiyi.com, utilisez la même clé API pour exécuter une fois vos tâches réelles avec MiniMax-M3 et claude-opus-5-5, puis comparez les résultats et les coûts. C’est plus fiable que n’importe quel score de benchmark.
Questions fréquentes
Q1 : Quand les poids de MiniMax M3.1 Flash seront-ils disponibles au téléchargement ?
La date prévue indiquée dans la publication officielle sur X est le 23 octobre. Le blog officiel se contente de dire « prochainement ». À la date de publication de cet article, les poids n’étaient pas encore disponibles. Consultez la page officielle du modèle MiniMax sur Hugging Face pour connaître les dernières informations.
Q2 : Une carte graphique grand public suffit-elle pour exécuter MiniMax M3.1 Flash ?
Les exigences matérielles de M3.1 Flash n’ont pas été communiquées officiellement. Pour un modèle de taille comparable, la configuration de référence officielle de M3 repose sur 8 × B200, avec des poids MXFP8 d’environ 440 Go. La version complète est donc difficilement exploitable sur une seule carte graphique grand public.
Q3 : MiniMax M3.1 Flash pourra-t-il être utilisé à des fins commerciales après sa publication en open source ?
La licence n’a pas encore été annoncée. L’équipe officielle rappelle que la publication des poids en open source ne signifie pas que tous les modèles utilisent la même licence. Avant le déploiement, la redistribution ou toute utilisation commerciale, lisez attentivement la licence complète.
Q4 : Comment essayer les modèles MiniMax à moindre coût dès maintenant ?
Le plus simple est d’utiliser directement une API. M3.1 Flash sera accessible via l’API officielle de MiniMax ou l’abonnement M Plan ; consultez le site officiel pour connaître le tarif mensuel. Si vous préférez gérer plusieurs modèles avec une seule clé, vous pouvez déjà appeler MiniMax-M3, disponible sur APIYI, à l’adresse apiyi.com. Pour savoir si M3.1 Flash est accessible, consultez la page des tarifs d’APIYI.
Q5 : MiniMax M3.1 Flash peut-il remplacer Claude Opus 5.5 ?
Ce n’est pas la bonne façon de voir les choses. La comparaison officielle porte uniquement sur Claude Opus 5, et MiniMax M3.1 Flash est moins performant sur les tâches de programmation qui impliquent de longues chaînes d’étapes. Il est plus judicieux de répartir les rôles : MiniMax pour les tâches en masse, et Opus 5.5 pour la planification complexe et les refactorisations. Avec APIYI, une seule clé suffit pour combiner les deux.
MiniMax M3.1 Flash : points clés sur les poids ouverts
- Les poids ne sont pas encore disponibles : leur publication est prévue le 23 octobre. Référez-vous à la page officielle du modèle sur Hugging Face.
- La licence et la configuration matérielle requise n’ont pas été annoncées : évitez d’acheter du matériel ou de planifier un déploiement sur la base de suppositions.
- Un ordre de grandeur comparable à M3 : 8 × B200 et environ 440 Go de poids au format MXFP8, soit une infrastructure de centre de données.
- L’API est plus avantageuse : à 0,15 $/0,60 $, elle est bien plus simple à utiliser que l’auto-hébergement pour la plupart des particuliers et des petites équipes.
- L’auto-déploiement ne convient qu’à des cas limités : exigences strictes de conformité, très gros volumes d’appels ou besoin de modifier le modèle.
- La comparaison porte sur Opus 5 : Opus 5.5 reste le modèle phare le plus puissant d’Anthropic, et l’entreprise n’a pas publié de comparaison détaillée.
- Combinez les modèles : sur APIYI apiyi.com, utilisez une seule clé pour associer MiniMax et Claude Opus 5.5.
Résumé
Les points essentiels sur les poids ouverts de MiniMax M3.1 Flash :
- Disponibilité : la publication des poids est prévue le 23 octobre. La licence et les exigences matérielles de déploiement n’ont pas encore été annoncées. La page officielle du modèle fait foi.
- Configuration : pour un modèle de taille comparable, la configuration officielle de M3 repose sur 8 GPU de classe B200, hors de portée d’un équipement personnel.
- Décision : évaluez la conformité, le volume d’appels, les capacités d’exploitation et le besoin de modifier le modèle. Dans la plupart des cas, l’API est plus avantageuse.
Une fois les poids disponibles, commencez par lire la licence et les recommandations matérielles officielles avant de décider de l’héberger vous-même. Pour les besoins métier, une approche plus réaliste consiste à choisir un modèle adapté à la difficulté de chaque tâche. Vous pouvez tester la combinaison de la gamme MiniMax et de claude-opus-5-5 avec une seule clé sur APIYI apiyi.com.
📚 Références
- Article officiel de MiniMax : annonce de M3.1 Flash et données communiquées par l’entreprise
- Lien :
minimax.io/blog/minimax-m31f -
À retenir : les prix, la vitesse et les poids du modèle seront publiés ultérieurement, selon l’annonce officielle
-
Page officielle des tarifs de MiniMax : tarifs à l’usage des différents modèles
- Lien :
platform.minimax.io/docs/guides/pricing -
À retenir : comparaison des tarifs de M3.1 Flash et de M3
-
Guide officiel de déploiement local de MiniMax : configurations de référence pour le déploiement des modèles open source
- Lien :
platform.minimax.io/docs/guides/local-deploy -
À retenir : configuration de référence de M3 avec 8 × B200 et précautions liées au déploiement local
-
Page d’évaluation de Vals AI : résultats de l’évaluation indépendante de M3.1 Flash
- Lien :
vals.ai/models/minimax_MiniMax-M3.1-flash -
À retenir : classement dans le Vals Index et scores par catégorie
-
Hugging Face – MiniMax-M3 : poids de M3 et licence communautaire
- Lien :
huggingface.co/MiniMaxAI/MiniMax-M3 -
À retenir : une fois les poids de M3.1 Flash publiés, ils pourront être consultés sous la même organisation
-
Documentation de SGLang – MiniMax-M3 : instructions de déploiement avec un moteur d’inférence
- Lien :
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - À retenir : taille de la version MXFP8 de M3 et instructions d’exécution
Auteur : équipe technique d’APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site d’APIYI. Pour plus de ressources, consultez le centre de documentation sur docs.apiyi.com.