gemini-4-argon est sorti le 13 octobre 2026. Dès son intégration, de nombreux développeurs ont rencontré des erreurs 429 : dès que la concurrence augmente, les requêtes échouent, et il arrive même qu’une requête isolée soit refusée. Beaucoup en concluent que « la limite de requêtes simultanées d’AI Studio est trop basse », mais cette explication est probablement fausse. Cet article détaille le véritable mécanisme de limitation de gemini-4-argon sur AI Studio et propose des solutions concrètes aux erreurs 429.
Cet article ne se contente pas de répéter qu’il suffit d’ajouter des tentatives. Commençons par clarifier un point essentiel : Google n’a pas publié de limite fixe et universelle concernant le nombre de requêtes simultanées pour gemini-4-argon. Les chiffres qui circulent en ligne, comme « 10 requêtes simultanées » ou « 50 », ne reposent donc sur aucune source fiable.
Ce que vous allez apprendre : à la fin de cet article, vous saurez distinguer quatre causes d’erreurs 429 — RPM, TPM, débit de consommation et capacité de l’infrastructure en amont. Vous découvrirez aussi comment mettre en œuvre le recul exponentiel et la limitation du débit, et comment utiliser le canal haute capacité d’APIYI, sur apiyi.com, pour contourner les limites de quota d’un projet AI Studio.
Points clés sur gemini-4-argon
Commençons par résumer les conclusions dans un tableau. Les sections suivantes les détaillent une à une.
| Point clé | Explication | Intérêt |
|---|---|---|
| Aucune limite fixe de concurrence n’est publiée | Google n’a pas publié de limite de concurrence uniforme pour gemini-4-argon. La limitation repose sur des indicateurs comme les RPM, les TPM et les RPD. | Éviter de planifier la capacité à partir d’un chiffre erroné |
| Les RPM ne correspondent pas à la concurrence | Le nombre de requêtes en cours dépend de leur durée moyenne, et pas seulement du nombre de requêtes par minute. | Estimer correctement ses besoins en concurrence |
| Les limites sont calculées par projet | Créer plusieurs clés dans un même projet ne multiplie pas le quota. | Ne plus perdre de temps à faire tourner les clés |
| Plafond de consommation sur 10 minutes | Le plafond est de 10 $ pour le Tier 1, 50 $ pour le Tier 2 et 200 $ pour le Tier 3. | Comprendre pourquoi une erreur 429 peut survenir même sans dépasser les RPM |
| Les erreurs 429 se traitent par étapes | Il faut d’abord examiner la réponse brute, puis limiter le débit, appliquer un délai exponentiel, changer de canal ou demander une hausse du quota. | Résoudre le problème progressivement, par ordre de priorité |
| Canal APIYI à forte concurrence | APIYI, sur apiyi.com, prend en charge une forte concurrence pour gemini-4-argon. En dessous de 500 RPM, vous n’avez pas à vous soucier de la limitation de débit. | Une solution directe pour les projets de petite et moyenne envergure |
Pourquoi une erreur 429 ne signifie pas forcément que la concurrence est trop élevée
Beaucoup de développeurs assimilent une erreur 429 à une « concurrence trop élevée ». Pourtant, dans le système de limitation de débit de Google, la concurrence n’est pas un indicateur distinct. Une erreur 429 RESOURCE_EXHAUSTED peut être déclenchée par le nombre de requêtes par minute, le nombre de jetons d’entrée par minute, le nombre de requêtes par jour, le montant consommé sur une fenêtre glissante de 10 minutes ou encore une capacité amont insuffisante au début du déploiement d’un nouveau modèle.
gemini-4-argon a été lancé il y a moins d’une semaine et les ressources amont sont encore en cours de montée en charge. Même si votre quota est suffisant, une saturation temporaire peut entraîner le rejet de vos requêtes. La première étape pour diagnostiquer une erreur 429 consiste donc toujours à en déterminer la cause précise, plutôt qu’à réduire aveuglément la concurrence.
Quel est le niveau de concurrence de gemini-4-argon dans AI Studio ?
Réponse directe : il n’existe pas de valeur fixe publique et uniforme. Dans AI Studio, chaque projet dispose de quotas RPM, TPM et RPD qui lui sont propres pour gemini-4-argon. Les valeurs exactes varient selon le niveau Tier et l’état du projet : consultez-les dans l’interface d’administration.
Les cinq types de limites dans AI Studio
Les mécanismes de limitation appliqués par Google peuvent être résumés dans le tableau ci-dessous. Le dépassement de l’une de ces limites peut entraîner une erreur 429.
| Indicateur de limite | Signification | Peut-il provoquer une erreur 429 ? |
|---|---|---|
| RPM | Nombre de requêtes par minute | Oui |
| TPM | Nombre de jetons d’entrée par minute | Oui |
| RPD | Nombre de requêtes par jour | Oui |
| Débit de consommation | Montant consommé par l’API sur une fenêtre glissante de 10 minutes | Oui |
| Capacité réelle du service | Ressources disponibles en amont chez Google | Possible |
À noter : un manque de capacité est un cas que vous ne pouvez pas résoudre en ajustant vos paramètres. Vous pouvez seulement le gérer en réduisant le trafic, en réessayant plus tard ou en changeant de canal.
Relation entre les RPM et la concurrence
Les RPM désignent le nombre total de requêtes sur une minute ; la concurrence correspond au nombre de requêtes en cours au même moment. C’est la durée des requêtes qui relie ces deux mesures. Prenons un projet limité à 60 RPM (il s’agit d’un exemple de calcul, et non du quota réel d’Argon) :
- Avec une durée moyenne de 5 secondes par requête, le nombre moyen théorique de requêtes en cours est d’environ 5.
- Avec une durée moyenne de 30 secondes par requête, il est d’environ 30.
- Envoyer 60 requêtes d’un coup peut entraîner une limitation temporaire ou un problème de capacité, même si le total sur une minute reste dans la limite.
Ce troisième cas est souvent négligé. Beaucoup de scripts de test de charge envoient toutes les requêtes simultanément. Ce pic de trafic risque davantage de déclencher une limitation qu’un flux régulier, même si le volume total respecte parfaitement les règles.
Comment consulter les quotas réels de gemini-4-argon dans l’interface d’administration
Ouvrez la page Rate Limits de Google AI Studio (à l’adresse aistudio.google.com/usage, puis sélectionnez l’onglet rate-limit). Vous pouvez également y accéder depuis la documentation officielle sur les limites de débit : ai.google.dev/gemini-api/docs/rate-limits. Sélectionnez le projet concerné et gemini-4-argon pour afficher les RPM, TPM et RPD applicables, ainsi que le niveau Tier actuel.
Google précise que les limites sont calculées par projet, et non par clé API. Autrement dit, créer autant de clés que vous le souhaitez dans un même projet ne multipliera pas votre quota. La stratégie consistant à faire tourner plusieurs clés pour augmenter la capacité ne fonctionne donc pas dans AI Studio.
5 causes fréquentes des erreurs 429 avec gemini-4-argon
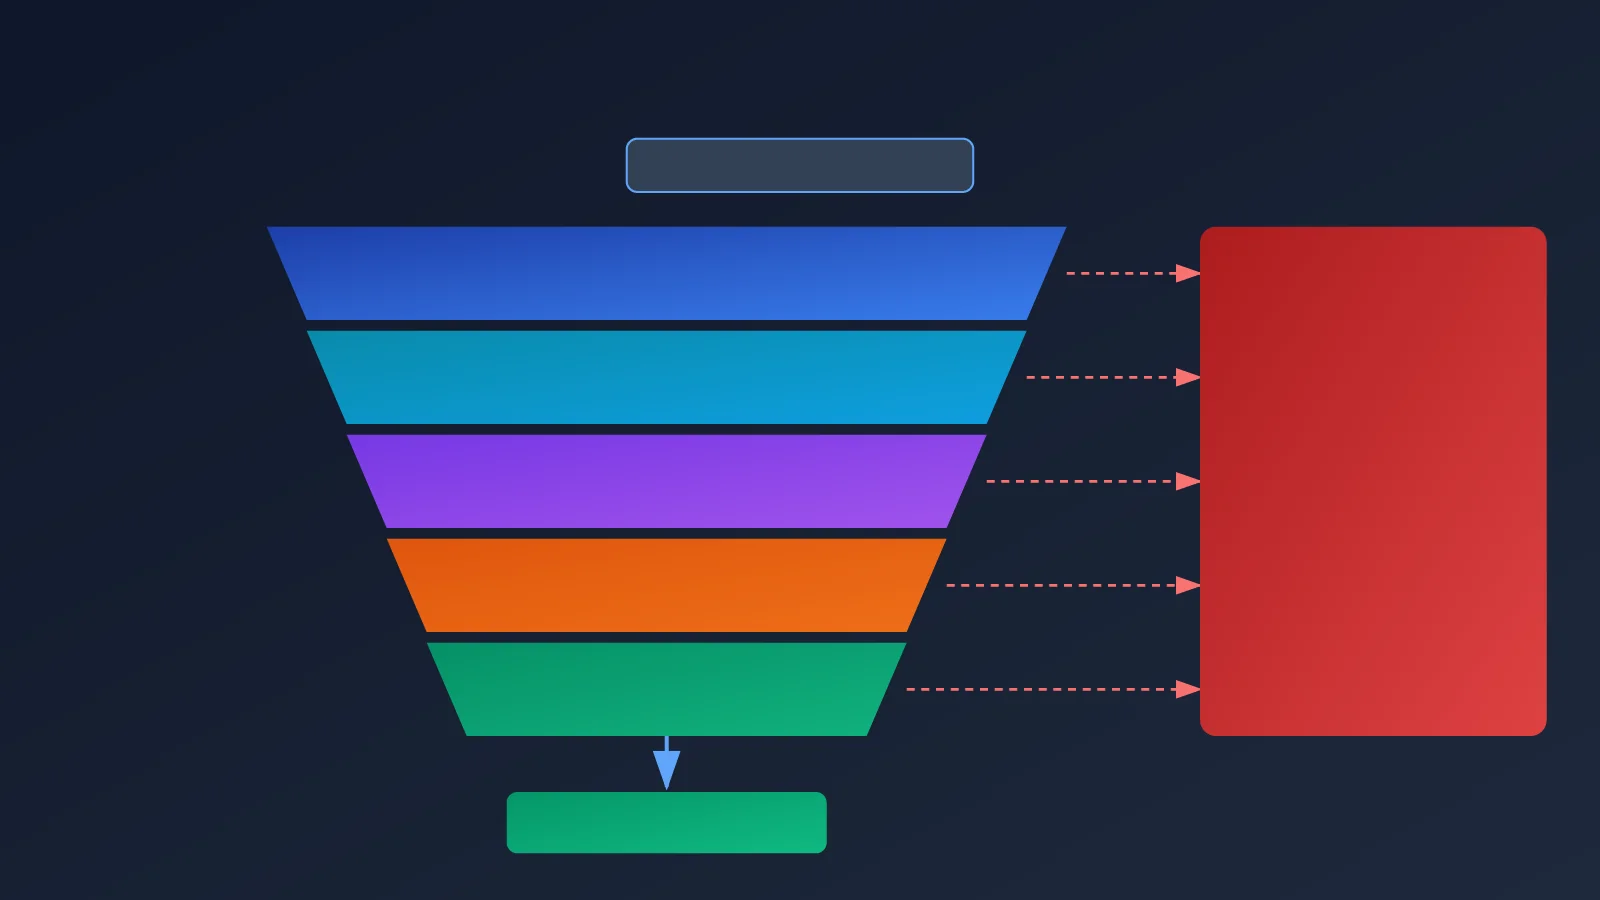
Maintenant que les limites sont plus claires, passons aux cas concrets. Les cinq causes ci-dessous couvrent la grande majorité des erreurs 429 signalées avec gemini-4-argon.
- Débit instantané de requêtes trop élevé : des tâches par lots ou des scripts de test de charge envoient beaucoup de requêtes d’un seul coup, provoquant un pic qui dépasse la capacité instantanée en RPM.
- Limite de TPM atteinte : les longs contextes et les documents volumineux consomment rapidement des tokens. Même avec peu de requêtes, la limite de TPM peut être atteinte en premier.
- Limite de dépenses sur 10 minutes atteinte : c’est l’une des limites les plus faciles à oublier. Nous y revenons juste après.
- Quota quotidien de RPD épuisé : si les erreurs 429 apparaissent après un certain temps, c’est souvent le signe que le quota journalier est épuisé.
- Capacité insuffisante en amont : les ressources peuvent être limitées au lancement d’un nouveau modèle. Des requêtes peuvent alors être refusées même si le quota est suffisant.
Une cause facile à oublier : la limite de dépenses sur 10 minutes
D’après la documentation officielle de Google, mise à jour le 15 octobre 2026, chaque niveau de compte est soumis à une limite de dépenses sur une fenêtre glissante de 10 minutes.
| Niveau du compte | Limite de dépenses par période de 10 minutes |
|---|---|
| Tier 1 | 10 $ |
| Tier 2 | 50 $ |
| Tier 3 | 200 $ |
Par exemple, si un compte Tier 1 dépense au total 10 $ en 10 minutes, il peut recevoir une erreur 429 RESOURCE_EXHAUSTED, même si les limites de RPM et de TPM ne sont pas dépassées. Comme gemini-4-argon est un modèle de nouvelle génération, le coût d’une invocation peut être supérieur à celui des anciens modèles. Les requêtes avec un long contexte font aussi grimper les dépenses plus rapidement. C’est une cause fréquente de limitation même lorsque le volume de requêtes semble faible.
À noter également : les quotas de l’API Argon Batch indiqués dans la documentation de Google correspondent aux quotas de tokens de la file de traitement par lots. Ils ne doivent pas être considérés comme des quotas de concurrence pour l’API en temps réel.
Comment déterminer l’origine des erreurs 429 avec gemini-4-argon ?
Les symptômes varient selon la cause. Une enquête ciblée est bien plus efficace que des ajustements au hasard.
| Symptôme | Pistes à vérifier en priorité | Solutions à envisager |
|---|---|---|
| Les erreurs 429 se multiplient dès que la concurrence augmente | Débit instantané des requêtes, RPM, capacité en amont | Effectuez un test de charge progressif en répartissant les requêtes dans le temps. Une concurrence fixe ne garantit pas un RPM fixe. |
| Les erreurs 429 apparaissent après un certain temps | Limite de dépenses sur 10 minutes, RPD, accumulation de TPM | Consultez la courbe des dépenses et l’utilisation du quota journalier. |
| Des erreurs 429 surviennent avec une seule requête ou une concurrence très faible | Capacité insuffisante en amont, compte ou projet limité | Consultez la réponse brute et envisagez de changer de canal. |
| Plusieurs clés API rencontrent des erreurs 429 en même temps | Les clés appartiennent au même projet et partagent le quota | Réduisez le trafic total du projet ou passez par un canal disposant d’un quota indépendant. |
Deux informations sont particulièrement utiles pour le diagnostic : le niveau de votre compte AI Studio (Tier 1, 2 ou 3) et le contenu brut de l’erreur 429, notamment error.message, error.details et l’en-tête de réponse Retry-After. Ces éléments suffisent généralement à déterminer si le problème vient d’un quota de compte trop faible, d’un trafic trop important ou d’une offre insuffisante pour le nouveau modèle Argon de Google. Ces trois situations ne se résolvent pas de la même manière.
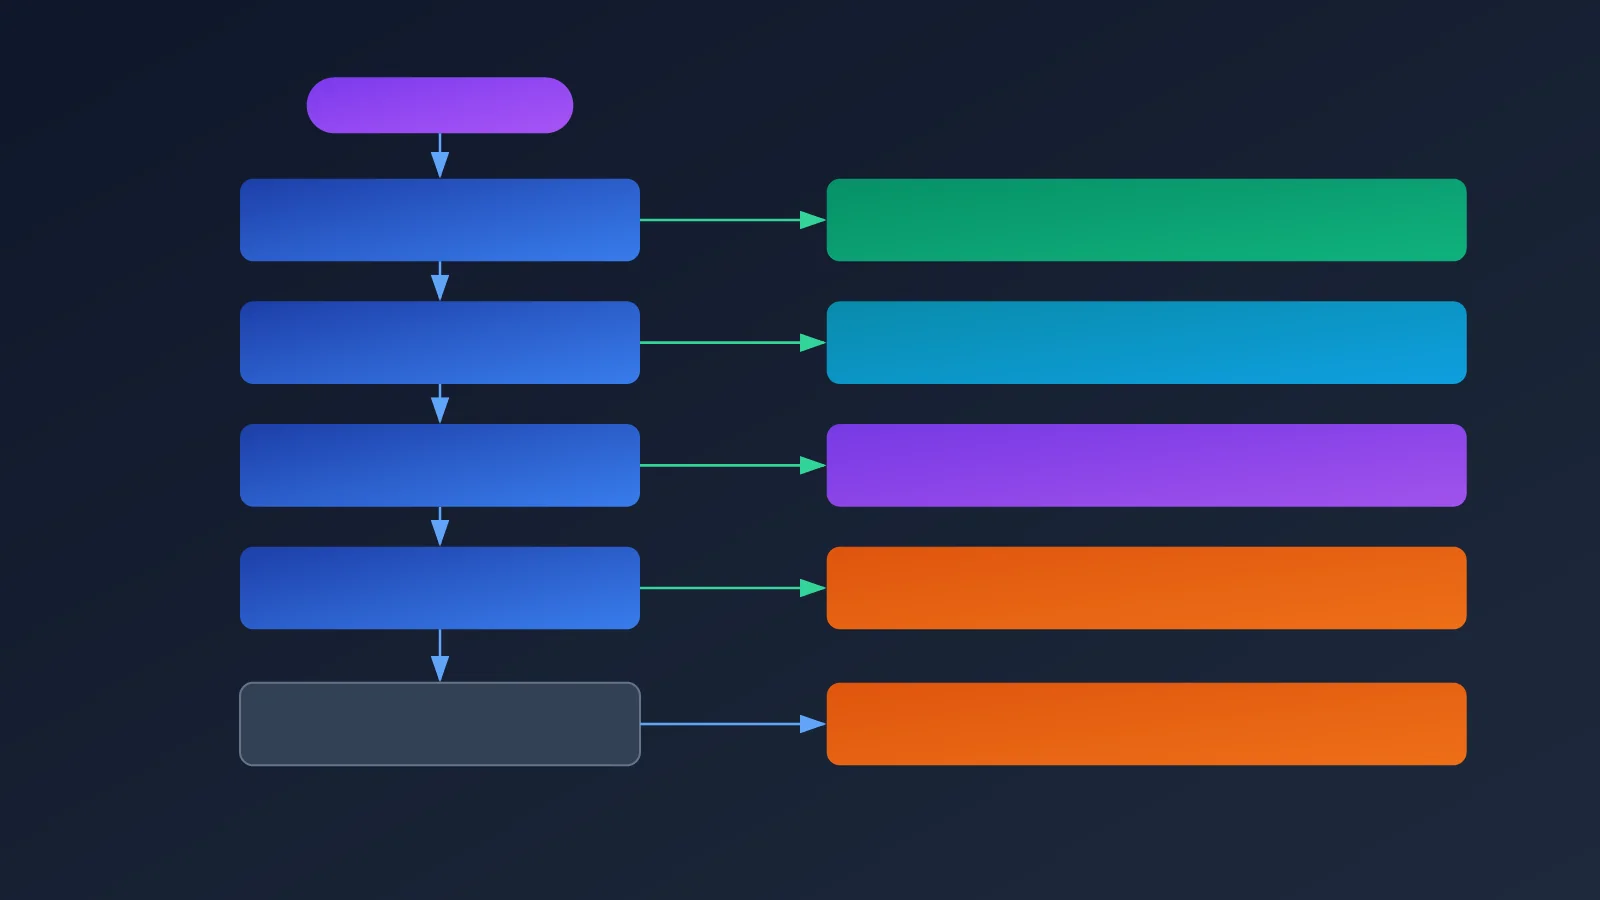
6 étapes pour résoudre les erreurs 429 de gemini-4-argon
Voici les mesures à prendre, classées par priorité. Les actions P0 sont indispensables et doivent être appliquées en premier. Les actions P2 relèvent plutôt d’une stratégie à long terme.
| Priorité | Mesure | Objectif |
|---|---|---|
| P0 | Examiner la réponse 429 complète et Retry-After |
Identifier la cause précise de la limitation |
| P0 | Configurer des limites de RPM, de TPM et de consommation par projet | Éviter de dépasser continuellement les quotas |
| P0 | Réessayer après une erreur 429 avec un délai exponentiel et une gigue aléatoire | Atténuer les limitations soudaines |
| P1 | En cas de 429, basculer automatiquement vers un canal opérationnel doté d’un quota indépendant | Augmenter le taux de réussite |
| P1 | Passer à un niveau supérieur ou demander une augmentation de quota à Google | Accroître la capacité à long terme |
| P2 | Évaluer Vertex AI ou d’autres canaux officiellement autorisés | Élargir les ressources disponibles |
Étape 1 : comprendre la réponse 429 complète
Ne vous contentez pas de repérer le code d’état avant de relancer la requête. Commencez par afficher le corps complet de l’erreur et les en-têtes de réponse. Examinez en particulier error.message, error.details et Retry-After. Si le service en amont vous indique combien de temps attendre, respectez ce délai au lieu d’en choisir un au hasard.
Étape 2 : limiter le débit côté client
Fixez le RPM à 70–80 % de la limite visible dans le tableau de bord, gérez le TPM séparément et surveillez également le montant dépensé sur une période de 10 minutes. Cette marge permet d’absorber les pics de trafic et les fluctuations du service en amont. De nombreuses équipes limitent seulement le nombre de requêtes et négligent les tokens et les dépenses. Résultat : elles se font bloquer alors qu’elles n’ont « même pas dépassé le RPM ».
Étape 3 : appliquer un délai exponentiel avec une gigue aléatoire
Google recommande d’utiliser un délai exponentiel en cas de 429 : attendez par exemple 1, 2, 4, puis 8 secondes, en ajoutant une gigue aléatoire. Cela évite qu’un grand nombre de requêtes soient relancées en même temps et provoquent un nouvel engorgement. Limitez-vous à 2 ou 3 nouvelles tentatives et respectez en priorité le délai indiqué par le service en amont.
Étape 4 : changer de canal en cas de 429 récurrentes
Si un même projet renvoie continuellement des erreurs 429, ne continuez pas à lui envoyer des requêtes : cela ne ferait qu’aggraver la limitation. Réduisez plutôt le trafic ou basculez vers un canal opérationnel doté d’un quota indépendant. C’est là que les services d’agrégation montrent leur intérêt : en passant par l’API APIYI, apiyi.com, les requêtes peuvent être réparties entre plusieurs canaux aux quotas indépendants. Un seul projet AI Studio n’a donc pas à supporter toute la charge.
Étape 5 : passer à un niveau supérieur ou demander une augmentation de quota
À long terme, le manque de capacité se règle en passant à un niveau de compte supérieur ou en demandant une augmentation de quota à Google. Avec un niveau supérieur, les limites RPM et TPM sont assouplies, et le plafond de dépenses sur 10 minutes passe de 10 $ à 50 $, voire 200 $. Mais l’augmentation de quota prend du temps et dépend de l’historique des dépenses : elle arrive généralement trop tard pour le calendrier d’un lancement.
Étape 6 : évaluer d’autres canaux officiellement autorisés
Si votre activité continue de croître, envisagez Vertex AI ou d’autres canaux officiellement autorisés pour élargir les ressources disponibles. Faire fonctionner plusieurs canaux en parallèle est également un moyen fiable de réduire les risques liés à un point de défaillance unique.
Conseils pour tester la charge d’un nouveau canal
Pour un nouveau canal utilisant Argon, commencez les tests de charge avec une concurrence de 5 à 10 requêtes. Attention : il s’agit uniquement d’un paramètre de départ pour les tests, et non d’une limite officielle de concurrence. Augmentez ensuite progressivement la charge, par paliers, en envoyant les requêtes de manière régulière à chaque niveau. Suivez séparément, par fournisseur, projet Google et modèle, le taux de 429, le RPM réel, le TPM, les dépenses sur 10 minutes et la durée des requêtes. Passez au palier suivant une fois la stabilité confirmée.
Prise en main rapide de gemini-4-argon : effectuer un appel avec APIYI
Passons de la théorie au code. APIYI fournit une interface compatible avec OpenAI : il suffit de remplacer base_url pour appeler gemini-4-argon.
Exemple minimal
Il suffit d’un peu plus de 10 lignes de code pour effectuer un appel :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Utilisez l’interface unifiée d’APIYI
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
Afficher le code complet : appels concurrents avec délai exponentiel, gigue aléatoire et Retry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Utilisez l’interface unifiée d’APIYI
)

MAX_RETRIES = 3       # 2 à 3 nouvelles tentatives au maximum
BASE_DELAY = 1.0      # Point de départ du délai exponentiel : 1, 2, 4, 8 secondes


def call_argon(prompt: str) -> str:
    """Appelle gemini-4-argon ; en cas de 429, applique un délai exponentiel et respecte en priorité Retry-After."""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # Utiliser en priorité la valeur Retry-After renvoyée par le service en amont
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # Ajouter une gigue aléatoire pour éviter les nouvelles tentatives simultanées
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # Commencez les tests de charge avec une concurrence de 5 ; ce n’est pas une limite officielle
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
Pour démarrer rapidement : nous vous recommandons de vous inscrire sur APIYI, apiyi.com, et d’y obtenir une clé API. Vous pourrez ensuite vérifier directement le fonctionnement de gemini-4-argon avec le code ci-dessus. La plateforme fournit une interface unifiée compatible avec OpenAI : inutile de demander et de gérer vous-même plusieurs projets Google.
Implémentation simple d’une limite de débit côté client
Au-delà des nouvelles tentatives, l’essentiel est de « moins se heurter aux limites ». Voici un limiteur minimal basé sur le principe du seau à jetons. Il régularise le rythme des requêtes et évite les pics :
import threading
import time


class RateLimiter:
    """Laisse passer les requêtes à un rythme constant selon le RPM cible pour éviter les pics instantanés"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # Réglez cette valeur à 70–80 % de la limite indiquée dans le tableau de bord

# À exécuter avant chaque appel :
# limiter.wait()
Placez le limiteur à l’entrée de la fonction d’appel et combinez-le avec les nouvelles tentatives à délai exponentiel présentées plus haut. Vous obtenez ainsi une double protection : une limitation proactive du débit et un mécanisme de recul en cas d’erreur.
La voie à haut débit de gemini-4-argon sur APIYI
La principale limite d’une connexion directe à AI Studio, c’est que le quota est fixe pour chaque projet. Les comptes Tier 1 doivent aussi composer avec un plafond de consommation de 10 $ sur une période de 10 minutes. Un service d’agrégation peut répartir le trafic entre plusieurs canaux disposant de quotas indépendants, puis basculer automatiquement vers un canal opérationnel lorsqu’un canal renvoie des erreurs 429 de manière répétée.
APIYI apiyi.com prend actuellement en charge gemini-4-argon à haut débit. En dessous de 500 RPM, vous n’avez pas à vous soucier des limitations de débit : vous pouvez l’utiliser directement. Pour la plupart des applications de petite ou moyenne envergure, des outils internes, des workflows automatisés et des tests de charge, cette capacité suffit à répondre aux besoins courants. Vous n’avez donc plus à vous préoccuper du niveau Tier, des quotas de projet ni de la fenêtre de consommation de 10 minutes.
| Critère de comparaison | Connexion directe à AI Studio | Appel via APIYI |
|---|---|---|
| Attribution des quotas | Un seul projet, quota partagé entre plusieurs clés | Quotas indépendants sur plusieurs canaux, répartis par la plateforme |
| Gestion des erreurs 429 | Implémenter soi-même le délai exponentiel et le basculement | La plateforme privilégie le basculement vers un canal opérationnel ; le client peut se contenter d’une logique de nouvelle tentative de base |
| Contraintes de consommation | Soumis au plafond de consommation de 10 minutes du niveau Tier | Pas besoin de gérer soi-même le niveau du compte Google |
| Mise en place | Demander un projet et configurer le niveau Tier | Interface compatible avec OpenAI ; il suffit de remplacer base_url |
| Échelle adaptée | Faible trafic ou niveau Tier supérieur | En dessous de 500 RPM, pas besoin de se soucier des limitations de débit |
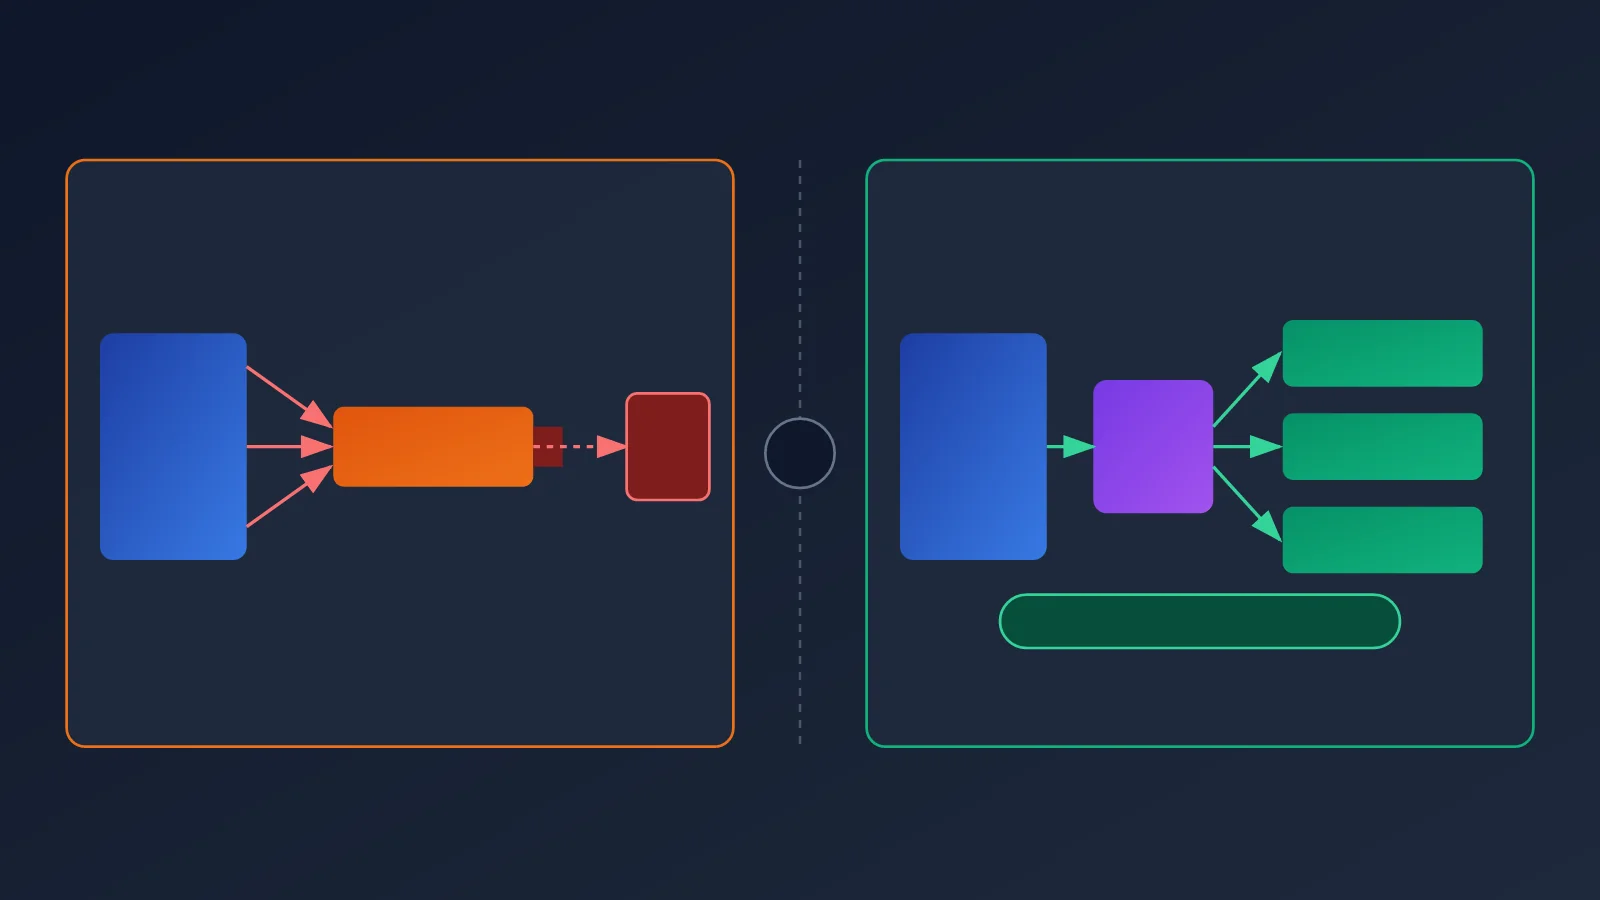
🎯 Conseil technique : si les pics de votre activité restent sous 500 RPM, vous pouvez appeler gemini-4-argon directement via APIYI apiyi.com et vous concentrer sur la logique métier. Si vous prévoyez un trafic supérieur, commencez par effectuer des tests de charge par paliers et contactez la plateforme à l’avance pour organiser la capacité nécessaire.
Même avec une voie à haut débit, il reste recommandé de conserver côté client un mécanisme de délai exponentiel et des délais d’expiration adaptés. Des variations du réseau ou de brèves perturbations en amont peuvent survenir ; une bonne logique de nouvelle tentative aidera votre service à rester stable, même dans les situations extrêmes.
FAQ : questions fréquentes
Q1 : quel est le nombre maximal de requêtes simultanées pour gemini-4-argon dans AI Studio ?
Google ne publie pas de limite fixe et universelle de requêtes simultanées. En pratique, les limites dépendent des RPM, des TPM, des RPD et du plafond de consommation sur 10 minutes du projet. Consultez la page Rate Limits d’AI Studio en sélectionnant le projet et le modèle concernés. Les chiffres qui circulent en ligne ne sont pas confirmés officiellement et ne constituent pas une base fiable pour planifier la capacité.
Q2 : créer plusieurs clés API permet-il d’augmenter le quota de gemini-4-argon ?
Non. Google précise que les limites s’appliquent au projet, et non à chaque clé API. Plusieurs clés d’un même projet partagent donc le même quota. Pour disposer de quotas réellement distincts, il faut utiliser différents projets Google ou recourir à un service d’agrégation multicanal comme APIYI, sur apiyi.com.
Q3 : pourquoi est-ce que je reçois une erreur 429 alors que je ne dépasse ni les RPM ni les TPM ?
La cause la plus fréquente est le dépassement du plafond de consommation sur 10 minutes : 10 $ pour le niveau 1, 50 $ pour le niveau 2 et 200 $ pour le niveau 3. Au début du déploiement d’un nouveau modèle, une capacité insuffisante en amont peut également entraîner le rejet de requêtes pourtant dans les limites du quota. Consultez aussi `error.details` dans le corps de l’erreur d’origine pour confirmer la cause.
Q4 : quelle est la bonne façon de réessayer après une erreur 429 ?
Appliquez un délai exponentiel, par exemple 1, 2, 4 puis 8 secondes, avec une part de hasard pour éviter que les requêtes ne repartent toutes en même temps. Limitez-vous à 2 ou 3 tentatives et respectez en priorité l’en-tête `Retry-After`, s’il est présent. Si les erreurs 429 persistent pour un même projet, réduisez le trafic ou passez à un canal disposant d’un quota indépendant au lieu de continuer à réessayer.
Q5 : comment appeler rapidement gemini-4-argon via APIYI ?
1. Rendez-vous sur APIYI, à l’adresse apiyi.com, créez un compte et obtenez une clé API.
2. Définissez `base_url` dans votre code sur `https://api.apiyi.com/v1`.
3. Indiquez `gemini-4-argon` comme nom de modèle pour exécuter les exemples de code de cet article.
APIYI prend en charge les appels à gemini-4-argon à grande échelle. En dessous de 500 RPM, vous n’avez pas à vous préoccuper de la limitation de débit. C’est une solution adaptée aux tests rapides et aux déploiements de petite ou moyenne envergure.
Q6 : est-ce que je risque encore de recevoir des erreurs 429 avec APIYI ?
Dans le cadre d’une utilisation normale, en dessous de 500 RPM, la limitation de débit ne devrait généralement pas être un problème. Toutefois, tout service en amont peut connaître des perturbations passagères. Il est donc conseillé de conserver un mécanisme de nouvelle tentative avec délai exponentiel. Si votre trafic risque de dépasser ce seuil, commencez par effectuer un test de charge progressif et vérifiez la capacité disponible avec APIYI sur apiyi.com.
Q7 : le quota de l’API Batch peut-il servir de référence pour le nombre de requêtes simultanées en temps réel ?
Non. Le quota de l’API Batch d’Argon indiqué dans la documentation Google correspond au quota de jetons de la file de traitement par lots, destinée aux tâches hors ligne. Il relève d’un système distinct des limites de requêtes simultanées et de RPM de l’API en temps réel. Ces quotas ne sont pas interchangeables.
Points clés sur les erreurs 429 de gemini-4-argon
- Pas de limite fixe de requêtes simultanées : Google n’a pas publié de plafond universel pour gemini-4-argon. Fiez-vous aux quotas réellement affichés dans votre console.
- Les RPM ne correspondent pas au nombre de requêtes simultanées : celui-ci dépend de la durée des requêtes. Un pic de trafic risque davantage de déclencher une limitation qu’un flux régulier.
- Les limites s’appliquent au projet : plusieurs clés API n’augmentent pas la capacité, car elles partagent le quota du projet.
- Attention au plafond de consommation sur 10 minutes : il est de 10 $, 50 $ et 200 $ pour les niveaux 1 à 3. Une erreur 429 peut survenir même si les RPM ne sont pas dépassés.
- Combinez délai exponentiel, limitation du débit et changement de canal : ajoutez une part de hasard aux délais exponentiels et, si les erreurs 429 persistent, passez à un canal disposant d’un quota indépendant.
- Gérez plus facilement les volumes importants : APIYI, sur apiyi.com, prend en charge les appels à gemini-4-argon à grande échelle. En dessous de 500 RPM, vous n’avez pas à vous préoccuper de la limitation de débit.
Résumé
Les erreurs 429 fréquentes avec gemini-4-argon sur AI Studio ne sont pas principalement dues à un « niveau de concurrence trop faible », mais à la combinaison de plusieurs limites : RPM, TPM, RPD, débit de consommation sur 10 minutes et capacité disponible en amont pour les nouveaux modèles. La solution doit elle aussi être progressive : commencez par examiner la réponse brute, puis limitez activement le débit. Ajoutez ensuite un backoff exponentiel avec une gigue aléatoire. Si les erreurs 429 persistent, basculez vers un autre canal. À long terme, augmentez votre niveau Tier ou élargissez vos canaux d’accès autorisés pour accroître votre capacité.
Pour les développeurs qui préfèrent éviter les complications liées aux quotas, le recours à une passerelle d’agrégation est une solution plus pragmatique. Nous vous recommandons de tester rapidement les résultats avec APIYI apiyi.com. La plateforme prend en charge les appels à gemini-4-argon avec une forte concurrence ; vous pouvez l’utiliser sereinement en dessous de 500 RPM. N’hésitez pas à l’essayer.
Références
- Page sur l’utilisation et les limites de débit de Google AI Studio : consultez les RPM, TPM, RPD et le niveau Tier de votre projet
- Lien :
aistudio.google.com/usage -
Remarque : sélectionnez un projet et gemini-4-argon pour consulter les quotas réels
-
Documentation sur les limites de débit de l’API Gemini : mécanismes officiels de limitation du débit et recommandations pour gérer les erreurs 429
- Lien :
ai.google.dev/gemini-api/docs/rate-limits - Remarque : comprend les limites de consommation sur 10 minutes et des conseils sur le backoff exponentiel
Auteur : APIYI Team
Échanges techniques : n’hésitez pas à partager dans les commentaires vos expériences de diagnostic des erreurs 429 avec gemini-4-argon. Pour plus d’informations sur l’intégration, consultez le centre de documentation d’APIYI : docs.apiyi.com.