Le 28 septembre, Anthropic a publié claude-sonnet-5-5 ; dès le lendemain, OpenAI a lancé gpt-6.1-sol lors de la DevDay. Les nouveaux modèles phares des deux entreprises sont arrivés presque simultanément, avec exactement le même tarif : 2 $ en entrée et 10 $ en sortie (par million de tokens). La première réaction de nombreux développeurs est : « ils sont tous les deux moins chers, autant choisir n’importe lequel ». Pourtant, une fois en production, les écarts entre les deux modèles en matière de coût par tâche, de facturation des contextes longs et de performances des agents sont bien plus importants que ne le laisse penser leur grille tarifaire. Cet article analyse, selon 5 dimensions, les différences concrètes entre gpt-6.1-sol et claude-sonnet-5-5, pour vous aider à choisir rationnellement selon vos cas d’usage, sans vous laisser influencer par votre préférence de marque ou l’accessibilité de votre compte.
Valeur clé : après cette lecture, vous saurez clairement lequel de gpt-6.1-sol ou claude-sonnet-5-5 choisir et comment les combiner pour les agents de programmation, les documents bureautiques, la recherche sur contexte long et les traitements par lots à fort volume.
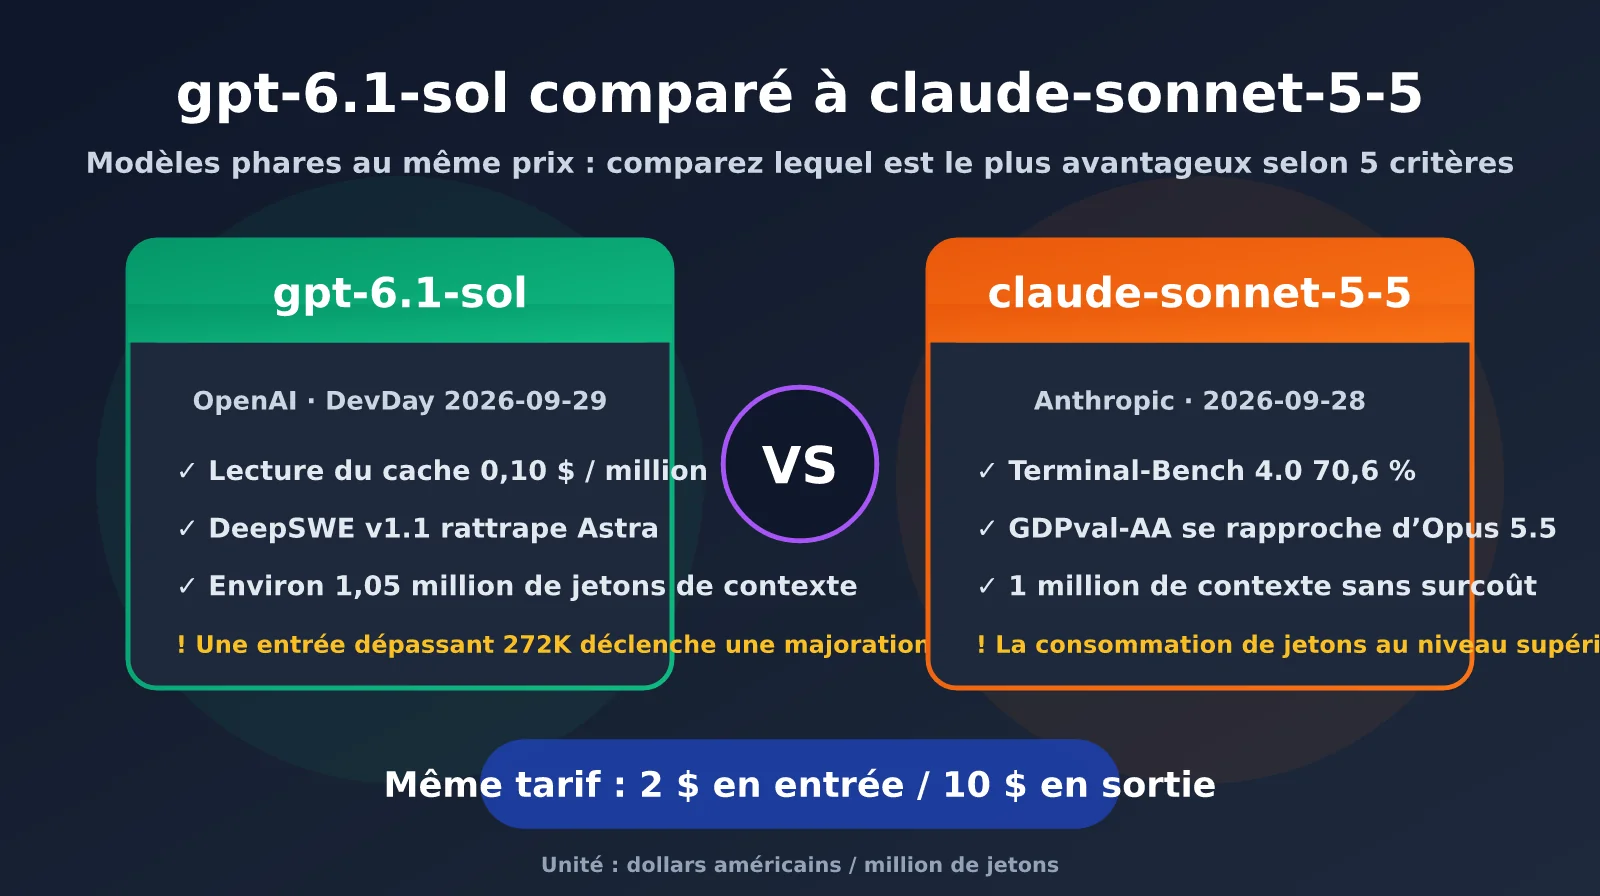
Vue d’ensemble des paramètres clés de gpt-6.1-sol et claude-sonnet-5-5
Commençons par clarifier un malentendu courant : à proprement parler, aucun de ces deux modèles n’a baissé de prix. claude-sonnet-5-5 conserve la tarification de Sonnet 5, soit 2 $/10 $, tandis que gpt-6.1-sol affiche le même tarif que la génération précédente, gpt-6-sol. Cette impression de « baisse » s’explique sur deux plans : d’une part, des capacités auparavant réservées aux modèles phares sont désormais proposées au tarif des modèles principaux. gpt-6.1-sol coûte ainsi seulement un cinquième du prix de gpt-6-astra, et claude-sonnet-5-5 la moitié de celui d’Opus 5.5. D’autre part, les coûts cachés diminuent : le prix des entrées mises en cache de gpt-6.1-sol a été divisé par deux, de 0,20 $ à 0,10 $, tandis que claude-sonnet-5-5 réduit le nombre d’appels aux outils, ce qui peut faire baisser le coût par tâche d’environ 30 % au maximum.
| Paramètre | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|
| Date de sortie | 29/09/2026 (DevDay) | 28/09/2026 |
| ID du modèle | gpt-6.1-sol |
claude-sonnet-5-5 |
| Fenêtre de contexte | Environ 1,05 million de tokens | 1 million de tokens |
| Sortie maximale | 128K | 128K (jusqu’à 300K dans la bêta Batch) |
| Niveaux de raisonnement | low / medium (par défaut) / high / xhigh / max | low / medium / high (par défaut dans l’API) / xhigh / max |
| Mode de réflexion | Réglable selon le niveau | Réflexion adaptative, impossible à désactiver |
| Modèle phare associé | gpt-6-astra (10 $/50 $) | Claude Opus 5.5 (4 $/20 $) |
| Plateformes disponibles | APIYI apiyi.com, API officielle OpenAI | APIYI apiyi.com, API officielle Anthropic |
Le tableau révèle une différence importante : les niveaux de raisonnement par défaut ne sont pas les mêmes. gpt-6.1-sol utilise medium par défaut, alors que l’API de claude-sonnet-5-5 est réglée sur high. Comparer les deux modèles directement avec leurs paramètres par défaut revient donc à laisser Sonnet « réfléchir » un niveau de plus : la consommation de tokens et la latence ne partent naturellement pas du même point. Pour une comparaison équitable, nous vous conseillons de spécifier explicitement le même reasoning_effort des deux côtés.
🎯 Conseil de test : pour comparer ces deux modèles, veillez à fixer le même niveau de raisonnement et la même invite. Via APIYI apiyi.com, utilisez une seule et même clé API pour appeler à la fois gpt-6.1-sol et claude-sonnet-5-5 : il suffit de modifier le paramètre
modelpour réaliser un test A/B. Vous éviterez ainsi les variables parasites liées aux comptes ou au réseau.
Les 5 principales différences entre gpt-6.1-sol et claude-sonnet-5-5
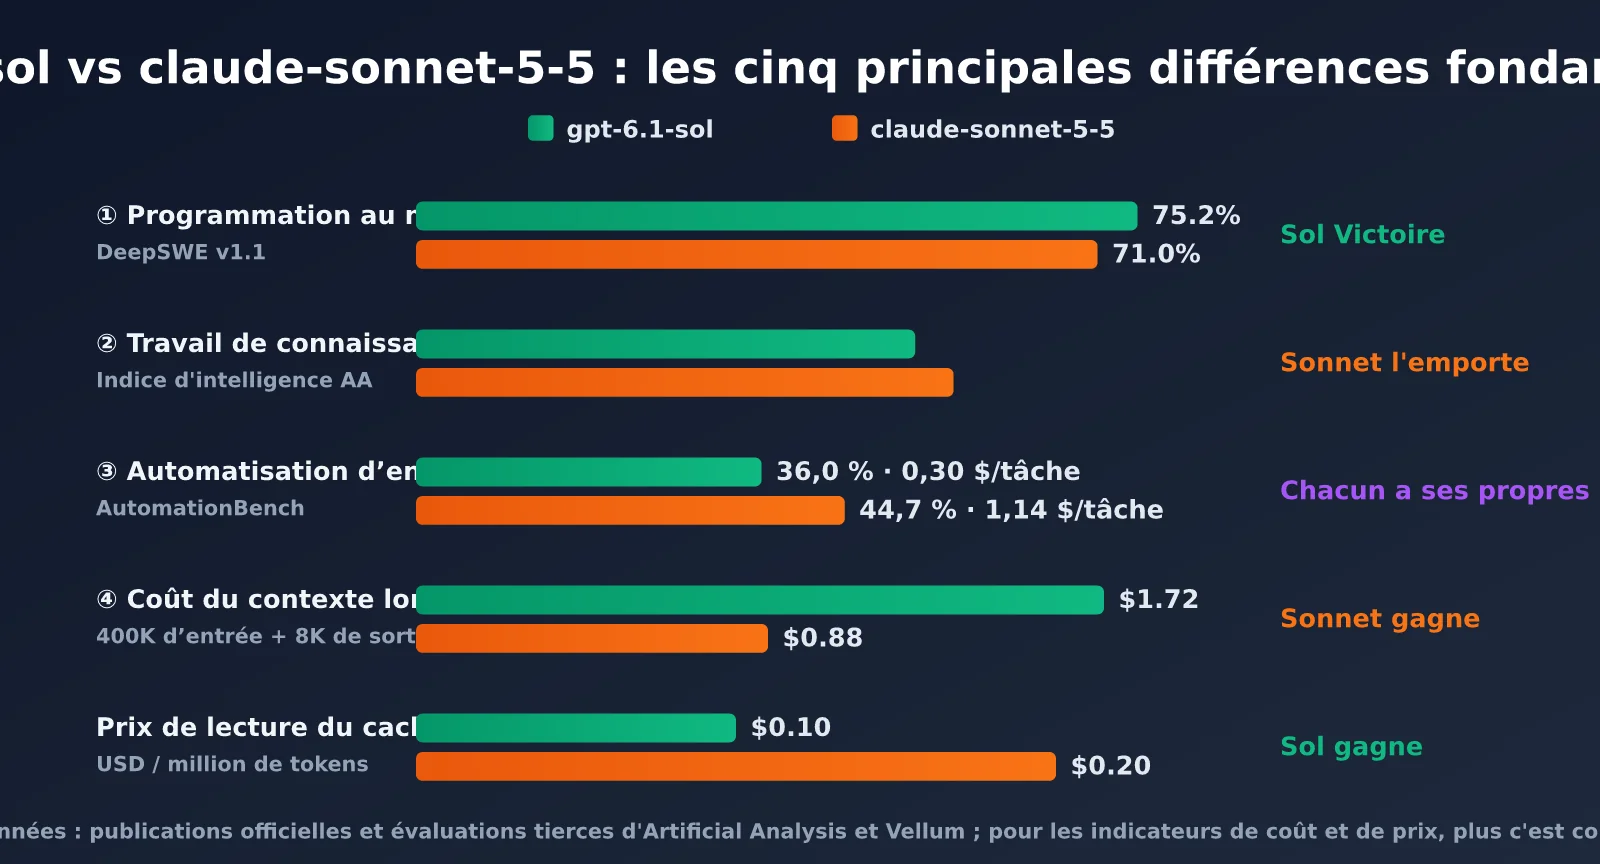
Différence n° 1 : pour les agents de programmation, claude-sonnet-5-5 est devant sur les tâches en terminal
La programmation est le domaine où les deux modèles se disputent le plus directement, mais les benchmarks publiés ne se recouvrent pas totalement : il faut donc les examiner séparément. Sur Terminal-Bench 4.0, claude-sonnet-5-5 obtient officiellement 70,6 %, une hausse spectaculaire par rapport aux 10,3 % de Sonnet 5. Il dépasse même les 66,4 % d’Opus 5.5. La contre-évaluation indépendante d’Artificial Analysis lui attribue 64 %, également au-dessus d’Opus 5.5 et des 60 % de gpt-6-astra. Il atteint aussi 81,3 % sur SWE-Bench Pro et 55,5 % sur CursorBench 4.0, juste derrière Opus 5.5.
Du côté de gpt-6.1-sol, OpenAI met en avant un score de 75,2 % sur DeepSWE v1.1, légèrement supérieur aux 74,8 % de gpt-6-astra, avec un coût d’environ 1,50 $ par tâche — moins d’un cinquième de celui d’Astra. Dans les synthèses de benchmarks tiers, claude-sonnet-5-5 obtient 71,0 % sur ce même test. Autrement dit, claude-sonnet-5-5 apporte des preuves plus solides pour la programmation par agent pilotée depuis le terminal, tandis que gpt-6.1-sol se distingue davantage par son rapport qualité-prix sur les tâches d’ingénierie logicielle à l’échelle d’un dépôt.
Différence n° 2 : pour le travail de connaissance, claude-sonnet-5-5 se rapproche d’Opus
Pour les tâches bureautiques et de travail de connaissance, claude-sonnet-5-5 affiche des résultats très convaincants. Il marque 1844 sur GDPval-AA v2.1, pratiquement à égalité avec les 1846 d’Opus 5.5. Son score de 1811 sur AA-Briefcase le place également tout près d’Opus. Dans l’indice d’intelligence d’Artificial Analysis, claude-sonnet-5-5 arrive deuxième avec 56 points, seulement 2 points derrière Opus 5.5 ; gpt-6.1-sol (max) obtient 52 points.
gpt-6.1-sol conserve toutefois ses propres atouts dans l’analyse de documents. Sur le benchmark GDP.pdf, il atteint 32,0 %, presque au niveau des 32,2 % de gpt-6-astra, et dépasse les 28,8 % d’Opus 5.5, pour un coût d’environ 0,38 $ par tâche. Sur AutomationBench, consacré à l’automatisation des processus d’entreprise, claude-sonnet-5-5 mène avec 44,7 %, contre 36,0 % pour gpt-6.1-sol. Mais le premier coûte environ 1,14 $ par tâche, contre seulement 0,30 $ pour le second.
Différence n° 3 : utilisation d’ordinateur, les deux sont désormais exploitables en pratique
Pour l’utilisation d’ordinateur (Computer Use), gpt-6.1-sol atteint 71,4 % sur OSWorld 2.0, soit seulement 2,1 points de moins que les 73,5 % de gpt-6-astra, pour environ 1,30 $ par tâche. claude-sonnet-5-5 obtient quant à lui 80,1 % sur OSWorld 2.1, proche des 81,8 % d’Opus 5.5.
Attention toutefois : les jeux de tests d’OSWorld ne sont pas les mêmes selon les versions, les scores ne peuvent donc pas être comparés directement. On peut néanmoins conclure que les deux modèles sont désormais capables d’utiliser des applications de bureau de manière fiable.
Différence n° 4 : la facturation des longs contextes, gpt-6.1-sol cache un seuil important
C’est le point le plus facile à manquer, et aussi celui qui peut le plus peser sur la facture. gpt-6.1-sol prend bien en charge une fenêtre de contexte d’environ 1,05 million de tokens, mais dès que l’entrée d’une requête dépasse 272 K tokens, l’ensemble des tokens d’entrée et du cache est facturé au double, tandis que les tokens de sortie sont facturés 1,5 fois plus cher.
La fenêtre de contexte d’un million de tokens de claude-sonnet-5-5 ne comporte pas de surcharge liée aux longs contextes : le tarif standard s’applique tout au long de la requête. Si votre activité consiste régulièrement à injecter un manuel entier ou un dépôt de code complet dans le contexte, cette différence peut à elle seule modifier votre choix de modèle.
Différence n° 5 : efficacité en tokens et cache, gpt-6.1-sol est plus économe
Le prix de lecture du cache de gpt-6.1-sol est de 0,10 $, soit la moitié de celui de claude-sonnet-5-5 (0,20 $). Son avantage est particulièrement net dans les scénarios comme les boucles d’agents, où le préfixe se répète fortement.
Par ailleurs, claude-sonnet-5-5 consomme beaucoup de tokens au niveau de raisonnement élevé : Artificial Analysis mesure environ 193 000 tokens de sortie par tâche en mode max, le niveau le plus élevé observé à ce jour. Des tests indépendants constatent aussi que le niveau high par défaut de l’API consomme presque deux fois plus de tokens de sortie que le niveau medium, sans amélioration notable de la qualité.
| Benchmark / indicateur | gpt-6.1-sol | claude-sonnet-5-5 | Avantage |
|---|---|---|---|
| Terminal-Bench 4.0 (officiel) | Non publié | 70,6 % | claude-sonnet-5-5 |
| DeepSWE v1.1 | 75,2 % | 71,0 % | gpt-6.1-sol |
| GDPval-AA v2.1 | Non publié (gpt-6-sol, génération précédente : 1487) | 1844 | claude-sonnet-5-5 |
| Analyse de documents GDP.pdf | 32,0 % | Non publié | gpt-6.1-sol |
| AutomationBench | 36,0 % (env. 0,30 $/tâche) | 44,7 % (env. 1,14 $/tâche) | Sonnet pour la qualité, Sol pour le coût |
| Indice d’intelligence AA | 52 | 56 | claude-sonnet-5-5 |
| Prix de lecture du cache | 0,10 $ / million | 0,20 $ / million | gpt-6.1-sol |
💡 À propos des données : ces benchmarks proviennent des publications officielles d’OpenAI et d’Anthropic, ainsi que d’évaluations tierces telles qu’Artificial Analysis et Vellum. Les versions testées et les niveaux de raisonnement varient selon les organismes. Nous vous conseillons d’exécuter une comparaison sur vos propres échantillons métier : elle sera toujours plus utile que n’importe quel classement.
Comparaison des coûts réels entre gpt-6.1-sol et claude-sonnet-5-5
Un tarif affiché identique ne signifie pas une facture identique. Les estimations ci-dessous calculent le coût par requête pour trois charges typiques (hors écriture en cache, selon les tarifs officiels), afin de voir clairement d’où viennent les écarts.
| Scénario de charge | Composition de la requête | gpt-6.1-sol | claude-sonnet-5-5 |
|---|---|---|---|
| Boucle d’agent (cache élevé) | 100K tokens d’entrée (90 % servis depuis le cache) + 5K tokens de sortie | env. 0,079 $ | env. 0,088 $ |
| Conversation classique | 5K tokens d’entrée + 1K tokens de sortie | env. 0,020 $ | env. 0,020 $ |
| Recherche sur contexte très long | 400K tokens d’entrée (sans cache) + 8K tokens de sortie | env. 1,72 $ (tarif majoré déclenché) | env. 0,88 $ |
| Traitement par lots (Batch) | 50 % du tarif affiché | 1 $ / 5 $ | 1 $ / 5 $ |
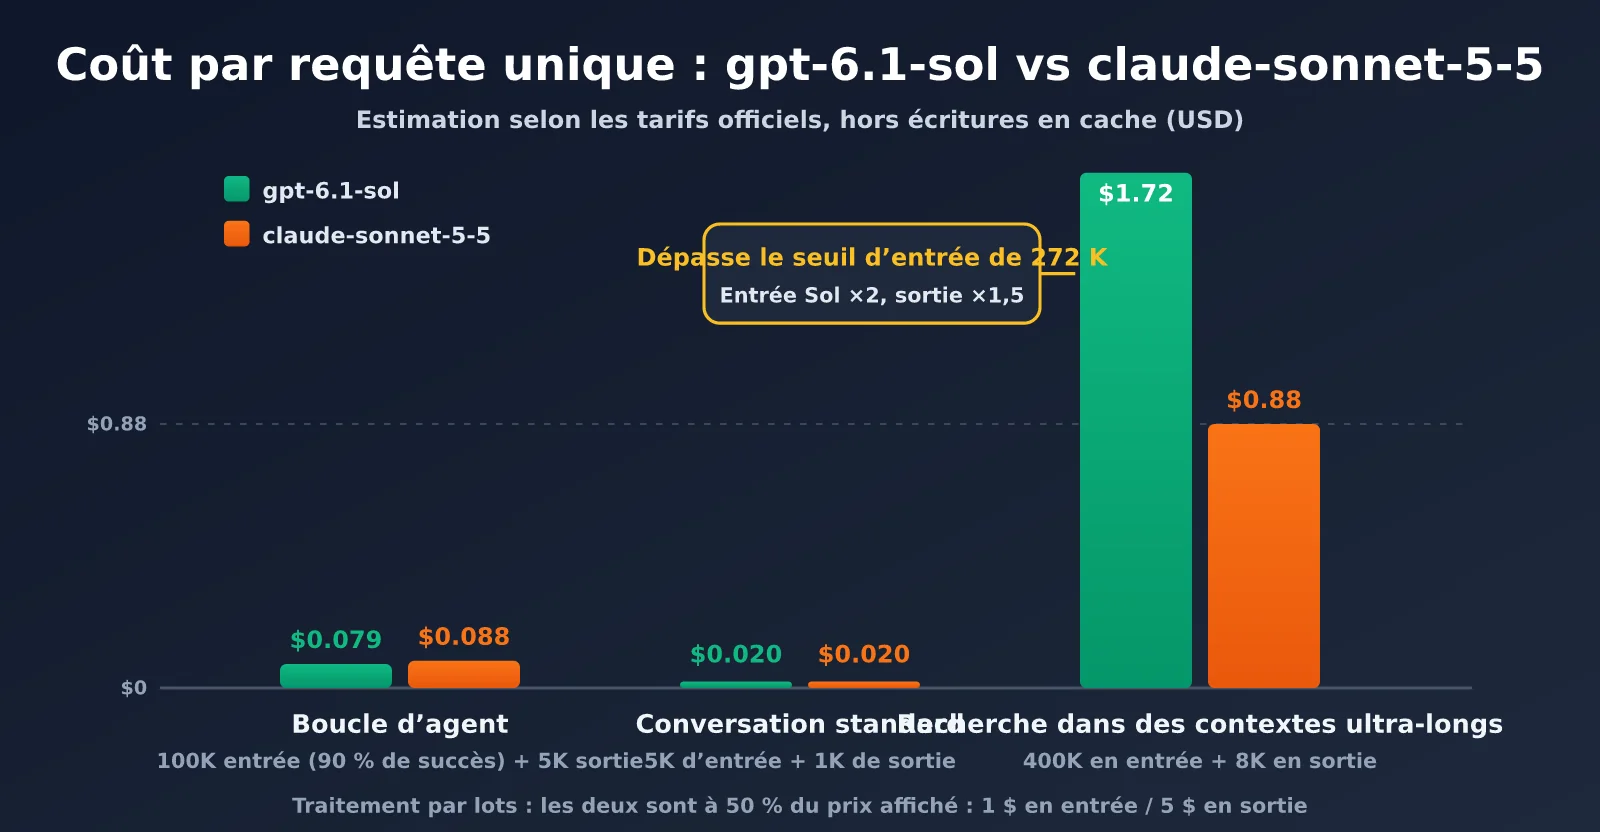
La conclusion est simple : dans les boucles d’agent où les préfixes se répètent beaucoup, gpt-6.1-sol l’emporte d’environ 10 % grâce à une lecture du cache moins chère ; pour les conversations classiques, les deux sont quasiment équivalents ; dès qu’une entrée unique dépasse 272K tokens, claude-sonnet-5-5 coûte environ deux fois moins cher que gpt-6.1-sol.
Il faut aussi prendre en compte l’efficacité en tokens. Si claude-sonnet-5-5 fonctionne avec le niveau high ou max, le nombre réel de tokens de sortie peut doubler et annuler son avantage sur les contextes longs. Contrôler le niveau de raisonnement est donc essentiel pour bien utiliser Sonnet.
Comparer rapidement les deux modèles avec le même code
Grâce à l’interface compatible OpenAI, il suffit de modifier le paramètre model pour tester les deux modèles côte à côte. Voici un exemple minimal :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, les deux modèles utilisent la même clé
)

for model in ["gpt-6.1-sol", "claude-sonnet-5-5"]:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="medium",  # Conserver le même niveau pour garantir une comparaison équitable
        messages=[{"role": "user", "content": "Ajoute des tests unitaires à cette fonction : def add(a, b): return a + b"}],
    )
    print(model, resp.usage.total_tokens, resp.choices[0].message.content[:200])
Afficher le script complet de comparaison avec mesure du temps et des coûts
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI
)

# Prix par million de tokens : entrée, lecture du cache, sortie
PRICES = {
    "gpt-6.1-sol": (2.0, 0.10, 10.0),
    "claude-sonnet-5-5": (2.0, 0.20, 10.0),
}

def run(model: str, prompt: str, effort: str = "medium"):
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort=effort,
        messages=[{"role": "user", "content": prompt}],
    )
    elapsed = time.time() - start
    u = resp.usage
    cached = getattr(getattr(u, "prompt_tokens_details", None), "cached_tokens", 0) or 0
    p_in, p_cache, p_out = PRICES[model]
    cost = ((u.prompt_tokens - cached) * p_in + cached * p_cache
            + u.completion_tokens * p_out) / 1_000_000
    return elapsed, u.prompt_tokens, u.completion_tokens, cost

tasks = [
    "Implémente en Python un cache LRU avec une durée d’expiration, puis écris les tests",
    "Lis les exigences suivantes et propose la structure des tables de base de données ainsi que des recommandations d’index : commandes, utilisateurs, coupons",
]

for task in tasks:
    for model in PRICES:
        t, i, o, c = run(model, task)
        print(f"{model:<20} {t:>6.1f}s  in={i:<6} out={o:<6} ${c:.4f}")
🚀 Pour démarrer rapidement : si vous n’avez pas encore de compte Anthropic, ou si les paiements internationaux et la vérification par numéro de téléphone vous bloquent, inscrivez-vous directement sur APIYI, apiyi.com, pour obtenir des crédits de test. Une seule clé API permet d’invoquer gpt-6.1-sol et claude-sonnet-5-5, sans avoir à ouvrir des comptes officiels distincts chez les deux fournisseurs.
Recommandations de scénarios pour gpt-6.1-sol et claude-sonnet-5-5
Les priorités accordées à la qualité, au coût et à la latence varient selon les métiers. Voici nos recommandations pour les scénarios les plus courants.
| Cas d’usage | Modèle recommandé | Raison principale |
|---|---|---|
| Agent de programmation piloté par terminal (type Claude Code) | claude-sonnet-5-5 | En tête sur Terminal-Bench 4.0, avec moins d’appels d’outils |
| Correction de code à l’échelle d’un dépôt, workflows Codex | gpt-6.1-sol | Égale Astra sur DeepSWE, pour un coût d’environ 1,50 $ par tâche |
| Analyse de documents très longs / de l’ensemble d’un dépôt de code (>272 K) | claude-sonnet-5-5 | Aucun surcoût pour les contextes longs, pour un coût environ deux fois inférieur à Sol |
| Service client à forte concurrence, questions-réponses RAG (cache élevé) | gpt-6.1-sol | Lecture du cache à 0,10 $, avec des économies croissantes grâce à la réutilisation des préfixes |
| Rédaction de rapports, tableaux et travail de bureau fondé sur les connaissances | claude-sonnet-5-5 | Pratiquement à égalité avec Opus 5.5 sur GDPval-AA |
| Analyse de PDF, extraction d’informations | gpt-6.1-sol | Égale Astra sur GDP.pdf, à environ 0,38 $ par tâche |
| Recherche en sécurité, assistance aux tests d’intrusion | gpt-6.1-sol | Sonnet 5.5 intègre des protections de cybersécurité, ce qui augmente son taux de refus |
Cas typiques où choisir gpt-6.1-sol
gpt-6.1-sol est particulièrement adapté aux activités sensibles aux coûts, avec un volume important de requêtes et une forte répétition des préfixes. C’est le cas, par exemple, des assistants de service client, des questions-réponses sur une base de connaissances ou du nettoyage de données en masse. Les invites système et les contextes de recherche y sont largement réutilisés : le tarif de 0,10 $ pour la lecture du cache renforce donc continuellement son avantage.
Son taux d’hallucination s’est également nettement amélioré : au niveau de raisonnement faible, le taux d’erreurs factuelles est passé de 11,4 % pour la génération précédente à 7,7 %. Il convient ainsi d’utiliser les niveaux low ou medium pour traiter à grande échelle des tâches légères. OpenAI prévoit aussi de proposer un mode Ultrafast pour gpt-6.1-sol, avec une vitesse de génération pouvant atteindre environ 300 tokens par seconde. Son prix sera six fois supérieur à celui du mode standard, mais il peut constituer une option pour les produits nécessitant des interactions en temps réel.
Cas typiques où choisir claude-sonnet-5-5
claude-sonnet-5-5 est davantage indiqué pour les activités complexes, à contexte très long et exigeant un taux de réussite élevé dès la première tentative. Dans les tâches agentiques, il lui suffit généralement d’environ trois appels d’outils pour réaliser un travail qui demandait 12 à 13 appels à Sonnet 5. Sa vitesse de sortie est également supérieure de plus de 30 % à celle de la génération précédente.
Pour les revues juridiques, les migrations de dépôts de code ou la rédaction de longs rapports, qui nécessitent de placer un grand volume de contenus dans le contexte en une seule fois, sa fenêtre de contexte d’un million de tokens sans surcoût est particulièrement intéressante.
Attention toutefois : claude-sonnet-5-5 introduit plusieurs changements d’API incompatibles avec Sonnet 5. Le mode de réflexion ne peut plus être désactivé, et la sélection forcée d’un outil avec tool_choice: "tool" a été supprimée. Si votre ancien code dépend de ces comportements, effectuez impérativement des tests de régression avant la migration.
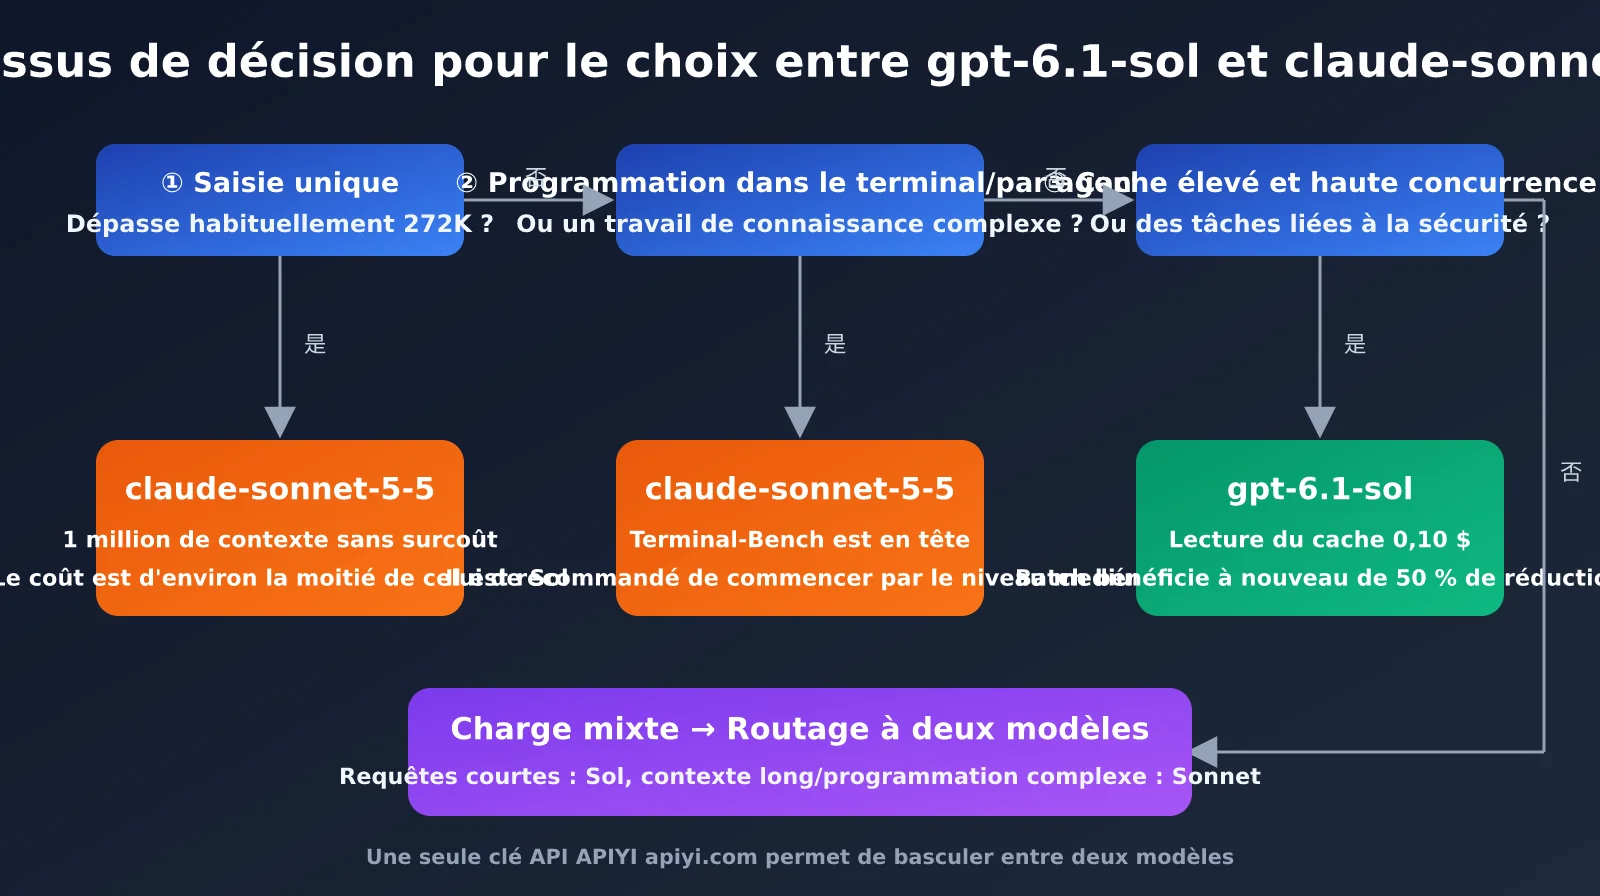
🎯 Conseil d’architecture : vous n’êtes pas obligé de choisir un seul des deux modèles. Nous recommandons de mettre en place un routage simple des modèles via APIYI apiyi.com : dirigez les requêtes courtes et le trafic avec un cache élevé vers gpt-6.1-sol, et les contextes très longs ainsi que les tâches de programmation complexes vers claude-sonnet-5-5. Vous pourrez basculer selon vos besoins, tout en utilisant la même interface compatible OpenAI.
Conseils de décision : gpt-6.1-sol vs claude-sonnet-5-5
Voici une série d’étapes concrètes pour résumer l’analyse précédente :
- Commencez par la longueur des entrées : si vos requêtes dépassent habituellement 272K tokens, privilégiez claude-sonnet-5-5 ; sinon, passez à l’étape suivante.
- Examinez ensuite le type de tâche : pour la programmation en terminal ou via agent, ainsi que le travail intellectuel complexe, claude-sonnet-5-5 est à privilégier ; pour la correction de code à l’échelle d’un dépôt et l’analyse de PDF, gpt-6.1-sol est plus adapté.
- Analysez ensuite la structure du trafic : pour les activités avec un taux de cache élevé et une forte concurrence, l’avantage de coût de gpt-6.1-sol s’amplifie à mesure que le volume augmente.
- Enfin, ajustez le niveau de raisonnement : quel que soit le modèle retenu, commencez les tests avec le niveau medium. Avec claude-sonnet-5-5 en particulier, évitez d’utiliser directement le niveau high par défaut de l’API, car la consommation de tokens peut alors doubler.
| Votre priorité | Premier choix | Stratégie alternative |
|---|---|---|
| Qualité prioritaire, budget confortable | claude-sonnet-5-5 (medium/high) | Passer à Opus 5.5 uniquement pour les tâches les plus difficiles |
| Coût prioritaire, trafic très important | gpt-6.1-sol (low/medium) | Utiliser Batch avec 50 % de réduction pour les tâches non temps réel |
| Vitesse prioritaire, interactions en temps réel | gpt-6.1-sol (une fois Ultrafast disponible) | claude-sonnet-5-5 au niveau low |
| Stabilité prioritaire, éviter un point de défaillance unique | Routage entre deux modèles | Basculer automatiquement vers l’autre en cas de limitation de débit |
Les préférences de marque et l’accessibilité ne devraient pas déterminer un choix technique. Les comptes officiels Claude imposent davantage de contraintes concernant les régions, les moyens de paiement et les modalités d’inscription, ce qui augmente effectivement la barrière d’entrée. Mais il s’agit d’un problème de couche d’accès, pas de capacité du modèle. En confiant cette couche à une plateforme API unifiée, vous pouvez choisir exclusivement selon les performances sur vos tâches et les coûts.
Questions fréquentes
Q1 : gpt-6.1-sol et claude-sonnet-5-5 ont-ils vraiment baissé leurs prix ?
Les tarifs affichés n’ont pas changé : les deux restent à 2 $ / 10 $. La véritable « baisse » vient du fait que gpt-6.1-sol offre des capacités proches de gpt-6-astra pour un cinquième du prix, tandis que la lecture depuis le cache passe aussi de 0,20 $ à 0,10 $. De son côté, claude-sonnet-5-5 propose des capacités proches d’Opus 5.5 pour la moitié de son prix et peut réduire le coût par tâche d’environ 30 % grâce à un nombre réduit d’appels d’outils. Il faut donc comparer le coût total par tâche, et non le seul prix unitaire.
Q2 : Comment appeler claude-sonnet-5-5 sans compte Anthropic ?
Les comptes officiels Anthropic imposent des exigences concernant la région d’inscription, le numéro de téléphone et le moyen de paiement. Les développeurs indépendants comme les équipes en Chine se retrouvent souvent bloqués à cette étape. Une solution simple consiste à passer par APIYI apiyi.com. La plateforme fournit une interface compatible avec OpenAI : il suffit de remplacer base_url par https://api.apiyi.com/v1 et de définir model sur claude-sonnet-5-5, sans modifier le reste de votre code métier.
Q3 : Peut-on utiliser sans risque les 1,05 million de tokens de fenêtre de contexte de gpt-6.1-sol ?
Oui, mais il faut surveiller la tarification. Lorsque l’entrée d’une requête dépasse 272K tokens, le prix de l’entrée comme celui du cache est doublé, et le prix de sortie est multiplié par 1,5. Si votre activité nécessite réellement un contexte très long, commencez par appliquer une compression par recherche, ou routez ces requêtes vers claude-sonnet-5-5, qui n’applique pas de surcoût lié aux contextes longs.
Q4 : Pourquoi claude-sonnet-5-5 coûte-t-il parfois plus cher que prévu ?
La principale raison est le niveau de raisonnement. Son niveau par défaut dans l’API est high, et le mode réflexion ne peut pas être désactivé. Sur les tâches simples, cela peut générer beaucoup de tokens de réflexion inutiles. Des tests indépendants indiquent que le niveau medium consomme autant de tokens que Sonnet 5 tout en offrant de meilleurs résultats. Pour les tâches courantes, il est donc recommandé de définir explicitement le niveau sur medium.
Q5 : Quel modèle choisir pour la programmation ?
Si vous utilisez principalement des agents en terminal, comme Claude Code, pour du développement en plusieurs étapes, les résultats de claude-sonnet-5-5 sur Terminal-Bench sont plus convaincants. Si vous travaillez surtout sur la correction de défauts à l’échelle d’un dépôt, dans un flux de travail Codex, gpt-6.1-sol atteint le niveau de gpt-6-astra avec un coût par tâche plus faible. Si les conditions de votre équipe le permettent, intégrer les deux modèles et les répartir selon le type de tâche reste la solution la plus fiable.
Conclusion
Il n’y a pas de vainqueur absolu entre gpt-6.1-sol et claude-sonnet-5-5. claude-sonnet-5-5 est plus performant pour la programmation agentique, le travail de connaissance et l’indice d’intelligence, tout en proposant une fenêtre de contexte d’un million de tokens sans surcoût. De son côté, gpt-6.1-sol offre de meilleurs tarifs de cache, de meilleures capacités de correction de code à l’échelle d’un dépôt, d’analyse documentaire, ainsi qu’un coût inférieur pour les tâches unitaires. Il convient donc particulièrement aux flux de production à grande échelle et fortement réutilisables. Les deux modèles affichent le même tarif catalogue ; les écarts réels sur la facture dépendent surtout de trois variables : la longueur des entrées, le taux de réussite du cache et le niveau de raisonnement.
En pratique, vous pouvez procéder en trois étapes : commencez par utiliser le processus de décision présenté dans cet article pour choisir votre modèle principal ; lancez ensuite un test A/B sur vos tâches réelles avec le script de comparaison, en conservant le même niveau de raisonnement ; enfin, mettez en place un routage à deux modèles selon le type de tâche, afin d’orienter chaque requête vers le modèle au meilleur rapport qualité-prix.
Si vous souhaitez éviter les démarches d’ouverture de comptes distincts chez Anthropic et OpenAI, vous pouvez appeler gpt-6.1-sol et claude-sonnet-5-5 via APIYI apiyi.com. La plateforme est compatible avec le format officiel d’OpenAI : une seule clé API suffit pour basculer librement entre les deux modèles. C’est particulièrement pratique pour les tests de sélection et le routage multi-modèle en production.
Références :
– Publication officielle d’OpenAI : présentation de GPT-6.1 Sol, openai.com/index/introducing-gpt-6-1-sol
– Publication officielle d’Anthropic : présentation de Claude Sonnet 5.5, anthropic.com/claude-sonnet-5-5
– Évaluation de l’indice d’intelligence d’Artificial Analysis : artificialanalysis.ai
– Analyse des benchmarks GPT-6.1 Sol par Vellum : vellum.ai/blog
– Article de The Decoder sur Claude Sonnet 5.5 : the-decoder.com
À propos de l’auteur : l’équipe technique d’APIYI, spécialisée dans l’intégration d’API de Grands modèles de langage et les pratiques d’industrialisation. Échangez avec nous via APIYI apiyi.com autour du choix entre gpt-6.1-sol et claude-sonnet-5-5, ainsi que de l’optimisation des coûts.