Note de l’auteur : décryptage du rapport 2026 de Menlo Ventures sur l’IA en entreprise. Comment les agents font-ils passer la consommation de modèles des « questions posées par des humains » à « l’exécution continue de tâches par des machines » ? Et quelles conséquences cela a-t-il sur les appels API, la concurrence et les achats ?
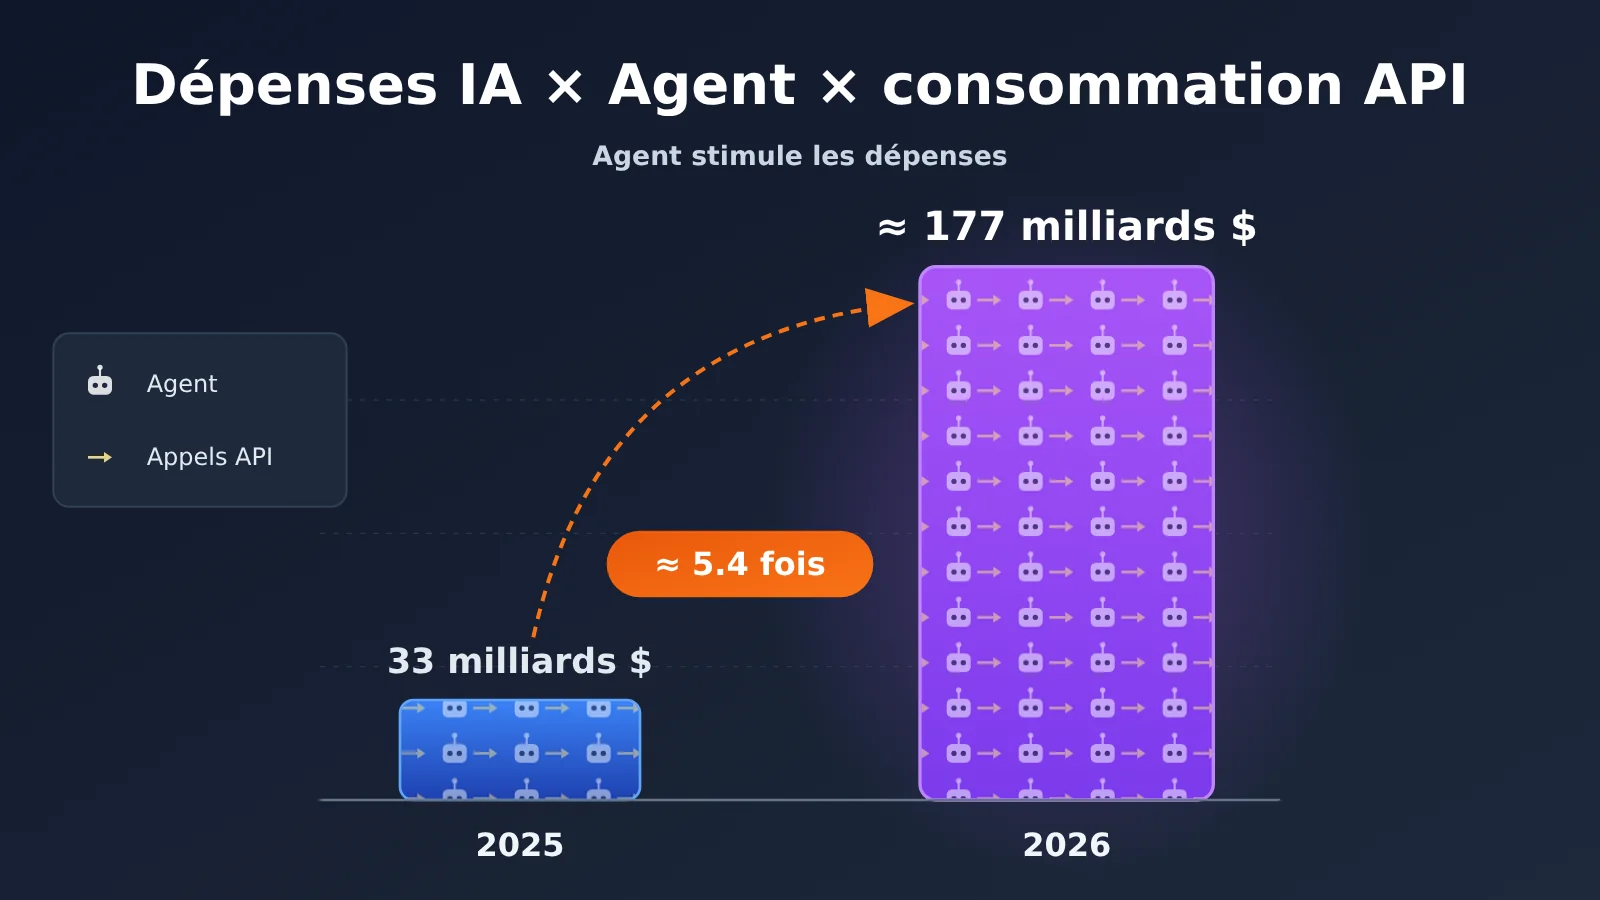
Menlo Ventures a publié le 3 novembre 2026 son rapport《The State of Enterprise AI》. Selon ses estimations, les entreprises ont consacré environ 177 milliards de dollars à l’IA en 2026 (176,8 milliards dans le rapport), soit environ 5,4 fois les 33 milliards de dollars dépensés en 2025. Plus frappant encore : leurs dépenses réelles ont été en moyenne environ 2,5 fois supérieures au budget initial.
Il ne s’agit pas simplement d’une nouvelle étude affirmant que « le marché de l’IA est immense ». Fondé sur une enquête menée auprès de près de 400 décideurs d’entreprises américaines et sur les données de tokens d’OpenRouter, le rapport pointe un même changement : la croissance des dépenses ne vient plus principalement du fait que « davantage de personnes posent des questions à l’IA », mais du fait que « des agents travaillent en continu à leur place ».
L’essentiel : cet article présente les chiffres clés des dépenses en IA des entreprises et de l’adoption des agents. Il explique pourquoi les agents changent la consommation de tokens et les appels API, puis examine ce que les développeurs et les acheteurs d’API doivent anticiper.
Dépenses des entreprises en IA en 2026 : l’essentiel
Commençons par les chiffres. Toutes les données du tableau proviennent d’estimations de marché de Menlo Ventures. Elles ne correspondent ni à des paiements d’entreprises vérifiés par audit, ni aux revenus d’un fournisseur de modèles en particulier.
| Indicateur | Détail |
|---|---|
| Publication / date | Menlo Ventures, 3 novembre 2026 |
| Dépenses des entreprises en IA en 2026 | Environ 176,8 milliards de dollars (contre 33 milliards en 2025, soit environ 5,4 fois plus) |
| Répartition des dépenses | Environ 99,5 milliards de dollars pour l’infrastructure IA et 77,3 milliards pour les applications IA |
| Utilisation vs construction | Les dépenses liées à l’utilisation de l’IA représentent environ 1,7 fois celles liées à la construction de modèles (102,5 milliards de dollars) |
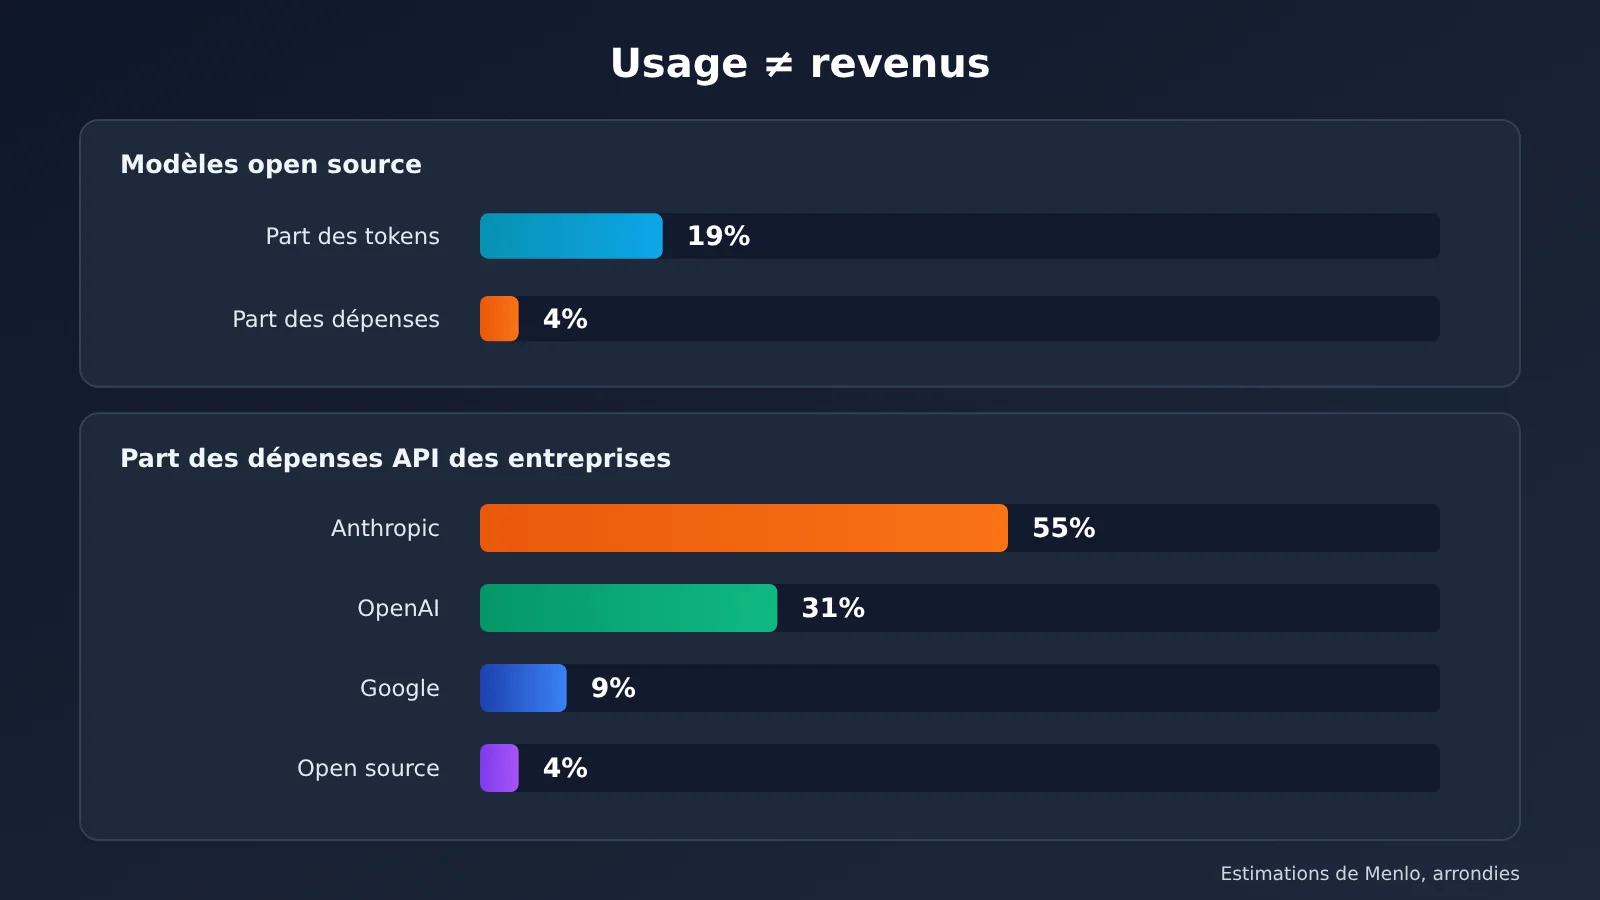
| Part des dépenses API des entreprises | Anthropic 55 %, OpenAI 31 %, Google 9 %, modèles open source 4 % |
| Part des tokens des agents | Environ 80 % de la consommation totale de tokens sur OpenRouter |
| Méthode d’enquête | Près de 400 décideurs d’entreprises américaines interrogés du 8 au 26 septembre 2026 |
Le fait que « les dépenses liées à l’utilisation de l’IA dépassent celles liées à la construction de modèles » marque un tournant. Jusqu’ici, les discussions sur la chaîne de valeur de l’IA se concentraient sur l’entraînement et la puissance de calcul. Désormais, les services que les entreprises paient pour faire travailler les modèles représentent une part plus importante. Attention toutefois : les « dépenses d’utilisation » couvrent plusieurs postes, notamment l’infrastructure, les abonnements aux applications et les API. Elles ne peuvent donc pas être assimilées directement aux revenus du marché des API.
À la même période, le 4 novembre, le président d’OpenAI, Greg Brockman, a déclaré lors de la conférence technologique du WSJ que plus de la moitié des revenus d’OpenAI provenaient désormais de son activité auprès des entreprises. Ce chiffre décrit la structure des revenus propres à OpenAI. Il ne mesure pas la même chose que la « part de 31 % d’OpenAI dans les dépenses API des entreprises » estimée par Menlo : les deux chiffres ne sont pas directement comparables.
Pourquoi les dépenses des entreprises en IA dépassent largement les budgets : l’intensité d’utilisation compte plus que le nombre d’utilisateurs
L’écart entre les budgets prévus et les dépenses réelles
La donnée la plus surprenante du rapport concerne l’écart budgétaire. En début d’année, les entreprises ont généralement sous-estimé la vitesse à laquelle leurs dépenses en IA allaient augmenter :
| Indicateur | Prévision initiale (par rapport à l’année précédente) | Réalité (par rapport à l’année précédente) |
|---|---|---|
| Dépenses moyennes en IA | 1,9 fois | 4,7 fois |
| Dépenses médianes en IA | 1,8 fois | 2,2 fois |
| Taux d’adoption de l’IA par les entreprises | — | 55 % → 65 % |
La moyenne est plus de deux fois supérieure à la médiane : un petit nombre d’entreprises qui utilisent l’IA de manière intensive tirent les dépenses globales vers le haut. Le taux d’adoption n’a progressé que de 10 points de pourcentage, tandis que les dépenses moyennes par entreprise ont presque été multipliées par cinq. La hausse vient donc surtout des entreprises qui utilisent déjà l’IA et qui en font un usage de plus en plus intensif, plutôt que de l’arrivée de nouvelles entreprises.
Les dépenses en IA donnent naissance à de nouveaux budgets
Du côté des sources de financement, Menlo estime qu’environ 55 % des dépenses supplémentaires en IA proviennent de nouveaux budgets, et environ 22 % des budgets logiciels existants. Autrement dit, l’IA ne se contente pas de remplacer les solutions SaaS traditionnelles : elle crée aussi des catégories d’achat qui n’existaient pas auparavant. Pour les responsables des achats, l’IA s’est détachée des « frais d’outils informatiques » pour devenir un coût opérationnel à gérer séparément.
Comment les agents changent la consommation d’API : de la question à l’exécution
Chatbots et agents : des mécanismes d’invocation différents
La raison directe des dérapages budgétaires, c’est le changement de mode d’invocation. Un chatbot classique fonctionne essentiellement sur le principe « une question, une réponse » : l’utilisateur envoie un message, le modèle renvoie un résultat, et la consommation de tokens est à peu près proportionnelle au nombre de questions posées. Un agent, lui, reçoit un objectif, décompose les tâches, utilise des outils, vérifie les résultats, puis recommence si nécessaire. Une seule tâche peut ainsi entraîner des dizaines d’invocations du modèle.
| Dimension | Chatbot | Agent IA |
|---|---|---|
| Déclenchement | L’utilisateur pose une question | Piloté par un objectif, peut être déclenché à heure fixe ou par un événement |
| Nombre d’invocations par tâche | Généralement 1 | Plusieurs cycles de planification, d’exécution et de vérification |
| Parallélisme | Dépend du nombre d’utilisateurs connectés | Plusieurs sous-tâches et agents en parallèle |
| Contexte | Historique de conversation | Documents, dépôt de code, résultats renvoyés par les outils |
| Durée d’exécution | S’arrête quand l’utilisateur part | Peut continuer en arrière-plan |
| Facteurs de consommation | Nombre d’utilisateurs × fréquence des questions | Volume de tâches × degré de parallélisme × durée |
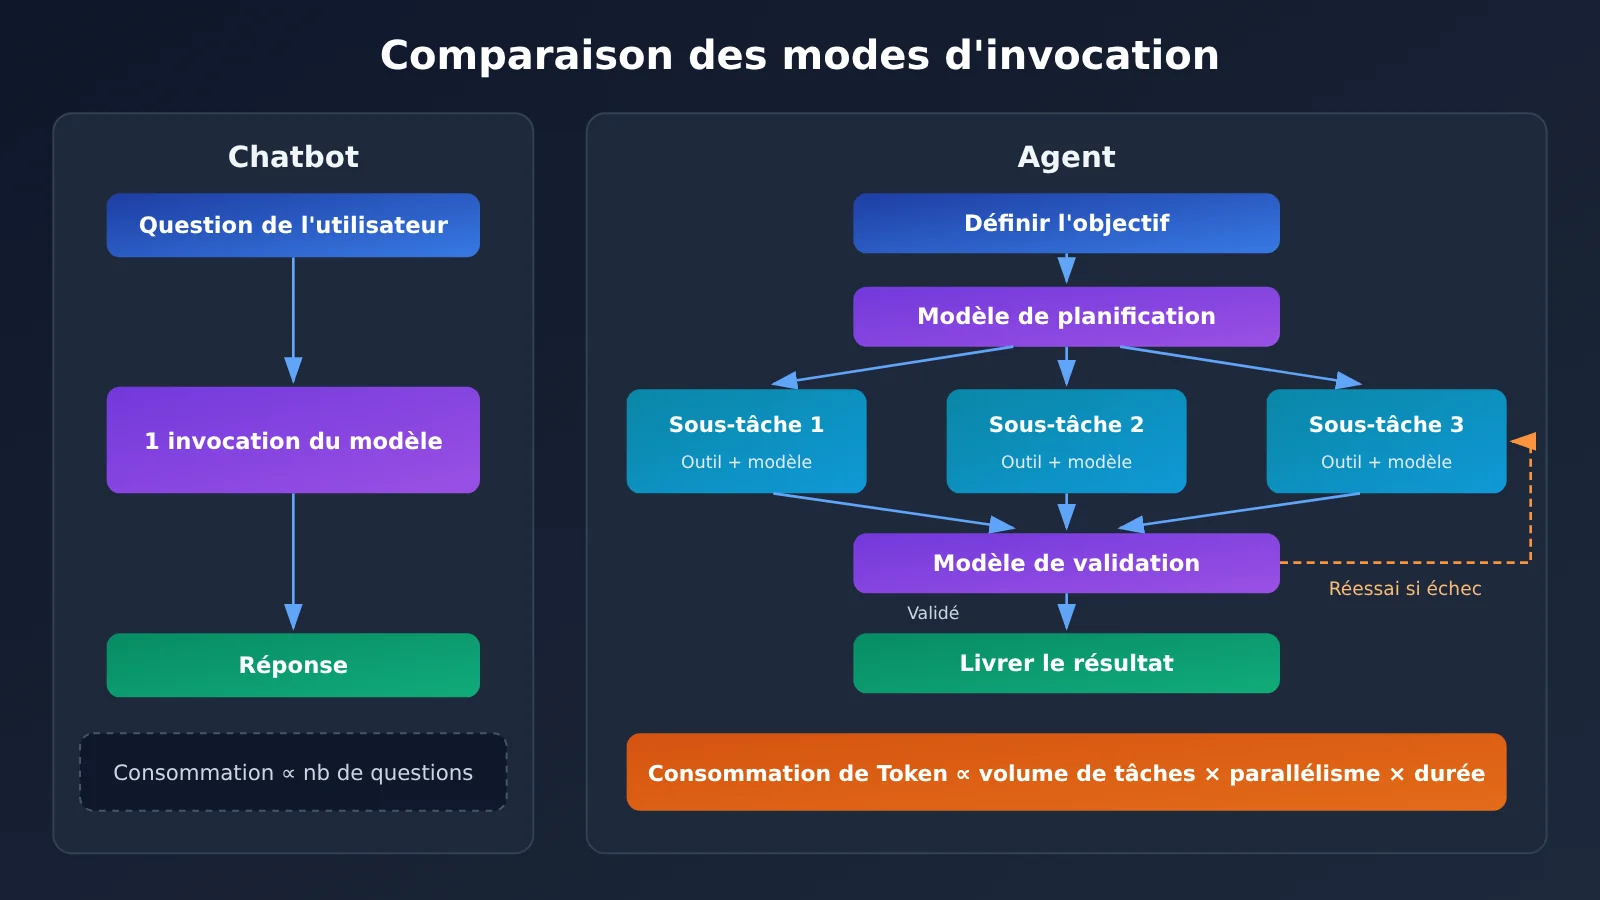
📊 À propos du schéma : dans le flux d’agent multimodèle à droite, les étapes de planification, d’exécution et de vérification peuvent chacune utiliser un modèle différent. Pour tester vous-même cette structure, vous pouvez utiliser une seule clé sur APIYI apiyi.com et passer d’un modèle à l’autre pour les comparer.
La consommation de tokens dépend du volume de tâches exécutées
À partir des données d’OpenRouter, Menlo a observé que les agents représentent désormais environ 80 % de la consommation totale de tokens sur la plateforme, soit quelque 130,9 billions de tokens par semaine. Depuis que le trafic des agents a dépassé celui généré par les humains en février 2026, il a été multiplié par environ 37, contre environ 5 pour le trafic humain sur la même période.
Les utilisateurs d’OpenRouter sont principalement des développeurs et des jeunes entreprises. Ces données ne sont donc pas représentatives de l’ensemble du secteur, mais elles vont dans le même sens que d’autres indicateurs. Selon le rapport d’OpenAI sur les entreprises en 2025, la consommation moyenne de tokens de raisonnement via l’API par organisation a été multipliée par environ 320 sur un an. Un article d’Axios sur Codex indique également que plus de 60 % des utilisateurs exécutent plusieurs tâches en même temps à un moment de la journée. Ces chiffres montrent que la consommation de tokens dépend de moins en moins des personnes et de plus en plus des tâches.
Dépenses des entreprises en IA : pourquoi la programmation et les chatbots dominent
Répartition des investissements dans les applications d’IA
Sur le marché des applications d’IA, estimé à environ 77,3 milliards de dollars, les investissements sont très concentrés :
| Catégorie d’application | Taille estimée en 2026 | Évolution sur un an |
|---|---|---|
| Applications d’IA pour la programmation | 34 milliards de dollars | Environ 7,7 fois |
| Chatbots IA pour les entreprises | 25 milliards de dollars | Environ 3 fois |
| Applications d’IA dans la santé | 3,7 milliards de dollars | — |
| Part cumulée de la programmation et des chatbots | Environ 76 % | — |
La concentration est encore plus forte dans la programmation. Selon les estimations de Menlo, Claude Code et Codex représentent ensemble environ 24 milliards de dollars sur ce marché, soit près de 70 %. Si la programmation est le premier domaine où les agents ont trouvé leur place, c’est directement lié aux trois conditions suivantes.
Les trois conditions pour déployer des agents avec succès
- Un environnement où agir : un agent doit pouvoir accéder à GitHub, aux courriels, aux calendriers, à Slack, aux documents de l’entreprise et aux bases de données. La capacité de raisonnement seule, sans outils, ne permet pas d’accomplir un travail concret.
- Un contexte complet pour la tâche : outre la question de l’utilisateur, l’agent a besoin des normes de l’entreprise, des processus métier, de l’historique du projet, des contraintes opérationnelles et des critères de réussite.
- Des résultats vérifiables : un compilateur peut déterminer si le code peut être compilé, et les tests permettent de vérifier si les fonctionnalités marchent correctement. C’est l’une des principales raisons de l’avance des agents de programmation. À l’inverse, les résultats des tâches de recherche documentaire ou d’information sont plus difficiles à vérifier objectivement.
Ce troisième point explique aussi les risques liés au coût des agents. Dans les domaines où les résultats sont difficiles à vérifier, un agent peut consommer un grand nombre de tokens tout en produisant des conclusions erronées. Axios a rapporté le cas d’Andrew Hall, professeur à Stanford, qui avait utilisé Claude Code pour actualiser un ancien article scientifique. Une vérification humaine a ensuite révélé des erreurs dans la collecte des données et le traitement du code.
Analyse de l’impact des agents sur le marché de la consommation d’API
Impact sur les développeurs d’API
- Revoir le modèle de coûts : estimer le budget API selon la formule « nombre d’utilisateurs × prix unitaire » n’est plus assez précis. Il faut plutôt compter « nombre de tâches × nombre moyen d’appels × longueur du contexte ».
- Prévoir des garde-fous budgétaires : un agent qui tourne en continu en arrière-plan doit avoir une limite de tokens par tâche, un nombre maximal d’itérations et un mécanisme d’arrêt en cas d’échecs répétés. Sinon, les dépenses peuvent passer de 1,9 à 4,7 fois le budget prévu.
- Combiner plusieurs modèles devient la norme : un modèle puissant pour la planification, un modèle moins cher pour l’exécution en masse et un modèle d’un autre fournisseur pour les vérifications croisées. Cette approche peut réduire nettement le coût par tâche.
Impact sur les fournisseurs d’API
Les changements de demande liés aux agents se répartissent en cinq catégories, chacune correspondant à des capacités que les fournisseurs doivent proposer :
| Évolution de la demande | Cause | Capacités nécessaires |
|---|---|---|
| Hausse de la fréquence des appels | Une tâche nécessite plusieurs appels successifs | Faible latence, nouvelles tentatives en cas d’échec |
| Hausse des appels parallèles | Plusieurs agents traitent des sous-tâches en même temps | Gestion des appels simultanés, limitation du débit |
| Hausse de la consommation de contexte | Ajout de documents et de résultats renvoyés par les outils | Prise en charge des contextes longs, facturation du cache |
| Hausse des exécutions continues | Les tâches se poursuivent après le départ de l’utilisateur | Stabilité des appels, suivi de la consommation |
| Multiplication des combinaisons de modèles | Répartition entre planification, exécution et vérification | Accès unifié à plusieurs modèles et possibilité de passer de l’un à l’autre |
💡 Conseil : si votre workflow d’agents doit combiner des modèles de plusieurs fournisseurs, vous pouvez d’abord tester votre prototype sur APIYI apiyi.com avec une interface compatible OpenAI. La facturation à l’usage facilite le suivi du coût réel de chaque étape.
Gardons du recul : les dépenses des entreprises en IA ne sont pas les revenus des API
L’idée selon laquelle « plus il y a d’agents, plus les revenus des fournisseurs d’API augmentent » ne se vérifie pas forcément, pour trois raisons :
- Une grande partie des 176,8 milliards de dollars concerne les infrastructures et les abonnements à des applications, pas les frais d’appel d’API.
- Les prix continuent de baisser. Les modèles open source représentent désormais 19 % des tokens utilisés, mais seulement 4 % environ des dépenses. Une hausse du volume de tokens ne se traduit donc pas nécessairement par une hausse équivalente des revenus.
- Le cache, le traitement par lots et le routage entre modèles réduisent les coûts unitaires. Au final, la concurrence se joue sur la stabilité et le taux de réussite des tâches, pas seulement sur le volume de tokens vendus.
Comment créer un workflow d’agents multimodèles avec une API
Exemple minimal
Ce code illustre les deux appels de base d’un agent : « planification → exécution ». Remplacez les noms de modèles par ceux disponibles dans la console de la plateforme :
from openai import OpenAI

client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="YOUR_PLANNER_MODEL",
    messages=[{"role": "user", "content": "把“整理本周销售周报”拆成 3 个步骤"}]
).choices[0].message.content

result = client.chat.completions.create(
    model="YOUR_EXECUTOR_MODEL",
    messages=[{"role": "user", "content": f"按以下步骤执行并输出结果:\n{plan}"}]
)
print(result.choices[0].message.content, result.usage.total_tokens)
Voir le code complet (avec vérification, nouvelles tentatives et budget de tokens)
import time
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",
)

MODELS = {
    "planner": "YOUR_PLANNER_MODEL",    # Modèle performant en raisonnement, chargé de décomposer la tâche
    "executor": "YOUR_EXECUTOR_MODEL",  # Modèle économique, chargé de l'exécution en série
    "checker": "YOUR_CHECKER_MODEL",    # Modèle d'un autre fournisseur pour la vérification croisée
}
TOKEN_BUDGET = 50_000   # Limite de tokens par tâche
MAX_ROUNDS = 3          # Nombre maximal d'itérations

used_tokens = 0

def call(role: str, prompt: str, retries: int = 3) -> str:
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出单任务 Token 预算,熔断")
    for i in range(retries):
        try:
            resp = client.chat.completions.create(
                model=MODELS[role],
                messages=[{"role": "user", "content": prompt}],
            )
            used_tokens += resp.usage.total_tokens
            return resp.choices[0].message.content
        except Exception as e:
            time.sleep(2 ** i)  # Délai exponentiel entre les tentatives
            last_err = e
    raise last_err

def run_agent(goal: str) -> str:
    plan = call("planner", f"将目标拆成可执行步骤:{goal}")
    output = call("executor", f"按步骤执行:\n{plan}")
    for _ in range(MAX_ROUNDS):
        verdict = call("checker", f"检查结果是否满足目标“{goal}”,"
                                  f"合格只回复 PASS,否则指出问题:\n{output}")
        if verdict.strip().startswith("PASS"):
            break
        output = call("executor", f"根据反馈修正:\n{verdict}\n原结果:\n{output}")
    print(f"本任务共消耗 Token:{used_tokens}")
    return output

print(run_agent("整理本周销售数据并写一份 300 字摘要"))
Ce code illustre plusieurs points abordés plus haut : chaque tâche nécessite au moins trois appels, les trois rôles utilisent des modèles différents, et le budget de tokens ainsi que la limite d’itérations permettent de maîtriser les coûts.
🚀 Pour commencer : récupérez d’abord un crédit de test gratuit sur APIYI apiyi.com. Testez différents modèles pour chacun des trois rôles et relevez les données
usageavant de choisir votre combinaison de modèles pour la production.
Questions fréquentes (FAQ)
Q1 : Que représentent les 177 milliards de dollars de dépenses des entreprises en IA en 2026 ?
Il s’agit d’une estimation ascendante de Menlo Ventures des dépenses des entreprises liées à l’utilisation de l’IA en 2026 : 176,8 milliards de dollars, dont environ 99,5 milliards pour l’infrastructure et 77,3 milliards pour les applications. C’est une estimation de marché, pas un total de paiements audité ni le chiffre d’affaires du marché des API.
Q2 : Quelle différence entre les dépenses d’utilisation de l’IA et celles de développement des modèles ?
Les dépenses de développement couvrent les investissements nécessaires à la création et à l’entraînement des modèles. Menlo les estime à environ 102,5 milliards de dollars. Les dépenses d’utilisation correspondent aux achats de services d’IA par les entreprises pour accomplir leur travail. Les premières représentent environ 60 % des secondes, ce qui montre que l’activité commerciale se tourne de plus en plus vers l’utilisation.
Q3 : Pourquoi les agents peuvent-ils faire dépasser le budget IA des entreprises ?
La consommation des agents dépend du volume de tâches, du niveau de parallélisme et de la durée d’exécution. Une tâche peut nécessiter plusieurs séries d’appels, tandis que plusieurs agents peuvent fonctionner en parallèle et continuer à travailler en arrière-plan. Les entreprises qui estiment leurs dépenses en fonction du nombre d’utilisateurs risquent donc de sous-estimer leur consommation réelle.
Q4 : La part de 80 % attribuée aux agents sur OpenRouter représente-t-elle l’ensemble du secteur ?
Non. Les utilisateurs d’OpenRouter sont principalement des développeurs et des startups : ces données indiquent une tendance, sans représenter tout le secteur. La répartition peut être très différente pour les déploiements privés en entreprise ou les achats directs auprès de plateformes cloud. Il faut donc préciser la source de l’échantillon lorsqu’on cite ce chiffre.
Q5 : Comment les développeurs peuvent-ils tester à moindre coût une solution d’agents multimodèles ?
Pour créer un prototype, il est conseillé d’utiliser une plateforme d’agrégation dotée d’une interface unifiée :
1. Rendez-vous sur APIYI apiyi.com pour vous inscrire et obtenir une clé API ainsi que des crédits de test gratuits
2. Remplacez le base_url et les noms de modèles dans l’exemple ci-dessus par les paramètres indiqués dans la console
3. Mesurez séparément la consommation de tokens pour la planification, l’exécution et la vérification, puis optimisez votre combinaison de modèles
Q6 : Quelles sont les limites connues des agents aujourd’hui ?
Il y en a trois principales. Premièrement, les tâches dont les résultats sont difficiles à vérifier sont sujettes aux erreurs et nécessitent toujours un examen par des spécialistes. Deuxièmement, l’exécution de plusieurs agents en parallèle augmente la charge de supervision et certains utilisateurs signalent une fatigue mentale. Troisièmement, le coût des tâches exécutées en arrière-plan est difficile à prévoir. En pratique, vous pouvez commencer par tester le processus sur APIYI apiyi.com avec un petit budget, puis définir un plafond de dépenses avant de passer à plus grande échelle.
Dépenses des entreprises en IA et agents : points clés
- Échelle : Menlo estime les dépenses des entreprises liées à l’utilisation de l’IA à environ 176,8 milliards de dollars en 2026, soit près de 5,4 fois celles de l’année précédente.
- Écart budgétaire : les dépenses réelles moyennes des entreprises ont été multipliées par 4,7 par rapport à l’année précédente, alors qu’une hausse d’un facteur 1,9 seulement était prévue.
- Moteur de croissance : la hausse vient surtout d’un usage plus intensif dans les entreprises déjà équipées, plutôt que d’une progression du taux d’adoption.
- Mécanisme d’invocation : avec les agents, la consommation de tokens dépend du nombre de tâches, du degré de parallélisme et de la durée d’exécution.
- Conditions de déploiement : il faut un environnement d’exécution, un contexte complet et des résultats vérifiables, ce qui explique l’avance du développement logiciel.
- Interprétation prudente : les dépenses des entreprises en IA ne correspondent pas aux revenus des API, et la croissance des tokens ne signifie pas une hausse équivalente des revenus d’une année sur l’autre.
- Pour se lancer : APIYI apiyi.com permet de combiner les modèles de plusieurs fournisseurs avec une seule clé et d’estimer le coût de tâches réelles.
Conclusion
Les dépenses des entreprises en IA connaissent trois changements majeurs en 2026 :
- De l’usage humain à l’exécution de tâches : la consommation de modèles passe progressivement des « questions posées par des humains » à « l’exécution continue par des agents ».
- Des frais d’outils à un budget distinct : plus de la moitié des nouvelles dépenses proviennent de budgets supplémentaires ; l’IA devient un coût opérationnel géré séparément.
- De la vente de tokens à la vente de fiabilité : la concurrence entre services API portera davantage sur la stabilité, les appels simultanés, le basculement entre modèles et le suivi de la consommation.
Pour les développeurs et les acheteurs, le plus utile aujourd’hui est de calculer le « coût par tâche » à partir de cas réels, plutôt que d’estimer le budget en fonction du nombre d’utilisateurs. APIYI apiyi.com permet de créer rapidement un prototype d’agent multimodèle et d’utiliser les données réelles de usage pour préparer le budget IA de l’année suivante.
📚 Références
- Menlo Ventures – 2026 The State of Enterprise AI : principale source de données de cet article
- Lien :
menlovc.com/perspective/2026-the-state-of-enterprise-ai -
Contenu : dépenses des entreprises en IA, parts de marché des API, données d’OpenRouter sur les agents et méthodologie de l’enquête
-
Reuters – Brockman parle des revenus d’OpenAI auprès des entreprises : les entreprises représentent plus de la moitié des revenus d’OpenAI
- Lien :
reuters.com/legal/transactional -
Contenu : article publié le 5 novembre 2026. Attention, cet indicateur diffère des parts de marché des API présentées par Menlo
-
OpenAI – The State of Enterprise AI 2025 : données de référence sur l’utilisation de l’IA en entreprise
- Lien :
openai.com/business/guides-and-resources/the-state-of-enterprise-ai-2025-report -
Contenu : données historiques, notamment une consommation de tokens d’inférence par organisation multipliée par environ 320 sur un an
-
Axios – Office workers drive OpenAI’s Codex growth : exécution simultanée de plusieurs tâches par les agents et questions de supervision
- Lien :
axios.com/2026/06/02/openai-codex-knowledge-workers - Contenu : données de juin 2026, utiles pour comprendre comment les travailleurs du savoir utilisent les agents
Auteur : équipe technique APIYI
Échanges techniques : pour discuter de questions pratiques liées aux workflows d’agents et à l’invocation de plusieurs modèles, contactez-nous depuis la page d’accueil d’APIYI : apiyi.com