Note de l’auteur : cet article répond à une question précise — deepseek-v4-1-flash-economy-261017 est-il un modèle moins bon ? Conclusion : non, il utilise les mêmes poids que deepseek-v4.1-flash, il est simplement plus lent et moins cher.
Depuis que DeepSeek V4.1 Flash a été scindé en deux paliers tarifaires, le choix de la valeur à mettre dans le champ model d’une requête est devenu un casse-tête incontournable pour les développeurs qui utilisent ce modèle. Cet article compare deepseek-v4-1-flash-economy-261017 et deepseek-v4.1-flash, et donne des recommandations claires sous quatre angles : tarification, point de terminaison, groupe et vitesse.
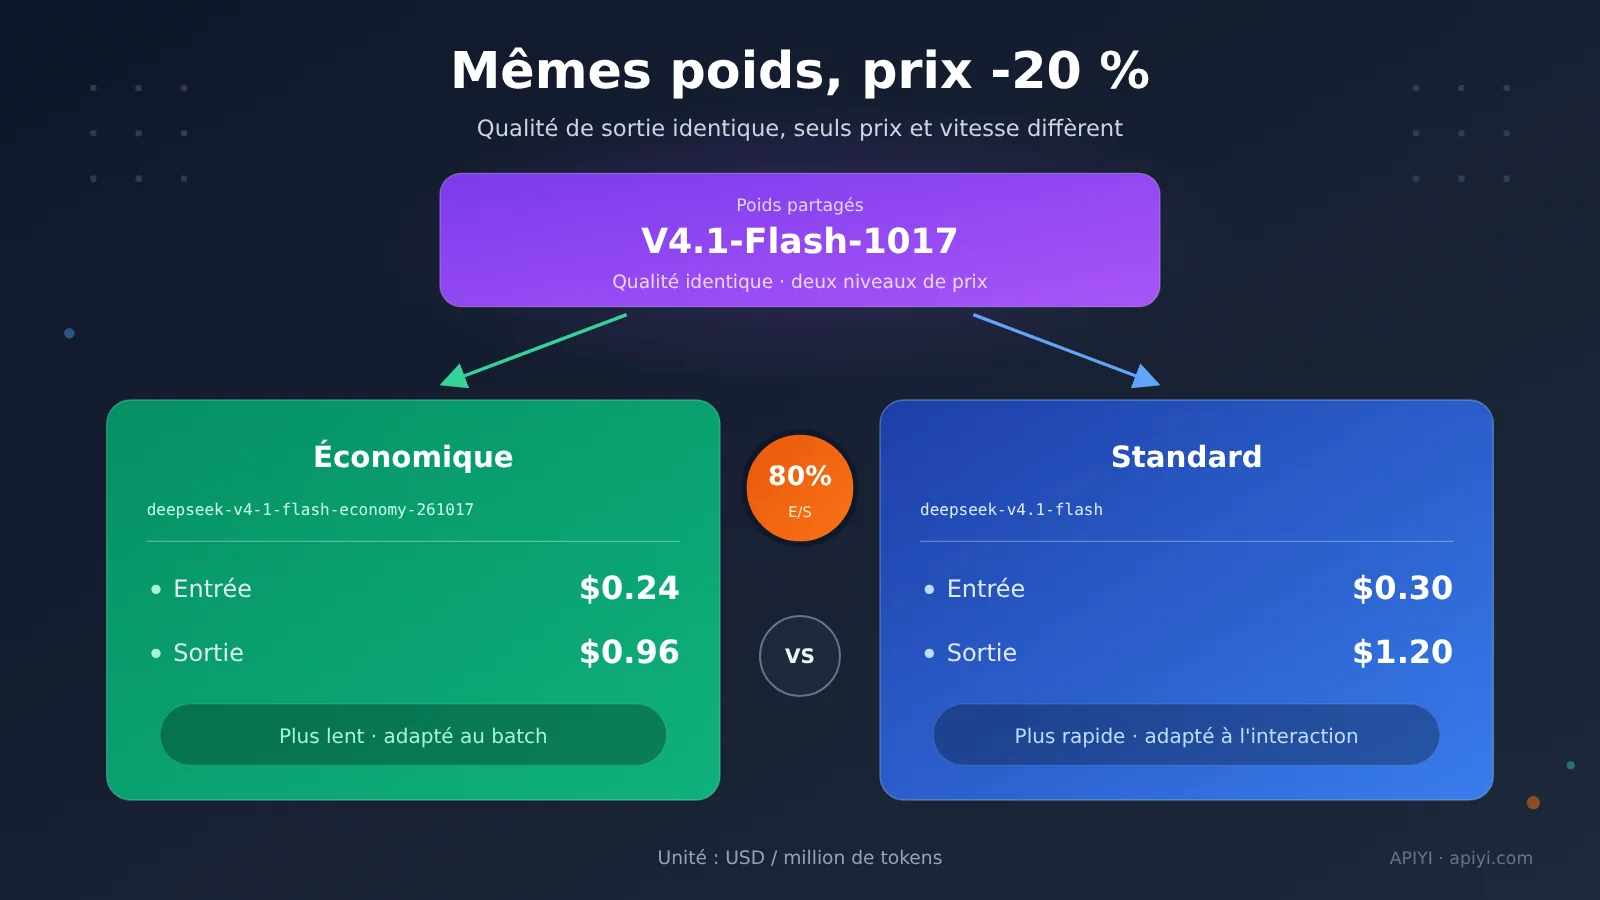
Conclusion d’emblée : la version économique n’est pas un modèle moins bon. Les deux ID chargent les mêmes poids V4.1-Flash-1017, et la qualité de sortie annoncée officiellement est identique ; il n’y a que deux différences — une génération plus lente, et des tarifs unitaires d’entrée et de sortie à 80 % de ceux de la version standard. Il ne s’agit ni d’une évaluation de nouveau modèle ni d’une version au rabais, mais des mêmes poids répartis dans deux paliers tarifaires.
L’essentiel : après lecture, vous saurez clairement quel ID choisir dans des cas comme le traitement hors ligne par lots, les produits interactifs ou les workflows au format Anthropic. Les deux modèles sont déjà disponibles sur APIYI (apiyi.com) ; il suffit de modifier une chaîne de caractères pour basculer de l’un à l’autre.
Qu’est-ce que deepseek-v4-1-flash-economy-261017 ?
La version économique est arrivée en ligne le 11 novembre 2026 à 12 h 22 (UTC+8) ; au moment de la vérification pour cet article (13 novembre 2026), elle n’a donc que deux jours. Son positionnement tient en une phrase : les mêmes poids V4.1-Flash-1017, un prix unitaire d’entrée et de sortie plus bas, une génération plus lente. Ce n’est ni une version distillée ni une version quantifiée — APIYI fournit les poids 552B complèts via le canal officiel BytePlus, sans quantification ni distillation, et la facturation se fait sur un seul palier, au tarif de pointe.
Pour l’instant, la version économique n’a ni page de détail ni page explicative dédiée : les paramètres clés sont ceux du document de lancement. Les prix ont été recoupés avec la liste officielle des modèles et l’interface de tarification d’apiyi.com — les deux concordent. Pour vous éviter d’éplucher la doc, voici l’essentiel dans un tableau :
| Point clé | Explication | Ce que ça change pour vous |
|---|---|---|
| Les mêmes poids | Partagés avec deepseek-v4.1-flash sous l’identifiant V4.1-Flash-1017 |
Qualité de sortie identique d’après les spécifications officielles, vos invites restent valables telles quelles |
| Entrée et sortie à −20 % | Entrée $0.24, sortie $0.96 (pour 1 million de tokens) | Le coût de vos tâches par lots baisse directement de 20 % |
| Génération plus lente | Le document estime environ 2 s avant le premier token, puis ~15 ms par token | Adapté au traitement par lots hors ligne, pas aux usages fortement interactifs |
| Moins de points de terminaison | Uniquement l’endpoint Chat, groupes Default et SVIP | Utilisable via l’interface compatible OpenAI |
Pourquoi deepseek-v4-1-flash-economy-261017 mérite son propre ID de modèle
Parce que ce que vous économisez, c’est du coût direct, sans avoir à prendre une assurance qualité. Dans une tâche par lots, le gros de la facture, ce sont les tokens d’entrée et de sortie : à −20 %, le même budget fait tourner environ un quart de volume en plus. Comme les poids et la qualité de sortie ne changent pas, le seul prix à payer est l’attente. La question passe donc de « faut-il basculer ? » à « mes tâches peuvent-elles se permettre d’attendre ? » — et c’est précisément la différence que nous allons détailler dans la section suivante.
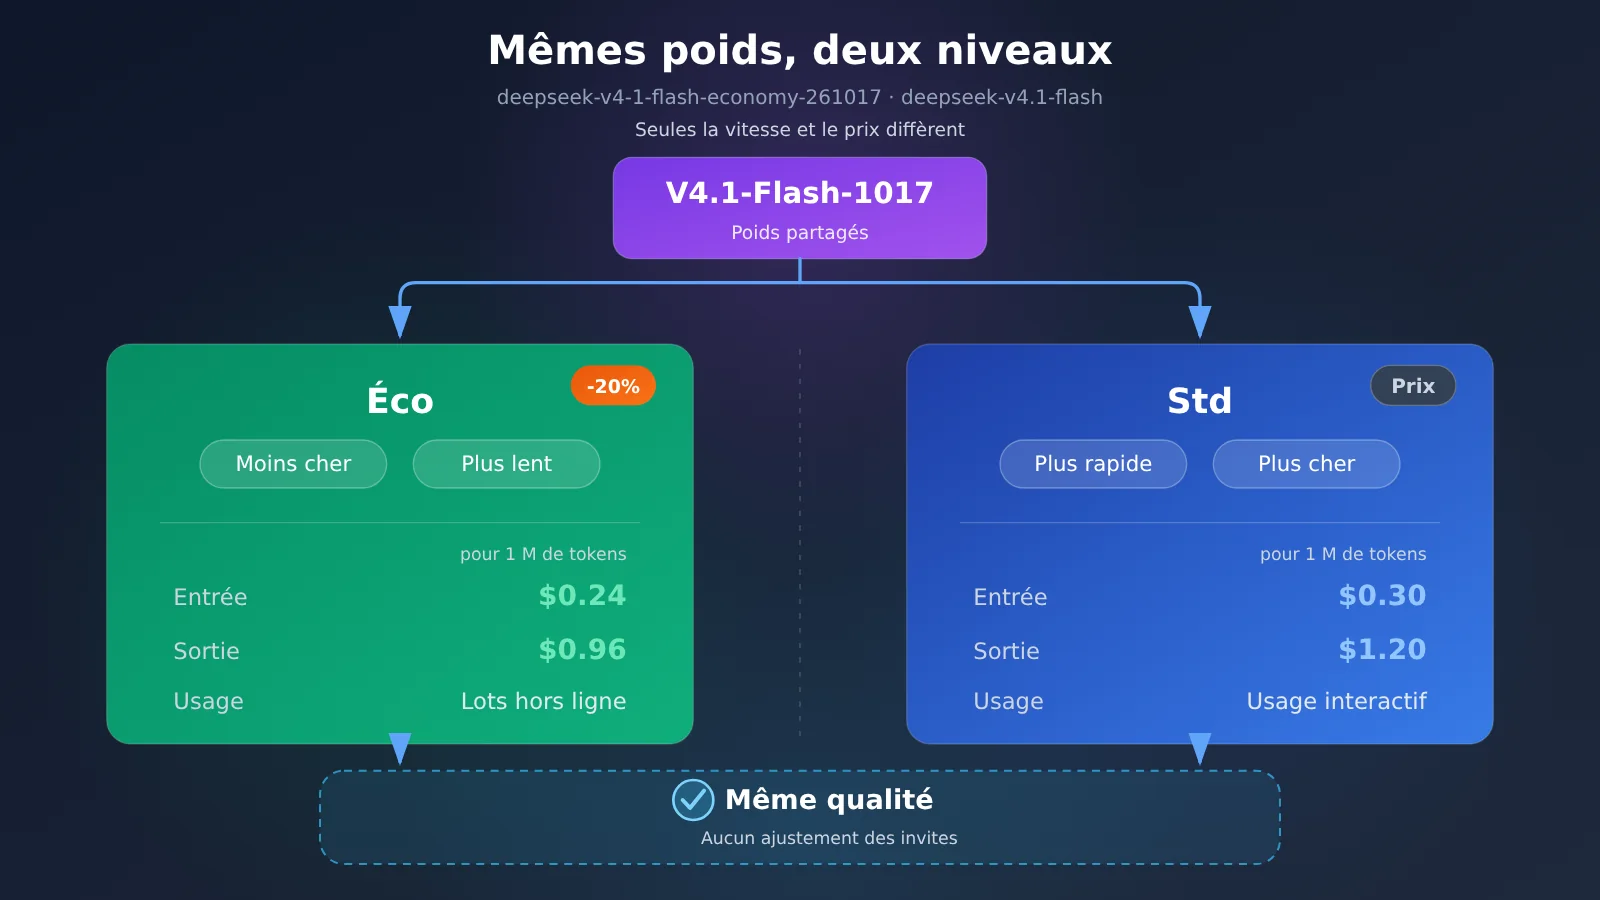
Différences clés entre deepseek-v4-1-flash-economy-261017 et deepseek-v4.1-flash
Les différences entre les deux versions se concentrent sur trois points : le prix, le point de terminaison et le groupe, ainsi que la vitesse. Les poids et la qualité ne figurent pas dans cette liste de différences : les deux versions s’appuient déjà sur le même V4.1-Flash-1017.
Différence de prix : remise de 20 % sur l’entrée et la sortie, lecture du cache au même prix
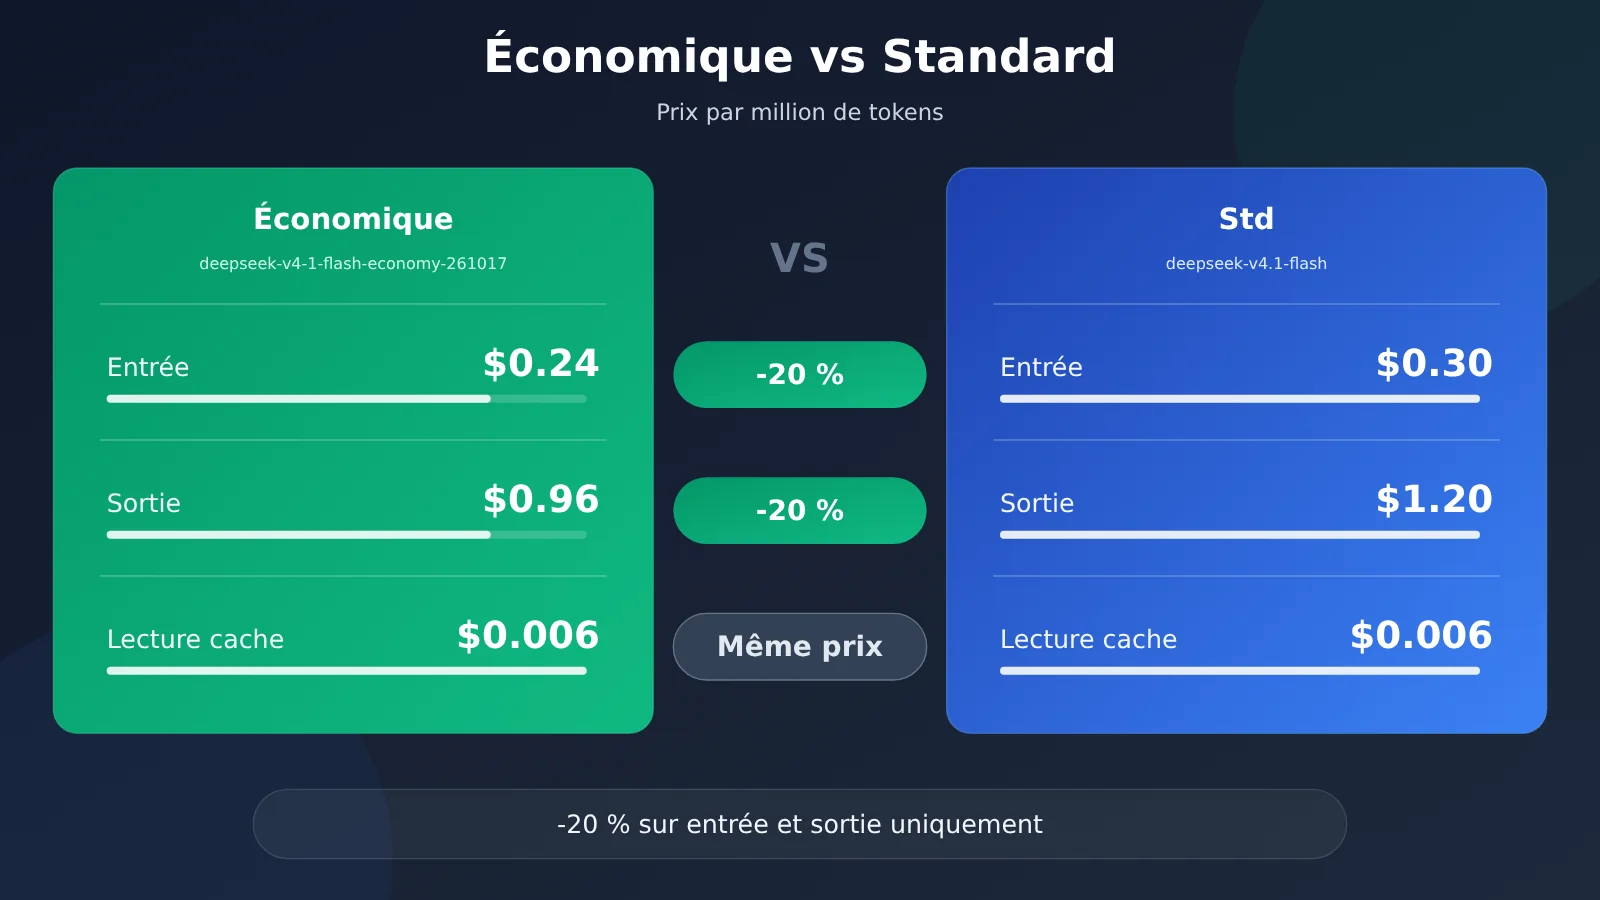
| Poste de facturation (pour 1 million de tokens) | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash | Remise |
|---|---|---|---|
| Entrée | $0.24 | $0.30 | −20 % |
| Sortie | $0.96 | $1.20 | −20 % |
| Lecture du cache | $0.006 | $0.006 | Même prix |
0.24 divisé par 0.30 donne 0.8, et 0.96 divisé par 1.20 donne aussi 0.8. La remise de 20 % ne s’applique donc qu’à l’entrée et à la sortie, les deux postes facturés de la version économique par rapport à la version standard ; la lecture du cache est à $0.006 dans les deux versions, sans remise. Si votre tâche a un taux de hit du cache élevé, ce coût est identique entre les deux versions, ce qui dilue l’économie globale : lors du calcul des coûts, il faut isoler la lecture du cache.
Un autre point prête à confusion : cette remise de 20 % est un écart fixe entre les prix catalogue des deux modèles, pas une promotion limitée dans le temps. Les avantages compte d’APIYI passent par des bonus de recharge ; le crédit offert ne modifie pas les prix unitaires du tableau ci-dessus, et la facturation se fait selon un palier unique, celui du prix de pointe, sans variation liée aux campagnes.
💰 Conseil coût : pour les tâches de traitement par lots, vous pouvez définir reasoning_effort sur none pour désactiver la réflexion, puis cumuler avec la remise de 20 % sur l’entrée et la sortie de la version économique : les deux se cumulent pour faire des économies. Si vous voulez d’abord faire les calculs avant de vous lancer, vous pouvez comparer les prix unitaires des deux modèles et simuler les coûts sur APIYI apiyi.com.
Différence d’endpoints : deepseek-v4-1-flash-economy-261017 ne propose que Chat
C’est la seule vraie différence « ça marche ou ça ne marche pas » entre les deux versions. L’édition économique n’expose que l’endpoint Chat, avec pour seuls groupes Default et SVIP ; la version standard, en plus de Chat, accepte aussi le format Anthropic, et ajoute les groupes ClaudeCode et CodexResponses.
| Dimension | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash |
|---|---|---|
| Endpoint | Chat | Chat, format Anthropic |
| Groupes | Default, SVIP | Default, SVIP, ClaudeCode, CodexResponses |
Concrètement, dans un workflow : si le client assemble ses requêtes au format de messages Anthropic, ou si l’orchestration tourne dans les groupes ClaudeCode ou CodexResponses, la seule option est deepseek-v4.1-flash. Pour les applications classiques qui passent par une interface compatible OpenAI, les deux versions conviennent. Dans les deux cas, on met https://api.apiyi.com/v1 dans le base_url, et changer de version ne demande de toucher que le champ model.
Différence de vitesse : deepseek-v4-1-flash-economy-261017 est plus lent, mais seulement plus lent
La documentation de lancement donne une estimation de vitesse : environ 2 secondes pour le premier token, puis environ 15 millisecondes par token. À souligner : ce sont des estimations issues de la doc, pas un classement de mesures réelles. Le ressenti variera selon la longueur de la tâche et le moment de la journée ; si vous vous en servez pour dimensionner votre capacité, gardez une marge. Côté qualité, pas d’inquiétude : l’éditeur indique que les deux versions offrent une qualité de sortie identique, puisqu’elles chargent en réalité le même V4.1-Flash-1017.
Autrement dit, n’allez pas traiter ces deux ID comme deux modèles distincts pour faire une évaluation qualité. Une seule chose mérite vraiment d’être évaluée : votre tâche tolère-t-elle une génération plus lente ?
Recommandations d’usage pour deepseek-v4-1-flash-economy-261017
La logique de sélection en une phrase : si vous n’êtes pas sensible à la latence et que vous passez par l’endpoint Chat, prenez la version économique ; dans le cas inverse, prenez la version standard. Voici le détail par scénario.
Quand choisir deepseek-v4-1-flash-economy-261017
Pour les cas où le prix unitaire passe en premier et où personne n’attend le résultat devant un écran :
- Traitement par lots hors ligne : résumé de logs, étiquetage de documents, nettoyage de corpus, traduction en masse — gros volumes, mise en file possible, relance possible
- Tâches planifiées nocturnes : les tâches accumulées le jour tournent la nuit, les 2 secondes avant le premier token passent totalement inaperçues
- Étapes intermédiaires sensibles au coût : classification, extraction, transformation structurée — ces nœuds de pipeline n’ont pas besoin d’interaction humaine
- Relances avec préfixe long : le même lot de contexte est appelé plusieurs fois ; la partie qui touche le cache est au même prix sur les deux versions, et l’entrée non mise en cache est à 80 % du prix sur la version économique
Le traitement par lots a aussi une petite option à retenir : régler reasoning_effort sur none désactive la réflexion, ce qui économise des tokens de sortie. C’est indépendant de la remise de 20 %, mais les deux peuvent se cumuler.
Quand continuer à utiliser deepseek-v4.1-flash
- Produits interactifs : chat, interfaces de type Copilot — la latence avant le premier token pèse directement sur l’expérience
- Workflows au format Anthropic fixe : le client assemble les requêtes selon le protocole Anthropic, la version économique ne sait pas les recevoir
- Groupes ClaudeCode et CodexResponses : l’orchestration repose sur ces deux groupes, que seule la version standard fournit
- Débit en ligne prioritaire : payer plus cher pour bénéficier d’un rythme de génération plus rapide
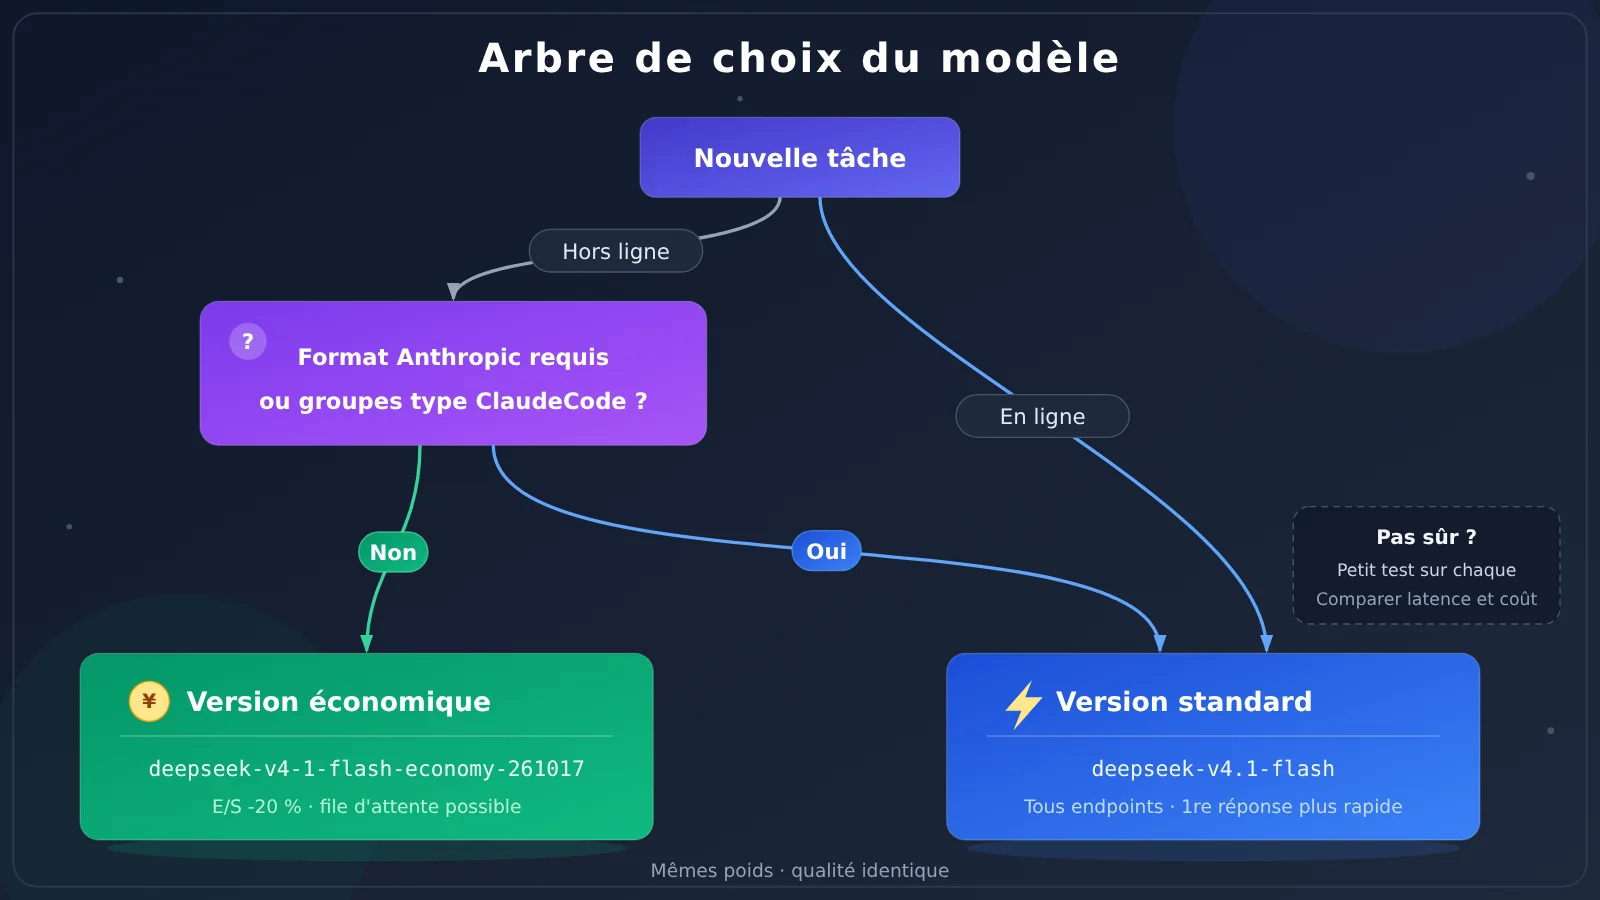
| Votre scénario | Recommandation | Raison |
|---|---|---|
| Traitement par lots hors ligne, tâches planifiées | deepseek-v4-1-flash-economy-261017 |
Entrée et sortie à 80 % du prix, latence imperceptible |
| Chat, interface Copilot | deepseek-v4.1-flash |
Priorité à la vitesse de première réponse |
| Format Anthropic ou groupes ClaudeCode, CodexResponses | deepseek-v4.1-flash |
La version économique ne dispose que de l’endpoint Chat |
| Mise en file possible, sensibilité au coût | deepseek-v4-1-flash-economy-261017 |
Mêmes poids, qualité identique |
🎯 Conseil de scénario : en cas de doute, faites tourner un petit lot de la même tâche sur les deux versions, puis comparez latence et facture avant de trancher. APIYI apiyi.com permet de basculer directement sur le champ model avec une seule clé API, sans toucher au reste de la configuration.
deepseek-v4-1-flash-economy-261017 : recommandations de choix et méthode de bascule
La bascule ne coûte rien. La structure de la requête reste inchangée, le base_url reste https://api.apiyi.com/v1 ; il suffit de remplacer le champ model de deepseek-v4.1-flash par deepseek-v4-1-flash-economy-261017 pour changer de palier. La facturation distingue automatiquement les modèles, inutile de changer de clé API, et les groupes Default et SVIP peuvent tous utiliser la version économique.
| Champ | Version économique | Version standard |
|---|---|---|
| model | deepseek-v4-1-flash-economy-261017 |
deepseek-v4.1-flash |
| base_url | https://api.apiyi.com/v1 |
https://api.apiyi.com/v1 |
| Point de terminaison | Chat | Chat, format Anthropic |
| Prix unitaire entrée / sortie | $0.24, $0.96 | $0.30, $1.20 |
Un piège dans lequel on tombe facilement : dans l’ID de la version standard, c’est un point — deepseek-v4.1-flash, pas un trait d’union ; si l’un des deux ID est mal orthographié, l’API renvoie une erreur indiquant que le modèle n’existe pas. Conseil : enregistrez ce tableau de référence dans le mémo de configuration des modèles de l’équipe pour éviter les fautes de frappe.
💡 Conseil de choix : utilisez la version économique pour le traitement par lots hors ligne et la version standard pour les interactions en ligne ; seule la version standard prend en charge le format Anthropic ou les groupes ClaudeCode et CodexResponses. Pour une nouvelle tâche, vous pouvez d’abord faire tourner un petit lot sur chacun des deux paliers avec le quota d’essai gratuit sur APIYI (apiyi.com), puis arrêter votre choix.
deepseek-v4-1-flash-economy-261017 — Questions fréquentes (FAQ)
Q1 : Qu’est-ce que deepseek-v4-1-flash-economy-261017 ?
C’est le palier économique de DeepSeek V4.1 Flash, mis en ligne le 2026-11-11 à 12:22 (UTC+8). Il charge exactement les mêmes poids V4.1-Flash-1017 que la version standard `deepseek-v4.1-flash` ; les tarifs d’entrée et de sortie correspondent à 80 % de ceux de la version standard, mais la génération est plus lente.
Q2 : Quelle est la différence entre deepseek-v4-1-flash-economy-261017 et deepseek-v4.1-flash ?
Trois points : le prix (entrée et sortie à 80 %, lecture de cache au même tarif), la vitesse (la version économique est plus lente), et les endpoints/groupes (la version économique ne propose que Chat et Default, SVIP ; la version standard ajoute le format Anthropic ainsi que ClaudeCode et CodexResponses). Les poids et la qualité de sortie sont identiques.
Q3 : Quand la version économique est-elle sortie ? Peut-on l’utiliser dès maintenant ?
Elle a été mise en ligne le 2026-11-11 à 12:22 (UTC+8) et est déjà disponible sur APIYI apiyi.com, dans les groupes Default et SVIP. Elle n’a pas encore de page de détail dédiée ; les paramètres font foi dans la documentation de lancement et la liste officielle des modèles.
Q4 : Dans quels cas d’usage deepseek-v4-1-flash-economy-261017 est-il le plus adapté ?
Les tâches peu sensibles à la latence et passant par l’endpoint Chat : résumés de logs en lot, étiquetage de documents, nettoyage de corpus, traduction par lots, tâches planifiées de nuit, pipelines de classification et d’extraction sensibles au coût. Pour du traitement hors ligne par lots, vous pouvez aussi mettre `reasoning_effort` à `none` pour désactiver la réflexion et économiser encore des tokens.
Q5 : Comment appeler deepseek-v4-1-flash-economy-261017 via l’API ?
Créez un compte sur APIYI apiyi.com pour obtenir une clé API, renseignez `https://api.apiyi.com/v1` comme base_url, mettez `deepseek-v4-1-flash-economy-261017` dans le champ model, puis lancez un appel Chat via l’interface compatible OpenAI. Les nouveaux utilisateurs disposent d’un quota de test gratuit, de quoi comparer directement la latence et la facture entre les deux paliers.
Q6 : Quelles sont les limitations connues de deepseek-v4-1-flash-economy-261017 ?
Trois points à garder en tête : la génération est plus lente (environ 2 secondes avant le premier token et environ 15 ms par token d’après la documentation) ; seul l’endpoint Chat est disponible, donc si vous avez besoin du format Anthropic, passez par la version standard ; la lecture de cache n’est pas remisée, elle reste à $0.006 comme pour la version standard. C’est « plus lent mais moins cher », pas « moins bon ».
Q7 : Les 80 % sont-ils une promotion ? Le prix reviendra-t-il au tarif normal plus tard ?
Ce n’est pas une promotion. Les 80 % correspondent à l’écart fixe entre les tarifs catalogue des deux modèles — entrée $0.24 contre $0.30, sortie $0.96 contre $1.20. Sur APIYI apiyi.com, les avantages du compte passent par des bonus de recharge et ne modifient pas ces deux tarifs unitaires ; la facturation se fait sur le palier du prix de pointe.
deepseek-v4-1-flash-economy-261017 — points clés à retenir
- Mêmes poids : partage V4.1-Flash-1017 avec
deepseek-v4.1-flash, qualité de sortie identique selon les spécifications officielles - La limite des 20 % de remise : entrée à 0,24 $, sortie à 0,96 $ (par million de tokens), soit 80 % du tarif standard ; lecture de cache à 0,006 $, même prix pour les deux versions
- Le prix à payer en vitesse : la documentation estime environ 2 secondes avant le premier token et environ 15 millisecondes par token — adapté au traitement hors ligne, pas à l’interactif
- Différence au niveau des endpoints : la version économique ne propose que Chat (Default, SVIP) ; la version standard ajoute le format Anthropic ainsi que les groupes ClaudeCode et CodexResponses
- Coût de bascule : la structure de la requête ne change pas, il suffit de modifier le champ model pour passer d’un palier à l’autre
- Règle de décision : si vous pouvez attendre, économisez ; si vous ne pouvez pas, privilégiez la vitesse
Résumé
La relation entre les deux modèles tient en une phrase : deepseek-v4-1-flash-economy-261017 et deepseek-v4.1-flash sont deux paliers d’une même pondération V4.1-Flash-1017 — qualité identique, vitesse différente, et un écart de prix entrée/sortie de 20 %.
- Coût : les tâches en traitement par lots en profitent directement, avec 20 % de remise en entrée et en sortie, et un prix identique pour la lecture de cache
- Capacités : les pondérations complètes de 552B sont fournies via le canal officiel BytePlus, sans quantification ni distillation
- Périmètre : la version économique ne dispose que de l’endpoint Chat et des groupes Default, SVIP ; le format Anthropic et les groupes ClaudeCode, CodexResponses sont réservés à la version standard
Le choix reste simple : si la latence ne vous dérange pas, prenez la version économique ; pour de l’interaction en ligne ou un format Anthropic imposé, prenez la version standard. Je vous conseille de passer par APIYI apiyi.com en utilisant le quota d’essai gratuit pour lancer un petit lot sur chacun des deux paliers et laisser la facture trancher à votre place.
📚 Références
- Documentation de lancement de DeepSeek V4.1 Flash — Édition Économique
- Lien :
docs.apiyi.com/live/2026-11/deepseek-v4-1-flash-economy-launch.md -
Description : Source primaire pour les pondérations, les tarifs, les endpoints, les groupes et les estimations de vitesse
-
Liste des modèles APIYI
- Lien :
docs.apiyi.com/models -
Description : Point de vérification des prix unitaires affichés pour les deux modèles
-
API de tarification APIYI
- Lien :
api.apiyi.com/api/pricing - Description : Données tarifaires lisibles par machine, adaptées à une vérification automatisée
Auteur : Équipe technique APIYI
Échanges techniques : N’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com