Note de l’auteur : si votre agent utilise encore client.chat.completions.create avec tools, le passage à GPT-6.1 vous amène à un point de bascule très concret. Le texte fonctionne toujours, mais pour les appels d’outils, il faut changer d’endpoint.
Pourquoi, après le passage à GPT-6.1, les appels d’outils se retrouvent bloqués par l’endpoint
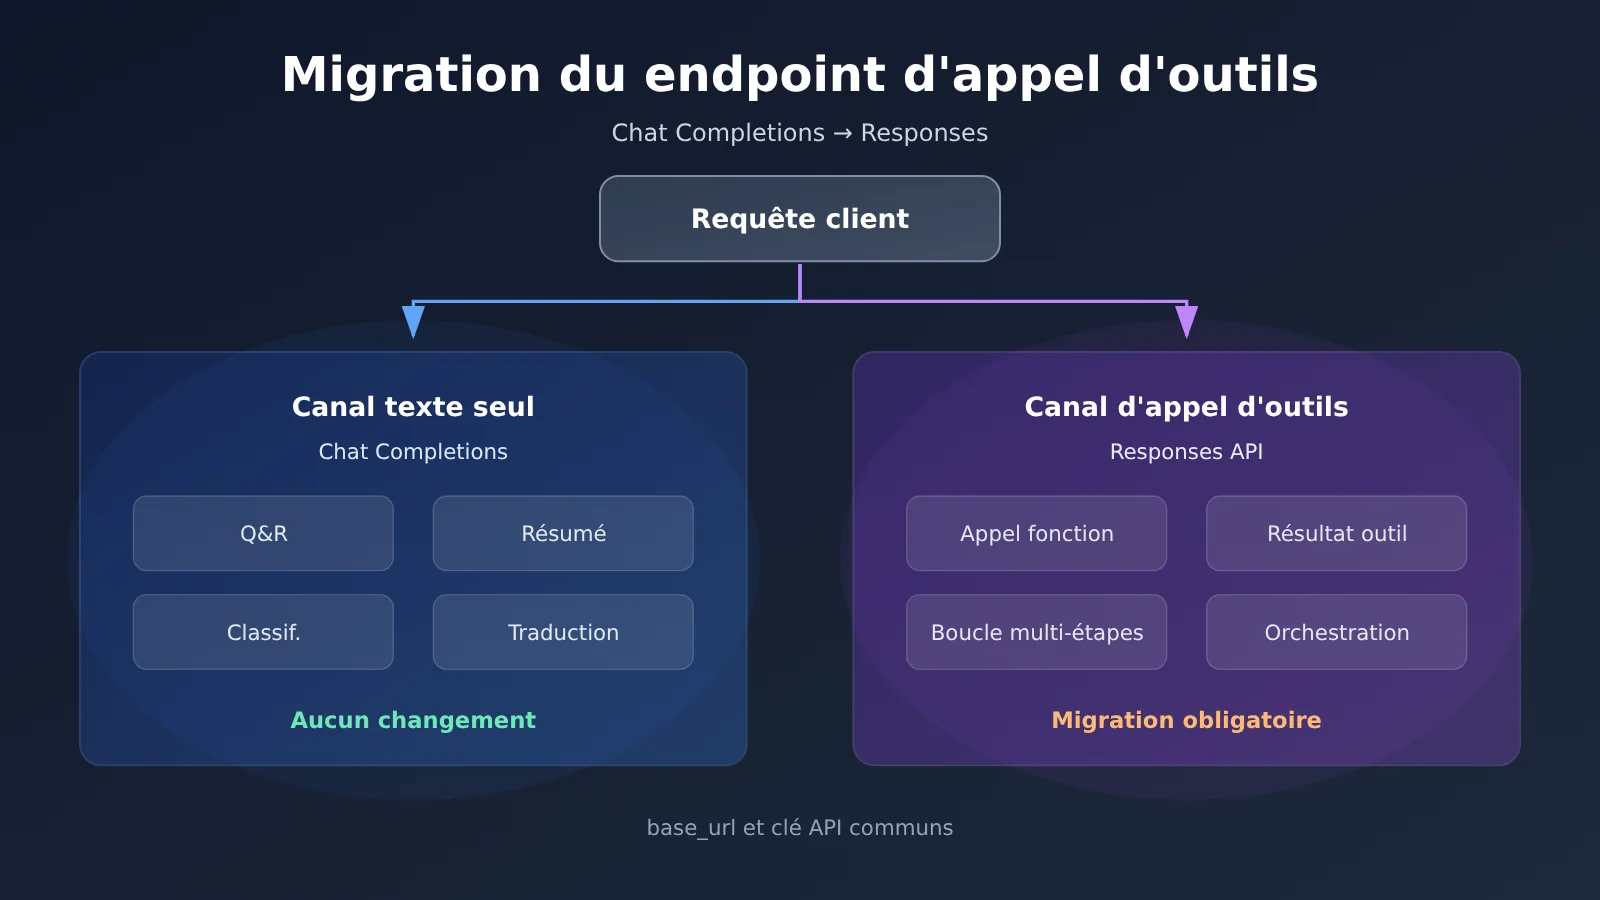
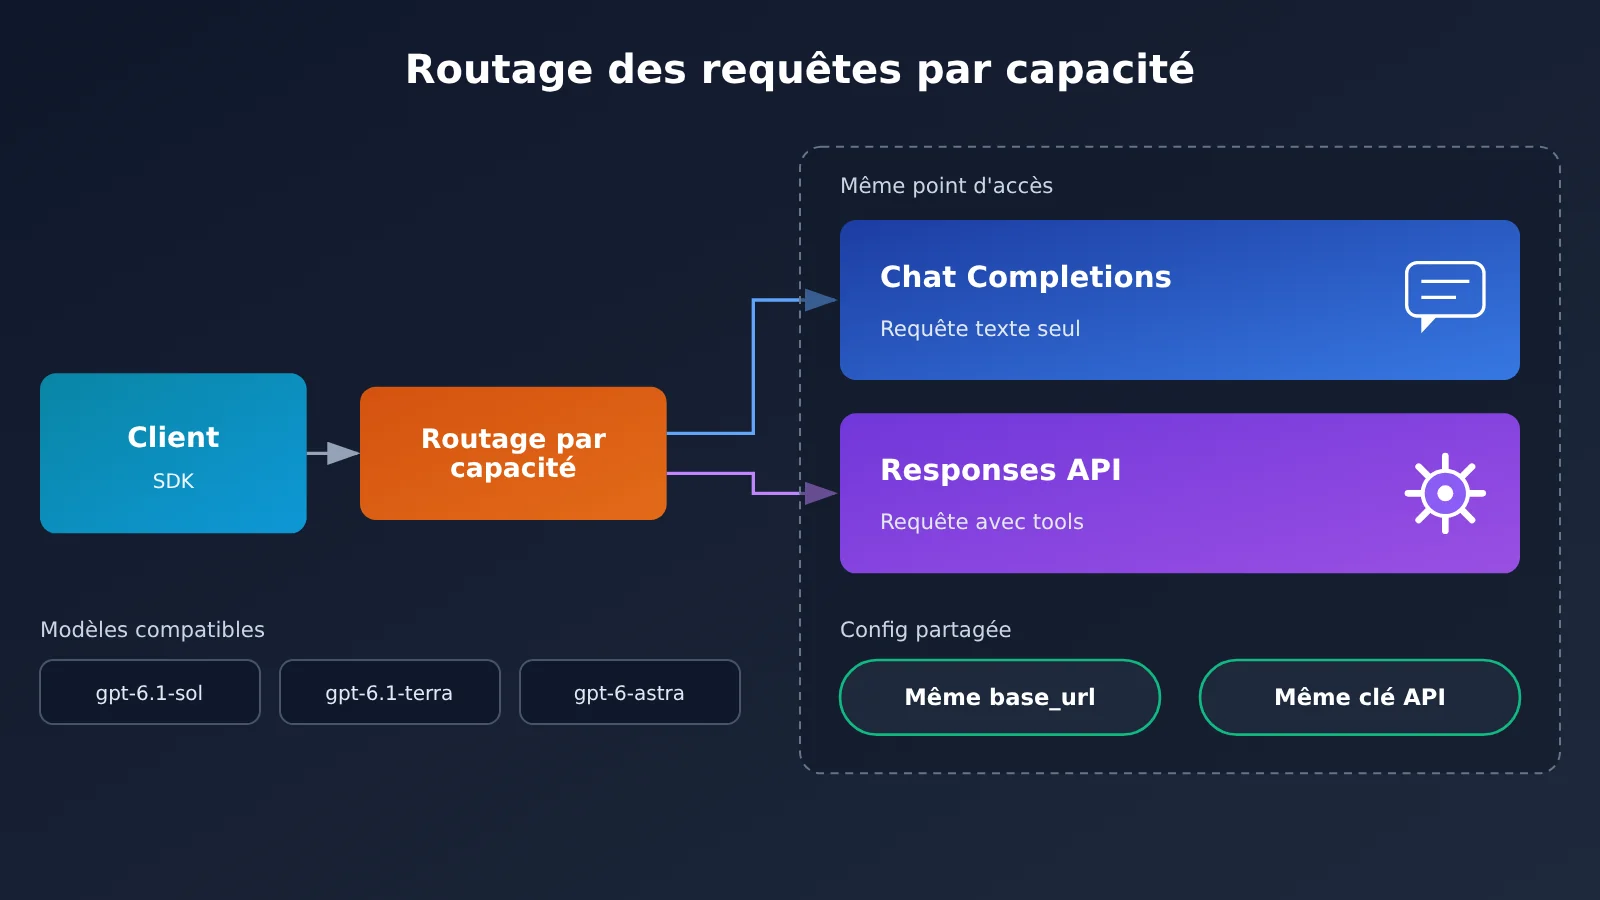
Commençons par la conclusion : GPT-6 Astra, GPT-6.1 Sol et GPT-6.1 Terra prennent tous en charge Chat Completions, mais les appels d’outils doivent passer par l’API Responses. Dans un même code, une conversation purement textuelle peut donc rester sur Chat. Dès que vous devez déclarer des fonctions, lire des retours d’outils ou faire tourner une boucle d’outils sur plusieurs tours, la requête doit partir vers l’endpoint Responses.
Ce n’est pas un problème de compatibilité qu’on contourne en ajustant des paramètres. Changer la syntaxe de tools n’y fait rien, ajouter tool_choice non plus : pour ces trois modèles, la voie Chat Completions n’offre tout simplement pas l’appel d’outils. Ce qu’il faut changer, c’est l’endpoint lui-même, ainsi que toute la structure de requête et de réponse qui l’entoure. Si vous voulez comparer les deux endpoints avec votre propre clé API, vous pouvez utiliser le point d’entrée unifié d’APIYI (apiyi.com) : il suffit de pointer base_url vers https://api.apiyi.com/v1 et de changer l’ID du modèle pour basculer.
Un autre piège concerne GPT-6 Sol et GPT-6 Luna. Dans Chat Completions, ces deux modèles peuvent faire de l’appel de fonctions, mais seulement si reasoning_effort vaut none. Autrement dit, ils savent appeler des outils via Chat, mais au prix de la désactivation du niveau de raisonnement. Si vous voulez garder le raisonnement, il faut là aussi repasser par Responses. Ce détail est souvent négligé : le code tourne, mais les résultats ne sont pas ceux attendus.
Ce que vous allez en retirer : à la fin de cet article, vous saurez à quelle catégorie appartient votre chaîne d’appels d’outils, et vous pourrez faire passer vos requêtes de l’endpoint Chat à l’endpoint Responses sans remettre en cause votre architecture globale.
Points clés de l’appel d’outils avec GPT-6.1
Le tableau ci-dessous indique, pour trois modèles récents et deux anciens, quel point de terminaison utiliser. Repérez d’abord votre cas avant de passer aux étapes de migration.
| Modèle | Chat Completions texte seul | Chat Completions appel d’outils | Point de terminaison à utiliser pour les outils |
|---|---|---|---|
| gpt-6.1-sol | Pris en charge | Non pris en charge | Responses |
| gpt-6.1-terra | Pris en charge | Non pris en charge | Responses |
| gpt-6-astra | Pris en charge | Non pris en charge | Responses |
| gpt-6-sol | Pris en charge | Uniquement si reasoning_effort vaut none |
Responses (si vous voulez conserver le raisonnement) |
| gpt-6-luna | Pris en charge | Uniquement si reasoning_effort vaut none |
Responses (si vous voulez conserver le raisonnement) |
Répartition des rôles : Chat pour le texte, Responses pour les outils
Ce tableau se résume en une phrase : sur la série GPT-6, Chat Completions devient un simple canal texte, et les outils passent par Responses. L’impact sur vos projets existants dépend de ce qu’ils font. Un service de questions-réponses, de résumé ou de classification n’a presque rien à changer. En revanche, un service qui fait de l’agent, de l’appel de fonctions ou de l’orchestration d’outils en plusieurs étapes doit obligatoirement migrer.
Si votre équipe a déjà encapsulé le SDK dans une couche maison, la migration sera plus légère que prévu. L’ID du modèle reste le même, tout comme l’authentification et la base_url. Seuls la structure du corps de la requête et la manière de renvoyer les résultats d’outils changent. Le vrai travail ne consiste donc pas à « changer de modèle », mais à « changer la façon de l’appeler ».
Comment choisir parmi les trois modèles principaux
GPT-6.1 Sol et GPT-6.1 Terra forment le duo phare de cette génération, et ils se distinguent surtout par leur positionnement et leur coût. GPT-6 Astra était le modèle haut de gamme de la génération précédente : il gère toujours le texte seul via Chat et l’appel d’outils via Responses, ce qui convient bien aux projets déjà stables que l’on ne veut pas remanier en profondeur. Pour choisir, regardez d’abord la fréquence de vos appels d’outils, ensuite la longueur du contexte par requête, et seulement en dernier le prix unitaire. Les appels d’outils entraînent souvent de nombreux allers-retours, ce qui amplifie la consommation de tokens.
Vous trouverez les tarifs dans le tableau plus bas. Vous pouvez aussi vérifier la grille de facturation en vigueur directement dans la documentation d’APIYI (apiyi.com), pour ne pas bâtir votre budget sur d’anciens prix.
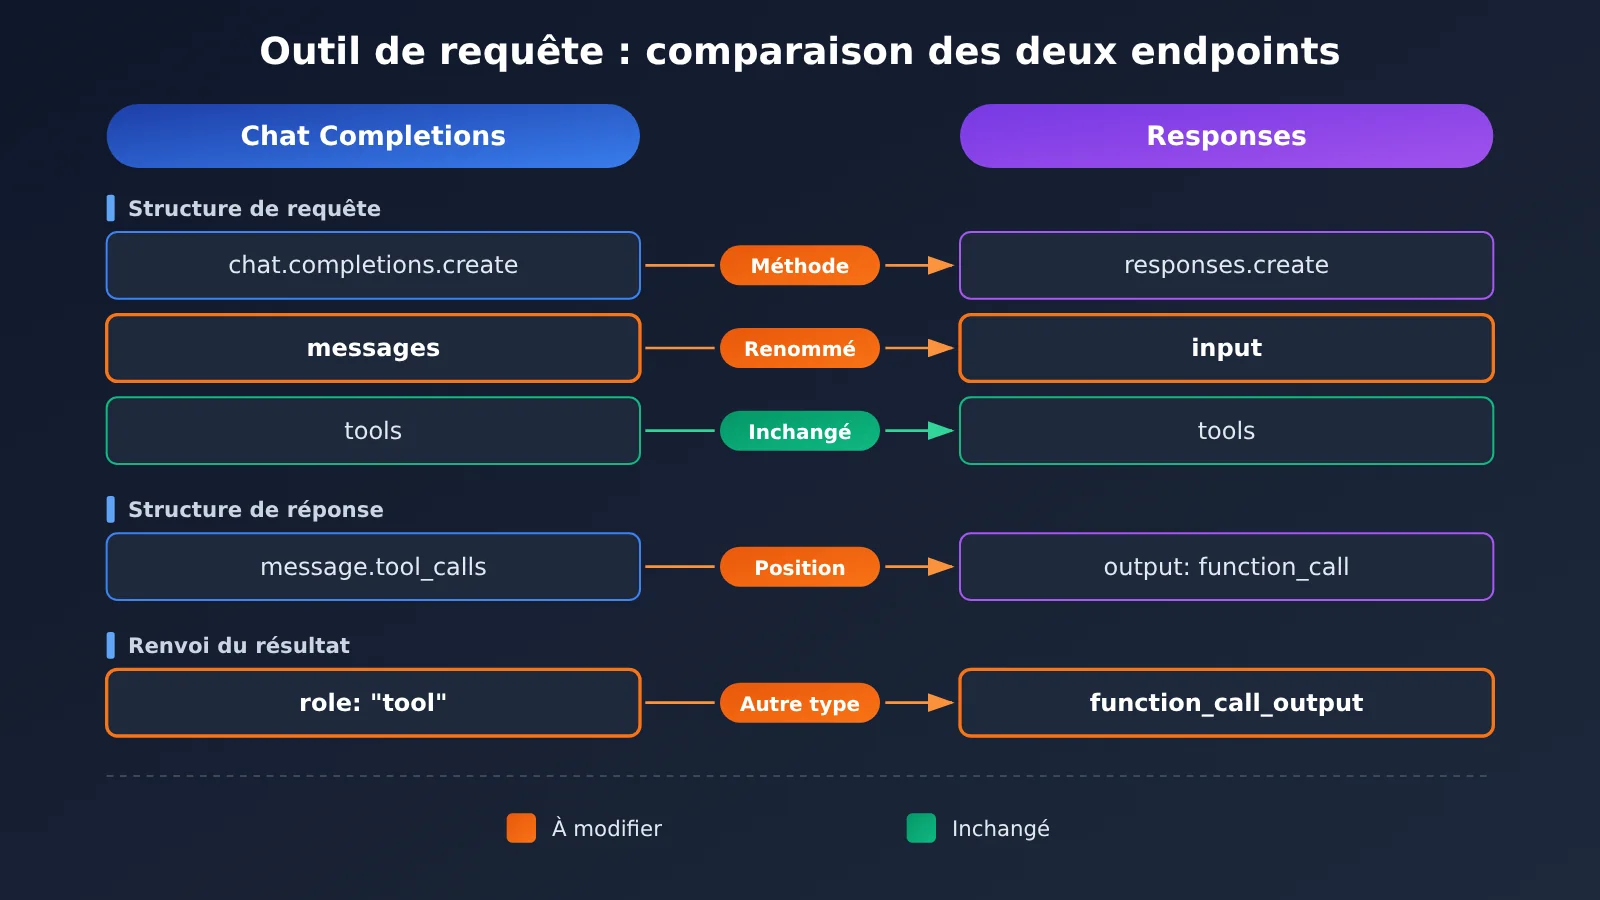
GPT-6.1 : les 5 changements à faire pour l’appel d’outils
C’est la section la plus pratique de tout l’article. Une fois ces 5 points modifiés, une boucle d’appel d’outils classique peut passer de l’endpoint Chat à l’endpoint Responses.
| N° | Point de changement | Écriture Chat Completions | Écriture Responses |
|---|---|---|---|
| 1 | Méthode d’appel | client.chat.completions.create |
client.responses.create |
| 2 | Support d’entrée | tableau messages |
paramètre input |
| 3 | Déclaration des outils | tools (conservé) |
tools (structure globalement identique) |
| 4 | Renvoi du résultat d’outil | message avec role: "tool" |
élément de type function_call_output |
| 5 | Contexte multi-tours | assembler à la main l’ensemble des messages |
possibilité d’enchaîner avec previous_response_id |
Les points 1 et 2 sont les plus faciles à oublier. Beaucoup de gens modifient la structure de tools, pensent que la migration est terminée, puis s’aperçoivent que la méthode du SDK n’a pas changé du tout et que leurs requêtes partent toujours vers chat.completions. C’est la méthode qui détermine l’endpoint : tant que vous ne la changez pas, l’endpoint ne change pas.
Le point 4 est celui où la migration bloque le plus souvent. Avec Chat, on réinjecte le résultat d’exécution de l’outil dans messages sous la forme d’un message role: "tool". Avec Responses, il faut renvoyer tel quel l’élément d’appel retourné par le modèle, puis ajouter un élément function_call_output. Si vous en oubliez un, ou si l’ordre est inversé d’un cran, le modèle risque de relancer le même appel en boucle.
Le point 5 relève du « pas obligatoire, mais recommandé ». Responses permet de reprendre le tour précédent avec previous_response_id, ce qui évite de renvoyer tout l’historique des messages à chaque fois. Pour un agent qui enchaîne beaucoup de tours d’outils, l’impact sur le coût est bien plus net que celui d’un changement de modèle.
🎯 Conseil technique : pendant la migration, le moyen de vérifier le plus simple consiste à faire tourner l’ancienne et la nouvelle chaîne en parallèle sur le même lot de requêtes, puis à comparer le taux de déclenchement des outils et la structure des réponses. Avec l’interface unifiée d’APIYI (apiyi.com), vous n’avez plus à gérer des clés pour plusieurs plateformes : une seule configuration suffit pour comparer concrètement les réponses de Responses et de Chat.
Prise en main de l’appel d’outils avec GPT-6.1
Un exemple minimal avec appel d’outil
Imaginons que vous avez une fonction outil pour consulter le statut d’une commande, nommée get_order_status, qui prend en entrée un numéro de commande. Il n’y a que deux endroits à modifier : la méthode d’appel et le renvoi du résultat.
- L’initialisation du client reste identique :
api_keycorrespond à votre propre clé, etbase_urlpointe vershttps://api.apiyi.com/v1. Tous les modèles compatibles avec l’interface OpenAI peuvent ainsi être appelés directement. - Pour l’ID du modèle, utilisez
gpt-6.1-sol(ougpt-6.1-terra,gpt-6-astra). Ces trois modèles passent par Responses pour l’appel d’outils. - Remplacez l’ancien
client.chat.completions.create(...)parclient.responses.create(...), et le paramètremessagesparinput. - Continuez à passer
toolscomme avant : la description des outils et le schéma des paramètres n’ont pas besoin d’être réécrits. - Dans le
outputrenvoyé, repérez l’entrée de typefunction_call, récupérez le nom de l’outil et ses arguments, puis exécutez en local votre fonction de consultation de commande. - Ajoutez le résultat de l’exécution sous forme de
function_call_output, puis lancez une seconde requête pour obtenir la réponse finale.
Sur ces 6 étapes, seules les étapes 3 et 6 sont vraiment « obligatoires ». Les étapes 1 et 2 relèvent de la configuration, et les étapes 4 et 5 consistent simplement à lire à un autre endroit ce que vous lisiez déjà à l’époque de Chat.
🚀 Démarrage rapide : si vous ne voulez pas monter votre propre environnement de test, vous pouvez obtenir un crédit de test gratuit sur APIYI (apiyi.com), faire tourner une première fois l’exemple de consultation de commande ci-dessus, puis adapter votre code de production. C’est l’approche qui présente le moins de risques.
Une approche encore plus pratique consiste à découpler d’abord la couche outils de la couche modèle : on centralise les définitions d’outils à un seul endroit, puis on encapsule le point d’entrée de l’appel dans une fonction qui décide en interne : « texte simple → Chat, présence de tools → Responses ». La migration ne touche alors que la couche d’encapsulation, et le code métier reste inchangé.
Tarifs et choix du modèle GPT-6.1 (12/11/2026)
Le tableau ci-dessous reprend les tarifs en vigueur au 12/11/2026, exprimés en dollars américains pour 1 M de tokens.
| Modèle | Entrée | Sortie | Lecture du cache | Endpoint recommandé |
|---|---|---|---|---|
| gpt-6.1-sol | $2 | $10 | $0,1 | responses |
| gpt-6.1-terra | $1 | $5 | $0,05 | responses |
| gpt-6-luna | $0,1 | $0,5 | $0,01 | chat (avec reasoning_effort à none) ou responses |
Ce tableau permet de tirer une conclusion très concrète : les prix d’entrée et de sortie de GPT-6.1 Terra sont exactement la moitié de ceux de Sol. Pour les scénarios avec beaucoup de tours d’outils et un fort taux de répétition du contexte, Terra est souvent le meilleur choix par défaut. Quant à GPT-6 Luna, son prix est inférieur d’un ordre de grandeur : il convient bien aux tâches légères comme la classification ou l’extraction, et vous gardez Sol ou Terra pour l’orchestration d’outils, là où le raisonnement est vraiment nécessaire.
La colonne « lecture du cache » mérite qu’on s’y arrête. L’appel d’outils génère naturellement beaucoup de préfixes répétés (invite système, définitions des outils, historique de conversation). Lorsque ces éléments sont servis depuis le cache, leur prix unitaire est environ vingt fois moins élevé que celui de l’entrée classique. C’est pourquoi, dans Responses, reprendre le contexte avec previous_response_id permet d’économiser non seulement du trafic, mais aussi de l’argent bien réel.
💰 Astuce coût : si vous devez répartir le budget par projet, appeler les modèles via une clé unique sur APIYI (apiyi.com) permet de centraliser la consommation de plusieurs modèles au même endroit. Combinée à la facturation à l’usage, cette approche facilite le calcul du coût réel des appels d’outils.
FAQ sur l’appel d’outils avec GPT-6.1
Q1 : Qu’est-ce que GPT-6.1, et quel est le lien avec GPT-6 ?
GPT-6.1 est une version itérative de la série GPT-6. Il comprend pour l’instant deux modèles : GPT-6.1 Sol et GPT-6.1 Terra. La série GPT-6, elle, regroupe GPT-6 Astra, GPT-6 Sol et GPT-6 Luna. Tous partagent le même canal d’appel d’outils via Responses ; la différence porte surtout sur le positionnement en termes de capacités et sur le prix.
Q2 : Pourquoi je n’arrive pas à appeler des outils avec Chat Completions ? Mes paramètres sont-ils incorrects ?
Non, ce n’est pas un problème de paramètres. Sur Chat Completions, GPT-6 Astra, GPT-6.1 Sol et GPT-6.1 Terra ne proposent que des capacités en texte seul : l’appel d’outils est réservé à l’API Responses. Modifier `tools` ou `tool_choice` n’y changera rien. Il faut remplacer la méthode du SDK `chat.completions.create` par `responses.create`.
Q3 : GPT-6 Sol et GPT-6 Luna peuvent-ils faire de l’appel de fonctions via Chat ?
Oui, mais uniquement quand `reasoning_effort` est réglé sur `none`. Si vous avez besoin de conserver l’effort de raisonnement, ces deux modèles doivent eux aussi passer par Responses. C’est la limite la plus facile à rater lors d’une migration : elle ne déclenche aucune erreur, elle produit simplement des résultats différents de ce que vous attendiez.
Q4 : Faut-il changer l’ID du modèle en migrant vers Responses ?
Non. Les ID restent `gpt-6.1-sol`, `gpt-6.1-terra` et `gpt-6-astra`, et le `base_url` ainsi que le mode d’authentification ne changent pas non plus. Ce qu’il faut vraiment modifier, c’est la méthode d’appel, le support de l’entrée et la structure utilisée pour renvoyer le résultat des outils.
Q5 : Comment vérifier rapidement que l’appel d’outils fonctionne après la migration ?
Je vous conseille un smoke test avec un petit outil de consultation de commande, toujours le même. D’abord, vérifiez que la requête arrive bien sur le point de terminaison Responses. Ensuite, vérifiez que le `output` renvoyé contient une entrée `function_call`. Enfin, vérifiez qu’après le renvoi de `function_call_output`, le modèle donne bien sa réponse finale. Si les trois étapes passent, la chaîne est opérationnelle. Sur APIYI (apiyi.com), il suffit de récupérer une clé API de test pour réaliser toute cette vérification.
Q6 : Les services en texte seul doivent-ils eux aussi migrer vers Responses ?
Pas nécessairement. Les capacités en texte seul de Chat Completions restent disponibles pour les trois modèles principaux : un service qui ne fait que des questions-réponses, des résumés ou de la traduction peut rester tel quel. Seules les requêtes impliquant `tools` doivent migrer, et c’est ce qui explique que l’impact de ce changement soit réparti par niveaux.
Q7 : Comment maîtriser le coût du contexte dans les appels d’outils sur plusieurs tours ?
Privilégiez `previous_response_id` pour enchaîner avec le tour précédent, plutôt que de renvoyer tout l’historique à chaque tour. Le préfixe répété a ainsi plus de chances de tomber dans le cache, et le tarif de lecture du cache est bien inférieur à celui de l’entrée. Avec `gpt-6.1-sol`, par exemple, l’entrée coûte 2 $ contre 0,1 $ pour la lecture du cache : l’écart est considérable.
Q8 : Y a-t-il des pièges connus lors de la migration vers Responses ?
Deux cas reviennent le plus souvent : d’abord, on a modifié uniquement la structure `tools` sans changer la méthode d’appel, si bien que la requête atterrit toujours sur l’endpoint Chat. Ensuite, on a gardé l’ancienne écriture `role: « tool »` pour renvoyer le résultat de l’outil, et le modèle ne reçoit jamais la sortie : il relance alors l’appel en boucle. Par ailleurs, si votre équipe mélange des modèles comme GPT-6 Sol, qui exigent `reasoning_effort` à `none`, mieux vaut imposer une contrainte unifiée dans la couche d’encapsulation. Vous éviterez ainsi le piège du « même outil qui fonctionne sur certains modèles et pas sur d’autres ».
Points clés à retenir sur l’appel d’outils avec GPT-6.1 (Key Takeaways)
- Les endpoints sont désormais séparés : pour GPT-6.1 Sol, Terra et GPT-6 Astra, le texte passe par Chat, mais les outils doivent passer par Responses.
- Une exception : GPT-6 Sol et GPT-6 Luna peuvent faire de l’appel de fonctions via Chat, à condition que
reasoning_effortsoit réglé surnone. - Cinq changements : la méthode d’appel, le support
input, la déclarationtools, le renvoi du résultat viafunction_call_outputet le chaînage avecprevious_response_id. - Les ID de modèle ne changent pas :
base_urlet clé API restent identiques, la migration se fait uniquement dans la couche d’encapsulation. - Le coût dépend du cache : les préfixes d’appel d’outils se répètent beaucoup, et la lecture du cache coûte environ vingt fois moins cher que l’entrée.
- Une validation en trois étapes : vérifiez l’endpoint, vérifiez que
outputcontient bien unfunction_call, puis vérifiez que vous obtenez la réponse finale après le renvoi du résultat. - Pour démarrer : utilisez le quota gratuit d’APIYI (apiyi.com) pour faire tourner d’abord un petit outil de consultation de commandes, puis adaptez votre chaîne de production.
Résumé
Le changement tient en une phrase : GPT-6.1 a déplacé l’appel d’outils de Chat Completions vers Responses, tandis que les capacités purement textuelles restent là où elles sont. Trois points à retenir :
- Classer avant de migrer : les services qui ne font que du texte n’ont pas à bouger, mais toute requête contenant
toolsdoit changer de point de terminaison. - Changer de méthode, pas seulement de paramètres : c’est
client.responses.createqui fait office d’interrupteur de point de terminaison, la structure detoolsn’est qu’un complément. - Le renvoi des résultats est la principale source de bugs :
function_call_outputremplacerole: "tool", et il faut respecter l’ordre et l’exhaustivité des éléments.
Si votre projet fait déjà tourner des appels d’outils en production, je vous conseille de commencer par un déploiement progressif sur un seul outil minimal, puis de basculer l’ensemble une fois la chaîne validée. Pour éviter de jongler avec plusieurs clés et configurations d’environnement, vous pouvez passer par APIYI (apiyi.com) : avec une seule clé, comparez les retours réels de Responses et de Chat, en pointant base_url vers https://api.apiyi.com/v1.
Références
- Documentation officielle des modèles OpenAI : description des capacités par point de terminaison pour les séries GPT-6 et GPT-6.1, y compris la restriction qui impose Responses pour l’appel d’outils
- Lien :
developers.openai.com/api/docs/guides/latest-model -
Description : la source de référence pour savoir si un modèle peut faire du function calling dans Chat Completions
-
Documentation APIYI sur les modèles et les tarifs : prix d’entrée, de sortie et de lecture du cache pour chaque modèle, ainsi que le point de terminaison recommandé
- Lien :
docs.apiyi.com/models - Description : pour vérifier les règles de facturation en vigueur au 2026-11-12 et les recommandations de point de terminaison
Auteur : l’équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI (apiyi.com) ; d’autres précisions sur les interfaces sont disponibles dans le centre de documentation docs.apiyi.com