Note de l’auteur : cet article retrace 12 étapes clés de Gemini, de 2023 à 2026. Il montre comment Google est passé du multimodal et du long contexte au raisonnement, à l’appel d’outils et au développement d’agents de longue durée. Gemini 4 Carbon est le résultat actuel de cette trajectoire.
Le 10 novembre 2026, Google a élargi l’accès à Gemini 4 Carbon aux développeurs API payants et aux utilisateurs de Google AI Ultra. Quelques jours plus tôt, le 28 octobre, l’évaluation publiée par Artificial Analysis plaçait Carbon en tête de son Intelligence Index v5, avec 59 points. Gemini, que la communauté des développeurs chinois surnommait avec ironie « le Doubao américain » (d’après l’assistant grand public de ByteDance), fait désormais partie du peloton de tête.
Ce n’est pas une revanche soudaine. Carbon est le fruit de trois ans d’efforts de Google pour rattraper son retard sur le multimodal, le long contexte, le raisonnement, l’appel d’outils et le développement d’agents. Cet article suit le fil suivant : chronologie, évolutions techniques clés, puis état actuel de la concurrence. Il explique ce que chaque génération de Gemini a réellement apporté. Pour chaque classement indépendant cité, nous précisons la catégorie testée et la date. Nous signalons aussi les domaines où des concurrents comme Opus ou Astra gardent l’avantage sur des tâches spécifiques.
Ce que vous y gagnez : comprendre en un seul article trois ans d’évolution technique de Gemini, et décider où la série Gemini 4 a sa place dans votre flux de développement.
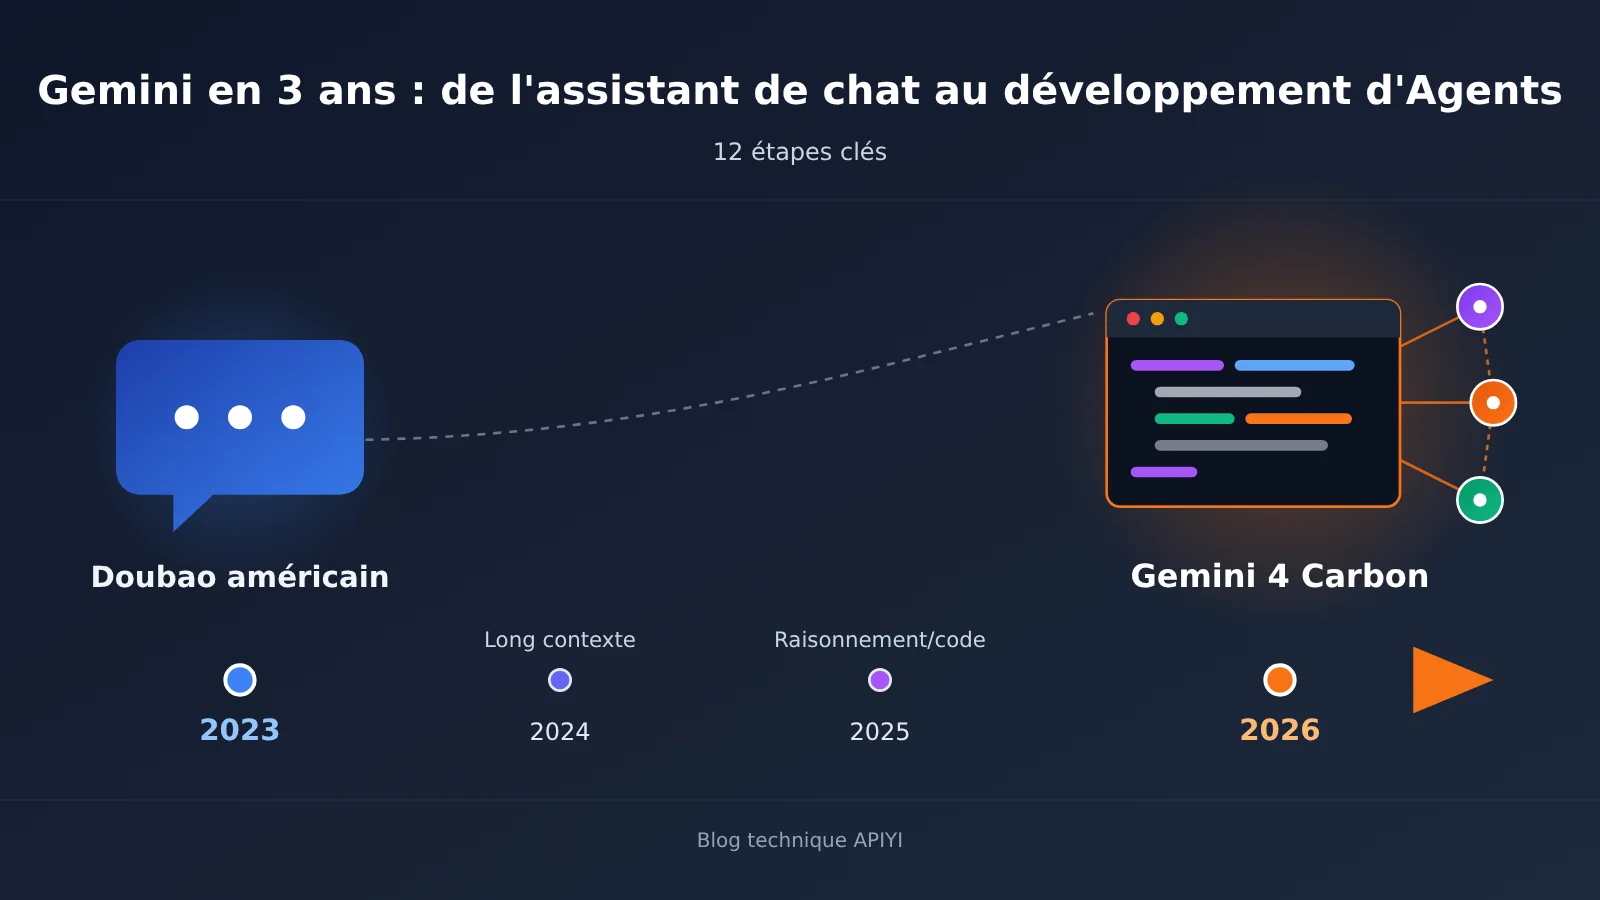
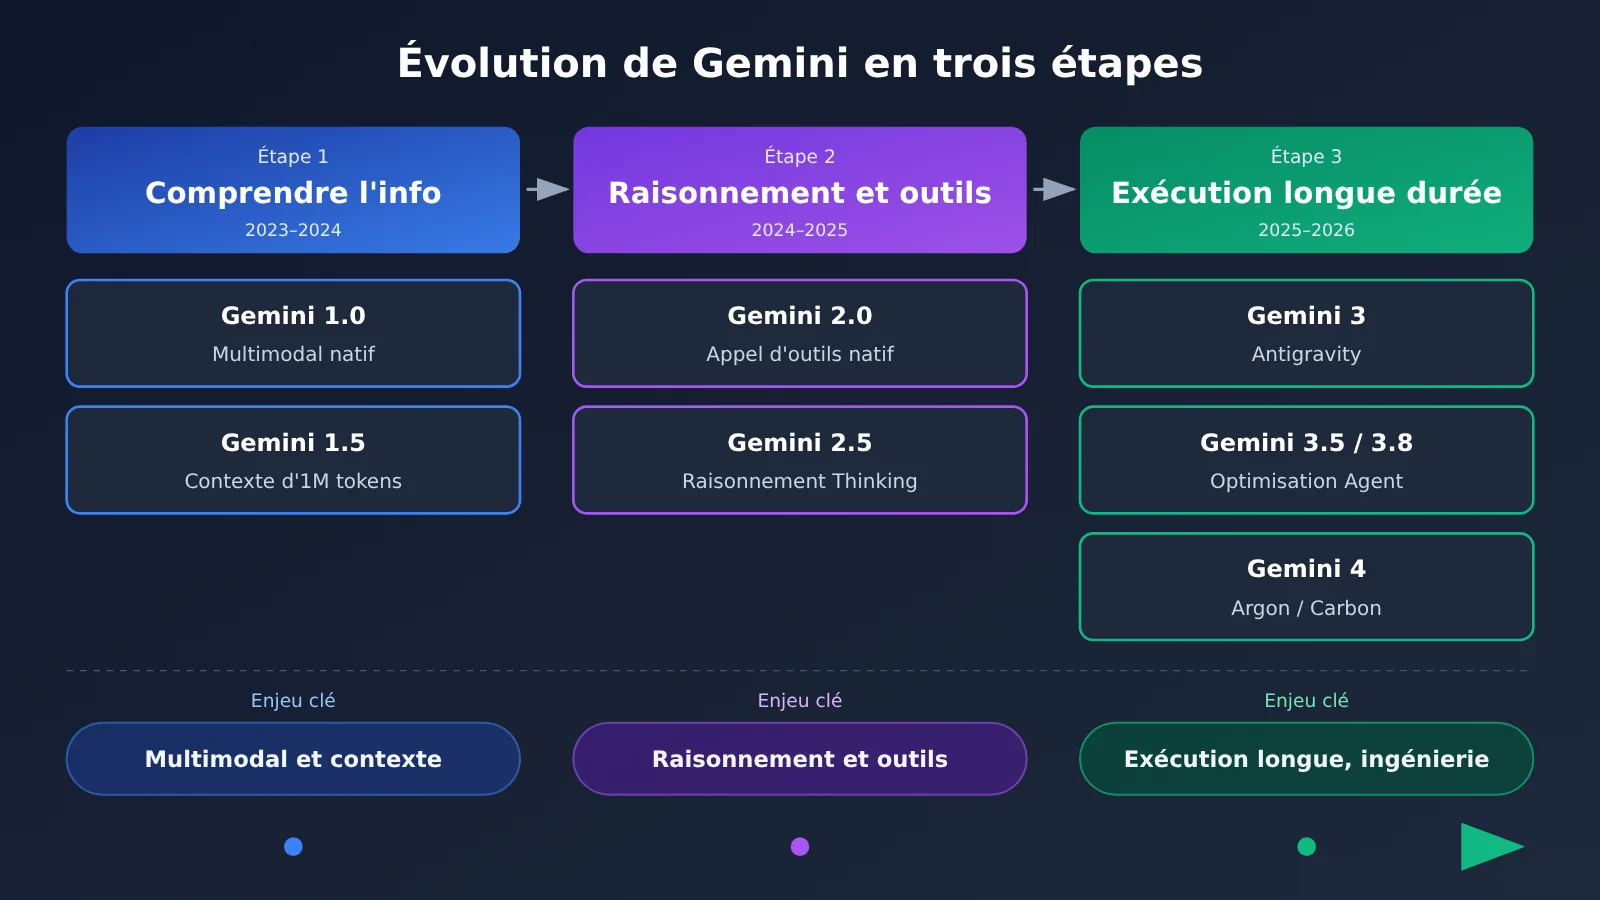
Gemini en trois ans : 12 étapes clés en un coup d’œil
Commençons par l’origine du surnom. Dans le texte original du compte public WeChat de Liu Xiaopai, « le Doubao américain » est une manière de taquiner Gemini : adossé à un géant du numérique, il a été glissé dans le téléphone, la recherche, la suite bureautique… bref, tout l’écosystème. Il brille pour discuter, reconnaître des images ou proposer des API pas chères. Mais dès qu’il s’agit de coder pour de bon ou de construire un produit complexe, beaucoup de développeurs reviennent vers Claude. C’est un résumé subjectif de l’auteur sur ce qu’on pense dans le milieu, mais il touche juste sur l’image qu’avait Gemini à ses débuts : beaucoup d’utilisateurs, mais peu de présence sur les tâches d’ingénierie.
Le tableau ci-dessous, établi à partir des annonces officielles successives de Google, sert de fil conducteur à cet article.
| Date | Jalon | Changement clé |
|---|---|---|
| 2023-12-06 | Gemini 1.0 | Famille de modèles nativement multimodaux, déclinée en Ultra, Pro et Nano |
| 2024-02-15 | Gemini 1.5 Pro | Introduction du contexte long, jusqu’à 1 million de tokens en test précoce |
| 2024-12-11 | Gemini 2.0 | Accent sur l’appel d’outils natif et les sorties multimodales, début de l’ère des agents |
| 2025-03-25 | Gemini 2.5 Pro | Modèle Thinking, nette progression en raisonnement et en programmation |
| 2025-11-18 | Gemini 3 | Renforcement du Vibe Coding et de l’Agentic Coding, lancement simultané d’Antigravity |
| 2026-02-19 | Gemini 3.1 Pro | Raisonnement de base encore renforcé pour les tâches complexes |
| 2026-05-19 | Gemini 3.5 Flash | Amélioration de la vitesse, du raisonnement et de l’exécution longue durée des agents |
| 2026-09-02 | Gemini 3.8 Flash | Optimisé pour l’ingénierie logicielle, l’appel d’outils et les workflows d’agents complexes |
| 2026-09-30 | Annonce de Gemini 4 Argon | Cap sur les workflows de longue durée, l’ingénierie et la cybersécurité |
| 2026-10-13 | Argon ouvert aux développeurs | Accessible via l’API payante et Antigravity |
| 2026-10-28 | Annonce de Gemini 4 Carbon | Pensé pour le raisonnement très complexe, l’ingénierie logicielle et la cybersécurité, d’abord ouvert à certains professionnels |
| 2026-11-10 | Élargissement de l’accès à Carbon | Intégré à l’API développeurs et à l’offre Google AI Ultra |
Ces 12 étapes se résument en une phrase : à ses débuts, la valeur de Gemini tenait à sa capacité à « comprendre l’information » ; il a ensuite ajouté « raisonner sur les problèmes » et « appeler des outils », pour finir par « exécuter des tâches complexes ».
« Le Doubao américain » : ce qui change aujourd’hui chez Gemini
Si Carbon fait autant parler de lui, c’est d’abord grâce à ses résultats sur des classements indépendants. Artificial Analysis est un organisme d’évaluation tiers largement consulté par les développeurs. Le 28 octobre 2026, il a publié une analyse dédiée à Carbon, dont voici les principales données.
| Critère d’évaluation (Artificial Analysis) | Gemini 4 Carbon | Point de comparaison | Remarque |
|---|---|---|---|
| Intelligence Index v5 (analyse du 28/10) | 59 points, 1ᵉʳ à l’époque | — | 1ᵉʳ sur 4 des 9 indicateurs qui composent l’indice |
| Classement général des modèles (mise à jour ultérieure) | Carbon High : 60 points | Opus 5.5 Max : 59 points, GPT-6 Astra Max : 57 points | Le classement est mis à jour en temps réel, les rangs peuvent donc évoluer |
| Coding Agent Index | Carbon High dans Antigravity CLI : 59 points | Opus 5.5 Max dans Claude Code : 62 points | Pour les agents de programmation, Opus garde la tête |
| AA-Briefcase (travail intellectuel) | 1609 Elo | Gemini 4 Argon : 1483 Elo | +126 points par rapport à Argon |
Deux précautions pour bien lire ce tableau. D’abord, chaque score correspond à une configuration précise du modèle, comme Carbon High ou Opus 5.5 Max : on ne peut pas mélanger directement les résultats de niveaux de raisonnement différents. Ensuite, être en tête au score global ne veut pas dire être en tête partout : sur le Coding Agent Index, Opus 5.5 Max dans Claude Code devance encore Carbon High de 3 points.
Par ailleurs, sur la capture du classement en temps réel partagée par l’auteur de l’article d’origine (publié sur un compte WeChat), un autre modèle, Claude Fable 5.2, se place devant Carbon. L’auteur trouve qu’il est lent à exécuter chaque tâche et coûteux ; il a donc opté pour un workflow du type « Carbon pour le développement principal, Fable pour la relecture finale ». Il s’agit d’un retour d’expérience personnel : il peut servir de piste, mais il ne faut pas en faire une conclusion générale.
Les premiers atouts de Gemini : multimodal et contexte long (2023-2024)
Gemini 1.0 : un multimodal pensé dès la conception
Lancé en décembre 2023, Gemini 1.0 se distingue surtout par son caractère « nativement multimodal ». Dès la conception, le modèle a été pensé pour traiter plusieurs types d’informations : texte, image, audio, vidéo et code. On n’a pas d’abord construit un modèle textuel auquel on aurait ensuite greffé un module de vision. Si vous envoyez un graphique accompagné d’un texte, le modèle peut comprendre le lien entre les deux au sein d’un même système.
Cette génération répondait à la question : « Combien de types d’informations le modèle sait-il comprendre ? » Les trois versions, Ultra, Pro et Nano, ciblent respectivement la haute performance, l’usage généraliste et l’exécution sur appareil. Cela a aussi préparé l’arrivée de Gemini sur les smartphones et autres appareils.
Gemini 1.5 Pro : le contexte long devient un enjeu de compétition
En février 2024, Gemini 1.5 Pro a fait du contexte long un argument de poids, avec une démonstration officielle d’une fenêtre de contexte d’un million de tokens. Pour faire une analogie, la fenêtre de contexte, c’est un peu l’« établi » du modèle : plus il est grand, plus on peut y étaler de documents d’un seul coup. Parmi les usages cités officiellement : l’analyse de vidéos longues, de fichiers audio longs et de grandes bases de code. Concrètement, un développeur peut confier d’un bloc au modèle le code clé de tout un projet pour qu’il comprenne les appels entre modules, sans avoir à le lui servir morceau par morceau.
Gemini 2.0 : le virage assumé vers les agents
Gemini 2.0, sorti en décembre 2024, marque un tournant. Google se tourne clairement vers l’ère des agents, avec des capacités d’outils natives : recherche, exécution de code, appel de fonctions. À la même période, l’entreprise a aussi présenté des pistes de recherche sur les agents, comme Project Mariner.
L’appel d’outils se comprend facilement : avant, le modèle ne pouvait répondre à « Quelle est la dernière version de telle bibliothèque aujourd’hui ? » que de mémoire. Avec les outils, il peut lancer lui-même une recherche, ou exécuter réellement un morceau de code pour en observer le résultat. Son rôle évolue : de « répondeur », il devient « opérateur ».
Tournant du raisonnement et du code chez Gemini en 2025 : Thinking et Antigravity
Gemini 2.5 : Thinking, ou réfléchir avant de répondre
En mars 2025, Gemini 2.5 Pro a introduit la capacité Thinking, et ses performances en raisonnement comme en programmation ont nettement progressé. Concrètement, Thinking signifie que le modèle mène un raisonnement en plusieurs étapes avant de donner sa réponse. Prenons le débogage : en mode classique, le modèle peut proposer directement un correctif qui « a l’air bon ». En mode Thinking, il commence par émettre des hypothèses sur les causes possibles, écarte celles qui ne tiennent pas, puis propose une modification. En mai 2025, Google a annoncé que 2.5 Pro prenait la tête de classements comme WebDev Arena, qui faisait alors référence. C’était la première fois que Gemini s’imposait vraiment sur les classements liés à la programmation.
Gemini 3 et Antigravity : du modèle à l’environnement de travail
Le 18 novembre 2025, Google a lancé simultanément Gemini 3 et Antigravity. Antigravity réunit l’éditeur, le terminal et les opérations dans le navigateur au sein d’un même environnement de travail pour agents. L’enjeu de cette étape : Google ne veut plus seulement que le modèle « écrive du code », mais qu’il puisse l’exécuter lui-même, ouvrir un navigateur pour vérifier le rendu, repérer les problèmes, puis corriger.
C’est tout le sens de l’Agentic Coding : l’agent se charge de planifier, d’écrire, d’exécuter et de vérifier le code, tandis que le développeur fixe plutôt les objectifs et relit les résultats. À partir de là, le modèle et la chaîne d’outils sont conçus ensemble, et c’est précisément ce qui a permis à Gemini de rattraper son retard par la suite.
Gemini 4 Argon et Carbon : l’ingénierie complexe en ligne de mire pour 2026
Le rythme des itérations de Gemini s’accélère nettement en 2026. Gemini 3.1 Pro renforce le raisonnement de base en février, 3.5 Flash conjugue vitesse et exécution longue durée pour les agents en mai, et 3.8 Flash est optimisé en septembre pour l’ingénierie logicielle, l’appel d’outils et les workflows d’agents complexes. Puis Gemini 4 Argon et Carbon arrivent l’un après l’autre.
Pour les développeurs, la question à éclaircir en priorité est la différence de positionnement entre les deux.
| Critère | Gemini 4 Argon | Gemini 4 Carbon |
|---|---|---|
| Positionnement officiel | La plupart des tâches courantes d’ingénierie logicielle et de travail intellectuel | Débogage complexe, raisonnement approfondi, tâches d’exécution longue durée |
| Ouverture | Ouvert aux développeurs le 13/10/2026 | Ouverture élargie le 10/11/2026 |
| Relation | Modèle de base | Construit sur Argon |
| Contexte | Selon la documentation officielle | La fiche du modèle annonce jusqu’à 1 million de tokens (entrée et sortie cumulées) |
| Modes d’accès | Gemini API, Antigravity, plateformes d’agrégation comme APIYI (apiyi.com) (selon la liste des modèles) | Gemini API, Google AI Ultra, plateformes d’agrégation (selon la liste des modèles) |
En clair, Argon convient au quotidien : écrire des fonctionnalités, corriger des bugs, traiter des documents. Carbon est fait pour les tâches qui demandent de raisonner longtemps d’affilée, de traverser plusieurs étapes et de vérifier à plusieurs reprises, par exemple repérer un problème de concurrence complexe dans un gros dépôt de code. Dans l’évaluation de travail intellectuel AA-Briefcase, Carbon devance Argon de 126 points Elo, ce qui confirme que l’écart entre les deux se creuse bien sur les tâches complexes.
La vraie place de Gemini 4 Carbon dans le classement du développement web
Être en tête en intelligence globale ne veut pas dire dominer toutes les tâches de développement. Le classement WebDev Arena du 10 novembre 2026 en est un bon contre-exemple.
| Modèle | Elo WebDev | Remarque |
|---|---|---|
| Claude Opus 5.5 Max | 1814 | Première place du classement |
| Gemini 4 Carbon High | 1768 | Indiqué « Preliminary » à l’époque |
| GPT-6 Astra Max | 1764 | À seulement 4 points de Carbon |
On le voit : sur le développement web en particulier, Opus 5.5 Max a près de 50 points d’avance, Carbon et Astra sont quasiment à égalité, et le score de Carbon n’est qu’une donnée préliminaire. L’auteur du compte WeChat d’origine est très élogieux sur le sens esthétique de Carbon pour les interfaces, et affirme qu’il rend la page puis vérifie lui-même la mise en page. Ce type d’expérience mérite l’attention, mais il s’agit d’une observation personnelle : à valider sur vos propres projets.
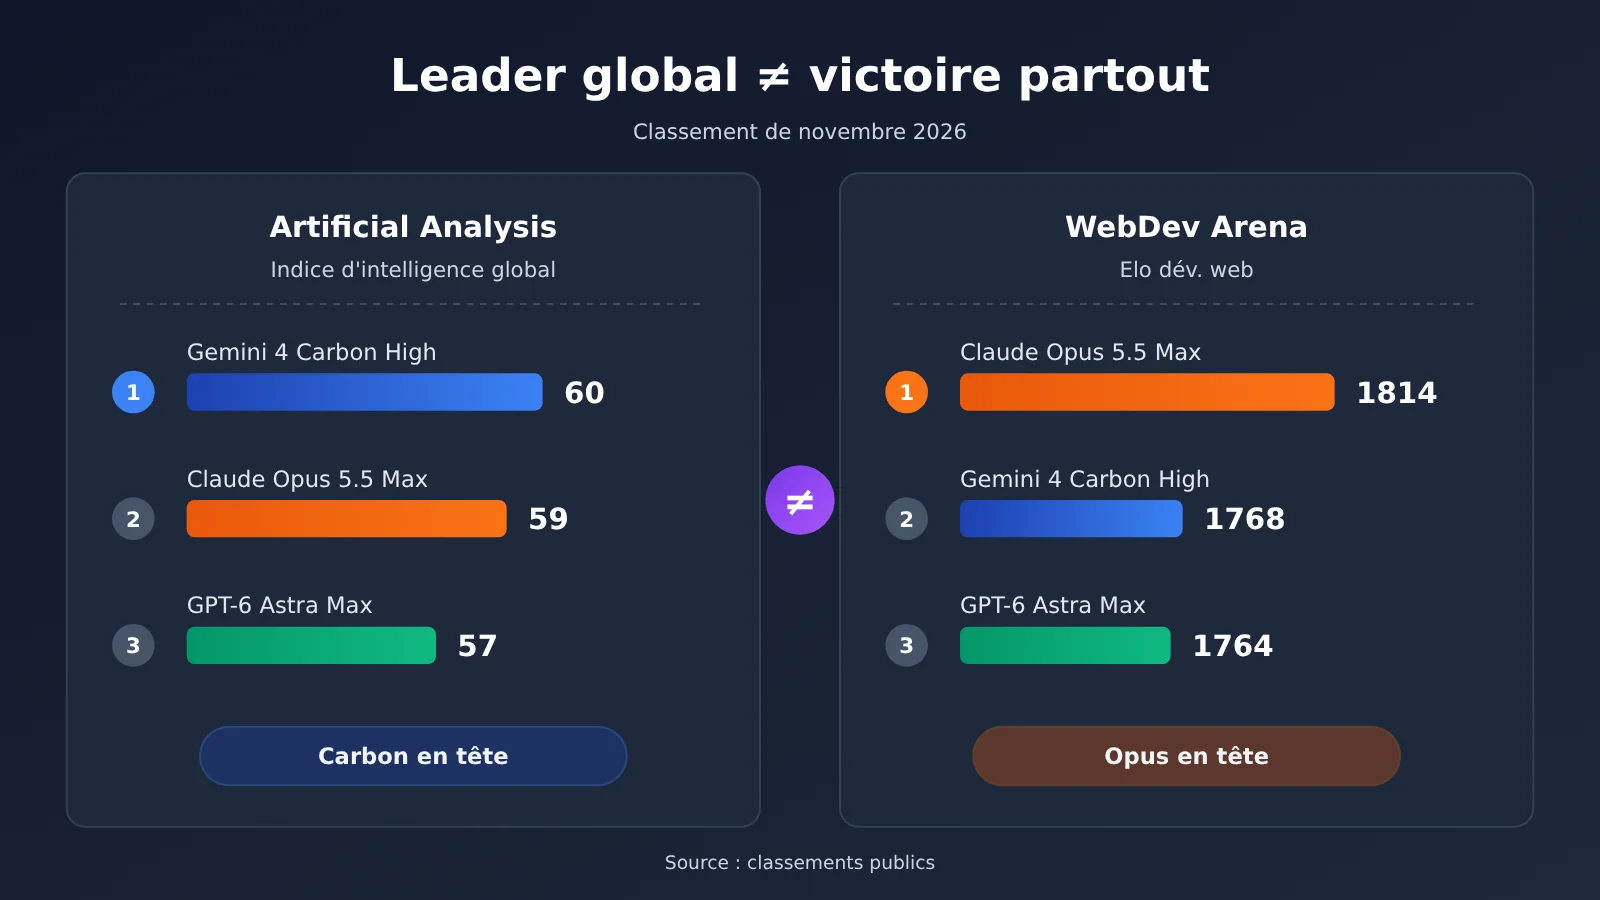
Note sur le graphique : les données proviennent des pages publiques d’Artificial Analysis et d’Arena ; les catégories de test diffèrent d’un classement à l’autre. Si vous voulez mesurer l’écart sur vos propres invites métier, vous pouvez changer de modèle via APIYI (apiyi.com) avec la même interface compatible OpenAI et tester en conditions réelles.
Pourquoi Gemini a pu rebondir : analyse des effets
Capacités du modèle : de « voir beaucoup » à « aller jusqu’au bout »
Sur trois ans, Gemini a changé trois fois de terrain de compétition. D’abord, la quantité de types d’informations comprises et le volume traité en une seule fois. Ensuite, le raisonnement et l’utilisation d’outils. Aujourd’hui, l’exécution de tâches d’ingénierie complexes sur de longues durées. Rien de ce qui a été accumulé à chaque génération n’a été gaspillé : le multimodal permet au modèle de comprendre des captures d’écran et des maquettes, la fenêtre de contexte longue lui permet de contenir un code source entier, et le mode Thinking associé à l’appel d’outils lui permet enfin de passer à l’action.
Écosystème d’outils : le modèle et l’environnement d’exécution conçus ensemble
Antigravity, AI Studio, l’application Gemini et les différents services de développement de Google couvrent des scénarios variés, de la prise en main au prototype, jusqu’au développement de produits en production. C’est une différence majeure entre Google et les acteurs qui se contentent de proposer une API de modèle : un agent a besoin de « mains et de pieds » (éditeur, terminal, navigateur), et Google peut fournir lui-même un environnement d’exécution complet.
Distribution et tarification : toucher à la fois les développeurs et le grand public
Côté abonnements, Google a ajouté le 19 mai 2026 un forfait Ultra à 100 dollars et a ramené le forfait le plus élevé de 250 à 200 dollars. Ils offrent respectivement environ 5 fois et 20 fois le quota de base du forfait Pro à 20 dollars. Côté API, voici la grille tarifaire publique de Carbon.
| Période | Entrée (par million de tokens) | Sortie (par million de tokens) |
|---|---|---|
| Avant le 30/11/2026 | 2 $ | 10 $ |
| À partir du 01/12/2026 | 4 $ | 20 $ |
Une précision s’impose : les avantages des forfaits et les tarifs dépendent des pages officielles de Google et de la date concernée. Les affirmations absolues de l’article d’origine, comme « quota illimité » ou « aucun risque de bannissement », ne sont pas des engagements officiels.
Ce que cela change pour les développeurs
- Le choix du modèle passe d’un « leader incontesté » à une « répartition par tâche » : pour le raisonnement généraliste, on peut privilégier Carbon ; pour le développement web et les agents de programmation, comparer avec Opus ; pour les tâches quotidiennes où le rapport qualité-prix compte, utiliser Argon.
- La structure des coûts doit être repensée : le prix de Carbon doublera le 1er décembre, et les tâches d’agent de longue durée consomment vite des tokens. Mieux vaut estimer son budget à l’avance.
- La validation doit revenir à des tâches réelles : les classements permettent seulement de restreindre la liste des candidats. Il faut toujours tester avec son propre code source et ses propres invites.
Ce que cela change pour le secteur
- Un trio de tête plus net : Google, OpenAI et Anthropic s’affrontent directement sur les tâches de développement complexes, chacun conservant un avantage sur des domaines spécifiques.
- L’unité de compétition passe du modèle au flux de travail : demain, on ne comparera plus seulement les scores des modèles, mais aussi des chaînes d’outils complètes (IDE, CLI, collaboration multi-agents).
Comment tester la série Gemini 4 via API
Pour les développeurs qui veulent vérifier par eux-mêmes, le plus rapide reste d’appeler directement l’interface compatible OpenAI. L’exemple minimal ci-dessous fonctionne en remplaçant simplement la clé API. Le nom du modèle est à vérifier dans la liste des modèles de la plateforme :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # Le nom du modèle dépend de la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "用三句话解释什么是 Agentic Coding"}]
)
print(response.choices[0].message.content)
Voir le code complet : routage entre Argon et Carbon selon la complexité de la tâche
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Les noms de modèles sont à vérifier dans la liste des modèles de la plateforme
MODEL_ROUTER = {
    "simple": "gemini-4-argon",   # Développement courant et travail de connaissance
    "complex": "gemini-4-carbon"  # Débogage complexe, raisonnement approfondi, tâches de longue durée
}

def ask_gemini(
    prompt: str,
    complexity: str = "simple",
    system_prompt: Optional[str] = None,
    max_tokens: int = 2000
) -> str:
    """Choisit un modèle de la série Gemini 4 selon la complexité de la tâche"""
    model = MODEL_ROUTER.get(complexity, MODEL_ROUTER["simple"])
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Les tâches du quotidien passent par Argon, le débogage complexe par Carbon
print(ask_gemini("给这个函数补充类型注解", complexity="simple"))
print(ask_gemini(
    "分析以下并发代码可能出现死锁的原因,并给出修复方案",
    complexity="complex",
    system_prompt="你是资深后端工程师,先列假设再逐一验证"
))
Conseil pour bien démarrer : le prix de l’API de Carbon sera ajusté le 1er décembre, mieux vaut donc commencer par un petit échantillon de test. En vous inscrivant sur APIYI (apiyi.com), vous obtenez un quota de test gratuit, et une seule clé API suffit pour appeler Gemini, Claude, OpenAI et d’autres modèles, ce qui est pratique pour comparer les résultats sur une même invite.
Questions fréquentes (FAQ)
Q1 : Pourquoi Gemini est-il surnommé « le Doubao américain » ?
C’est une plaisanterie qui circule chez les développeurs chinois. Elle veut dire que Gemini, soutenu par un géant du secteur et présent partout dans la suite de produits Google, fait beaucoup parler de lui pour les conversations du quotidien et la reconnaissance d’images, mais qu’à ses débuts il n’était pas le premier choix pour la programmation exigeante. Avec la sortie de Gemini 3, d’Antigravity et de la série Gemini 4, cette image est en train de changer.
Q2 : Entre Gemini 4 Carbon et Claude Opus 5.5, lequel est le plus performant ?
Ça dépend de la catégorie de test. Dans le classement général d’Artificial Analysis, Carbon High (60 points) est légèrement devant Opus 5.5 Max (59 points). En revanche, dans le Coding Agent Index, Opus 5.5 Max est en tête avec 62 points contre 59 pour Carbon High, et Opus est aussi nettement au-dessus sur WebDev Arena.
Q3 : Quand pourra-t-on utiliser Carbon ?
Carbon a été annoncé le 28 octobre 2026 et ouvert d’abord à certains professionnels. Le 10 novembre, l’accès a été élargi : il est intégré à l’API payante pour développeurs et à l’offre Google AI Ultra.
Q4 : Pour le développement au quotidien, vaut-il mieux choisir Argon ou Carbon ?
Selon le positionnement officiel, Argon convient à la plupart des tâches courantes d’ingénierie logicielle et de travail intellectuel, tandis que Carbon est destiné au débogage complexe, au raisonnement approfondi et aux exécutions de longue durée. L’approche la plus prudente consiste à répartir les tâches entre les deux via un routage dans le code, puis à tester les deux modèles avec la même invite sur APIYI (apiyi.com) pour comparer qualité et coût avant de choisir le modèle par défaut.
Q5 : Comment appeler rapidement la série Gemini 4 via l’API ?
1. Rendez-vous sur APIYI (apiyi.com) pour créer un compte et récupérer votre clé API
2. Récupérez le crédit de test gratuit offert aux nouveaux utilisateurs
3. Utilisez le code de cet article, en définissant `base_url` sur `https://api.apiyi.com/v1` et en renseignant le nom du modèle selon la liste des modèles de la plateforme
Gemini en trois ans : les points clés à retenir
- Fil conducteur : Gemini est passé de la compréhension de l’information au raisonnement, puis à l’exécution de tâches complexes sur de longues durées
- Premiers acquis : le multimodal natif de la version 1.0 et la fenêtre de contexte d’un million de tokens de la 1.5 ont posé les bases de tout ce qui a suivi
- Tournants décisifs : le Thinking de la 2.5 et Antigravity avec la génération 3 ont permis à Gemini d’entrer dans l’arène principale de la programmation
- Répartition des modèles : Argon s’occupe du développement courant, Carbon du débogage complexe et du raisonnement sur de longues périodes
- Lire les classements avec recul : Carbon est en tête au score global, mais Opus garde l’avantage sur WebDev et sur les agents de programmation
- Pour tester : vous pouvez comparer Gemini et les autres grands modèles via une interface unifiée sur APIYI (apiyi.com)
Conclusion
Du « Doubao américain » au modèle de programmation de premier plan, l’évolution de Gemini sur ces trois ans se résume en trois points :
- Les capacités s’empilent couche après couche : multimodal, contexte long, Thinking, appel d’outils, exécution sur la durée. Chaque étape repose sur la précédente.
- L’écosystème a fait la différence : des chaînes d’outils comme Antigravity ont offert au modèle un véritable environnement où agir, et la distribution des produits Google a mis ces capacités entre les mains d’un très grand nombre d’utilisateurs.
- La concurrence reste multipolaire : Carbon fait son entrée dans le peloton de tête, mais Opus et Astra ont chacun leurs points forts. Pour les développeurs, la meilleure stratégie consiste à choisir le modèle en fonction de la tâche.
Longtemps vu surtout comme l’assistant de la suite Google, Gemini peut désormais figurer parmi les principaux candidats pour l’ingénierie complexe et le développement d’agents. Un classement n’est qu’un point de départ : la vraie réponse, c’est dans vos propres projets que vous la trouverez. Nous vous conseillons d’utiliser le quota gratuit d’APIYI (apiyi.com) pour confronter la série Gemini 4 et d’autres modèles sur une même tâche, puis de choisir la combinaison qui servira de base à votre équipe.
📚 Références
- Blog officiel de Google : lancement de Gemini 1.0 : présentation de la famille de modèles nativement multimodaux
- Lien :
blog.google/innovation-and-ai/technology/ai/google-gemini-ai -
Pourquoi le lire : comprendre le positionnement d’origine de Gemini
-
Blog officiel de Google : Gemini 3 et Antigravity : lancement du Agentic Coding et de l’environnement de développement
- Lien :
blog.google/products-and-platforms/products/gemini/gemini-3 -
Pourquoi le lire : saisir le virage de Google, du modèle vers l’environnement de travail
-
Blog officiel de Google : disponibilité et tarifs de Gemini 4 Carbon : périmètre d’ouverture et tarification de l’API
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Pourquoi le lire : voir la différence de positionnement officielle entre Carbon et Argon
-
Google DeepMind : fiche modèle de Carbon : fenêtre de contexte et capacités
- Lien :
deepmind.google/models/model-cards/gemini-4-carbon -
Pourquoi le lire : consulter les paramètres techniques, notamment la fenêtre de contexte de 1 million de tokens
-
Artificial Analysis : dossier d’évaluation de Carbon : évaluation globale indépendante
- Lien :
artificialanalysis.ai/articles/gemini-4-carbon-new-number-1 -
Pourquoi le lire : source des données de l’Intelligence Index, du Coding Agent Index, etc.
-
Arena : classement WebDev : classement spécialisé en développement web
- Lien :
arena.ai/leaderboard/code/webdev -
Pourquoi le lire : comparer les performances des différents modèles sur les tâches de développement web
-
Tarification officielle de l’API Gemini : dernières règles de facturation
- Lien :
ai.google.dev/gemini-api/docs/pricing - Pourquoi le lire : les prix de la page officielle font foi, car ils sont mis à jour en temps réel
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel d’APIYI. Pour plus de ressources sur l’intégration, rendez-vous sur le centre de documentation docs.apiyi.com