Anmerkung des Autors: Dieser Artikel ordnet 12 Meilensteine von Gemini zwischen 2023 und 2026 ein. Er zeigt, wie Google von Multimodalität und langem Kontext über Reasoning und Tool-Aufrufe bis zur Entwicklung langlaufender Agenten gekommen ist. Gemini 4 Carbon ist das bisherige Zwischenergebnis dieser Linie.
Am 10. November 2026 hat Google Gemini 4 Carbon für zahlende API-Entwickler und Nutzer von Google AI Ultra weiter geöffnet. Zuvor hatte Artificial Analysis in einer Bewertung vom 28. Oktober Carbon mit 59 Punkten im Intelligence Index v5 auf Platz eins gesetzt. Gemini, in chinesischen Entwicklerkreisen einst scherzhaft „das amerikanische Doubao“ genannt, gehört damit inzwischen zur Spitzengruppe der Modelle.
Das war kein plötzlicher Überraschungserfolg. Carbon ist das Ergebnis von drei Jahren, in denen Google Schritt für Schritt multimodale Fähigkeiten, langes Kontextfenster, Reasoning, Tool-Aufrufe und Agent-Entwicklung nachgezogen hat. Der Artikel folgt der Reihenfolge „Zeitleiste + zentrale technische Veränderungen + heutige Wettbewerbslage“ und erklärt, was jede Gemini-Generation tatsächlich besser gemacht hat. Bei allen unabhängigen Ranglisten, die wir zitieren, nennen wir Testkategorie und Zeitpunkt. Wo Konkurrenten wie Opus oder Astra bei Spezialaufgaben vorn liegen, erwähnen wir das ebenfalls.
Kernnutzen: In einem Artikel verstehen Sie die technische Entwicklung von Gemini über drei Jahre und können einschätzen, an welcher Stelle Ihres Entwicklungsablaufs die Gemini-4-Reihe sinnvoll eingesetzt werden kann.
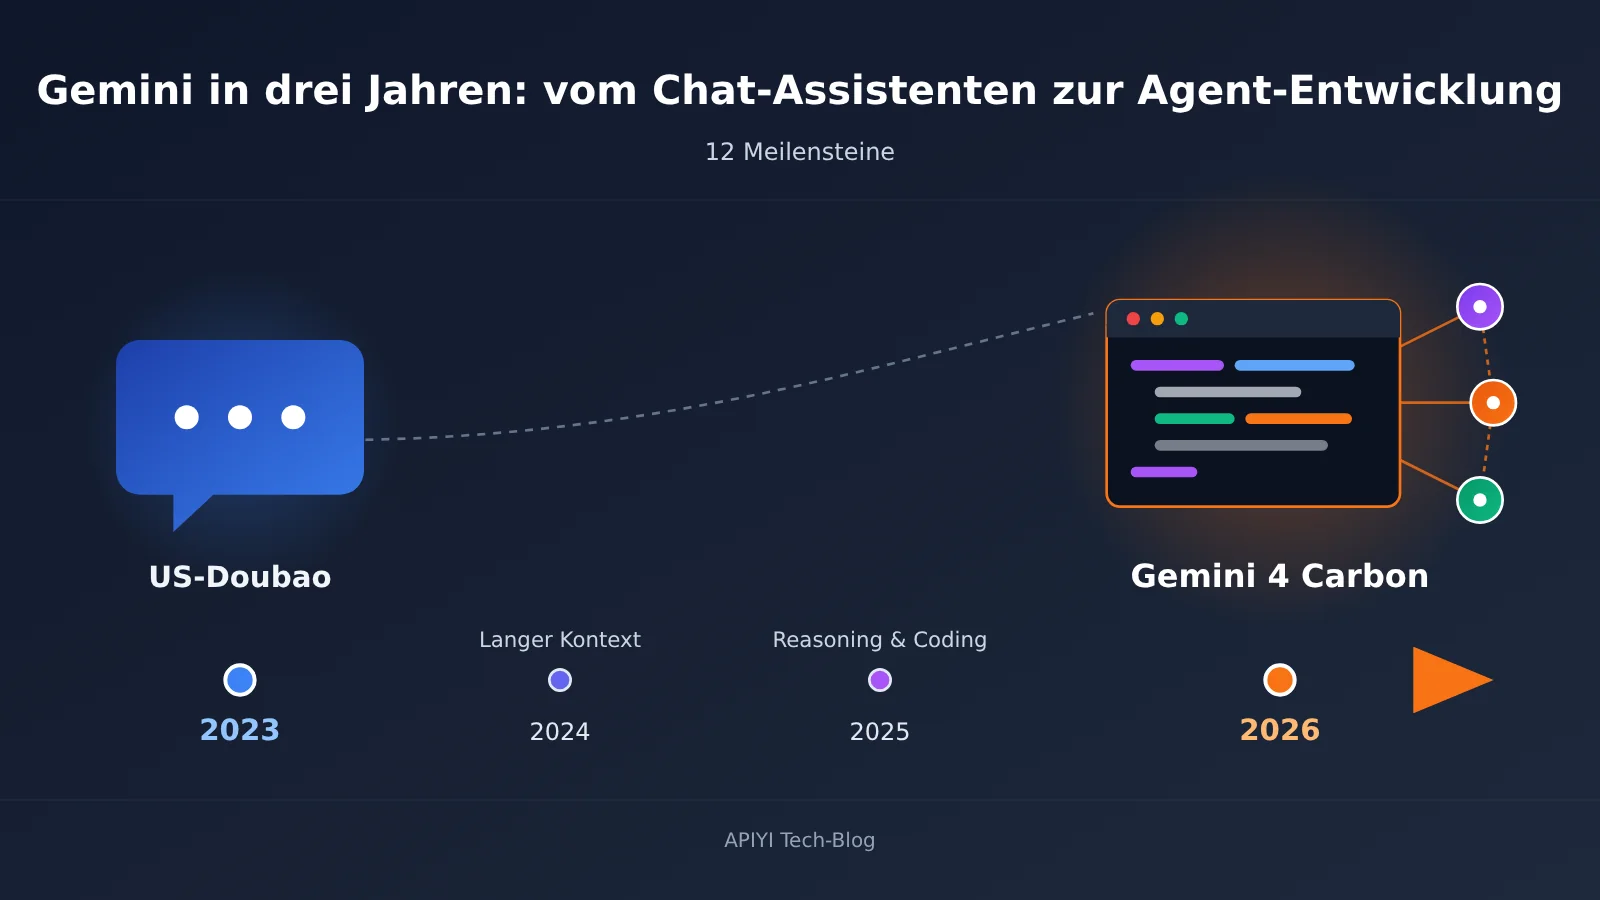
Was Gemini in drei Jahren durchlaufen hat: 12 Meilensteine im Überblick
Zuerst zur Herkunft des Spitznamens. In der Darstellung von Liu Xiaopai, dem Autor des ursprünglichen WeChat-Artikels, ist „Amerikanisches Doubao“ ein ironischer Spitzname: Gemini hat einen Big-Tech-Konzern im Rücken und steckt in Smartphones, Suche und Office-Anwendungen, also im ganzen Produktpaket. Zum Plaudern, zur Bilderkennung und als günstige Schnittstelle ist es sehr beliebt. Geht es aber um anspruchsvolles Programmieren oder komplexe Produkte, wechseln viele Entwickler wieder zu Claude. Das ist die subjektive Zusammenfassung des Autors über die Meinung in der Branche, trifft aber ziemlich genau den Eindruck, den Gemini anfangs hinterließ: viele Nutzer, aber bei Engineering-Aufgaben kaum präsent.
Die folgende Tabelle basiert auf den offiziellen Ankündigungen von Google und bildet den roten Faden dieses Artikels.
| Zeitpunkt | Meilenstein | Wichtigste Änderung |
|---|---|---|
| 06.12.2023 | Gemini 1.0 | Native multimodale Modellfamilie, unterteilt in Ultra, Pro und Nano |
| 15.02.2024 | Gemini 1.5 Pro | Einführung des langen Kontexts, bis zu 1 Million Token in früher Testphase |
| 11.12.2024 | Gemini 2.0 | Fokus auf native Tool-Nutzung und multimodale Ausgabe, Ausrufung des Agent-Zeitalters |
| 25.03.2025 | Gemini 2.5 Pro | Thinking-Modell, deutlich stärkeres Schlussfolgern und Programmieren |
| 18.11.2025 | Gemini 3 | Stärkerer Fokus auf Vibe Coding und Agentic Coding, gleichzeitig Start von Antigravity |
| 19.02.2026 | Gemini 3.1 Pro | Weiter verbessertes Kernschlussfolgern für komplexe Aufgaben |
| 19.05.2026 | Gemini 3.5 Flash | Mehr Tempo, besseres Schlussfolgern und längere Agent-Ausführung |
| 02.09.2026 | Gemini 3.8 Flash | Optimiert für Softwareentwicklung, Tool-Aufrufe und komplexe Agent-Workflows |
| 30.09.2026 | Gemini 4 Argon angekündigt | Schwerpunkt verlagert sich auf lang laufende Workflows, Engineering und Cybersicherheit |
| 13.10.2026 | Argon für Entwickler geöffnet | Nutzbar über die kostenpflichtige API und Antigravity |
| 28.10.2026 | Gemini 4 Carbon angekündigt | Für hochkomplexes Schlussfolgern, Softwareentwicklung und Cybersicherheit, zunächst für ausgewählte Fachleute geöffnet |
| 10.11.2026 | Carbon breiter geöffnet | Aufnahme in die Entwickler-API und in das Produktangebot von Google AI Ultra |
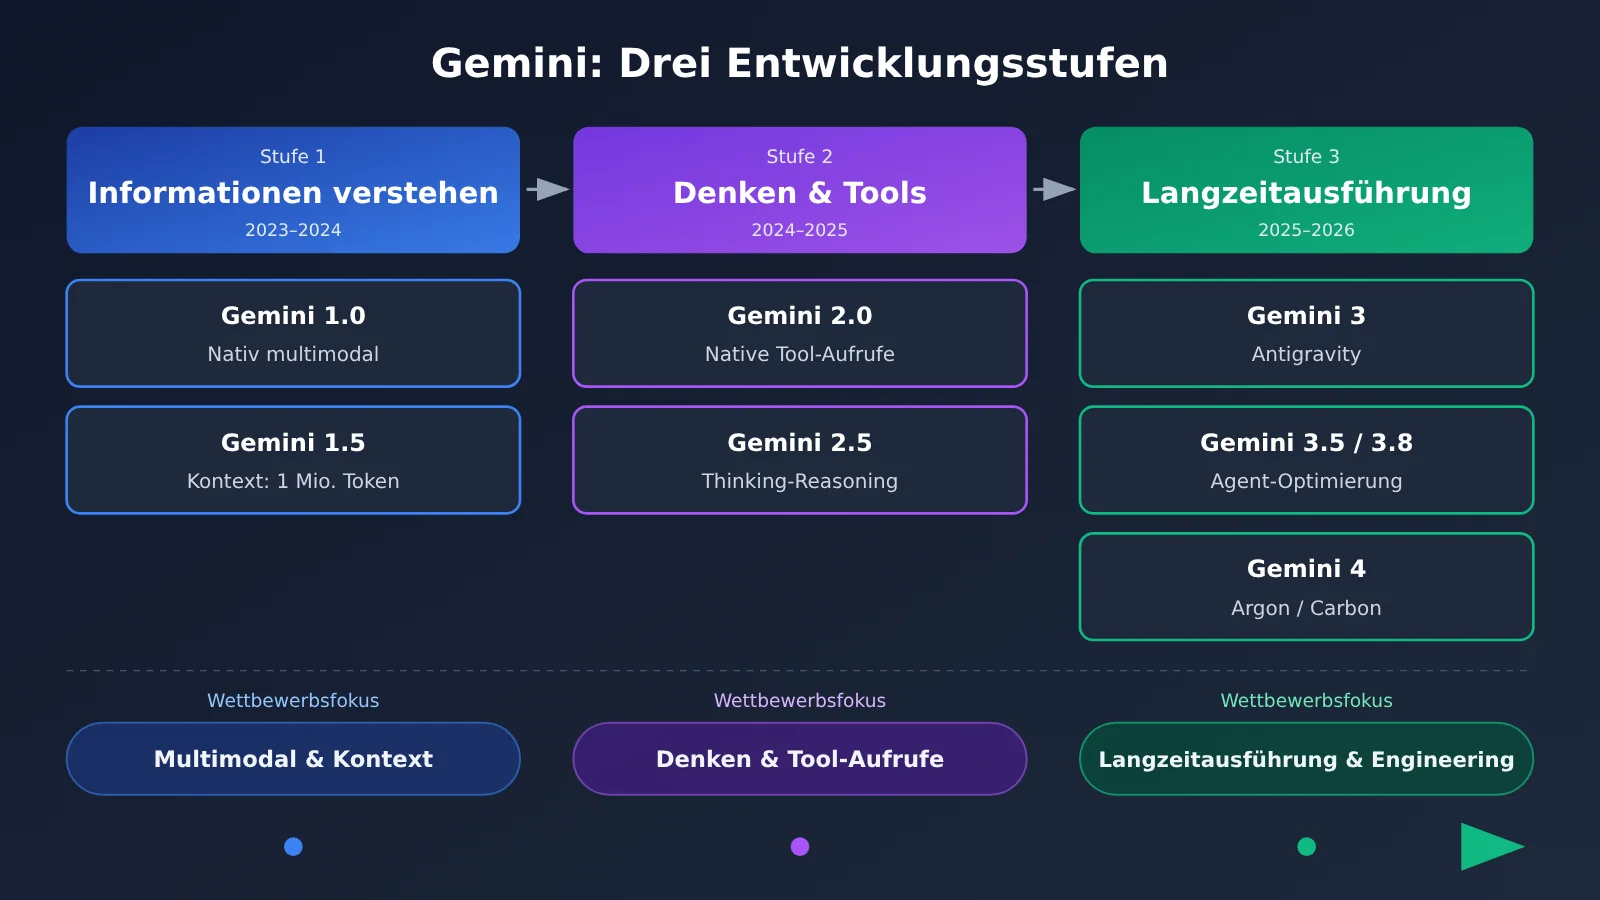
Diese 12 Meilensteine lassen sich in einem Satz zusammenfassen: Der Kernwert des frühen Gemini lag im „Verstehen von Informationen“. Später kamen schrittweise „Probleme durchdenken“ und „Tools aufrufen“ hinzu, und am Ende steht das „Ausführen komplexer Aufgaben“.
„Amerikanisches Doubao“ Gemini: Was sich jetzt geändert hat
Aufmerksamkeit hat Carbon zunächst durch seine Ergebnisse in unabhängigen Rankings bekommen. Artificial Analysis ist ein Drittanbieter für Benchmarks, auf den sich viele Entwickler stützen. Am 28. Oktober 2026 hat das Unternehmen eine Sonderanalyse zu Carbon veröffentlicht. Die wichtigsten Daten:
| Testkategorie (Artificial Analysis) | Gemini 4 Carbon | Vergleichsmodell | Anmerkung |
|---|---|---|---|
| Intelligence Index v5 (Sonderanalyse vom 28.10.) | 59 Punkte, damals Platz 1 | — | Bei 9 Teilindikatoren in 4 davon Platz 1 |
| Gesamtranking (spätere Aktualisierung) | Carbon High: 60 Punkte | Opus 5.5 Max: 59 Punkte, GPT-6 Astra Max: 57 Punkte | Das Ranking wird laufend aktualisiert, Platzierungen können sich ändern |
| Coding Agent Index | Carbon High in Antigravity CLI: 59 Punkte | Opus 5.5 Max in Claude Code: 62 Punkte | Bei Coding-Agenten liegt Opus weiterhin vorn |
| AA-Briefcase (Wissensarbeit) | 1609 Elo | Gemini 4 Argon: 1483 Elo | 126 Punkte mehr als Argon |
Beim Lesen der Tabelle sollten Sie zwei Dinge beachten. Erstens beziehen sich alle Werte auf konkrete Modellkonfigurationen, etwa Carbon High oder Opus 5.5 Max. Ergebnisse unterschiedlicher Reasoning-Stufen lassen sich nicht ohne Weiteres miteinander vergleichen. Zweitens bedeutet eine Spitzenposition im Gesamtscore nicht, dass ein Modell in jeder Einzeldisziplin vorn liegt: Im Coding Agent Index liegt Opus 5.5 Max in Claude Code mit 3 Punkten noch immer vor Carbon High.
Außerdem taucht in dem Screenshot des Live-Rankings, den der Autor des ursprünglichen WeChat-Artikels geteilt hat, noch Claude Fable 5.2 vor Carbon auf. Der Autor hält Fable für zu langsam pro Aufgabe und zu teuer. Deshalb setzt er auf den Workflow „Carbon als Hauptmodell für die Entwicklung, Fable für die abschließende Prüfung“. Das ist die persönliche Erfahrung des Autors. Sie kann eine Orientierung sein, sollte aber nicht als allgemeingültige Schlussfolgerung verstanden werden.
Gemini in der Frühphase: Multimodalität und langer Kontext in den Jahren 2023 und 2024
Gemini 1.0: Multimodalität von Grund auf
Gemini 1.0, im Dezember 2023 erschienen, zeichnete sich vor allem durch seine „native Multimodalität“ aus. Das Modell wurde von Anfang an für verschiedene Informationstypen entworfen: Text, Bild, Audio, Video und Code. Man hat also nicht erst ein Textmodell gebaut und dann ein Bildmodul angeflanscht. Lädt ein Nutzer ein Diagramm samt Text hoch, kann das Modell den Zusammenhang beider innerhalb desselben Systems erfassen.
Diese Generation beantwortete die Frage, wie viele Arten von Informationen ein Modell überhaupt verstehen kann. Die drei Stufen Ultra, Pro und Nano standen für Hochleistung, Allzweck und Einsatz direkt auf dem Gerät. Damit war auch die Grundlage dafür gelegt, dass Gemini später auf Smartphones und anderen Geräten landete.
Gemini 1.5 Pro: Langer Kontext wird zum Wettbewerbsfaktor
Im Februar 2024 machte Gemini 1.5 Pro den langen Kontext zu einem zentralen Verkaufsargument. Offiziell wurde ein Kontext von einer Million Token demonstriert. Man kann sich das Kontextfenster wie den „Arbeitstisch“ des Modells vorstellen: Je größer der Tisch, desto mehr Material lässt sich auf einmal ausbreiten. Als Anwendungsfälle nannte Google unter anderem die Analyse langer Videos, langer Audiodateien und großer Codebasen. Für Entwickler heißt das: Sie können die wichtigsten Teile eines ganzen Projekts auf einmal an das Modell übergeben, damit es die Aufrufbeziehungen zwischen den Modulen versteht. Stückchenweise füttern ist nicht mehr nötig.
Gemini 2.0: Der klare Schwenk zu Agenten
Gemini 2.0 vom Dezember 2024 markierte eine Richtungsentscheidung. Google richtete sich nun ausdrücklich auf das Zeitalter der Agenten aus und betonte native Werkzeugfähigkeiten wie Suche, Codeausführung und Funktionsaufrufe. Gleichzeitig wurden Forschungsrichtungen für Agenten wie Project Mariner vorgestellt.
Werkzeugaufrufe lassen sich so verstehen: Früher konnte ein Modell die Frage „Was ist heute die neueste Version einer bestimmten Bibliothek?“ nur aus dem Gedächtnis beantworten. Mit Werkzeugaufrufen kann es selbst eine Suche anstoßen oder tatsächlich ein Stück Code ausführen und sich das Ergebnis ansehen. Die Rolle des Modells wandelt sich damit vom „Antwortgeber“ zum „Ausführenden“.
Gemini: Wendepunkt bei Reasoning und Programmierung 2025 – Thinking und Antigravity
Gemini 2.5: Thinking lässt das Modell erst denken, dann antworten
Mit Gemini 2.5 Pro kam im März 2025 die Thinking-Fähigkeit hinzu, und die Leistung bei Reasoning und Programmierung stieg spürbar. Thinking bedeutet, dass das Modell vor der Antwort mehrere Schritte durchdenkt. Ein Beispiel Debugging: Im normalen Modus liefert das Modell womöglich sofort einen Fix, der „richtig aussieht“. Im Thinking-Modus vermutet es zuerst mögliche Ursachen, schließt Hypothesen aus, die nicht zutreffen, und schlägt erst dann eine Änderung vor. Im Mai 2025 gab Google bekannt, dass 2.5 Pro in Ranglisten wie der damaligen WebDev Arena vorn lag. Damit zeigte Gemini zum ersten Mal deutlich Präsenz in programmierbezogenen Rankings.
Gemini 3 und Antigravity: Vom Modell zur Arbeitsumgebung
Am 18. November 2025 veröffentlichte Google Gemini 3 und Antigravity gleichzeitig. Antigravity bündelt Editor, Terminal und Browser-Steuerung in einer gemeinsamen Agent-Arbeitsumgebung. Der Schritt ist bedeutsam, weil Google nicht mehr nur wollte, dass das Modell Code „schreibt“. Es soll den Code selbst ausführen, im Browser das Ergebnis prüfen, Fehler erkennen und anschließend nachbessern.
Genau das meint Agentic Coding: Ein Agent übernimmt Planung, Schreiben, Ausführen und Prüfen des Codes, während Entwickler vor allem Ziele vorgeben und Ergebnisse abnehmen. Ab diesem Zeitpunkt wurden Modell und Toolchain gemeinsam entworfen – und das war der Schlüssel dafür, dass Gemini in der Folge aufholen konnte.
Gemini 4 Argon und Carbon: Der Weg zu komplexem Engineering im Jahr 2026
Das Iterationstempo bei Gemini hat 2026 spürbar angezogen. Im Februar hat 3.1 Pro das Kernreasoning gestärkt, im Mai hat 3.5 Flash Geschwindigkeit und langfristige Agent-Ausführung unter einen Hut gebracht, und im September wurde 3.8 Flash für Softwareentwicklung, Tool-Aufrufe und komplexe Agent-Workflows optimiert. Danach folgten Gemini 4 Argon und Carbon.
Wie sich die beiden Modelle voneinander unterscheiden, ist für Entwickler die wichtigste Frage.
| Vergleichspunkt | Gemini 4 Argon | Gemini 4 Carbon |
|---|---|---|
| Offizielle Positionierung | Die meisten gängigen Aufgaben in Softwareentwicklung und Wissensarbeit | Komplexes Debugging, tiefes Reasoning, lang laufende Aufgaben |
| Verfügbarkeit | Seit 13.10.2026 für Entwickler geöffnet | Seit 10.11.2026 breiter verfügbar |
| Beziehung | Basismodell | Auf Argon aufgebaut |
| Kontext | Maßgeblich ist die offizielle Dokumentation | Laut Model Card bis zu 1 Million Token (Ein- und Ausgabe zusammen) |
| Zugang | Gemini API, Antigravity, Aggregationsplattformen wie APIYI (apiyi.com) (maßgeblich ist die jeweilige Modellliste) | Gemini API, Google AI Ultra, Aggregationsplattformen (maßgeblich ist die jeweilige Modellliste) |
Kurz gesagt: Argon eignet sich für den Alltag, also Funktionen schreiben, Bugs beheben und Dokumente bearbeiten. Carbon ist für Aufgaben gedacht, bei denen lange am Stück gedacht werden muss, die mehrere Phasen umfassen und immer wieder überprüft werden müssen, etwa wenn Sie in einem großen Repository ein kompliziertes Nebenläufigkeitsproblem aufspüren wollen. Im Wissensarbeits-Benchmark AA-Briefcase liegt Carbon 126 Elo-Punkte vor Argon. Auch das zeigt, dass bei komplexen Aufgaben tatsächlich ein Unterschied besteht.
Wo Gemini 4 Carbon im Web-Development-Ranking wirklich steht
Wer bei der allgemeinen Intelligenz vorn liegt, führt nicht automatisch bei jeder Entwicklungsaufgabe. Das WebDev-Arena-Ranking vom 10. November 2026 ist dafür ein gutes Gegenbeispiel.
| Modell | WebDev Elo | Anmerkung |
|---|---|---|
| Claude Opus 5.5 Max | 1814 | Platz 1 im Ranking |
| Gemini 4 Carbon High | 1768 | Damals als Preliminary gekennzeichnet |
| GPT-6 Astra Max | 1764 | Nur 4 Punkte hinter Carbon |
Man sieht: In der Disziplin Webentwicklung liegt Opus 5.5 Max knapp 50 Punkte vorn, Carbon und Astra sind praktisch gleichauf, und Carbons Ergebnis ist zudem noch vorläufig. Der Autor des ursprünglichen WeChat-Artikels lobt Carbons Gespür für Oberflächendesign sehr und berichtet, das Modell rendere Seiten und prüfe anschließend selbst das Layout. Solche Erfahrungen sind interessant, bleiben aber persönliche Beobachtungen und sollten Sie an Ihrem eigenen Projekt überprüfen.
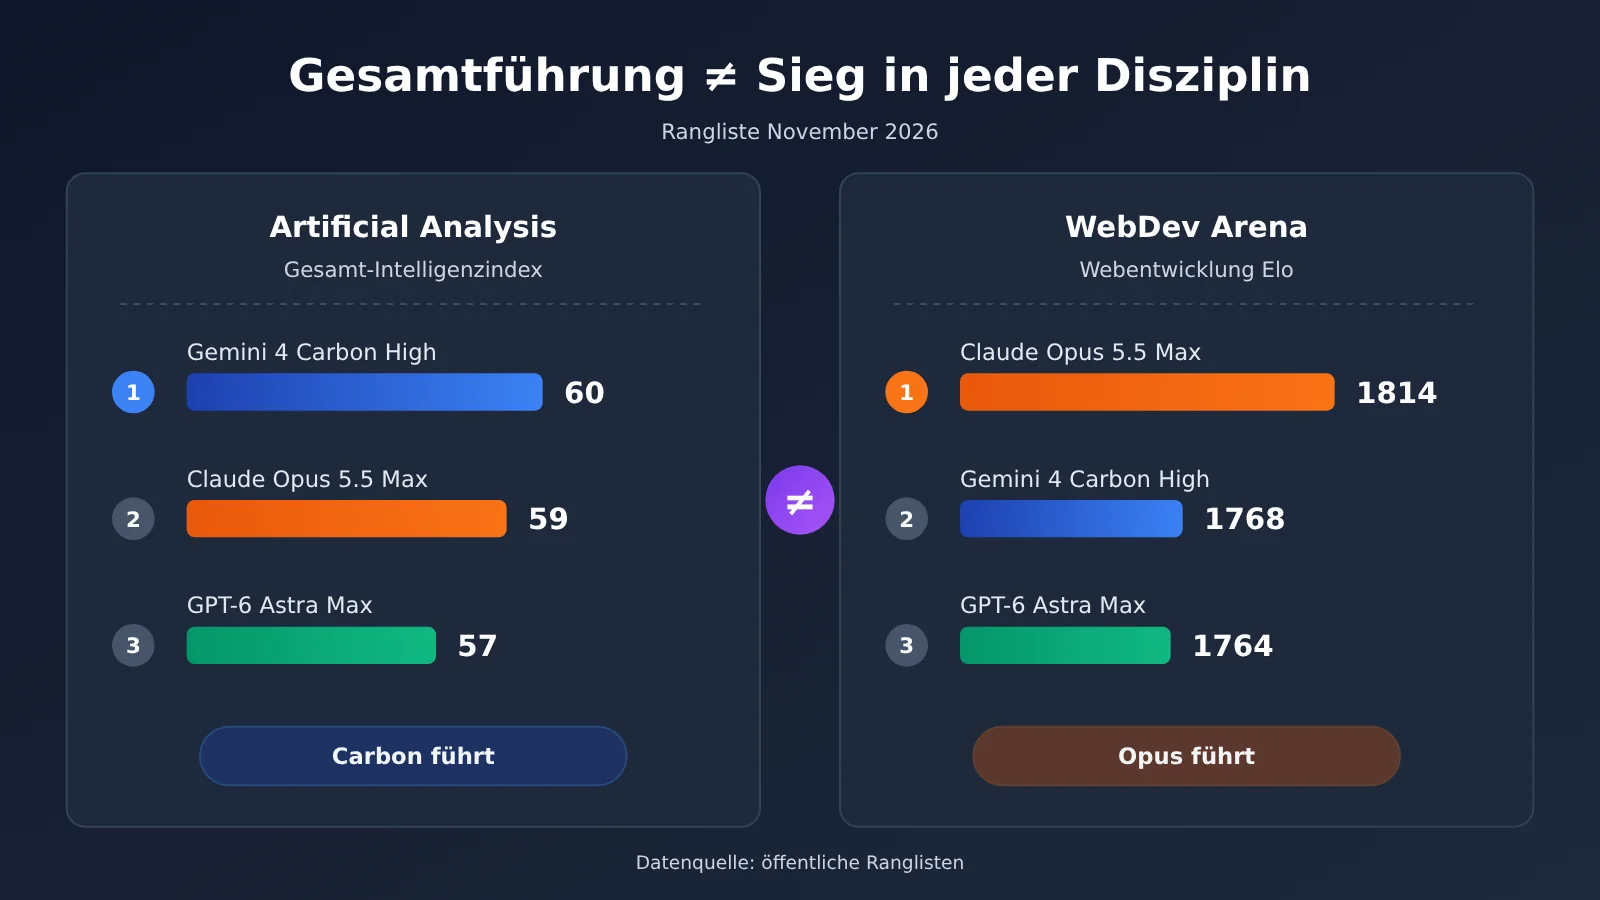
Hinweis zur Grafik: Die Ranking-Daten stammen von den öffentlichen Seiten von Artificial Analysis und Arena. Die Testkategorien unterscheiden sich je nach Ranking. Wenn Sie die Unterschiede mit Ihren eigenen Eingabeaufforderungen prüfen möchten, können Sie über APIYI (apiyi.com) mit derselben OpenAI-kompatiblen Schnittstelle zwischen den Modellen wechseln und sie direkt testen.
Warum Gemini zurückkommen konnte: Einflussanalyse
Modellfähigkeiten: Vom „viel sehen“ zum „zu Ende bringen“
Blickt man auf die letzten drei Jahre zurück, hat Gemini seinen Wettbewerbsschwerpunkt dreimal verlagert: Zuerst ging es darum, wie viele Arten von Informationen ein Modell versteht und wie viel es auf einmal verarbeiten kann. Dann kamen Schlussfolgern und Tool-Nutzung, und heute geht es darum, komplexe Engineering-Aufgaben über lange Zeit eigenständig auszuführen. Die Vorarbeit jeder Generation war dabei nicht umsonst. Dank multimodaler Fähigkeiten versteht das Modell Screenshots und Designentwürfe, ein langes Kontextfenster fasst ganze Codebasen, und mit Thinking und Tool-Aufrufen kann es tatsächlich selbst Hand anlegen.
Tool-Ökosystem: Modell und Ausführungsumgebung aus einem Guss
Antigravity, AI Studio, die Gemini App und die verschiedenen Entwicklerdienste von Google decken unterschiedliche Szenarien ab, vom Ausprobieren über Prototypen bis zur Entwicklung echter Produkte. Das ist ein wesentlicher Unterschied zwischen Google und Anbietern, die lediglich eine Modell-API bereitstellen: Ein Agent braucht Editor, Terminal und Browser als „Hände und Füße“, und Google kann die gesamte Ausführungsumgebung aus eigener Hand liefern.
Produktvertrieb und Preise: Entwickler und normale Nutzer zugleich erreichen
Bei den Abos hat Google am 19. Mai 2026 eine neue Ultra-Stufe für 100 US-Dollar eingeführt und die höchste Stufe von 250 auf 200 US-Dollar gesenkt. Sie bieten ein Basiskontingent von rund dem 5-Fachen beziehungsweise 20-Fachen der Pro-Stufe für 20 US-Dollar. Bei der API sieht die öffentliche Preisgestaltung von Carbon so aus:
| Zeitraum | Eingabe (pro Million Token) | Ausgabe (pro Million Token) |
|---|---|---|
| Bis 30.11.2026 | 2 US-Dollar | 10 US-Dollar |
| Ab 01.12.2026 | 4 US-Dollar | 20 US-Dollar |
Ein wichtiger Hinweis: Maßgeblich sind für Leistungen und Preise der Tarife immer die offiziellen Google-Seiten zum jeweiligen Zeitpunkt. Absolute Aussagen wie „unbegrenztes Kontingent“ oder „keine Kontosperrung“ aus dem ursprünglichen WeChat-Artikel sind keine offiziellen Zusagen.
Auswirkungen auf Entwickler
- Die Modellwahl wandelt sich vom „Alleinherrscher“ zur „Arbeitsteilung nach Aufgabe“: Für allgemeines Schlussfolgern bietet sich zuerst Carbon an, bei Webentwicklung und Coding-Agents lohnt der Vergleich mit Opus, und für alltägliche Aufgaben mit gutem Preis-Leistungs-Verhältnis kommt Argon infrage.
- Die Kostenstruktur muss neu geplant werden: Der Preis von Carbon verdoppelt sich am 1. Dezember, und lang laufende Agent-Aufgaben verbrauchen Token sehr schnell. Das Budget sollte man daher frühzeitig abschätzen.
- Die Bewertung muss wieder an echten Aufgaben ansetzen: Ranglisten helfen nur, die Kandidaten einzugrenzen. Am Ende sollten Sie mit Ihrer eigenen Codebasis und Ihren eigenen Prompts testen.
Auswirkungen auf die Branche
- Das Dreierfeld wird klarer: Google, OpenAI und Anthropic konkurrieren bei komplexen Entwicklungsaufgaben direkt miteinander und behalten jeweils in bestimmten Spezialgebieten die Nase vorn.
- Die Vergleichsgröße verschiebt sich vom Modell zum Workflow: Künftig zählen nicht nur Modellwerte, sondern auch die gesamte Toolchain aus IDE, CLI und der Zusammenarbeit mehrerer Agents.
So testen Sie die Gemini-4-Modelle per API
Wer das Ganze selbst ausprobieren möchte, kommt am schnellsten über die OpenAI-kompatible Schnittstelle ans Ziel. Das folgende Minimalbeispiel läuft, sobald Sie den API-Schlüssel ersetzt haben. Maßgeblich für die Modellnamen ist die Modellliste der Plattform:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # Modellname gemäß Modellliste der Plattform
    messages=[{"role": "user", "content": "用三句话解释什么是 Agentic Coding"}]
)
print(response.choices[0].message.content)
Vollständigen Code anzeigen: Routing zwischen Argon und Carbon nach Aufgabenkomplexität
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Modellnamen bitte der Modellliste der Plattform entnehmen
MODEL_ROUTER = {
    "simple": "gemini-4-argon",   # Übliche Entwicklungs- und Wissensarbeit
    "complex": "gemini-4-carbon"  # Komplexes Debugging, tiefes Reasoning, lang laufende Aufgaben
}

def ask_gemini(
    prompt: str,
    complexity: str = "simple",
    system_prompt: Optional[str] = None,
    max_tokens: int = 2000
) -> str:
    """Wählt je nach Aufgabenkomplexität ein Modell der Gemini-4-Serie aus"""
    model = MODEL_ROUTER.get(complexity, MODEL_ROUTER["simple"])
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        resp = client.chat.completions.create(
            model=model,
            messages=messages,
            max_tokens=max_tokens
        )
        return resp.choices[0].message.content
    except Exception as e:
        return f"Error: {e}"

# Alltägliche Aufgaben laufen über Argon, komplexes Debugging über Carbon
print(ask_gemini("给这个函数补充类型注解", complexity="simple"))
print(ask_gemini(
    "分析以下并发代码可能出现死锁的原因,并给出修复方案",
    complexity="complex",
    system_prompt="你是资深后端工程师,先列假设再逐一验证"
))
Tipp für den schnellen Einstieg: Der API-Preis für Carbon wird am 1. Dezember angepasst, deshalb lohnt es sich, zunächst mit einer kleinen Stichprobe zu testen. Nach der Registrierung bei APIYI (apiyi.com) erhalten Sie ein kostenloses Testkontingent. Mit einem einzigen API-Schlüssel rufen Sie Gemini, Claude, OpenAI und weitere Modelle auf und können so denselben Prompt bequem direkt vergleichen.
Häufige Fragen (FAQ)
Q1: Warum wird Gemini als „amerikanisches Doubao“ bezeichnet?
Das ist ein scherzhafter Spitzname aus der chinesischen Entwicklerszene. Gemini hat einen großen Konzern im Rücken und steckt in unzähligen Produkten des Google-Universums. Im Alltag, bei Chats und Bilderkennung, ist es sehr präsent, für anspruchsvolle Programmieraufgaben war es anfangs aber nicht die erste Wahl. Mit Gemini 3, Antigravity und der Gemini-4-Reihe ändert sich dieser Eindruck gerade.
Q2: Wer ist stärker, Gemini 4 Carbon oder Claude Opus 5.5?
Das hängt von der Testkategorie ab. Im Gesamtranking von Artificial Analysis liegt Carbon High (60 Punkte) knapp vor Opus 5.5 Max (59 Punkte). Im Coding Agent Index führt dagegen Opus 5.5 Max mit 62 Punkten vor Carbon High mit 59 Punkten. Auch in der WebDev Arena liegt Opus deutlich vorn.
Q3: Ab wann kann man Carbon nutzen?
Carbon wurde am 28. Oktober 2026 vorgestellt und zunächst nur für ausgewählte Fachleute freigegeben. Am 10. November folgte die Erweiterung: Seitdem ist das Modell über die kostenpflichtige Entwickler-API und im Rahmen von Google AI Ultra verfügbar.
Q4: Soll ich für die tägliche Entwicklung Argon oder Carbon wählen?
Laut offizieller Positionierung eignet sich Argon für die meisten gängigen Aufgaben in der Softwareentwicklung und der Wissensarbeit. Carbon ist für komplexes Debugging, tiefes Schlussfolgern und lange Ausführungszeiten gedacht. Am sichersten fahren Sie, wenn Sie Aufgaben per Code-Routing verteilen und beide Modelle auf APIYI (apiyi.com) mit derselben Eingabeaufforderung auf Qualität und Kosten testen. Erst danach legen Sie das Standardmodell fest.
Q5: Wie rufe ich die Gemini-4-Reihe schnell per API auf?
1. Registrieren Sie sich auf APIYI (apiyi.com) und holen Sie sich Ihren API-Schlüssel.
2. Sichern Sie sich das kostenlose Testguthaben für Neukunden.
3. Verwenden Sie den Code aus diesem Artikel, setzen Sie `base_url` auf `https://api.apiyi.com/v1` und tragen Sie den Modellnamen gemäß der Modellliste der Plattform ein.
Gemini in drei Jahren: Die wichtigsten Erkenntnisse (Key Takeaways)
- Entwicklungslinie: Gemini hat sich vom Verstehen von Informationen über das Lösen von Problemen bis hin zur langen, selbstständigen Ausführung komplexer Aufgaben entwickelt
- Frühes Fundament: Die nativ multimodale Architektur von 1.0 und das Kontextfenster mit einer Million Token in 1.5 bilden die Grundlage für alle späteren Fähigkeiten
- Wendepunkt: Mit Thinking in 2.5 und Antigravity in der 3er-Generation ist Gemini in die Königsdisziplin Programmierung vorgestoßen
- Aufgabenteilung der Modelle: Argon deckt die reguläre Entwicklung ab, Carbon übernimmt komplexes Debugging und langfristiges Schlussfolgern
- Ranglisten nüchtern lesen: Carbon führt im Gesamtscore, aber bei WebDev und speziellen Coding-Agent-Tests hat Opus weiterhin die Nase vorn
- Selbst ausprobieren: Über APIYI (apiyi.com) lassen sich Gemini und andere gängige Modelle mit einer einheitlichen Schnittstelle direkt testen
Fazit
Vom „amerikanischen Doubao“ zum Top-Programmiermodell: Die Gemini-Entwicklung der letzten drei Jahre lässt sich auf drei Kernpunkte zusammenfassen:
- Fähigkeiten bauen Schicht für Schicht aufeinander auf: Multimodalität, langes Kontextfenster, Thinking, Tool-Aufrufe und lange Ausführungszeiten – jeder Schritt setzt auf dem vorherigen auf.
- Das Ökosystem war der Schlüssel zum Aufschwung: Toolchains wie Antigravity geben dem Modell eine Umgebung, in der es wirklich selbst Hand anlegen kann, und Googles Produktvertrieb bringt diese Fähigkeiten zu sehr vielen Nutzern.
- Der Wettbewerb bleibt multipolar: Carbon ist in die erste Liga aufgestiegen, doch Opus und Astra haben jeweils eigene Stärken. Die beste Strategie für Entwickler ist, das Modell nach Aufgabe auszuwählen.
Gemini galt lange eher als Assistent im Google-Gesamtpaket. Inzwischen ist es einer der ernsthaften Kandidaten für komplexe Engineering-Aufgaben und die Agent-Entwicklung. Eine Rangliste ist nur der Ausgangspunkt – die eigentliche Antwort zeigt sich erst im eigenen Projekt. Wir empfehlen, über APIYI (apiyi.com) das kostenlose Kontingent zu nutzen, die Gemini-4-Reihe und andere Kandidaten an derselben Aufgabe zu vergleichen und erst danach die Modellkombination für Ihr Team festzulegen.
📚 Referenzen
- Google-Blog: Veröffentlichung von Gemini 1.0: Vorstellung der nativ multimodalen Modellfamilie
- Link:
blog.google/innovation-and-ai/technology/ai/google-gemini-ai -
Hinweis: Hier erfahren Sie, wie Gemini ursprünglich positioniert war
-
Google-Blog: Gemini 3 und Antigravity: Agentic Coding und Veröffentlichung der Entwicklungsumgebung
- Link:
blog.google/products-and-platforms/products/gemini/gemini-3 -
Hinweis: Zeigt den Wendepunkt, an dem Google vom reinen Modell zur Arbeitsumgebung übergeht
-
Google-Blog: Gemini 4 Carbon verfügbar, inklusive Preise: Verfügbarkeit und API-Preise
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available -
Hinweis: Offizieller Unterschied in der Positionierung von Carbon und Argon
-
Google DeepMind: Modellkarte zu Carbon: Angaben zu Kontext und Fähigkeiten
- Link:
deepmind.google/models/model-cards/gemini-4-carbon -
Hinweis: Technische Parameter wie das Kontextfenster von 1 Million Token
-
Artificial Analysis: Carbon-Benchmark-Special: Unabhängige Gesamtbewertung
- Link:
artificialanalysis.ai/articles/gemini-4-carbon-new-number-1 -
Hinweis: Quelle für Daten wie den Intelligence Index und den Coding Agent Index
-
Arena: WebDev-Bestenliste: Spezielles Ranking für Webentwicklung
- Link:
arena.ai/leaderboard/code/webdev -
Hinweis: Vergleich der Modelle bei Aufgaben der Webentwicklung
-
Offizielle Gemini-API-Preise: Aktuelle Abrechnungsregeln
- Link:
ai.google.dev/gemini-api/docs/pricing - Hinweis: Maßgeblich sind immer die aktuellen Angaben auf der offiziellen Seite
Autor: APIYI-Technikteam
Fachaustausch: Schreiben Sie uns gern über die Startseite von APIYI. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com