Note de l’auteur : cet article propose de trier les erreurs d’API de modèles par code afin de savoir quand réessayer, quand basculer vers un modèle de secours et quand s’arrêter pour corriger la configuration. Il comprend un tableau de tri des erreurs, une liste de vérification des modèles de secours et une liste de contrôle avant mise en production.
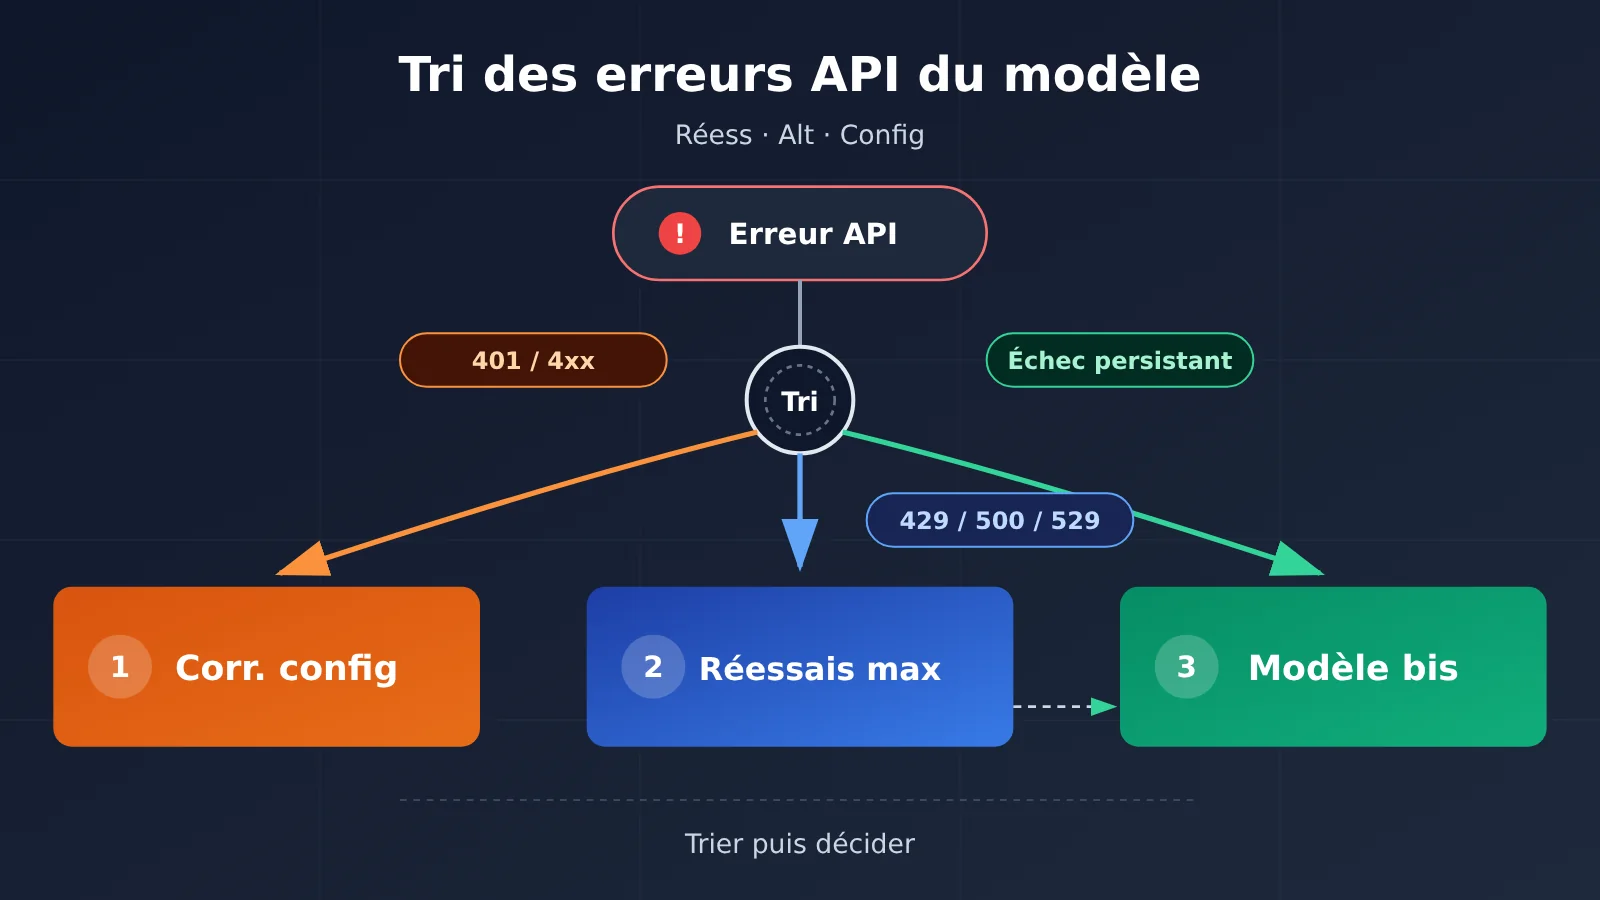
Quand une API de modèle renvoie une erreur, commencez par déterminer sa catégorie avant de décider quoi faire. Les erreurs 4xx signalent le plus souvent un problème de requête ou de configuration : réessayer ne changera rien. Les erreurs 5xx, 529 et les délais d’attente dépassés justifient des tentatives limitées ; si elles échouent encore, basculez vers un modèle de secours. Sans garantie d’idempotence, ne réessayez pas automatiquement. Réessayer ne doit pas être le réflexe par défaut, et basculer vers un autre modèle ne résout pas tout. Beaucoup d’incidents en production ne viennent pas d’une panne du modèle : c’est la gestion des erreurs qui transforme un petit incident en facturations et écritures en base en double, voire en limitation de débit sur toute la chaîne.
Cet article n’est pas une traduction de dictionnaire des codes d’erreur. Il s’adresse aux développeurs qui ont déjà intégré une API de modèle dans un environnement de production ou de préproduction. L’objectif : éviter d’aggraver la situation lorsqu’une erreur survient. Vous y trouverez un tableau de tri des erreurs, une stratégie de nouvelles tentatives et de repli, une liste de vérification des capacités du modèle de secours et une liste de contrôle à suivre avant la mise en production. Tout se résume à une règle : pour les 4xx, corrigez d’abord ; pour les 5xx, envisagez de réessayer ; pour les requêtes non idempotentes, arrêtez-vous d’abord.
Les 5 catégories d’erreurs d’API de modèles : classer avant de réessayer ou de basculer
En bref : les erreurs d’API de modèles se répartissent en cinq catégories, chacune avec une marche à suivre. Classez d’abord le code d’erreur pour décider ensuite s’il faut réessayer ou basculer.
| Catégorie d’erreur | Codes typiques | Origine | Action par défaut |
|---|---|---|---|
| Erreur de requête | 400, 404, 409, 422 |
Corps de la requête, paramètres, ID du modèle, point de terminaison | Ne pas réessayer ; corriger la requête |
| Erreur d’authentification ou d’autorisation | 401, 403 |
Clé, en-têtes, autorisations, région ou politique | Ne pas réessayer ; vérifier la clé et les autorisations |
| Quota ou limitation de débit | 402, 429 |
Solde, concurrence, débit, quota du modèle | 402 : arrêter ; 429 : examiner le corps de l’erreur avant d’attendre ou de basculer |
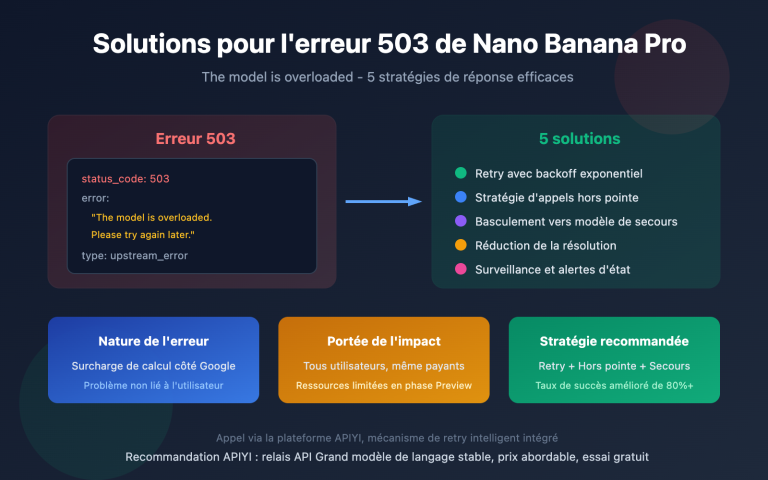
| Défaillance en amont | 500, 502, 503, 529 |
Passerelle, service en amont, surcharge | Réessayer un nombre limité de fois, puis basculer en cas d’échec |
| Expiration du délai ou interruption du flux | 408, 504, délai réseau dépassé, flux interrompu |
Connexion, sortie longue, réponse lente en amont | Vérifier d’abord si la requête a été exécutée ou facturée ; ne réessayer que si elle est idempotente |
La clé du diagnostic : distinguer « réessayer » de « basculer »
Réessayer consiste à renvoyer la requête avec le même modèle et par la même voie : c’est adapté aux perturbations passagères. Basculer consiste à changer de modèle ou de voie : c’est utile lorsqu’un service en amont reste indisponible. Les coûts ne sont pas les mêmes : réessayer augmente la latence et peut entraîner une double facturation ; basculer peut modifier la qualité des résultats, la compatibilité des appels d’outils et le coût.
Le diagnostic suit donc toujours trois étapes : identifier la catégorie d’erreur, vérifier si la requête est idempotente, puis choisir de réessayer, de basculer ou d’arrêter. Sauter la deuxième étape est particulièrement risqué : exécuter une seconde fois un appel d’outil déjà effectué peut avoir des conséquences bien plus graves qu’un simple surcoût.
Pourquoi « tout réessayer » aggrave les erreurs d’API de modèles
En bref : réessayer systématiquement après chaque erreur peut sembler prudent, mais cela amplifie les coûts, les effets secondaires et les limitations de débit. En production, les incidents provoqués par cette logique sont souvent plus difficiles à diagnostiquer que l’erreur initiale.
Le premier problème, c’est la double facturation. Une réponse en streaming interrompue ne signifie pas forcément que la requête a échoué : le fournisseur a peut-être déjà généré une partie des tokens, et leur coût a déjà pu être facturé. Relancer la requête à l’aveugle revient à payer deux fois pour la même tâche, surtout lorsque la réponse attendue est longue.
Le deuxième problème, c’est la répétition des actions. Dans un scénario d’agent, une requête au modèle peut déclencher une écriture en base de données, l’envoi d’un message, la création d’une tâche ou même un paiement. Si un appel d’outil expire, vous ne savez pas si l’outil a déjà exécuté son action. Relancer immédiatement toute la requête risque alors de créer deux commandes ou d’envoyer deux courriels.
Le troisième problème, c’est l’aggravation des limitations de débit. Une erreur 429 signifie justement que le fournisseur demande de ralentir. Si le client lance immédiatement des tentatives simultanées, il ajoute lui-même de la pression. Un autre mauvais réflexe courant consiste à réessayer pour toutes les erreurs 4xx : une erreur 401 peut simplement venir d’une clé API incorrecte, mais après plusieurs tentatives, le volume de requêtes atteint la limite. Les journaux finissent alors par afficher une multitude d’erreurs 429, masquant la véritable cause.
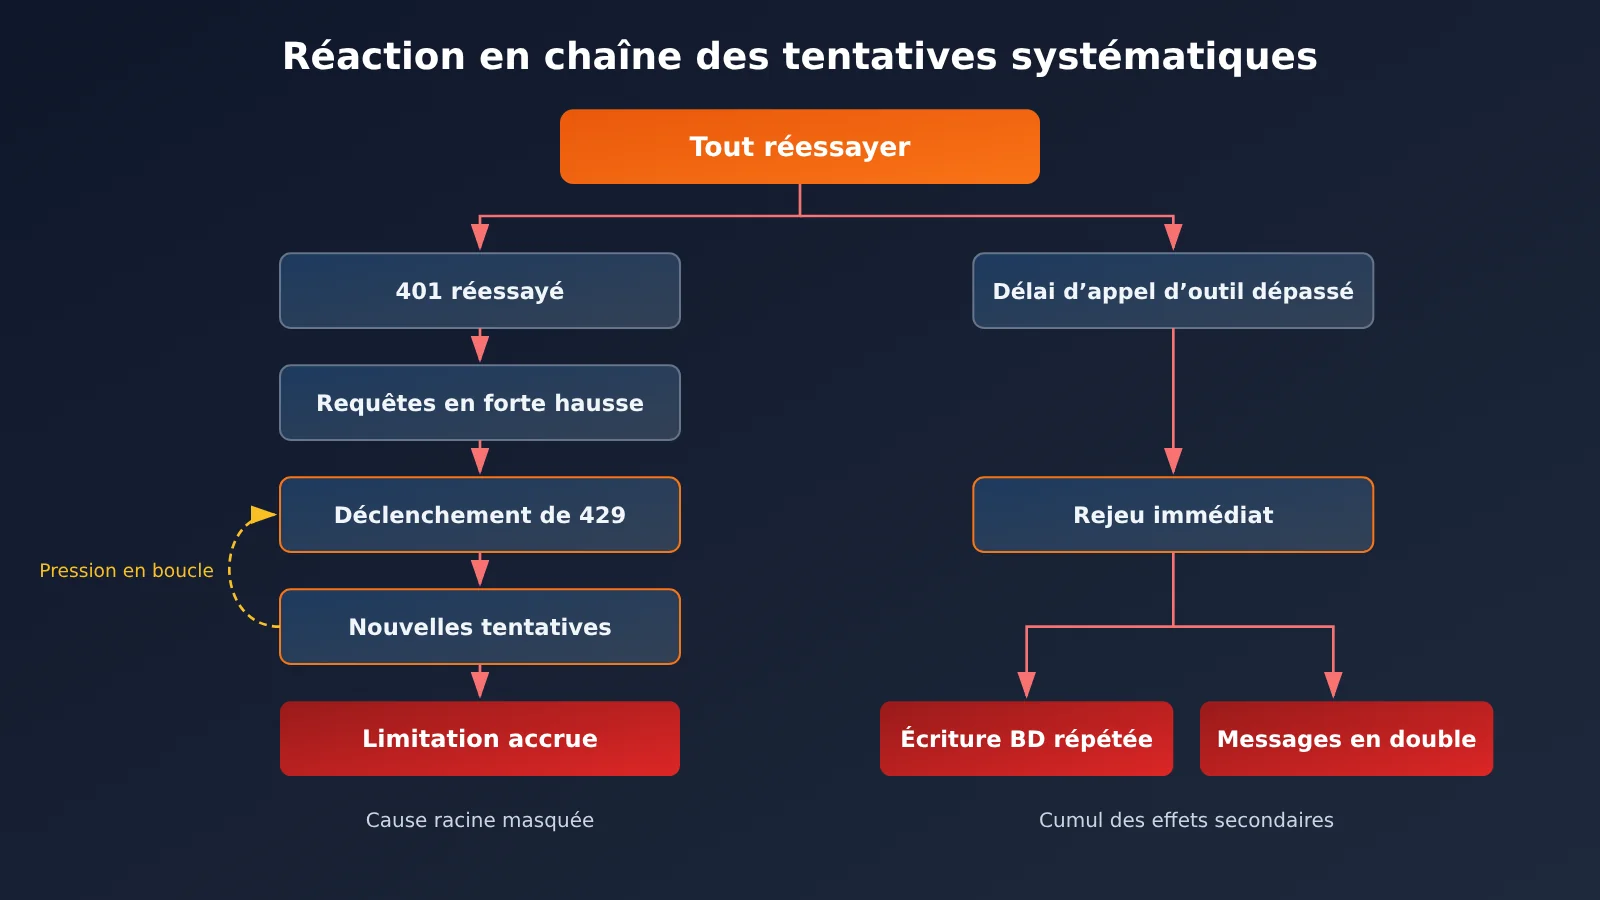
Tableau de triage des erreurs 401, 429, 500 et 529 : quand réessayer et quand basculer
En bref : ce tableau couvre les 14 codes de statut les plus courants en production. Seuls quelques-uns justifient une nouvelle tentative ; on ne bascule qu’après avoir constaté que les tentatives sont inefficaces. Dans la colonne « Basculer ? », il s’agit de passer à un modèle ou à une connexion de secours. La signification exacte dépend du corps de l’erreur et de la documentation de chaque fournisseur.
| Code de statut | Signification courante | Réessayer ? | Basculer ? | Action |
|---|---|---|---|---|
400 |
Format de requête ou paramètres incorrects | Non | Non | Corriger le corps de la requête, vérifier les champs et leurs types |
401 |
Clé invalide ou échec de l’authentification | Non | Non | Vérifier la clé, l’en-tête Authorization et l’URL de base |
402 |
Solde insuffisant ou quota épuisé | Non | Selon le cas | Recharger le compte ou passer à une connexion disposant d’un quota, puis déclencher une alerte |
403 |
Refus lié aux permissions, à la région ou aux règles d’accès | Non | Non | Vérifier les permissions du compte, l’accès au modèle et les restrictions géographiques |
404 |
Modèle ou point de terminaison inexistant | Non | Non | Vérifier l’ID du modèle et le chemin du point de terminaison |
408 |
Délai de la requête dépassé | Tentatives limitées si la requête est idempotente | Facultatif | Confirmer que la requête n’a pas été exécutée, puis réessayer 1 fois |
409 |
Conflit ou état incohérent | Non | Non | Vérifier l’état métier et éviter les écritures concurrentes |
422 |
Échec de validation des paramètres | Non | Non | Corriger les paramètres ; erreur courante avec le schéma de sortie structurée |
429 |
Limite de débit, concurrence ou quota | Réessayer après un délai progressif | Basculer si les tentatives échouent | Lire d’abord le corps de l’erreur et Retry-After |
500 |
Erreur interne du service en amont | Tentatives limitées | Basculer en cas d’échecs répétés | Consigner l’identifiant de requête et le corps de l’erreur |
502 |
Erreur de passerelle | Tentatives limitées | Basculement possible | Distinguer un problème de passerelle d’un problème en amont |
503 |
Service indisponible | Tentatives limitées | Basculement possible | Respecter Retry-After et passer en mode dégradé si nécessaire |
504 |
Délai de la passerelle dépassé | Réessayer uniquement si la requête est idempotente | Basculement possible | Vérifier d’abord si la tâche a déjà été exécutée |
529 |
Surcharge du service en amont | Tentatives limitées | Basculement possible | Utiliser un délai progressif avec une variation aléatoire, puis basculer si la surcharge persiste |
Une erreur 429 n’est pas forcément une limite de débit : lisez le corps de l’erreur avant de décider
Le code 429 est facile à mal interpréter. Il peut signaler une limite de débit, mais aussi un dépassement du nombre de requêtes simultanées, un quota de modèle épuisé ou, dans certains cas, un problème de solde. Une limite de débit se résout généralement après quelques secondes d’attente. En revanche, si le quota est épuisé, multiplier les tentatives ne sert à rien. Passer directement au modèle le plus cher ne fera qu’augmenter les coûts sans résoudre le problème.
Voici comment traiter une erreur 429 :
- Consultez l’en-tête de réponse
Retry-Afteret, s’il est présent, attendez la durée indiquée. - Lisez le champ indiquant le type d’erreur dans le corps de la réponse pour distinguer une limite de débit, une limite de concurrence et un problème de quota.
- En cas de problème de débit ou de concurrence : réessayez 1 à 2 fois avec un délai progressif et réduisez le nombre de requêtes simultanées côté client.
- En cas de problème de quota : arrêtez les tentatives, déclenchez une alerte et passez à une connexion disposant d’un quota.
La logique est similaire pour 500. Ce code ne signifie pas forcément que le modèle lui-même est en panne : le problème peut venir de la passerelle ou du service en amont. Consignez d’abord l’identifiant de requête et un résumé du corps de l’erreur : ils serviront au diagnostic comme au rapprochement des données.
Stratégie de nouvelle tentative en cas d’erreur d’API de modèle : nombre, délai, Retry-After et idempotence
En bref : ne relancez que les requêtes ayant échoué à cause d’une erreur transitoire, limitez-vous à 1 ou 2 nouvelles tentatives, utilisez un délai exponentiel avec une variation aléatoire et automatisez les nouvelles tentatives uniquement pour les requêtes idempotentes. Si ces quatre conditions ne sont pas réunies, ne relancez pas automatiquement la requête.
| Paramètre | Valeur conseillée | Explication |
|---|---|---|
| Erreurs permettant une nouvelle tentative | 429, 500, 502, 503, 504, 529, délais d’attente réseau |
Parmi les erreurs 4xx, seules 408 et 429 font exception |
| Nombre maximal de nouvelles tentatives | 1 à 2 | Au-delà, basculez vers une autre solution ou déclenchez une alerte, sans continuer à réessayer sur place |
| Délai entre les tentatives | 1s, 2s, 4s, avec progression exponentielle | Ajoutez une variation aléatoire à chaque délai pour éviter que plusieurs instances ne réessaient en même temps |
| Retry-After | À respecter en priorité s’il est présent | Il prime sur l’algorithme local de calcul du délai |
| Idempotence | Obligatoire | Les opérations d’écriture, appels d’outils, envois de messages et paiements ne sont pas relancés automatiquement par défaut |
Mise en place de la stratégie de nouvelle tentative
- Créez une fonction de classification des erreurs. Elle reçoit le code d’état et le corps de l’erreur, puis renvoie l’une des cinq catégories. Toute la logique doit s’appuyer sur ce résultat : évitez de vérifier les codes un peu partout dans le code métier.
- Indiquez si chaque requête est idempotente. La génération de texte, le résumé et la traduction peuvent généralement être considérés comme idempotents. Dès qu’une requête peut déclencher un outil ou une écriture externe, marquez-la comme non idempotente.
- Vérifiez d’abord l’état des requêtes non idempotentes. Après l’expiration du délai d’un appel d’outil, consultez l’état de la tâche ou de la base de données et confirmez que l’opération n’a pas été exécutée avant de réessayer. Si nécessaire, utilisez une clé d’idempotence côté métier pour éviter les doublons.
- Fixez une durée totale maximale. Le temps total consacré aux nouvelles tentatives doit être limité pour chaque requête. Sinon, le délai côté utilisateur risque d’expirer alors que le service continue à réessayer en arrière-plan.
- Consignez chaque tentative. Enregistrez au minimum le request id, l’ID du modèle, le code d’état, la catégorie d’erreur, la latence, le nombre de tokens utilisés et le nombre de nouvelles tentatives.
Cette dernière étape est souvent oubliée, alors qu’elle est indispensable pour rapprocher les données de facturation et diagnostiquer les problèmes. Si vous passez par APIYI apiyi.com, la console permet de consulter l’utilisation et les journaux d’appels par clé. En rapprochant le request id enregistré localement des erreurs côté plateforme, vous pouvez déterminer si l’échec vient de la passerelle, du fournisseur en amont ou du corps de votre requête.
Traitez les interruptions de flux à part. Lorsqu’une requête en streaming est interrompue, vérifiez d’abord combien de tokens ont déjà été reçus et si le contenu est exploitable. Décidez ensuite s’il faut poursuivre la génération, abandonner le résultat ou relancer la requête. Avant de relancer une tâche produisant une longue réponse, gardez à l’esprit que la génération précédente a peut-être déjà été facturée.
🎯 Conseil de diagnostic : face à une erreur comme
500ou529, dont l’origine est difficile à déterminer, conservez d’abord le corps d’erreur original et le request id. Vérifiez ensuite l’utilisation et les journaux de la même période dans la console APIYI apiyi.com. Ne tirez pas de conclusion à partir du seul code d’état.
Stratégie de bascule vers un modèle de secours : niveaux de capacité, correspondance des modèles et vérification de la compatibilité
En bref : pour basculer, il faut avoir vérifié au préalable que le modèle de secours peut prendre en charge les mêmes tâches. Si le chemin de repli est emprunté pour la première fois au moment d’une panne, il risque fort de provoquer une deuxième panne.
Commencez par classer les modèles par niveau : haut de gamme, généralistes et légers. Associez chaque type de tâche à un modèle principal et à un modèle de secours du même niveau ou d’un niveau voisin. Ne faites pas basculer toutes les requêtes vers le modèle le plus cher : une perturbation chez le fournisseur pourrait faire exploser la facture, et beaucoup de tâches simples ne tirent aucun bénéfice d’un modèle haut de gamme.
| Capacité | Modèle principal | Modèle de secours | Compatible ? | À faire avant la bascule |
|---|---|---|---|---|
| Fenêtre de contexte | Indiquer la limite réelle | Indiquer la limite réelle | À vérifier | Vérifier que l’entrée réelle la plus longue tient dans la fenêtre ; sinon, prévoir une stratégie de troncature |
| Appels d’outils | Schéma des outils, appels parallèles | Idem | À vérifier | Vérifier le format de retour des ID d’appel et la structure des paramètres |
| Sortie structurée | Schéma JSON ou JSON strict | Idem | À vérifier | Mesurer le taux de réussite avec le même schéma pour éviter les erreurs 422 |
| Entrée multimodale | Images, audio, vidéo | Idem | À vérifier | Vérifier les formats d’entrée et les limites de taille |
| Paramètres reasoning | Niveau de raisonnement ou champ de réflexion | Idem | À vérifier | Supprimer ou adapter les paramètres non pris en charge lors de la bascule |
| Prix et limites de débit | Se référer à la console | Se référer à la console | À vérifier | Estimer le coût après bascule et vérifier que les limites sont suffisantes |
| Région et conformité | Périmètre autorisé | Périmètre autorisé | À vérifier | Vérifier que la solution de secours respecte les régions et les exigences de conformité autorisées pour l’activité |
Remplissez ce tableau pour chaque type de tâche. Dans la colonne « Compatible ? », indiquez uniquement des résultats vérifiés, pas des suppositions. Les paramètres reasoning sont particulièrement susceptibles de poser problème : un champ de niveau de raisonnement pris en charge par le modèle principal peut provoquer directement une erreur 400 ou 422 avec le modèle de secours. La logique de bascule doit donc comporter une couche d’adaptation des paramètres, plutôt que de les transmettre tels quels.
Correspondance des modèles : référez-vous à la console pour les ID
Une erreur élémentaire fréquente lors d’une bascule consiste à se tromper dans l’ID du modèle et à recevoir une erreur 404. Maintenez une table de correspondance entre les noms logiques et les ID réels des modèles, puis utilisez uniquement les noms logiques dans le code métier. Lors d’une invocation via APIYI apiyi.com, référez-vous à la console et à la documentation pour connaître les ID exacts, la disponibilité et les prix des modèles. Utilisez https://api.apiyi.com/v1 comme base_url pour toutes les intégrations. Après toute modification de la table, lancez une requête canari avant la mise en production.
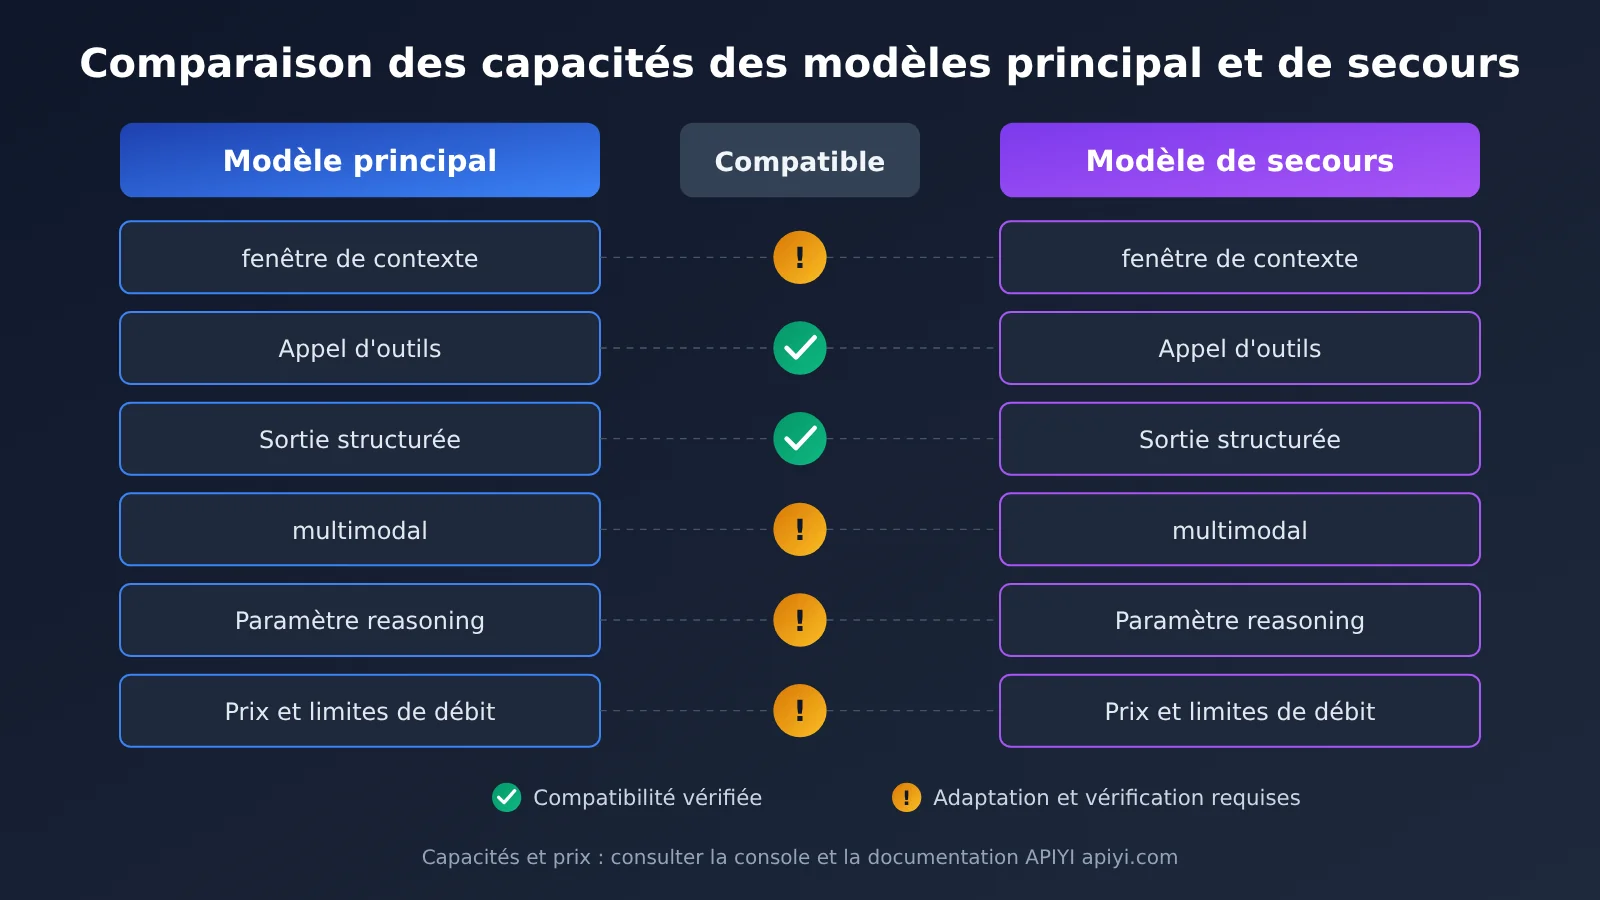
Validation des modèles de secours et passerelle multimodèle : tests canari, journaux et basculement automatique
En bref : avant de mettre en service un modèle de secours, testez-le sur des tâches réelles. Après un basculement, validez les résultats : un code 200 ne suffit pas. Une passerelle multimodèle facilite le changement de modèle, mais ne remplace pas le contrôle qualité.
Valider un modèle de secours en trois étapes
- Requêtes canari. Choisissez un ensemble de tâches métier réelles et envoyez-les au modèle principal et au modèle de secours, avec la même invite, les mêmes outils et les mêmes données d’entrée.
- Comparaison sur les mêmes tâches. Comparez le taux de réussite, la latence, le temps jusqu’au premier token, le coût en tokens et le taux d’échec. Pour les tâches avec appel d’outils, vérifiez aussi la compatibilité des ID d’appel, de la structure des paramètres et de celle des réponses.
- Validation après basculement. Lorsqu’un basculement se produit réellement, contrôlez automatiquement les résultats : le JSON peut-il être analysé ? Les champs obligatoires sont-ils présents ? Les paramètres des outils sont-ils valides ? Consignez aussi la raison du basculement et le résultat de la validation.
Testez régulièrement la procédure de basculement. Par exemple, dirigez chaque semaine une petite partie du trafic vers le modèle de secours pour vérifier que le parcours fonctionne toujours et éviter qu’une dépendance, un paramètre ou un ID de modèle ne devienne invalide sans que vous vous en rendiez compte.
Les champs des journaux devraient comprendre au minimum :
- ID de requête, ID de modèle, point d’accès, code d’état, classe d’erreur et résumé du corps de l’erreur
- Latence, temps jusqu’au premier token, durée totale, nombre de tentatives et cible du basculement
- Tokens d’entrée, tokens de sortie, succès du cache et coût estimé
- Nom de l’outil appelé, ID d’appel et réussite ou échec de l’exécution
- Raison du basculement et résultat de la validation après basculement
Le rôle d’une passerelle multimodèle dans la reprise après incident
Si vous intégrez vous-même plusieurs fournisseurs pour assurer la reprise après incident, vous devez maintenir au minimum plusieurs clés, plusieurs SDK et plusieurs formats d’erreur. Avec une passerelle d’agrégation comme APIYI apiyi.com, une seule clé permet d’invoquer les principaux modèles, notamment OpenAI, Claude, Gemini, DeepSeek et Qwen. L’interface est compatible avec le standard OpenAI et prend aussi en charge les formats natifs de Claude et Gemini. Les modèles principal et de secours peuvent ainsi partager le même code d’intégration : lors du basculement, vous changez l’ID du modèle plutôt que toute la chaîne d’intégration.
La plateforme propose aussi un déploiement sur plusieurs nœuds, le routage intelligent, le basculement automatique et l’équilibrage de charge, ce qui permet d’absorber une partie des perturbations en amont. Le basculement automatique de la passerelle ne remplace toutefois pas les contrôles métier : vérification de l’idempotence, déduplication des appels d’outils et validation des résultats restent à gérer dans votre propre code. Une répartition prudente consiste à laisser la passerelle gérer la disponibilité des connexions et des nœuds, et l’application vérifier la justesse des tâches.
💡 Conseil pour la reprise après incident : lors de la conception de votre dispositif principal-secours, vous pouvez d’abord exécuter le même ensemble de tâches canari sur les deux modèles avec une seule clé sur APIYI apiyi.com, puis inscrire les combinaisons validées dans votre table de correspondance des modèles. Les nouveaux utilisateurs peuvent commencer par les valider avec le crédit de test gratuit.
FAQ : erreurs courantes des API de modèles
En bref : les cinq questions ci-dessous couvrent les situations qui suscitent le plus de débats en production. Elles suivent toutes le même principe : diagnostiquer d’abord, agir ensuite.
Q1 : faut-il réessayer après une erreur 401 ?
Non. Une erreur `401` indique un échec d’authentification. Réessayer ne ferait qu’augmenter le nombre de requêtes, au risque de provoquer une erreur `429`. Vérifiez que la clé est valide, que le format de l’en-tête `Authorization` est correct et que l’URL de base et la clé appartiennent à la même plateforme. Si vous utilisez APIYI apiyi.com, vous pouvez vérifier l’état de la clé dans la console.
Q2 : faut-il changer immédiatement de modèle après une erreur 429 ?
Ce n’est pas recommandé. Consultez d’abord le corps de l’erreur et `Retry-After` : en cas de limitation du débit ou du nombre de requêtes simultanées, attendre avant de réessayer 1 à 2 fois suffit généralement à rétablir le service. Ne changez de route que si le quota est épuisé. Choisissez alors un modèle de secours de même niveau, plutôt que de basculer systématiquement vers le plus cher.
Q3 : faut-il relancer une requête si la sortie en streaming est interrompue ?
Pas tout de suite. Une interruption du flux ne signifie pas forcément que la requête a échoué : du contenu peut déjà avoir été généré et facturé. Vérifiez d’abord le nombre de tokens reçus et si le contenu est exploitable. S’il l’est, conservez-le ou poursuivez la génération ; sinon, relancez la requête 1 fois, à condition qu’elle soit idempotente. Consultez l’utilisation dans la console pour connaître la facturation réelle.
Q4 : que faire si un appel d’outil est exécuté plusieurs fois ?
La solution de fond consiste à rendre l’outil idempotent : utilisez une clé d’idempotence métier ou un ID de tâche pour éliminer les doublons, afin qu’un même ID ne soit exécuté qu’une fois. Après un dépassement du délai d’un appel d’outil, vérifiez d’abord l’état de la tâche et ne réessayez que si elle n’a pas été exécutée. Si des doublons se sont déjà produits, retrouvez-les dans les journaux à l’aide de l’ID d’appel, puis compensez ou annulez les opérations en trop.
Q5 : que faire si le modèle de secours renvoie un code 200, mais que le résultat est incorrect ?
Le code 200 indique seulement que la requête a réussi, pas que la tâche a été accomplie. Validez automatiquement la sortie : structure JSON, champs obligatoires et validité des paramètres d’outil, par exemple. Comptabilisez les échecs de validation dans le taux d’échec et déclenchez une alerte ou une vérification manuelle. Si une combinaison de secours échoue fréquemment aux contrôles, retirez-la de la table de correspondance et relancez une validation canari.
Liste de vérification avant mise en production : quand réessayer, basculer ou s’arrêter
En bref : vérifier chaque point de cette liste avant la mise en production est bien plus fiable que d’ajouter de la logique dans l’urgence après une panne. Retenez cette règle : on corrige d’abord les erreurs 4xx, on ne réessaie que pour les 5xx, et on s’arrête avant de relancer une requête non idempotente.
| N° | Point à vérifier | Critère de validation |
|---|---|---|
| 1 | Identifier d’abord le type d’erreur | Tous les codes d’état peuvent être classés dans l’une des cinq catégories ; les erreurs inconnues ne sont pas réessayées par défaut |
| 2 | Ne pas réessayer automatiquement les 4xx | 400, 401, 402, 403, 404, 409 et 422 déclenchent directement une alerte ou une correction |
| 3 | Décider ensuite de réessayer ou de basculer | Réessayer uniquement les erreurs transitoires, 1 à 2 fois au maximum, avec temporisation progressive et délai aléatoire |
| 4 | Respecter Retry-After | Si cet en-tête de réponse est présent, attendre en priorité la durée qu’il indique |
| 5 | Vérifier l’idempotence | Pour les appels d’outils, les écritures, les envois de messages et les paiements, s’arrêter par défaut et vérifier l’état avant de décider |
| 6 | Gérer les interruptions de flux | Vérifier d’abord les jetons déjà reçus et les frais engagés, sans relancer à l’aveugle |
| 7 | Vérifier le modèle de secours | Le tableau des capacités a été rempli et validé pour chaque type de tâche |
| 8 | Vérifier la correspondance des modèles | La correspondance entre les noms logiques et les identifiants de modèle est conforme à la console |
| 9 | Valider le résultat final | Après une bascule, vérifier la structure et les champs, sans se limiter au code 200 |
| 10 | Vérifier les journaux et s’entraîner | Les champs essentiels sont présents et la procédure de repli est testée régulièrement |
Gestion des erreurs d’API de modèles : points à retenir
- Quand réessayer : pour les erreurs
429,500,502,503,529et les requêtes idempotentes ayant dépassé le délai d’attente, avec un nombre limité de tentatives et une temporisation progressive. - Quand basculer : si les tentatives échouent encore, si le service en amont reste indisponible ou si le quota est épuisé, à condition que le modèle de secours ait été validé.
- Quand s’arrêter : en cas d’erreur de configuration 4xx comme
401, ou de requête non idempotente dont l’état est inconnu. - Basculer ne garantit pas le succès : même si le modèle de secours renvoie 200, il faut encore valider son résultat.
- Répartition entre la passerelle et l’application : confiez la disponibilité des connexions à la passerelle et gardez la vérification des résultats dans le code métier.
Une bonne gestion des erreurs ne se mesure pas au nombre de tentatives, mais à la capacité de prendre la bonne décision à chaque échec. Commencez par compléter la classification des erreurs, les indicateurs d’idempotence et les champs de journalisation, puis introduisez progressivement des modèles de secours. Pour une connexion de secours, vous pouvez envisager APIYI apiyi.com : une seule clé donne accès aux modèles de plusieurs grands fournisseurs, ce qui facilite la validation et la bascule entre modèles principal et de secours avec le même code. Consultez la console et la documentation pour connaître les prix et la disponibilité.
📚 Ressources
- Centre de documentation APIYI : méthodes d’intégration, liste des modèles et facturation
- Lien :
docs.apiyi.com -
Remarque : consultez la documentation et la console pour connaître les ID, les prix et la disponibilité des modèles
-
Signification des codes d’état HTTP : rôle des en-têtes de réponse standard comme
Retry-After - Lien :
developer.mozilla.org/docs/Web/HTTP/Status - Remarque : ces ressources aident à comprendre le sens général des codes 4xx et 5xx. Pour leur signification précise, consultez le corps de la réponse d’erreur de chaque plateforme de modèles
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site officiel APIYI, apiyi.com. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com