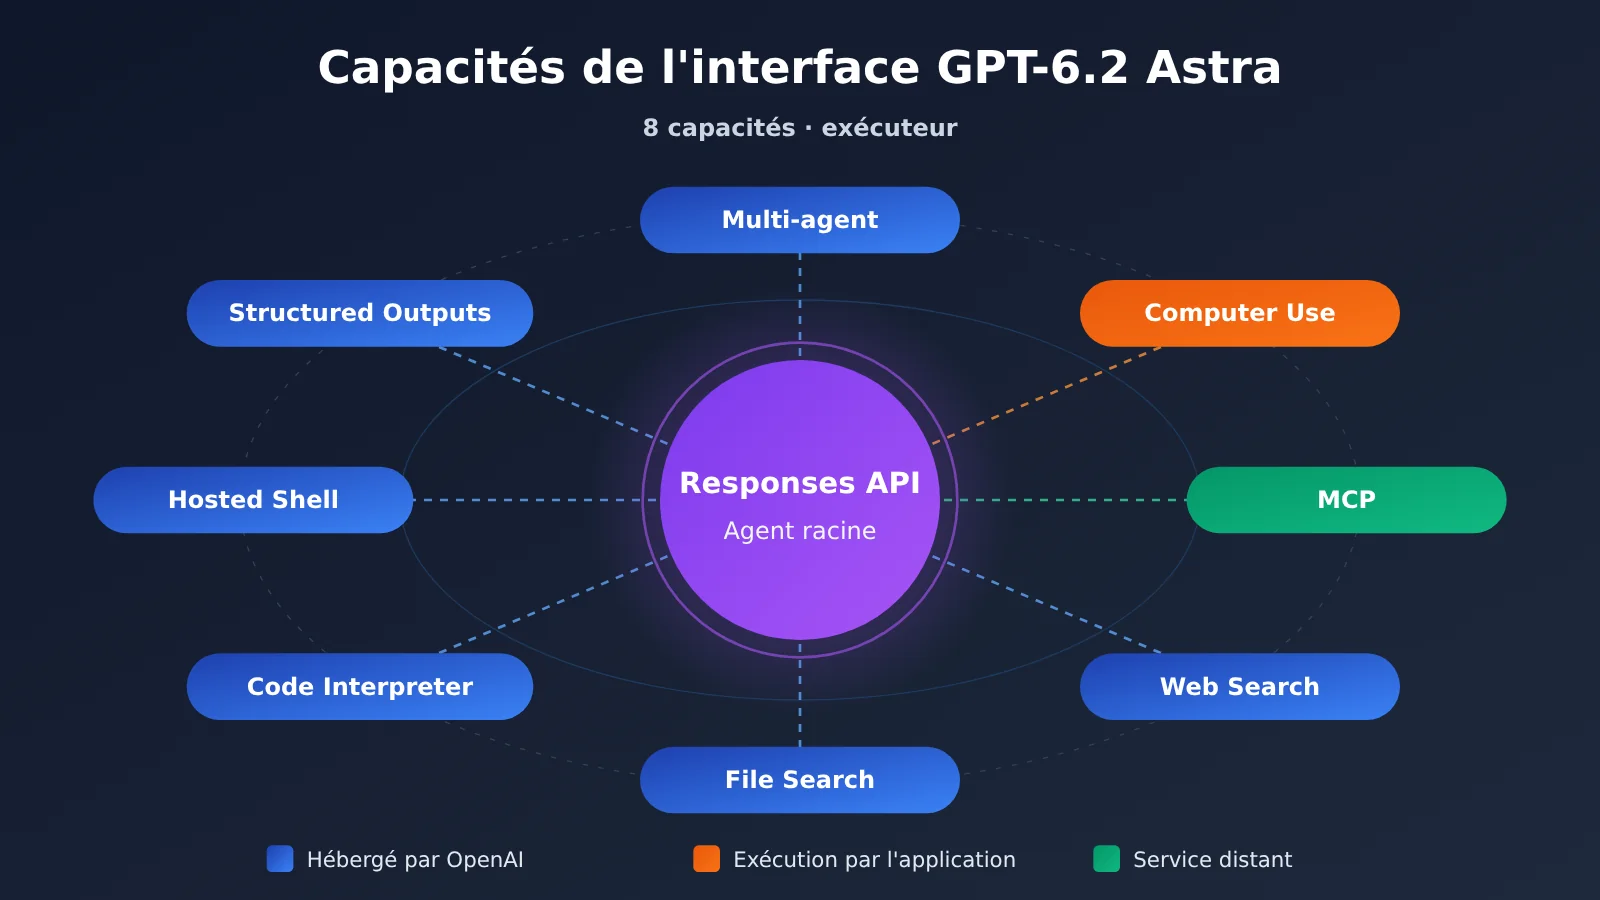
Réponse directe : Dans l’API Responses, GPT-6.2 Astra peut déléguer des sous-tâches en parallèle (Multi-agent), piloter un navigateur ou une interface de bureau à partir de captures d’écran (Computer Use), et se connecter à des services MCP distants pour appeler les outils métier de votre équipe. Cependant, l’exécutant de ces trois capacités n’est pas le même : la délégation est hébergée par l’API, l’environnement d’exécution des opérations d’interface est fourni par votre application, et l’objet des appels MCP est le service distant que vous configurez.
Conclusion clé : La difficulté d’ingénierie tient surtout à l’orchestration, pas aux capacités du modèle lui-même. Un agent métier réellement déployable doit clarifier dès le départ trois choses : qui exécute chaque outil, jusqu’où va l’autorisation des données, et qui valide le résultat final.
Que retiendrez-vous de cet article ?
- Les 6 catégories d’outils intégrés et les Structured Outputs pris en charge par GPT-6.2 Astra dans l’API Responses, ainsi que l’exécutant et les conditions d’utilisation de chacun ;
- Comment activer la version bêta Multi-agent, le nombre de concurrences par défaut, et quelles tâches se prêtent au parallélisme ou doivent au contraire s’exécuter en séquence ;
- La différence entre les deux chemins d’exécution Computer Use et MCP distant, notamment l’approbation, l’étendue des permissions et la répartition des responsabilités ;
- Comment enchaîner la recherche, le calcul et la sortie structurée pour livrer un résultat de vérification d’achat contrôlable.
Sommaire : Le corps de l’article commence par récapituler l’identité du modèle, ses spécifications et son prix, tels qu’annoncés par OpenAI le 17 novembre. Il présente ensuite un tableau comparant l’exécutant des 8 capacités, puis, en suivant l’exemple de conception « vérification d’achat en lecture seule », détaille successivement les limites du parallélisme Multi-agent, les chemins d’exécution de Computer Use et de MCP, et le mode de passage de relais entre recherche et sortie structurée. La partie analyse en fin d’article répondra à la question : que doivent faire dès maintenant les développeurs et les responsables produit ?
GPT-6.2 Astra To Know : explication des concepts
| Concept | Brève explication |
|---|---|
| Responses API | Interface d’OpenAI pour les réponses de modèle et les appels d’outils ; c’est elle qui sert de référence pour les outils intégrés et le Multi-agent abordés dans cet article |
| Multi-agent | Fonctionnalité bêta qui active plusieurs agents collaboratifs au sein d’une même requête Responses prise en charge |
| Sous-agent | Unité de travail qui traite une tâche déléguée dans un contexte indépendant, puis rend compte à l’agent racine une fois terminée |
| Computer Use | Capacité du modèle à localiser les éléments d’interface à partir de captures d’écran et à demander l’exécution d’opérations dans le navigateur ou sur le bureau |
| MCP | Protocole qui définit comment un client de modèle découvre et appelle les outils de services externes |
| Web Search | Outil de recherche de ressources sur l’internet public, capable de renvoyer les sources citées dans la réponse |
| File Search | Outil de recherche dans les fichiers déjà téléversés au sein d’un stockage vectoriel donné |
| Code Interpreter | Bac à sable hébergé pour exécuter du code Python, analyser des données et générer des fichiers |
| Hosted Shell | Environnement isolé hébergé par OpenAI, dans lequel on peut exécuter des commandes de terminal |
| Structured Outputs | Capacité de sortie qui contraint le format de la réponse via un JSON Schema |
| ID d’appel d’outil | Identifiant qui fait correspondre une demande d’appel à son résultat d’exécution, par exemple call_id |
Aperçu des impacts de GPT-6.2 Astra
- Ingénieurs en agents métier : une seule requête peut désormais combiner délégation, récupération, outils distants et sortie structurée, ce qui réduit le code d’orchestration. En revanche, le renvoi des résultats de fonctions, l’environnement d’exécution de Computer Use et l’approbation MCP doivent toujours être implémentés côté application.
- Responsables produit : l’idée que « l’agent peut piloter lui-même le système » bénéficie désormais d’un support d’interface officiel. La portée des permissions, la confirmation d’écriture et la responsabilité de la revue humaine doivent être intégrées au processus dès la phase de conception produit.
- Équipes sensibles aux coûts : le prix unitaire officiel a été revu à la baisse par rapport à la génération précédente. Mais le parallélisme multi-agents peut augmenter la consommation de tokens ; le budget doit donc être réestimé en fonction de la structure des tâches.
GPT-6.2 Astra : faits objectifs, lancement, spécifications et liste des outils
Publication et identité du modèle GPT-6.2 Astra
OpenAI a lancé simultanément GPT-6.2 Astra et GPT-6.2 Sol le 17 novembre 2026. L’éditeur positionne Astra comme un modèle dédié au raisonnement complexe, au codage et au travail professionnel, avec un ID de modèle API gpt-6.2-astra, succédant à GPT-6 Astra (gpt-6-astra). Le journal des mises à jour de l’API consigne le jour même la publication du modèle ainsi que les entrées liées à la fenêtre d’achèvement en arrière-plan.
Les spécifications indiquées sur la fiche du modèle sont les suivantes : une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et une sortie maximale de 128 000 tokens. Le modèle accepte des entrées texte et image, produit du texte, et prend en charge à la fois l’API Responses et l’API Chat Completions. Attention : la fiche précise que les requêtes dont reasoning.effort est réglé sur none sont rejetées ; pensez donc à vérifier ce paramètre lors d’une migration de code existant.
Côté tarification, les prix unitaires standard publiés par OpenAI pour le texte pur en contexte court s’expriment par million de tokens : entrée normale à 8 $, entrée avec cache hit à 0,40 $, sortie à 40 $. Par rapport à la génération précédente, l’éditeur annonce une baisse de 20 % sur le prix de l’entrée normale et de la sortie, et de 60 % sur l’entrée avec cache hit. Ces chiffres ne valent que pour une estimation en connexion directe à l’API officielle ; les coûts par question utilisés dans les évaluations tierces reposent sur une autre base tarifaire et ne sont pas directement comparables.
🚀 Démarrage rapide : si vous souhaitez d’abord vérifier les performances de GPT-6.2 Astra sur vos propres données métier, vous pouvez lancer un appel compatible OpenAI avec une seule clé API via APIYI apiyi.com. Les nouveaux utilisateurs disposent d’un quota de test gratuit, idéal pour une validation à petite échelle avant l’intégration officielle. La disponibilité des outils beta dépend du support réel de la plateforme.
Tableau récapitulatif des capacités d’interface de GPT-6.2 Astra
La fiche modèle liste Web Search, File Search, Code Interpreter, Hosted Shell, Computer Use et MCP comme outils pris en charge par Astra dans l’API Responses ; Structured Outputs y apparaît comme capacité de sortie, tandis que Multi-agent est une fonctionnalité bêta de Responses. Les développeurs déclarent les outils disponibles dans la requête, et le modèle décide, selon la tâche, s’il faut lancer un appel. La réponse peut contenir des demandes d’outil, des demandes d’approbation, des résultats d’exécution ou un texte final ; les éléments de sortie que le client doit traiter dépendent de l’exécutant de chaque outil.
| Capacité | Exécutant | Prérequis / configuration | Actions adaptées |
|---|---|---|---|
| Multi-agent | Délégation hébergée par Responses | Activer explicitement la fonctionnalité bêta | Traiter en parallèle des sous-tâches indépendantes et les agréger |
| Computer Use | Navigateur ou bureau fourni par l’application | L’application gère l’environnement et la session de connexion | Consulter ou manipuler des interfaces qui demandent de l’interaction |
| MCP | OpenAI appelle le service distant que vous avez configuré | Adresse du service, authentification, allowed_tools | Interroger un système métier ou demander une écriture |
| Web Search | Hébergé par OpenAI | Déclarer l’outil suffit | Chercher des informations publiques et qui évoluent rapidement |
| File Search | Hébergé par OpenAI | Téléverser et indexer au préalable dans un vector store | Chercher dans la documentation interne par sémantique et par mots-clés |
| Code Interpreter | Conteneur Python géré par OpenAI | Gérer l’entrée et la récupération des fichiers | Rapprochements, statistiques, génération de graphiques |
| Hosted Shell | Conteneur de terminal géré par OpenAI | Configurable via container_auto | Lignes de commande multi-étapes et traitement de plusieurs fichiers |
| Structured Outputs | Contrainte sur le format de réponse | Déclarer un JSON Schema dans text.format | Produire des données métier vérifiables |
Comment activer Multi-agent sur GPT-6.2 Astra, et ce qui est partagé
Pour activer Multi-agent, il faut renseigner multi_agent.enabled dans la requête Responses. Si vous passez par HTTP brut ou WebSocket, ajoutez également l’en-tête OpenAI-Beta: responses_multi_agent=v1 ; avec le SDK, il suffit d’appeler l’interface beta correspondante. L’agent racine peut créer des sous-agents, discuter avec eux, attendre qu’ils aient terminé et se charger de la synthèse finale.
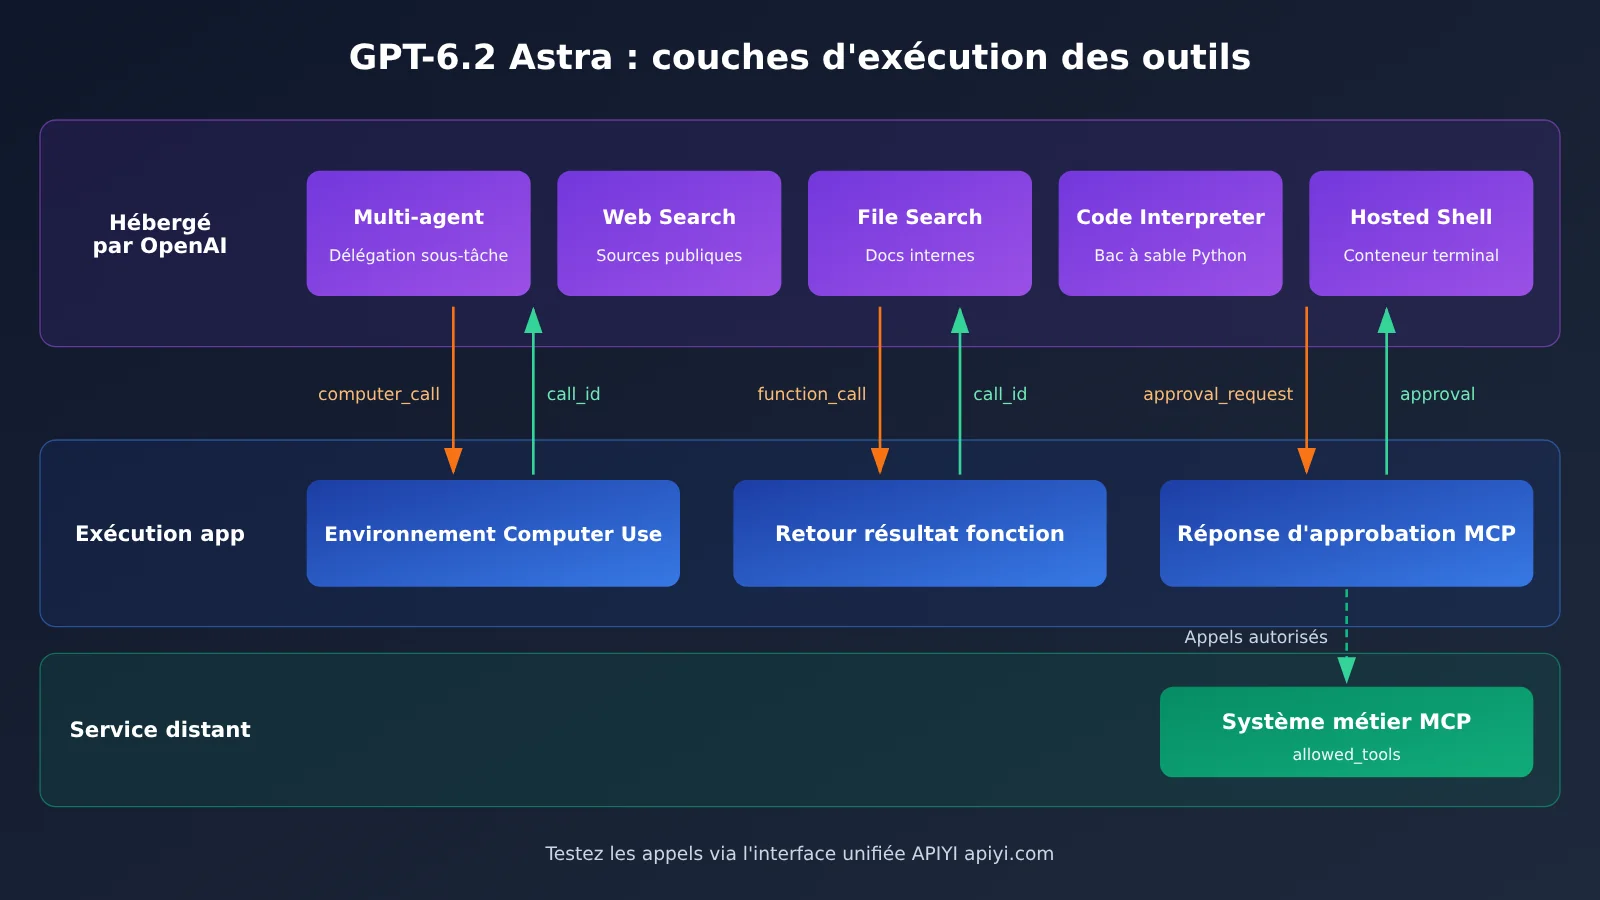
Chaque sous-agent possède son propre contexte, mais partage le modèle et les outils disponibles de la requête. La valeur par défaut de max_concurrent_subagents est 3 : elle plafonne le nombre de tours de sous-agents actifs simultanément dans l’ensemble de l’arbre d’agents. L’action de délégation multi_agent_call est hébergée par l’API. Si un sous-agent appelle une fonction personnalisée par le développeur, l’application doit renvoyer le résultat d’exécution en fonction de l’ID d’appel correspondant. La documentation officielle rappelle par ailleurs que le parallélisme convient aux tâches d’investigation indépendantes les unes des autres, au prix d’une consommation de tokens potentiellement plus élevée ; pour les étapes qui dépendent de résultats précédents et pour les écritures partagées, c’est à vous d’organiser l’ordre d’exécution.
Les frontières d’exécution entre Computer Use et MCP sur GPT-6.2 Astra
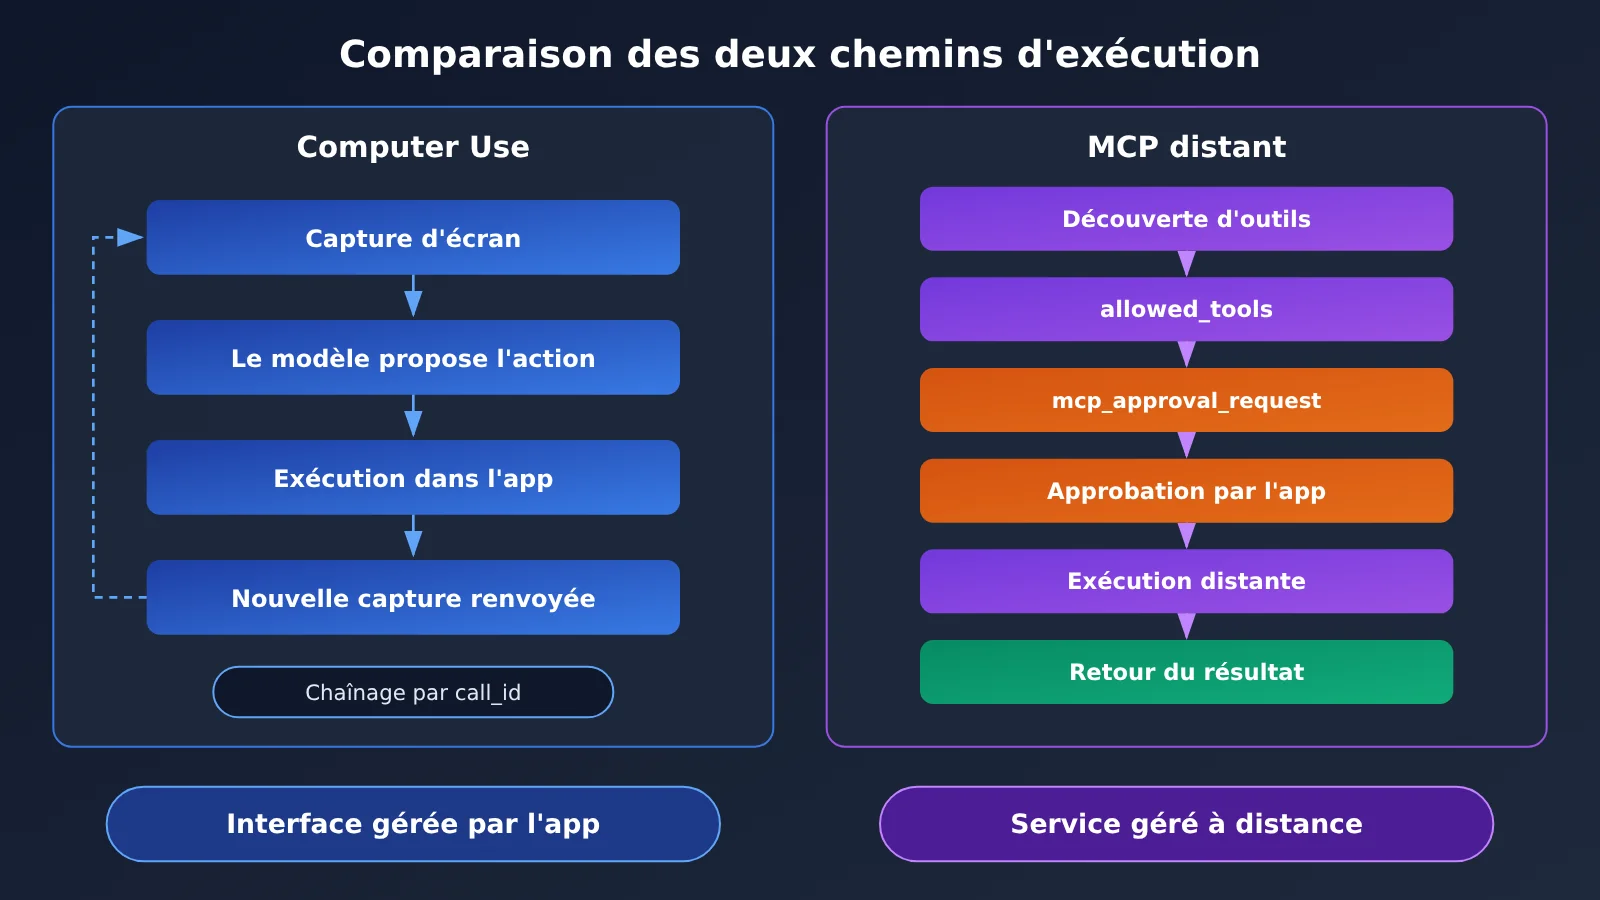
L’environnement d’exécution de Computer Use est fourni par l’application. Avec l’outil natif computer, le modèle émet un computer_call ; votre environnement exécute les clics, la saisie et autres actions qu’il contient, puis renvoie une nouvelle capture d’écran au modèle via computer_call_output et le call_id correspondant, et ainsi de suite jusqu’à la fin de la tâche. Le guide officiel présente aussi une autre approche : laisser le modèle générer un script, que l’application exécute dans un environnement isolé. Quelle que soit la méthode retenue, l’environnement lui-même, l’état de connexion, les pages accessibles et la confirmation avant toute écriture critique restent à la charge de l’application.
Le MCP distant, lui, fonctionne différemment. L’API se connecte à l’adresse de service que vous indiquez, importe les outils exposés par le serveur et exécute les appels autorisés. L’authentification distante se configure selon les exigences du service, et allowed_tools permet de restreindre les outils importés. Par défaut, l’envoi de données vers un connecteur ou un service distant déclenche d’abord une demande d’approbation : l’application peut lire le nom de l’outil et les paramètres dans mcp_approval_request, puis renvoyer un mcp_approval_response pour chaque cas.
Les règles de GPT-6.2 Astra pour la recherche, le calcul et les sorties structurées
La recherche web s’adresse à l’Internet public ; une application peut utiliser url_citation pour relier ses conclusions à leurs sources. La recherche de fichiers explore les documents déjà téléversés dans un stockage vectoriel donné, ce qui convient aux ressources internes archivées. L’interpréteur de code (Code Interpreter) fournit un bac à sable Python et peut produire des fichiers. Le Hosted Shell permet de configurer un terminal cloud via container_auto ; le guide Shell décrit aussi la solution où l’application héberge elle-même son runtime. Dans ces deux environnements de calcul, les fichiers doivent être gérés et récupérés activement au moment de l’utilisation.
Les sorties structurées déclarent un JSON Schema via text.format ; elles encadrent uniquement les réponses complètes et non refusées. La documentation officielle précise clairement que le destinataire doit encore gérer les refus, les réponses inachevées, les erreurs API et les règles métier qu’un schéma ne peut pas exprimer.
Analyse de GPT-6.2 Astra : enchaîner toutes les capacités autour d’une seule vérification d’achat
Le processus ci-dessous est un exemple de conception, déduit en combinant les capacités décrites dans les documents de référence ; il ne s’agit pas d’un cas officiel. À chaque requête, les outils doivent être configurés selon la situation réelle, et les combinaisons finalement activables dépendent de votre compte, de la configuration des outils et de l’environnement d’exécution.
GPT-6.2 Astra Multi-agent : quand le parallélisme est-il pertinent
L’objectif de la tâche est le suivant : vérifier la cohérence entre les clauses d’un contrat, les enregistrements de commandes dans le système d’achats et les informations publiques figurant sur le site du fournisseur, le tout en lecture seule. Ces trois requêtes n’ont aucune dépendance entre elles, ce qui correspond exactement au nombre de tâches simultanées par défaut, à savoir 3 : le groupe contrat utilise File Search pour consulter les clauses, le groupe achats interroge les commandes via un serveur MCP en lecture seule, et le groupe web utilise Web Search pour consulter les informations publiques. L’agent racine attend que les trois groupes aient rendu compte avant de procéder à la consolidation.
Pour déterminer si des sous-tâches peuvent s’exécuter en parallèle, on peut s’appuyer sur un critère : l’entrée d’une sous-tâche a-t-elle besoin de la sortie d’une autre sous-tâche ? Par exemple, « récupérer d’abord le numéro de commande, puis utiliser ce numéro pour consulter la facture » impose une exécution séquentielle ; forcer un découpage en parallèle ne ferait que pousser les sous-agents à faire des suppositions, ce qui rendrait le résultat encore plus difficile à vérifier. Il faut aussi garder à l’esprit que, même si l’action de délégation est gérée par l’API, dès lors qu’un sous-agent appelle une fonction que vous avez définie, le résultat de cette fonction doit toujours être renvoyé par l’application en utilisant l’ID d’appel. Si cette étape est omise, toute l’arborescence d’agents restera bloquée en attente.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)

# Code indicatif : pour la structure des paramètres, reportez-vous au guide OpenAI le plus récent
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},  # la valeur none sera refusée
    input="只读核验:合同 C-102 条款、订单 PO-881 记录、供应商官网公示信息是否一致",
    tools=[
        {"type": "file_search", "vector_store_ids": ["vs_contracts"]},
        {"type": "web_search"},
        {
            "type": "mcp",
            "server_label": "procurement",
            "server_url": "https://mcp.example.com/procurement",
            "allowed_tools": ["get_purchase_order"],  # n'exposer qu'un seul outil en lecture seule
            "require_approval": "always",
        },
    ],
    extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
    extra_body={"multi_agent": {"enabled": True, "max_concurrent_subagents": 3}},
)
💡 Conseil de choix : la délégation parallèle augmente la consommation de tokens. Je vous suggère de mesurer d’abord la consommation réelle d’une seule vérification sur un petit échantillon, puis de décider du nombre de tâches simultanées. Avec la facturation à l’usage via APIYI apiyi.com, vous pouvez comparer rapidement les coûts entre différentes configurations de parallélisme.
Répartition des rôles entre GPT-6.2 Astra Computer Use et MCP
Imaginons que la période de validité d’un certificat sur le site d’un fournisseur n’apparaisse qu’après avoir ouvert une fenêtre modale « certificat de qualification ». Web Search ne peut pas récupérer ce champ : il faut donc passer par Computer Use. Le processus se déroule en trois étapes : l’application ouvre la page dans un navigateur isolé et prend une capture d’écran ; le modèle renvoie les coordonnées du clic ou une instruction d’action ; après exécution, l’application transmet la nouvelle capture d’écran au modèle avec le call_id. Comme l’état de connexion et la portée d’accès restent entre les mains de l’application, pour les tâches en lecture seule, mieux vaut interdire la soumission de formulaires au niveau de l’environnement plutôt que de compter uniquement sur les contraintes de l’invite.
La consultation des commandes passe en revanche par MCP. Lors de la phase de découverte des outils, on importe uniquement l’outil en lecture seule get_purchase_order via allowed_tools ; l’authentification utilise des identifiants en lecture seule avec le minimum de privilèges. Avant chaque appel, l’application lit les paramètres de mcp_approval_request, vérifie que le numéro de commande entre dans le périmètre de cette vérification, puis renvoie l’approbation. On peut répartir les responsabilités entre les deux voies ainsi : ce qui se passe dans l’interface relève de l’application, ce que renvoie le système distant relève du fournisseur de service, et le modèle se contente de formuler la demande.
| Dimension | Computer Use | MCP distant |
|---|---|---|
| Environnement d’exécution | Navigateur / bureau fourni par l’application | Service distant que vous configurez |
| Identifiant de corrélation | computer_call et call_id | mcp_approval_request / response |
| Points de contrôle des droits | Isolation de l’environnement, état de connexion, liste blanche de pages | Authentification du service, allowed_tools, approbation à chaque appel |
| Champs adaptés | Informations publiques affichées seulement après interaction | Enregistrements structurés dans les systèmes métier |
| Risques principaux | Clics accidentels, refonte de la page | Appels non autorisés, paramètres hors limites |
GPT-6.2 Astra : de la collecte d’informations à une sortie exploitable
On choisit l’outil de recherche en fonction de l’emplacement du document : pour les informations publiques et susceptibles de changer, utilisez Web Search en conservant le url_citation ; pour les contrats déjà archivés, utilisez File Search. On choisit l’environnement de calcul selon la forme de la tâche : pour un rapprochement de montants ou des statistiques agrégées, le bac à sable Python de Code Interpreter suffit ; s’il faut décompresser plusieurs fichiers en lot, les convertir ou enchaîner des outils en ligne de commande, envisagez plutôt Hosted Shell. Et n’oubliez pas de prévoir une étape de récupération des fichiers dans le flux.
Une fois que l’agent racine a terminé la fusion, le mieux est de générer le résultat structuré dans une requête Responses ultérieure lancée par l’application, plutôt que de le mélanger à la recherche dans une même requête. Le schéma reste ainsi plus simple et, en cas d’échec, la nouvelle tentative est plus facile.
Voir l’exemple de code pour le renvoi d’approbation et la sortie structurée
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

ALLOWED_PO = {"PO-881"}

def handle_approvals(resp):
    """Approuver les appels MCP un par un : ne laisser passer que les numéros de commande du périmètre vérifié ici"""
    replies = []
    for item in resp.output:
        if item.type == "mcp_approval_request":
            ok = item.name == "get_purchase_order" and \
                 item.arguments and any(po in item.arguments for po in ALLOWED_PO)
            replies.append({
                "type": "mcp_approval_response",
                "approval_request_id": item.id,
                "approve": bool(ok),
            })
    return replies

schema = {
    "type": "object",
    "properties": {
        "records": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "record_id": {"type": "string"},
                    "evidence": {"type": "array", "items": {"type": "string"}},
                    "status": {"type": "string",
                               "enum": ["match", "mismatch", "needs_review"]},
                },
                "required": ["record_id", "evidence", "status"],
                "additionalProperties": False,
            },
        }
    },
    "required": ["records"],
    "additionalProperties": False,
}

def to_structured(prev_id):
    final = client.responses.create(
        model="gpt-6.2-astra",
        previous_response_id=prev_id,
        input="把核验结论整理为结构化记录,evidence 只写可追溯来源",
        text={"format": {"type": "json_schema", "name": "procurement_check",
                         "schema": schema, "strict": True}},
    )
    if final.status != "completed":
        raise RuntimeError(f"未完成:{final.status}")  # les refus et les cas inachevés sont à traiter à part
    return final.output_text
Les contraintes de format ne sont que la première ligne de défense : la logique des champs demande encore du code et des humains pour vérifier. Voici un exemple de sortie, avec la responsabilité de validation de chaque champ :
| Champ | Valeur d’exemple | Garanti par le format | Ce qu’il reste à vérifier | Responsable |
|---|---|---|---|---|
| record_id | PO-881 | le schéma impose une chaîne de caractères | l’identifiant existe-t-il vraiment dans le système d’achat | contre-vérification par le programme |
| evidence | article 5.2 du contrat ; page des certifications du site officiel | doit être un tableau | la source s’ouvre-t-elle, la citation correspond-elle | programme + contrôle par échantillonnage |
| status | mismatch | uniquement des valeurs de l’énumération | la décision respecte-t-elle les règles métier | relecture humaine |
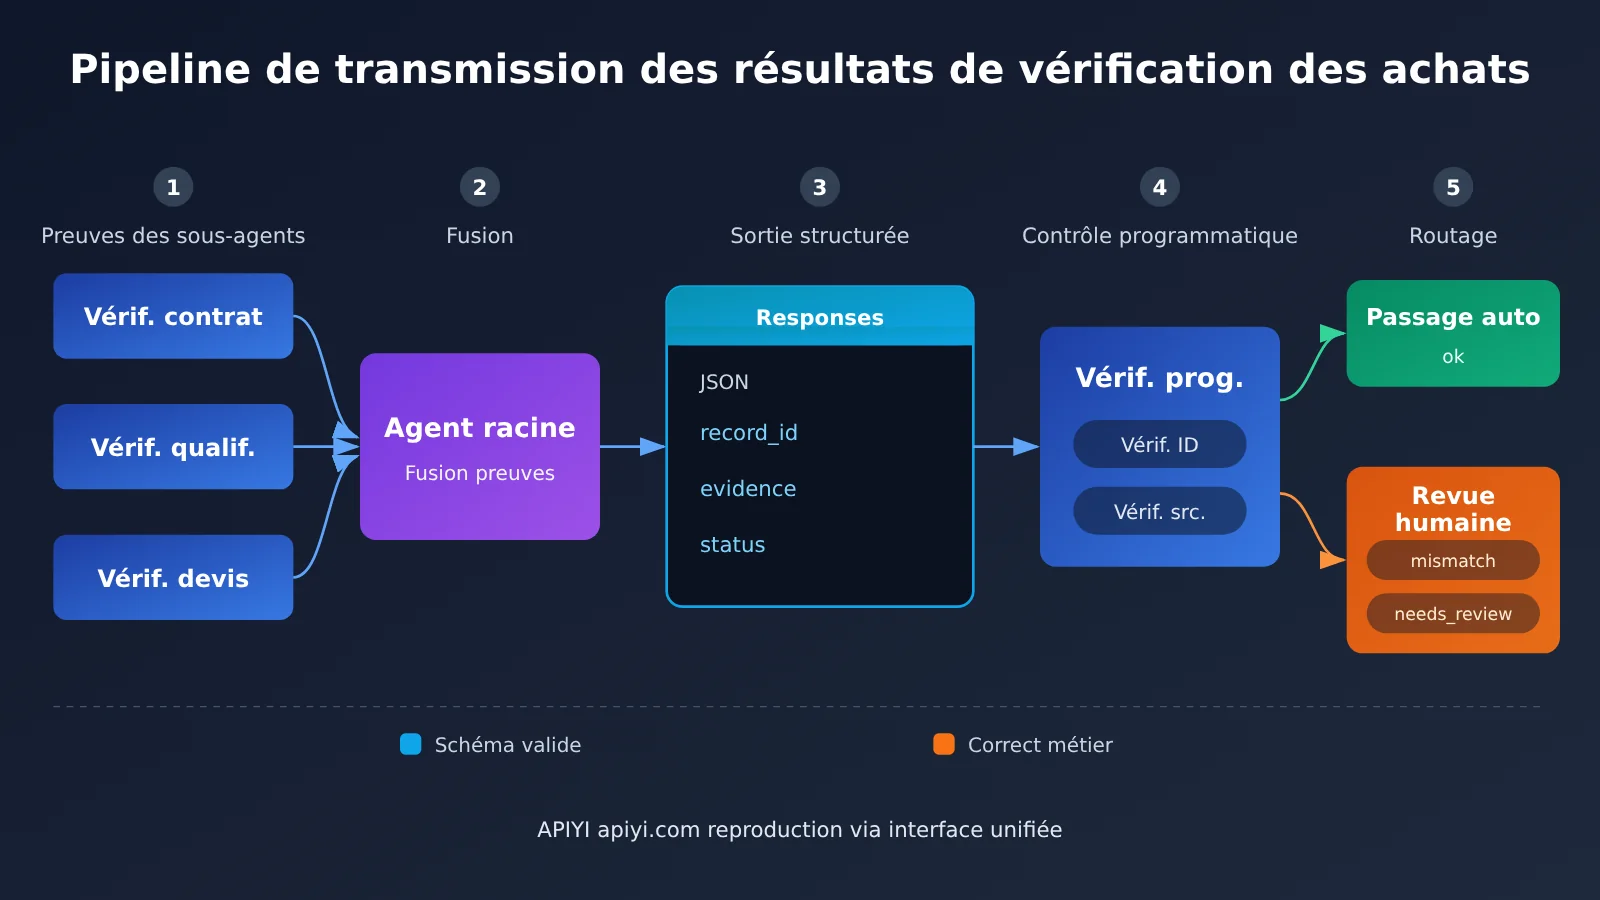
🎯 Conseil technique : nous recommandons de séparer la « validité du schéma » et la « conformité métier » en deux étapes de vérification distinctes ; tous les enregistrements dont
statusvautmismatchouneeds_reviewdoivent passer par une file de revue manuelle. Avant la mise en production, vous pouvez rejouer l’ensemble du processus avec des bons de commande historiques sur APIYI apiyi.com, mesurer le taux de décisions erronées, puis déterminer quels statuts peuvent être validés automatiquement.
L’ordre de déploiement de GPT-6.2 Astra
Sur la base de ces éléments, voici notre avis sur l’ordre d’intégration : commencez par rendre Structured Outputs et File Search pleinement opérationnels, ajoutez ensuite le MCP en lecture seule, puis introduisez Multi-agent et Computer Use. Les deux premières solutions sont hébergées par OpenAI, avec le risque d’erreur le plus faible ; le retour des approbations du MCP constitue une machine à états qui doit être testée séparément ; Multi-agent est encore en bêta, et la stabilité de Computer Use dépend de la qualité de l’environnement que vous hébergez vous-même. Ces deux derniers éléments gagnent à être ajoutés une fois le processus principal stabilisé.
Ce raisonnement repose sur deux conditions : les interfaces bêta ne subiront pas de changements non rétrocompatibles à court terme, et votre compte pourra activer les outils concernés. Dans les deux cas, il faut suivre régulièrement le journal des mises à jour de l’API OpenAI. Par ailleurs, « lecture seule » est une contrainte de conception dans cet exemple. Dès que le métier exige des écritures, la politique d’approbation, l’ordre des écritures et la procédure de rollback doivent être repensés : on ne peut pas réutiliser telle quelle la configuration de cet article.
💰 Optimisation des coûts : lorsqu’un long contrat est interrogé à plusieurs reprises, le prix unitaire des entrées qui touchent le cache est bien inférieur à celui des entrées normales ; placer les instructions système fixes et le schéma en tête de requête aide à améliorer le taux de succès du cache. Les équipes de petite et moyenne taille peuvent aussi passer par APIYI apiyi.com pour des appels facturés à l’usage, et élargir progressivement le périmètre de vérification.
La liste des outils ne cesse de s’allonger, mais ce qui détermine vraiment si un agent peut passer en production reste ces quelques frontières simples : qui exécute, qui autorise, qui contrôle. Comme l’écrivait Lu You dans « Enseigner à mon fils Ziyu en lisant une nuit d’hiver » :
Ce que l’on apprend sur le papier paraît toujours superficiel ; pour vraiment connaître une chose, il faut la pratiquer soi-même.
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com pour obtenir davantage de ressources pratiques sur l’intégration de GPT-6.2 Astra.