Resumen: Google Decisions API puntúa directamente opciones fijas, sin generar texto. Este artículo calcula con precios públicos su costo en tareas de clasificación, moderación y enrutamiento, y explica sus límites de uso a partir de datos oficiales y de terceros.
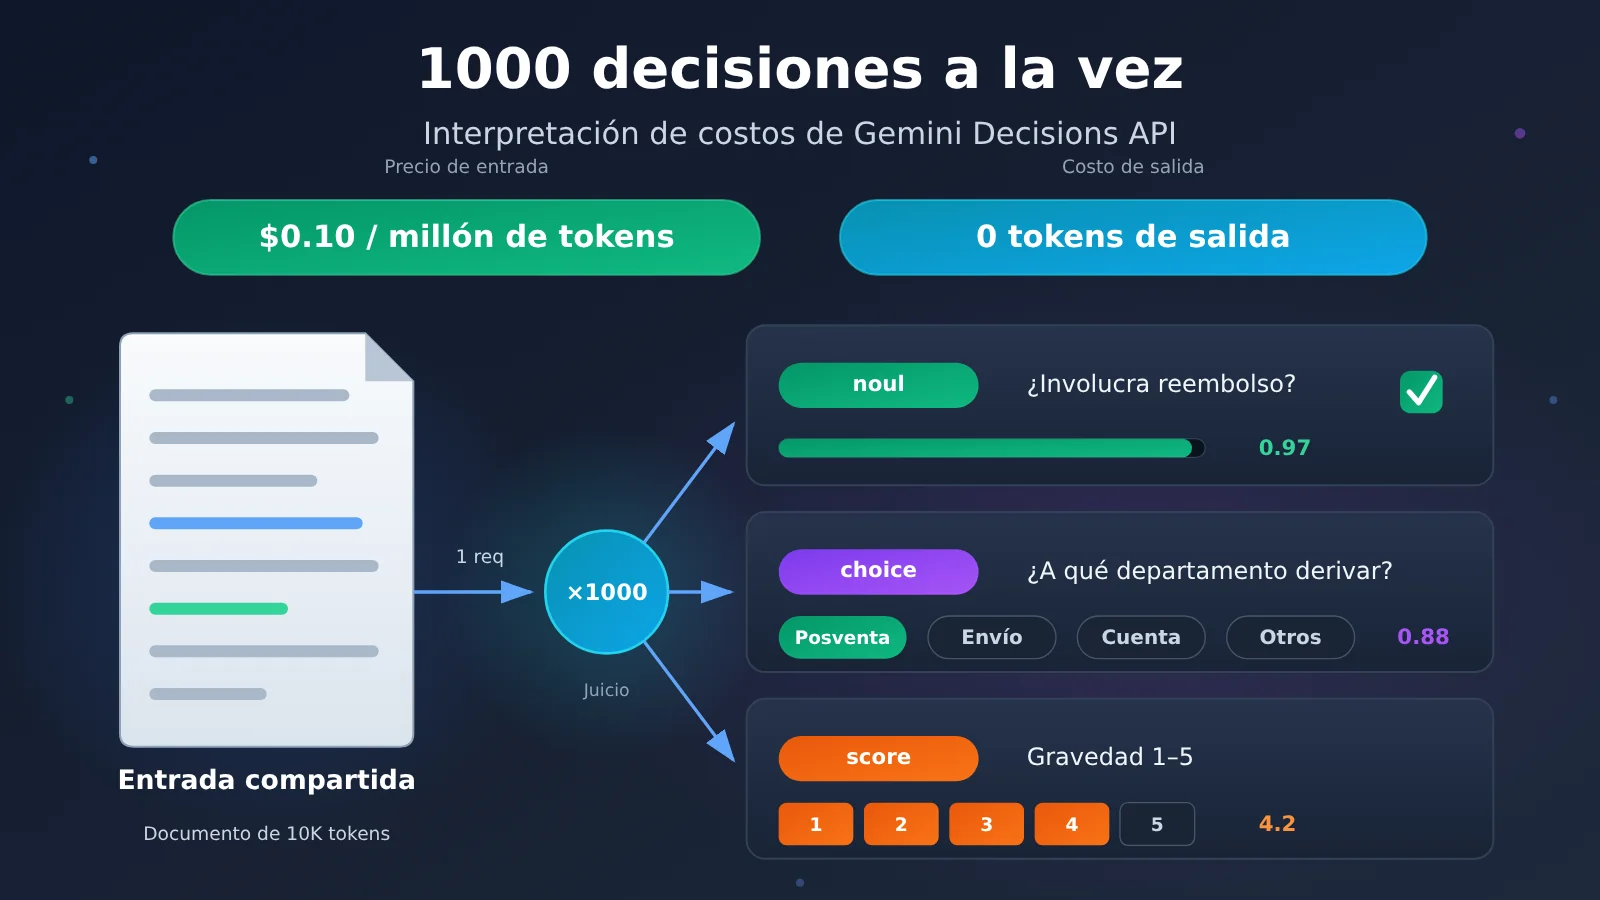
Conclusión principal: Google lanzó el 11 de noviembre de 2026 Gemini Decisions API (ID del modelo gemini-decision-1). Puede realizar entre 1 y 1,000 decisiones independientes sobre la misma entrada en una sola solicitud; el precio de entrada es de 0.10 USD por millón de tokens y no hay costo por tokens de salida generativa. Según cálculos con precios públicos, al revisar 1,000 reglas en un mismo documento de 10K tokens, el costo es aproximadamente 1/20 del de Gemini 3.5 Flash-Lite, con un ahorro teórico del 94.9%. Al clasificar una vez cada uno de 1,000 mensajes, el ahorro teórico es del 73.1%. La ventaja de costos que arrojan las pruebas oficiales de Google es de aproximadamente 4.7 veces. En pruebas independientes de terceros por pregunta individual, esta ventaja ronda las 1.5 veces. Las tareas que solo hacen clasificación, moderación o enrutamiento, y cuyas respuestas se pueden restringir de antemano a opciones fijas, son las más adecuadas para reducir costos con esta API.
A continuación, primero explicaremos cómo funciona esta interfaz y los tres tipos de decisión; luego calcularemos el costo de tres casos típicos de negocio con fórmulas reproducibles, y explicaremos la diferencia entre el «aproximadamente 5 veces» oficial y las mediciones de terceros. Después compararemos los datos de velocidad publicados por Google con la evaluación independiente de Artificial Analysis, y discutiremos si la precisión cumple los requisitos de producción. Por último, incluiremos un ejemplo mínimo de llamada, una tabla de selección de modelos y una lista de verificación de costos antes de la puesta en producción.
Para saber: terminología básica
| Término | Explicación |
|---|---|
| Decisions API | Interfaz de decisión lanzada por Google que devuelve directamente el resultado y las probabilidades para opciones fijas |
| Gemini Decision 1 | Modelo dedicado que soporta esta interfaz, con ID de modelo gemini-decision-1 |
| Token | Unidad básica de procesamiento y facturación; texto, imágenes y demás se convierten en Tokens |
| Shared Input | La porción de entrada que comparten todas las decisiones dentro de una misma solicitud |
| Closed-set Decision | Decisión cuyo rango de respuestas está predefinido, por ejemplo «sí/no» o «elige una de A/B/C» |
| noul | Decisión binaria; devuelve la probabilidad de «Yes» |
| choice | Elegir un elemento entre 2 y 255 opciones predefinidas |
| score | Puntuación según niveles ordenados predefinidos; el resultado es un valor esperado ponderado |
| Confidence | Estimación de probabilidad del modelo sobre lo acertado del resultado elegido |
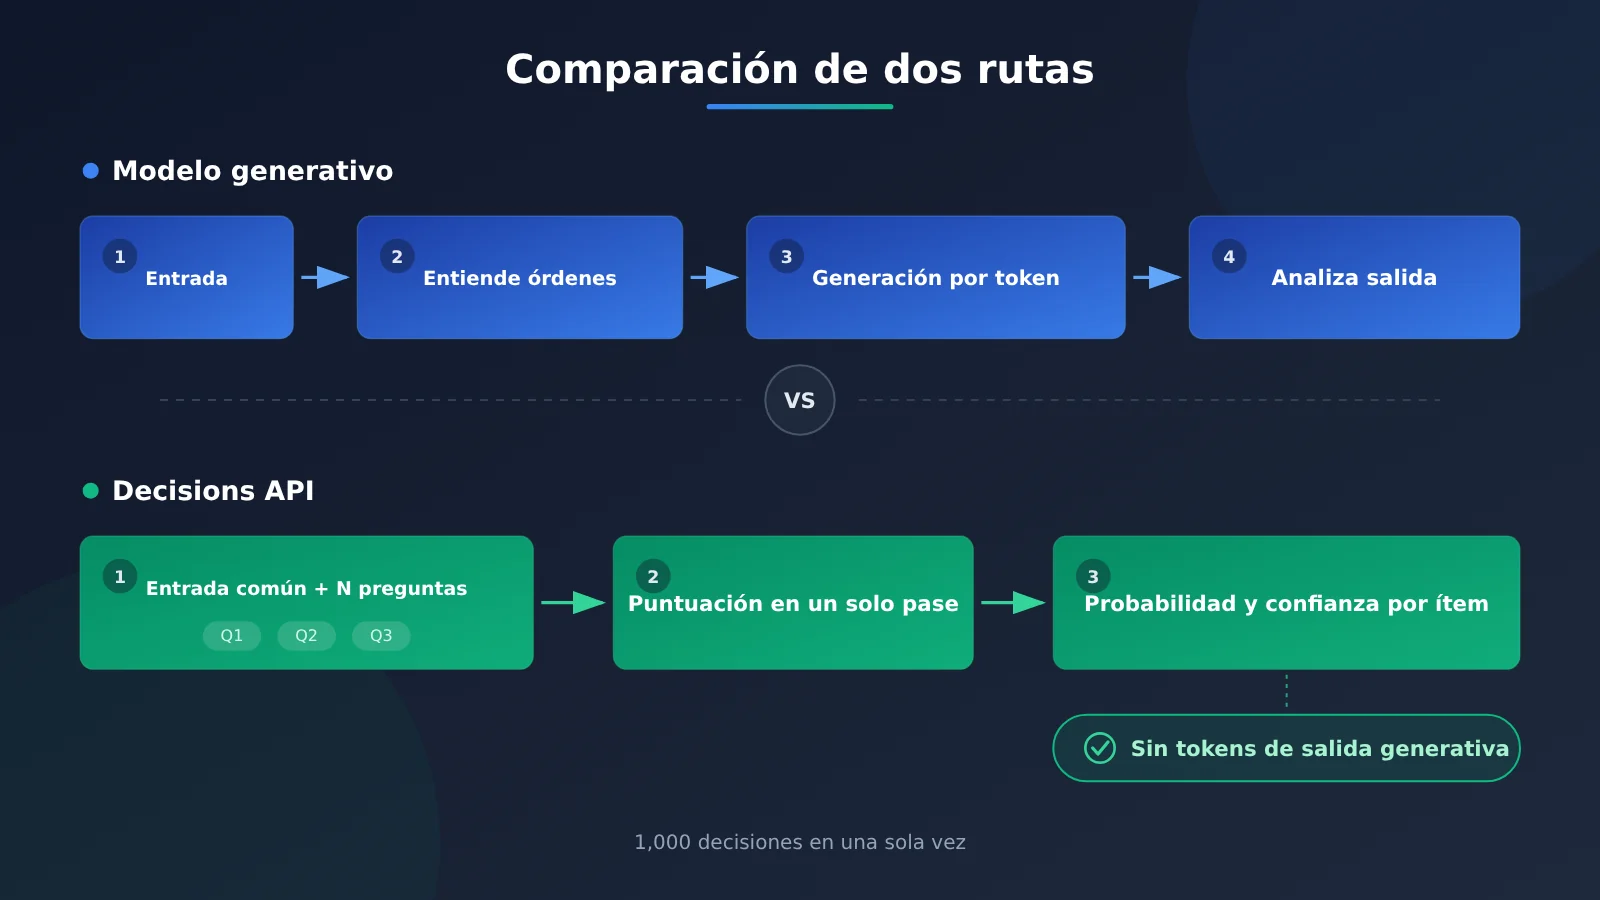
| Single Forward Pass | El modelo calcula las puntuaciones de cada opción en un solo pase, sin generar texto token por token |
| Context Window | Cantidad total de contenido que cabe en una solicitud; en este modelo son 262.144 Tokens |
| TPM / RPM | Tokens / solicitudes procesables por minuto, es decir, el techo de rendimiento |
1 Qué ha lanzado Google: la Gemini Decisions API responde preguntas de sí o no
1.1 Diferencias entre Gemini Decision 1 y los modelos generativos tradicionales
La Gemini Decisions API se abrió el 11 de noviembre de 2026 a través de Gemini Developer API v1beta, con el endpoint REST POST https://generativelanguage.googleapis.com/v1beta/decisions. Su función central es emitir juicios de probabilidad sobre opciones predefinidas, devolviendo el resultado de la decisión, la probabilidad de cada opción, la confianza y el consumo de Tokens. La entrada admite texto, imágenes, audio, vídeo y PDF.
El flujo de los modelos generativos tradicionales ante una tarea de clasificación es: leer el contenido, interpretar la instrucción y generar una respuesta Token a Token, que además el desarrollador tiene que parsear. La Decisions API cambia ese flujo: primero lee el contenido compartido y luego puntúa directamente las opciones predefinidas de cada pregunta. Tareas como clasificación, moderación o enrutamiento solo necesitan una etiqueta o un «sí/no»; generar una respuesta larga encarece la salida y ralentiza la respuesta. Eliminar ese paso es justamente el origen de su menor coste y menor latencia.
1.2 Qué tareas cubren los tres modos de decisión de la Decisions API
Tomemos como ejemplo un mensaje de atención al cliente: «Compré unos auriculares la semana pasada y el izquierdo no suena; pedí el reembolso hace tres días y nadie me responde. Si no lo solucionan, denunciaré a la plataforma.» Sobre este único mensaje se pueden plantear a la vez tres preguntas independientes dentro de la misma solicitud.
| Tipo de decisión | Pregunta de ejemplo | Contenido devuelto | Tareas típicas |
|---|---|---|---|
| noul | ¿Este mensaje implica un reembolso? | Probabilidad de «Yes», por ejemplo 0,97 | Si infringe normas, si menciona precios, si requiere escalar a revisión |
| choice | ¿A qué departamento corresponde: posventa / logística / cuenta / otro? | Elige «posventa» e indica la probabilidad de cada opción | Enrutamiento de tickets, clasificación de artículos, selección de herramientas por un Agent |
| score | ¿Qué severidad tiene la queja en una escala de 1 a 5? | Valor esperado ponderado calculado a partir de las probabilidades de cada nivel, por ejemplo 4,2 | Puntuación de relevancia, severidad, prioridad de leads |
choice admite de 2 a 255 opciones, y score de 2 a 255 niveles. score devuelve un valor esperado calculado a partir de las probabilidades de cada nivel, por lo que puede usarse directamente para ordenar o fijar umbrales, sin necesidad de extraer una nota de un texto de valoración.
2 ¿Cuánto se puede ahorrar realmente con Google Decisions API? Tres escenarios de negocio
2.1 Por qué compartir la entrada ayuda a reducir el consumo de tokens
La estructura de facturación de Decisions API tiene tres particularidades: la entrada compartida se cobra una sola vez por solicitud; las instrucciones de cada pregunta se siguen cobrando como tokens de entrada; y el resultado de la decisión no genera costos de salida generativa. El referente de comparación es Gemini 3.5 Flash-Lite, cuyo precio estándar oficial es de 0.30 USD por millón de tokens de entrada y 2.50 USD por millón de tokens de salida (precios oficiales del 13 de noviembre de 2026).
Sea S la cantidad de tokens de una entrada compartida, Q la cantidad de preguntas independientes sobre esa entrada, Tq la cantidad promedio de tokens por pregunta, To la cantidad promedio de tokens de salida por pregunta del modelo generativo y N la cantidad de entradas. Bajo el supuesto simplificado de que “ambas interfaces pueden facturar la misma cantidad de tokens de entrada”:
Decisions API 成本  C_D = N × (S + Q×Tq) × 0.10 / 1,000,000
Flash-Lite 成本     C_F = N × [ (S + Q×Tq) × 0.30 + Q×To × 2.50 ] / 1,000,000
节省率              = (1 − C_D / C_F) × 100%
Este es un modelo de cálculo para entender el mecanismo; Google no ofrece una tasa de ahorro fija. Cada interfaz tiene sus propios costos de codificación de instrucciones y de formato, y el costo real se calcula según los tokens facturables que devuelve cada una.
2.2 De 1 decisión a 1.000 decisiones: cómo cambian los costos
La siguiente tabla es un ejemplo teórico derivado de precios públicos, no de pruebas de carga reales. Las 1.000 decisiones del escenario ① se aplican todas al mismo documento: son 1.000 preguntas independientes sobre una sola entrada, lo que constituye una carga completamente distinta de «analizar 1.000 documentos una vez cada uno».
| Escenario de negocio | Supuestos principales | Decisions API | Flash-Lite | Ahorro teórico |
|---|---|---|---|---|
| ① Revisar 1.000 reglas en un documento | Documento de 10K tokens, 20 tokens por regla, Flash-Lite genera 20 tokens por regla y ambos se combinan en una sola solicitud | $0.003 | $0.059 | 94,9% |
| ② Clasificar 1.000 mensajes una vez cada uno | 300 tokens por mensaje, 50 tokens para la indicación de decisión, Flash-Lite genera 10 tokens | $0.035 | $0.130 | 73,1% |
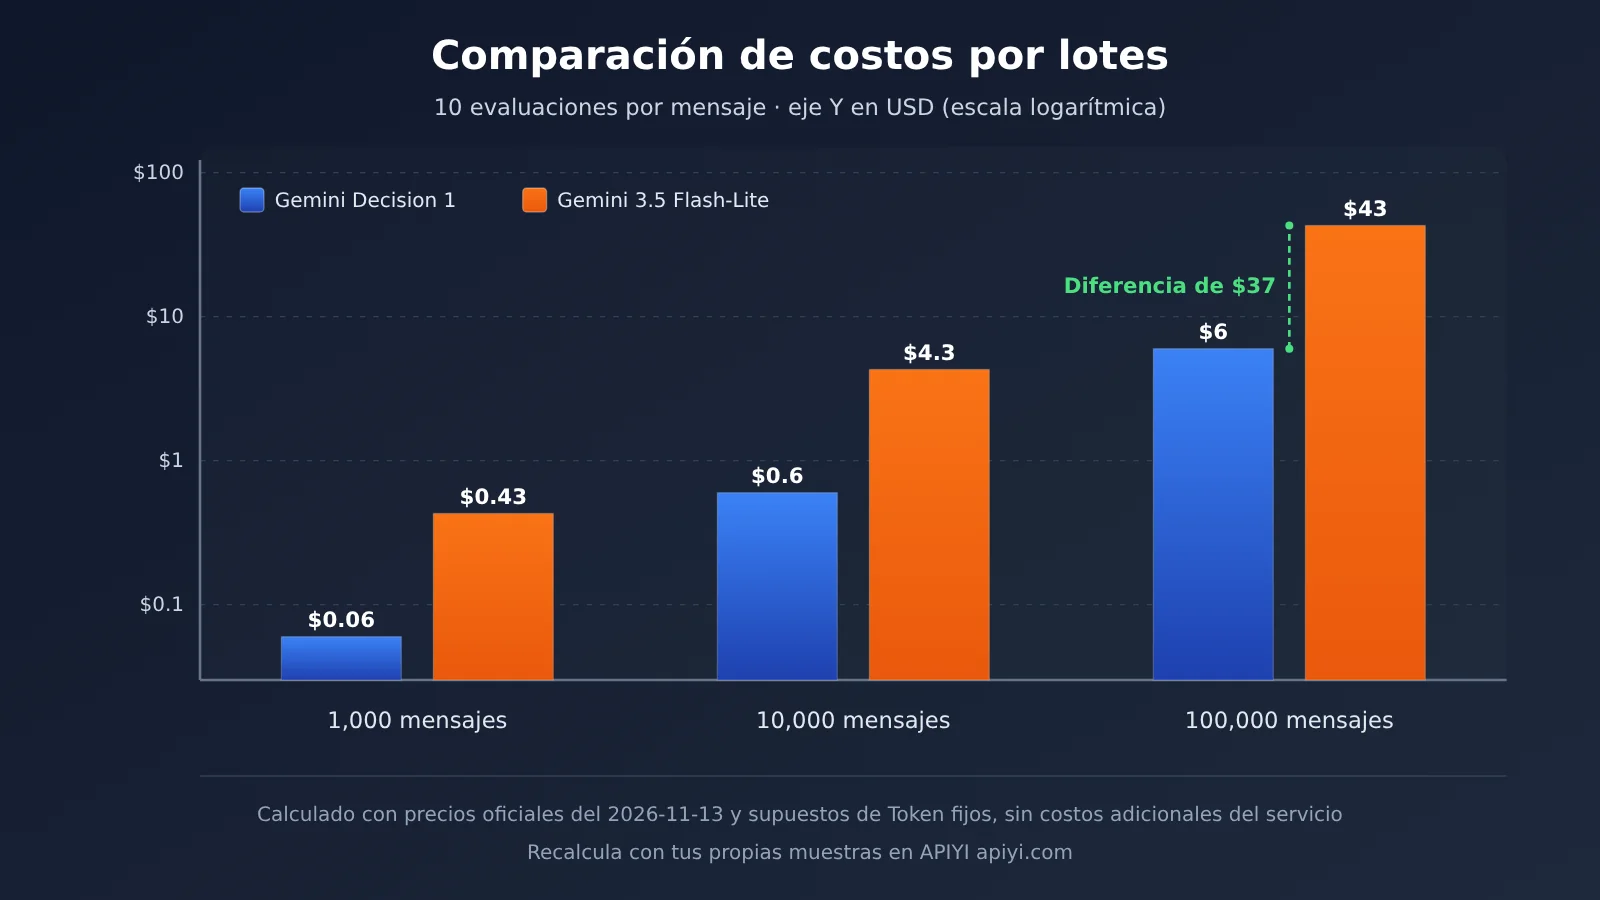
| ③ Hacer 10 decisiones por cada uno de 1.000 mensajes | 300 tokens por mensaje, 30 tokens por decisión, Flash-Lite genera 10 tokens por decisión, una solicitud por mensaje | $0.060 | $0.430 | 86,0% |
Los tres escenarios demuestran dos cosas. En el escenario ②, cada solicitud contiene solo una pregunta y aun así hay un ahorro teórico del 73,1 %, porque el precio unitario de entrada se reduce a un tercio y el costo de salida es cero. Los ahorros de los escenarios ① y ③ son mayores porque la entrada compartida se reparte entre varias preguntas y, al mismo tiempo, Flash-Lite debe generar una salida para cada pregunta.
Si ampliamos la escala con los parámetros del escenario ③: al procesar 100.000 mensajes y un total de 1.000.000 de decisiones, el costo de invocación del modelo con Decisions API es de 6 dólares, frente a 43 dólares con Flash-Lite; la diferencia es de 37 dólares. Esta cifra solo incluye el costo de invocación del modelo y no contempla reintentos, revisión humana tras decisiones erróneas, actualización a un modelo más potente, costos de transmisión y almacenamiento, ni costos de ingeniería y migración.
Si quieres recalcular con muestras de tu propio negocio, puedes pasar primero el mismo lote de datos por un modelo generativo, registrar los tokens de entrada y salida reales y luego introducirlos en las fórmulas anteriores. Con APIYI apiyi.com puedes invocar Gemini, GPT, Claude y otros modelos generativos con una sola clave API, lo que facilita establecer rápidamente esta línea base de costos.
2.3 Por qué el «aproximadamente 5 veces» de Google no es una respuesta universal
Cuando Google lo presentó, anunció que en sus pruebas oficiales el coste de Decision 1 era aproximadamente 1/4.7 del de Gemini 3.5 Flash-Lite. El probador independiente RanThis publicó el 12 de noviembre de 2026 otro conjunto de cifras usando llamadas reales a la API: 100 mensajes en inglés y 20 en vietnamita, con cada solicitud haciendo solo un juicio binario.
- Precisión: de 100 juicios en inglés, Decision 1 acertó 99 y Flash-Lite acertó 98.
- Coste: el coste estimado por cada mil juicios en inglés fue de $0.0113 y $0.0166 respectivamente; Decision 1 es aproximadamente un 32 % más barato, una diferencia de alrededor de 1.5 veces.
- Latencia: la mediana de latencia por solicitud fue de 0.18 segundos y 0.58 segundos respectivamente.
- Consumo de tokens: Decision 1 factura de media unos 113 tokens de entrada por solicitud, mientras que Flash-Lite ronda los 47 tokens de entrada más 1 token de salida.
La razón de la diferencia está clara: el sobrecoste de instrucciones y formato propio de la interfaz Decisions más que duplica los tokens de entrada facturados, lo que anula parte de la ventaja de precio unitario. Cuando la entrada es muy corta, solo se hace una pregunta por vez y el modelo generativo apenas necesita emitir un token, el ahorro es mínimo. Cuando RanThis agrupó las 10 preguntas de un mismo correo en una sola solicitud a Decision 1 y las comparó con 10 solicitudes independientes a Flash-Lite, la diferencia se amplió a unas 5.4 veces; en esa comparación Flash-Lite no hizo la misma agrupación, así que se trata de una comparativa entre formas distintas de plantear las solicitudes.
Por lo tanto, las variables que afectan el ahorro real son: la longitud de la entrada compartida, el número de preguntas por entrada, la longitud de salida del modelo generativo, si ambos lados agrupan solicitudes y el sobrecoste fijo de la propia interfaz. Las deducciones de fórmulas, los benchmarks oficiales y las mediciones de terceros provienen de condiciones distintas, así que conviene evaluarlas por separado a la hora de elegir.
3 Completar 1,000 juicios de una sola vez: ¿para qué tipo de trabajo sirve realmente Decisions API?
3.1 Revisión de documentos: un solo material que cumple múltiples reglas
Donde mejor se aprovecha la ventaja de la entrada compartida es en el formato «material largo + muchas reglas». Un contrato, un pliego de licitación o un manual de producto debe cotejarse punto por punto con una lista de cumplimiento: si incluye cláusulas de incumplimiento, si estipula transferencia de datos al exterior, si el plazo de pago supera los 60 días, si falta la fecha de firma, etc. Cuanto más largo sea el material y más numerosas las reglas, más se diluye la entrada compartida; el 94.9% de ahorro teórico del escenario ① es precisamente el resultado de esta estructura.
Otra ventaja de este tipo de tareas es que los resultados pueden volcarse directamente en una tabla. Cada regla corresponde a un juicio noul, que devuelve probabilidad y confianza; el programa puede marcar «aprobado / rechazado / pendiente de revisión» según los umbrales, y los revisores solo miran las entradas que requieren revisión.
3.2 Enrutamiento de agentes y clasificación de contenido
El agente debe decidir en cada paso cuál será la siguiente acción: si necesita buscar en internet, si debe ejecutar código, si debe pasar la tarea a otra herramienta. Este tipo de juicios tiene opciones fijas, se invoca con frecuencia y es sensible a la latencia, por lo que conviene completarlo de una vez con choice. Los usos internos que Google ha divulgado también se concentran aquí: Gemini Notebook lo utiliza para elegir el modelo y el nivel de pensamiento según la naturaleza de la consulta, reduciendo la latencia de las consultas normales hasta un 40%; Google Search lo usa para hacer comprobaciones de seguridad de las herramientas MCP e identificar contenido adversarial; CC lo emplea para elegir rápidamente una reacción entre más de 200 emojis candidatos. Estos son datos del propio Google; el resultado real para desarrolladores externos depende de la carga de cada uno.
Otro escenario de extensión es el flujo de producción de contenido. Una vez recopilada una noticia de IA, el sistema necesita determinar si es un evento nuevo, si está relacionada con desarrolladores, si toca precios de API, si tiene fuente oficial, si es apta para convertirse en tutorial, y además puntuar el valor del contenido. Estas seis condiciones son independientes entre sí y pueden caber en una sola solicitud a Decisions para completar el filtrado; los temas que pasan el filtro se entregan luego a un modelo generativo para investigar, escribir y pulir. Este es un ejemplo de solución diseñada a partir de las capacidades de la interfaz. En la segunda mitad, la fase de generación puede alternar entre distintos modelos según sea necesario a través de APIYI apiyi.com, comparando la calidad de escritura y el coste.
3.3 Los tres límites de las 1,000 preguntas
- Las preguntas deben ser independientes entre sí. Los juicios dentro de una misma solicitud no pueden leer los resultados de los demás. Los flujos con dependencia de orden, como «primero determinar si es una queja y luego clasificarla por tipo de queja», requieren que el programa combine los resultados y, si hace falta, lance una nueva solicitud.
- 1,000 preguntas comparten un contexto de 262,144 tokens. La entrada compartida y todas las preguntas ocupan conjuntamente esta ventana; cuanto más largas sean las instrucciones de cada pregunta, más corto será el material que cabe.
- Los datos oficiales sobre baja latencia solo cubren solicitudes de pequeña escala. En las pruebas de Google, el rango en el que la latencia se mantiene aproximadamente estable es de 1 a 100 preguntas por solicitud y un contexto de hasta 16K tokens. Con 1,000 preguntas y un contexto cerca de su capacidad máxima, la latencia hay que medirla por cuenta propia.
4. Más allá de ser económico, ¿la precisión y la velocidad de Gemini Decisions API cumplen los requisitos de producción?
4.1 Los datos de velocidad y aplicaciones internas publicados por Google
Google publica que la mediana del tiempo de cómputo del modelo es de 50–100 ms y que la latencia de extremo a extremo es de 150–250 ms; las condiciones de prueba consisten en 1–100 preguntas por vez y un contexto que no supere los 16K tokens. Estos datos indican que es apto para integrarse en cadenas en tiempo real, por ejemplo, en el enrutamiento de cada paso de un Agent o en la clasificación instantánea de mensajes de usuario. La latencia mediana de 0.18 segundos por pregunta medida por RanThis también cae cerca de ese rango.
4.2 Qué nos dicen las evaluaciones de terceros
Los resultados iniciales del Decision Index v2.1 de Artificial Analysis se calculan combinando puntuaciones brutas con tareas reales. Los costes de la siguiente tabla corresponden al coste mixto de las tareas de esta prueba de referencia, que es una métrica distinta del «precio por millón de tokens».
| Modelo de decisión | Puntuación global | Tiempo por tarea | Coste estimado por millón de tareas | Tasa de acierto total en las 15 tareas de AA-Paperclip |
|---|---|---|---|---|
| Drex Max v1.1 | 72.62 | 283 ms | $103 | 63% |
| TypeSafe Jev 1.14 | 66.23 | 92 ms | $156 | 35.5% |
| Gemini Decision 1 | 65.98 | 211 ms | $345 | 33% |
| GPT-6 Luna (Decisions) | 60.25 | 206 ms | $339 | — |
Hay dos informaciones que merecen atención. Primero, el precio por token de Gemini Decision 1 es bajo, pero bajo esta distribución de tareas el coste estimado por millón de tareas es mayor que el de Drex Max y Jev, lo que muestra que la forma de solicitud y la estructura de las tareas cambian la economía final. Segundo, en la prueba de documentos de AA-Paperclip, la proporción de documentos en los que Decision 1 completa de una vez las 15 decisiones y acierta todas es del 33%. Completar múltiples decisiones de una vez ahorra costes, pero la precisión de cada decisión individual aún debe verificarse por separado.
4.3 Usar la confianza para evitar que los errores se ejecuten automáticamente
La confianza es la estimación de probabilidad que el modelo hace sobre su propio resultado, y puede usarse para decidir qué resultados se ejecutan automáticamente y cuáles se derivan a una persona. Al ponerlo en producción, se recomienda combinar tres prácticas:
- Establecer umbrales de confianza: por ejemplo, cuando la confianza de una decisión de reembolso sea inferior a 0.85, derivarla a revisión humana; solo por encima del umbral se etiqueta o se asigna automáticamente.
- Añadir una opción «other» a choice: cuando ninguna opción encaje, el modelo seguirá eligiendo una de ellas; añadir «otro / no puedo determinar» frena parte de las entradas fuera de rango, y también se puede agregar un
noulpor separado para comprobar el alcance. - Mantener restricciones de código para operaciones de alto riesgo: acciones como el importe de reembolso, el bloqueo de cuentas o la interceptación por cumplimiento normativo deben contar, además del juicio del modelo, con reglas codificadas y revisión humana.
5 ¿Cómo deben los desarrolladores usar y seleccionar la API Gemini Decisions?
5.1 Cómo realizar la primera solicitud
La documentación oficial requiere el SDK google-genai 3.2 de Python o una versión posterior; también admite el SDK de JavaScript y REST. Para integrarlo se necesita una clave API de Google AI Studio. El siguiente ejemplo se ha preparado según la estructura del SDK oficial: hace al mismo tiempo un juicio binario y un juicio de clasificación sobre la misma noticia. No se ha verificado con llamadas reales en este artículo, así que los nombres de los campos deben consultarse en la guía oficial para desarrolladores.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    # input: entrada compartida por todas las preguntas; solo se factura una vez
    input="Google released a new AI API with official pricing and developer documentation.",
    # questions: juicios independientes entre sí; el nombre de la clave es el ID de la pregunta
    questions={
        "has_api_pricing": {
            "type": "noul",
            "instructions": "Does this news mention API pricing?",
        },
        "category": {
            "type": "choice",
            "instructions": "Which news category fits best?",
            "criteria": {
                "model": "An AI model launch",
                "api": "An API or developer tool",
                "business": "Business or finance news",
            },
        },
    },
)

print(result.answers)  # resultado de cada pregunta, probabilidad de cada opción y confianza
print(result.usage)    # uso de tokens facturables; esta es la base para el cálculo de costos
La función de los cuatro campos clave es la siguiente: input contiene el contenido compartido; questions contiene las preguntas independientes (para la forma de escribir la definición de niveles del tipo score, consulta la guía oficial); answers devuelve los resultados de los juicios y las probabilidades; usage devuelve los tokens facturables. Al calcular costos, asegúrate de usar los valores reales de usage; la sección 2.3 ya explica que el costo fijo de la interfaz afecta significativamente el costo por pregunta.
Para comparar costos, también se necesita una línea base con un modelo generativo. A continuación, usamos la interfaz compatible con OpenAI a través de APIYI para llamar a Flash-Lite y realizar la misma clasificación, registrando el uso de tokens:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="gemini-3.5-flash-lite",  # Usa el nombre real de la lista de modelos de la plataforma
    messages=[{
        "role": "user",
        "content": "News: Google released a new AI API with official pricing.\n"
                   "Q1 mentions API pricing? Answer yes/no.\n"
                   "Q2 category: model/api/business. Answer one word each line."
    }],
    max_tokens=10,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Tokens de entrada y salida, para sustituirlos en la fórmula de la sección 2.1
Ver el script de comparación por lotes: calcular por separado el costo de las dos interfaces con el mismo lote de muestras
import openai

PRICE_IN, PRICE_OUT = 0.30, 2.50   # Precio estándar oficial de Flash-Lite, USD por millón de tokens
DECISION_IN = 0.10                 # Precio de entrada de Decision 1; la salida no se factura

gen_client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def flash_lite_cost(samples, questions, model="gemini-3.5-flash-lite"):
    """Combina todas las preguntas de cada muestra en una sola solicitud generativa y acumula el costo real facturado"""
    total = 0.0
    for text in samples:
        prompt = text + "\n" + "\n".join(
            f"Q{i+1}: {q} Answer briefly." for i, q in enumerate(questions)
        )
        r = gen_client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": prompt}],
            max_tokens=10 * len(questions),
        )
        total += (r.usage.prompt_tokens * PRICE_IN
                  + r.usage.completion_tokens * PRICE_OUT) / 1_000_000
    return total

def decision_cost(usage_input_tokens_list):
    """Recibe los tokens de entrada de usage que devuelve la API Decisions en cada llamada y calcula el costo total"""
    return sum(t * DECISION_IN for t in usage_input_tokens_list) / 1_000_000
🚀 Consejo para empezar rápido: seleccione primero entre 200 y 500 muestras reales de negocio, ejecute modelos generativos para obtener la precisión de referencia y el consumo de tokens, y luego compárelos con
usagede Decisions API. APIYI apiyi.com ofrece una interfaz compatible con OpenAI y crédito de prueba gratuito para nuevos usuarios, ideal para completar rápidamente esta prueba de referencia.
5.2 Cuándo elegir Decisions API y cuándo seguir usando modelos generativos
| Tipo de tarea | Solución recomendada | Motivo |
|---|---|---|
| Auditar un mismo documento largo contra varias reglas | Decisions API | La entrada compartida amortiza el costo y las evaluaciones son independientes entre sí |
| Enrutamiento de herramientas para agentes y selección de modelo | Decisions API | Opciones fijas y baja latencia |
| Revisión de seguridad de contenido y de infracciones | Decisions API | Múltiples condiciones noul independientes; permite enrutar según la confianza |
| Clasificación de tickets de atención al cliente y etiquetas de posventa de comercio electrónico | Decisions API | Conjunto de etiquetas fijo |
| Filtrado de temas y puntuación de prioridad de leads | Decisions API | Adecuado para el score de una escala predefinida |
| Resúmenes, reescritura y redacción | Modelos generativos | Requieren generar lenguaje natural |
| Investigación compleja, argumentación y propuesta de nuevas ideas | Modelos generativos | Requieren razonamiento abierto |
| Flujos donde los juicios tienen dependencias secuenciales | Orquestación programática + varias solicitudes, o modelos generativos | Las preguntas dentro de una misma solicitud no pueden referenciarse entre sí |
La salida estructurada de los modelos generativos (JSON Schema) también puede restringir las respuestas a un formato fijo, pero estos siguen generando contenido token por token y cobran por la salida; las probabilidades requieren procesamiento adicional para obtenerse. Decisions API devuelve directamente la probabilidad y la confianza de cada opción, y la salida no se cobra; el precio a pagar es que solo puede responder preguntas con opciones predefinidas.
5.3 ¿Qué otros costos hay que calcular antes de salir a producción?
Además del precio unitario, los siguientes factores inciden directamente en el «costo total por cada decisión correcta»:
- Consumo real de tokens: tómalo como referencia en
usage; en escenarios de una sola pregunta con entradas cortas, el costo fijo es el que más pesa. - Límites de solicitudes: la capa gratuita es de 200 RPM, 50,000 TPM y 10,000 RPD; el Tier 1 de pago es de 1,500 RPM, 1 millón de TPM y 50,000 RPD. Las solicitudes con contexto largo suelen activar primero el límite de TPM.
- Falta de caché y procesamiento por lotes: no admite Context Caching, Batch API ni inferencia Flex/Priority, así que al reutilizar el mismo documento largo no se puede aprovechar el descuento de caché.
- Restricciones funcionales: no se puede incluir contenido multimedia en la instrucción de la pregunta, ni pasar directamente el historial completo de la conversación, el razonamiento (thinking) o bloques de llamadas a herramientas; las conversaciones multiturno deben organizarse primero como entrada de texto.
- Errores de juicio y revisión manual: la proporción de casos derivados a revisión humana por baja confianza y el costo de retrabajo tras un error deben imputarse al costo unitario.
- Condiciones de tratamiento de datos: los datos usados en la capa gratuita pueden aprovecharse para mejorar productos de Google; la tabla de precios oficial indica que la capa de pago no se usa con ese fin. Antes de procesar documentos de clientes, confirma qué capa estás usando.
- Reingeniería: convertir las indicaciones generativas en preguntas de tipo noul / choice / score, y establecer umbrales y lógica de fallback, exige inversión en desarrollo.
Si planeas conectarte a través de una plataforma de API de terceros, necesitas confirmar si admite el endpoint dedicado /v1beta/decisions; las plataformas que solo admiten Chat Completions no pueden llamar directamente a Decisions API. Antes de usar APIYI apiyi.com, puedes consultar la lista de modelos y endpoints en el centro de documentación, o ponerte en contacto con la plataforma para confirmar la compatibilidad.
6 Conclusión: las tareas de clasificación, moderación y enrutamiento pueden delegarse a Gemini Decisions API
Volviendo a la pregunta del título, hay tres conclusiones:
- Las tareas con opciones fijas merecen prioridad con Decisions API. Según los precios públicos, la clasificación de una sola pregunta ahorraría teóricamente alrededor del 73%, y la revisión de mil reglas sobre un mismo documento largo ahorraría cerca del 95%; las pruebas independientes de terceros con una sola pregunta muestran una ventaja de aproximadamente el 32%.
- «Una entrada, varias preguntas independientes» es la estructura con mayor potencial de ahorro. La entrada compartida se factura una sola vez: cuanto más numerosas sean las preguntas, más largo el input y más extensa la salida del modelo generativo, mayor será la diferencia.
- La métrica final es el coste total por cada decisión correcta en producción. El precio unitario de los tokens y el límite de 1.000 preguntas son solo el punto de partida; la precisión, la proporción de intervención humana tras el enrutamiento por confianza, las cuotas y el coste de ingeniería determinan conjuntamente el beneficio real.
El camino más prudente es: primero obtener una línea base con el modelo generativo usando muestras reales, luego comparar usage y precisión en Decisions API, y diseñar por separado la capa de decisión y la capa de generación. La selección de modelo y la comparación de costes en la capa de generación se pueden realizar a través de APIYI apiyi.com con una interfaz unificada.
📚 Referencias
- Guía para desarrolladores y tabla de precios de Google Gemini Decisions API: capacidades de la interfaz, límites, cuotas y precios oficiales.
- Enlace:
ai.google.dev -
Descripción: ID del modelo, tipos de pregunta, ventana de contexto, límites de velocidad y uso del SDK.
-
Artículo publicado en el blog oficial de Google: fecha de publicación, datos de latencia y casos de uso internos.
- Enlace:
blog.google -
Descripción: 50–100 ms de tiempo de cómputo, ventaja de coste de aproximadamente 4,7 veces, casos como Gemini Notebook, etc.
-
Endpoint REST de Gemini Decisions API
- Enlace:
generativelanguage.googleapis.com/v1beta/decisions -
Descripción: endpoint oficial para llamadas mediante REST.
-
Artificial Analysis Decision Index v2.1: evaluación de terceros de modelos de decisión.
- Enlace:
artificialanalysis.ai -
Descripción: puntuación global, tiempo por tarea, coste por millón de tareas y tasa de acierto total de AA-Paperclip.
-
Prueba independiente de RanThis (2026-11-12): prueba a pequeña escala basada en llamadas reales.
- Descripción: comparación de coste por pregunta, latencia y consumo de tokens, así como resultados de solicitudes combinadas con varias preguntas.
Autor: equipo técnico de APIYI
Contacto técnico: escríbenos desde la página principal de APIYI apiyi.com; para más material de integración, visita el centro de documentación docs.apiyi.com