Nota del autor: El 2 de noviembre de 2026, OpenAI dio a conocer Pando, su backend interno de Git. A partir del hecho de que llegó a producción en 10 semanas, este artículo analiza el reparto de tareas entre personas y agentes, el sistema de pruebas y el proceso de migración, y reúne prácticas de ingeniería con agentes que otros equipos pueden aprovechar.
El 2 de noviembre de 2026, OpenAI publicó el artículo técnico «Scaling Git at OpenAI», en el que presentó el nuevo backend de Git que sostiene toda la actividad de desarrollo de su monorrepositorio: Pando. Desde su inicio hasta que empezó a recibir tráfico de producción pasaron unas 10 semanas; un ingeniero diseñó la arquitectura principal, varios equipos de agentes se encargaron de la implementación y un pequeño grupo de ingenieros realizó el despliegue. Es fácil convertir estos hechos en una historia sobre «una persona que dirigió a la IA para construir infraestructura», pero los detalles publicados por OpenAI muestran que lo que realmente funcionó fue todo un sistema de restricciones y validación de ingeniería.
Este artículo no repite un mito sobre la programación con IA. A partir de la información oficial de OpenAI, distingue entre los hechos publicados y los datos que aún no se conocen. Por ejemplo, no se han divulgado el tamaño del equipo, el costo en tokens, los registros de tareas ni la proporción de código modificado por personas.
Qué aprenderás: por qué se creó Pando, de qué se encargaron concretamente los equipos de agentes Codex, qué mecanismos de validación permitieron que los agentes participaran en el desarrollo de infraestructura y cómo aplicar este enfoque a tus propios proyectos.
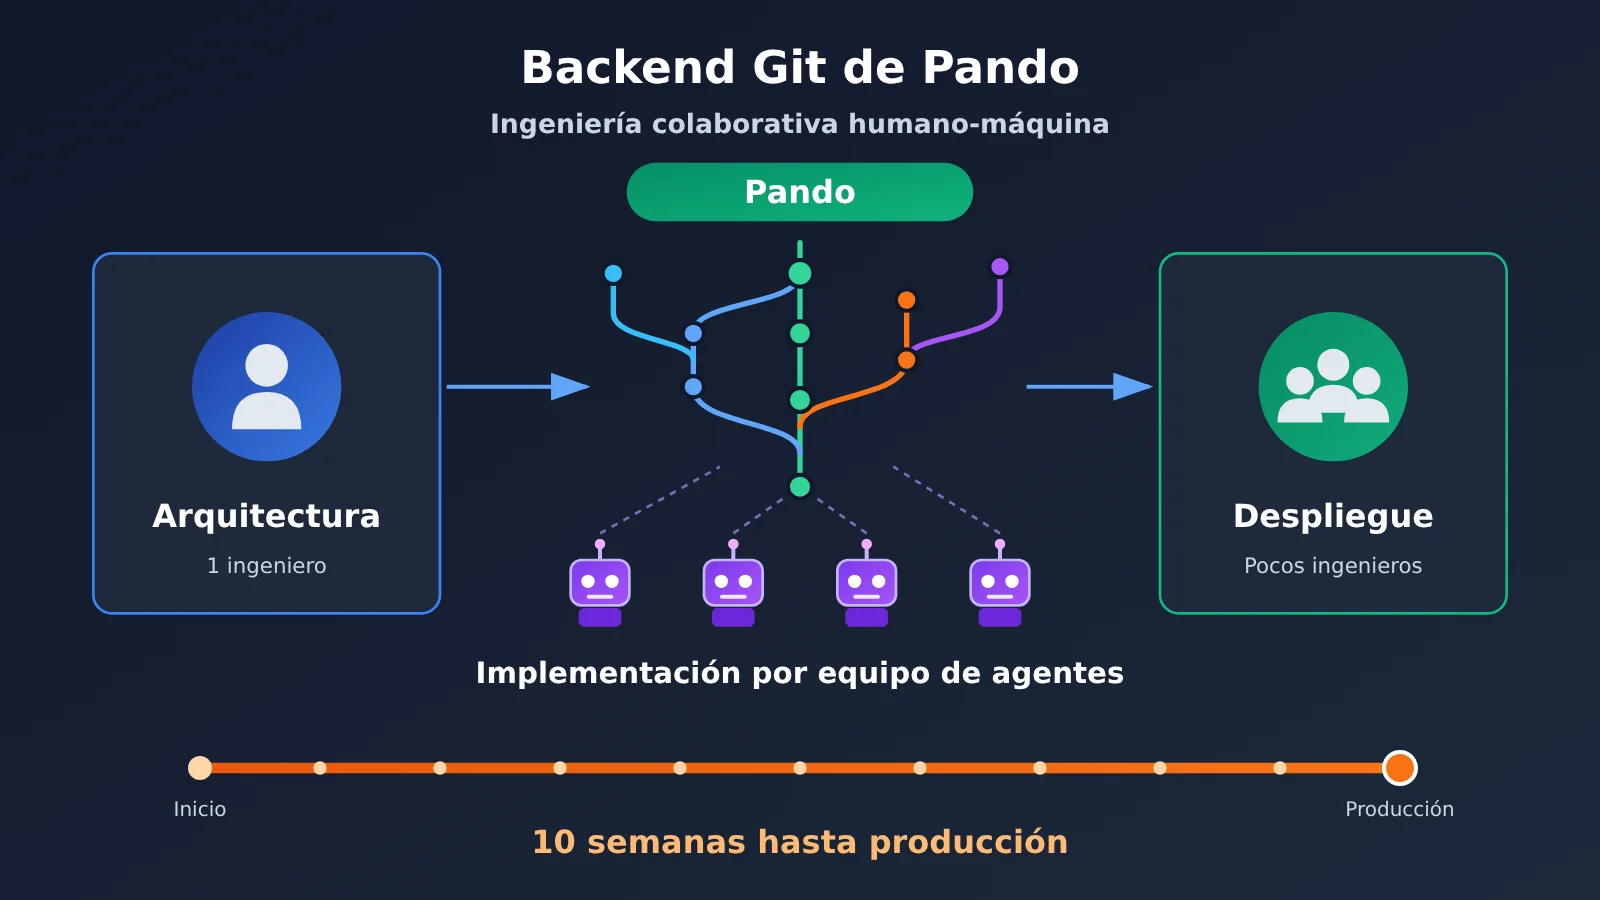
Pando de un vistazo: ¿qué entregaron los equipos de agentes de Codex?
Empecemos con una tabla que resume la información confirmada oficialmente. Hay un matiz importante: Pando es un backend de servidor compatible con Git, no un nuevo protocolo de control de versiones ni un sustituto directo de GitHub.
| Dato | Detalle |
|---|---|
| Fecha de publicación | 2 de noviembre de 2026, artículo oficial «Scaling Git at OpenAI» |
| Autores | Aaron Friel, Taylor Blau y Ted Nyman (personal técnico de OpenAI) |
| Duración del proyecto | Unas 10 semanas desde el inicio hasta su puesta en producción; empezó a gestionar tráfico de producción en abril de 2026 |
| Lenguaje de implementación | El servidor se desarrolló desde cero principalmente en Rust, evitando deliberadamente heredar dependencias del sistema anterior |
| Reparto del trabajo | Un ingeniero diseñó la arquitectura principal, varios equipos de agentes la implementaron y un pequeño grupo de ingenieros la desplegó |
| Resultados en producción | La latencia mediana de Push se redujo casi un 80% y se entregan cerca de 1 PB de datos Git al día |
| Disponibilidad | Al 2026-11-03, no se había publicado un servidor ni una API de acceso público, ni tampoco precios |
Por qué OpenAI necesitaba reconstruir el backend de Git con agentes de Codex
Pando surgió a raíz del crecimiento explosivo del volumen de commits. El gráfico oficial toma como referencia el número de commits fusionados en la rama principal durante el primer trimestre de 2024 y muestra su crecimiento en los trimestres posteriores. Esta tabla recoge algunos puntos clave.
| Trimestre | Crecimiento de commits respecto a 2024 Q1 | Detalle |
|---|---|---|
| 2024 Q4 | +98% | Casi el doble |
| 2025 Q4 | +264% | El sistema anterior empezó a tener dificultades para seguir el ritmo de la demanda |
| 2026 Q1 | +432% | Fase de desarrollo de Pando |
| 2026 Q3 | +1,378% | Aproximadamente 14.78 veces el valor del período base |
| 2026 Q4 | +2,442% | Pronóstico oficial, no resultado real de un trimestre completado |
Hay una distinción que conviene mantener: el número de commits no equivale al número de líneas de código, al número de PR ni a la productividad del desarrollo. Por eso no se puede afirmar que «la cantidad de código se multiplicó por 25» o que «Codex hizo que los ingenieros fueran 25 veces más productivos». Según la explicación de OpenAI, Codex permite a los ingenieros avanzar en más tareas al mismo tiempo, lo que a su vez genera más ramas paralelas, operaciones Push, fusiones, trabajos de CI y solicitudes Fetch y Clone.
Hacia el cuarto trimestre de 2025, el sistema anterior empezó a sufrir lentitud en las operaciones Push y Fetch y fallos en las fusiones. En ocasiones, su fiabilidad caía por debajo del 90%. OpenAI no ha publicado cómo se calculó ese indicador ni su evolución temporal, por lo que tampoco puede interpretarse como que «más del 10% de los commits fallaban».
Los 4 diseños clave de la arquitectura técnica de Pando
Pando no abandonó Git: rediseñó el almacenamiento, la actualización de referencias y la entrega de datos en el backend. Entender estas decisiones ayuda a ver con claridad «qué concesiones irremplazables hicieron las personas».
- Actualización independiente de ramas: en lugar de mantener una única instantánea consistente de todo el repositorio en un momento dado, cada rama conserva su propia versión. Solo es necesario coordinar las solicitudes que modifican el mismo Ref, siguiendo un modelo de consistencia causal. La contrapartida es que, al leer varias ramas a la vez, estas pueden corresponder a momentos distintos.
- Almacenamiento y reutilización de Packfile: cada Packfile recibido en un Push se escribe como dato inmutable en Blob Store. Durante un Fetch, se seleccionan Packfile existentes según los have/want del cliente y se entregan las direcciones de descarga mediante el mecanismo packfile-uri de Git. Así se evita empaquetar y comprimir de nuevo para cada cliente.
- Caché regional Express: se despliegan clústeres y cachés locales en varias regiones, y las solicitudes se distribuyen mediante hashing consistente. La tasa de aciertos de la caché de Packfile supera el 99 %. Esta es una caché de datos de Git; no es lo mismo que Prompt Caching en una API de un Modelo de Lenguaje Grande.
- Compaction por niveles en segundo plano: de forma similar a un LSM Tree, los Packfile pequeños se combinan progresivamente en conjuntos mayores que cubren intervalos continuos de versiones. El monorepositorio actual utiliza hasta el nivel L4.
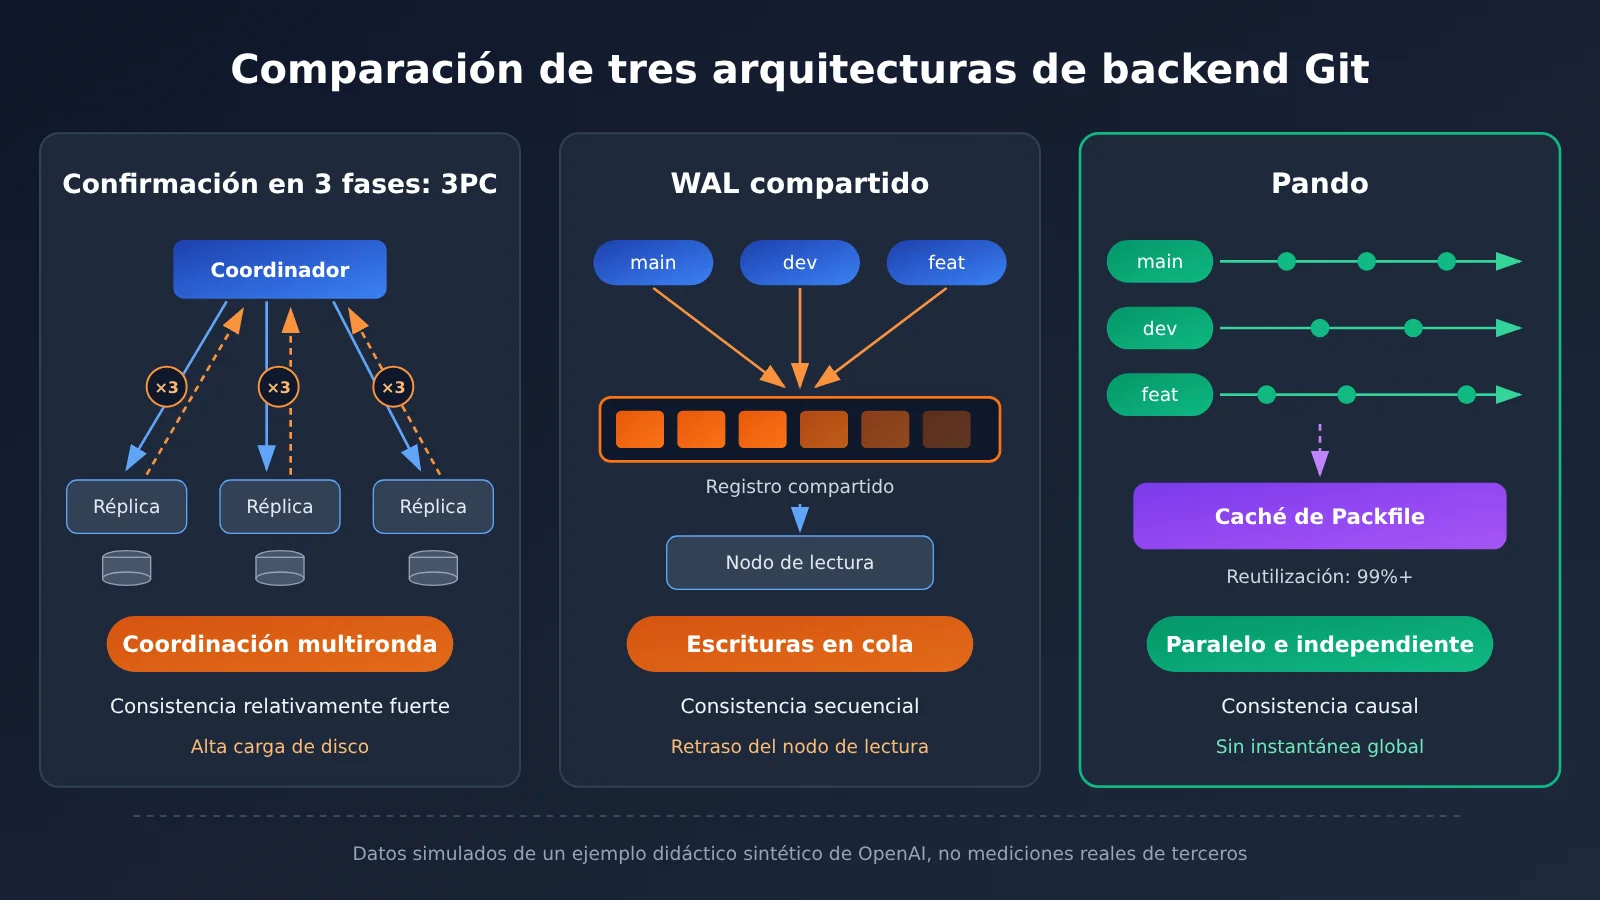
El equipo también comparó tres tipos de arquitectura y realizó una simulación con 1,000 clientes y un total de 10,000 Push. Es una simulación didáctica sintética creada por OpenAI, no una prueba de rendimiento independiente de terceros.
| Arquitectura | Forma de escritura | Consistencia | Principal cuello de botella |
|---|---|---|---|
| Confirmación en tres fases 3PC | Varias réplicas completas coordinan las escrituras | Relativamente fuerte | Las múltiples rondas de coordinación y la carga de disco ralentizan las escrituras concurrentes |
| WAL compartido | Todas las actualizaciones compiten por el mismo registro | Consistencia secuencial | Los nodos de lectura se retrasan cuando las escrituras llegan más rápido de lo que pueden aplicarse |
| Pando | Transacciones atómicas independientes para cada Ref | Consistencia causal | Se renuncia a una instantánea de todo el repositorio en un mismo momento |
Los datos de producción publicados también incluyen: un pico de entrega de Packfile superior a 57 TB en una sola hora, con más del 99 % de los bytes procedentes de la caché de disco local; Clone y Fetch capaces de aprovechar al máximo un enlace de 10 Gbps en máquinas virtuales estándar en la nube; lecturas y escrituras de metadatos de Push de O(1), y lecturas de metadatos para planificar Fetch de O(log Δ). Estas complejidades describen operaciones de metadatos, no el tiempo de red de extremo a extremo.
Cómo se repartió el trabajo el equipo de agentes Codex para crear Pando
Que «un ingeniero diseñara el núcleo» no significa que trabajara solo en el proyecto, ni que «un equipo de agentes lo implementara» implica que la IA escribiera cada línea de código. Según el alcance del trabajo divulgado oficialmente, podemos resumir el reparto de tareas así, aunque OpenAI no ha publicado una lista concreta de tareas para cada agente.
| Rol | Trabajo realizado | Por qué se asignó a este rol |
|---|---|---|
| Ingeniero de arquitectura (humano) | Identificar los cuellos de botella del sistema anterior, mantener la compatibilidad con el protocolo Git, elegir actualizaciones independientes por rama y la reutilización de Packfiles, y descartar la consistencia fuerte en todo el repositorio | Son decisiones técnicas difíciles de revertir que definen los límites del sistema |
| Equipo de agentes, incluido Codex | Implementar el backend en Rust, garantizar la compatibilidad con los protocolos Push/Fetch, gestionar escrituras concurrentes, optimizar el rendimiento y corregir casos límite | El volumen de implementación es grande y los resultados pueden verificarse repetidamente con pruebas, lo que favorece la iteración en paralelo |
| Agentes de validación | Ejecutar sesiones prolongadas para detectar casos límite y usar modelos con capacidades de Daybreak para realizar pruebas adversariales de forma continua | Es un trabajo constante que a las personas les resultaría difícil mantener con la misma frecuencia |
| Ingeniero de despliegue (humano) | Redirigir el tráfico de forma gradual, sincronizar los sistemas antiguo y nuevo, y migrar cientos de integraciones | Los riesgos en producción y la coordinación entre equipos requieren responsabilidad humana |
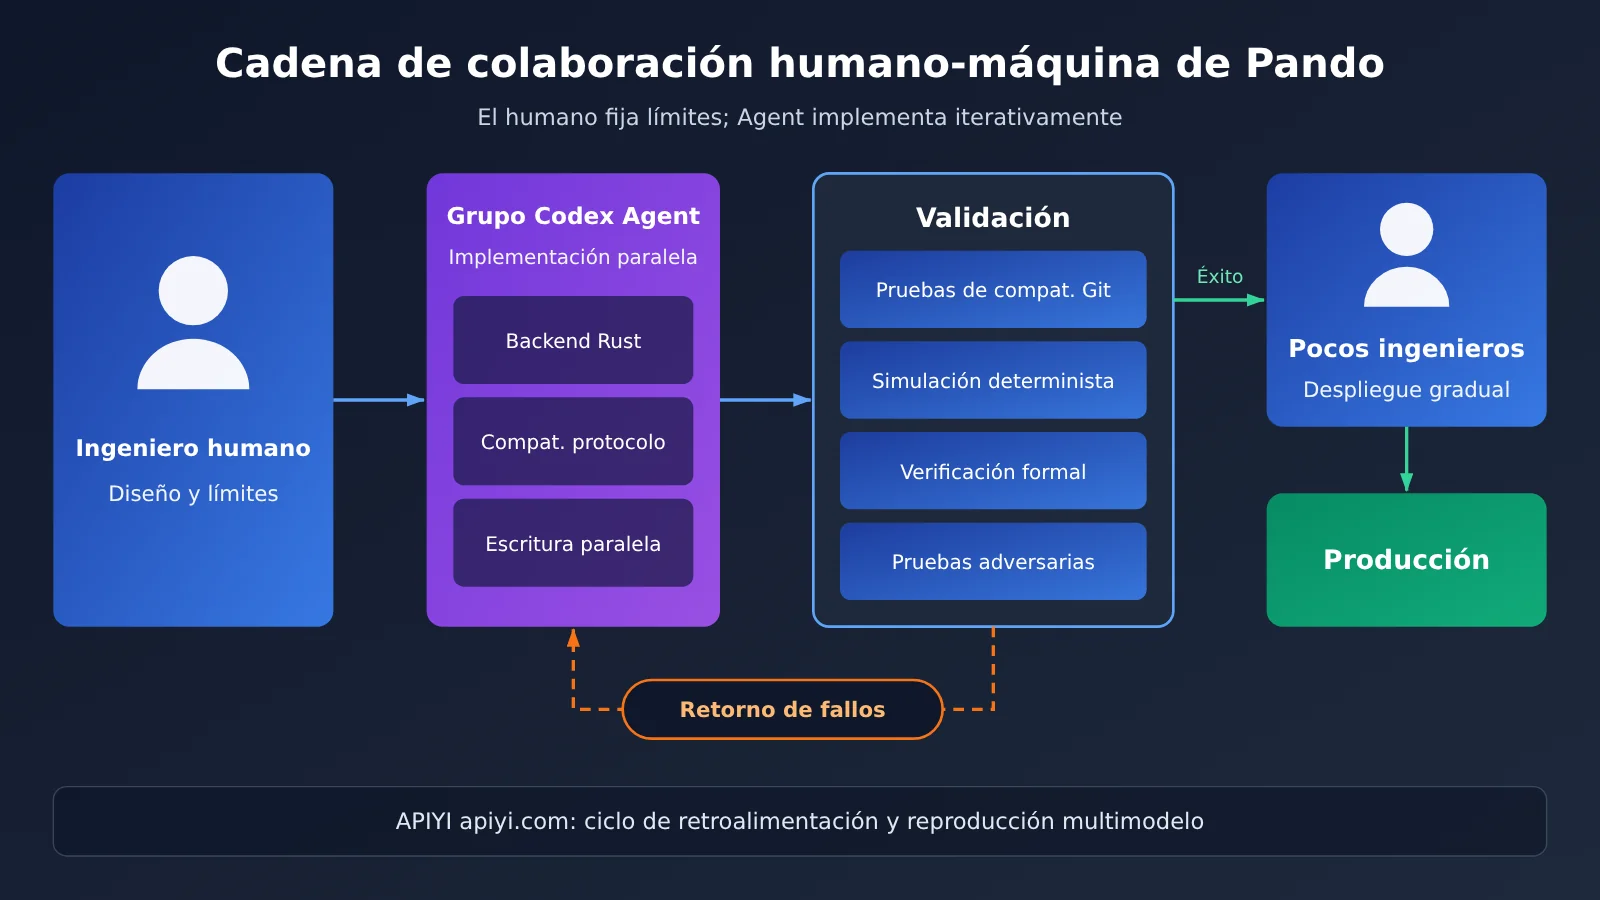
La idea central de esta tabla es que las personas definen la arquitectura, las restricciones y los criterios de aceptación; los agentes se encargan de buena parte de la implementación y la iteración; y los ingenieros responden por la migración a producción y la fiabilidad del sistema. OpenAI no proporcionó un grupo de control con desarrollo humano, por lo que no se puede calcular cuántas veces aceleró Codex este proyecto.
El sistema de pruebas de Pando: por qué Codex Agent puede participar en el desarrollo de infraestructura
Pando es software de infraestructura: si algo falla, puede que una rama no apunte al commit correcto, que un Push pierda objetos o que un Fetch no recupere el historial completo. Si una página web falla, a menudo basta con recargarla; si falla un backend de Git, el desarrollo de toda una empresa puede detenerse. Por eso, OpenAI no equipó al Agent con indicaciones más largas, sino con un sistema de verificación ejecutable.
Pruebas de compatibilidad con Git: importa el comportamiento, no solo la compilación
OpenAI creó la Git Conformance Test Suite para que el Agent pueda comprobar por sí mismo, después de modificar la implementación del servidor, si su comportamiento coincide con lo que se espera de Git estándar. Las pruebas abarcan la actualización de referencias, Push, Fetch, la transferencia de Packfiles y la compatibilidad de protocolos. La clave es que el criterio sea «comportarse como Git», y no solo «compilar y superar las pruebas unitarias». OpenAI no ha publicado el número de casos de prueba.
Simulación determinista de concurrencia: hacer reproducibles las condiciones de carrera
Los errores más difíciles de los sistemas distribuidos suelen aparecer cuando varias operaciones se intercalan. OpenAI utiliza Deterministic Simulation Harnesses para simular de forma reproducible los estados del sistema y los eventos concurrentes. Esto ayuda a detectar condiciones de carrera, problemas de negociación de Git, errores en la planificación de Packfiles y regresiones.
Por ejemplo, si dos Agents modifican la misma rama al mismo tiempo, dos actualizaciones incompatibles no pueden darse ambas por exitosas. Además, antes de actualizar el puntero de una rama, el nuevo objeto de commit ya debe poder leerse. Estos ejemplos explican los objetivos de las pruebas; no son casos que OpenAI haya publicado de forma individual.
Verificación formal con Lean y TLA+: atención a la cronología
OpenAI indicó que utilizó GPT-6 Astra para ayudar a los Agents a escribir especificaciones formales en Lean y TLA+, dando forma a la llamada «Theory of Pando». Estas especificaciones sirven para comprobar invariantes, detectar y corregir errores, y demostrar propiedades concretas. Hay dos límites importantes: primero, se verifican propiedades específicas, lo que no significa que se hayan demostrado matemáticamente todas las rutas de ejecución del sistema; segundo, OpenAI señala que los nuevos modelos se han ido utilizando de forma continua para mejorar el rendimiento y la fiabilidad a medida que aparecían. Por tanto, no se pueden atribuir todas estas prácticas a las primeras 10 semanas.
Sesiones prolongadas de Agents y pruebas de seguridad adversariales
OpenAI también señaló que varias sesiones consecutivas de Agents se prolongaron durante cientos de horas para buscar y corregir casos límite, mientras que modelos con capacidades de Daybreak realizaron pruebas adversariales continuas contra Git y Pando. La empresa no ha publicado el número de Agents, la duración de cada sesión, el consumo de tokens, la cantidad de bugs corregidos ni la frecuencia de supervisión humana. Por eso, no se puede concluir que «un Agent escribiera código sin supervisión durante cientos de horas seguidas». Lo interesante es el cambio de enfoque: los Agents se utilizan para verificar de forma continua, no solo para generar código inicialmente.
El fork de Git publicado por OpenAI también ofrece indicios de esa mejora continua. Por ejemplo, incluye parches para el cálculo paralelo de hashes en index-pack en agosto de 2026, y para los reintentos ante límites de tasa y la reutilización de Packs completados en octubre. Sin embargo, todos esos commits son posteriores a la primera puesta en producción, en abril de 2026, por lo que tampoco pueden contarse como entregables de las primeras 10 semanas.
Migración gradual a Pando: que Codex Agent termine el código no significa que esté listo para producción
Las 10 semanas abarcan desde el inicio hasta la puesta en producción, no todo el tiempo necesario para que el sistema alcance su plena madurez. El despliegue de Pando siguió un enfoque clásico de «migración gradual sin tiempo de inactividad». Según la información oficial, el proceso fue aproximadamente así:
- Se colocó Pando delante del sistema anterior como proxy de lectura y escritura, manteniendo sincronizados ambos sistemas backend.
- Se agruparon las solicitudes idénticas y se almacenaron en caché los datos de Git para las solicitudes reales. Al migrar parte del tráfico, incluso se redujo la carga del sistema anterior.
- Se migraron los clientes de desarrollo por lotes mediante un wrapper interno de la CLI de Git.
- Se migraron cientos de integraciones que dependían de la API anterior, los webhooks y los métodos de descarga de repositorios, además de los flujos de trabajo de Review y Change Request.
- Se ofrecieron Codex Skills para la migración, de modo que los desarrolladores pudieran pedirle directamente a Codex ayuda para preparar sus repositorios locales y el entorno de migración.
- Se desplegó una versión mejorada del cliente Git en los dispositivos de los ingenieros y en la aplicación de escritorio de ChatGPT.
Según la información oficial, toda la migración se realizó sin interrumpir el desarrollo de ingeniería, aunque no se publicaron la tasa de reversiones, la distribución de incidencias ni los casos de fallo. Para quienes lideran equipos técnicos, esta parte merece más atención que las «10 semanas»: mantener la compatibilidad con los flujos de trabajo anteriores, migrar las integraciones y desviar el tráfico por lotes suele ser tan complejo como desarrollar el nuevo sistema.
Análisis del impacto de Pando: qué significa para desarrolladores de agentes y equipos técnicos
Impacto para desarrolladores de agentes
- La capacidad de verificación determina el límite de lo que puede hacer un agente: Pando permite que los agentes participen en la implementación de componentes centrales, siempre que existan pruebas de compatibilidad, simulaciones deterministas y descripciones formales que les proporcionen información fiable sobre los resultados.
- El papel de los agentes se está ampliando: ya no se limita a escribir código, sino que también incluye buscar continuamente casos límite, realizar pruebas adversariales y ayudar a los usuarios con la migración.
Impacto para responsables técnicos
- El desarrollo con IA aumentará la carga en las etapas posteriores: el crecimiento de los commits repercutirá en la integración continua (CI), la revisión de código y el alojamiento de repositorios. En otra publicación de julio de 2026, OpenAI señaló que el número semanal de PR internos se había más que duplicado respecto al cuarto trimestre anterior y que la revisión de código se había convertido en uno de los nuevos cuellos de botella.
- No hace falta construir una versión propia de Pando sin más: los problemas de escala de los grandes monorepos no surgieron con la era de la IA, y la gran mayoría de los equipos no necesita reconstruir el backend de Git.
Comparación con el caso de Harness Engineering
En febrero de 2026, OpenAI presentó otro proyecto independiente: partiendo de un repositorio vacío, Codex escribió el código del producto y, en unos cinco meses, generó alrededor de un millón de líneas de código y unos 1.500 PR. Al principio, el proyecto estuvo a cargo de tres ingenieros. No se trata del mismo equipo ni del mismo proceso que en Pando, por lo que no se deben mezclar sus datos. Aun así, ambos apuntan a una misma tendencia: los ingenieros se encargan cada vez más del diseño de sistemas, los entornos de prueba y los flujos de trabajo de los agentes. Entre las lecciones del proyecto están dividir el trabajo en tareas pequeñas, proporcionar un entorno de ejecución independiente para cada rama, dar a los agentes acceso a registros y métricas, y usar AGENTS.md para orientarlos en lugar de meter toda la base de conocimiento en la indicación.
En Hacker News también hay opiniones contrapuestas: quienes cuestionan estos avances sostienen que un aumento de commits no equivale a una mejora de la calidad; quienes los apoyan creen que la reducción del costo de escribir código hace viables más proyectos pequeños. Son opiniones de la comunidad, no conclusiones estadísticas.
Cómo aprovechar el método del equipo de Codex Agent: un ciclo de retroalimentación basado en pruebas
Lo más fácil de trasladar de Pando a otros proyectos no es su escala, sino la estructura que permite a los agentes recibir resultados verificables. Este es un ciclo mínimo basado en pruebas: el modelo genera un parche y recibe los resultados de las pruebas para seguir corrigiéndolo.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz de APIYI compatible con OpenAI
)

resp = client.chat.completions.create(
    model="YOUR_CODING_MODEL",  # Sustituye por el modelo de programación que quieras probar
    messages=[{"role": "user", "content": "根据以下失败测试修复函数:..."}]
)
print(resp.choices[0].message.content)
Ver la implementación completa del ciclo de retroalimentación de pruebas
import subprocess
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

SYSTEM = (
    "你是严格遵守约束的工程 Agent。"
    "只修改指定文件,不得改动测试;输出完整的新文件内容。"
)

def run_tests() -> tuple[bool, str]:
    """Ejecuta la verificación, equivalente a las pruebas de compatibilidad de Pando"""
    r = subprocess.run(["pytest", "-q", "tests/"], capture_output=True, text=True)
    return r.returncode == 0, r.stdout[-3000:] + r.stderr[-1000:]

def agent_loop(target: str, spec: str, max_rounds: int = 5) -> bool:
    for i in range(max_rounds):
        ok, log = run_tests()
        if ok:
            print(f"第 {i} 轮:测试全部通过,等待人工审核")
            return True
        source = open(target, encoding="utf-8").read()
        resp = client.chat.completions.create(
            model="YOUR_CODING_MODEL",
            messages=[
                {"role": "system", "content": SYSTEM},
                {"role": "user", "content":
                    f"需求与约束:\n{spec}\n\n当前代码:\n{source}\n\n测试输出:\n{log}"}
            ],
        )
        with open(target, "w", encoding="utf-8") as f:
            f.write(resp.choices[0].message.content)
    print("达到轮次上限,转交人类工程师处理")
    return False

agent_loop("src/ref_store.py", "同一分支的并发更新必须只有一个成功")
🚀 Inicio rápido: Para crear un ciclo de este tipo, puedes empezar con el crédito gratuito de prueba de APIYI apiyi.com. Usa la misma clave API para cambiar entre distintos modelos de programación y comparar su tasa de éxito al corregir errores en tu conjunto de pruebas.
La siguiente tabla resume cómo adaptar las prácticas de Pando a un marco que pueda aplicar cualquier equipo. Son recomendaciones basadas en la información divulgada oficialmente, no un flujo de trabajo específico de Pando publicado por OpenAI.
| Etapa | Acción clave | Práctica correspondiente en Pando | Herramientas disponibles |
|---|---|---|---|
| Definir objetivos y límites | Precisar los protocolos que deben ser compatibles y las métricas innegociables | Mantener la compatibilidad con el protocolo Git | Documentos de diseño, AGENTS.md |
| Crear el entorno de validación | Pruebas de compatibilidad, simulación de concurrencia y detección de regresiones | Pruebas de conformidad y simulación determinista | pytest, pruebas basadas en propiedades, TLA+ |
| Distribuir el trabajo entre agentes | Tareas pequeñas, ramas independientes y ejecución automática de pruebas | Implementación por varios equipos de agentes | Invocación de varios modelos, por ejemplo, con APIYI apiyi.com |
| Revisión humana | Revisar las decisiones clave, las dependencias entre módulos y el impacto en la seguridad | Ingenieros humanos a cargo de la arquitectura | Reglas de revisión de código |
| Despliegue gradual | Empezar con poco tráfico y mantener la compatibilidad con el sistema anterior | Proxy de lectura y escritura, migración por lotes | Despliegue gradual, métricas de monitoreo |
Preguntas frecuentes FAQ
P1: ¿Qué es Pando?
Pando es el backend de servidor compatible con Git que OpenAI utiliza internamente para dar soporte a toda la actividad de desarrollo de su monorepositorio. Conserva el protocolo y el cliente estándar de Git, pero rediseña la actualización de referencias, la reutilización del almacenamiento de Packfiles y la distribución mediante caché. Su objetivo es permitir que numerosos agentes e ingenieros envíen y lean cambios de forma simultánea.
P2: ¿Pando lo creó una sola persona con Codex?
No. Según la descripción oficial, un ingeniero diseñó la arquitectura principal, varios equipos de agentes la implementaron y un pequeño grupo de ingenieros la desplegó. OpenAI no ha publicado el número de participantes, la proporción de código modificado por personas ni la configuración de los agentes. Tampoco ha afirmado que Codex generara todo el código o que no hubiera revisión humana.
P3: ¿Cuándo entró Pando en funcionamiento? ¿Se puede usar fuera de OpenAI?
Pando comenzó a recibir tráfico de producción en abril de 2026 y el artículo técnico se publicó el 2 de noviembre de 2026. A fecha del 3 de noviembre de 2026, no hay información pública sobre el servidor, una API, precios o una fecha de apertura. Solo se han publicado el fork del cliente de Git de OpenAI y algunos parches para el proyecto original; eso no significa que el servidor de Pando sea de código abierto.
P4: ¿Se completó toda la validación en 10 semanas?
No se puede interpretar así. Según la información oficial, los nuevos modelos se fueron usando para mejorar Pando a medida que aparecían. No se puede confirmar que el trabajo de verificación formal con Lean/TLA+ asistido por GPT-6 Astra, los cientos de horas de sesiones con agentes y las pruebas adversariales ocurrieran por completo durante las primeras 10 semanas. Además, la mayoría de los parches de Git publicados son posteriores a la primera puesta en producción.
P5: ¿Cómo se puede crear con una API un ciclo similar de pruebas y retroalimentación para agentes?
Conviene empezar por un módulo pequeño:
1. Regístrate en APIYI apiyi.com y obtén una clave API y crédito gratuito para pruebas.
2. Prepara primero pruebas ejecutables o comprobaciones de compatibilidad y después pide al modelo que modifique el código.
3. Usa el código de este artículo, establece base_url en `https://api.apiyi.com/v1` y repite el ciclo «generar, probar y devolver los registros».
Como la interfaz es compatible con OpenAI, para cambiar de modelo solo tienes que modificar el parámetro model, lo que facilita comparar los resultados de las correcciones.
P6: ¿Qué limitaciones tendría un equipo común si intentara copiar directamente el método de Pando?
Hay tres limitaciones principales: primero, se desconoce el costo, ya que OpenAI no ha publicado los gastos en tokens ni en infraestructura; segundo, Pando depende de un sistema de validación de alta calidad, y dejar que los agentes escriban mucho código en un proyecto sin pruebas implica más riesgo; tercero, el resultado de 10 semanas no se puede extrapolar a todos los proyectos del mismo tamaño. Lo recomendable es empezar con un presupuesto pequeño en APIYI apiyi.com y probar en un módulo no crítico. Si el ciclo de retroalimentación funciona, puedes ampliar el alcance.
Puntos clave sobre Pando y Codex Agent
- Qué es Pando: un backend interno de OpenAI compatible con Git, que llegó a producción en unas 10 semanas y no está disponible públicamente.
- Por qué se creó: Codex aumentó la concurrencia de commits y el sistema anterior empezó a sufrir ralentizaciones y fallos de fusión.
- Reparto entre personas y agentes: las personas definen la arquitectura y las restricciones; los agentes iteran sobre la implementación; los ingenieros se encargan del despliegue.
- Claves del éxito: las pruebas de compatibilidad, la simulación determinista y la verificación formal proporcionan retroalimentación fiable.
- Límites de la cronología: no todos los modelos y métodos de verificación posteriores formaron parte de las 10 semanas iniciales.
- Puesta en producción: un proxy que redirigía lecturas y escrituras y un traslado gradual del tráfico permitieron migrar sin interrumpir el desarrollo diario.
- Cómo empezar: crea primero las pruebas y después usa varios modelos a través de APIYI apiyi.com para validar el ciclo de retroalimentación.
Resumen
Los puntos centrales del caso Pando son:
- La escala obliga a adaptar la infraestructura: el aumento de commits que trae consigo la programación con IA afecta a Git, CI y la revisión de código. Pando es una respuesta de ingeniería a esa presión.
- Los resultados de los agentes dependen de la validación: el equipo de Codex Agent pudo participar en la implementación de infraestructura gracias a pruebas de compatibilidad ejecutables, simulaciones de concurrencia y descripciones formales.
- Las decisiones humanas siguen siendo clave: los ingenieros humanos se encargaron de las decisiones de arquitectura, los límites de consistencia y la migración a producción.
Para la mayoría de los equipos, lo que se puede aplicar no es la cifra de «10 semanas», sino estos cinco elementos: restricciones claras, pruebas ejecutables, reparto de tareas, retroalimentación continua y decisiones clave tomadas por personas. No hace falta buscar un desarrollo totalmente automatizado: empieza por cerrar el ciclo de retroalimentación con un agente en un módulo pequeño que tenga pruebas completas y amplía el alcance poco a poco.
Para validar los resultados rápidamente, recomendamos APIYI apiyi.com. La plataforma ofrece una interfaz compatible con OpenAI y crédito gratuito para nuevos usuarios, lo que facilita comparar distintos modelos de programación dentro de un mismo ciclo de retroalimentación.
📚 Referencias
- Artículo técnico oficial de OpenAI Scaling Git at OpenAI: fuente principal sobre la arquitectura de Pando, su migración y los datos de rendimiento
- Enlace:
openai.com/index/scaling-git-at-openai -
Nota: publicado el 2 de noviembre de 2026; es la fuente principal de los datos de este artículo
-
OpenAI Harness Engineering: otro proyecto interno cuyo desarrollo estuvo liderado por Codex
- Enlace:
openai.com/index/harness-engineering -
Nota: ayuda a entender la metodología de ingeniería de agentes; sus datos no deben mezclarse con los de Pando
-
Custom Code Review Rules for Codex: el cuello de botella en la revisión de código generado con IA
- Enlace:
developers.openai.com/blog/custom-code-review-rules-for-codex -
Nota: revela el aumento del número semanal de PR internos y las reglas de revisión de AGENTS.md
-
Fork público de Git de OpenAI: repositorio con mejoras para el cliente
- Enlace:
github.com/openai/git -
Nota: incluye mejoras como packfile-uri; no es el código fuente del servidor de Pando
-
Seguimiento de parches de Git de OpenAI: registro de contribuciones al proyecto original
- Enlace:
oai-git.openai.chatgpt.site - Nota: permite verificar las mejoras de ingeniería continuas tras la puesta en producción
Autor: Equipo técnico de APIYI
Intercambio técnico: Puedes contactarnos desde la página principal de APIYI. Encontrarás más recursos sobre desarrollo de agentes en el centro de documentación docs.apiyi.com