Nota del autor: Si ya usas image_generation de Responses en APIYI para generar imágenes mientras conversas, después de migrar a la Images API independiente puedes seguir editando imágenes de forma continua con el método de este artículo.
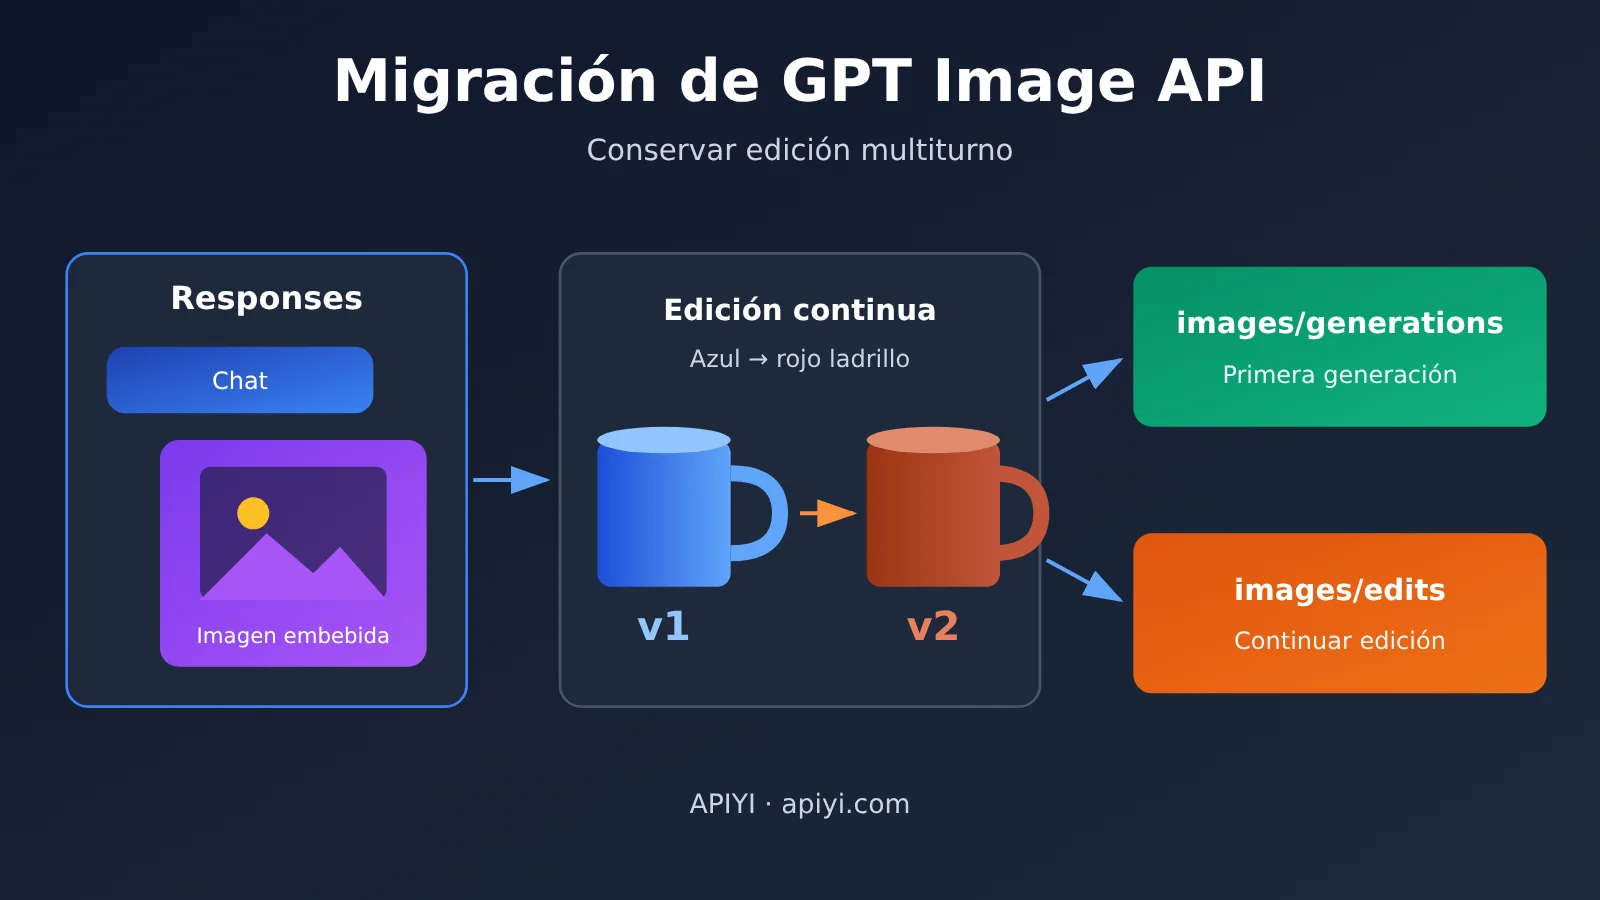
La conclusión, primero: Migra solo la parte de generación de imágenes; la conversación de texto existente no hay que tocarla. La “imagen anterior”, que antes se enlazaba de forma implícita mediante previous_response_id, ahora la guarda tu propia aplicación; tú la seleccionas explícitamente en cada edición y la subes como imagen original a POST /v1/images/edits. Con esto, el resultado de editar imágenes en varias rondas no cambia; lo único que cambia es quién recuerda la “imagen anterior”.
Esta conclusión se basa en la actualización de documentación que APIYI publicó el 21 de noviembre de 2026 a las 22:30 (hora de Beijing). Cinco modelos de imagen con proxy oficial pasan a recomendarse mediante dos endpoints de imagen independientes. OpenAI no ha desactivado Responses, y las conversaciones de texto dentro de la plataforma siguen funcionando con normalidad. Todas las interfaces, campos y criterios de facturación que aparecen a continuación provienen de la documentación de APIYI en apiyi.com y de la guía oficial de generación de imágenes de OpenAI. El código es un ejemplo de documentación y no representa resultados de pruebas reales.
Mapa de conocimiento e índice para la migración de GPT Image API
Toda la migración avanza en cuatro pasos; la salida de cada paso es la entrada del siguiente:
Identificar las llamadas antiguas y enrutarlas (sección 1)
   └─> Salida: para cada solicitud, decidir si va a chat, generations o edits
Generar y guardar la primera imagen (sección 2.1)
   └─> Salida: v1.png validada + registro de activos
Entregar la imagen original seleccionada al endpoint de edición (sección 2.2)
   └─> Salida: v2.png + relación parent_asset_id
Validar y conciliar costos (sección 3)
   └─> Salida: lista de imágenes utilizables + costo por imagen validada
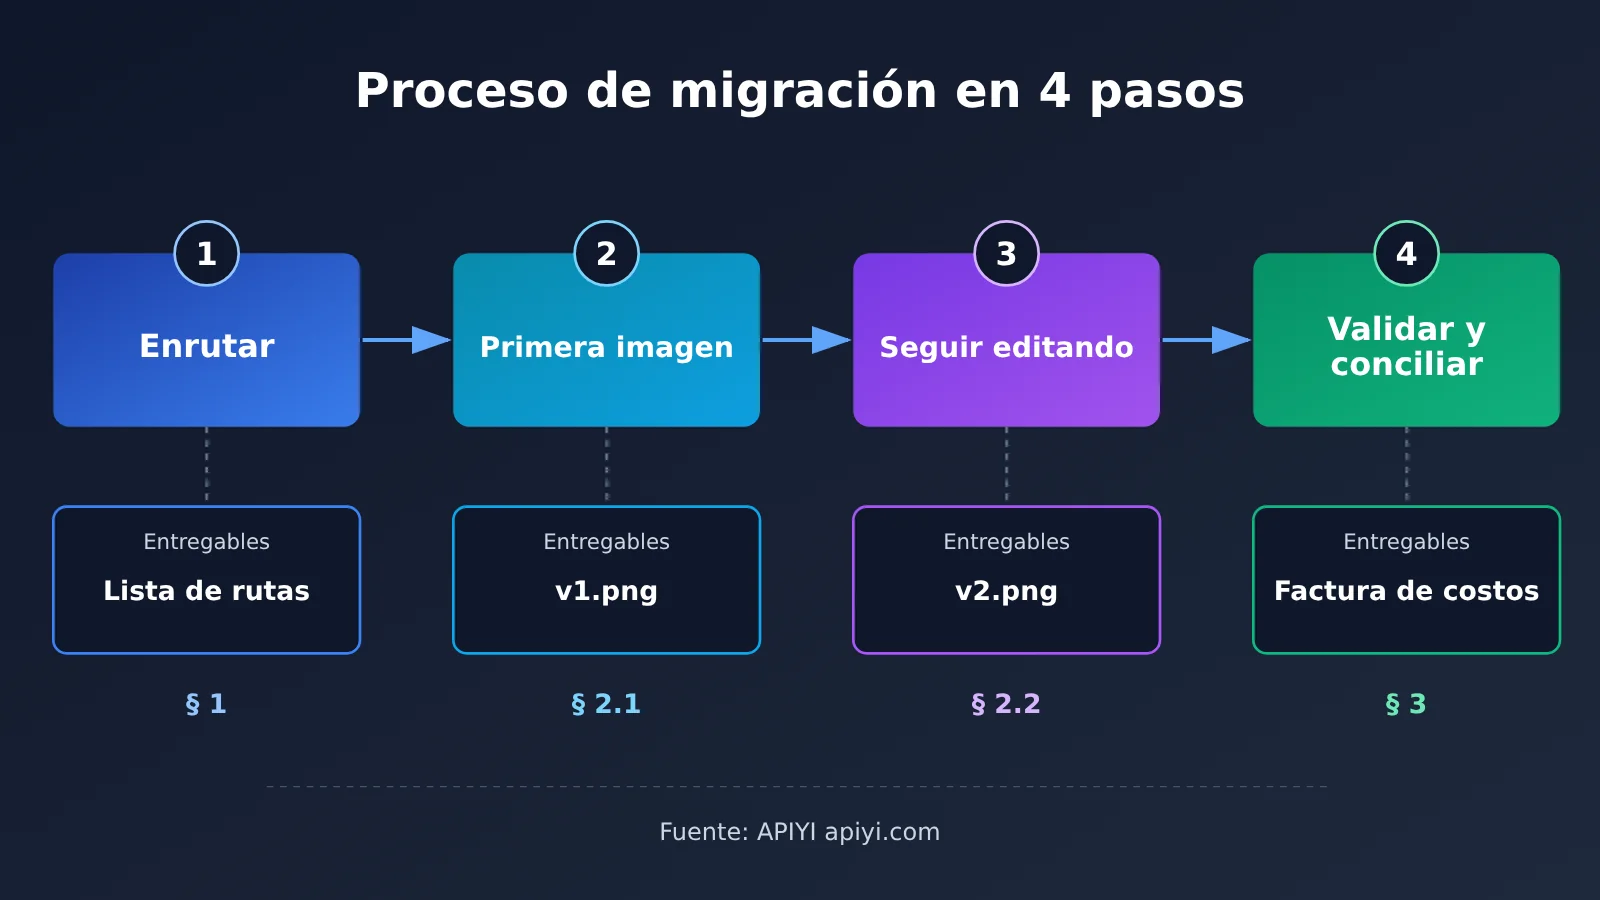
| Paso | Depende de | Por qué se coloca aquí | Objetivo |
|---|---|---|---|
| 1 Enrutamiento | El inventario de llamadas en el código actual | Primero identificar qué cambiar para no tocar por error las conversaciones de texto | Cambiar solo las solicitudes de generación de imágenes a la Images API |
| 2.1 Primera generación de imagen | La ruta de generations definida en el paso 1 | La edición posterior necesita una imagen original realmente guardada | Obtener una v1 validada y registrarla en el sistema |
| 2.2 Continuar editando la imagen | El archivo v1 guardado en el paso 2.1 | El endpoint independiente no acepta previous_response_id, solo reconoce la imagen que subes |
Obtener v2 y registrar la relación padre-hijo |
| 3 Validación y conciliación de costos | Las imágenes del paso 2 y los registros de la consola | Solo las imágenes validadas entran en el denominador de costos | Imágenes entregables + facturación explicable |
Orden de lectura recomendado: la sección 1 es de lectura obligatoria; la sección 2 se sigue en el orden del código; la sección 3 se consulta antes de salir a producción o cuando haya desconexiones o dudas de facturación.
To Know: Terminología de la migración de GPT Image API
| Término | Explicación breve |
|---|---|
| Retransmisión oficial | Modelos del canal oficial de retransmisión que ofrece APIYI; en este artículo se refiere a los cinco ID de modelos de imagen |
| image_generation | Herramienta de generación de imágenes dentro de Responses API; la ruta antigua lo usaba para generar imágenes mientras se conversaba |
| previous_response_id | Parámetro que usa Responses para continuar el contexto de la ronda anterior; las solicitudes independientes de Images no lo aceptan |
| multipart | Formato de subida por formulario; /images/edits lo usa para enviar el binario real de la imagen |
| b64_json | Campo con el que el endpoint independiente de imágenes devuelve la imagen; su contenido es la imagen codificada en base64 |
| parent_asset_id | Campo de relación que la aplicación registra por su cuenta para indicar de qué imagen proviene esta imagen |
1 Qué llamadas a GPT Image API deben migrarse desde Responses
1.1 Alcance del cambio dinámico de GPT Image API del 21/11 y los cinco modelos oficiales del proxy
Esta actualización de la documentación afecta a los siguientes cinco IDs de modelos oficiales servidos por el proxy:
gpt-image-2.6-sunburstgpt-image-2.6-flaregpt-image-2.5-sunburstgpt-image-2.5-flaregpt-image-2
Los dos endpoints independientes de imágenes correspondientes son POST /v1/images/generations (cuerpo de solicitud JSON) y POST /v1/images/edits (formulario multipart). APIYI no recomienda seguir usando la ruta image_generation de Responses para generar imágenes, por dos motivos: la disponibilidad es inestable y se generan cargos adicionales por uso de herramientas. Además, Chat Completions no permite generar imágenes con estos cinco modelos de imagen oficiales del proxy; si tu código antiguo usa esta forma, también debe incluirse en la lista de migración.
Cabe aclarar que este ajuste solo afecta a la generación de imágenes. OpenAI no ha descontinuado Responses, y el chat de texto dentro de APIYI tampoco se ha descontinuado. Por tanto, el alcance de la migración se limita al código en el que «la solicitud invoca la herramienta de imágenes o un modelo de imagen». Elegir entre los cinco modelos es otro tema; puedes consultar el artículo sobre selección de modelos en el centro de ayuda de APIYI apiyi.com. No lo cubrimos aquí.
1.2 Rutas para conversación de texto, primera generación y edición posterior de imágenes en GPT Image API
La combinación que propone la FAQ de APIYI es: el modelo de conversación se encarga de interpretar la intención del usuario, y la aplicación llama por separado a Images API y gestiona las imágenes por su cuenta. Con esa idea, las tres cosas que antes resolvía una sola solicitud a Responses se pueden dividir en tres rutas:
| Intención del usuario | Nueva ruta | Formato de solicitud | Origen de la imagen |
|---|---|---|---|
| Chat solo de texto, preguntas y respuestas | Mantener la interfaz de chat de texto existente | Sin cambios | Ninguno |
| Primera generación de imagen | POST /v1/images/generations |
JSON | Solo el prompt |
| Seguir editando una imagen existente | POST /v1/images/edits |
multipart | La aplicación sube la imagen original seleccionada |
En Responses nativo, la edición continuada se puede hacer mediante previous_response_id o pasando la imagen directamente. Las solicitudes independientes a Images no aceptan previous_response_id; esa es la razón de fondo por la que la «edición en varios turnos» tiene que quedar en manos de la aplicación. El modelo ya no recuerda por ti la imagen anterior: tienes que entregarle el archivo de esa imagen.
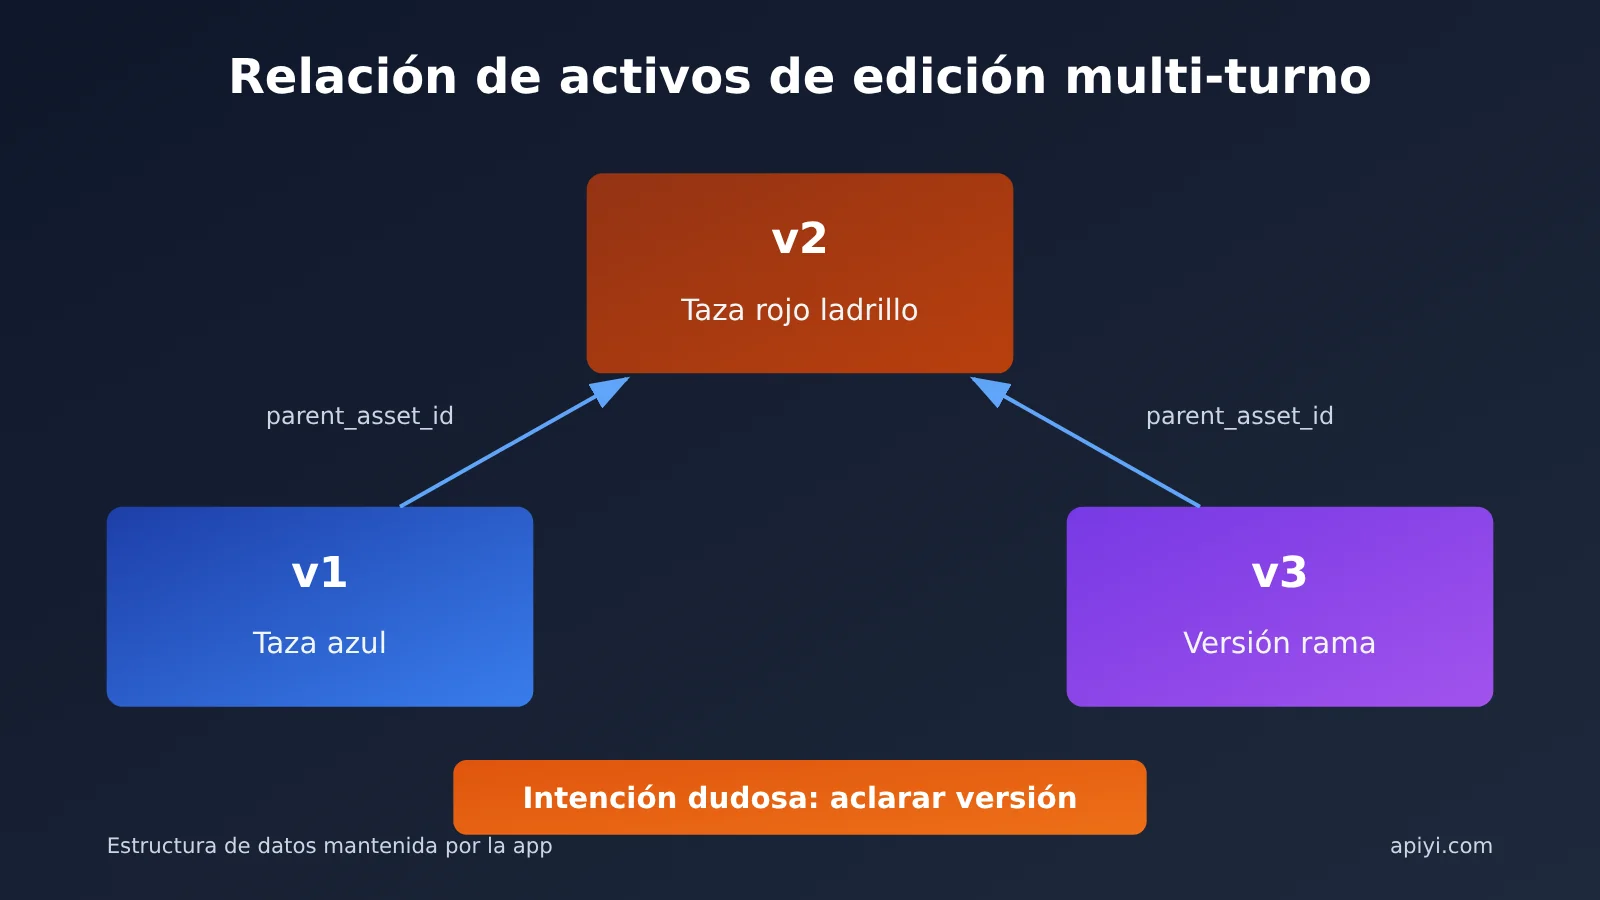
Si el usuario dice «un poco más rojo», pero en la conversación ya hay varias versiones v1, v2 y v3, la aplicación no puede saber a cuál se refiere. En ese caso, primero confirma con el usuario; no adivines. Usar la última versión por defecto parece lo más cómodo, pero si el usuario en realidad quería volver a v2 para reeditarla, acabarás cobrando una vez de más y confundiéndolo.
El análisis de la respuesta también debe cambiar:
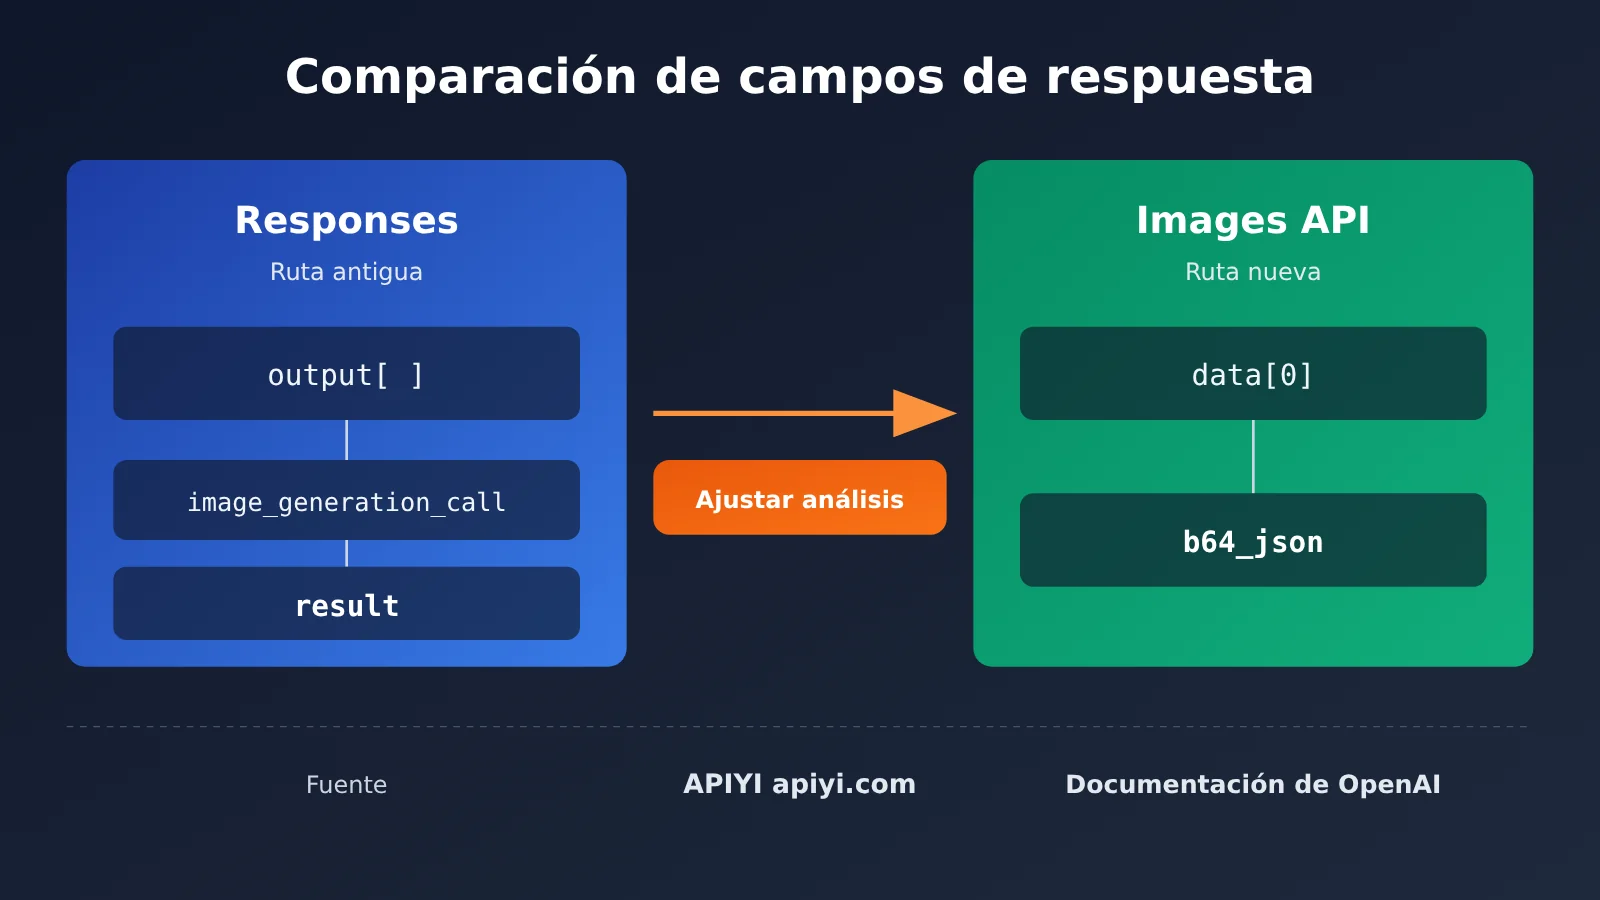
| Ruta | Dónde está la imagen en la respuesta | Cómo se mantiene el contexto |
|---|---|---|
| Responses + image_generation | result del elemento con type=image_generation_call dentro de output |
previous_response_id o pasar una imagen |
| Images API independiente | data[0].b64_json |
La aplicación sube la imagen original seleccionada |
2 Cómo seguir editando la imagen anterior con GPT Image API
A continuación, un ejemplo de dos rondas ilustra el flujo completo. En la primera ronda se genera una taza azul; en la segunda, solo el cuerpo de la taza se cambia a rojo ladrillo. Los parámetros siguen el ejemplo de la documentación de APIYI: modelo gpt-image-2.5-sunburst, tamaño 1024x1024, quality=medium, output_format=png. El token se lee de la variable de entorno APIYI_KEY y se pasa como Bearer.
2.1 Generar y validar el PNG de la taza azul con GPT Image API
La primera ronda llama al endpoint generations; la indicación describe: fondo gris claro, taza de cerámica azul centrada, asa hacia la derecha, luz lateral suave y ningún texto en la imagen. Después de recibir la respuesta, procesa en este orden:
- Llama a
raise_for_status()para descartar primero los fallos a nivel HTTP. - Realiza una decodificación base64 estricta de
b64_json; si no se puede decodificar, se considera un fallo. - Abre con Pillow y llama a
load()para confirmar que el archivo realmente se decodifica como imagen. - Confirma que el formato es PNG y el tamaño es 1024×1024; luego guarda como
v1.png. - Registra este activo en la aplicación; las siguientes ediciones tomarán la imagen original desde aquí.
El paso 3 no se puede omitir. open() solo lee la cabecera del archivo; si los datos de imagen están truncados, solo se revelará al llamar a load().
2.2 API GPT Image: subir la imagen original seleccionada y cambiar solo el cuerpo de la taza a rojo ladrillo
En la segunda ronda se llama al endpoint edits. En data se envían model, prompt, size, quality y output_format; en files, se sube el binario real de v1.png mediante el campo image[]. El prompt significa: cambiar únicamente el cuerpo de la taza a rojo ladrillo y mantener intactos la forma de la taza, el asa, la composición, la iluminación y el fondo.
Hay varios puntos en los que es fácil equivocarse:
- No envíes
response_format. - No escribas manualmente
Content-Type.requestsgenerará automáticamente la cabecera multipart con boundary; si la escribes a mano, puedes acabar perdiendo el boundary. - No subas una cadena base64 como si fuera un archivo: lo que se sube deben ser los bytes originales de la imagen.
Cuando termines la edición, decodifica y valida de la misma forma, y guarda el resultado como v2.png. Conserva v1 y, en el registro del asset, escribe parent_asset_id = v1. Esta relación padre-hijo es el “contexto multiturno” dentro de la nueva arquitectura. Ten en cuenta también que se trata de una edición generativa: el modelo intentará conservar el resto de la imagen, pero no garantiza que los píxeles fuera del cuerpo de la taza sean idénticos uno por uno.
A continuación, un ejemplo mínimo completo (ejemplo de documentación, no probado en este artículo):
import base64
import io
import os
import uuid

import requests
from PIL import Image

BASE_URL = "https://api.apiyi.com/v1"  # Endpoint unificado de APIYI
API_KEY = os.environ["APIYI_KEY"]
HEADERS = {"Authorization": f"Bearer {API_KEY}"}
MODEL = "gpt-image-2.5-sunburst"
SIZE = "1024x1024"
# Tiempo de espera intermedio de ejemplo; ajústalo según tu red y la calidad. Sin reintento automático.
TIMEOUT = (10, 360)

assets = {}  # asset_id -> {"path": ..., "parent_asset_id": ...}


def decode_and_check(resp, path):
    resp.raise_for_status()
    item = resp.json()["data"][0]
    b64 = item.get("b64_json")
    if not b64:
        raise ValueError("no b64_json in response, check body before any resend")
    raw = base64.b64decode(b64, validate=True)
    img = Image.open(io.BytesIO(raw))
    img.load()
    if img.format != "PNG" or img.size != (1024, 1024):
        raise ValueError(f"unexpected image: {img.format} {img.size}")
    with open(path, "wb") as f:
        f.write(raw)
    return path


def save_asset(path, parent_asset_id=None):
    asset_id = str(uuid.uuid4())
    assets[asset_id] = {"path": path, "parent_asset_id": parent_asset_id}
    return asset_id


# Ronda 1: texto a imagen mediante JSON
gen_resp = requests.post(
    f"{BASE_URL}/images/generations",
    headers=HEADERS,
    json={
        "model": MODEL,
        "prompt": (
            "Light gray background, a blue ceramic mug centered, "
            "handle facing right, soft side lighting, no text."
        ),
        "size": SIZE,
        "quality": "medium",
        "output_format": "png",
    },
    timeout=TIMEOUT,
)
v1_id = save_asset(decode_and_check(gen_resp, "v1.png"))

# Ronda 2: editar mediante multipart la imagen original seleccionada explícitamente
selected_id = v1_id  # si no está claro qué versión quiere el usuario, pregúntale primero
with open(assets[selected_id]["path"], "rb") as f:
    edit_resp = requests.post(
        f"{BASE_URL}/images/edits",
        headers=HEADERS,  # no escribas Content-Type manualmente; requests establece el boundary
        data={
            "model": MODEL,
            "prompt": (
                "Change only the mug body to brick red. Keep the mug shape, "
                "handle, composition, lighting and background unchanged."
            ),
            "size": SIZE,
            "quality": "medium",
            "output_format": "png",
        },
        files={"image[]": ("v1.png", f, "image/png")},
        timeout=TIMEOUT,
    )
v2_id = save_asset(decode_and_check(edit_resp, "v2.png"), parent_asset_id=selected_id)
print(assets)
El timeout=(10, 360) del ejemplo es solo un ajuste intermedio de la documentación; el valor real debe elegirse según tu enlace de red y el nivel de calidad. El ejemplo también omite deliberadamente el reintento automático; la razón se explica en la sección 3.2.
🚀 Verificación rápida: asigna a APIYI_KEY el token que creaste en la consola de APIYI apiyi.com y el script anterior podrá ejecutar las dos rondas del flujo. Los usuarios nuevos pueden empezar usando la cuota de prueba gratuita para confirmar la lógica de enrutamiento y de análisis, y después cambiar al tráfico de producción.
3 Cómo validar y conciliar las cuentas después de migrar a GPT Image API
3.1 Los cuatro controles de validación de imágenes de GPT Image API
Solo cuando una imagen supera los cuatro controles se puede marcar como «disponible» en la aplicación:
- HTTP correcto:
raise_for_status()no lanza ninguna excepción. - Se puede decodificar: la decodificación base64 estricta se realiza correctamente y Pillow
load()se ejecuta sin problemas. - Especificaciones correctas: el formato y las dimensiones coinciden con la solicitud; en este caso, PNG y 1024×1024.
- El cambio visual realmente se produjo: el cuerpo del vaso de la v2 efectivamente se volvió de color rojo ladrillo, mientras que la forma del vaso, el asa, la composición y el fondo se mantuvieron básicamente iguales.
El cuarto control requiere revisión manual o un paso de auditoría aparte, porque el código de estado HTTP no indica si el modelo hizo el cambio correcto. Una imagen que solo pasa los tres primeros controles se considera, como mucho, «técnicamente válida», pero aún no se puede entregar. Si la respuesta no contiene ninguna imagen, conviene revisar primero el contenido de la respuesta antes de decidir si se reintenta; el centro de ayuda tiene un artículo dedicado a este tema y no lo repetiremos aquí.
3.2 GPT Image API: el antiguo cargo por herramienta y el costo por imagen validada
Antes y después de la migración, la base de facturación es distinta:
| Elemento | Antigua cadena Responses image_generation | Images API independiente |
|---|---|---|
| Cargo adicional | Aproximadamente $0.20 de cargo adicional por llamada a la herramienta de imágenes de APIYI | No existe este cargo por herramienta |
| Qué significa esa cifra | Se refiere únicamente a este cargo adicional por herramienta; no es el precio total de la operación ni el precio genérico de OpenAI | Facturación por uso |
| Forma adecuada de comparación | Comparar por «costo por imagen validada» | Comparar por «costo por imagen validada» |
No compares solo el precio unitario; se recomienda usar de forma uniforme la siguiente fórmula:
Costo por imagen validada = cobros reales relacionados (incluidas las llamadas de texto necesarias, las solicitudes fallidas ya cobradas y los reintentos) ÷ número de imágenes que superaron la validación
El numerador debe incluir todos los cobros relacionados, incluidas las llamadas de conversación para determinar la intención, las solicitudes fallidas ya cobradas y los reintentos. El denominador solo debe contar las imágenes que superaron los cuatro controles de la sección 3.1. Si no hay ninguna imagen aprobada, no calcules el costo por imagen, porque en ese caso la conclusión debería ser «el proceso tiene un problema», no «el precio unitario es muy alto». Cuánto dinero se puede ahorrar con la migración depende de tu tasa de reintentos y de tu tasa de aprobación de la validación; este artículo no ofrece proporciones concretas.
Los datos para la conciliación de cuentas provienen del registro de consumo de la consola, donde los registros de consumo tienen type=2. Si lo que lees es el campo quota, conviértelo a importe según la documentación de la plataforma usando quota ÷ 500000.
Hay que prestar especial atención al manejo de las desconexiones. El endpoint de imágenes independiente devuelve la respuesta de forma síncrona; si la conexión se corta a mitad de camino, es posible que esta solicitud ya se haya cobrado y que no se pueda recuperar la imagen mediante el request ID. El orden correcto es: primero ir al registro de consumo de la consola de APIYI apiyi.com para confirmar si esta solicitud se ha cobrado, y después decidir si hay que reenviarla. Esta es también la razón por la que el código de ejemplo no incluye reintentos automáticos: los reintentos automáticos pueden provocar fácilmente cobros duplicados cuando hay una desconexión. Si te encuentras con limitación de tasa o necesitas cambiar de canal, puedes consultar el artículo del centro de ayuda sobre selección de canales y degradación de 429.
El criterio para comprobar que la migración está completa es muy directo: el diálogo de texto sigue funcionando con normalidad; la primera generación de imágenes devuelve de forma estable un v1 que supera los cuatro controles; cada edición de imagen se puede localizar en el registro de activos con un parent_asset_id claro; y cada cobro por imagen en el registro de la consola se corresponde con una imagen validada, un error conocido o un reenvío documentado. Una vez cumplidos estos puntos, puedes redirigir el tráfico restante de generación de imágenes de Responses a Images API. Cuando necesites pruebas comparativas con varios modelos, APIYI apiyi.com ofrece una interfaz unificada compatible con OpenAI; para cambiar de modelo, solo tienes que modificar el parámetro MODEL.
Referencias
-
Actualización de la documentación de APIYI: los modelos de imagen con relay oficial ahora usan Images API
- Enlace:
docs.apiyi.com/live/2026-11/gpt-image-official-relay-images-api - Descripción: los cinco ID de relay oficial, los dos endpoints independientes y por qué no se recomienda la cadena antigua
- Enlace:
-
Preguntas frecuentes de APIYI: procesar texto e imágenes al mismo tiempo en una sola API
- Enlace:
docs.apiyi.com/faq/text-and-image-in-one-api - Descripción: cómo el modelo de conversación determina la intención y el patrón en el que la aplicación llama a Images API por separado
- Enlace:
-
Guía de generación de imágenes de OpenAI
- Enlace:
developers.openai.com/api/docs/guides/image-generation - Descripción: el modo de edición continua de Responses y la estructura de la respuesta
- Enlace:
-
APIYI GPT Image 2 texto a imagen / edición de imágenes
- Enlace:
docs.apiyi.com/api-capabilities/gpt-image-2/text-to-image - Enlace:
docs.apiyi.com/api-capabilities/gpt-image-2/image-edit - Descripción: ejemplos de parámetros de solicitud, carga multipart y validación de decodificación
- Enlace:
-
APIYI herramienta de imágenes de Responses / buenas prácticas de API de imágenes / consulta de logs
- Enlace:
docs.apiyi.com/api-capabilities/gpt-image-2/responses-image-tool - Enlace:
docs.apiyi.com/api-capabilities/image-api-best-practices - Enlace:
docs.apiyi.com/api-capabilities/log-query - Descripción: criterios de cobro de la herramienta, manejo de desconexiones y conversión de logs de consumo
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: si durante la migración encuentras problemas de enrutamiento o facturación, puedes contactarnos desde la página de inicio de APIYI en apiyi.com; para más detalles sobre la interfaz, consulta el centro de documentación en docs.apiyi.com