Nota del autor: el precio de introducción de Gemini 4 Carbon vence el 30 de noviembre. Este artículo te ayuda a recalcular las cuentas antes de la fecha límite y a reestructurar la capa de integración de modo que «cambiar de modelo implique solo cambiar el ID y el endpoint».
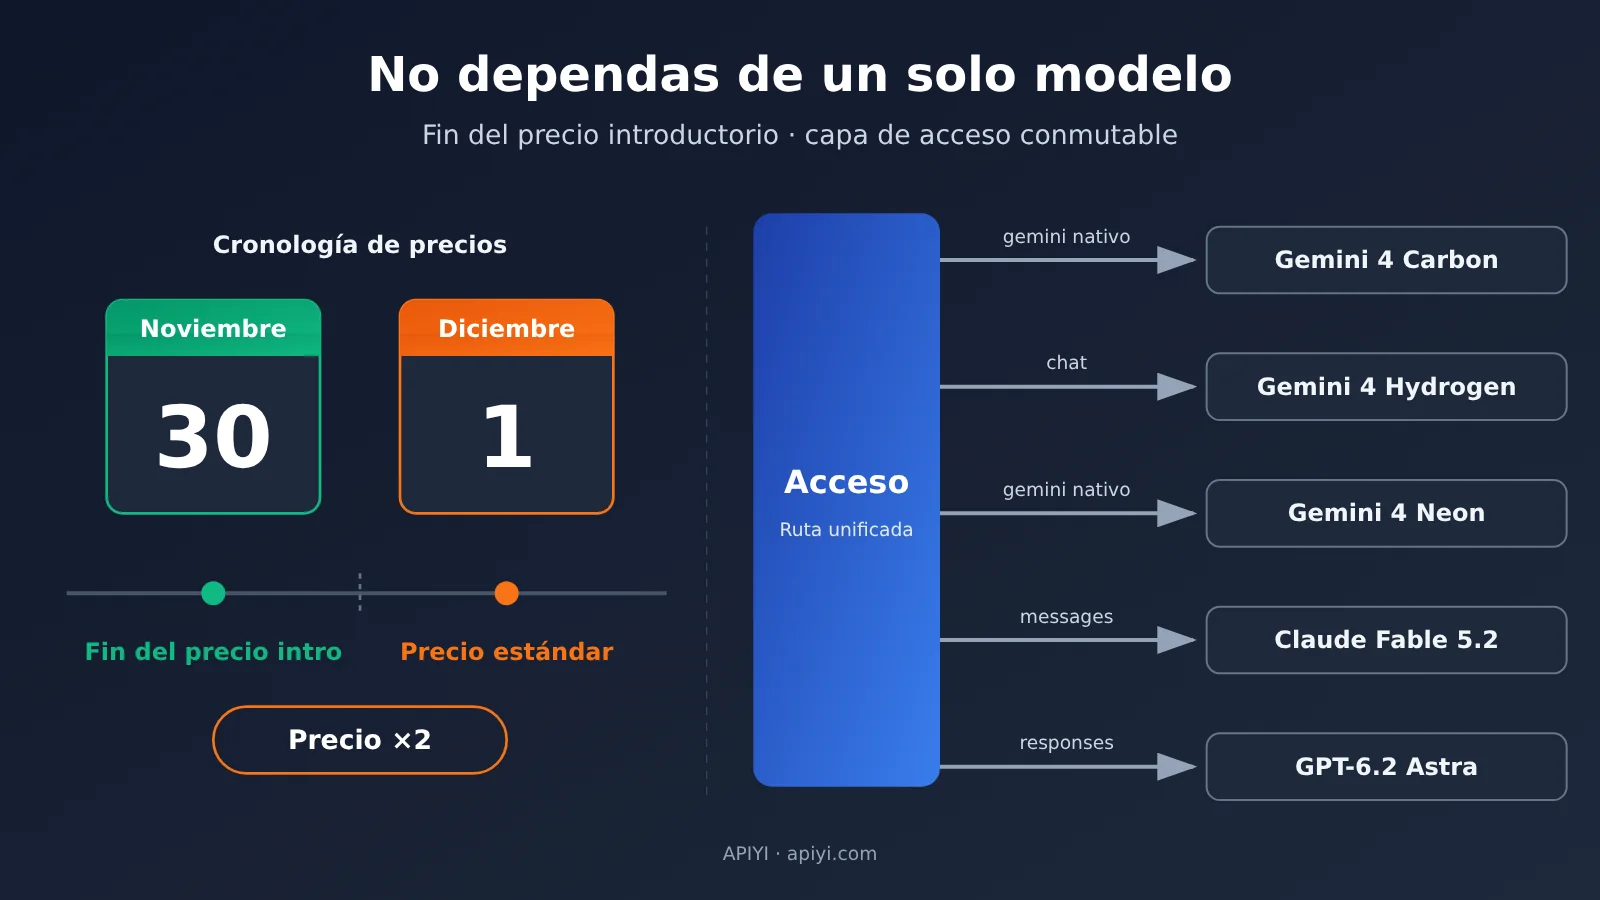
Si tu negocio ya está conectado a Gemini 4 Carbon, los próximos 10 días merecen que los tomes en serio. La página para desarrolladores de Google lo dice con claridad: el precio de introducción de Gemini 4 Carbon se mantiene hasta el 2026-11-30; a partir del 2026-12-01 se pasa al precio estándar, y tanto el precio unitario de entrada como el de salida se duplican. Hoy es 2026-11-20, el precio de introducción aún no ha terminado, así que si te pones ahora a ajustar el modelo de costes y el código de integración, vas bien de tiempo.
Este no es un artículo que te empuje a cambiar de modelo sobre la marcha. Cambiarse no siempre sale más barato, y los resultados tampoco tienen por qué ser equivalentes. Aquí vamos a resolver dos cosas más concretas: primero, cómo recalcular las cuentas cuando venza el plazo; segundo, cómo rediseñar la capa de invocación para que sea intercambiable en cualquier momento, de forma que la próxima vez que cambien los precios o la ventana de contexto, solo tengas que tocar el ID del modelo y el endpoint, sin reescribir toda la invocación.
Valor principal: al terminar de leer tendrás la fecha de vencimiento clara, dos juegos de cifras —precio de introducción y precio estándar— y los endpoints que corresponden a cada alternativa al pasar a Hydrogen, Neon, Fable o Astra.
Puntos clave del vencimiento del precio introductorio de Gemini 4 Carbon
Primero, reúno los datos clave. Las cifras de la tabla proceden de la página para desarrolladores de Google y de la información de precios verificada por APIYI el 2026-11-20; la unidad es dólares por millón de tokens.
| Punto clave | Detalle | Impacto para ti |
|---|---|---|
| Fecha límite del precio introductorio | Hasta el 2026-11-30 |
La factura de noviembre se calcula con el precio introductorio |
| Precio introductorio | Entrada 2, salida 10, lectura de caché 0.10 |
Línea base de coste actual |
| Precio estándar (desde el 1 de diciembre) | Entrada 4, salida 20, lectura de caché 0.20 |
Con el mismo uso, el coste aproximadamente se duplica |
| Catálogo actual de APIYI | gemini-4-carbon: entrada 2, lectura de caché 0.1, salida 10 |
Coincide con el precio introductorio; después del vencimiento, prevalecerá la lista de modelos de la plataforma |
| Modelos alternativos | Hydrogen, Neon, Fable, Astra | Tienen endpoints distintos; no pueden compartir un mismo cuerpo de solicitud |
Cómo interpretar los dos precios de Gemini 4 Carbon
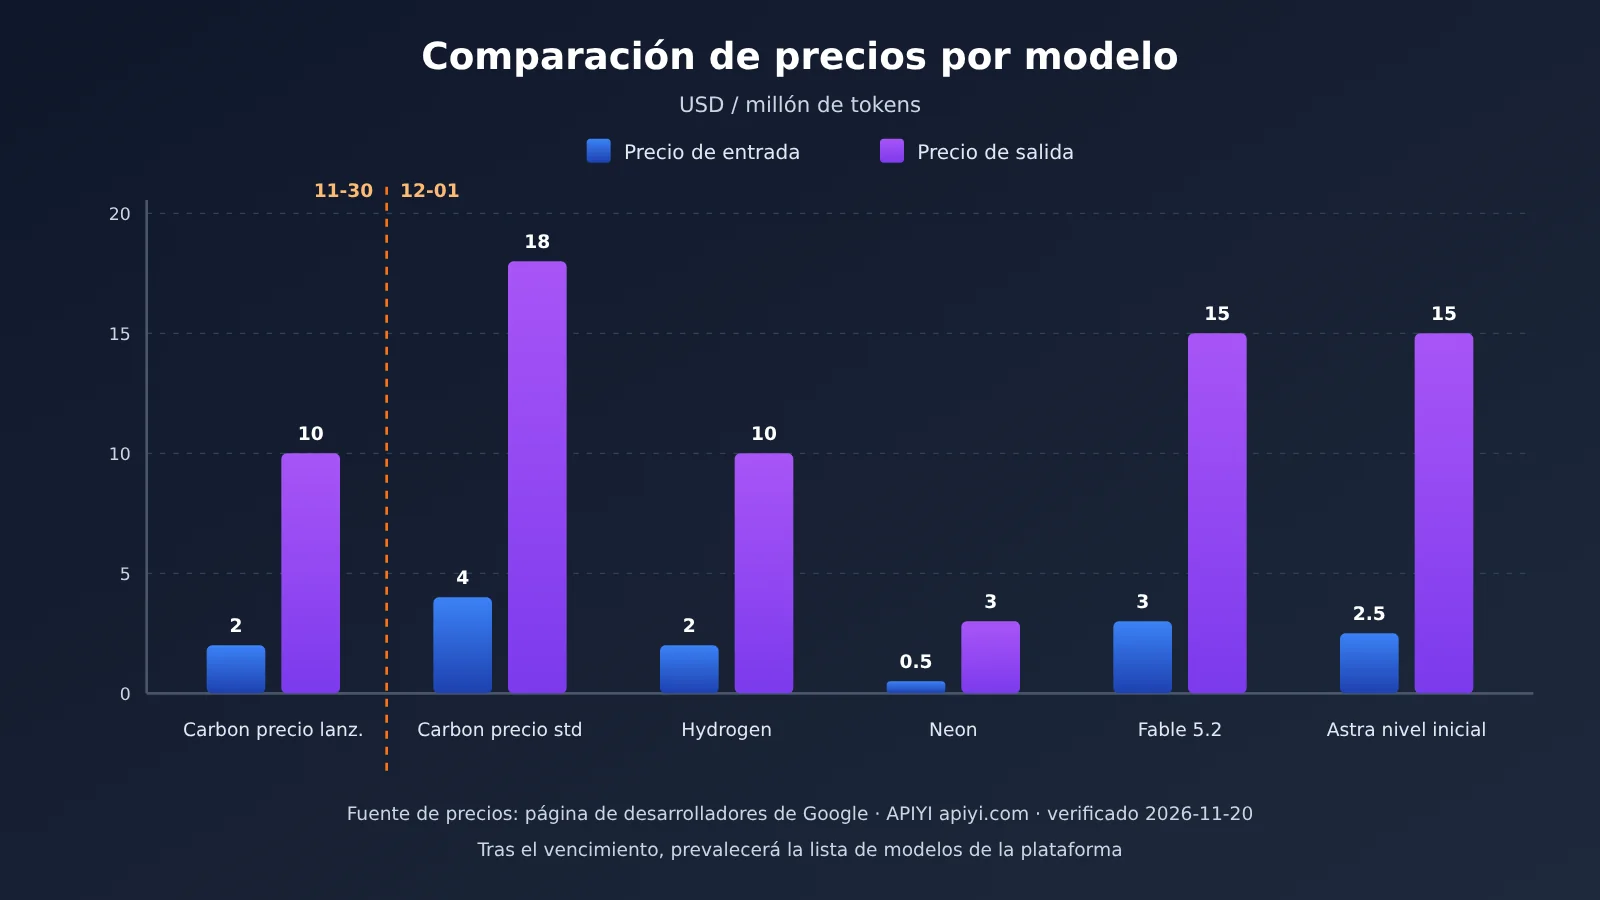
La diferencia entre el precio introductorio y el precio estándar es muy directa: la entrada sube de 2 a 4, la salida de 10 a 20 y la lectura de caché de 0.10 a 0.20; los tres conceptos se duplican. Por eso, el coste a partir de diciembre será, en la práctica, «el mismo uso de noviembre multiplicado por 2». Si tus indicaciones tienen muchos prefijos reutilizables y una alta tasa de aciertos de caché, el incremento absoluto de la lectura de caché será algo menor, pero la proporción también se duplica.
Hay que distinguir especialmente el precio de catálogo de APIYI apiyi.com. Según la verificación del 2026-11-20, en la plataforma gemini-4-carbon aparece con entrada 2, lectura de caché 0.1 y salida 10, lo que corresponde al precio introductorio de Google, no al precio estándar posterior al 1 de diciembre. Cómo ajuste la plataforma después del vencimiento dependerá de la lista de modelos vigente en ese momento; no tomes el precio de catálogo que ves ahora como garantía para después de diciembre.
Por qué no deberías depender de un solo modelo
Si solo usas una única familia de modelos, el riesgo viene principalmente de tres frentes. El primero es el cambio de precios: el fin del periodo introductorio y los ajustes promocionales alteran directamente el coste unitario. El segundo es que el modelo se retire o cambie de nombre: de repente, el ID anterior deja de estar disponible y las invocaciones fallan de forma masiva. El tercero es que un mismo modelo puede tener niveles de razonamiento y ventanas de contexto distintos según el punto de acceso; los parámetros que ajustas en un punto de acceso pueden no surtir efecto en otro.
Ninguno de estos tres tipos de cambios está bajo tu control, pero lo que sí puedes controlar es el alcance de las modificaciones cuando ocurren. Si el ID del modelo, el tipo de endpoint y los parámetros de precio están codificados directamente en el código de negocio, cada cambio obliga a modificar código, volver a probar y volver a desplegar. Si todo esto se concentra en la configuración de la capa de integración, un cambio se reduce a modificar una línea de configuración.
Cómo recalcular el costo después del vencimiento de Gemini 4 Carbon
Usa tus propios consumos para comparar ambos esquemas de precios
En realidad, recalcular solo requiere tres cifras: tokens de entrada mensuales, tokens de salida mensuales y tokens de lectura de caché mensuales. Multiplica cada una por su precio unitario correspondiente y súmalas para obtener el costo mensual. A continuación, una demostración con un consumo supuesto: 100M tokens de entrada al mes y 20M tokens de salida, sin contar caché por ahora. Este consumo es solo ilustrativo; reemplázalo por los valores reales de tu propia factura.
| Plan de facturación | Precio unitario de entrada | Precio unitario de salida | Costo mensual con el consumo supuesto |
|---|---|---|---|
| Precio introductorio de Carbon (hasta 11-30) | 2 |
10 |
100×2 + 20×10 = 400 dólares |
| Precio estándar de Carbon (desde 12-01) | 4 |
20 |
100×4 + 20×20 = 800 dólares |
gemini-4-hydrogen |
1.5 |
7.5 |
100×1.5 + 20×7.5 = 300 dólares |
gemini-4-neon |
3 |
15 |
100×3 + 20×15 = 600 dólares |
claude-fable-5-2 |
8 |
40 |
100×8 + 20×40 = 1600 dólares |
gpt-6.2-astra (primer tramo) |
8 |
40 |
100×8 + 20×40 = 1600 dólares |
Esta tabla solo calcula precios unitarios, no resultados. Hydrogen tiene el precio unitario más bajo, pero que pueda sustituir a Carbon depende de los requisitos de tu tarea en cuanto a calidad de razonamiento y estabilidad de formato. Fable y Astra tienen precios unitarios más altos y encajan en etapas donde se exige alta calidad y se está dispuesto a pagar por resultados, no como una solución para reducir costos. En otras palabras, recalcular sirve para ver con claridad el costo de cada camino, no para asumir que cambiar de modelo ahorra más por defecto.
Dónde verificar los datos de precios
Los precios de APIYI se pueden contrastar con dos fuentes. Una es la tabla general de modelos; la versión verificada el 2026-11-20 se actualizó el 2026-11-19 a las 10:59 (UTC+8). La otra es la interfaz de precios api.apiyi.com/api/pricing, versión shell-api-modelmak-v1, donde model_ratio igual a 1 equivale a 2 dólares por millón de tokens de entrada, y salida y caché se convierten mediante completion_ratio y cache_ratio respectivamente.
Tomemos gemini-4-neon como ejemplo: esa versión de la tabla general no incluye esta fila, pero la interfaz de precios sí: model_ratio es 1.5, completion_ratio es 5 y cache_ratio es 0.05. Al convertir, queda entrada 3, salida 15 y lectura de caché 0.15, en línea con el precio de lista de Google. Para presupuestar, te sugiero tomar como referencia la interfaz de precios y usar la tabla general como material de apoyo.
gpt-6.2-astra tiene precios por tramos y hay que revisar ambos lugares. La tabla general indica que el primer tramo es entrada 8, lectura de caché 0.4 y salida 40; al superar 272000 tokens, la entrada pasa a 16. La interfaz de precios, en cambio, muestra que al superar 272000 tokens la salida se calcula a 60 y la lectura de caché a 0.8. Si tus solicitudes individuales suelen tener contextos muy largos, estos tramos afectan mucho el costo y debes estimarlos por separado.
💰 Consejo para verificar costos: consulta la interfaz de precios y la lista de modelos de APIYI apiyi.com antes y después del vencimiento, y coloca los precios unitarios en tu configuración de enrutamiento en lugar de hardcodearlos en los comentarios del código. Así, al conciliar cada mes, solo tendrás que comparar si la configuración coincide con los datos de la plataforma.
Comparativa de endpoints para reemplazar modelos Gemini 4 Carbon
Antes de cambiar de modelo, revisa los endpoints; no des por hecho que el cuerpo de la solicitud es universal
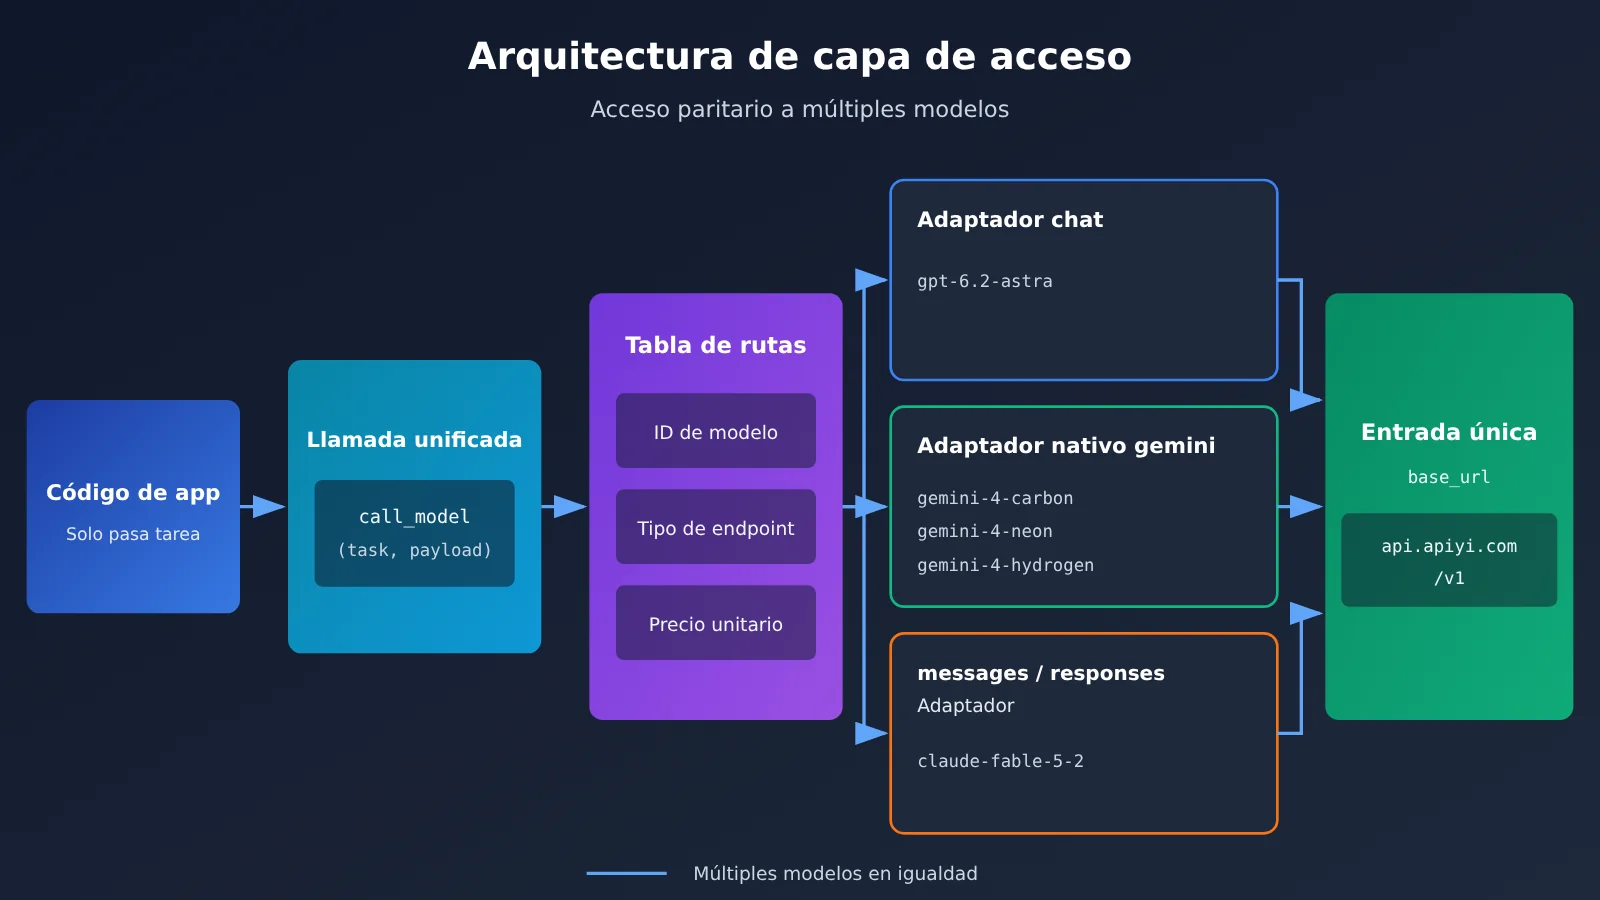
Este es el paso donde es más fácil tropezar. Muchos equipos piensan que «como todo va por la interfaz compatible con OpenAI, basta cambiar el campo model», pero algunos modelos recomiendan endpoints completamente distintos y los campos del cuerpo de la solicitud también cambian. La siguiente tabla resume los tipos de endpoint recomendados para los modelos de reemplazo; todas las llamadas usan la misma dirección base https://api.apiyi.com/v1.
| ID del modelo | Endpoint recomendado | Precio unitario de entrada / lectura de caché / salida | Nota para el cambio |
|---|---|---|---|
gemini-4-carbon |
chat o nativo de Gemini | 2 / 0.1 / 10 (catálogo actual) |
Tras la expiración, regirse por la lista de modelos |
gemini-4-hydrogen |
chat o nativo de Gemini | 1.5 / 0.075 / 7.5 |
Igual al endpoint de Carbon, cambio mínimo |
gemini-4-neon |
chat o nativo de Gemini | 3 / 0.15 / 15 |
El precio se rige por la API de precios |
claude-fable-5-2 |
chat o messages | 8 / 0.2 / 40 |
Las capacidades nativas son más completas por messages |
claude-fable-5-2-thinking |
chat o messages | 8 / 0.2 / 40 |
El nivel de pensamiento es un ID independiente |
gpt-6.2-astra |
Se recomienda responses | Primer tramo 8 / 0.4 / 40 |
Precio por tramos al superar 272000 tokens |
Además, gemini-4-argon también aparece en la tabla general, con precios de entrada 2, lectura de caché 0.1 y salida 10, iguales al precio actual de catálogo de Carbon. La información de endpoint de este modelo no está cubierta por las referencias de este artículo; si lo consideras, primero confirma el endpoint recomendado en la documentación de la plataforma antes de integrarlo.
¿Cuáles son las diferencias entre los tres tipos de endpoint?
El endpoint chat es el formato de completado de chat compatible con OpenAI; el núcleo del cuerpo de la solicitud son model y el arreglo messages, y la mayoría de los SDK usan este tipo por defecto. El endpoint nativo de Gemini usa la estructura de solicitud propia de Gemini y encaja en escenarios que necesitan parámetros nativos (por ejemplo, una configuración de pensamiento específica). El endpoint messages es el formato nativo de Claude; la forma de colocar la indicación de sistema y la estructura de los bloques de contenido son distintas de chat. El endpoint responses es una forma de interfaz más reciente de OpenAI, y para gpt-6.2-astra se recomienda usar este.
Por eso, una capa de integración estable debería preparar un adaptador independiente para cada endpoint; el código de negocio solo pasa «tipo de tarea + contenido», y el adaptador se encarga de armar el formato correspondiente. Para las rutas y campos concretos de los endpoints, guíate por las indicaciones del centro de documentación de APIYI.
🎯 Consejo técnico: antes de cambiar, usa la misma clave API de APIYI apiyi.com para enviar varias solicitudes reales de negocio a cada endpoint recomendado de los modelos candidatos; confirma que la estructura de respuesta, el comportamiento del nivel de pensamiento y la longitud del contexto cumplan lo esperado, y después modifica la configuración de enrutamiento.
Guía rápida de la capa de acceso conmutable de Gemini 4 Carbon
Ejemplo mínimo: cliente unificado
Esta sección no incluye bloques de código extensos; solo muestra la configuración clave. Al inicializar el cliente con el SDK compatible con OpenAI, solo se necesitan dos parámetros: client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Después, al llamar al endpoint chat, escribe client.chat.completions.create(model="gemini-4-carbon", messages=msgs). Si quieres cambiar a Hydrogen, basta con cambiar model por gemini-4-hydrogen, porque ambos comparten el endpoint chat y no hay que tocar el cuerpo de la solicitud.
Al cambiar a gpt-6.2-astra, la cosa cambia. La forma recomendada es client.responses.create(model="gpt-6.2-astra", input=msgs); el nombre del parámetro pasa de messages a input, y la estructura de respuesta también cambia. Por eso la capa de acceso debe dividir los adaptadores por endpoint, en lugar de limitarse a cambiar el nombre del modelo.
Pasos completos para la migración
Para pasar de una invocación de un solo modelo a una estructura conmutable, sigue este orden:
- Extrae la configuración de enrutamiento: crea una tabla de configuración donde cada fila incluya el nombre de la tarea, el ID del modelo, el tipo de endpoint, el precio unitario de entrada, el de salida y el de lectura de caché. El código de negocio solo reconoce el nombre de la tarea.
- Escribe adaptadores por endpoint: implementa cuatro adaptadores —chat, Gemini nativo, messages y responses—; cada uno se encarga de convertir la entrada unificada en el cuerpo de solicitud correspondiente y de transformar la respuesta en una estructura unificada.
- Unifica la dirección base y la clave: todos los adaptadores comparten el mismo
base_urly la misma clave API; al cambiar de modelo no hace falta añadir gestión de claves. - Añade una cadena de respaldo: configura un modelo principal y uno de respaldo para las tareas críticas; por ejemplo,
gemini-4-carboncomo principal ygemini-4-hydrogencomo respaldo. Si el principal falla o se descontinúa, se usa automáticamente el de respaldo. - Seguimiento de costos: registra el ID del modelo y el consumo de tokens en cada llamada, estima el costo en tiempo real con los precios unitarios de la tabla de configuración y compara a fin de mes con la factura.
Ver campos de ejemplo de la tabla de configuración de enrutamiento
Una configuración de enrutamiento típica puede incluir estos campos: `task: «summary»`, `model: «gemini-4-carbon»`, `endpoint: «chat»`, `price_in: 2`, `price_out: 10`, `price_cache: 0.1`, `fallback: «gemini-4-hydrogen»`. Después del 1 de diciembre, solo tienes que actualizar `price_in` y `price_out` según la lista de modelos de la plataforma, o cambiar `model` y `endpoint`; el código de negocio no necesita modificarse en absoluto.
Para modelos con precios por tramos como `gpt-6.2-astra`, conviene añadir además `tier_threshold: 272000` y el campo correspondiente al precio del tramo superior; el módulo de seguimiento de costos determina en qué tramo cae según la cantidad de tokens de cada solicitud.
🚀 Inicio rápido: si aún no tienes un punto de entrada unificado, puedes registrarte primero en APIYI apiyi.com para obtener una clave API y crédito de prueba gratuito, probar Carbon, Hydrogen, Neon, Fable y Astra con una sola clave y luego decidir cómo configurar el enrutamiento.
Lista de verificación antes de la fecha límite
| Comprobación | Fecha límite recomendada | Descripción |
|---|---|---|
| Exportar el uso de noviembre | antes de 11-25 | Obtener las cifras reales de tokens de entrada, salida y lectura de caché |
| Calcular con las dos tarifas | antes de 11-26 | Calcular el costo mensual con el precio introductorio y el precio estándar |
| Probar los modelos candidatos | antes de 11-28 | Ejecutar un lote de solicitudes reales con cada endpoint recomendado |
| Publicar la configuración de enrutamiento | antes de 11-30 | Incluir en la configuración los modelos principal y de respaldo, y los precios unitarios |
| Revisar los precios de la plataforma | después de 12-01 | Actualizar los precios unitarios según la lista de modelos de la plataforma |
Preguntas frecuentes (FAQ)
Q1: ¿Hasta qué fecha se aplica exactamente el precio introductorio de Gemini 4 Carbon?
Según la página de desarrolladores de Google, el precio introductorio se mantiene hasta el 2026-11-30. Durante ese periodo, la entrada cuesta `2`, la salida `10` y la lectura de caché `0.10`, en USD por millón de tokens. A partir del 2026-12-01 se aplica el precio estándar: entrada `4`, salida `20` y lectura de caché `0.20`.
Q2: ¿Cuánto costará Carbon en APIYI a partir de diciembre?
Actualmente, en el catálogo de APIYI, `gemini-4-carbon` tiene un precio de entrada de `2`, lectura de caché de `0.1` y salida de `10`, lo que corresponde al precio introductorio. Para conocer los precios posteriores al 1 de diciembre, consulta la lista de modelos de la plataforma. Este artículo no ofrece ninguna garantía sobre el precio de catálogo posterior; cuando finalice ese periodo, te recomendamos verificarlo directamente en APIYI, apiyi.com.
Q3: ¿Cuánto código hay que cambiar para pasar de Carbon a Hydrogen?
El cambio es mínimo. Ambos tienen el mismo endpoint recomendado: chat o nativo de Gemini. Si ya usas el endpoint chat, solo tienes que cambiar el campo `model` de `gemini-4-carbon` a `gemini-4-hydrogen`. Aun así, te recomendamos validar primero los resultados con solicitudes reales: un precio unitario más bajo no implica que la calidad en la tarea sea equivalente.
Q4: ¿Por qué no basta cambiar el nombre del modelo para pasar a Claude Fable o GPT Astra?
Porque el endpoint recomendado es diferente. `claude-fable-5-2` puede usar chat o messages; las capacidades nativas se aprovechan mejor mediante messages. Para `gpt-6.2-astra` se recomienda responses, y tanto los parámetros de solicitud como la estructura de respuesta son distintos de chat. Si solo cambias el nombre del modelo, lo habitual es encontrarte con campos no reconocidos o errores de análisis.
Q5: ¿Qué referencia se debe usar para el precio de Gemini 4 Neon?
En la tabla general de modelos de la versión 2026-11-19 no aparece la fila de Neon, pero sí está en la API de precios: equivale a `3` de entrada, `15` de salida y `0.15` de lectura de caché, en línea con el precio de lista de Google. Para presupuestar, puedes guiarte por la API de precios; el endpoint también es chat o nativo de Gemini.
Q6: ¿Cómo comparar rápidamente varios modelos candidatos con una sola clave API?
Te recomendamos usar una plataforma de agregación de APIs para unificar las pruebas:
1. Regístrate en APIYI, apiyi.com, para obtener una clave API y una cuota de prueba gratuita.
2. Configura la `base_url` del cliente con la dirección unificada y llama a cada modelo usando su endpoint recomendado.
3. Registra el consumo de tokens y la calidad de salida de cada modelo, y luego traslada esos datos a la tabla de recálculo de este artículo.
Q7: ¿Qué limitaciones tiene esta capa de integración intercambiable?
La capa de integración solo reduce el costo de cambio, no elimina las diferencias de resultados. Cada modelo puede interpretar una misma indicación de forma distinta, cumplir el formato de otra manera y comportarse de modo diferente según el nivel de razonamiento; después del cambio, siguen siendo necesarias las pruebas de regresión. Además, los modelos con precios por tramos (como Astra cuando supera los `272000` tokens) deben estimarse por separado, ya que una fórmula de costo unificada subestimaría las solicitudes con contexto largo.
Gemini 4 Carbon: puntos clave del fin del precio de lanzamiento
- Fecha de vencimiento clara: el precio introductorio se mantiene hasta el 2026-11-30; a partir del 1 de diciembre pasa al precio estándar
- El costo casi se duplica: los precios estándar de entrada, salida y lectura de caché son el doble de los introductorios
- El precio publicado no es una promesa: el precio actual de Carbon en APIYI corresponde al introductorio; tras el vencimiento, manda la lista de modelos
- Los endpoints no son iguales: Hydrogen y Neon usan chat o gemini, Fable usa chat o messages, y para Astra se recomienda responses
- Cambiar no siempre sale más barato: Hydrogen tiene un precio unitario bajo, mientras Fable y Astra lo tienen alto; hay que decidir combinando con la calidad de los resultados
- La configuración es la clave: el ID del modelo, el endpoint y el precio unitario entran todos en la configuración de enrutamiento; el código de negocio solo reconoce nombres de tarea
- Un punto de entrada unificado facilita la validación: con una sola Key de APIYI puedes probar varios modelos candidatos y luego decidir el enrutamiento
Resumen
Sobre el fin del precio introductorio de Gemini 4 Carbon, hay tres puntos centrales:
- Primero echa números: aplica los precios introductorio y estándar a tu consumo real, y verás que, después de diciembre, el costo para el mismo consumo será aproximadamente el doble.
- Luego revisa los endpoints: los endpoints recomendados para los modelos de reemplazo no son los mismos; antes de cambiar de modelo, confirma el formato de solicitud de chat, gemini, messages y responses.
- Por último, configura: concentra el ID del modelo, el tipo de endpoint y el precio unitario en la configuración de enrutamiento; la próxima vez que cambien precios o ventanas, solo modificarás la configuración, no el código.
Quedan 10 días hasta el 30 de noviembre, tiempo suficiente para exportar tu consumo, recalcular con ambos precios y probar los modelos candidatos. No amarres el negocio a un único modelo a un único precio: dejar en la capa de integración una puerta que permita cambiar es la preparación más sólida para la próxima sacudida.
Recomendamos integrar de forma unificada a través de APIYI apiyi.com, usando una sola Key para validar resultados y comparar costos entre varios modelos y endpoints.
📚 Referencias
-
Página para desarrolladores de Google: explicación de precios de Gemini: precios de introducción y precio estándar de Gemini 4 Carbon
- Enlace:
ai.google.dev - Descripción: fecha límite del precio de introducción y precio estándar vigente desde el 1 de diciembre
- Enlace:
-
Tabla general de modelos de APIYI: precio unitario de entrada, salida y lectura de caché de cada modelo
- Enlace:
docs.apiyi.com/models.md - Descripción: versión verificada el 2026-11-20, actualizada el 2026-11-19 10:59 (UTC+8)
- Enlace:
-
Interfaz de precios de APIYI: precios en tiempo real convertidos por multiplicador
- Enlace:
api.apiyi.com/api/pricing - Descripción: versión
shell-api-modelmak-v1, adecuada para leer precios unitarios de forma programática
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos en la página de inicio del sitio web de APIYI; las especificaciones de endpoints y parámetros de cada modelo están disponibles en el centro de documentación