Nota del autor: desglosamos las puntuaciones públicas de Gemini 4 Neon en tres bloques —programación, trabajo del conocimiento y ciencia—, indicamos la fuente de cada dato y te ayudamos a decidir qué tipo de tareas conviene delegarle.
El 2026-11-18, Google presentó Gemini 4 Neon. En su publicación de lanzamiento, Sundar Pichai lo resumió como un modelo que permite «terminar antes» en ingeniería de software compleja, trabajo del conocimiento y procesos científicos. Ese mismo día, DeepMind publicó la ficha del modelo y Artificial Analysis también sacó un artículo con mediciones de terceros y una página del modelo: de golpe, aparecieron varios conjuntos de datos públicos.
El problema es que esos conjuntos de cifras no usan el mismo criterio. El blog de Google contiene datos autoinformados por la propia compañía; la tabla comparativa de la ficha del modelo sí incluye Claude Opus 5.5 y GPT-6.2 Sol, pero las notas de evaluación aclaran que los resultados de modelos que no son Gemini se toman por defecto de lo que declara cada fabricante; solo Artificial Analysis aporta mediciones de terceros. En este artículo, con el 2026-11-19 como fecha de verificación de datos, conservamos la etiqueta de fuente para cada punto y colocamos lado a lado las cifras que no coinciden entre ambos conjuntos, sin promediarlas.
Valor clave: al terminar, tendrás una tabla organizada por tipo de tarea que te dirá, dentro de los tres bloques de programación, lectura de documentos y ciencia, en cuáles Gemini 4 Neon ocupa el primer lugar según la fuente oficial, en cuáles la ficha del modelo muestra a los rivales por delante y en cuáles, según la medición de terceros, la ventaja es de apenas 1 punto.
Puntos clave de Gemini 4 Neon: primero el punto de entrada, luego el desglose en tres bloques
La puntuación global es el número que la mayoría ve primero. El artículo de Artificial Analysis muestra que Gemini 4 Neon, en el nivel de pensamiento xhigh, obtiene una puntuación de inteligencia de 61 y ocupa el 3.º puesto general; por delante quedan GPT-6.2 Astra (max) y Claude Fable 5.2 (max). El blog de Google (autodeclaración oficial) también indica 61 y el 3.º puesto, y añade que «queda por detrás de modelos más grandes y más lentos». La columna AA Index v5.0.1 de la ficha del modelo también señala 61; a modo de comparación, Opus 5.5 obtiene 59 y Sol, 57.
Ese 61 coincide en las tres fuentes, pero es solo un punto de entrada. La puntuación global mezcla programación, lectura de materiales y ciencia, mientras que el trabajo que tienes que entregar normalmente pertenece solo a una de esas partes. La siguiente tabla aclara primero la naturaleza de los tres tipos de fuentes; después iremos desglosando bloque por bloque en las secciones siguientes.
| Fuente | Naturaleza | Para qué la usamos en este artículo |
|---|---|---|
| Blog de Google | Autodeclaración oficial | Qué apartados Google presenta como primeros y las puntuaciones de cada uno |
| Ficha del modelo de DeepMind | Resumen oficial; los resultados que no son de Gemini suelen ser autodeclarados por cada proveedor | Comparación punto por punto entre las tres columnas Neon, Opus 5.5 y Sol |
| Artículo de Artificial Analysis | Medición de terceros | Coding Agent Index, GDP.pdf, MKA, etc. |
| Página del modelo de Artificial Analysis | Medición de terceros, desglosada por nivel de pensamiento | Diferencias de puntuación de inteligencia entre los cuatro niveles de pensamiento |
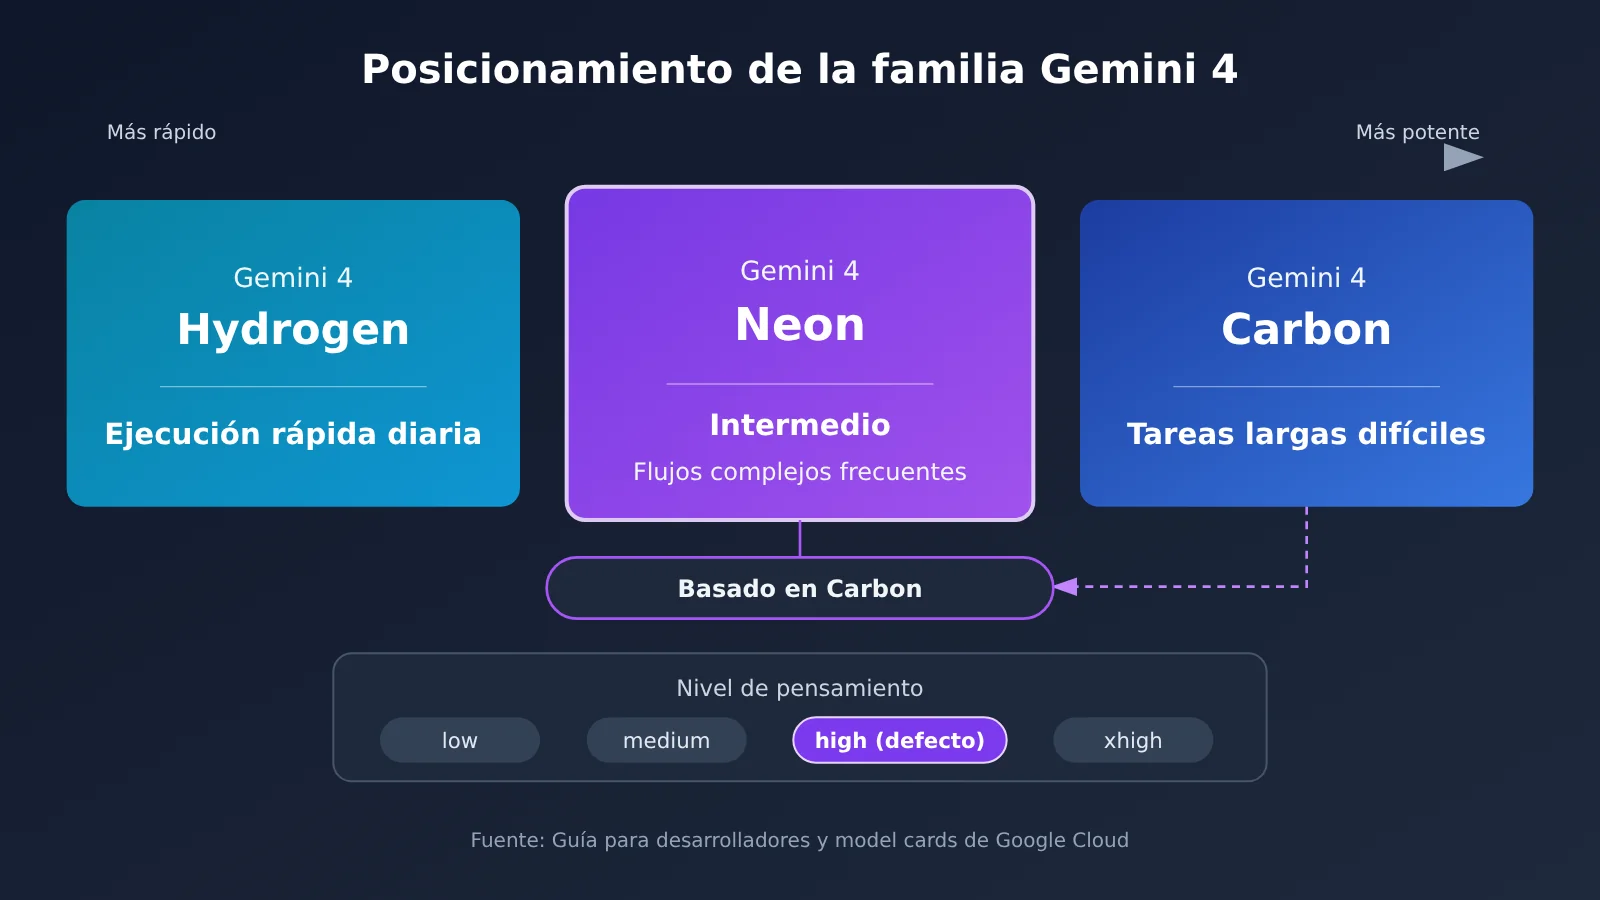
La posición de Gemini 4 Neon dentro de la familia
La ficha del modelo indica que Gemini 4 Neon está adaptado de Gemini 4 Carbon, tiene un corte de conocimiento en marzo de 2026 y admite como entrada texto, imágenes, audio y vídeo, con una ventana unificada de hasta 1 millón de tokens. La guía para desarrolladores de Google Cloud lo sitúa entre Hydrogen (ciclo rápido diario) y Carbon (tareas complejas de largo recorrido), y el blog oficial también señala que está pensado para procesos complejos de alta frecuencia.
Entender esta posición ayuda a interpretar las puntuaciones que vienen después. Los objetos de comparación de Neon varían según la fuente: la ficha del modelo solo incluye las dos columnas Opus 5.5 y Sol; no incluye Fable 5.2, Astra ni Carbon. Artificial Analysis, en cambio, lo compara principalmente con Carbon, Fable y Opus. Al comparar apartado por apartado, este artículo no tomará prestadas otras celdas para rellenar huecos.
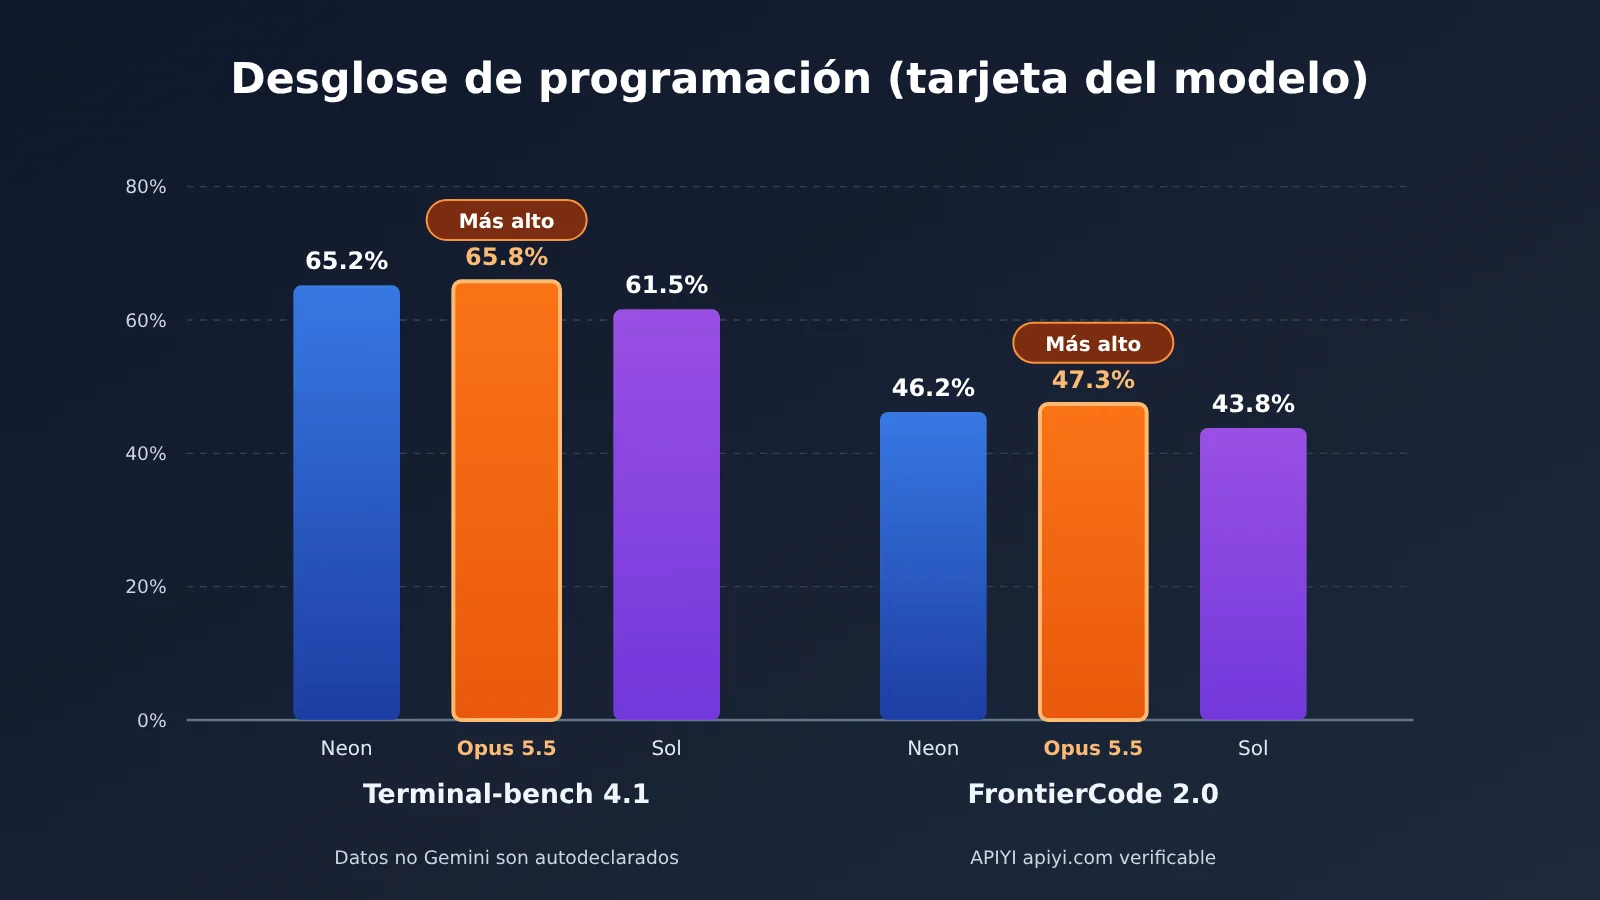
Capacidad de programación de Gemini 4 Neon: lidera en dos aspectos y Opus lo supera ligeramente en otros dos
La programación es el área a la que el blog de Google dedica más espacio. Según las cifras que Google reporta, Gemini 4 Neon obtiene 58.6 en el Artificial Analysis Coding Agent Index, primer puesto global. El artículo de Artificial Analysis da la cifra de 59, medida con Neon xhigh en Antigravity CLI. 58.6 y 59 provienen de dos fuentes distintas, así que aquí conservamos ambas.
El margen de liderazgo en la evaluación de terceros conviene analizarlo por separado. En el artículo de Artificial Analysis, Fable xhigh en Claude Code y Opus 5.5 max obtienen 58; Carbon high, 55. Es decir, Neon aventaja a estos dos modelos Claude por 1 punto.
Las métricas de la ficha del modelo son más detalladas, y en dos de ellas Opus 5.5 queda por delante.
| Prueba de programación (ficha del modelo) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | No disponible |
| Terminal-bench 4.1 (ajuste por trampas) | 65.2% | 65.8% | 61.5% |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% |
| SWE-sweep harness del fabricante | 39.0% | 10.1% | 8.3% |
| SWE-sweep mini-SWE harness | 12.8% | 3.6% | 11.6% |
Cómo interpretar las puntuaciones de programación de Gemini 4 Neon
En Terminal-bench 4.1, Opus 5.5 obtiene 65.8% y Neon, 65.2%; en FrontierCode 2.0, Opus 5.5 obtiene 47.3% y Neon, 46.2%. Ambas diferencias rondan un punto porcentual, pero en ambos casos Opus queda ligeramente por delante. En el blog oficial, el 46.2% de FrontierCode 2.0 aparece marcado como el nivel high predeterminado.
Las dos cifras de SWE-sweep son las más fáciles de interpretar mal. El 12.8% corresponde al resultado con el harness mini-SWE, mientras que el 39.0% corresponde a Google Antigravity (harness del fabricante). El blog oficial describe la diferencia entre ambos como un desbloqueo aportado por el harness; refleja el efecto de la cadena de herramientas y no debe interpretarse como que el modelo en sí rinde tres veces mejor. Conviene notar también que, con el harness mini-SWE, Sol obtiene 11.6%, muy cerca del 12.8% de Neon.
Gemini 4 Neon en el trabajo de conocimiento: lidera en la mayoría, pero en Chartography gana Sol
En el ámbito del trabajo de conocimiento, el blog oficial enumera varios “n.º 1”. Legal Research Bench y Tax Agent Bench se presentan ambos como n.º 1, pero el blog no ofrece porcentajes para ninguno de los two. En Surge, las tareas de finanzas, contabilidad, modelado de hojas de cálculo y restricciones complejas también se anuncian como n.º 1 en su mayoría, aunque de nuevo no se dan puntuaciones por ítem. Estos datos solo pueden registrarse como clasificaciones autodeclaradas por la compañía; este artículo no añade cifras.
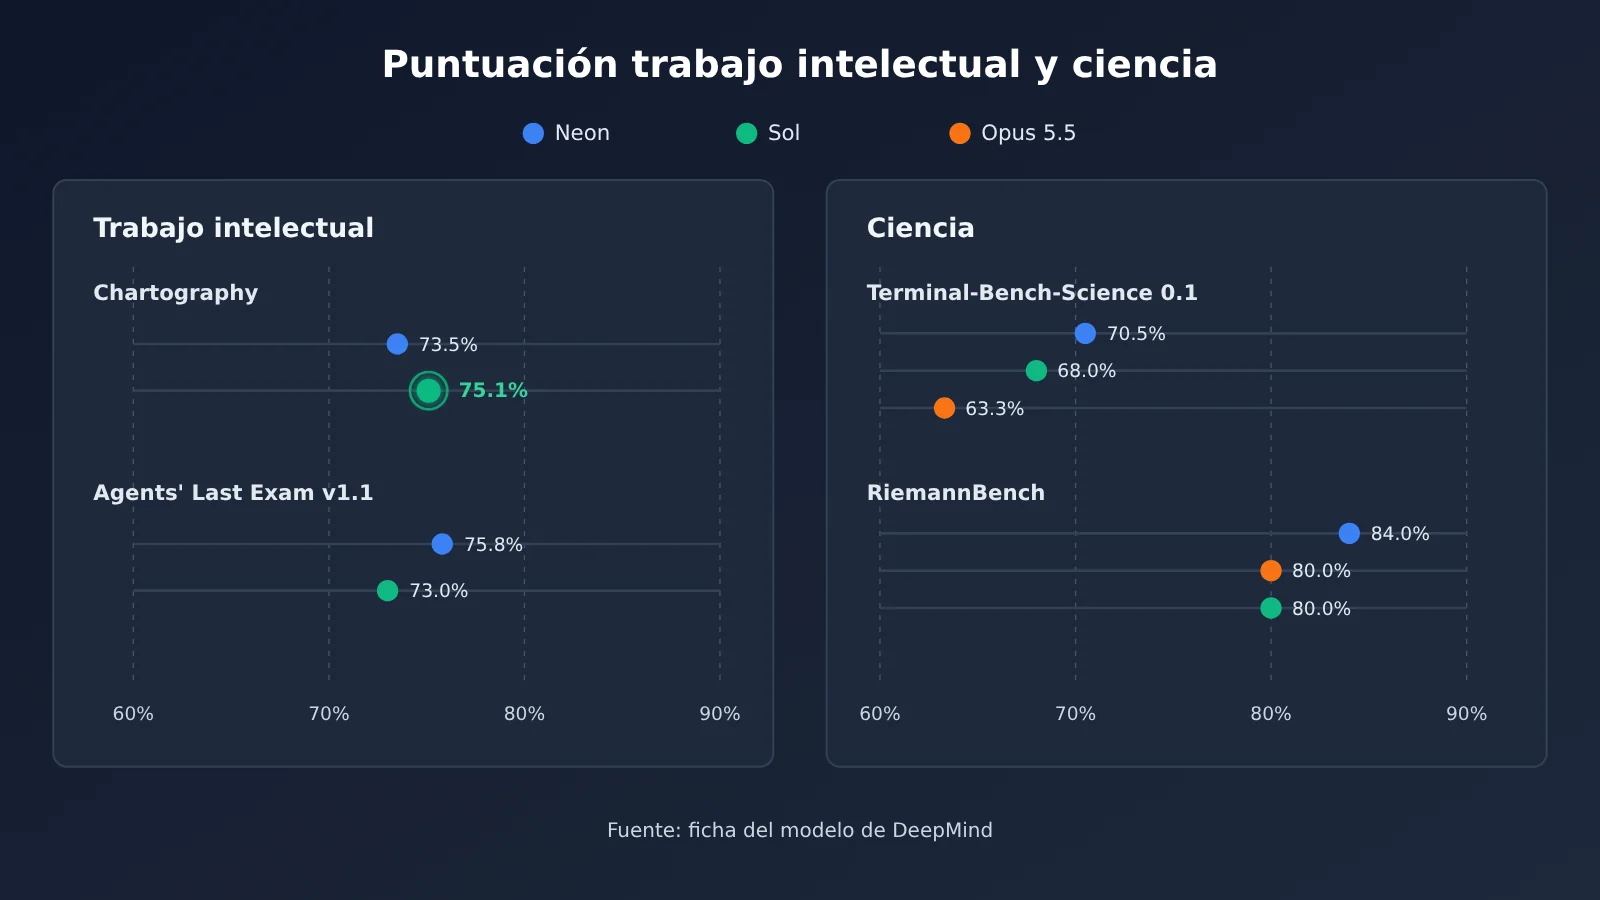
Los ítems con puntuación se pueden contrastar con la ficha del modelo. Zapier AutomationBench figura como n.º 1 en el blog oficial, con 56.3%; Andon Labs Vending-Bench 2 aparece como n.º 1, con 16843 dólares. Chartography es la única subcategoría de este bloque en la que Sol obtiene una puntuación más alta: Sol 75.1%, Neon 73.5%.
Las mediciones de terceros aportan más detalles. Un artículo de Artificial Analysis muestra que, en GDP.pdf, Neon high obtiene 33.4%, Neon xhigh cae a 28.0% y Carbon high obtiene 28.4%; esto indica que subir el nivel de razonamiento no siempre se traduce en una puntuación más alta. En AA-Briefcase, Neon xhigh alcanza una puntuación total de 1700 Elo y 1771 Elo en calidad de presentación, por encima de 1726 de Claude Sonnet 5.5 max. En el ítem MKA, el artículo de Artificial Analysis indica que Neon alcanza 56%, cerca del 57% de Fable max y 2 puntos por encima de Carbon; la ficha del modelo indica 56.5%. Ambas cifras se conservan.
Capacidades científicas de Gemini 4 Neon: tres pruebas que la propia compañía califica como best in class
De las tres áreas, la de ciencia es en la que el lenguaje oficial es más contundente. En el blog de Google se afirma que Terminal-Bench Science (70.5%), RiemannBench (84.0%) y HLE-Diamond (71.3%) son best in class; son datos autoinformados por la compañía. La tabla comparativa de la ficha del modelo coincide con esas cifras: Neon supera a Opus 5.5 y a Sol en las tres pruebas, pero la columna de comparación también es una recopilación de datos autoinformados por cada fabricante.
| Conocimiento y ciencia (ficha del modelo) | Gemini 4 Neon | Claude Opus 5.5 | GPT-6.2 Sol |
|---|---|---|---|
| AutomationBench | 56.3% | 42.5% | 41.3% |
| Agents’ Last Exam v1.1 | 75.8% | 71.6% | 73.0% |
| Chartography | 73.5% | 66.3% | 75.1% |
| LVBench | 89.0% | 83.7% | 87.6% |
| GraphWalks (256k–1M, BFS F1) | 95.2% | 66.8% | 80.1% |
| MKA Climb WSR | 56.5% | 53.0% | 52.7% |
| RiemannBench | 84.0% | 80.0% | 80.0% |
| Terminal-Bench-Science 0.1 | 70.5% | 63.3% | 68.0% |
| HLE-Diamond | 71.3% | 67.9% | 64.0% |
GraphWalks alcanza 95.2% en el intervalo de contexto largo de 256k a 1M, una diferencia bastante amplia frente al 66.8% de Opus 5.5; conviene prestarle especial atención en escenarios que implican leer materiales muy extensos. En Terminal-Bench-Science, Sol obtiene 68.0%, solo 2.5 puntos porcentuales por debajo del 70.5% de Neon, la diferencia más pequeña entre las tres pruebas científicas.
Gemini 4 Neon por tarea: una tabla resumen
Si reunimos los tres bloques y los ordenamos según tres situaciones — «la fuente oficial dice que es primero», «la tarjeta del modelo muestra que el rival es superior» y «el tercero solo aventaja por 1 punto» — obtenemos la siguiente tabla ordenada por tarea. No responde a quién es el más fuerte en general, solo te dice sobre qué evidencia se apoya la puntuación de cada tipo de tarea.
| Tipo de tarea | La fuente oficial se autoproclama primera | La tarjeta del modelo muestra al rival superior | Diferencia de 1 punto en terceros |
|---|---|---|---|
| Programación | Coding Agent Index 58.6, 1.º en total | Terminal-bench 4.1, FrontierCode 2.0: Opus 5.5 es superior | Coding Agent Index 59 frente al 58 de Fable xhigh y Opus 5.5 max |
| Trabajo de conocimiento | Legal Research Bench, Tax Agent Bench, AutomationBench, Vending-Bench 2 | Chartography: Sol es superior | MKA 56 % frente al 57 % de Fable max (Neon, 1 punto por debajo) |
| Ciencia | Terminal-Bench Science, RiemannBench, HLE-Diamond | Ninguno | No hay puntuación científica de terceros desglosada |
| Entrada global | Vals Index, 2.º (70.9 %) | Ninguno | Puntuación de inteligencia AA: 61, 1 punto por encima de Carbon high |
Análisis de ventajas y desventajas de Gemini 4 Neon
Ventajas
- Liderazgo consistente en las tres pruebas científicas: tanto el informe oficial como la tarjeta del modelo muestran que Terminal-Bench Science, RiemannBench y HLE-Diamond están por encima de los dos modelos de comparación.
- Lectura sólida en contextos largos: la tarjeta del modelo indica un BFS F1 de 95.2 % en GraphWalks para el rango de 256k–1M, lo que corresponde a una ventana unificada de 1 millón de tokens.
- Amplificación clara de la cadena de herramientas: SWE-sweep alcanza 39.0 % bajo el harness del fabricante, lo que indica que el rendimiento mejora bastante cuando se combina con entornos de agentes como Antigravity.
- Entradas multimodales completas: la tarjeta del modelo especifica compatibilidad con entradas de texto, imagen, audio y vídeo; la página del modelo en Artificial Analysis muestra que Opus 5.5 solo acepta texto e imagen.
Limitaciones
- No es el primero en todas las pruebas de programación: en Terminal-bench 4.1 y FrontierCode 2.0, Opus 5.5 obtiene algo más; para tareas de terminal puro o de código de vanguardia conviene probar ambos.
- En comprensión de gráficos hay un rival superior: Sol obtiene más en Chartography; para tareas de informes con muchos gráficos, vale la pena incluir a Sol en la comparación.
- El nivel alto no garantiza una puntuación mayor: en el artículo de Artificial Analysis, xhigh en GDP.pdf queda por debajo de high; los niveles de pensamiento deben ajustarse según la tarea.
- Restricciones de parámetros bastante estrictas: la guía para desarrolladores indica que pasar
thinking_budgetoMINIMALdevuelveHTTP 400; no se admite el caché de contexto explícito y solo funciona el caché implícito de prefijos compartidos de más de 4096 tokens.
Sobre precio y velocidad, este artículo solo deja una frase: la comparación del coste por tarea con Carbon tiene métricas distintas, como el 32 % menos que Google declara y el aproximadamente 17 % menos del artículo de Artificial Analysis; eso se deja para la entrega especializada en precios. La latencia y la velocidad de salida de cada nivel de pensamiento se dejan para la entrega sobre velocidad.
Inicio rápido con Gemini 4 Neon: primero define la tarea, luego el nivel de pensamiento
Se recomienda seguir un orden de inicio en tres pasos: primero selecciona el tipo de tarea según la tabla general de arriba, luego elige el nivel de pensamiento, y finalmente consulta la tabla general de APIYI para verificar si los modelos de la familia Gemini 4 ya publicados son suficientes.
- Elige el tipo de tarea: para razonamiento científico y lectura de materiales extensos, prioriza las fortalezas de Neon; para programación en terminal y comprensión de gráficos, incluye también Opus 5.5 o Sol como candidatos.
- Elige el nivel de pensamiento: la guía para desarrolladores indica que Neon solo tiene cuatro niveles:
low,medium,highyxhigh, conhighcomo predeterminado. La página del modelo en Artificial Analysis muestra que las puntuaciones de inteligencia de los cuatro niveles son 44, 55, 60 y 61 respectivamente; la diferencia entrehighyxhighes solo 1 punto, y en GDP.pdfhighes incluso superior, así que para la mayoría de las tareas basta empezar con el nivel predeterminado. - Verifica los modelos disponibles: para tareas de orquestación puedes seguir el enfoque de la guía para desarrolladores, asignando el control principal a un modelo fuerte y las subtareas rápidas a
gemini-4-hydrogen; para las tareas de largo recorrido más difíciles, consultagemini-4-carbon.
En cuanto a la dirección de invocación, para la interfaz compatible con OpenAI configura base_url como https://api.apiyi.com/v1; para la interfaz nativa de Gemini usa https://api.apiyi.com y selecciona la versión v1beta. La clave se lee desde una variable de entorno, por ejemplo APIYI_API_KEY; no escribas la clave en texto plano en el código. Al invocar, basta poner gemini-4-carbon o gemini-4-hydrogen en model; ambos tienen endpoints chat y gemini en la tabla general de APIYI.
La siguiente tabla muestra los modelos que se pueden usar como referencia en la tabla general de APIYI actualizada el 2026-11-16 (docs.apiyi.com/models.md) y en la interfaz de precios consultada el 2026-11-19 (api.apiyi.com/api/pricing, 285 modelos en total), con unidades en dólares por millón de tokens.
| ID del modelo | Entrada | Lectura de caché | Salida | Plataforma disponible |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | Tabla general de APIYI, interfaz de precios |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | Tabla general de APIYI, interfaz de precios |
claude-opus-5-5 |
4 | 0.2 | 20 | Tabla general de APIYI, interfaz de precios |
gpt-6.2-sol |
2 (3 para entradas de más de 272000 tokens) | 0.1 | 10 (aproximadamente 11.25 en el nivel alto de la interfaz de precios) | Tabla general de APIYI, interfaz de precios |
El 2/10 de gemini-4-carbon es el precio de catálogo actual de APIYI, que corresponde al precio introductorio de Google hasta el 2026-11-30. El precio listado de Gemini 4 Neon en la página de precios de Google AI Studio es de 3.00 de entrada y 15.00 de salida en dólares por millón de tokens, sin nivel gratuito; aún no aparece ni en la tabla general de APIYI ni en la interfaz de precios. Todavía no está publicado; lo publicaremos lo antes posible. Los modelos y precios están sujetos a la lista de modelos de la plataforma.
🚀 Sugerencia para empezar: antes de que Neon esté disponible, puedes usar la misma clave a través de APIYI apiyi.com para invocar por separado
gemini-4-carbon,claude-opus-5-5ygpt-6.2-sol, ejecutando cada una de tus tareas de programación o informes, para primero determinar qué tipo de tareas requiere capacidades de nivel Neon.
Preguntas frecuentes FAQ
Q1: ¿Cuál es el posicionamiento de Gemini 4 Neon?
Es la opción de gama media de la familia Gemini 4 que Google lanzó el 2026-11-18. Está adaptada de Carbon y la guía para desarrolladores la sitúa entre Hydrogen y Carbon. El blog oficial indica que está orientada a flujos complejos de alta frecuencia. El ID del modelo es `gemini-4-neon`.
Q2: Gemini 4 Neon tiene 61 puntos globales, ¿en qué puesto queda?
El artículo de Artificial Analysis muestra 61 puntos en el nivel xhigh y el tercer puesto global; por delante están GPT-6.2 Astra (max) y Claude Fable 5.2 (max). El 61 del blog de Google y de la model card coincide, pero la puntuación global solo sirve como punto de entrada: las puntuaciones por apartado deben interpretarse según la tarea.
Q3: Coding Agent Index es 58.6 o 59?
Ambos son correctos, pero provienen de fuentes distintas. 58.6 es la cifra del blog de Google (reportada por la propia empresa); 59 es la cifra del artículo de Artificial Analysis, medida con Neon xhigh en Antigravity CLI. No deben combinarse ni promediarse.
Q4: El 12.8% y el 39.0% de SWE-sweep difieren tanto, ¿qué significa?
Son resultados de dos harness distintos: 12.8% viene del harness mini-SWE y 39.0% de Google Antigravity. El blog oficial atribuye la diferencia al efecto desbloqueador del harness; a la hora de elegir, fíjate en el entorno de agente que realmente vas a usar.
Q5: ¿En qué pruebas otros modelos superan a Gemini 4 Neon?
En la model card, Claude Opus 5.5 está ligeramente por delante en Terminal-bench 4.1 y FrontierCode 2.0, y GPT-6.2 Sol lo está en Chartography. En el artículo de Artificial Analysis, MKA de Fable max es 57%, por encima del 56% de Neon.
Q6: ¿Se puede invocar Gemini 4 Neon por API ahora?
Por parte de Google, ya está disponible en canales como Gemini API de AI Studio. La tabla general y la API de precios de APIYI apiyi.com todavía no incluyen `gemini-4-neon`; aún no está listado, pero lo incorporaremos lo antes posible. El modelo y el precio se rigen por la lista de modelos de la plataforma.
Q7: ¿Qué modelo puedo usar como alternativa para probar antes de que esté disponible?
En APIYI apiyi.com puedes usar la dirección compatible con OpenAI `https://api.apiyi.com/v1` para invocar `gemini-4-carbon` o `gemini-4-hydrogen`; con la misma clave API también puedes cambiar a `claude-opus-5-5` y `gpt-6.2-sol` para comparar lado a lado. Los nuevos usuarios tienen cuota de prueba gratuita.
Q8: ¿Qué restricciones tiene la invocación de Gemini 4 Neon?
La guía para desarrolladores especifica: solo hay cuatro niveles de pensamiento, de `low` a `xhigh`; si pasas `thinking_budget` o `MINIMAL`, devuelve `HTTP 400`; no admite caché de contexto explícita; el límite unificado es 1048576 tokens, incluidos entrada y salida, y la salida máxima predeterminada por segmento es 65536.
Gemini 4 Neon: puntos clave
- La puntuación global es solo el punto de entrada: la puntuación de inteligencia AA de 61 y el 3.er puesto coinciden en tres fuentes, pero la elección del modelo debe seguir desglosándose por tarea.
- En programación, Opus 5.5 supera dos métricas: según la ficha del modelo, Terminal-bench 4.1 y FrontierCode 2.0 son ligeramente superiores en Opus 5.5.
- En programación, la medición de terceros lidera por 1 punto: Coding Agent Index 59 frente a 58 de Fable xhigh y Opus 5.5 max.
- En trabajo de conocimiento lidera en la mayoría: en Chartography, Sol es superior; en GraphWalks, la ventaja en contexto largo es la más evidente.
- En ciencia, tres métricas se presentan oficialmente como best in class: en la comparación de la ficha del modelo también lidera, pero los datos de los competidores son declarados por cada empresa.
- El nivel de razonamiento empieza en high: high y xhigh solo se diferencian en 1 punto de inteligencia, y en GDP.pdf high es superior.
- Para empezar, prueba primero los modelos ya disponibles: antes de que Neon esté disponible, puedes ejecutar tareas primero con Carbon y Hydrogen en APIYI apiyi.com.
Resumen
Para ver hasta dónde llega Gemini 4 Neon, conviene dividirlo en tres bloques:
- Programación: según los datos oficiales, es primero en Coding Agent Index; en la medición de terceros solo lidera por 1 punto, y en la ficha del modelo Opus 5.5 es ligeramente superior en dos métricas.
- Trabajo de conocimiento: lidera en la mayoría, incluidos AutomationBench y GraphWalks de contexto largo; en Chartography, Sol es superior.
- Ciencia: tres métricas se presentan oficialmente como best in class y, en la comparación de la ficha del modelo, lidera de forma consistente; es el bloque con la evidencia más ordenada de los tres.
Mi recomendación es que primero clasifiques tu tarea en una de estas categorías y luego consultes la tabla general de este artículo para decidir si necesitas Neon. Antes de que Neon esté disponible, puedes usar APIYI apiyi.com para llamar a Gemini 4 Carbon, Hydrogen, Opus y Sol mediante una interfaz unificada y compararlos; cuando gemini-4-neon esté disponible, solo tendrás que sustituir el ID del modelo y volver a probar.
📚 Referencias
-
Blog de Google – Presentamos Gemini 4 Neon: publicación oficial y puntajes autoinformados
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descripción: clasificación, puntajes de programación y ciencia autoinformados oficialmente
- Enlace:
-
Ficha de modelo de DeepMind – Gemini 4 Neon: tabla comparativa de tres columnas y especificaciones del modelo
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon/ - Descripción: puntajes detallados de Neon, Opus 5.5 y Sol; los resultados que no son de Gemini provienen por defecto de lo reportado por cada proveedor
- Enlace:
-
Guía para desarrolladores de Google Cloud – Gemini 4 Neon: parámetros y restricciones de invocación
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descripción: niveles de razonamiento, límite de tokens, caché y códigos de error
- Enlace:
-
Artículo de Artificial Analysis – Ganancia de inteligencia de Gemini 4 Neon: medición de terceros
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descripción: Coding Agent Index 59, GDP.pdf, MKA, etc.
- Enlace:
-
Página de modelo de Artificial Analysis – Gemini 4 Neon: índices desglosados por nivel de razonamiento
- Enlace:
artificialanalysis.ai/models/gemini-4-neon - Descripción: comparación de puntajes de inteligencia en cuatro niveles
- Enlace:
-
Tabla general de modelos de APIYI: modelos disponibles y precios
- Enlace:
docs.apiyi.com/models.md - Descripción: los modelos y precios están sujetos a la lista de modelos de la plataforma
- Enlace:
Autor: equipo técnico de APIYI
Contacto técnico: no dudes en contactarnos desde la página de inicio del sitio web de APIYI; para más recursos, visita el centro de documentación en docs.apiyi.com