El equipo Tongyi de Alibaba lanzó Qwen4-Max el 2026-11-16 por la mañana. Tiene 2.4T de parámetros en el modelo principal y una ventana de contexto de 1M; además, publicó una imagen comparativa con 16 benchmarks.
Primero la conclusión: donde Qwen4-Max realmente lidera es en eficiencia de tokens y en la entrega de tareas de largo horizonte; no es el primero en todas las categorías. De los 16 benchmarks autodeclarados por el fabricante, consigue 4 primeros puestos y 4 segundos; en operaciones de terminal, construcción de programas, comprensión de gráficos y comprensión de video, sigue claramente por detrás de los principales rivales que aparecen en el mismo gráfico.
Este artículo se basa solo en tres tipos de fuentes: los materiales oficiales del lanzamiento del 2026-11-16, la instantánea de la clasificación final del ranking público de arena.ai Code Arena WebDev (2026-11-14), y los precios publicados en QwenCloud y en la plataforma Qwen AI. Los detalles de parámetros no publicados y los resultados de replicación por terceros quedan fuera del alcance de este artículo. Si ahora mismo estás usando Qwen3.8-Max u otro modelo insignia, después de leerlo puedes evaluar si cambiar según tres tipos de tareas, y hacer tus propias cuentas con el precio de entrada, el precio de salida y el precio de caché.
Información rápida sobre el lanzamiento de Qwen4-Max
| Elemento | Detalle |
|---|---|
| Fecha de lanzamiento | 2026-11-16 10:01 (UTC+8) |
| Emisor | Equipo Tongyi Qianwen (Qwen) de Alibaba |
| Escala de parámetros | 2.4T de parámetros en el tronco principal, 71B activados por token, más 328B de parámetros de Embedding N-gram |
| Contexto | 1M, visión nativa |
| Canales oficiales | API de QwenCloud, Qwen Studio, QwenWork, Qoder, app Qianwen |
| Plan de código abierto | La compañía señala que las versiones más pequeñas de Qwen4 se abrirán en pesos; para Max no se menciona código abierto |
Viendo el ritmo del anuncio, está claro que esta vez no se trata solo de actualizar un modelo de API. Qwen4-Max entró al mismo tiempo en dos productos propios, QwenWork (ofimática) y Qoder (programación), y los materiales oficiales ponen el acento en las tareas largas de agentes y en la entrega para industrias concretas, dejando la capacidad de pura conversación en segundo plano.
Los tres cambios en la arquitectura de Qwen4-Max
El blog oficial enumera tres cambios estructurales; a continuación explico, uno por uno, qué problema resuelve cada uno:
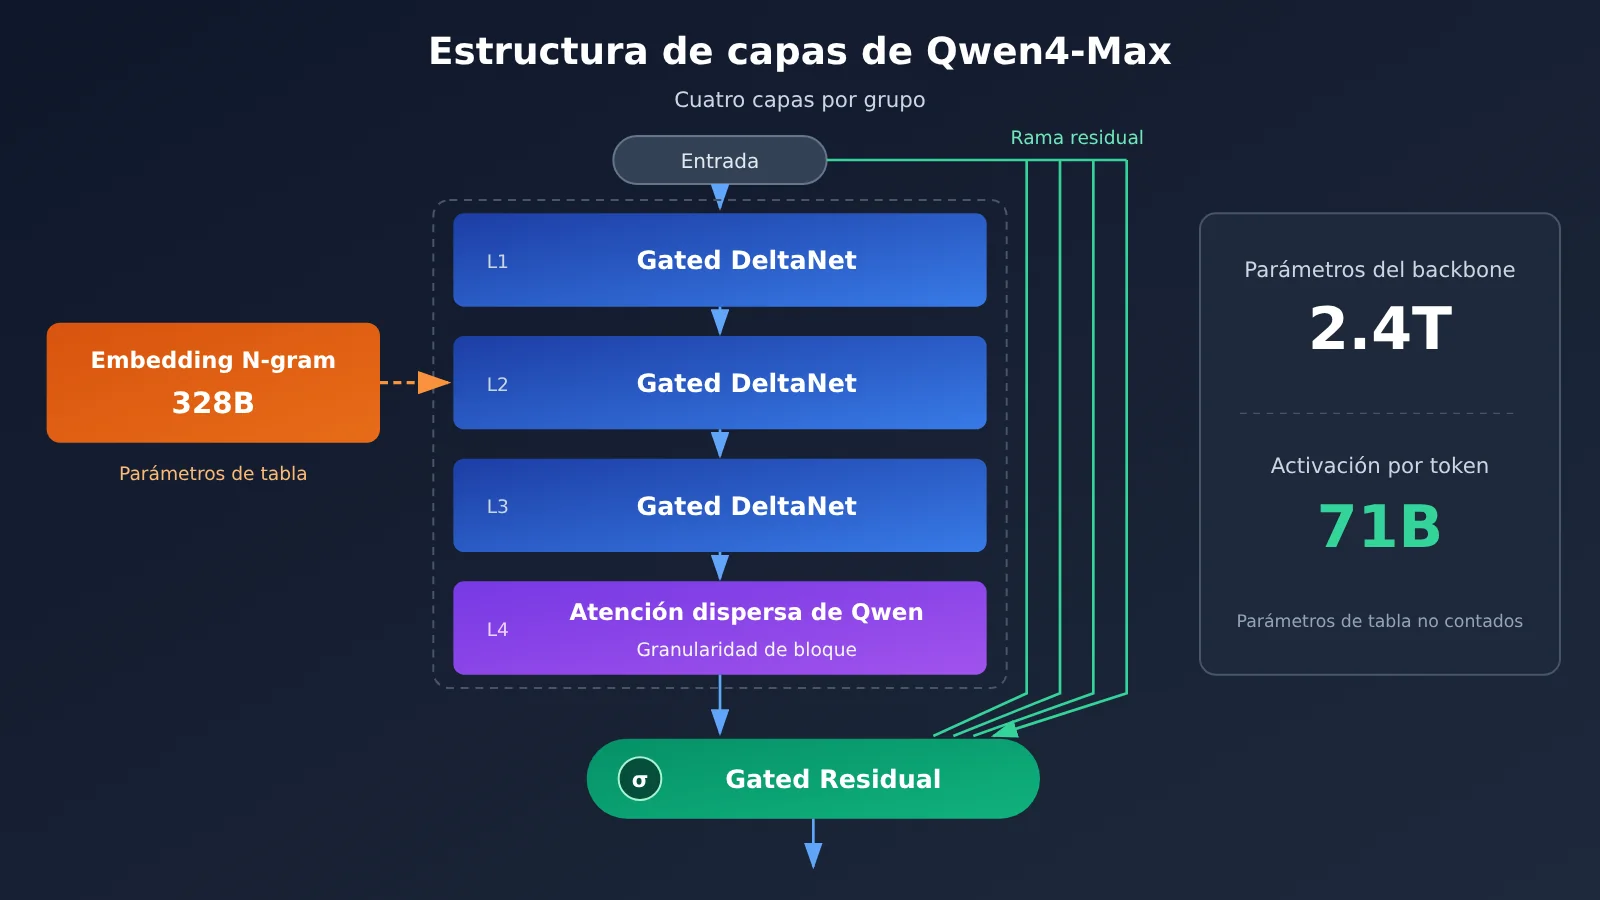
- Atención híbrida GDN + QSA: de cada cuatro capas, tres usan Gated DeltaNet y la otra usa Qwen Sparse Attention, seleccionando el contexto a nivel de bloque. El objetivo principal de esta organización es reducir el costo de cómputo con contextos largos de 1M.
- Gated Residual: la ruta residual se divide en cuatro ramas paralelas que luego se combinan mediante compuertas, lo que sirve para mejorar la capacidad de expresión de las redes profundas.
- Embedding N-gram: en la segunda capa se consulta una tabla para complementar los patrones locales de tokens. De ahí vienen los 328B de parámetros adicionales, que son parámetros de tabla de consulta y no participan en el cálculo de activación de cada token.
Conviene tener en cuenta que 2.4T es el total de parámetros del tronco principal, mientras que por token se activan realmente 71B. A la hora de comparar el «tamaño de parámetros» con otros modelos, primero hay que confirmar que ambos usan la misma medida.
Especificaciones y protocolos de Qwen4-Max
| Elemento de especificación | Qwen4-Max |
|---|---|
| Ventana de contexto | 1M |
| Entrada máxima | 991K (983K en modo de razonamiento) |
| Salida máxima | 393K |
| Cadena de pensamiento máxima | 262K |
| TPM | 5 millones |
| Protocolos compatibles | OpenAI Chat Completions, Responses, Anthropic Messages, DashScope |
reasoning_effort por defecto |
high (en Qwen3.8-Max el valor por defecto es xhigh) |
La última fila se pasa por alto con facilidad. El nivel de razonamiento por defecto de Qwen4-Max es high, un escalón por debajo del xhigh que traía la generación anterior. Si comparas las dos generaciones usando directamente los parámetros por defecto, parte del ahorro de tokens que ves viene de la diferencia de nivel y no enteramente del modelo en sí. A la hora de hacer pruebas A/B, conviene fijar reasoning_effort explícitamente en el mismo valor.
Qwen4-Max: 16 benchmarks oficiales, en qué lidera y en qué queda atrás
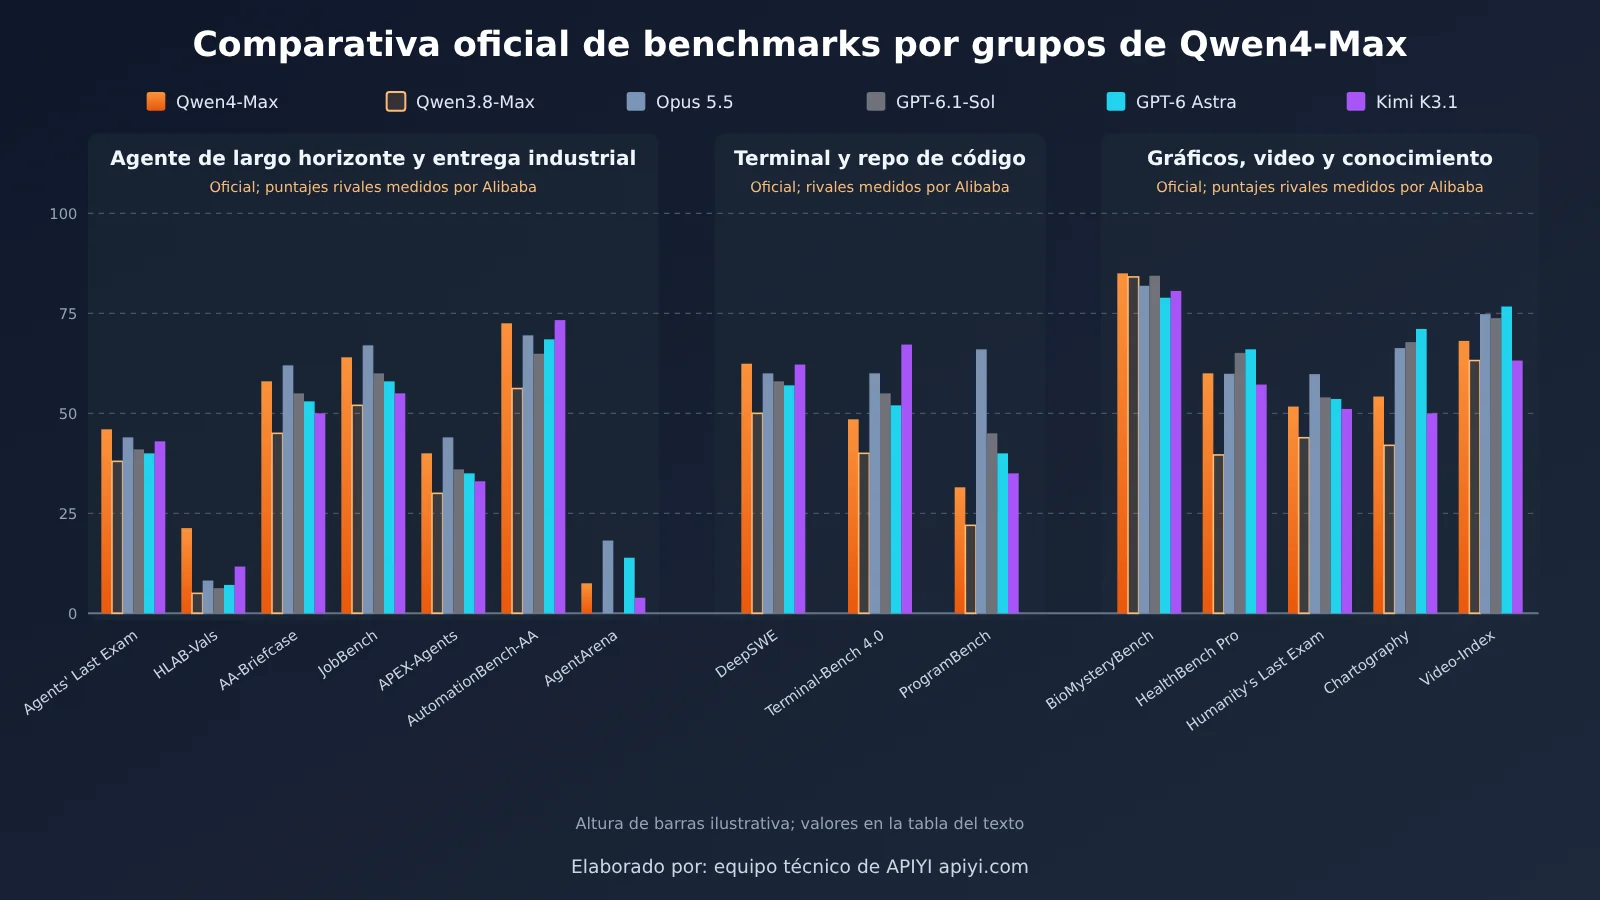
Todas las cifras de la tabla salen de la misma imagen publicada oficialmente: son datos declarados por el propio fabricante. Las puntuaciones de los rivales que aparecen en esa imagen también las ha medido Alibaba, así que no conviene tomarlas como resultados oficiales publicados por Anthropic, OpenAI o Moonshot AI. En concreto, CodeArena y AgentArena proceden de LM Arena; AA-Briefcase y AutomationBench-AA, de Artificial Analysis; APEX-Agents, del ranking de Mercor; y JobBench lo ha evaluado Alibaba con un conjunto de datos y un código de evaluación actualizados.
| Benchmark | Qwen4-Max | Qwen3.8-Max-0902 | Opus 5.5 | GPT-6.1-Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 75.7 | 69.3 | 74.2 | 75.2 | 74.1 | 75.5 |
| CodeArena WebDev (Elo) | 1750 | 1676 | 1816 | 1742 | 1763 | 1686 |
| Terminal-Bench 4.0 | 48.5 | 38.9 | 59.6 | 56.1 | 59.1 | 67.2 |
| ProgramBench | 31.5 | 28.0 | 65.0 | 52.5 | 55.0 | 25.0 |
| AA-Briefcase v1.1 (Elo) | 1686 | 1605 | 1801 | 1555 | 1569 | 1674 |
| Agents’ Last Exam v1.1 | 46.7 | 27.9 | 43.4 | 42.6 | 43.4 | No indicado |
| JobBench | 68.5 | 65.3 | 75.4 | 66.2 | 66.1 | 61.2 |
| APEX-Agents v1.1 | 72.1 | 63.3 | 73.5 | 60.0 | 64.7 | 65.5 |
| HLAB-Vals-1.1 | 21.3 | 15.4 | 9.2 | 6.3 | 7.1 | 11.7 |
| AutomationBench-AA | 72.5 | 56.2 | 69.5 | 64.9 | 68.5 | 73.3 |
| AgentArena (Net Improvement) | 7.5 | — | 18.2 | — | 13.9 | 3.9 |
| BioMysteryBench | 85.0 | 84.1 | 81.9 | 84.4 | 78.9 | 80.6 |
| HealthBench Professional | 60.0 | 39.6 | 59.9 | 65.1 | 66.0 | 57.2 |
| Humanity’s Last Exam | 51.7 | 43.9 | 59.8 | 54.0 | 53.6 | 51.1 |
| Chartography | 54.2 | 42.0 | 66.3 | 67.8 | 71.1 | 50.0 |
| Video-Index | 68.1 | 63.2 | 74.8 | 73.8 | 76.7 | 63.2 |
Proyectos en los que Qwen4-Max lidera
Qwen4-Max ocupa el primer puesto en cuatro benchmarks: DeepSWE, Agents’ Last Exam, HLAB-Vals y BioMysteryBench. Entre ellos, la diferencia más amplia se da en HLAB-Vals: 21,3 puntos, casi el doble de Kimi K3.1, que queda segundo. En DeepSWE, Qwen4-Max supera a Kimi por solo 0,2 puntos, una diferencia que básicamente puede considerarse un empate.
En otros cuatro benchmarks queda en segunda posición: AA-Briefcase, JobBench, APEX-Agents y AutomationBench-AA. En los tres primeros, el líder es Opus 5.5; en el último, es Kimi K3.1. Todos estos benchmarks se inclinan hacia agentes de larga duración y entregables de trabajo de oficina, que es precisamente el enfoque que la compañía ha destacado esta vez.
Proyectos en los que Qwen4-Max se queda atrás
La terminal y la construcción de programas son los puntos débiles más evidentes esta vez. Terminal-Bench 4.0 obtiene 48,5 puntos y queda quinto entre seis modelos, 18,7 puntos por debajo del primero, Kimi. Los 31,5 puntos de ProgramBench no llegan ni a la mitad de Opus 5.5. Si tu agente se dedica principalmente a ejecutar compilaciones, depuración y despliegues en el shell, estos dos benchmarks tienen más valor de referencia que DeepSWE.
La comprensión de gráficos y vídeos también queda atrás. Chartography y Video-Index ocupan ambos el cuarto puesto, con diferencias de 16,9 y 8,6 puntos respecto al primero, GPT-6 Astra. Humanity’s Last Exam también queda en cuarto lugar. Así que «visión nativa» significa que la capacidad existe, no que sea líder en este terreno.
La posición de Qwen4-Max en la clasificación pública de Code Arena
La instantánea final de la clasificación pública de Code Arena WebDev (2026-11-14) reúne 1,007,405 votos y 159 modelos. Qwen4-Max (xHigh) ocupa el 6.º puesto con 1750 puntos, marcado como Preliminary, con solo 1,814 votos; el costo por tarea P50 que muestra la página es de $4.18. Por delante de él están, en orden, Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Gemini 4 Carbon (Preliminary) y GPT-6 Astra.
La generación anterior, Qwen3.8-Max (0902), tenía 1676 puntos y el puesto 16 en la misma clasificación, así que esta generación sube 74 puntos y 10 posiciones. Aun así, Qwen4-Max todavía tiene relativamente pocos votos, por lo que el ranking podría seguir cambiando.
La eficiencia de tokens de Qwen4-Max y de dónde viene la «reducción de costos del 60 %»
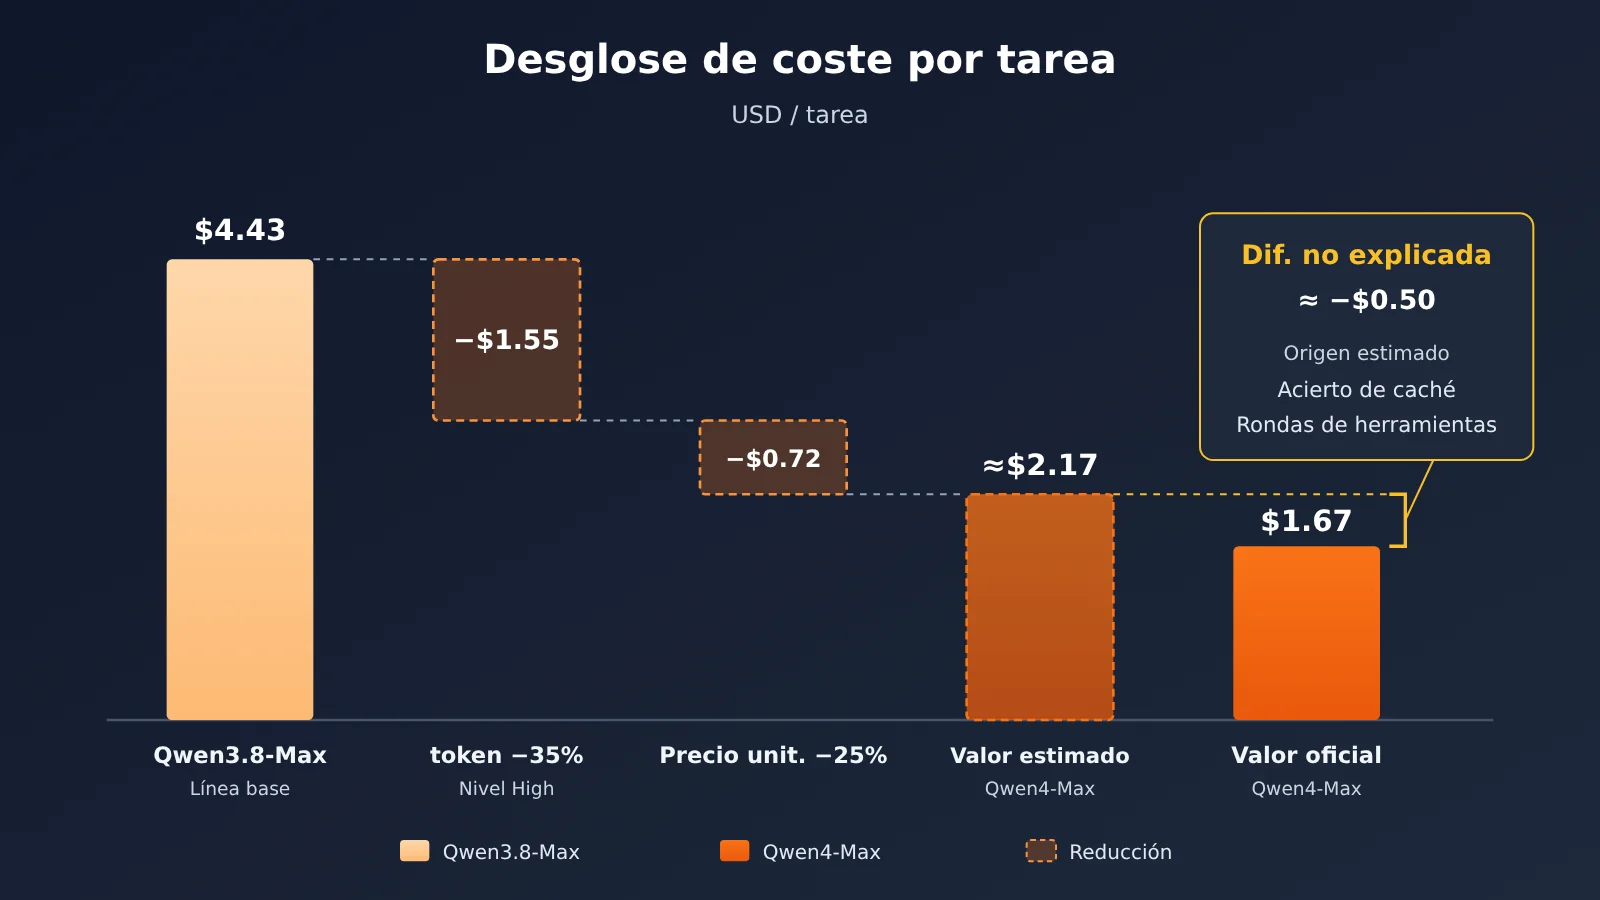
Las cifras oficiales de eficiencia provienen de su propio benchmark de escenarios Work360. Este benchmark tiene 26 dominios de primer nivel, 182 de segundo nivel y 721 de tercer nivel; Qwen4-Max obtiene 52.69 y Qwen3.8-Max, 47.74. En consumo de tokens, el nivel Xhigh de Work360 gasta aproximadamente un 24 % menos y el nivel High, alrededor de un 35 % menos; en Terminal-Bench 4.0, ambos niveles gastan cerca de un 48 % y un 49 % menos, respectivamente.
En cuanto al costo promedio por tarea, las cifras oficiales van de $4.43 a $1.67; según el blog chino, de ¥26.58 a ¥11.16, una reducción del 58 %. Si se calcula con las cifras en dólares, la caída ronda el 62 %. Pero si solo se usa «35 % menos tokens × 25 % menos precio unitario» para estimarlo, el resultado es aproximadamente 0.65 × 0.75 ≈ 0.49, es decir, una reducción de alrededor del 51 %. La documentación oficial no explica esa diferencia intermedia; las causas más probables serían una mayor tasa de aciertos de caché y menos rondas de llamadas a herramientas, pero son solo conjeturas y no deben tomarse como causas confirmadas.
En seguridad, la «tasa de aprobación dual de funcionalidad y vulnerabilidades» a nivel de función de Last Secure Code Bench pasa del 22.0 % al 31.8 %. La proporción de código seguro generado en las tres granularidades —función, archivo y repositorio— sube del 8 % al 14.7 %. Los valores absolutos siguen siendo bajos, y el código generado todavía requiere revisión humana.
¿Cómo se calcula el precio de Qwen4-Max?
A continuación se muestran los precios oficiales de Qwen4-Max, junto con el precio oficial del modelo de la generación anterior y el precio actual de APIYI. Todas las cifras están en USD / 1M tokens y la fecha de consulta es 2026-11-16.
| Concepto de facturación | Qwen4-Max (oficial de QwenCloud) | Qwen3.8-Max (oficial) | qwen3.8-max (precio actual en APIYI apiyi.com) |
|---|---|---|---|
| Entrada | $1.5 | $2 | $1.65 |
| Salida | $4.5 | $6 | $4.95 |
| Lectura de caché / aciertos | $0.075 | $0.25 | $0.20625 |
| Creación explícita de caché de 5 minutos | $1.875 | — | — |
| Creación explícita de caché de 1 hora | $3 | — | — |
Los precios en yuanes se rigen por la plataforma Qwen AI y la unidad es yuanes / 1M tokens; fecha de consulta: 2026-11-16:
- Entrada ¥10, salida ¥30, acierto de caché ¥0.5
- Creación explícita de caché de 5 minutos ¥12.5, creación explícita de caché de 1 hora ¥20
En comparación con el precio oficial de la generación anterior, los precios de entrada y salida de Qwen4-Max son un 25 % más bajos, y el precio de lectura de caché es un 70 % más bajo. La caída más pronunciada se da en el precio de lectura de caché, algo que afecta de forma notable a los agentes de tareas prolongadas, porque en las tareas de varios turnos una gran cantidad de indicaciones del sistema y de historial de contexto repetidos se factura al precio de caché.
Cuando estimes el costo por tu cuenta, puedes desglosarlo con esta fórmula: entrada sin acierto de caché × precio de entrada + aciertos de caché × precio de caché + cantidad de creación de caché explícita × precio de creación + salida (incluida la cadena de pensamiento) × precio de salida. Un ejemplo hipotético: una tarea tiene 1M de entrada, de los cuales 600 mil son aciertos de caché, y 100 mil de salida. Con el precio oficial de Qwen4-Max, el cálculo da aproximadamente $0.6 + $0.045 + $0.45 ≈ $1.10; con la misma cantidad de tokens, usando el precio oficial de Qwen3.8-Max, el cálculo da aproximadamente $1.55. A la diferencia real hay que añadir además los cambios en el consumo de tokens, así que lo más fiable es volver a ejecutar el cálculo con tus propios logs reales.
💰 Consejo para calcular costos: APIYI todavía no tiene qwen4-max en su catálogo; publicaremos este modelo lo antes posible. El nombre exacto del modelo y el precio se regirán por la lista de modelos de la plataforma apiyi.com. Antes de que esté disponible, puedes usar primero
qwen3.8-maxde la plataforma para establecer una línea base de costos y, cuando el nuevo modelo salga, comparar directamente las dos facturas.
Cómo decidir si cambiar a Qwen4-Max según el escenario
| Escenario | Rendimiento de Qwen4-Max (según datos oficiales) | Recomendación |
|---|---|---|
| Agentes de horizonte largo y entrega sectorial (automatización de oficina, investigación, documentos entregables) | HLAB-Vals y Agents’ Last Exam: primero; APEX, JobBench y AA-Briefcase: segundo; ahorra claramente más tokens | Evaluar con prioridad: la ganancia de actualizar desde Qwen3.8-Max es la más clara |
| Terminal y repositorios de código (agentes de shell, compilaciones, cambios entre repos) | DeepSWE: primero, pero con una ventaja mínima; Terminal-Bench: quinto; ProgramBench: cuarto | Para tareas centradas en operaciones de terminal, conviene comparar antes con Kimi K3.1 y Opus 5.5 y luego decidir |
| Desarrollo web frontend | 6.º puesto en la clasificación pública de Code Arena, 1750 puntos (Preliminary) | Puede servir como opción con buena relación costo-rendimiento, pero no está en la cima |
| Comprensión de gráficos y video, documentos multimodales largos | Chartography y Video-Index: ambos en cuarto puesto | En flujos con mucha lectura de imágenes y video, por ahora no se recomienda usarlo en solitario |
| Preguntas y respuestas de biología y medicina | BioMysteryBench: primero; HealthBench Professional: tercero | Se puede incluir en las pruebas, pero requiere revisión de expertos del dominio |
Un enfoque bastante seguro es dividir el tráfico: las tareas de agentes de horizonte largo y entrega de documentos se las damos a Qwen4-Max, mientras que las tareas intensivas de terminal y las de gráficos y video siguen con los modelos que hoy rinden mejor en esos campos. Así no hace falta migrar todo el tráfico de golpe y ya se obtienen las ventajas del ahorro de tokens.
🎯 Consejos para elegir el modelo: dividir el tráfico exige poder cambiar de modelo con el mismo código. APIYI apiyi.com ofrece una interfaz compatible con OpenAI: con una sola clave API puedes invocar varios modelos insignia, y basta cambiar el campo
modelpara hacer pruebas A/B.
Inicio rápido con Qwen4-Max
El canal oficial es QwenCloud API, que admite cuatro protocolos: OpenAI Chat Completions, Responses, Anthropic Messages y DashScope. Puedes conectarte directamente con el SDK de OpenAI o el de Anthropic que ya tengas. Al integrarte, ten en cuenta estos puntos:
- Confirma el modelo: el ID oficial del modelo es
qwen4-max; consulta la página del modelo para asegurarte. El valor predeterminado dereasoning_efforteshigh; en las pruebas comparativas, especifica explícitamente el mismo nivel, por ejemploxhigh. - Reserva espacio para la salida: la salida máxima es 393K y la cadena de razonamiento máxima es 262K. Para tareas largas, configura
max_tokenso el parámetro correspondiente con un valor suficientemente grande; de lo contrario, la cadena de razonamiento consumirá todo el presupuesto de salida. - Activa la caché: el precio por acierto de caché implícita es $0.075. Si la indicación del sistema es larga y se va a reutilizar, evalúa si vale la pena usar caché explícita de 5 minutos o 1 hora; crear la caché tiene un cargo aparte y, si se reutiliza pocas veces, puede que no compense.
- Prepara un grupo de control: regístrate en APIYI y obtén una clave API; configura
base_urlcomohttps://api.apiyi.com/v1ymodelcomoqwen3.8-max, y ejecuta el mismo lote de tareas para obtener el consumo de tokens y la puntuación del modelo anterior como línea base. - Cambia al nuevo modelo cuando esté disponible: cuando qwen4-max esté disponible en APIYI, solo tienes que cambiar el campo
model; el resto del código queda igual y obtendrás directamente los datos comparativos entre la generación nueva y la anterior.
🚀 Inicio rápido: los nuevos usuarios pueden registrarse en APIYI apiyi.com y obtener crédito de prueba gratuito, suficiente para ejecutar primero la línea base de
qwen3.8-max; para cambiar de modelo más adelante no hace falta volver a integrar.
Preguntas frecuentes sobre Qwen4-Max
P1: ¿Qué es Qwen4-Max?
Qwen4-Max es el modelo insignia lanzado por Tongyi Qianwen el 2026-11-16. Utiliza 2.4T parámetros en el tronco principal, activa 71B por token, soporta de forma nativa la entrada visual, tiene una ventana de contexto de 1M, y está orientado principalmente a agentes de largo recorrido y tareas de entrega en la industria.
P2: ¿En qué se diferencia Qwen4-Max de Qwen3.8-Max?
En los 16 benchmarks autodeclarados por la propia compañía, Qwen4-Max supera a Qwen3.8-Max-0902 en todos y cada uno de ellos. En la tabla pública de Code Arena, la diferencia es de 74 puntos. En cuanto al precio oficial, tanto la entrada como la salida son un 25% más bajas, y la lectura de caché es un 70% más baja. Además, los niveles de razonamiento por defecto de ambos son distintos: `high` y `xhigh` respectivamente.
P3: ¿Son fiables los 16 benchmarks?
Estas puntuaciones son todas autodeclaradas por la compañía, y las puntuaciones de los rivales también fueron medidas por Alibaba mismo; por ahora no hay reproducción por parte de terceros. La señal externa a la que se puede hacer referencia es la tabla pública de Code Arena WebDev: en la instantánea de la clasificación final del 2026-11-14, Qwen4-Max ocupaba el puesto 6, pero seguía en estado Preliminary, con pocos votos.
P4: ¿Se puede aplicar directamente a mi negocio la «reducción de costes del 60%»?
No se puede aplicar directamente. Esta cifra proviene del escenario oficial Work360, y la reducción es mayor que el resultado calculado simplemente en función de los tokens y el precio unitario; la diferencia intermedia no ha sido explicada por la compañía. Tu reducción real dependerá de la tasa de aciertos de caché, el número de rondas de llamadas a herramientas y el nivel de razonamiento, por lo que necesitas hacer tus propios cálculos con los registros de tus tareas.
P5: ¿Se puede invocar Qwen4-Max a través de APIYI?
Hasta las 11:00 del 2026-11-16, el modelo qwen4-max todavía no aparecía en la lista de modelos de APIYI; lo publicaremos lo antes posible. Actualmente, el modelo insignia de Qwen a la venta es `qwen3.8-max`, con precios de entrada $1.65, salida $4.95 y lectura de caché $0.20625 (unidad: 1M tokens). El avance de la publicación y los precios están sujetos a la lista de modelos en apiyi.com.
P6: ¿Cuáles son los puntos débiles de Qwen4-Max?
La operación en terminal (quinto en Terminal-Bench), la construcción de programas (cuarto en ProgramBench), la comprensión de gráficos y vídeo (ambos cuarto) y HLE (cuarto) quedan por detrás de los rivales punteros del mismo gráfico. Aunque la tasa de doble aprobación en código seguro ha mejorado, sigue siendo solo del 31.8%. Además, actualmente no hay planes de abrir los pesos para el tamaño Max.
Resumen: ¿Vale la pena cambiar a Qwen4-Max?
- Posicionamiento: modelo insignia con backbone de 2.4T, 71B activados por token y contexto de 1M; está orientado a agentes de horizonte largo y a la entrega de soluciones sectoriales.
- Aspectos en los que lidera: en 16 benchmarks reportados por la propia compañía, obtuvo 4 primeros puestos y 4 segundos, concentrados sobre todo en benchmarks de agentes y de entrega de trabajo profesional.
- Aspectos en los que queda atrás: operación de terminal, construcción de programas, gráficos, video y HLE aparecen en cuarto o quinto lugar; no se puede cubrir todo con un solo modelo.
- Posición en el ranking público: instantánea del ranking final de Code Arena WebDev (2026-11-14), puesto 6, 1750 puntos, aún marcado como Preliminary.
- Costo: el precio unitario oficial bajó 25%, la lectura de caché bajó 70% y el consumo de tokens también se redujo de forma notable; la afirmación de «una reducción del 60%» debe validarse con tus propios datos.
Si tu carga principal son agentes de horizonte largo y entrega de documentos, Qwen4-Max merece evaluarse de forma prioritaria; si se trata de tareas intensivas de terminal o de comprensión de gráficos y video, conviene seguir derivando esas tareas al modelo que hoy sea más potente. Antes de que qwen4-max se lance, puedes usar la interfaz compatible con OpenAI de APIYI apiyi.com para establecer una línea base de costo y rendimiento con qwen3.8-max; cuando salga el nuevo modelo, basta cambiar un solo campo para completar la comparación.
📚 Referencias
- Publicación oficial de Qwen en X: anuncio de lanzamiento de Qwen4-Max
- Enlace:
x.com/Alibaba_Qwen/status/2122148127520289151 -
Descripción: fecha de lanzamiento y canales oficiales disponibles
-
Blog oficial de Qwen (en chino): arquitectura, especificaciones, 16 resultados de benchmark y cifras de eficiencia
- Enlace:
qwen.ai/blog?id=qwen4-max -
Descripción: la arquitectura, las especificaciones y los datos de benchmark de este artículo provienen de esta publicación
-
Página del modelo en QwenCloud: precio de lista en USD
- Enlace:
qwencloud.com/models/qwen4-max -
Descripción: precios de entrada, salida y caché en USD / 1M tokens
-
Página del modelo en la plataforma Qianwen AI: precio de lista en yuanes
- Enlace:
qianwenai.com/models/qwen4-max -
Descripción: precio en yuanes / 1M tokens
-
arena.ai Code Arena WebDev: clasificación pública
- Enlace:
arena.ai - Descripción: este artículo cita la instantánea de la clasificación final del 2026-11-14
Autor: Equipo técnico de APIYI
Contacto técnico: si quieres conocer el estado de disponibilidad del modelo y cómo integrarlo, puedes contactarnos desde la página principal de APIYI; la documentación está en docs.apiyi.com.