Anmerkung des Autors: Auf Basis öffentlich verfügbarer Daten vom 29. Oktober 2026 beleuchtet dieser Artikel in fünf Dimensionen, wie groß der Abstand zwischen Mistral Large 4 und den Modellen von DeepSeek und GLM tatsächlich ist.
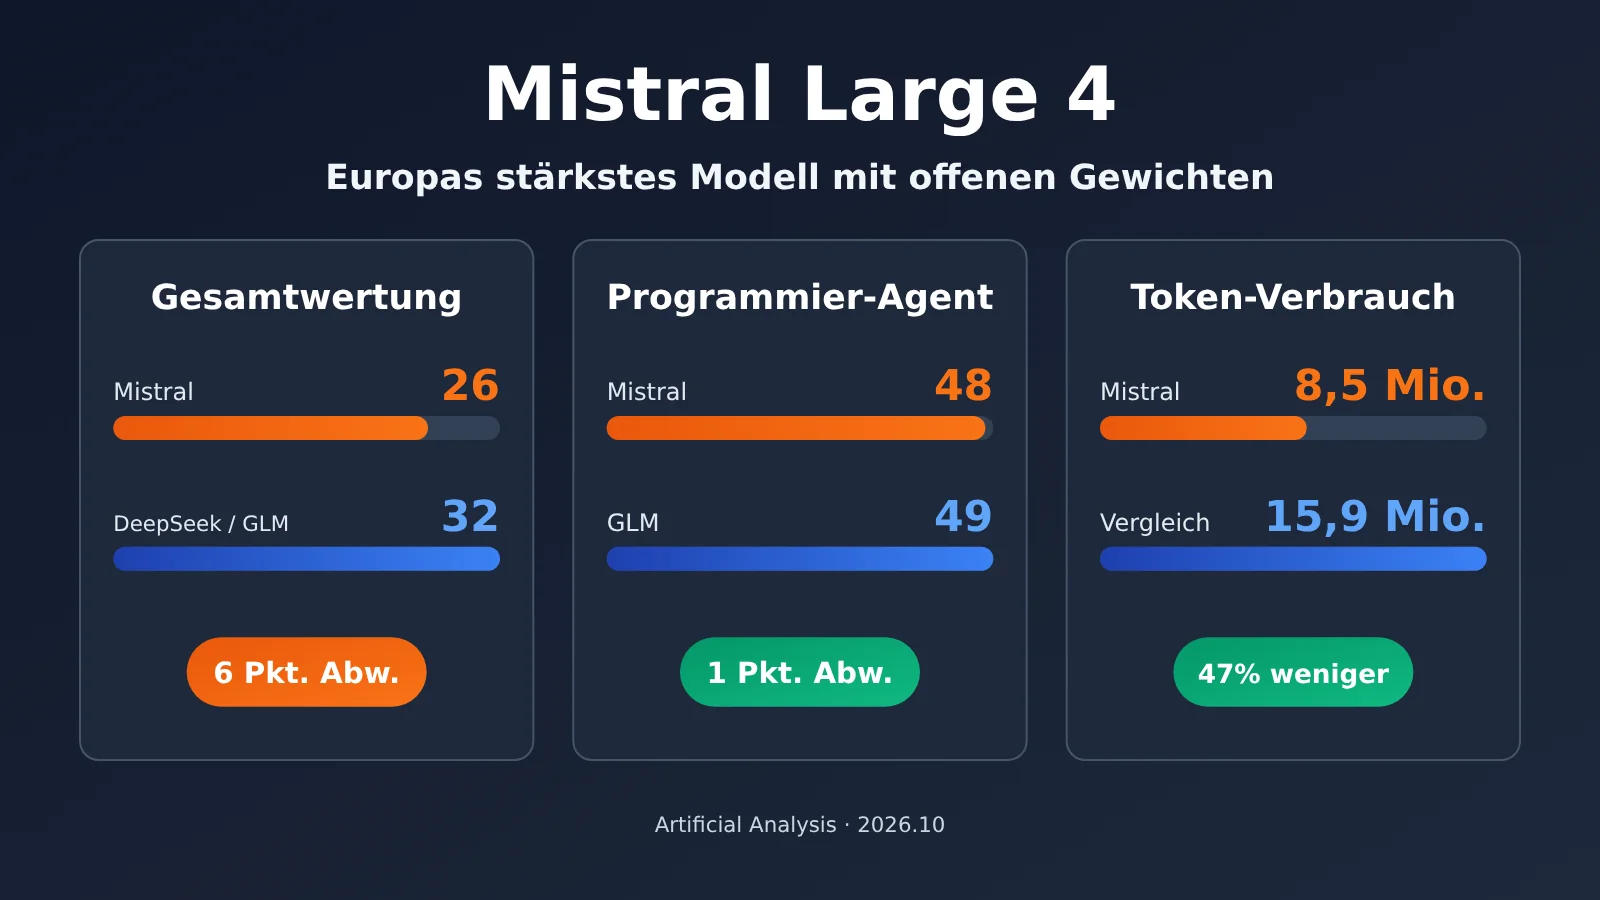
Am 29. Oktober 2026 veröffentlichte das französische KI-Unternehmen Mistral die Gewichte einer verbesserten Version von Large 4 und gab die offiziellen API-Preise bekannt. Im am selben Tag aktualisierten Intelligence Index v5.0 von Artificial Analysis ist Mistral Large 4 mit 26 Punkten das Modell mit offenen Gewichten und der höchsten Gesamtpunktzahl außerhalb Chinas. Zu den 32 Punkten von DeepSeek V4.1 Flash 1017 und GLM-5.3 fehlen allerdings noch 6 Punkte.
Das hier ist kein Werbetext über eine „europäische Modell-Aufholjagd“. „Europas stärkstes Modell“ hat klare Grenzen: Large 4 liegt nur 1 Punkt vor Meta Muse Spark Open auf Platz zwei. Weltweit erzielen noch 7 Modelle mit offenen Gewichten eine höhere Gesamtpunktzahl. Wirklich interessant ist, dass Large 4 bei Coding-Agenten bereits nahe an der Spitzengruppe liegt und dabei deutlich weniger Token verbraucht.
Das Wichtigste auf einen Blick: In 3 Minuten erfahren Sie, wo Large 4 bereits aufgeholt hat, wo noch Lücken bestehen und wie Entwickler und Unternehmen einschätzen können, ob sich ein Test lohnt.
Mistral Large 4: Das Wichtigste im Überblick
Zunächst zur zeitlichen Einordnung: Large 4 wurde nicht erst am 29. Oktober vorgestellt. Mistral veröffentlichte am 6. Oktober eine öffentliche Vorschau und trainierte das Modell anschließend rund drei Wochen lang mit Reinforcement Learning weiter. Unter Einbeziehung des Feedbacks von Unternehmens- und Cybersicherheitspartnern gab Mistral am 29. Oktober schließlich die Gewichte der verbesserten Version frei.
| Information | Details |
|---|---|
| Wichtige Termine | Vorschau am 6. Oktober, Freigabe der verbesserten Gewichte am 29. Oktober |
| Modellgröße | MoE-Architektur, insgesamt rund 1,05 Billionen Parameter, davon etwa 49 Milliarden pro Token aktiviert |
| Kontext und Modalitäten | Kontextfenster von rund 1 Million Token, Eingabe von Text und Bildern, Ausgabe als Text |
| Offizielle API-Preise | $0,70 pro Million Eingabe-Token, $0,07 für zwischengespeicherte Eingabe-Token, $2,10 für Ausgabe-Token |
| Offene Lizenz | Mistral Ecosystem Open-Weight License, zusätzliche Bedingungen für MaaS-Geschäftsmodelle |
| Schwerpunkte | Agentenbasierte Programmierung, defensive Cybersicherheit, Bild- und Dokumentenverständnis, private Unternehmensbereitstellung |
Was bedeuten die Billionen Parameter von Mistral Large 4?
Dank der MoE-Architektur (Mixture of Experts) durchläuft jedes Token nur einen Teil der Experten: Das Modell verfügt über 128 Routing-Experten, von denen jeweils vier ausgewählt werden. Zusätzlich kommt ein gemeinsamer Experte zum Einsatz. Obwohl das Modell insgesamt rund 1,05 Billionen Parameter besitzt, werden pro Token nur etwa 49 Milliarden aktiviert. Zählt man Embedding und Ausgabeschicht hinzu, sind es rund 52 Milliarden.
Wichtig: Weniger aktivierte Parameter bedeuten nicht automatisch einen geringen Speicherbedarf bei der Bereitstellung. Im Betrieb müssen weiterhin das vollständige Modell und die Laufzeitzustände gespeichert werden. Die Aussage „Es werden nur 52 GB Grafikspeicher benötigt“ ist daher falsch.
Was verbessert die überarbeitete Version von Mistral Large 4?
Die wichtigste Verbesserung liegt bei der Effizienz, nicht bei der Gesamtpunktzahl. In einem Vergleich von Artificial Analysis mit derselben Benchmark-Version erreichte die Vorschau 25 Punkte, die überarbeitete Version 26 – also nur einen Punkt mehr. Ein älterer Index hatte die Vorschau Anfang Oktober mit 38 Punkten bewertet. Dieser gehört jedoch zu einem anderen Bewertungssystem als v5. Daraus lässt sich also kein Rückgang der Modellleistung ableiten.
- Token-Effizienz: Die durchschnittliche Ausgabe pro Aufgabe im Intelligence Index sank von etwa 135.000 auf rund 82.000 Token – ein Rückgang um etwa 39 %.
- Kosten der Benchmark-Aufgaben: Sie sanken von etwa $5,54 auf rund $2,06 – ein Rückgang um etwa 63 %. Das bedeutet aber nicht, dass sich bei allen Aufgaben im Produktivbetrieb im gleichen Verhältnis Kosten sparen lassen.
- Faktentreue: Die Halluzinationsrate in AA-Omniscience v1.1 sank von 41 % auf 28 %. Dieser Wert gilt nur nach der Definition des jeweiligen Testsatzes und entspricht nicht der Fehlerwahrscheinlichkeit bei alltäglichen Antworten.
Wie groß ist der Abstand zwischen Mistral Large 4, DeepSeek und GLM?
Die folgende Tabelle fasst unabhängige Testergebnisse von Artificial Analysis zusammen. Verglichen wurden Large 4 High, DeepSeek V4.1 Flash 1017 Max und GLM-5.3 Max. Die Werte sind eine Momentaufnahme der Tests vom 29. bis 30. Oktober und können sich später ändern.
| Kennzahl | Mistral Large 4 | DeepSeek V4.1 Flash 1017 | GLM-5.3 |
|---|---|---|---|
| Intelligence Index v5.0 | 26 | 32 | 32 |
| Coding Agent Index | 48 | 46 | 49 |
| Durchschnittliche Gesamtzahl der Token pro Aufgabe | ca. 8,5 Mio. | ca. 16,7 Mio. | ca. 15,9 Mio. |
| Agent-Framework | Mistral Vibe | DeepSeek Harness | OpenCode |
| AA-Briefcase v1.1 (Elo) | ca. 1349 | ca. 1570 | ca. 1504 |
| Ausgabegeschwindigkeit (Token/Sekunde) | ca. 161 | ca. 178 | ca. 74 |
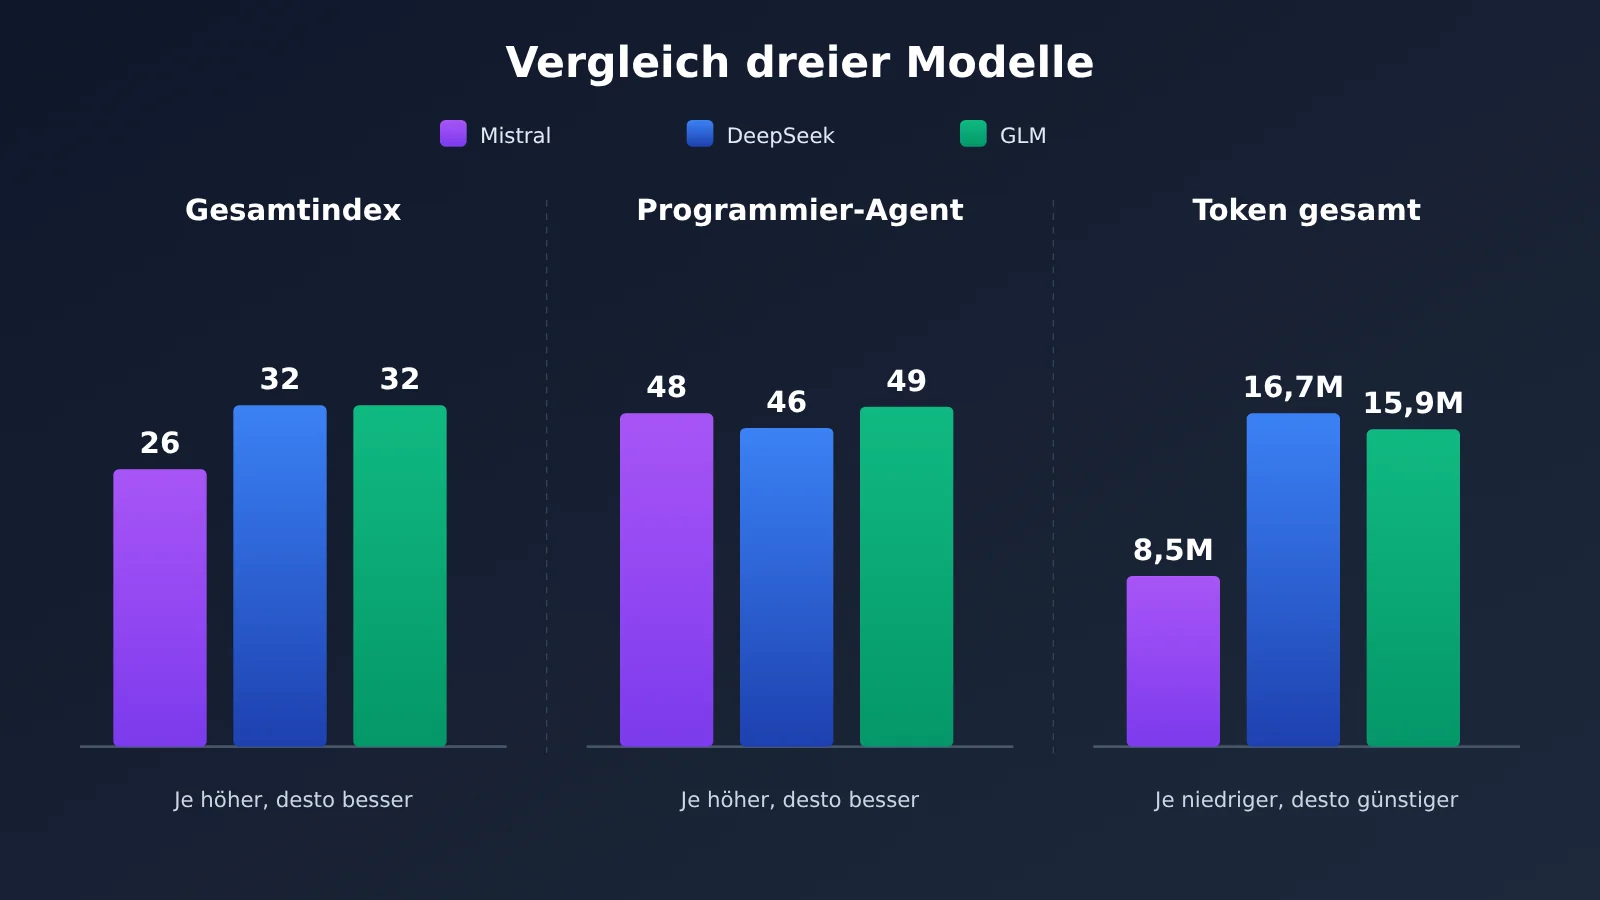
Der Intelligence Index ist weder eine Genauigkeitsrate noch ein allgemeingültiger IQ für Modelle. Version 5.0 umfasst neun Tests aus Bereichen wie Wissensarbeit, Softwareentwicklung, Automatisierung und wissenschaftlichem Schlussfolgern. Der Abstand von sechs Punkten zeigt, dass Large 4 in diesem Bewertungssystem noch nicht zu den führenden offenen Modellen aus China aufgeschlossen hat. Auch der Elo-Abstand bei AA-Briefcase weist darauf hin, dass es bei bestimmten komplexen Wissensaufgaben noch Schwächen gibt.
Wo liegen die Stärken von Mistral Large 4 als Programmier-Agent?
Im Index für Programmier-Agenten liegt Large 4 mit 48 Punkten knapp hinter GLM-5.3 mit 49 Punkten und zwei Punkte vor DeepSeek. Einen Unterschied von ein bis zwei Punkten sollte man jedoch nicht überbewerten. Aussagekräftiger ist der Token-Verbrauch: Large 4 benötigt rund 47 % weniger Tokens als GLM-5.3 und rund 49 % weniger als DeepSeek.
Der Test vergleicht allerdings jeweils die gesamte Kombination aus Modell und Agent-Framework, wobei alle drei unterschiedliche Frameworks nutzen. Die Gesamtzahl der Tokens umfasst zudem Eingabe, Cache und Ausgabe. Ein geringerer Verbrauch bedeutet daher nicht automatisch niedrigere Kosten – dafür müssen auch die jeweiligen Einzelpreise berücksichtigt werden.
Warum unterscheiden sich die offiziellen und unabhängigen Ranglisten?
Die von Mistral veröffentlichten Ergebnisse weichen deutlich von den Tests von Artificial Analysis ab. Bei solchen Ranglisten sollte man zunächst die Testkonfiguration prüfen, statt Zahlen aus verschiedenen Quellen zu einer einheitlichen Rangfolge zusammenzufügen.
| Benchmark | Offizielle Mistral-Daten | AA-Konfiguration: Large 4 | AA-Konfiguration: GLM-5.3 | AA-Konfiguration: DeepSeek |
|---|---|---|---|---|
| Terminal-Bench 4.0 | ca. 41 % | ca. 25 % | ca. 42 % | ca. 34 % |
| FrontierCode 2.0 | 19,7 % | ca. 15 % | ca. 22 % | ca. 29 % |
Agent-Framework, Inferenzkonfiguration, Laufzeitumgebung und Einstellungen für Tool-Aufrufe können alle zu diesen Abweichungen beitragen. Die öffentlich verfügbaren Informationen reichen aber nicht aus, um den Einfluss der einzelnen Faktoren zu bestimmen. Die Aussage „Large 4 schneidet in der von Mistral veröffentlichten Konfiguration besonders gut ab“ ist daher haltbar. „Unabhängige Tests belegen, dass es bei beiden Benchmarks führt“ ist es nicht.
Ähnlich sieht es bei der Cybersicherheit aus: Large 4 erreicht im Cyber Index 51 % und liegt damit hinter DeepSeek mit 57 % und MiMo-V2.6-Pro mit 56 %. Mistral setzt zwar einen Schwerpunkt auf diesen Bereich, daraus folgt aber nicht, dass sein Modell bei allen Sicherheitsaufgaben am stärksten ist.
Empfehlung zur Auswahl: Ranglisten helfen dabei, die Kandidaten einzugrenzen. Die endgültige Entscheidung sollte anhand der eigenen Codebasis und durch das erneute Ausführen typischer Aufgaben überprüft werden. Über APIYI apiyi.com lassen sich die Modellkandidaten mit demselben OpenAI-kompatiblen Code wechseln und Erfolgsrate sowie Token-Verbrauch erfassen.
Was kostet die Mistral Large 4 API?
Der reguläre Preis von Large 4 liegt etwa bei der Hälfte des ursprünglichen Preises ohne Rabatt: Dieser betrug $1,36 für die Eingabe und $4,18 für die Ausgabe. Während der Vorschauphase gab es allerdings bereits rund zwei Wochen lang einen Aktionspreis, der nahe am regulären Preis lag: etwa $0,68 für die Eingabe und $2,09 für die Ausgabe. Treffender ist daher: „Der Preis liegt nahe am Aktionspreis der Vorschauphase und deutlich unter dem ursprünglichen Preis ohne Rabatt“ – nicht: „Am 29. Oktober wurde der Preis erstmals um 50 % gesenkt.“
| Modell und Zeitraum | Eingabe ($/Million Token) | Cache-Eingabe | Ausgabe | Kosten pro Aufgabe im AA-Benchmark |
|---|---|---|---|---|
| Mistral Large 4 | 0,70 | 0,07 | 2,10 | ca. $2,06 |
| DeepSeek V4.1 Flash 1017 (Spitzenzeiten) | 0,30 | 0,006 | 1,20 | ca. $0,60 |
| DeepSeek V4.1 Flash 1017 (Nebenzeiten) | 0,15 | 0,003 | 0,60 | ca. $0,60 |
| GLM-5.3 (von AA verwendeter Preis) | 1,40 | 0,26 | 4,40 | ca. $5,01 |
Die Kosten pro Aufgabe sind ein gewichteter Durchschnitt innerhalb des Benchmarks und entsprechen nicht der Rechnung für einen einzelnen Einsatz in der Praxis. In diesen Daten erzielt DeepSeek ein höheres Gesamtergebnis bei geringeren Kosten; GLM erzielt ebenfalls ein höheres Gesamtergebnis, kostet aber auch mehr. Large 4 liegt also nicht in beiden Kategorien vorn. Zudem kann Mistral für Inferenz in der EU- oder US-Region einen Aufschlag von 10 % erheben. Auch für die Modi Batch und Priority sollten die Preise separat geprüft werden.
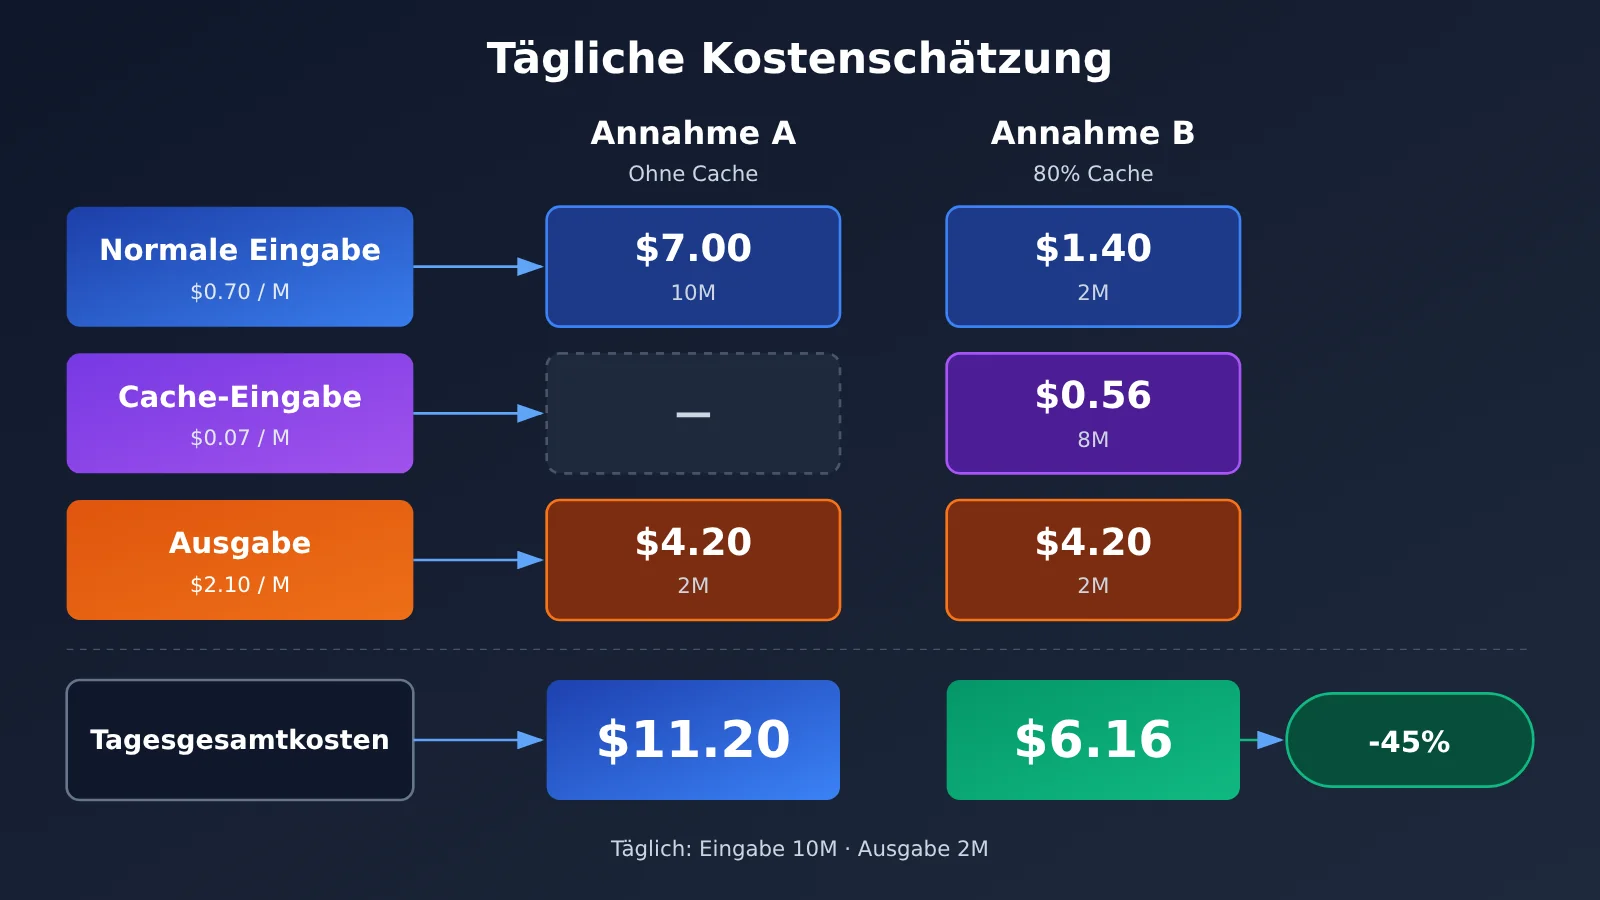
Ein Rechenbeispiel: Bei täglich 10 Millionen Eingabe-Token und 2 Millionen Ausgabe-Token fallen zum Standardpreis $7,00 + $4,20 = $11,20 pro Tag an. Werden 80 % der Eingabe aus dem Cache bedient, sinken die Kosten auf $1,40 + $0,56 + $4,20 = $6,16 – eine Ersparnis von rund 45 %. Die tatsächliche Cache-Trefferquote lässt sich nur anhand der eigenen Aufrufdaten bestimmen. Auch Inferenz-Token, Tool-Aufrufe und Wiederholungen nach Fehlern können die Kosten erhöhen.
So rufen Sie die Mistral Large 4 API auf
Die offizielle Modell-ID für die API lautet mistral-large-4. Wenn Sie bereits ein Projekt mit dem OpenAI SDK haben, müssen Sie für einen Test nur base_url und den Modellnamen anpassen:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 统一接口
)

response = client.chat.completions.create(
    model="mistral-large-4",
    messages=[{"role": "user", "content": "检查这段代码可能存在的安全问题"}]
)
print(response.choices[0].message.content)
Vollständigen Code mit Kostenschätzung anzeigen
import openai

# Mistral 官方标准价,单位:美元/百万 Token
INPUT_PRICE = 0.70
OUTPUT_PRICE = 2.10

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def ask_with_cost(prompt: str, model: str = "mistral-large-4") -> str:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000
    )
    usage = response.usage
    # 未计入缓存折扣,实际计费以账单为准
    cost = (
        usage.prompt_tokens * INPUT_PRICE
        + usage.completion_tokens * OUTPUT_PRICE
    ) / 1_000_000
    print(f"输入 {usage.prompt_tokens},输出 {usage.completion_tokens},估算 ${cost:.6f}")
    return response.choices[0].message.content

print(ask_with_cost("为这个函数设计三个边界测试用例"))
Schnellstart: Nutzen Sie zunächst das kostenlose Testguthaben für neue Nutzer bei APIYI auf apiyi.com und prüfen Sie, ob das gewünschte Modell verfügbar ist und welche Modell-ID es hat. Testen Sie den Aufruf vor dem Produktivstart mit einigen echten Aufgaben. Die aktuellen Preise finden Sie in der Konsole.
Kostenoptimierung: Vergleichen Sie nicht nur die Einzelpreise der Modelle, sondern auch die Gesamtkosten für eine erfolgreich abgeschlossene Aufgabe. Bei nutzungsabhängigen Aufrufen über APIYI auf apiyi.com empfiehlt es sich, die Anzahl der Wiederholungsversuche, die Ausgabe-Token und die Aufgabenergebnisse für jedes Modell getrennt zu erfassen.
Auswirkungen der Veröffentlichung von Mistral Large 4
Auswirkungen auf Entwickler
- Eine weitere Option für Coding-Agents: Der Programmierindex von Large 4 liegt nahe bei dem von GLM-5.3, bei geringerem Token-Verbrauch. Für lang laufende automatisierte Workflows lohnt sich daher ein Test.
- Bei kostensensiblen Aufgaben bleibt der Vergleich mit DeepSeek wichtig: DeepSeek hat niedrigere Stückpreise und deutliche Preisunterschiede zwischen Haupt- und Nebenzeiten. Bei großen Auftragsvolumen sollte man deshalb nicht nur auf den Token-Vorteil von Large 4 schauen.
- Das Meinungsbild in der Community ist noch offen: Auf Hacker News finden einige, dass sich angesichts der neuen Preise ein erneuter Test lohnt. Andere berichten von langen Denkzeiten bei der Vorschauversion. Das sind frühe Einzelberichte, und manche beziehen sich nicht auf die verbesserte Version.
Auswirkungen auf Teams mit Selbsthosting
Offene Modellgewichte bedeuten nicht, dass der lokale Betrieb kostenlos ist. Laut Schätzungen von Unsloth benötigt die 1-Bit-Quantisierung etwa 256–270 GB Gesamtspeicher, die 4-Bit-Version rund 630 GB und die 8-Bit-Version etwa 1,2 TB. Lange Kontexte und der Overhead des Inferenz-Frameworks können den Bedarf weiter erhöhen.
Auch die Geschwindigkeit hängt von Hardware und Konfiguration ab. In Tests von Hugging Face erreichten einige quantisierte Versionen auf einem einzelnen M3 Ultra mit viel Arbeitsspeicher etwa 15 Token pro Sekunde. Die FP8-Version kam auf einem Server mit acht H200 auf rund 65 Token pro Sekunde. Bei kleinerem Umfang oder gelegentlicher Nutzung ist ein direkter API-Aufruf meist praktischer. Organisationen, die das Modell dauerhaft und intensiv nutzen und Wert auf Datenkontrolle legen, können Selbsthosting prüfen. Es gibt jedoch keinen allgemeingültigen Schwellenwert für die Anzahl der Aufrufe, ab dem Selbsthosting grundsätzlich günstiger ist.
Auswirkungen auf Unternehmen und die Branche
Mistral setzt auf europäische Infrastruktur, private Bereitstellung, Modellanpassung und Geschäftskontinuität. Das sind keine Alleinstellungsmerkmale: Auch offene chinesische Modelle lassen sich privat betreiben. Die eigentlichen Unterschiede liegen im Standort der Bereitstellung, im rechtlichen Umfeld, in der vertraglichen Unterstützung und in den Anforderungen einer Organisation an das Vertrauen in den Anbieter.
| Modell | Offene Lizenz | Wichtiges zur kommerziellen Nutzung |
|---|---|---|
| Mistral Large 4 | MEOW License v26.10 | Erlaubt eine weitreichende kommerzielle Nutzung; MaaS-Geschäfte, die unter die Definition fallen, benötigen grundsätzlich eine gesonderte kommerzielle Lizenz, wobei es ausdrückliche Ausnahmen gibt |
| DeepSeek V4.1 Flash 1017 | MIT License | Erlaubt kommerzielle Nutzung, Änderungen und Weiterverbreitung; im Wesentlichen müssen der Urheberrechts- und Lizenzhinweis erhalten bleiben |
| GLM-5.3 | GLM-5.3 License | Erlaubt eine weitreichende kommerzielle Nutzung; MaaS-Betreiber, deren Umsatz zusammen mit verbundenen Unternehmen über zwölf Monate 10 Milliarden US-Dollar übersteigt, müssen eine Sicherheitsprüfung durchlaufen |
Die MaaS-Beschränkung von Mistral betrifft vor allem Geschäftsmodelle, die Dritten Zugang zur Inferenz oder zum Nachtraining allgemeiner Modelle bieten. Für Endprodukte mit eingebetteten spezifischen Funktionen, die reine Weiterleitung von Anfragen und die unternehmensinterne Nutzung gelten gesonderte Regelungen. Ob ein konkretes Geschäftsmodell darunterfällt, muss anhand des vollständigen Lizenztextes geprüft werden.
Cybersicherheit ist ein weiterer wichtiger Beobachtungsbereich. ENISA testet Large 4 für die Erkennung von Schwachstellen, Code-Reviews und Log-Analysen. Auch Organisationen wie Booz Allen Hamilton haben positive Einschätzungen veröffentlicht. Dabei handelt es sich jedoch um Aussagen von Partnern, nicht um einen Beleg für einen flächendeckenden Einsatz oder eine unabhängige Validierung. Die von Mistral genannte Ablehnungsrate von 96,6 % bei bösartigen Anfragen basiert ebenfalls nur auf ausgewählten Test-Eingabeaufforderungen. Sie bedeutet nicht, dass sich in der Praxis ein ebenso hoher Anteil an Angriffen verhindern lässt.
Häufig gestellte Fragen (FAQ)
Q1: Ist Mistral Large 4 das weltweit stärkste Modell mit offenen Gewichten?
Nein. Laut Artificial Analysis v5.0 war es zum damaligen Zeitpunkt das Modell mit offenen Gewichten und der höchsten Gesamtpunktzahl außerhalb Chinas. Weltweit erzielten jedoch sieben Modelle mit offenen Gewichten höhere Werte, darunter DeepSeek V4.1 Flash 1017 und GLM-5.3 mit jeweils 32 Punkten.
Q2: Wie entscheide ich mich zwischen Mistral Large 4, DeepSeek und GLM?
Steht die Kostenkontrolle im Vordergrund, lohnt sich zunächst ein Test mit DeepSeek. Wer Wert auf umfassende Fähigkeiten legt und ein grösseres Budget hat, kann GLM-5.3 testen. Geht es um die Kombination aus Coding-Agent-Leistung und Token-Effizienz oder werden Mistrals europäische Bereitstellung und Unternehmensdienste bevorzugt, sollte Large 4 im Mittelpunkt der Tests stehen. Entscheidend sind letztlich die Ergebnisse bei den eigenen Aufgaben.
Q3: Ist die verbesserte Version von Mistral Large 4 deutlich stärker als die Vorschauversion?
Der Gesamtindex stieg nur von 25 auf 26 Punkte – die Verbesserung ist also begrenzt. Deutliche Fortschritte zeigen sich vor allem bei einigen Programmieraufgaben, der Token-Effizienz und den Kennzahlen zur Faktentreue. So sank die durchschnittliche Ausgabe pro Testaufgabe um rund 39 %.
Q4: Wie kann ich die API von Mistral Large 4 schnell testen?
Sie können direkt die offizielle API nutzen oder sich zunächst bei APIYI auf apiyi.com registrieren und einen API-Schlüssel erstellen. Prüfen Sie dann in der Modellliste, ob das Modell verfügbar ist. Ersetzen Sie anschliessend die Modell-ID im Code dieses Artikels durch den auf der Plattform angezeigten Namen und testen Sie das Modell mit einigen realen Aufgaben.
Q5: Wie lässt sich der Anpassungsaufwand beim Vergleich mehrerer Modelle reduzieren?
Am besten legen Sie den Modellnamen als Konfigurationsoption an und erfassen Erfolgsrate, Laufzeit und Token-Verbrauch einheitlich. APIYI auf apiyi.com bietet eine OpenAI-kompatible Schnittstelle. Damit können Sie mit demselben Code relativ einfach zwischen Modellen wechseln und sie während der Auswahlphase vergleichen.
Q6: Welche bekannten Schwächen hat Mistral Large 4?
Zu den wichtigsten Einschränkungen zählen der niedrigere Gesamtindex gegenüber führenden chinesischen Modellen mit offenen Gewichten, ein deutlicher Rückstand bei komplexer Wissensarbeit in AA-Briefcase und ein niedrigerer Cyber Index als bei DeepSeek und MiMo. Hinzu kommen hohe Speicheranforderungen beim Selbsthosting und zusätzliche kommerzielle Lizenzanforderungen für einige MaaS-Dienste.
Mistral Large 4: Die wichtigsten Erkenntnisse
- Europas Spitzenmodell – mit Einschränkungen: Mit 26 Punkten liegt es außerhalb Chinas vorn, allerdings nur einen Punkt vor Muse Spark Open.
- Bei der Gesamtleistung noch im Rückstand: DeepSeek und GLM erreichen 32 Punkte und liegen damit sechs Indexpunkte vorn.
- Bei Coding-Agents fast gleichauf: Mit 48 Punkten liegt Large 4 nur einen Punkt hinter GLM-5.3 und vor DeepSeek mit 46 Punkten.
- Besonders tokeneffizient: Mit rund 8,5 Millionen Token pro Aufgabe verbraucht es etwa halb so viele wie GLM und DeepSeek.
- Kosten im Zusammenhang mit dem Ergebnis betrachten: Im Test kostete eine Aufgabe rund 2,06 US-Dollar – weniger als bei GLM, aber mehr als bei DeepSeek.
- Offen bedeutet nicht uneingeschränkt: Für MaaS-Geschäftsmodelle, die unter die entsprechende Definition fallen, gelten zusätzliche Anforderungen an die kommerzielle Lizenzierung.
- Zum Einstieg im kleinen Rahmen testen: Über APIYI apiyi.com lassen sich die Modelle anhand realer Aufgaben vergleichen.
Fazit
Wie weit Mistral Large 4 noch von DeepSeek und GLM entfernt ist, hängt davon ab, was verglichen wird:
- Gesamtleistung: Der Abstand beträgt weiterhin sechs Punkte. Large 4 hat die beiden Modelle in der globalen Rangliste noch nicht überholt.
- Coding-Agents: Die Ergebnisse liegen bereits sehr nah beieinander. Zudem verbraucht Large 4 in der entsprechenden Testreihe deutlich weniger Token.
- Kosten und Bereitstellung: Es liegt zwischen DeepSeek und GLM und bietet mit europäischer Infrastruktur und Anpassungsmöglichkeiten für Unternehmen zusätzliche Optionen.
Die Veröffentlichung bringt also nicht nur ein weiteres Modell mit einer Billion Parametern hervor. Sie bietet Teams mit Anforderungen an Programmierung, Sicherheit und eigenständige Bereitstellung eine wettbewerbsfähige Alternative. Ob sich ein Wechsel lohnt, hängt von den Ergebnissen bei realen Aufgaben, den Gesamtkosten pro Aufgabe und den Anforderungen an die Bereitstellung ab.
Ein guter erster Schritt ist ein kleiner Vergleich über APIYI apiyi.com mit dem kostenlosen Testguthaben. Auf Basis der tatsächlichen Ergebnisse lässt sich dann über das weitere Vorgehen entscheiden.
📚 Quellen
- Offizielle Ankündigung von Mistral: Verbesserte Modellgewichte öffentlich verfügbar
- Link:
mistral.ai/news/mistral-large-4-oss -
Inhalt: Informationen zur Veröffentlichung, offizielle Benchmarks und Stellungnahmen von Partnern
-
Offizielle Preisdokumentation von Mistral: Preise für API und regionale Inferenz
- Link:
docs.mistral.ai/inference/pricing -
Inhalt: Preise für Standard- und Cache-Nutzung sowie verschiedene Servicemodelle
-
Modellseite und Lizenz auf Hugging Face: Large-4-Gewichte und MEOW License
- Link:
huggingface.co/mistralai/Mistral-Large-4-1T-A52B -
Inhalt: Modellkarte mit Zugang zum vollständigen Lizenztext
-
Technische Einführung auf Hugging Face: Architektur und Deployment
- Link:
huggingface.co/blog/mistral-large4 -
Inhalt: MoE-Struktur, Inferenz-Frameworks und Ergebnisse von Hardwaretests
-
Rangliste offener Modelle von Artificial Analysis: Unabhängige Benchmark-Daten
- Link:
artificialanalysis.ai/models/open-source -
Inhalt: Gesamtindex sowie Daten zu Programmier-Agenten, Kosten und Geschwindigkeit
-
Deployment-Anleitung von Unsloth: Quantisierung und lokaler Betrieb
- Link:
unsloth.ai/docs/models/mistral-large-4 -
Inhalt: Schätzungen des Speicherbedarfs für verschiedene Quantisierungsstufen
-
Offizielle Preise von DeepSeek: API-Preise zu Spitzen- und Nebenzeiten
- Link:
api-docs.deepseek.com/quick_start/pricing -
Inhalt: Preise und Zeitfenster für DeepSeek V4.1 Flash 1017
-
GLM-5.3-Lizenz: Sicherheitsprüfungsbedingungen für MaaS
- Link:
huggingface.co/zai-org/GLM-5.3/blob/main/LICENSE -
Inhalt: Umsatzschwellen und Anforderungen für die kommerzielle Nutzung
-
Bericht von VentureBeat: Ranking und Kostenanalyse von Large 4
- Link:
venturebeat.com/technology/mistral-large-4-le-chonk-arrives-as-the-top-open-model-outside-china-with-improved-coding-performance-and-63-lower-cost-per-task -
Inhalt: Überblick über Modellranking, Token-Effizienz und Veränderungen der Kosten pro Aufgabe
-
Diskussion auf Hacker News: Frühes Feedback von Entwicklern
- Link:
news.ycombinator.com/item?id=50289418 - Inhalt: Persönliche Erfahrungen zu Preisen, selbst betriebenem Deployment und Lizenzfragen
- Link:
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite von APIYI. Weitere Informationen finden Sie im Dokumentationszentrum unter docs.apiyi.com.