
Hinweis des Autors: Um eine häufige Frage zur Abrechnung zu beantworten: Obwohl die Listenpreise der Modelle in den letzten Monaten rapide gesunken sind, bleiben Coding-Agents weiterhin spürbar teuer. Die genannten Preise basieren auf den offiziellen Preislisten mit Stand vom 26.10.2026 sowie der Modellpreisseite von APIYI. Die Zahl von 96 % ist eine Schätzung eines Drittautors und keine eigene Messung für diesen Artikel.
Vom 26.06.2026 bis zum 29.09.2026 – also über einen Zeitraum von rund vier Monaten – lieferten sich OpenAI und Anthropic einen regelrechten Preiskampf. Max Woolf hat diese Chronologie am 25.10.2026 unter minimaxir.com/2026/10/cheap-llms zusammengefasst, wobei im Titel von Preisnachlässen von bis zu 80 % die Rede ist. In seinem Artikel betont er, dass bei Coding-Agents das Lesen aus dem Cache (Cache Read) 96 % bis 99 % der gesamten Token-Kosten ausmacht. Der Grund: Bei jeder Interaktionsrunde wird der vorangegangene Dialogverlauf erneut aus dem Cache geladen, mit einer Trefferquote (Cache Hit Rate) von etwa 90 % bis 100 %, je nach Inferenz-Provider. Woolf hat seinen Beitrag zwar ohne verifizierbare Request-Logs veröffentlicht – wir betrachten diese Zahl daher als Referenzwert eines Drittautors, der Ihre individuellen Verbrauchsanalysen nicht ersetzen sollte.
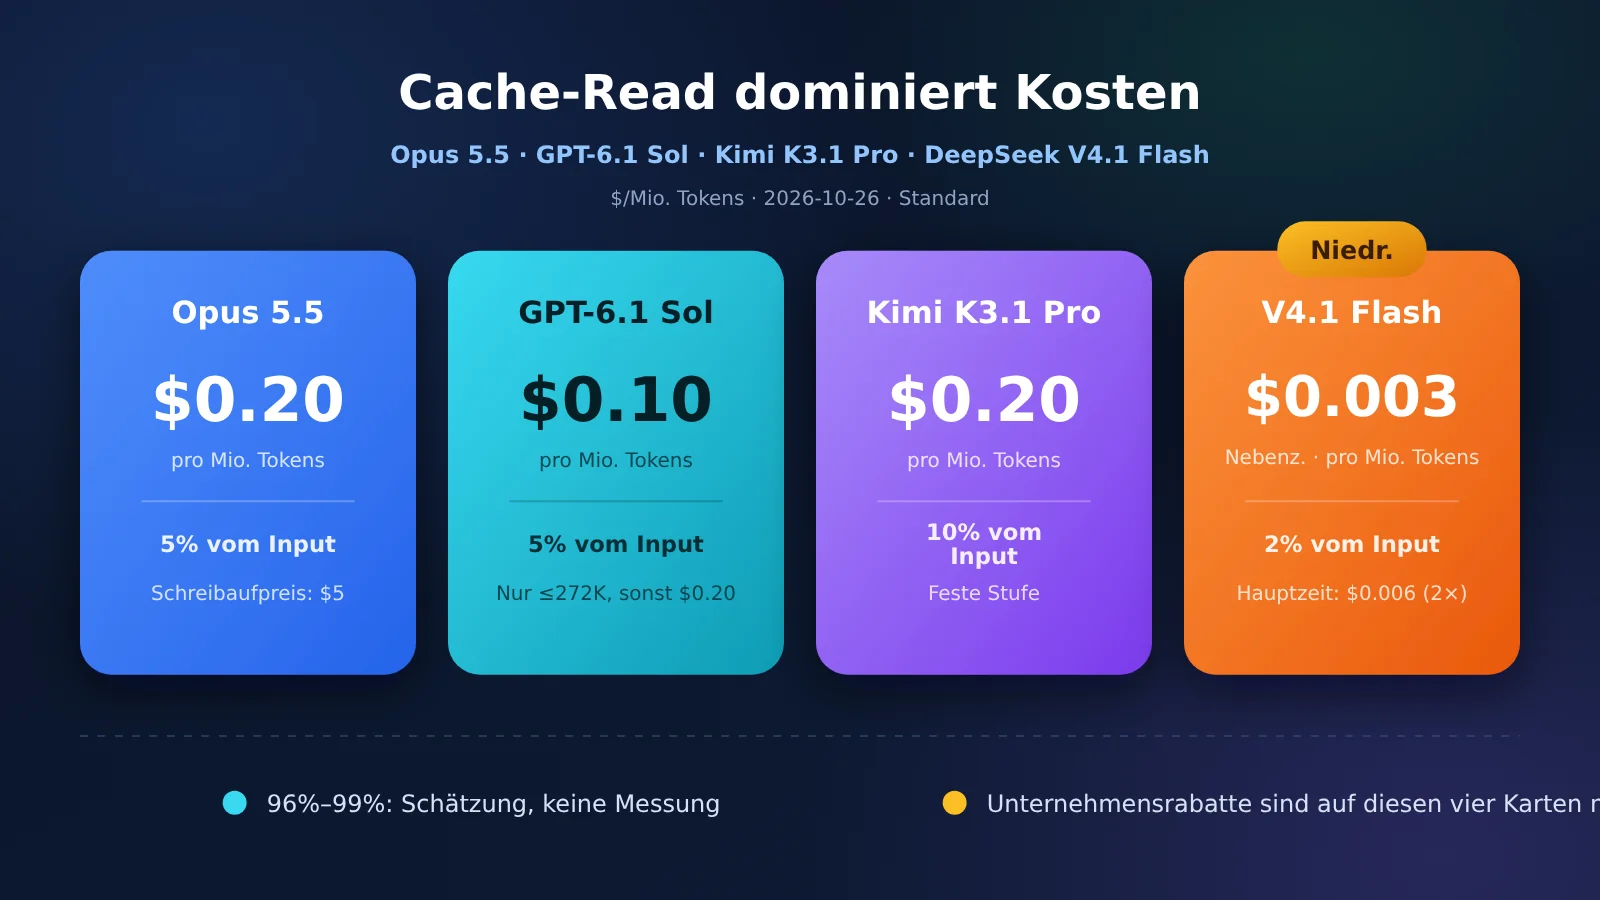
Im gleichen Zeitfenster sehen die aktuell mit den offiziellen Preislisten übereinstimmenden Cache-Read-Preise wie folgt aus: Claude Opus 5.5 liegt bei 0,20 $, GPT-6.1 Sol bei 0,10 $ (bei einer Eingabe von bis zu 272K Tokens), Kimi K3.1 Pro bei 0,20 $ und DeepSeek V4.1 Flash bei 0,003 $ in Nebenzeiten (Off-Peak) bzw. 0,006 $ in Spitzenzeiten (Peak). Alle Angaben verstehen sich in US-Dollar pro Million Tokens.
Das ist keine Tabelle, bei der am Ende alle Anbieter irgendwie gleichauf liegen. Bei Programmier-Loops mit stabilem Prompt-Präfix und Eingaben von typischerweise unter 272K Tokens hat GPT-6.1 Sol unter den drei proprietären Anbietern bei den Cache-Read-Kosten klar die Nase vorn. Wer die Kosten um eine weitere Größenordnung senken will, schaut sich die Off-Peak-Cache-Read-Preise von DeepSeek an. Opus 5.5 und Kimi liegen beim Cache-Read zwar gleichauf, unterscheiden sich jedoch spürbar bei den Cache-Miss-Eingabekosten, den Output-Preisen und dem Aufschlag für das Cache-Schreiben (Cache Write).
Kernbotschaft: Nach diesem Artikel können Sie Modelle gezielt nach der Cache-Trefferquote statt bloß nach den regulären Eingabepreisen auswählen – und verstehen genau, warum die in den Medien gefeierten Unternehmensrabatte oft wenig mit der tatsächlichen Rechnung kleinerer Teams zu tun haben.
💡 Praxistipp: Alle vier Modelle lassen sich über APIYI (apiyi.com) mit einem einzigen API-Schlüssel testen – Sie müssen lediglich den Modellnamen austauschen. Für neue Accounts gibt es kostenloses Testguthaben. Fixieren Sie zunächst Ihr Prompt-Präfix und prüfen Sie anschließend das tatsächliche Cache-Read-Volumen in den Verbrauchsdaten, anstatt voreilige Schlüsse aus einem einzelnen kurzen Dialog zu ziehen.
Wo liegen die Unterschiede bei den Cache-Read-Preisen der vier Anbieter?
Schauen wir uns zuerst die Cache-Read-Preise an und danach das Verhältnis zu den regulären Eingabekosten (Cache-Miss). Dieser Prozentsatz bestimmt, wie viel günstiger längere Konversationen tatsächlich werden. Bei Opus 5.5 und GPT-6.1 Sol im kurzen Kontextfenster liegen die Cache-Reads bei 5 % des regulären Eingabepreises, bei Kimi K3.1 Pro sind es 10 % und bei DeepSeek V4.1 Flash lediglich 2 %. Der absolute Preisunterschied ist noch deutlicher: Die $0.003 von Flash in Nebenzeiten (Off-Peak) entsprechen gerade einmal 1/33 der $0.10 von Sol (kurzer Kontext) und 1/67 von $0.20.
| Modell | Cache-Read | Anteil am Cache-Miss (Input) | Cache-Miss (Input) | Output |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol, Eingabe ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol, Eingabe >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash (Nebenzeiten) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash (Hauptzeiten) | $0.006 | 2% | $0.30 | $1.20 |
Alle Angaben verstehen sich in US-Dollar pro Million Tokens und beziehen sich ausschließlich auf die Standardtarife – ohne Batch-, Fast- oder regionale Preisaufschläge. Opus 5.5 stammt aus der Anthropic-Preisliste; Cache-Hits werden mit dem 0,05-Fachen des regulären Eingabepreises berechnet. GPT-6.1 Sol basiert auf den Standardpreisen von OpenAI: Ein kurzer Kontext bedeutet hier eine Eingabe von maximal 272K Tokens. Wird dieser Wert überschritten, steigen Cache-Read-, Eingabe- und Ausgabepreise gemeinsam in die nächste Tarifstufe (der Output kostet dann $15 statt $20). Kimi basiert auf den öffentlichen Tarifdetails von Moonshot, hier gibt es keine Staffelung nach Kontextlänge. DeepSeek stammt von der offiziellen Preisübersicht (Modellbezeichnung deepseek-flash, Version DeepSeek-V4.1-Flash-1017). Die Hauptzeiten (Peak) gelten montags bis freitags von 01:00–04:00 Uhr und 06:00–10:00 Uhr UTC (ohne gesetzliche Feiertage in China), was 09:00–12:00 Uhr und 14:00–18:00 Uhr Peking-Zeit entspricht. Der Zeitraum dazwischen (12:00–14:00 Uhr) zählt weiterhin zu den Nebenzeiten (Off-Peak). An Wochenenden sowie chinesischen Feiertagen gilt ganztägig der Nebenzeittarif.
Auf der Modell-Preisseite von APIYI (docs.apiyi.com/models) sind im Katalog vom 25.10.2026 folgende Preise gelistet: claude-opus-5-5 mit $4 / $20 / $0.20, gpt-6.1-sol mit $2 / $10 / $0.10 (mit dem Hinweis, dass die Eingabe ab 272.000 Tokens auf $4 steigt) und kimi-k3.1-pro mit $2 / $10 / $0.20. DeepSeek ist in zwei Zeilen aufgeteilt: deepseek-v4.1-flash sowie deepseek-flash kosten $0.30 / $1.20 / $0.006 (entspricht den offiziellen Hauptzeiten), während deepseek-v4-1-flash-260910 bei $0.15 / $0.60 / $0.003 liegt (entspricht den Nebenzeiten). Während die Umschaltung offiziell dynamisch über den Zugriffszeitpunkt der Anfrage erfolgt, bildet der Katalog die beiden Tarife als separate Modellzeilen ab. Maßgeblich für den Modellaufruf ist der genaue Modellname in der Konsole.
Cache-Reads machen allerdings nur die halbe Rechnung aus. Der Cache-Write-Preis bestimmt, wie viel Aufschlag fällig wird, sobald ein Prefix abläuft und neu zwischengespeichert werden muss. Die kurzen und langen Zeitfenster in der folgenden Tabelle lassen sich dabei nicht direkt minutenweise vergleichen: Bei OpenAI umfasst das kurze Intervall bereits 30 Minuten, während es bei Anthropic und Kimi lediglich 5 Minuten sind.
| Modell | Kurze Cache-Dauer (Write) | Lange Cache-Dauer (Write) | Wie das Präfix im Cache landet |
|---|---|---|---|
| Opus 5.5 | 5 Minuten, 5 $, 1,25-faches des Inputs | 1 Stunde, 8 $, 2-faches des Inputs | Request muss cache_control enthalten |
| GPT-6.1 Sol, ≤272K | 30 Minuten, 2,50 $, 1,25-faches des Inputs | 12 Stunden, 5 $, 2,5-faches des Inputs | In Preisliste separat aufgeführt; Präfix muss stabil sein |
| Kimi K3.1 Pro | 5 Minuten, 2 $, entspricht Input-Preis | 1 Stunde, 4 $, hochgerechnet mit Faktor 2 | Standardmäßig automatisch (5 Min.); für längere Intervalle muss 1 Stunde angegeben werden |
| V4.1 Flash | Keine separaten Schreibkosten | Keine | Erster Request zählt als Cache-Miss, danach als Cache-Read |
Auf der Startseite von Kimi wird das Cache-Schreiben mit 2 $ angegeben, was der standardmäßigen 5-Minuten-Stufe entspricht. Die 4 $ für die 1-Stunden-Stufe stammen aus den Konfigurationspreisen der Kimi-Dokumentation von APIYI. Dort wird darauf hingewiesen, dass diese Cache-Stufe im aktuellen Testlauf noch nicht bezüglich der Abrechnung verifiziert wurde. In der offiziellen Dokumentation der vorherigen Generation (Kimi K3) betrugen die Schreibkosten für 1 Stunde das Doppelte der 5-Minuten-Stufe – beim K3.1 Pro ergibt sich nach demselben Multiplikator 4 $. Sollten die Angaben in der Konsole abweichen, ist immer die Konsole maßgeblich. Bei der Highspeed-Variante kimi-k3.1-pro-highspeed verdoppeln sich Input- und Output-Preise, der Cache-Read bleibt jedoch bei 0,20 $. Erzielt man viele Präfix-Treffer, schrumpft der Abstand zwischen beiden Stufen deutlich zusammen.
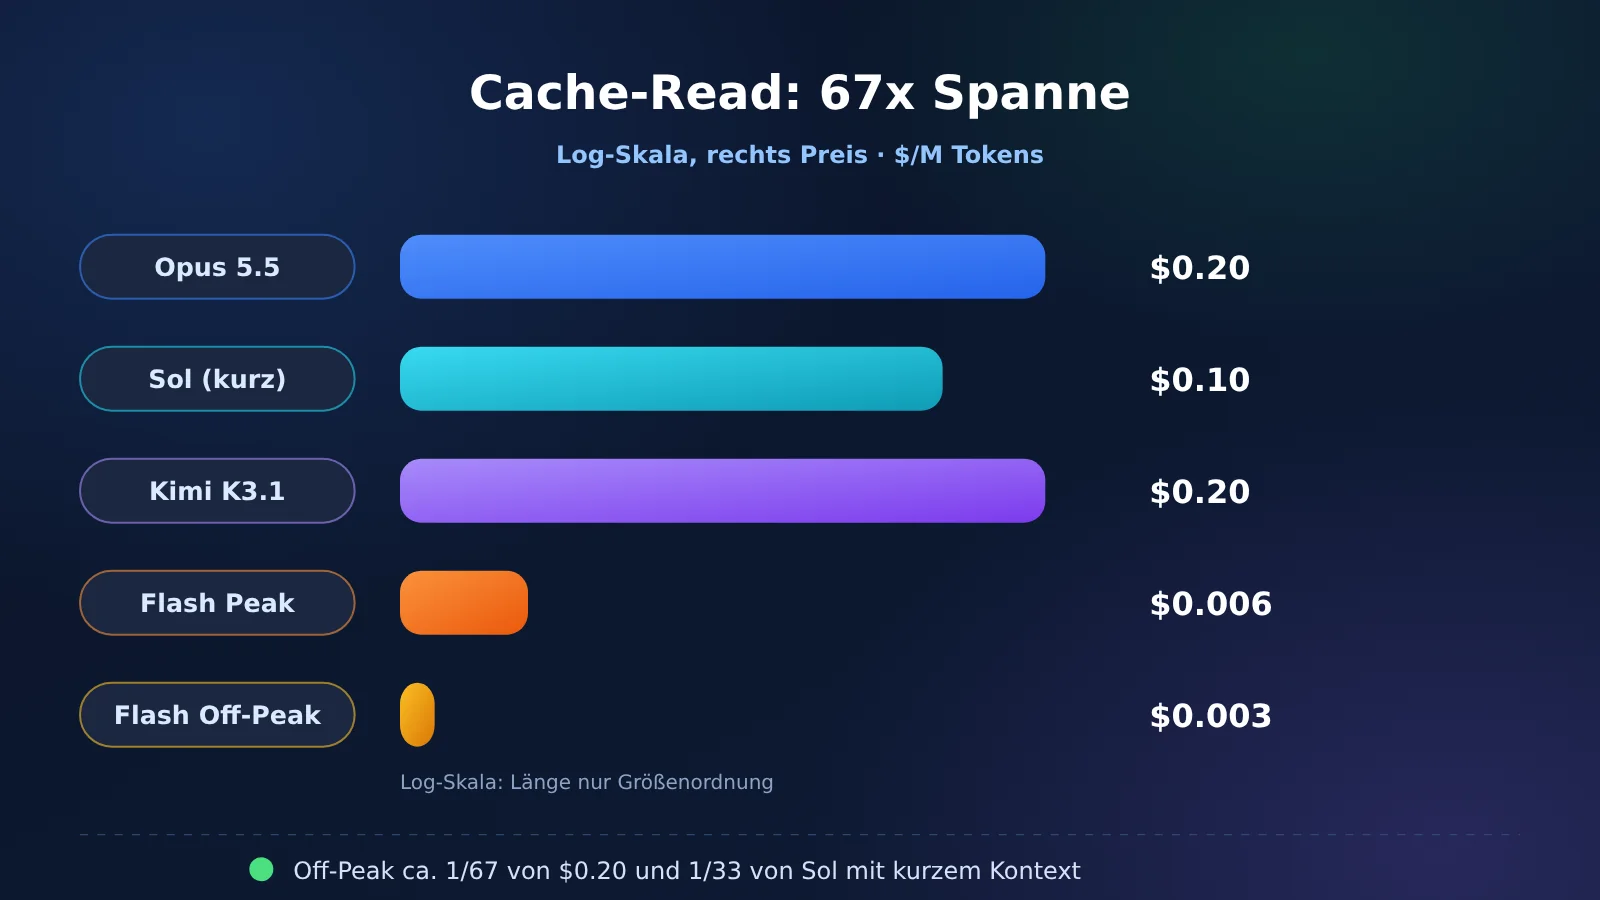
Die Balkenlängen in der Grafik dienen nur zur Veranschaulichung der Größenordnungen. Die Abrechnung erfolgt weiterhin nach dem Originalpreis multipliziert mit der Token-Anzahl. Wenn Sie mit demselben API-Schlüssel das Modell wechseln, orientieren Sie sich bitte an der Spalte für Cache-Reads in der APIYI-Konsole und nutzen Sie diese Grafik nicht für exakte Betragskalkulationen.
Warum sollten Cache-Reads bei Coding-Agents auf der Rechnung separat aufgeführt werden?
In jeder Runde sendet ein Agent die System-Eingabeaufforderung, Tool-Definitionen und den bisherigen Gesprächsverlauf erneut mit. Teile des Präfix, die sich nicht geändert haben, können zu den günstigeren Cache-Read-Preisen abgerechnet werden. Ändert sich das Präfix, zählt ab der geänderten Stelle alles als Cache-Miss – und manche Anbieter berechnen dafür zusätzlich Schreibgebühren (Cache-Writes). Wenn also die regulären Eingabepreise um 20 % sinken, bedeutet das keineswegs, dass die Rechnung für einen Programmierdurchlauf ebenfalls um 20 % sinkt. Wenn Cache-Reads das Gros der Tokens ausmachen, ist genau diese Spalte der entscheidende Faktor.
Max Woolf bezieht sich bei seinen 96 %–99 % auf die „gesamten Token-Ausgaben“. Im Englischen kann „expenditure“ sowohl monetäre Kosten als auch Token-Verbrauch bedeuten. Im Original wurde die Bezugsgröße (der Nenner) nicht explizit genannt. Eine andere Drittanbieter-Messung definiert die Kriterien hingegen eindeutig: Laut einem Update von WorkloadBench vom 16.10.2026 stammen bei langwierigen Coding-Aufgaben 89 %–96 % der Eingabeaufforderungs-Tokens aus dem Cache. Sowohl GPT-6.1 Sol als auch Claude Opus 5.5 liegen im Median bei 95 %, mit Bandbreiten von 91 %–98 % bzw. 94 %–99 % (Quelle: workloadbench.brenhq.com/cache). Dies bezieht sich rein auf den Anteil der Eingabeaufforderungs-Tokens – der Nenner enthält weder Outputs noch entspricht dies dem prozentualen Anteil an den Dollar-Kosten. Man darf diese beiden Quellen also keinesfalls zu einem pauschalen „96 % der Gesamtrechnung“ zusammenwerfen.
Der Anteil an den tatsächlichen Kosten fällt meist deutlich geringer aus, da der Einzelpreis für Outputs das Dutzend- bis Hundertfache von Cache-Reads beträgt. Nachfolgend rechnen wir das anhand transparenter Annahmen durch – rein zur Veranschaulichung der Kostenstruktur, nicht als Originalaufschlüsselung des Autors und auch nicht als realer Benchmark-Log:
Angenommen werden 40 Runden, jeweils mit 120.000 Tokens als Cache-Read, 1.500 neuen Miss-Tokens und 800 Output-Tokens. Zu Beginn der Sitzung fallen einmalig 40.000 geschriebene Tokens (Writes) an. Diese 40.000 Tokens werden nicht doppelt als Miss gezählt. (DeepSeek verlangt keine Schreibgebühr; dort werden diese 40.000 als Miss verbucht.) Mit rund 120.000 Eingabe-Tokens pro Runde liegt dies im Bereich des kürzeren Kontextfensters von Sol.
Das ergibt insgesamt 4.932.000 Tokens, wovon 4.800.000 auf Cache-Reads entfallen – also rund 97 %. Das verdeutlicht lediglich: Unter der Annahme von „langem Präfix, vielen Runden und kurzen Outputs pro Runde“ landet die reine Token-Zahl tatsächlich in der vom Autor genannten Spanne.
| Modell | Cache-Read | Miss | Output | Write / Erster Miss | Gesamt | Cache-Read-Anteil (USD) |
|---|---|---|---|---|---|---|
| Opus 5.5, 5-Minuten-Write | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | ca. 47 % |
| GPT-6.1 Sol, ≤272K, 30-Minuten-Write | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | ca. 47 % |
| Kimi K3.1 Pro, 5-Minuten-Write | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | ca. 65 % |
| V4.1 Flash (Nebenzeiten) | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | ca. 30 % |
| V4.1 Flash (Spitzenzeiten) | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | ca. 30 % |
Die vier Einzelpreise für kurze Kontexte liegen bei Opus und Sol exakt im Verhältnis 2:1, weshalb ihre relativen Anteile identisch sind und die Summe genau die Hälfte ausmacht. Bei Kimi kostet das Lesen aus dem Cache (Cache-Read) 10 % statt 5 % des regulären Input-Preises. Bei der gleichen Token-Struktur entfallen daher rund 65 % der Kosten auf Cache-Reads, was einer Summe von 1,48 $ entspricht – ein Wert, der genau dazwischenliegt. Flash liegt in der Nebenzeit insgesamt bei rund 0,049 $, in Spitzenzeiten verdoppelt sich dieser Betrag. Da der Cache-Read hier lediglich 2 % eines Cache-Miss ausmacht, verlagert sich der Hauptteil der Kosten in diesem Szenario wieder auf den Output (rund 40 %), während Cache-Reads etwa 30 % ausmachen. Unter den drei Flaggschiff-Modellen bleibt der Cache-Read dennoch der größte Posten auf dieser Beispielabrechnung. Flash spart dabei gleich eine ganze Größenordnung auf der Gesamtrechnung ein – und verändert nicht bloß dieselbe 96%-Kostenstruktur im Detail.
Verändert sich das Präfix jedoch in jeder Runde, ist die obige Tabelle hinfällig. Zeitstempel, zufällig angeordnete Tool-Listen oder mitten in die System-Eingabeaufforderung eingeschobene Benutzernamen machen jeden Cache-Hit zunichte. In diesem Fall entscheiden die Preise für Cache-Misses und Schreibvorgänge (Cache-Writes). Der 5-Minuten-Write bei Opus liegt beim 1,25-Fachen des regulären Input-Preises. Bei Sol beträgt der 30-Minuten-Write ebenfalls das 1,25-Fache, während für ein 12-Stunden-Caching das 2,5-Fache anfällt. Der 5-Minuten-Write von Kimi entspricht exakt dem normalen Input-Preis – hier gibt es keinen Aufschlag für kurze Cache-Fenster. Bei DeepSeek wird für den ersten Durchlauf einfach der reguläre Cache-Miss-Preis fällig.
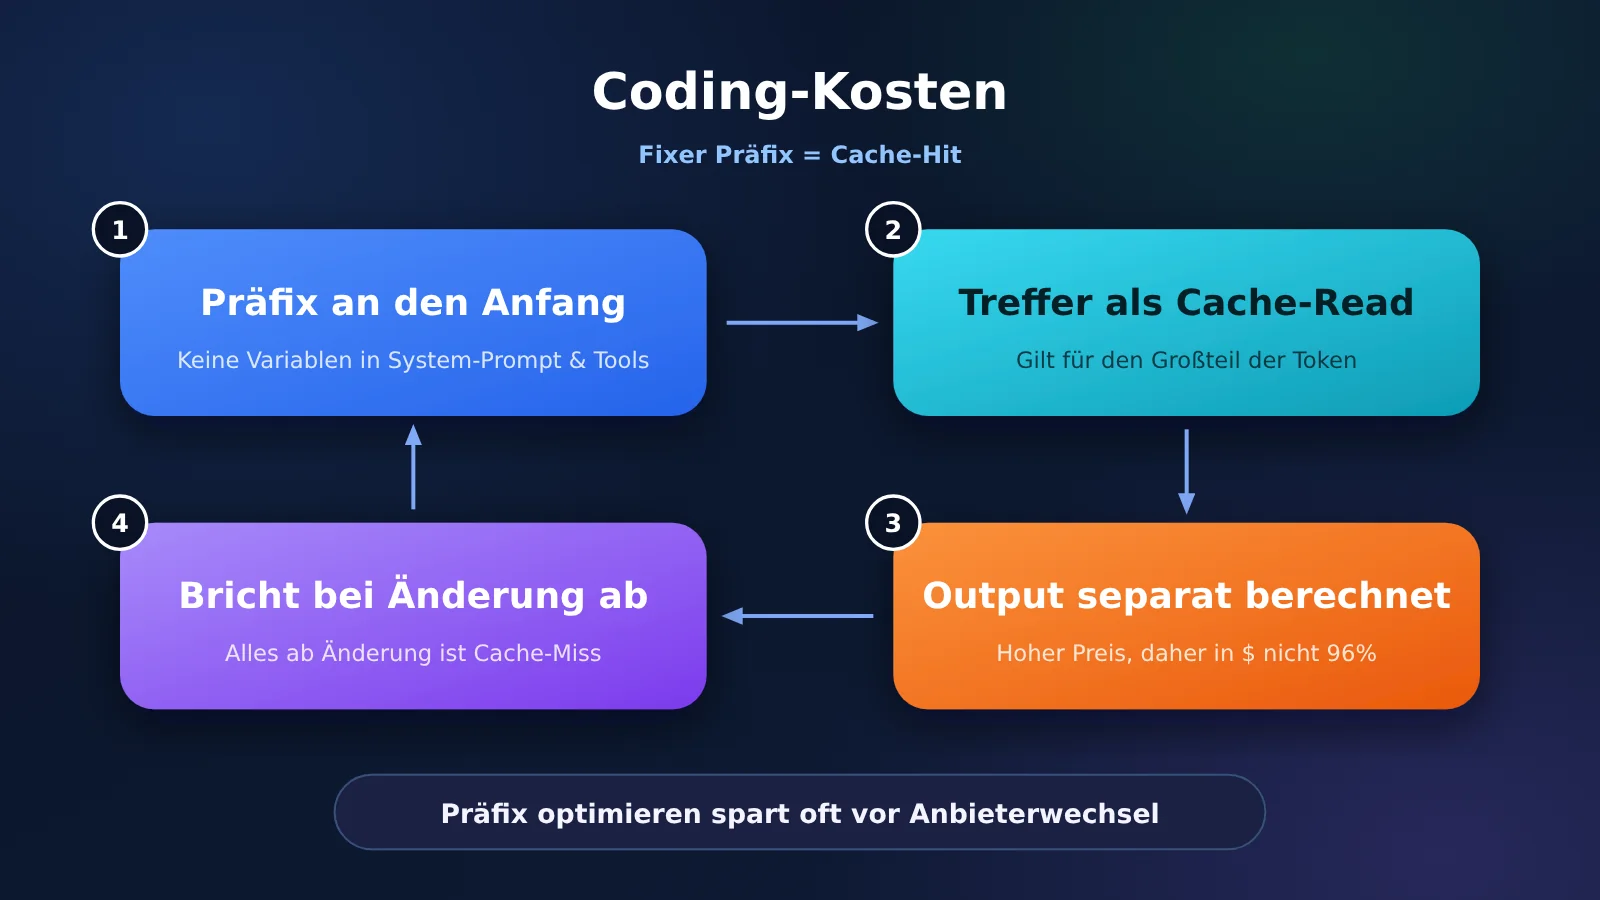
Das Optimieren der Präfixe senkt die Kosten meist wesentlich schneller und spürbarer als ein Wechsel des Anbieters. Achten Sie auf eine feste, konsistente Reihenfolge bei Tool-Listen, verschieben Sie dynamische Inhalte ans Ende der Nachricht und stellen Sie sicher, dass die Intervalle innerhalb einer Sitzung die TTL der kurzen Stufe nicht überschreiten. Sobald diese Optimierungen umgesetzt sind, lässt sich die finale Modellauswahl fundiert anhand der Einzelpreise für Cache-Reads treffen.
Was verrät uns die Preissenkungs-Timeline dieser vier Monate?
Die Aussage „bis zu 80 % günstiger“ trifft an zwei Stellen tatsächlich zu – man sollte das jedoch keinesfalls so verstehen, als wären pauschal alle Modelle um 80 % im Preis gefallen. Der erste Fall stammt aus den Aufzeichnungen von Max Woolf: Am 30.07.2026 senkte OpenAI die Preise für GPT-5.6 Luna von 1 $ / 6 $ / 0,10 $ auf 0,20 $ / 1,20 $ / 0,02 $ – sowohl Input als auch Cache-Read fielen hierbei um rund 80 %. Der zweite Fall betrifft die Cache-Read-Preise der Sol-Produktlinie: von 0,50 $ bei GPT-5.6 Sol am 26.06.2026 auf 0,10 $ bei GPT-6.1 Sol am 29.09.2026 – ebenfalls ein Minus von 80 %. Hierbei wechselte allerdings auch die Modellversion von 5.6 auf 6.1; es handelt sich also nicht um denselben SKU mit einem reduzierten Preisschild.
| Datum | Protokollierte Änderung | Input / Output / Cache-Read |
|---|---|---|
| 2026-06-26 | OpenAI veröffentlicht GPT-5.6 Sol und Luna | Sol 5 $ / 30 $ / 0,50 $ |
| 2026-06-30 | Anthropic veröffentlicht Sonnet 5 (Einführungspreis damals als vorübergehend deklariert) | 2 $ / 10 $ / 0,20 $ |
| 2026-07-24 | Anthropic veröffentlicht Opus 5 | 5 $ / 25 $ / 0,50 $ |
| 2026-07-30 | GPT-5.6 Luna Preissenkung | 0,20 $ / 1,20 $ / 0,02 $ |
| 2026-08-21 | GPT-5.6 Sol vorübergehend um ca. 20 % gesenkt (für drei Monate) | 4 $ / 20 $ / 0,40 $ |
| 2026-09-01 | Fable 5.1, Cache-Read günstiger als bei Fable 5 im Juni | 10 $ / 50 $ / 0,25 $ |
| 2026-09-22 | Zeitgleicher Release von GPT-6 Sol und Opus 5.5 | Sol 2 $ / 10 $ / 0,20 $; Opus 5.5 4 $ / 20 $ / 0,20 $ |
| 2026-09-29 | GPT-6.1 Sol, Cache-Read nochmals halbiert | 2 $ / 10 $ / 0,10 $ |
Die obige Tabelle basiert auf der Zusammenstellung von Max Woolf; die drei Preisangaben stehen jeweils für Input, Output und Cache-Read. Für diesen Artikel haben wir die aktuellen Preise der letzten beiden Zeilen abgeglichen: Die 4 $ / 20 $ / 0,20 $ für Opus 5.5 stimmen exakt mit der Preisliste von Anthropic überein; die 2 $ / 10 $ / 0,10 $ für GPT-6.1 Sol entsprechen OpenAIs Standardtarif bei kurzem Kontext. Die früheren Zeilen wurden nicht einzeln anhand der damaligen Ankündigungen gegengeprüft – bei Zitaten empfiehlt sich daher ein Blick in seinen Originalbeitrag.
Zu Opus 5.5 merkt Woolf zudem an, dass die Gesamtkosten um 40 % bis 60 % gesunken seien. In der offiziellen Preisliste lassen sich die drei Einzelpreise nachvollziehen: Im Vergleich zu Opus 5 sind Input und Output jeweils um 20 % günstiger (5 $ auf 4 $, 25 $ auf 20 $), während der Cache-Read von 0,50 $ auf 0,20 $ fiel – ein Rückgang um 60 %. Die Spanne von 40 % bis 60 % ist somit eine von ihm anhand typischer Nutzungsmuster geschätzte Gesamtreduktion, kein offizieller Pauschalrabatt. Anthropic selbst erklärt, dass Opus 5.5 weniger Inferenz-Rechenleistung benötige als Opus 5 und sich dies in der Preisgestaltung widerspiegele – das ist allerdings die Herstellerperspektive.
Woolf erwähnt außerdem, dass DeepSeek V4.1 Flash über die hauseigene Schnittstelle bei etwa 0,15 $ / 0,60 $ / 0,003 $ liege. Diese Werte entsprechen den offiziellen Off-Peak-Tarifen; zu Spitzenzeiten verdoppeln sie sich. Kimi K3.1 Pro listet er mit 2 $ / 10 $ / 0,20 $ auf, was mit den Angaben auf der offiziellen Website übereinstimmt. Die im Text genannten Scores von Artificial Analysis – Kimi bei 55, Opus 5.5 bei 58 und Flash bei 45 – sind Benchmarks von Drittanbietern und keine eigenen Coding-Evaluierungen. Bei der Modellauswahl sollte man sich daher keineswegs nur auf diese wenigen Punkte Unterschied verlassen.
Wie wählen kleine Teams Modelle aus, wenn Enterprise-Rabatte fehlen?
Hinter den offiziellen Listenpreisen gibt es oft eine weitere Rabattstufe, die nur Großkunden zu Gesicht bekommen. Laut einem Bericht von The Information (zitiert von AI Weekly am 24.10.2026) soll OpenAI mit einem Preisnachlass von über 30 % einen Vertrag im Wert von über 100 Millionen Dollar pro Jahr an Land gezogen haben. Infolgedessen verlagerte Replit den Großteil seiner KI-Ausgaben von Anthropic zu OpenAI. Dem Bericht zufolge hatte Anthropic frühere Rabatte für Replit nicht verlängert. Eine offizielle Bestätigung der beteiligten Parteien liegt nicht vor. Amjad Masad, CEO von Replit, erklärte auf der TechCrunch Disrupt, die Entscheidung beruhe auf Kosten, Partnerschaften und Performance. Laut dem Bericht bleiben Claude-Modelle weiterhin verfügbar, während OpenAI zum Standard für Agents wurde. Im selben Artikel hieß es, dass auch Rippling sein Coding-Volumen aus Kostengründen von Anthropic zu OpenAI verlagerte. Das sind Medienberichte, keine offiziellen gemeinsamen Preislisten.
Kleine Teams haben auf solche Deals keine Chance. Ohne ein jährliches Commitment von 100 Millionen Dollar gibt es eben keine 30 % Rabatt. Selbst wenn man diesen 30%-Rabatt rein rechnerisch auf die Cache-Reads von Opus anwendet, sinkt der Preis von 0,20 $ auf 0,14 $ – und liegt damit immer noch über dem offiziellen Listenpreis von GPT-6.1 Sol für kurze Kontexte (0,10 $). Im Bericht wird nicht spezifiziert, ob der Rabatt auf Cache-Reads, Cache-Misses oder das Gesamtvolumen gewährt wurde. Dieser Vergleich soll lediglich die Größenordnung verdeutlichen: Die regulären Cache-Read-Preise genügen völlig, um als kleines Team eine fundierte erste Auswahl zu treffen.
| Session-Merkmal | Erste Wahl | Grund |
|---|---|---|
| Stabiler Präfix, Input meist unter 272K, proprietäres Coding-Modell gewünscht | GPT-6.1 Sol | Cache-Read bei 0,10 $, der niedrigste unter den drei Anbietern |
| Einzelner Input überschreitet 272K | Nicht mehr mit 0,10 $ rechnen | Sol Cache-Read steigt auf 0,20 $, Output auf 15 $ |
| Cache-Read-Budget wie bei Opus, aber günstigere Misses und Outputs gewünscht | Kimi K3.1 Pro | Cache-Read ebenfalls 0,20 $, Input/Output bei 2 $ / 10 $ ohne Staffelung |
| Hohe Trefferquote, Tasks laufen außerhalb der Stoßzeiten (Off-Peak) | DeepSeek V4.1 Flash (Off-Peak) | Cache-Read bei 0,003 $, Kosten um eine Größenordnung niedriger |
| Feste Ausführung an Werktagen (Peking-Zeit 9–12 Uhr, 14–18 Uhr) | Flash mit Peak-Preisen kalkulieren | Cache-Read steigt auf 0,006 $, andere Einzelpreise verdoppeln sich ebenfalls |
| Präfix ändert sich in jedem Durchlauf | Zuerst Präfix optimieren | Cache-Read-Preise greifen hier ohnehin nicht |
Die Modellleistung ist in dieser Tabelle bewusst nicht gerankt. Max Woolf stuft beispielsweise Opus 5.5 stärker ein als das teurere Fable 5.1 – das ist seine individuelle Praxiseinschätzung. DeepSeek gibt offiziell an, dass deepseek-flash nun über DeepSeek-V4.1-Flash-1017 bereitgestellt wird. Der alte Bezeichner deepseek-v4-flash bleibt weiterhin gültig und wird nach Flash-Tarif abgerechnet, während deepseek-v4-pro separat vertrieben wird. Ein offizielles Leistungsranking zwischen Flash und Pro gibt es nicht. Als Faustregel gilt: Wenn die Kosten eines Fehlschlags den Preisunterschied pro Token übersteigen, greift man zum teureren Modell. Ist das Fehlerrisiko finanziell vernachlässigbar, lässt man die Schleife kostengünstig mit Flash durchlaufen.
💰 Kostenoptimierung: Der Listenpreis ist nur der Standardwert. In der Konsole von APIYI apiyi.com wird der rabattierte Preis je nach Benutzergruppe angezeigt. Guthabenaktionen gelten zusätzlich; die genauen Bedingungen sind auf der Preisseite aufgeführt. Das sind transparente, öffentliche Konditionen – keine individuellen Rahmenverträge, die mühsam verhandelt werden müssen. Maßgeblich für die Abrechnung sind die Werte in der Konsole.
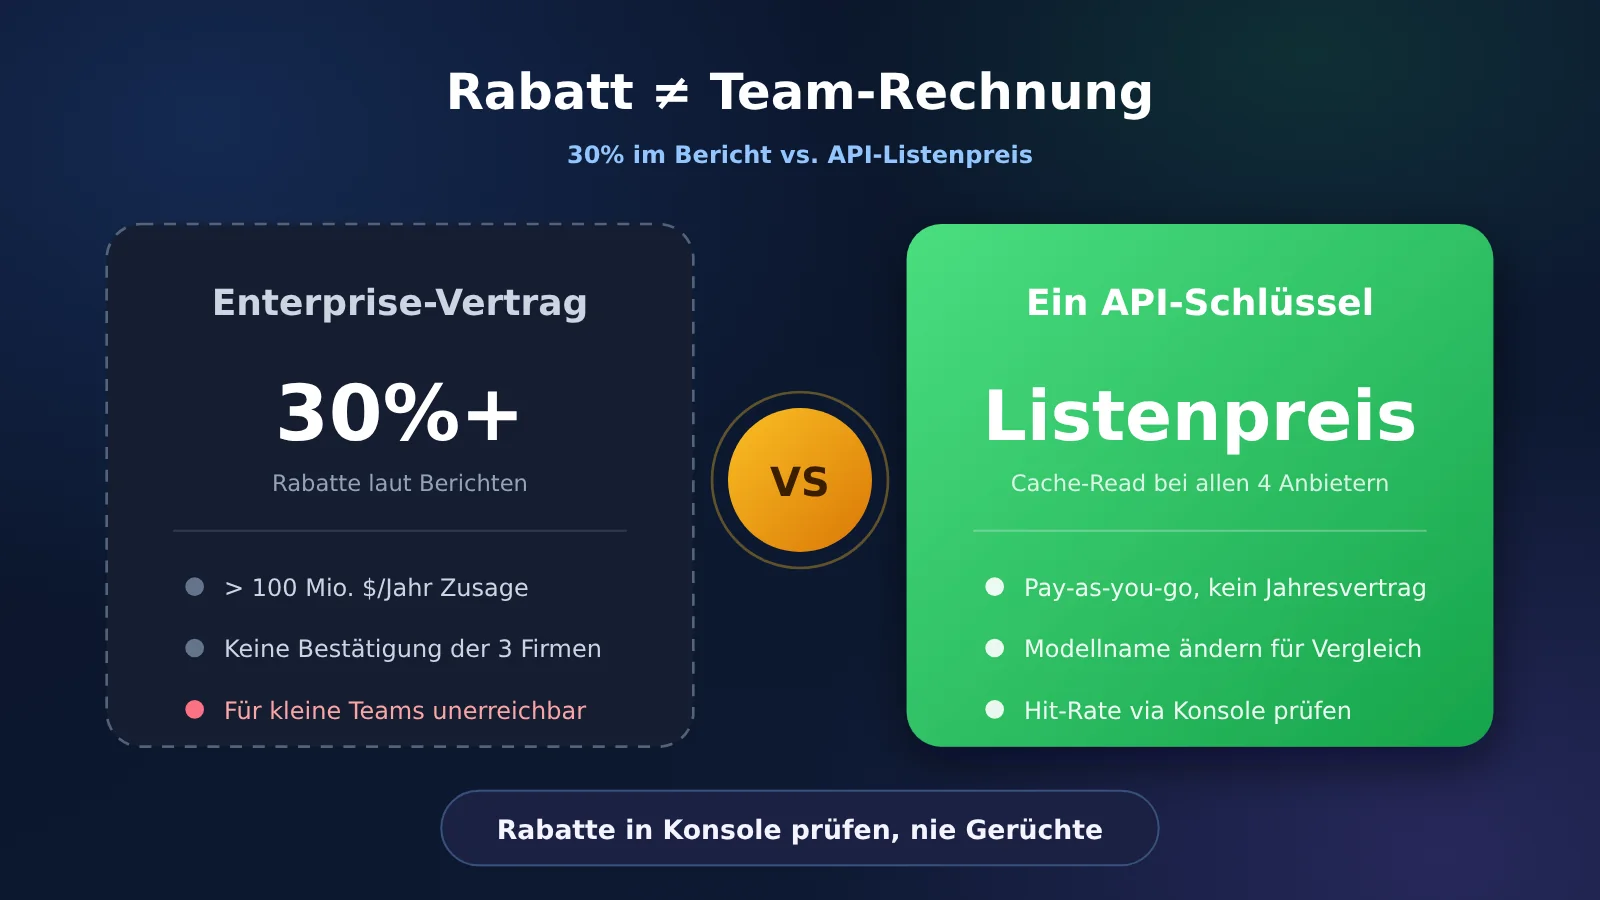
Die 30 % und 100 Millionen US-Dollar auf der linken Seite stammen aus Medienberichten und sollten nicht als verbindliche Bestellpreise verstanden werden. Die rechte Seite zeigt den Weg, den auch kleine Teams tatsächlich umsetzen können.
Wie man mit einem einzigen Key die Cache-Reads von vier Anbietern überprüft
Laut Preisseite empfiehlt es sich für GPT-5 und neuere Modelle, vorrangig /v1/responses zu nutzen, da der Cache bei mehreren Runden so deutlich leichter greift. Chat Completions steht weiterhin zur Verfügung. Im folgenden Beispiel nutzen wir Chat Completions, damit man für gpt-6.1-sol, kimi-k3.1-pro und deepseek-flash lediglich den Modellnamen austauschen muss. Bei Opus 5.5 ist das Caching auf diesem Pfad allerdings nicht das Standardverhalten. Bei Anthropic aktiviert man es derzeit, indem man auf oberster Ebene des Requests ein cache_control setzt oder Breakpoints direkt auf Inhaltsblöcke anwendet. APIYI stellt für claude-opus-5-5 sowohl chat als auch messages bereit. Wenn Sie von den vergünstigten Cache-Preisen profitieren wollen, nutzen Sie messages zusammen mit cache_control. Verlassen Sie sich bei reiner Nutzung von Chat Completions nicht darauf, dass die im Katalog genannten 0,20 $ bereits greifen.
- Basis-Setup vorbereiten: Wer das SDK noch nicht installiert hat, führt zuerst einmal
pip install openaiaus. Am Anfang des Skripts stehenimport osundfrom openai import OpenAI. Hinterlegen Sie den API-Schlüssel in der UmgebungsvariableAPIYI_API_KEY– bitte keinesfalls fest ins Repository einchecken. - Client initialisieren: Eine einzige Zeile genügt:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). Die Basis-URL wird nur an dieser zentralen Stelle angepasst. - Präfix festlegen: In
STABLE_PREFIXkommen die System-Eingabeaufforderung und Tool-Definitionen, die Wort für Wort unverändert bleiben;user_turnenthält die dynamischen Inhalte der aktuellen Runde und steht immer an letzter Stelle. - Request abschicken:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}]). Tauscht manmodelgegenkimi-k3.1-prooderdeepseek-flashaus, bindet man direkt die beiden anderen Anbieter ein. - Nutzung auslesen: Zuerst
details = resp.usage.prompt_tokens_details, danncached = getattr(details, "cached_tokens", 0) or 0und schließlichprint(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens). Die drei Zahlen stehen der Reihe nach für Eingabeaufforderungs-Tokens, Cache-Treffer-Tokens und Ausgabe-Tokens.
Lässt man das Ganze über mehrere Runden laufen und teilt die Cache-Treffer durch die Prompt-Tokens, erhält man seine reale Hit-Rate. Multipliziert man diese Treffermenge anschließend mit dem jeweiligen Cache-Read-Preis des Anbieters, erhält man die tatsächlichen Kosten in US-Dollar. In der Kimi-Dokumentation wird explizit erwähnt, dass die Cache-Stufe ein Konfigurationspreis ist – abgerechnet wird gemäß der Konsole. Wenn Sie bei DeepSeek den Off-Peak-Tarif für Nebenzeiten nutzen möchten, wechseln Sie im Katalog auf den Modellnamen deepseek-v4-1-flash-260910 – gehen Sie nicht davon aus, dass deepseek-flash die Preise automatisch nach der Uhrzeit anpasst.
Hinterlegen Sie den Key in der Umgebungsvariable APIYI_API_KEY, anstatt ihn im Code zu speichern. Das kostenlose Testguthaben eignet sich ideal dafür, dasselbe Präfix über vier Modellnamen hinweg für ein paar Runden durchlaufen zu lassen, um rein die Verbrauchsstruktur zu vergleichen. Erst wenn mehr Durchsatz oder tiefere Tests nötig sind, sollten Sie die Anzahl der Runden erhöhen – anstatt direkt alle vier Anbieter über ein riesiges Repository laufen zu lassen.
Häufige Fragen zum Cache-Read-Vergleich
Q1: Bedeutet 96 %, dass Cache-Reads 96 % des Rechnungsbetrags ausmachen?
Das ist nicht die Schlussfolgerung dieses Artikels. Max Woolf beschrieb, dass Cache-Reads 96 % bis 99 % der gesamten Token-Kosten ausmachen – allerdings ohne Nennung des Nenners, weshalb es sich um eine Schätzung Dritter handelt. WorkloadBench ermittelte 89 % bis 96 % der Eingabeaufforderung-Tokens (Prompt-Tokens), exklusive Ausgaben (Outputs). Nach den beispielhaften Annahmen in diesem Artikel machen Tokens etwa 97 % aus, während der Kostenanteil in US-Dollar bei Opus und Sol bei etwa 47 %, bei Kimi bei etwa 65 % und bei Flash bei etwa 30 % liegt.
Q2: Warum liegt der Cache-Read-Preis bei Sol manchmal bei 0,10 $ und manchmal bei 0,20 $?
Das hängt von der Eingabelänge des einzelnen Aufrufs ab. Liegt sie bei maximal 272K Tokens, beträgt der Standardtarif für Cache-Reads bei OpenAI 0,10 $. Wird dieser Wert überschritten, steigt der Preis auf 0,20 $; gleichzeitig erhöhen sich die Kosten für reguläre Eingaben (Cache-Misses) auf 4 $ und für Ausgaben auf 15 $. Im Katalog von APIYI wird für kurze Kontexte die Preisstaffel 2 $ / 10 $ / 0,10 $ aufgeführt, mit dem Hinweis, dass ab 272.000 Tokens der Eingabepreis auf 4 $ steigt. Für Ausgaben und Cache-Reads bei langen Kontexten gelten die OpenAI-Standardtarife. Falls die Konsole dies nach Stufen getrennt anzeigt, ist die Angabe in der Konsole maßgebend.
Q3: Warum gibt es bei DeepSeek zwei verschiedene Cache-Read-Tarife?
Offiziell wird nach Spitzen- und Nebenzeiten (Peak/Off-Peak) abgerechnet, wobei die Nebenzeittarife nur halb so hoch sind wie in Spitzenzeiten. In der Nebenzeit kostet ein Cache-Read 0,003 $, in der Spitzenzeit 0,006 $. Spitzenzeiten sind an Werktagen von 09:00 bis 12:00 Uhr sowie von 14:00 bis 18:00 Uhr Pekinger Zeit (bereits aus dem offiziellen UTC-Zeitfenster umgerechnet, gesetzliche Feiertage in China ausgenommen). An Wochenenden und Feiertagen gilt durchgehend der Nebenzeittarif. Im APIYI-Katalog sind diese beiden Preissätze in zwei separaten Modellzeilen aufgeführt.
Q4: Können auch kleine Teams den 30%-Rabatt für Unternehmenskunden erhalten?
Die in Berichten erwähnten Rabatte sind an Jahresverträge von über 100 Millionen US-Dollar gekoppelt und wurden von keinem der drei Anbieter öffentlich bestätigt. Kleinen Teams fehlt dieses Zusagevolumen. Für eine erste Auswahl genügt jedoch bereits der Vergleich der offiziell publizierten Cache-Read-Preise. Rabattierte Gruppenpreise und Guthaben-Aktionen entnehmen Sie bitte der APIYI-Konsole – diese sollten nicht mit denselben Unternehmenskontingenten verwechselt werden.
Q5: Wie bindet man alle vier Anbieter mit einem einzigen API-Schlüssel an?
Erstellen Sie einen API-Schlüssel auf APIYI (apiyi.com) und verwenden Sie als Basis-URL `https://api.apiyi.com/v1`. `gpt-6.1-sol`, `kimi-k3.1-pro` und `deepseek-flash` können direkt über Chat Completions aufgerufen werden – Sie müssen lediglich den Modellnamen anpassen. Bei `claude-opus-5-5` nutzen Sie für die Cache-Abrechnung den Endpunkt `messages` zusammen mit `cache_control`. Bei GPT-5 und neueren Modellen empfiehlt die Preisseite den Wechsel auf `/v1/responses`, um bei mehrstufigen Dialogen (Multi-Turn) eine höhere Trefferquote zu erzielen.
Q6: Sollte man Flash als Standardmodell wählen, nur weil Cache-Reads so günstig sind?
Nur dann, wenn die Kosten möglicher Fehlversuche geringer sind als die Preisdifferenz. Die beispielhafte Rechnung in Nebenzeiten liegt bei etwa einem Zwanzigstel der Kosten von Sol (0,0486 $ gegenüber 1,02 $), in Spitzenzeiten bei etwa einem Zehntel. Wenn Flash jedoch mehrere Iterationsrunden benötigt, um dieselbe Aufgabe zu lösen, machen die zusätzlichen Runden den Preisvorteil schnell wieder zunichte. Testen Sie am besten vorab mit kostenlosem Guthaben anhand desselben Präfixes, wie viele Runden für eine erfolgreiche Fertigstellung nötig sind, bevor Sie ein Standardmodell festlegen.
Q7: Sind Cache-Writes teurer als Cache-Reads?
Das passiert, wenn Präfixe häufig ablaufen und Cache-Hits selten sind. Das kurzzeitige Schreiben in den Cache kostet bei Opus und Sol das 1,25-Fache des normalen Inputs, die 12-Stunden-Stufe bei Sol liegt beim 2,5-Fachen. Bei Kimi entspricht das Schreiben für ein 5-Minuten-Fenster dem regulären Input-Preis. Erst nach zwei bis drei Treffer-Runden wird der Cache-Read zum entscheidenden Kostenfaktor. Wählen Sie bei Aufgaben mit unregelmäßigen Intervallen daher zuerst die passende TTL, bevor Sie die Cache-Read-Preise vergleichen.
Die wichtigsten Kernpunkte beim Vergleich von Cache-Reads
- Die 96 % sind eine Drittanbieter-Schätzung: Max Woolf hat keine Logs veröffentlicht. Die Dollar-Anteile müssen Sie anhand der Einzelpreise selbst berechnen.
- Zuerst auf Cache-Reads achten, dann auf Stufenwechsel: Sobald Sol 272K überschreitet, steigt der Cache-Read-Preis von 0,10 $ auf 0,20 $.
- Opus und Kimi liegen beim Cache-Read beide bei 0,20 $: Kimi ist bei Cache-Misses sowie beim Output günstiger, und das kurzzeitige Schreiben in den Cache hat keinen Preisaufschlag.
- Flash punktet mit ganz anderen Größenordnungen: 0,003 $ in Nebenzeiten, 0,006 $ in Spitzenzeiten – die Kostenstruktur wird hier nicht mehr allein von Cache-Reads dominiert.
- Die 30 % für Großunternehmen gelten nicht für kleine Teams: Dabei handelt es sich um öffentlich diskutierte Jahresrahmenverträge. Für eine erste Auswahl reichen die offiziellen Listenpreise völlig aus.
- Ein einziger API-Schlüssel für alle vier Anbieter: Wechseln Sie bei APIYI apiyi.com einfach den Modellnamen; maßgeblich für die Cache-Trefferquote ist der tatsächliche Verbrauch in der Konsole.
Fazit
In den letzten vier Monaten gab es offizielle Preissenkungen von bis zu 80 %. Das betrifft vor allem die Listenpreise für Luna sowie die Cache-Read-Preise der Sol-Produktlinie, die von 0,50 $ auf 0,10 $ gefallen sind. Bei Coding-Agents sollte man das Cache-Reading nach wie vor separat betrachten. Nach den offiziellen Preisen vom 26.10.2026 liegt der Cache-Read für GPT-6.1 Sol bei kurzen Kontexten bei 0,10 $, für Opus 5.5 und Kimi K3.1 Pro bei 0,20 $ und für DeepSeek V4.1 Flash in Nebenzeiten bei 0,003 $ bzw. zu Spitzenzeiten bei 0,006 $. Die Spanne von 96 %–99 % wird hier lediglich als Aussage von Max Woolf zitiert. In einer Beispielabrechnung können die Token-Mengen zwar an diesen Bereich heranreichen, die tatsächlichen Ersparnisse in Dollar fallen jedoch spürbar geringer aus.
Die in Berichten erwähnten Enterprise-Rabatte erfordern jährliche Mindestumsätze – für kleinere Teams sind sie kaum erreichbar. Deutlich pragmatischer ist es, alle vier Anbieter über denselben API-Schlüssel anzubinden und die eigene Cache-Hit-Rate mit den offiziellen Cache-Read-Preisen gegenzurechnen, anstatt auf einen Vertrag mit 30 % Nachlass zu warten. Wir empfehlen, über APIYI (apiyi.com) zunächst denselben stabilen Prompt-Präfix zu testen, bevor Sie sich für ein Standardmodell entscheiden.
Autor: APIYI-Technikteam
Technischer Austausch: Kontaktieren Sie uns gerne über die APIYI-Startseite. Die verbindlichen Einzelpreise finden Sie auf der Modellpreis-Seite im Dokumentationszentrum unter docs.apiyi.com.
Referenzen
- Max Woolf: Zeitleiste der Preissenkungen und Schätzungen von 96 %–99 %
- Link:
minimaxir.com/2026/10/cheap-llms -
Anmerkung: 25.10.2026. Die Spanne von 96 %–99 % ist die Angabe des Autors selbst und kein Messwert aus diesem Artikel.
-
Preise der Anthropic-Modelle
- Link:
platform.claude.com/docs/en/about-claude/pricing -
Anmerkung: Preise für Input, Output, Cache-Reads und zwei Stufen für Cache-Writes bei Opus 5.5.
-
Preise der OpenAI-Modelle
- Link:
developers.openai.com/api/docs/pricing -
Anmerkung: Preise für kurzen Kontext, langen Kontext sowie Cache-Reads und Cache-Writes bei GPT-6.1 Sol. Die offizielle Grenze zwischen kurzem und langem Kontext liegt bei 272K.
-
Preise der DeepSeek-Modelle
- Link:
api-docs.deepseek.com/quick_start/pricing -
Anmerkung: Preise für Cache-Hits (Spitzen- und Nebenzeiten), Cache-Misses und Output bei
deepseek-flash. -
Kimi-API
- Link:
platform.kimi.ai -
Anmerkung: Preise für Input, Output, Cache-Hits und standardmäßige Cache-Writes bei Kimi K3.1 Pro.
-
AI Weeklys Bericht über den Replit-Vertrag
- Link:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
Anmerkung: Der Rabatt von über 30 % und das jährliche Ausgabenvolumen von über 100 Millionen US-Dollar basieren auf Recherchen von The Information; die Konditionen wurden von keiner der beteiligten Parteien öffentlich bestätigt.
-
WorkloadBench: Anteil der gecachten Tokens
- Link:
workloadbench.brenhq.com/cache - Anmerkung: 16.10.2026. Bezieht sich auf den Anteil der Eingabeaufforderungs-Tokens, die aus dem Cache stammen, nicht auf den Anteil an den Gesamtkosten in US-Dollar.


