gemini-4-argon wurde am 13. Oktober 2026 veröffentlicht. Viele Entwickler stießen kurz nach der Anbindung auf 429-Fehler: Sobald die Parallelität zunahm, schlugen Anfragen fehl – manchmal sogar einzelne Requests. Der erste Gedanke ist oft: „Das Parallelitätslimit von AI Studio ist zu niedrig.“ Doch meistens stimmt das nicht. In diesem Artikel erklären wir den tatsächlichen Rate-Limit-Mechanismus von gemini-4-argon in AI Studio und zeigen konkrete Lösungen für 429-Fehler.
Das ist nicht noch eine oberflächliche Anleitung nach dem Motto „Einfach einen Retry hinzufügen“. Zunächst klären wir eine wichtige Tatsache: Google hat bislang keine einheitliche, feste Zahl für die maximal zulässige Parallelität von gemini-4-argon veröffentlicht. Die online kursierenden Angaben wie „10 parallele Anfragen“ oder „50 parallele Anfragen“ sind daher nicht belegt.
Was Sie aus diesem Artikel mitnehmen: Sie lernen, 429-Fehler anhand von vier Ursachen zu unterscheiden: RPM, TPM, Verbrauchsrate und Kapazität des vorgelagerten Dienstes. Außerdem erfahren Sie, wie Sie exponentielles Backoff und Rate Limiting in der Praxis einsetzen und wie Sie mit dem Kanal für hohe Parallelität von APIYI (apiyi.com) die Engpässe durch die Kontingente einzelner AI-Studio-Projekte umgehen können.
Die wichtigsten Punkte zu gemini-4-argon
Die folgende Tabelle fasst die wichtigsten Erkenntnisse zusammen. In den weiteren Abschnitten werden sie im Detail erläutert.
| Punkt | Erklärung | Nutzen |
|---|---|---|
| Keine öffentlich bekannte, feste Parallelitätsgrenze | Google hat kein einheitliches Parallelitätslimit für gemini-4-argon veröffentlicht. Die Begrenzungen richten sich nach Kennzahlen wie RPM, TPM und RPD. | Verhindert eine Kapazitätsplanung auf Basis falscher Zahlen |
| RPM ist nicht gleich Parallelität | Die Anzahl der gleichzeitig laufenden Anfragen hängt von der durchschnittlichen Antwortzeit ab – nicht nur von der Anzahl der Anfragen pro Minute. | Ermöglicht eine realistische Einschätzung des eigenen Parallelitätsbedarfs |
| Limits gelten pro Projekt | Mehrere Schlüssel im selben Projekt vervielfachen das Kontingent nicht. | Spart den Aufwand für den Wechsel zwischen API-Schlüsseln |
| Verbrauchslimit für 10 Minuten | Tier 1: 10 $, Tier 2: 50 $, Tier 3: 200 $ | Erklärt, warum trotz eingehaltenem RPM-Limit ein 429-Fehler auftreten kann |
| 429-Fehler systematisch behandeln | Zuerst die vollständige Antwort prüfen, dann die Anfragerate begrenzen, mit Backoff erneut versuchen, den Kanal wechseln oder das Kontingent erhöhen. | Ermöglicht eine schrittweise Lösung nach Priorität |
| APIYI-Kanal für hohe Parallelität | APIYI auf apiyi.com unterstützt gemini-4-argon mit hoher Parallelität. Bei weniger als 500 RPM müssen Sie sich keine Gedanken über Rate-Limits machen. | Eine unkomplizierte Lösung für kleine und mittlere Anwendungen |
Warum 429 nicht unbedingt auf zu hohe Parallelität hindeutet
Viele Entwickler setzen einen 429-Fehler mit „zu hoher Parallelität“ gleich. Im Rate-Limit-System von Google ist Parallelität jedoch keine eigenständige Kennzahl. Ein 429 RESOURCE_EXHAUSTED kann durch die Anzahl der Anfragen pro Minute, die Zahl der Eingabe-Token pro Minute, die täglichen Anfragen, den rollierenden Verbrauch innerhalb von 10 Minuten oder sogar durch Kapazitätsengpässe beim Upstream-Anbieter ausgelöst werden.
gemini-4-argon ist erst seit weniger als einer Woche verfügbar, und die Ressourcen auf der Upstream-Seite werden noch ausgebaut. Selbst wenn Ihr Kontingent ausreicht, kann eine Anfrage daher wegen knapper Kapazitäten vorübergehend abgelehnt werden. Prüfen Sie bei einem 429-Fehler deshalb immer zuerst, welche Begrenzung tatsächlich erreicht wurde, statt einfach die Parallelität zu reduzieren.
Wie hoch ist die Parallelität von gemini-4-argon in AI Studio?
Die kurze Antwort: Es gibt keinen einheitlichen, öffentlich bekannten Festwert. In AI Studio gelten für jedes Projekt eigene RPM-, TPM- und RPD-Kontingente für gemini-4-argon. Die konkreten Werte hängen von der Tier-Stufe und dem Status des Projekts ab und müssen in der Verwaltung eingesehen werden.
Die fünf Arten von Limits in AI Studio
Die von Google verwendeten Begrenzungen lassen sich wie folgt zusammenfassen. Wird eines davon erreicht, kann ein 429-Fehler zurückgegeben werden.
| Limit | Bedeutung | Kann einen 429-Fehler verursachen? |
|---|---|---|
| RPM | Anfragen pro Minute | Ja |
| TPM | Eingabe-Token pro Minute | Ja |
| RPD | Anfragen pro Tag | Ja |
| Verbrauchsrate | API-Verbrauch innerhalb eines rollierenden 10-Minuten-Fensters | Ja |
| Tatsächliche Dienstkapazität | Verfügbare Ressourcen beim Google-Upstream | Möglich |
Beachten Sie die letzte Zeile: Bei unzureichender Kapazität handelt es sich um einen Fall, den Sie nicht durch Anpassungen der Parameter lösen können. Sie können lediglich den Datenverkehr reduzieren, Wiederholungsversuche verzögern oder zu einem anderen Kanal wechseln.
Zusammenhang zwischen RPM und Parallelität
RPM bezeichnet die Gesamtzahl der Anfragen innerhalb einer Minute. Parallelität meint die Anzahl der Anfragen, die gleichzeitig laufen. Beide Größen hängen über die Antwortzeit zusammen. Nehmen wir als Beispiel ein Projekt mit einem Limit von 60 RPM – dies dient nur der Veranschaulichung und entspricht nicht dem tatsächlichen Kontingent von Argon:
- Bei einer durchschnittlichen Antwortzeit von 5 Sekunden laufen theoretisch durchschnittlich etwa 5 Anfragen gleichzeitig.
- Bei einer durchschnittlichen Antwortzeit von 30 Sekunden sind es theoretisch etwa 30 gleichzeitige Anfragen.
- Werden 60 Anfragen auf einmal gesendet, kann es trotz eingehaltenem Minutenlimit zu kurzzeitigen Drosselungen oder Kapazitätsengpässen kommen.
Der dritte Fall wird besonders leicht übersehen. Viele Lasttestskripte senden alle Anfragen gleichzeitig. Solche Lastspitzen lösen eher eine Drosselung aus als ein gleichmäßiger Datenverkehr – selbst wenn die Gesamtzahl der Anfragen innerhalb des Limits bleibt.
So prüfen Sie das tatsächliche gemini-4-argon-Kontingent in der Verwaltung
Rufen Sie in Google AI Studio die Seite „Rate Limits“ auf (unter aistudio.google.com/usage, dort zum Tab „rate-limit“ wechseln). Alternativ können Sie die offizielle Dokumentation zu den Rate-Limits unter ai.google.dev/gemini-api/docs/rate-limits öffnen. Wählen Sie das gewünschte Projekt und gemini-4-argon aus. Anschließend sehen Sie die geltenden RPM-, TPM- und RPD-Limits sowie die aktuelle Tier-Stufe.
Google weist ausdrücklich darauf hin, dass Limits pro Projekt und nicht pro API-Schlüssel gelten. Auch wenn Sie im selben Projekt beliebig viele Schlüssel erstellen, vervielfacht sich das Kontingent dadurch nicht. Eine Erweiterung durch den Wechsel zwischen mehreren API-Schlüsseln funktioniert in AI Studio also nicht.
5 häufige Ursachen für gehäufte 429-Fehler bei gemini-4-argon
Nachdem wir die Limits kennen, sehen wir uns typische Situationen aus der Praxis an. Die folgenden fünf Ursachen decken die meisten Berichte über 429-Fehler bei gemini-4-argon ab.
- Zu hohe momentane Anfragerate: Batch-Aufgaben oder Lasttestskripte senden auf einmal sehr viele Anfragen. Dadurch entstehen Spitzen, die die momentane RPM-Kapazität übersteigen.
- TPM-Limit erreicht: Lange Kontexte und umfangreiche Dokumente verbrauchen viele Tokens. So kann das TPM-Limit erreicht werden, obwohl nur wenige Anfragen gestellt wurden.
- Verbrauchslimit für 10 Minuten erreicht: Dieser Punkt wird am häufigsten übersehen und weiter unten gesondert erläutert.
- Tägliches RPD-Limit ausgeschöpft: Wenn 429-Fehler erst nach einer gewissen Laufzeit auftreten, ist oft das Tageskontingent aufgebraucht.
- Zu geringe Kapazität beim Upstream-Anbieter: Besonders zum Start eines neuen Modells können Ressourcen knapp sein. Anfragen werden dann möglicherweise selbst bei ausreichendem Kontingent abgewiesen.
Häufig übersehen: das Verbrauchslimit für 10 Minuten
Laut der am 15. Oktober 2026 aktualisierten offiziellen Dokumentation von Google gibt es für jede Kontostufe ein Verbrauchslimit innerhalb eines gleitenden 10-Minuten-Fensters.
| Kontostufe | Verbrauchslimit je 10 Minuten |
|---|---|
| Tier 1 | $10 |
| Tier 2 | $50 |
| Tier 3 | $200 |
Ein Beispiel: Verbraucht ein Konto der Stufe Tier 1 innerhalb von 10 Minuten insgesamt $10, kann es 429 RESOURCE_EXHAUSTED zurückgeben, selbst wenn weder das RPM- noch das TPM-Limit überschritten wurde. Als Modell der neuen Generation kann gemini-4-argon pro Aufruf mehr kosten als ältere Modelle. Bei Anfragen mit langem Kontext steigt der Verbrauch besonders schnell. Das ist ein häufiger Grund dafür, dass „das Anfragevolumen gar nicht so hoch ist“, man aber trotzdem gedrosselt wird.
Ein weiterer wichtiger Hinweis: Die in der Google-Dokumentation genannten Kontingente für die Argon Batch API beziehen sich auf das Token-Kontingent der Batch-Warteschlange. Sie sind kein Maß für die Parallelität der Echtzeit-API.
Wie lässt sich die Ursache eines 429-Fehlers bei gemini-4-argon ermitteln?
Unterschiedliche Symptome haben unterschiedliche Ursachen. Eine gezielte Fehlersuche ist deutlich effizienter als wahlloses Anpassen von Parametern.
| Symptom | Zuerst prüfen | Mögliche Maßnahmen |
|---|---|---|
| Bei steigender Parallelität treten häufig 429-Fehler auf | Momentane Anfragerate, RPM, Kapazität des Upstream-Anbieters | Stufenweise Lasttests mit gleichmäßig verteilten Anfragen durchführen. Eine feste Parallelität bedeutet nicht automatisch eine feste RPM. |
| Nach einer gewissen Laufzeit treten 429-Fehler auf | Verbrauchslimit für 10 Minuten, RPD, angesammelter TPM-Verbrauch | Verbrauchskurve und Nutzung des Tageskontingents prüfen |
| Auch einzelne Anfragen oder sehr geringe Parallelität führen zu 429-Fehlern | Zu geringe Upstream-Kapazität, eingeschränktes Konto oder Projekt | Ursprüngliche Antwort prüfen und einen Wechsel des Kanals in Betracht ziehen |
| Mehrere Schlüssel erhalten gleichzeitig 429-Fehler | Mehrere Schlüssel gehören zum selben Projekt und teilen sich das Kontingent | Gesamtverkehr des Projekts reduzieren oder einen Kanal mit eigenständigem Kontingent nutzen |
Für die Fehlersuche sind zwei Informationen besonders wichtig: Erstens, ob dein AI-Studio-Konto zu Tier 1, Tier 2 oder Tier 3 gehört. Zweitens der ursprüngliche Fehlertext des 429-Fehlers – insbesondere error.message, error.details und der Retry-After-Header. Mit diesen Angaben lässt sich meist unterscheiden, ob das Kontingent des Kontos zu niedrig, das Anfragevolumen zu hoch oder die Verfügbarkeit des neuen Google-Argon-Modells eingeschränkt ist. Für diese drei Fälle gelten völlig unterschiedliche Lösungen.
6 Schritte zur Behebung von 429-Fehlern bei gemini-4-argon
Die folgenden Maßnahmen sind nach ihrer praktischen Priorität geordnet: P0 sollte zuerst umgesetzt werden, P2 ist Teil der langfristigen Planung.
| Priorität | Maßnahme | Wirkung |
|---|---|---|
| P0 | Ursprüngliche 429-Antwort und Retry-After prüfen |
Den konkreten Grund für die Drosselung ermitteln |
| P0 | RPM, TPM und Verbrauchsrate projektbezogen begrenzen | Wiederholte Quotenüberschreitungen vermeiden |
| P0 | Bei 429 exponentiellen Backoff mit zufälligem Jitter verwenden | Plötzliche Überlastung abfedern |
| P1 | Bei 429 automatisch auf einen gesunden Kanal mit eigenständigem Kontingent wechseln | Erfolgsquote erhöhen |
| P1 | Tier upgraden oder bei Google eine Kontingenterhöhung beantragen | Langfristig mehr Kapazität erhalten |
| P2 | Vertex AI oder andere offiziell autorisierte Kanäle prüfen | Verfügbare Ressourcen erweitern |
Schritt 1: Die ursprüngliche 429-Antwort verstehen
Nicht einfach nur den Statuscode sehen und erneut versuchen. Gib zuerst den vollständigen Fehlertext und die Antwort-Header aus. Achte besonders auf error.message, error.details und Retry-After. Wenn der Upstream bereits angibt, wie lange gewartet werden soll, solltest du diesen Zeitraum bevorzugen, statt selbst ein Intervall festzulegen.
Schritt 2: Anfragen clientseitig drosseln
Begrenze RPM auf 70 bis 80 Prozent des im Dashboard angezeigten Limits, verwalte TPM separat und überwache zusätzlich die Ausgaben über einen Zeitraum von 10 Minuten. Der Puffer fängt Spitzen im Datenverkehr und Schwankungen beim Upstream ab. Viele Teams begrenzen nur die Anzahl der Anfragen und übersehen Token und Kosten. Das führt dazu, dass Anfragen abgelehnt werden, obwohl das RPM-Limit offenbar nicht überschritten wurde.
Schritt 3: Exponentiellen Backoff mit zufälligem Jitter verwenden
Google empfiehlt bei 429 exponentiellen Backoff, zum Beispiel Wartezeiten von 1, 2, 4 und 8 Sekunden, ergänzt durch zufälligen Jitter. So wird verhindert, dass viele Anfragen gleichzeitig erneut gesendet werden und eine zweite Überlastung auslösen. Wiederhole den Versuch höchstens zwei- bis dreimal und richte dich vorrangig nach der vom Upstream angegebenen Wartezeit.
Schritt 4: Bei anhaltenden 429-Fehlern den Kanal wechseln
Wenn dasselbe Projekt wiederholt 429 zurückgibt, solltest du es nicht weiterhin mit Anfragen belasten. Das verschärft die Drosselung nur. Reduziere stattdessen den Datenverkehr oder wechsle zu einem gesunden Kanal mit eigenständigem Kontingent. Genau darin liegt der Vorteil eines Aggregationsdienstes: Bei Aufrufen über APIYI apiyi.com können Anfragen auf mehrere Kanäle mit unabhängigen Kontingenten verteilt werden. So muss nicht ein einzelnes AI-Studio-Projekt die gesamte Last tragen.
Schritt 5: Tier upgraden oder eine Kontingenterhöhung beantragen
Langfristig lässt sich ein Kapazitätsmangel nur durch ein höheres Konto-Tier oder eine Kontingenterhöhung bei Google beheben. Mit einem höheren Tier werden nicht nur RPM und TPM erhöht, sondern auch das Ausgabenlimit für 10 Minuten: von 10 US-Dollar auf 50 oder sogar 200 US-Dollar. Eine Erhöhung braucht jedoch Zeit und setzt meist eine entsprechende Ausgabenhistorie voraus. Häufig geht das langsamer, als das Geschäft den zusätzlichen Bedarf entwickelt.
Schritt 6: Andere offiziell autorisierte Kanäle prüfen
Wenn das Geschäft kontinuierlich wächst, können Vertex AI oder andere offiziell autorisierte Kanäle zusätzliche Ressourcen bereitstellen. Der parallele Einsatz mehrerer Kanäle ist außerdem eine solide Möglichkeit, das Risiko eines einzelnen Ausfallpunkts zu senken.
Empfehlungen für Lasttests bei neuen Kanälen
Beginne bei einem neu angebundenen Argon-Kanal mit einer Parallelität von 5 bis 10. Beachte, dass dies lediglich Startwerte für den Test sind und keine offiziellen Obergrenzen für gleichzeitige Anfragen. Erhöhe die Last anschließend schrittweise und sende auf jeder Stufe gleichmäßig verteilte Anfragen. Erfasse 429-Rate, tatsächliche RPM, TPM, Ausgaben über 10 Minuten und Antwortzeiten getrennt nach Anbieter, Google-Projekt und Modell. Gehe erst dann zur nächsten Stufe über, wenn der Kanal stabil läuft.
Schnelleinstieg in gemini-4-argon: Aufrufe über APIYI
Nach der Theorie nun zum Code. APIYI bietet eine OpenAI-kompatible Schnittstelle. Für Aufrufe von gemini-4-argon musst du lediglich base_url anpassen.
Minimales Beispiel
Mit den folgenden gut zehn Codezeilen kannst du einen Aufruf testen:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    messages=[{"role": "user", "content": "用一句话解释什么是 429 限流"}]
)
print(response.choices[0].message.content)
Vollständigen Code anzeigen: parallele Aufrufe mit exponentiellem Backoff, zufälligem Jitter und Retry-After
import random
import time
from concurrent.futures import ThreadPoolExecutor

import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 使用 APIYI 统一接口
)

MAX_RETRIES = 3       # 最多重试 2-3 次
BASE_DELAY = 1.0      # 指数退避起点:1、2、4、8 秒


def call_argon(prompt: str) -> str:
    """调用 gemini-4-argon,429 时指数退避并优先遵循 Retry-After"""
    for attempt in range(MAX_RETRIES + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-argon",
                messages=[{"role": "user", "content": prompt}],
                max_tokens=512,
            )
            return resp.choices[0].message.content
        except openai.RateLimitError as e:
            if attempt == MAX_RETRIES:
                return f"Error after retries: {e}"
            # 优先使用上游返回的 Retry-After
            retry_after = None
            try:
                retry_after = float(e.response.headers.get("Retry-After"))
            except (AttributeError, TypeError, ValueError):
                pass
            delay = retry_after if retry_after else BASE_DELAY * (2 ** attempt)
            delay += random.uniform(0, 0.5)  # 随机抖动,避免集体重试
            print(f"429,第 {attempt + 1} 次重试,等待 {delay:.1f}s")
            time.sleep(delay)
        except Exception as e:
            return f"Error: {e}"


if __name__ == "__main__":
    prompts = [f"请用一句话介绍第 {i} 种限流策略" for i in range(10)]
    # 并发度从 5 起步压测,不是官方上限
    with ThreadPoolExecutor(max_workers=5) as pool:
        for result in pool.map(call_argon, prompts):
            print(result)
Schnellstart: Registriere dich am besten bei APIYI apiyi.com und erstelle einen API-Schlüssel. Mit dem obigen Code kannst du gemini-4-argon direkt testen. Die Plattform bietet eine einheitliche, OpenAI-kompatible Schnittstelle. Du musst also nicht selbst mehrere Google-Projekte beantragen und verwalten.
Einfache clientseitige Drosselung
Neben Wiederholungsversuchen ist es noch wichtiger, Fehler gar nicht erst zu provozieren. Der folgende minimale Rate Limiter basiert auf dem Token-Bucket-Prinzip. Er glättet den Anfragerhythmus und verhindert plötzliche Spitzen:
import threading
import time


class RateLimiter:
    """按目标 RPM 匀速放行请求,避免瞬时尖峰"""

    def __init__(self, rpm: int):
        self.interval = 60.0 / rpm
        self.lock = threading.Lock()
        self.next_time = time.monotonic()

    def wait(self):
        with self.lock:
            now = time.monotonic()
            if now < self.next_time:
                time.sleep(self.next_time - now)
            self.next_time = max(now, self.next_time) + self.interval


limiter = RateLimiter(rpm=300)  # 按后台限额的 70%-80% 设置

# 在每次调用前执行:
# limiter.wait()
Wenn du den Rate Limiter an den Anfang der Aufruffunktion setzt und mit dem zuvor beschriebenen Backoff kombinierst, erhältst du einen zweistufigen Schutz: aktive Drosselung plus reaktive Wiederholungsverzögerung.
Der gemini-4-argon-Kanal von APIYI für hohe Parallelität
Bei einer direkten Anbindung an AI Studio liegt der Engpass darin, dass die Kontingente pro Projekt festgelegt sind. Bei Konten der Tier 1 kommt außerdem ein Ausgabenlimit von 10 $ pro 10 Minuten hinzu. Ein Aggregationsdienst kann den Datenverkehr dagegen auf mehrere Kanäle mit jeweils eigenständigen Kontingenten verteilen und automatisch auf einen verfügbaren Kanal umschalten, wenn bei einem Kanal wiederholt 429-Fehler auftreten.
APIYI apiyi.com unterstützt derzeit gemini-4-argon mit hoher Parallelität. Bei weniger als 500 RPM müssen Sie sich keine Gedanken über Rate-Limits machen. Sie können den Dienst direkt nutzen. Für die meisten Anwendungen mittlerer und kleiner Größe, internen Tools, automatisierten Workflows sowie Tests und Lasttests reicht dieser Bereich für den täglichen Bedarf aus. So müssen Sie sich nicht mit Tier-Stufen, Projektkontingenten oder dem Ausgabenlimit pro 10-Minuten-Fenster beschäftigen.
| Vergleichspunkt | Direkte Anbindung an AI Studio | Aufruf über APIYI |
|---|---|---|
| Zuordnung der Kontingente | Ein Projekt, mehrere Schlüssel teilen sich das Kontingent | Mehrere Kanäle mit unabhängigen Kontingenten, vom Dienst verwaltet |
| Umgang mit 429-Fehlern | Backoff und Kanalwechsel müssen selbst implementiert werden | Der Dienst schaltet bevorzugt auf verfügbare Kanäle um; auf Clientseite genügt eine grundlegende Wiederholungslogik |
| Ausgabenlimits | Unterliegt dem Ausgabenlimit der jeweiligen Tier-Stufe pro 10 Minuten | Die Kontostufe bei Google muss nicht selbst verwaltet werden |
| Anbindung | Projekt beantragen und Tier konfigurieren | Einheitliche OpenAI-kompatible Schnittstelle; base_url ersetzen |
| Geeignete Größenordnung | Geringer Datenverkehr oder bereits auf eine höhere Tier-Stufe umgestiegen | Bei weniger als 500 RPM müssen Sie sich nicht um Rate-Limits kümmern |
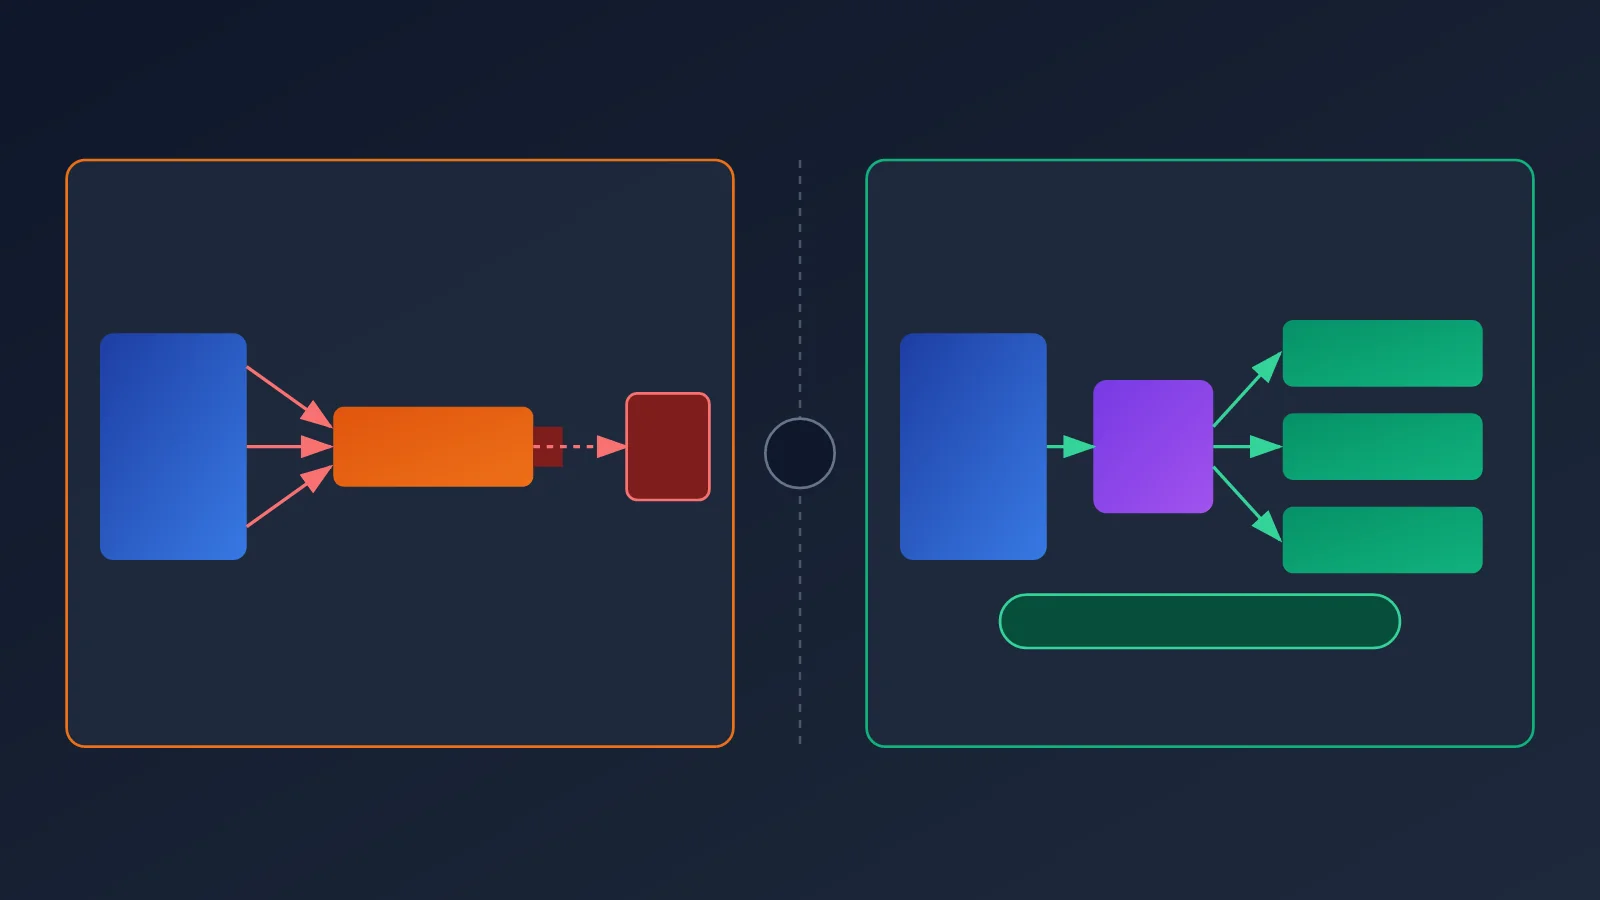
🎯 Technische Empfehlung: Liegt der Spitzenwert Ihrer Anwendung bei höchstens 500 RPM, können Sie gemini-4-argon direkt über APIYI apiyi.com aufrufen und sich ganz auf Ihre Geschäftslogik konzentrieren. Wenn Sie mit einem höheren Datenaufkommen rechnen, sollten Sie zunächst schrittweise Lasttests durchführen und die Kapazitätsplanung frühzeitig mit dem Dienstleister abstimmen.
Auch bei Verwendung eines Kanals mit hoher Parallelität empfiehlt es sich, auf Clientseite exponentiellen Backoff und angemessene Timeouts beizubehalten. Netzwerkschwankungen und kurzfristige Probleme beim Upstream können weiterhin auftreten. Eine gute Wiederholungslogik sorgt dafür, dass Ihr Dienst auch unter extremen Bedingungen stabil läuft.
Häufig gestellte Fragen (FAQ)
F1: Wie viele gleichzeitige Anfragen sind für gemini-4-argon in AI Studio tatsächlich möglich?
Google hat keine einheitliche, feste Zahl für gleichzeitige Anfragen veröffentlicht. Die tatsächlichen Limits hängen von RPM, TPM, RPD und dem Verbrauchslimit für jeweils 10 Minuten des Projekts ab. Rufen Sie in AI Studio die Seite „Rate Limits“ auf und wählen Sie das entsprechende Projekt und Modell aus, um die Werte zu prüfen. Konkrete Zahlen, die im Internet kursieren, sind nicht offiziell bestätigt und eignen sich daher nicht als Grundlage für die Kapazitätsplanung.
F2: Lässt sich das Kontingent für gemini-4-argon durch zusätzliche API-Schlüssel erhöhen?
Nein. Google weist ausdrücklich darauf hin, dass die Limits pro Projekt gelten, nicht pro API-Schlüssel. Mehrere Schlüssel desselben Projekts teilen sich also dasselbe Kontingent. Für tatsächlich unabhängige Kontingente benötigen Sie unterschiedliche Google-Projekte oder einen Multi-Channel-Aggregationsdienst wie APIYI (apiyi.com).
F3: Warum erhalte ich einen 429-Fehler, obwohl weder RPM noch TPM überschritten sind?
Häufig ist das Verbrauchslimit für 10 Minuten erreicht: Tier 1 liegt bei 10 $, Tier 2 bei 50 $ und Tier 3 bei 200 $. Außerdem kann es zu Beginn der Verfügbarkeit eines neuen Modells an Kapazität auf der Upstream-Seite fehlen, sodass Anfragen trotz eingehaltenem Kontingent abgelehnt werden. Prüfen Sie zur Klärung auch `error.details` im ursprünglichen Fehlerobjekt.
F4: Wie sollte ich bei einem 429-Fehler sinnvoll erneut versuchen?
Verwenden Sie exponentielles Backoff, zum Beispiel mit Wartezeiten von 1, 2, 4 und 8 Sekunden, und ergänzen Sie einen zufälligen Jitter. Wiederholen Sie den Versuch höchstens zwei- bis dreimal und beachten Sie bevorzugt den Wert von `Retry-After` im Antwortheader. Treten bei demselben Projekt weiterhin 429-Fehler auf, sollten Sie den Datenverkehr reduzieren oder zu einem Kanal mit eigenständigem Kontingent wechseln, statt es immer wieder zu versuchen.
F5: Wie kann ich gemini-4-argon schnell über APIYI aufrufen?
1. Registrieren Sie sich auf APIYI unter apiyi.com und rufen Sie Ihren API-Schlüssel ab.
2. Setzen Sie `base_url` im Code auf `https://api.apiyi.com/v1`.
3. Legen Sie als Modellnamen `gemini-4-argon` fest. Anschließend können Sie die Beispielcodes aus diesem Artikel ausführen.
APIYI unterstützt eine hohe Anzahl gleichzeitiger Aufrufe von gemini-4-argon. Bei weniger als 500 RPM müssen Sie sich keine Gedanken über Rate-Limits machen. Das eignet sich für schnelle Tests und den Produktivstart in kleinem bis mittlerem Umfang.
F6: Können nach dem Wechsel zu APIYI weiterhin 429-Fehler auftreten?
Bei normaler Nutzung mit weniger als 500 RPM müssen Sie sich grundsätzlich kaum Gedanken über Rate-Limits machen. Kurzzeitige Schwankungen können jedoch bei jedem Upstream-Dienst auftreten. Deshalb empfiehlt es sich weiterhin, ein grundlegendes exponentielles Backoff für Wiederholungsversuche einzubauen. Wenn Ihr Datenverkehr diesen Bereich überschreiten könnte, führen Sie zunächst schrittweise Lasttests durch und klären Sie die Kapazität mit der Plattform über APIYI (apiyi.com) ab.
F7: Kann ich das Kontingent der Batch API als Richtwert für gleichzeitige Echtzeitanfragen verwenden?
Nein. Das von Google dokumentierte Kontingent der Argon Batch API bezieht sich auf die Token-Kapazität der Batch-Warteschlange für Offline-Aufgaben. Es ist ein anderes System als die Limits für gleichzeitige Anfragen und RPM bei der Echtzeit-API. Die Werte lassen sich nicht aufeinander übertragen.
Die wichtigsten Punkte zu 429-Fehlern bei gemini-4-argon
- Keine feste Zahl für gleichzeitige Anfragen: Google hat kein einheitliches Parallelitätslimit für gemini-4-argon veröffentlicht. Maßgeblich ist das tatsächlich zugewiesene Kontingent.
- RPM ist nicht gleich Parallelität: Die Zahl gleichzeitiger Anfragen hängt von der Antwortzeit ab. Spitzenlasten lösen eher Rate-Limits aus als gleichmäßiger Datenverkehr.
- Limits gelten pro Projekt: Zusätzliche API-Schlüssel erhöhen die Kapazität nicht. Alle Schlüssel desselben Projekts teilen sich das Kontingent.
- Verbrauchslimit für 10 Minuten beachten: Tier 1 bis Tier 3 liegen bei 10 $, 50 $ beziehungsweise 200 $. Ein 429-Fehler ist auch möglich, wenn RPM nicht überschritten wurde.
- Backoff, Drosselung und Wechsel: Setzen Sie exponentielles Backoff mit zufälligem Jitter ein. Bei anhaltenden 429-Fehlern sollten Sie zu einem Kanal mit eigenständigem Kontingent wechseln.
- Hohe Parallelität mit weniger Aufwand: APIYI (apiyi.com) unterstützt eine hohe Anzahl gleichzeitiger Aufrufe von gemini-4-argon. Bei weniger als 500 RPM müssen Sie sich keine Gedanken über Rate-Limits machen.
Zusammenfassung
Die häufigen 429-Fehler bei gemini-4-argon in AI Studio liegen nicht in erster Linie an einer „zu geringen Parallelität“. Meist kommen mehrere Beschränkungen zusammen: RPM, TPM, RPD, das Verbrauchslimit über zehn Minuten und die verfügbare Kapazität des Upstream-Dienstes für das neue Modell. Die Lösung sollte daher in mehreren Schritten erfolgen: zunächst die ursprüngliche Antwort auswerten, dann die Anfragerate aktiv begrenzen und exponentielles Backoff mit zufälligen Verzögerungen kombinieren. Treten weiterhin 429-Fehler auf, sollte der Kanal gewechselt werden. Langfristig lässt sich die Kapazität durch ein Upgrade des Tier oder die Erschließung zusätzlicher autorisierter Kanäle erweitern.
Wer sich möglichst wenig mit Kontingenten beschäftigen möchte, kann auf einen Aggregationskanal zurückgreifen. Für einen schnellen Test empfiehlt sich APIYI unter apiyi.com. Die Plattform unterstützt eine hohe Anzahl paralleler Aufrufe von gemini-4-argon. Bis zu 500 RPM kann der Dienst bedenkenlos genutzt werden – probieren Sie es aus.
Referenzen
- Seite zu Nutzung und Ratenlimits von Google AI Studio: Hier finden Sie die projektbezogenen Werte für RPM, TPM und RPD sowie die Tier-Stufe.
- Link:
aistudio.google.com/usage -
Hinweis: Wählen Sie ein Projekt und gemini-4-argon aus, um die tatsächlichen Kontingente anzuzeigen.
-
Dokumentation zu den Ratenlimits der Gemini API: Informationen zu den offiziellen Drosselungsmechanismen und Empfehlungen zum Umgang mit 429-Fehlern.
- Link:
ai.google.dev/gemini-api/docs/rate-limits - Hinweis: Enthält Informationen zum Verbrauchslimit über zehn Minuten und Empfehlungen zum exponentiellen Backoff.
Autor: APIYI Team
Technischer Austausch: Teilen Sie Ihre Erfahrungen bei der Untersuchung von 429-Fehlern mit gemini-4-argon gern in den Kommentaren. Weitere Informationen zur Anbindung finden Sie in der Dokumentation von APIYI unter docs.apiyi.com.